Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
GPT-5.4 w przewodniku Openclaw: korzyści, konfiguracja i najlepsze praktyki
Najnowsze wydanie OpenClaw dodaje pełnoprawną, kompatybilną w przód obsługę GPT-5.4 od OpenAI i wprowadza architekturę „memory hot-swappable”, która pozwala agentom OpenClaw zmieniać w czasie działania, który model i który magazyn pamięci są aktywne, przy minimalnych zakłóceniach. To umożliwia przepływy pracy z dużym kontekstem (rozszerzone okna kontekstu w GPT-5.4), specjalizację modeli w locie oraz optymalizacje kosztów i opóźnień dla agentów produkcyjnych. Aktualizacja jest dostępna w wydaniach OpenClaw i towarzyszącej dokumentacji; poniższe przykłady przedstawiają praktyczną konfigurację, fragmenty kodu, kontekst benchmarków oraz zalecane najlepsze praktyki.
TL;DR: Najnowsze wydanie OpenClaw dodaje pełnoprawne, wstecznie zgodne wsparcie dla GPT-5.4 od OpenAI oraz wprowadza architekturę „hot-swappable” pamięci, która pozwala agentom OpenClaw w czasie działania zmieniać aktywny model i magazyn pamięci przy minimalnych zakłóceniach. Odblokowuje to przepływy pracy z dużym kontekstem (rozszerzone okna kontekstu GPT-5.4), specjalizację modelu w locie oraz optymalizacje kosztów/opóźnień dla agentów produkcyjnych. Aktualizacja jest dostępna w wydaniach i dokumentacji OpenClaw; poniższe przykłady pokazują praktyczną konfigurację, fragmenty kodu, kontekst benchmarków oraz zalecane najlepsze praktyki.
Co faktycznie dostarczyła aktualizacja OpenClaw (szybkie podsumowanie)
W dniu otwartoźródłowy framework agentowy, projekt powiązany z OpenAI, , wydał duże główne wydanie (2026.3.7), które dodaje pełnoprawne wsparcie dla oraz nowatorski mechanizm w swoim silniku kontekstu. To wydanie przekształca szeroko używany eksperymentalny framework agentowy w to, co opiekunowie opisują jako „Agent Operating System” — mający na celu uczynienie przepływów pracy agentów klasy produkcyjnej oraz przełączania modeli bezproblemowymi dla deweloperów i zespołów.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
9 marca 2026
OpenClaw
GPT-5.4
hot-swappable pamięci
3 praktyczne elementy ważne dla twórców agentów:
Pełnoprawne wsparcie GPT-5.4 — aliasy modeli i mapowania dostawców, które pozwalają agentom wybrać GPT-5.4 jako główny model wykonawczy (w tym nadpisywanie kanałów i przypięcia modelu per agent).
Silnik kontekstu i rozproszone wiązanie kanałów — ulepszenia w sposobie, w jaki OpenClaw składa długie okna kontekstu z pamięci, wyników narzędzi i historii kanałów, aby modele o dużej pojemności otrzymywały dobrze ustrukturyzowane wejścia.
Architektura „hot-swappable” pamięci — klarowniejsze interfejsy wtyczek pamięci i przepływy pracy, tak aby można było wymieniać backendy pamięci lub aktualizować agentów bez utraty „tożsamości” lub uszkodzenia utrwalonego stanu (pamięć pozostaje jedynym źródłem prawdy). Projekt pamięci OpenClaw (zwykłe pliki Markdown, indeksowane wyszukiwanie, wtyczkowe pobieranie) umożliwia bezpieczną wymianę na gorąco.
GPT-5.4 — czym jest GPT-5.4 i przełom w benchmarkach
GPT-5.4 to najnowszy model graniczny OpenAI skoncentrowany mocno na produktywności profesjonalnej (arkusze kalkulacyjne, edycja dokumentów i prezentacji, wieloetapowe wnioskowanie i obsługa narzędzi). Według OpenAI i niezależnych publikacji wydanie podkreśla:
Rozszerzony kontekst: GPT-5.4 wprowadza kolejny poziom okien kontekstu, z eksperymentalnym 1M tokenów i ulepszonym przetwarzaniem długiego kontekstu dostępny przez punkty końcowe Codex/zgodne z Codex — dla deweloperów udostępnione są opcje konfiguracyjne takie jak model_context_window i model_auto_compact_token_limit. Pozwala to utrzymywać znacznie większy stan rozmowy, dokumenty i bazy kodu w aktywnym kontekście.
Wyższa dokładność arkuszy i wnioskowania — OpenAI raportuje dużą poprawę w zadaniach modelowania arkuszy (średnie wyniki ~87% vs ~68% dla GPT-5.2 w ich benchmarku bankowo/analitycznym).
Poprawy dokładności i faktograficzności: Wczesne recenzje i QA pokazują ~33% redukcję halucynacji i mniej podatne na błędy wyniki względem GPT-5.2, ze znacznymi zyskami w tworzeniu dokumentów i pracy na arkuszach. Recenzenci wskazali również ~18% spadek odpowiedzi podatnych na błędy w niektórych zadaniach produktywnościowych.
Zintegrowana obsługa komputera i usprawnienia z linii Codex — GPT-5.4 zawiera możliwości odziedziczone z linii Codex, które poprawiają generowanie kodu, interaktywne debugowanie i operacyjne sterowanie narzędziami (automatyzacja myszy/klawiatury/zrzutów ekranu w niektórych demonstracjach). To czyni go lepszym w cyklu write-run-inspect-patch typowym dla pętli agenta.
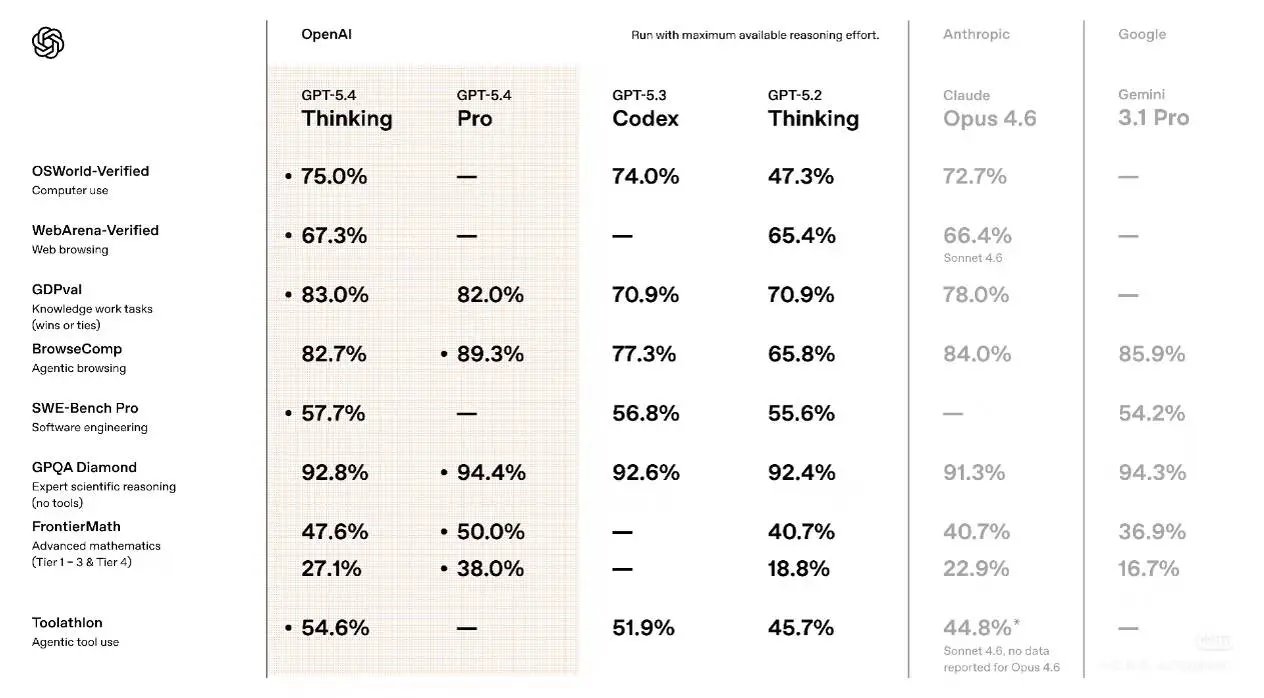
Benchmarki i kontekst porównawczy (co oznaczają liczby)
Modelowanie arkuszy: wewnętrzny benchmark arkuszy OpenAI: ~87.3% średnio dla GPT-5.4 vs ~68.4% dla GPT-5.2. To nagłówek, którego dostawca używa do pokazania zysków w zadaniach specyficznych.
Interakcja z komputerem (OSWorld / testy w stylu agentów): niezależni testerzy i uruchomienia społeczności pokazują, że GPT-5.4 poprawia wyniki w zadaniach interakcji agenta obejmujących manipulację pulpitem lub symulowanym UI, czasem minimalnie wyprzedzając ostatnie warianty modeli Anthropic na tych zestawach zadań (różnice są istotne dla agentów, ale niekoniecznie rozstrzygające w każdym obciążeniu).
Interpretacja: GPT-5.4 nie jest „złotym środkiem”, który wygrywa wszystko. Ma wyraźne mocne strony w zintegrowanym użyciu narzędzi, wzorcach wykonywania kodu i wnioskowaniu na arkuszach — czyli dokładnie w tych obciążeniach, które często realizują agenci OpenClaw. Dla twórców agentów kombinacja lepszej niezawodności wykonawcy (linia Codex) + kompetencji planera + lepszego przetwarzania długiego kontekstu jest bardzo istotna.
OpenClaw wspiera GPT-5.4: co się zmieniło i dlaczego to ważne
Wydanie OpenClaw (patrz strona wydań projektu) aktualizuje rozwiązywanie modeli i runtime, aby były wstecznie zgodne z rozszerzonym kontekstem i limitami tokenów GPT-5.4 oraz dodaje możliwość „hot-swappable” pamięci, aby agenci mogli przełączać backendy pamięci lub modele w czasie działania. Osiągnięto to na trzy konkretne sposoby: 1) aktualizacje metadanych modeli i resolverów, aby zaakceptować większe okna kontekstu i limity tokenów; 2) zmiany runtime agenta, aby orkiestracja płynnych przełączeń modeli i rozgrzewanie cache było możliwe; 3) API pamięci umożliwiające wiele kanałów pamięci i wyzwalacze szybkiej wymiany.
Wsparcie wersji 2026.3.7 dla GPT-5.4 plus projekt hot-swappable pamięci zapewnia dwie praktyczne, komplementarne korzyści:
Prosta ścieżka aktualizacji modelu. OpenClaw może teraz prezentować GPT-5.4 jako wybieralny „runtime” dla agentów, pozwalając przełączyć się ze starszych modeli GPT-5.x lub alternatywnych dostawców bez przebudowy logiki agenta. Aktualizacja OpenClaw explicite deklaruje stabilną integrację GPT-5.4 w rdzeniu.
Wymiana pamięci na gorąco. Zamiast utrwalać pojedynczy liniowy snapshot pamięci, Silnik Kontekstu OpenClaw pozwala odłączać, wymieniać lub migrować partycje pamięci w czasie działania — np. podmienić shard wektorowej bazy o wysokiej pamięci (high-recall) do debugowania lub przełączyć na wariant pamięci zanonimizowanej zgodnie z GDPR dla zewnętrznych audytów — bez zatrzymywania agenta. To obniża ryzyko zakłóceń w produkcji i umożliwia konfiguracje pamięci specyficzne dla przypadku użycia (debugowanie vs prywatność vs wydajność).
Praktyczne przełomy wydajności i korzyści
Integracja OpenClaw koncentruje się na trzech praktycznych obszarach, w których GPT-5.4 błyszczy:
Wierność orkiestracji narzędzi. Ulepszone wewnętrzne wyszukiwanie narzędzi i wnioskowanie w GPT-5.4 redukuje „churn” wywołań narzędzi (mniej zbędnych wywołań i powtórzeń). Przekłada się to na mniejszą liczbę wywołań API i szybsze zakończenia dla złożonych przepływów. Wczesne raporty wskazują na poprawę efektywności tokenów i wywołań narzędzi względem starszych modeli GPT-5.x.
Dłuższe, bogatsze przetwarzanie kontekstu. Agenci OpenClaw mogą teraz utrzymywać znacznie większe aktywne konteksty (w tym podmieniane fragmenty pamięci), co pozwala zarządzać długimi rozmowami, projektami wieloplikowymi i iteracyjnym debugowaniem bez utraty stanu.
Bardziej deterministyczny kod wyjściowy. Dla przepływów, które automatycznie generują kod (hooki CI, szkielety funkcji, szablony infrastruktury), GPT-5.4 ma tendencję do produkowania bardziej spójnych i uruchamialnych wyników, redukując nakład przeglądu ludzkiego. Niezależne testy pokazują zauważalne poprawy w metrykach jakości kodu względem wcześniejszych modeli GPT-5.
Ciągłość pamięci — „wymiana pamięci na gorąco” pozwala wymieniać lub rozszerzać magazyny pamięci (lokalny cache, baza wektorowa, pamięć LLM) bez utraty stanu agenta lub kontekstu, umożliwiając testy A/B, wdrożenia kroczące i przełączenie awaryjne.
W teście benchmarkowym OOLONG nowa wersja OpenClaw, w połączeniu z wtyczką lossless-claw, osiągnęła wysoki wynik 74.8, zostawiając daleko w tyle Claude Code (70.3 punktu). W szczególności OpenClaw wykazał stabilność i dokładność wraz ze wzrostem długości kontekstu, co skłoniło inżynierów prowadzących testy na miejscu do okrzyku, że „to zbyt zachowawcze, by powiedzieć, że działa dobrze”.
Jak skonfigurować i używać GPT-5.4 w OpenClaw (krok po kroku)
Prosty przepływ pracy OpenClaw z użyciem GPT 5.4:
Przykładowa konfiguracja jest poniżej:
Użytkownicy wysyłają wiadomości przez platformy takie jak Discord lub Telegram.
OpenClaw odbiera wiadomości przez swój serwer bramkowy.
Bramą przekazywane są prompty do GPT 5.4 przez dostawcę API AI.
GPT 5.4 generuje odpowiedź lub wyzwala akcję narzędzia.
OpenClaw odsyła wynik końcowy do użytkownika.
Poniżej pragmatyczne, gotowe do wklejenia przykłady konfiguracji i przepływów, aby bezpiecznie i odtwarzalnie uruchomić GPT-5.4 w OpenClaw. Są one celowo zachowawcze: najpierw włącz model w agencie testowym i zainstrumentuj wszystko dla metryk i błędów.
Wymagania wstępne- OpenClaw zaktualizowany do wydania zawierającego mapowania GPT-5.4 (wspomniane w notatkach do wydania).
Ważny klucz API OpenAI z dostępem do GPT-5.4 (wybieram punkt końcowy CometAPI z niższą ceną).
1) Wybór modelu i konfiguracja resolvera (Json/ YAML / CLI)
Umieść to w ~/.openclaw/openclaw.json (lub scal ze swoją istniejącą konfiguracją). Dostosuj nazwę dostawcy i referencję tokena zgodnie z Twoim środowiskiem.
OpenClaw używa resolvera modeli do mapowania logicznych nazw modeli (np. openai/gpt-5.4) na punkty końcowe i konfigurację runtime. Dodaj lub zaktualizuj swój plik resolvera (przykład models.yml):
</> Bash
# Switch OpenClaw to use GPT-5.4 for the current agent session
openclaw model set openai/gpt-5.4
Uwaga: context_window i max
Uwagi
agents.defaults.model.primary wybiera domyślny model. Użyj channels.modelByChannel dla nadpisywań per kanał, aby kierować kanały o wysokim wpływie do GPT-5.4, a mniej wymagające do tańszych modeli. Zobacz dokumentację wyboru modelu OpenClaw w sprawie semantyki kolejności.
Odnieś się do strony modelu CometAPI po konkretne nazwy modeli. Jeśli chcesz używać OpenAI, zastąp URL i klucz API danymi OpenAI.
Klucze context_window i max_output_tokens odzwierciedlają zmiany pod kątem wstecznej zgodności w resolverze OpenClaw, tak aby agent nie próbował używać nieaktualnych limitów Codex.
2) Jak włączyć i przetestować „wymianę pamięci na gorąco”
Subsystem pamięci OpenClaw oparty jest na plikach (pliki Markdown) plus indeksatorach/wtyczkach wyszukiwania, dzięki czemu można bezpiecznie wymieniać wtyczki backendów (np. SQLite vector, Milvus lub zewnętrzne usługi pamięci) bez utraty surowych plików pamięci.
Typowy wzorzec:
Ustandaryzuj lokalizację pamięci: użyj workspace wspieranego przez git: ~/.openclaw/workspace/, gdzie MEMORY.md i memory/YYYY-MM-DD.md są autorytatywne.
Zainstaluj i skonfiguruj wtyczkę pamięci (przykład: sqlite-vec) i wskaż na nią plugins.slots.memory w konfiguracji.
Przetestuj migrację: dodaj nową wtyczkę, uruchom cieniowane indeksowanie (shadow indexing), porównaj wyniki pobierania, a następnie przełącz alias plugins.slots.memory na nową wtyczkę, gdy będziesz usatysfakcjonowany.
# install new plugin (example package)pip install openclaw-memory-sqlite-vec# update config safely (backup first)cp ~/.openclaw/openclaw.json ~/.openclaw/openclaw.json.bak# then edit JSON: plugins.slots.memory = "memory-sqlite-vec"# reload gateway (safe restart)systemctl restart openclaw || openclaw gateway restart# run a retrieval consistency check using the test harnessopenclaw test memory_consistency --samples 100
Dlaczego to jest „hot-swappable”: pliki pamięci pozostają źródłem prawdy. Wtyczki implementują warstwy indeksowania i pobierania; ich wymiana powoduje reindeksowanie, ale nie zmienia bazowych plików .md. Pozwala to na wymiany modeli bez katastrofalnego dryfu tożsamości — agent nadal czyta te same PAMIĘCI.
3) Przykład: przypięcie pojedynczego agenta do GPT-5.4 (nadpisanie per agent)
Możesz nadpisać model per agent; dodaj wpis agenta jak poniżej:
Żądania przekraczające standardowe okna kontekstu mogą być rozliczane według różnych stawek użycia (dokumenty OpenAI wspominają o podwójnym rozliczaniu żądań wykraczających poza standardowe okna w wersji zapoznawczej Codex).
Praktyki najlepsze: maksymalne wykorzystanie mocnych stron GPT-5.4 w OpenClaw
Koszt, opóźnienie i miks modeli
Strategia hybrydowa modeli: używaj mniejszego, tańszego modelu do krótkich zapytań i przetwarzania strumieniowego; wymieniaj na gorąco na GPT-5.4 dla ciężkich analiz, podsumowań, generowania kodu wymagającego długiego kontekstu. To redukuje ogólny koszt tokenów przy zachowaniu jakości. (Zaimplementuj przez wyzwalacze w konfiguracji pamięci powyżej.)
Kompakcja tokenów i wzbogacanie przez wyszukiwanie: używaj potoków wspomaganych pobieraniem (RAG), by ograniczyć liczbę tokenów wysyłanych do modelu — przechowuj długie dokumenty w bazie wektorowej, pobieraj relewantne segmenty i dołączaj tylko najbardziej istotne fragmenty oraz zwięzły plan. Wyszukiwanie narzędzi w GPT-5.4 pomaga poprzez automatyczne lokalizowanie przydatnych narzędzi lub dokumentów.
Rozgrzewanie i zimny start: po wymianie modelu rozgrzej model krótkim uruchomieniem z kontekstem, aby uniknąć skoków opóźnienia przy pierwszym żądaniu. Prekompiluj szablony promptów i odtwórz krytyczne kanały pamięci. Strategia krocząca OpenClaw (zob. konfiguracja) wspiera wstępne rozgrzewanie.
Niezawodność i bezpieczeństwo
Łagodne awaryjne przełączanie: zaimplementuj time-outy i plany awaryjne (np. degradację do zbuforowanej odpowiedzi z poprzedniej sesji), aby obsłużyć limity szybkości API lub błędy kwoty.
Warstwy bezpieczeństwa: utrzymuj filtry polityk i krok weryfikacji, gdy wyniki wpływają na decyzje. GPT-5.4 statystycznie redukuje halucynacje, ale weryfikacja pozostaje ważna w zadaniach wysokiego ryzyka.
Ewaluacja i monitorowanie
Odtwarzaj własne benchmarki: uruchamiaj testy head‑to‑head dla swoich obciążeń (uzupełnianie kodu, refaktoryzacja wieloplikowa, analiza arkuszy) przy użyciu standardowego rubryka. Publiczne raporty wskazują mocne strony w arkuszach i zadaniach produktywności — zweryfikuj na swoich danych.
Telemetria: monitoruj zużycie tokenów, opóźnienia modelu, częstotliwość wymiany pamięci i jakość odpowiedzi (oceny ludzkie/testy automatyczne). Użyj telemetrii, by dopracować progi wymiany.
Przykład : Agent przeglądu kodu wymieniający na gorąco
Cel: Uruchomić rutynowe lint + podsumowanie testów jednostkowych przy pushu (tani model) i eskalować do GPT-5.4 po to, by zaproponować refaktoryzacje wieloplikowe, gdy testy zawodzą lub diff przekracza 10 plików.
Przepływ (wysoki poziom):
Wyzwalacz pre-commit uruchamia local/fast-small-coder do wygenerowania podsumowania lintu.
Jeśli test_failures > 0 lub diff_files > 10, wyzwól hot_swap do openai/gpt-5.4. Promuj longterm_vector zawierający historię repo.
Uruchom prompt GPT-5.4 z całymi nieudanymi stack trace’ami + relewantnymi plikami kodu wprowadzonymi do kontekstu. Wygeneruj łatę refaktoryzującą i zmiany w testach jednostkowych.
Szkielet promptu (wysyłany do GPT-5.4 po pobraniu i kompakcji):
You are a senior reviewer. The repository has 12 changed files. Tests failed with stack traces below. Relevant files (retrieved): <file snippets>. Provide:1) concise summary of root cause (3 bullets),2) a minimal patch (diff) to fix,3) test changes needed,4) risk assessment and roll-back plan.
Ten przypadek użycia podkreśla, dlaczego duży kontekst + wymiana pamięci na gorąco są wartościowe: możesz jednocześnie wprowadzić pełne stack trace’y i wiele plików do modelu. Implementuj wyzwalacze przełączania zachowawczo, aby kontrolować koszty.
Na koniec: kto i kiedy powinien adoptować GPT-5.4 w OpenClaw
Adoptuj teraz, jeśli Twoi agenci wykonują wieloetapowe zadania kod/narzędzia, ciężką automatyzację arkuszy lub złożoną edycję dokumentów, gdzie cykle iteracyjnego pisania-uruchamiania-inspekcji dominują w czasie dewelopera. Zyski produktywności i niezawodności są tu najbardziej widoczne.
Adoptuj ostrożnie, jeśli działasz w kosztowo wrażliwych, wysokowolumenowych kanałach czatu, gdzie wystarcza prostsze wnioskowanie; użyj routingu, aby zachować efektywność kosztową.
Nie zakładaj dominacji jednego modelu: benchmarkuj na swoich danych. GPT-5.4 to silny kandydat do obciążeń agentowych, ale wybór modelu musi być oparty na dowodach.
Deweloperzy mogą uzyskać dostęp do GPT-5.4 przez CometAPI już teraz. Aby zacząć, poznaj możliwości modelu w Playground i skonsultuj przewodnik integracji Openclaw po szczegółowe instrukcje. Przed uzyskaniem dostępu upewnij się, że zalogowano się do CometAPI i pozyskano klucz API. CometAPI oferuje cenę znacznie niższą niż oficjalna, by pomóc w integracji.