TL;DR
MiMo-V2.6 to nowa, otwarto‑wagowa, natywna multimodalna, zorientowana na agentów rodzina modeli wnioskowania firmy Xiaomi. MiMo-V2.6-Pro wykorzystuje rzadką architekturę MoE z łączną liczbą 1.02 biliona parametrów i około 42 miliardami aktywowanych parametrów na token, podczas gdy MiMo-V2.6-Flash ma łączną liczbę 309 miliardów parametrów i około 15 miliardów aktywowanych. Oba modele obsługują okno kontekstu 1M tokenów oraz multimodalne wejścia, w tym tekst, obrazy, wideo i audio.
Key Takeaways
- MiMo-V2.6-Pro to rzadki model MoE z 1.02T parametrów i ok. 42B parametrów aktywowanych na token; Flash ma 309B łącznie i ok. 15B aktywowanych parametrów.
- Oba modele obsługują okno kontekstu 1M tokenów, wejścia multimodalne oraz do 128K tokenów wyjściowych przez API Xiaomi.
- Rodzina jest zaprojektowana pod kątem wnioskowania, użycia narzędzi, wyszukiwania w sieci, ustrukturyzowanego wyjścia i długohoryzontowych przepływów pracy agentów.
- Xiaomi szkoliło V2.6 mieszanym RL obejmującym kodowanie, ogólne agentów, zadania wizualne i środowiska cyberbezpieczeństwa.
- Oficjalne wyniki pozycjonują Pro jako opcję o wyższych możliwościach, a Flash jako tańszą, wysokowolumenową opcję; nadal konieczna jest ocena specyficzna dla obciążenia.
What Is Xiaomi MiMo-V2.6?
MiMo-V2.6 to najnowsza generacja rodziny modeli MiMo firmy Xiaomi. Jej nacisk nie polega jedynie na generowaniu lepszych odpowiedzi, ale na wykonywaniu długich sekwencji działań: inspekcja środowiska, wywoływanie narzędzi, obserwowanie wyników, korygowanie błędów i kontynuowanie aż do osiągnięcia celu. Xiaomi osadza wydanie w kontekście Recursive Self-Improvement (RSI), czyli pętli treningowej RL, w której model wielokrotnie eksploruje środowiska, otrzymuje bogatsze sygnały nagrody, porównuje trajektorie i uczy się skuteczniejszych strategii. Nie należy tego interpretować jako modelu autonomicznie przepisującego i trenującego własnego następcę.
Pro vs Flash vs UltraSpeed: Jaka jest różnica
| Funkcja | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Pozycjonowanie | Flagship reasoning | High-volume / value | Low-latency flagship |
| Łączna liczba parametrów | 1.02T | 309B | Ten sam model Pro |
| Aktywne parametry | 42B | 15B | Ta sama zdolność Pro |
| Architektura | Sparse MoE | Sparse MoE | Tryb serwowania Pro |
| Kontekst | 1M | 1M | 1M |
| Maksymalne wyjście | 128K | 128K | 128K |
| Wejście: tekst/obraz/wideo/audio | Tak | Tak | Tak |
| Głębokie rozumowanie/wywołanie narz. | Tak | Tak | Tak |
| Ustrukturyzowane wyjście/kesz kontekstu | Tak | Tak | Tak |
| Główna zaleta | Maksymalne możliwości | Efektywność kosztowa | Do 20x szybsze serwowanie |
MiMo-V2.6-Pro czy Flash: którego użyć?
Praktyczny wybór: wybierz MiMo-V2.6-Pro do trudnych, długohoryzontowych zadań inżynieryjnych, badań, cyberbezpieczeństwa i wysokocennej pracy agentów; wybierz MiMo-V2.6-Flash do wysokowolumenowej automatyzacji, przetwarzania dokumentów i multimodaliów oraz kosztoczułych, powtarzalnych wywołań; wybierz MiMo-V2.6-Pro-UltraSpeed gdy potrzebne jest rozumowanie na poziomie Pro, ale to opóźnienie dominuje. UltraSpeed to warstwa serwowania, a nie inny model możliwości, i jest reklamowana jako do 20× szybsza pod względem prędkości wyjścia niż standardowy Pro.
How Does Xiaomi MiMo-V2.6 Work?
Architektura Sparse Mixture-of-Experts
MiMo-V2.6 nie aktywuje całego zestawu parametrów dla każdego tokena. Flagowy checkpoint Pro zawiera 1.02 trillion total parameters, ale na token aktywnych jest tylko około 42 miliardów. Karta modelu Xiaomi opisuje 70 warstw Transformera, 384 routowanych ekspertów i osiem ekspertów aktywowanych jednocześnie. Flash jest znacząco mniejszy: 309B łącznie / 15B aktywnych, z 48 warstwami Transformera i 256 routowanymi ekspertami.
| Specyfikacja architektury | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Łączna liczba parametrów | 1.02T | 309B |
| Aktywowane parametry | 42B | 15B |
| Warstwy Transformera | 70 | 48 |
| Rozmiar ukryty | 6,144 | 4,096 |
| Routowani eksperci | 384 | 256 |
| Aktywowani eksperci | 8 | 8 |
| Maksymalny kontekst | 1M | 1M |
| MiMo ViT | 681M parametrów | 681M parametrów |
| AudioTokenizer | 308M parametrów | 308M parametrów |
| Enkoder łatek audio | 127M parametrów | 127M parametrów |
| Dekoder spekulatywny | 5 warstw | 5 warstw |
Architektura łączy uwagę przesuwnego okna z warstwami globalnej uwagi i obejmuje pięciowarstwowy spekulatywny dekoder z przewidywaniem wielu tokenów. Praktyczną implikacją jest to, że nagłówkowa liczba parametrów i obliczenia na token są bardzo różnymi wielkościami: rzadkie trasowanie pozwala Xiaomi utrzymywać dułą pulę ekspertów bez wykonywania gęstej inferencji na wszystkich wagach dla każdego tokena.
Natywne multimodalne rozumienie
MiMo-V2.6 korzysta z 681‑milionowego MiMo ViT do kodowania wizualnego wraz z dedykowanymi komponentami audio. Daje to temu samemu agentowi możliwość przetwarzania instrukcji tekstowych, zrzutów ekranu, fotografii, wideo i audio. Dla agentów do obsługi komputera natywna multimodalność ma znaczenie, ponieważ percepcja i podejmowanie decyzji mogą zachodzić w tej samej pętli rozumowania, zamiast być rozdzielone na oddzielne, użytkownikocentryczne modele.
Why Is Reinforcement Learning So Important to MiMo-V2.6?
Xiaomi informuje, że zarówno Flash, jak i Pro przeszły około 30 RL steps and around 750,000 trajectories w sześciodniowym publicznym eksperymencie treningowym. Zgłoszone koszty treningu wyniosły około 850 000 USD dla Flash i 2,62 miliona USD dla Pro. Każda aktualizacja używała 1 568 próbek treningowych, a pojedyncze kroki treningowe sięgały około 3,5–3,7 miliarda tokenów. Mieszanka zadań obejmowała kod, ogólnych agentów, zadania wizualne, cyberbezpieczeństwo oraz wiele ram agentowych.
Podczas tego procesu RL Xiaomi raportuje, że wynik out‑of‑sample DeepSWE v1.1 wzrósł z 48,8 do 65,7 dla Flash i z 58,4 do 72,6 dla Pro. Liczby te opisują na żywo eksperyment RL i nie należy ich mylić z każdą końcową oceną benchmarkową dla wydanych checkpointów, ponieważ ustawienia ewaluacji mogą się różnić.
Grupowe ocenianie agentowe
Dla treningu agentów binarna nagroda typu pass/fail może ukrywać znaczące różnice między dwiema udanymi trajektoriami. Jedno rozwiązanie może kończyć szybko z kilkoma wywołaniami narzędzi, podczas gdy inne może marnować dziesiątki kroków. Xiaomi opisuje więc Groupwise Reward Synthesis and Groupwise Advantage Redistribution jako mechanizmy porównywania trajektorii w grupie i redystrybucji sygnału uczącego w kierunku czystszych rozwiązań. Celem jest poprawa nie tylko ukończenia zadania, ale także efektywności przebytej ścieżki.
How Good Is Xiaomi MiMo-V2.6 on Agent Benchmarks?
Najsilniejsze publiczne dowody dla V2.6 koncentrują się na benchmarkach agentowych, a nie na konwencjonalnych testach wielokrotnego wyboru. Oficjalny wykres Xiaomi porównuje Pro i Flash z MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol i Fable 5 w zadaniach kodowania, ogólnego działania agentów, cyberbezpieczeństwa i agentów wizualnych.
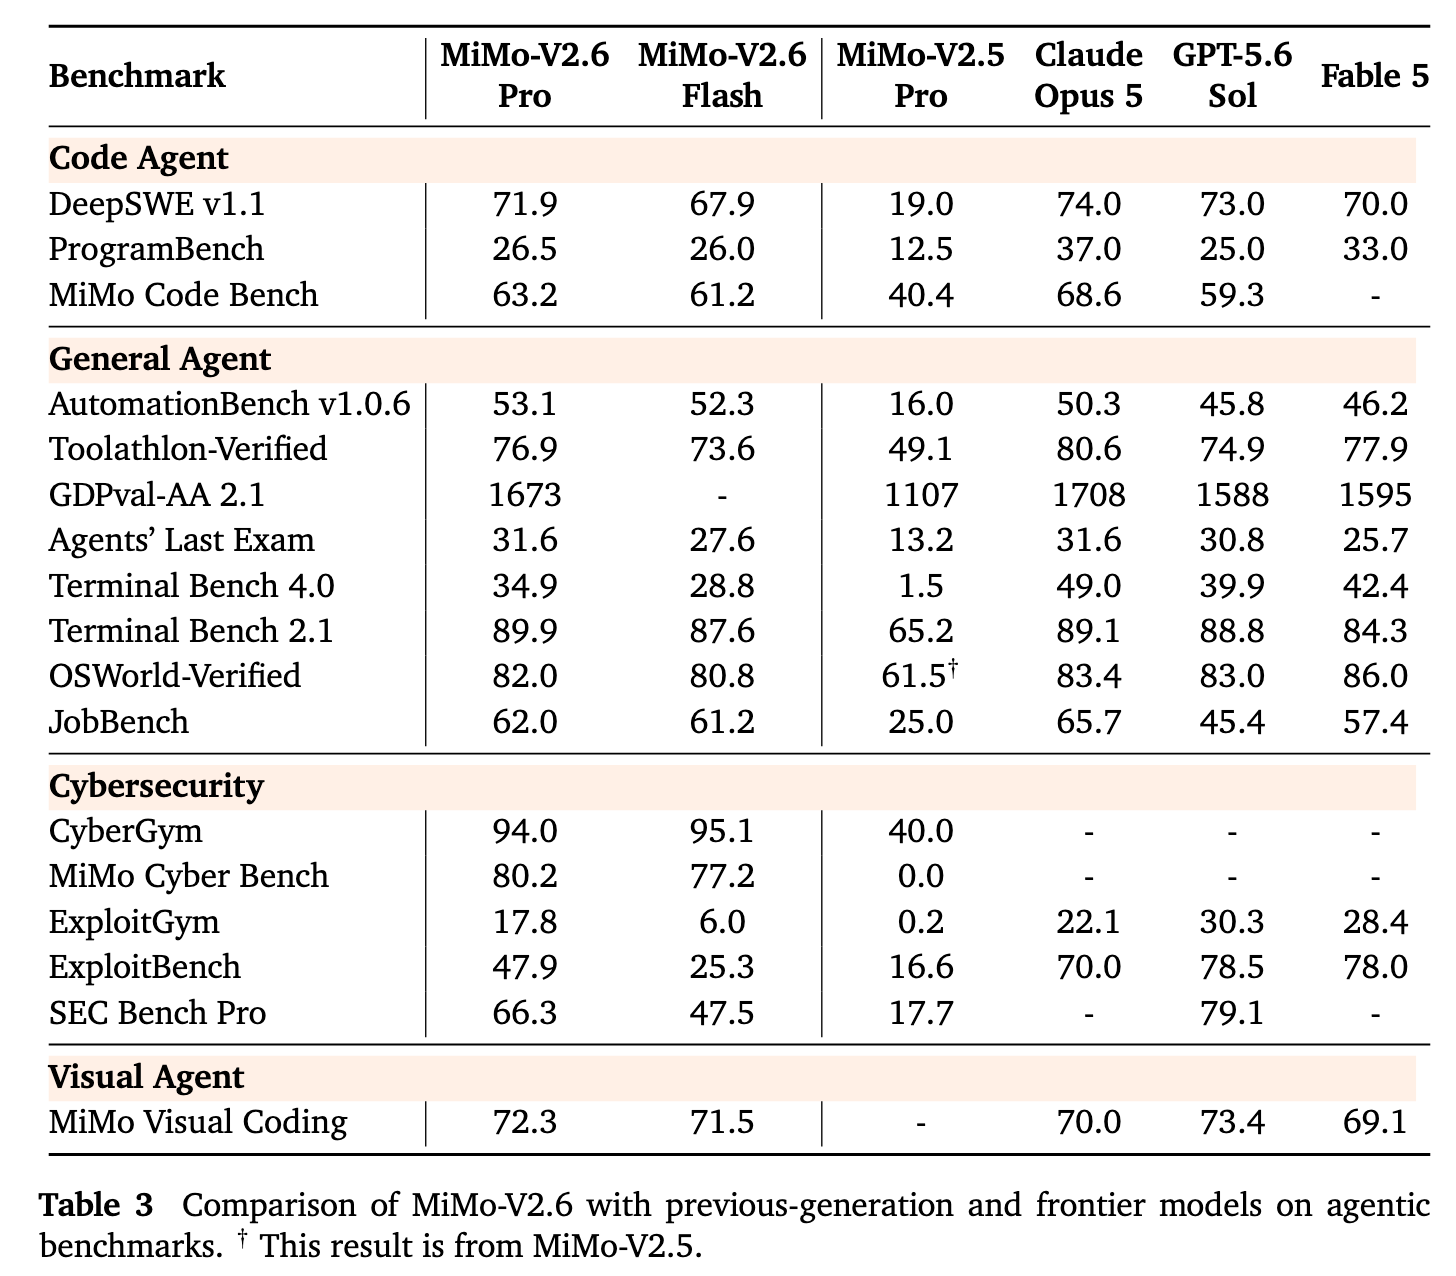
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Postępy w kodowaniu
Zyski w kodowaniu są najczytelniejsze w długohoryzontowej egzekucji. Podczas na żywo prowadzonego RL Xiaomi raportuje, że out‑of‑sample DeepSWE v1.1 poprawił się z 48,8 do 65,7 dla Flash i z 58,4 do 72,6 dla Pro. W opublikowanej tabeli porównań Pro osiąga 71,9 na DeepSWE v1.1 i 63,2 na MiMo Code Bench, podczas gdy Flash odpowiednio 67,9 i 61,2. Pro nie wygrywa każdego testu kodowania — Claude Opus 5 pozostaje przed nim na DeepSWE, ProgramBench i MiMo Code Bench — ale V2.6 łączy konkurencyjną wydajność w skali repozytoriów z otwartymi wagami i znacząco niższymi cenami API.
Postępy w rozumowaniu i działaniu agentowym
Postęp w rozumowaniu lepiej rozumieć jako poprawę planowania, użycia narzędzi i odzyskiwania po błędach niż jako pojedynczy abstrakcyjny wynik inteligencji. Pro notuje 89,9 na Terminal Bench 2.1, 53,1 na AutomationBench i 76,9 na Toolathlon-Verified; Flash odpowiednio 87,6, 52,3 i 73,6. Pro nieznacznie przewyższa wymienione wyniki Claude Opus 5 i GPT-5.6 Sol na Terminal Bench 2.1, podczas gdy oba modele V2.6 prowadzą nad tymi porównaniami na AutomationBench. Xiaomi przypisuje poprawę grupowemu porównywaniu trajektorii, bogatszym oceniaczom, treningowi w wielu ramach i sygnałom nagrody faworyzującym krótsze, czystsze ścieżki rozwiązań.
Postępy w wiedzy i badaniach
Postęp w obszarach intensywnie wiedzochłonnych jest bardziej wspierany przez ewaluacje agentowe i demonstracje niż przez konwencjonalny zestaw egzaminów wiedzy. Pro dorównuje Claude Opus 5 wynikiem 31,6 na Agents' Last Exam i osiąga 62,0 na JobBench. Xiaomi raportuje również przepływy pracy badawcze z materiałoznawstwa obejmujące przeszukiwanie literatury i patentów, generowanie hipotez i obliczeniowe wywołania narzędzi, a także projekt formalizacji w Lean 4 przekraczający 6 000 zweryfikowanych linii. Przykłady te sugerują silniejsze wyszukiwanie, syntezę, formalne rozumowanie i pracę z wiedzą opartą na narzędziach, ale nie należy ich traktować jako niezależnego dowodu uniwersalnej przewagi wiedzy.
Ogólnie: postęp V2.6 jest szeroki, ale nierówny. Najsilniejszy jako dowód poprawy długohoryzontowego kodowania i egzekucji agentów, natomiast roszczenia dotyczące ogólnego rozumowania i wiedzy powinny pozostać powiązane z konkretnym benchmarkiem, ramą i demonstracją.
Uwaga dot. benchmarków: O ile nie zaznaczono inaczej, poniższe wyniki krzyżowe między modelami są raportowane przez Xiaomi w karcie modelu MiMo-V2.6. Wyniki mogą zależeć od wersji benchmarków, ram agentowych, konfiguracji narzędzi, budżetów inferencji i protokołów ewaluacji, więc nie należy ich interpretować jako niezależnie odtworzonego rankingu.
MiMo-V2.6 vs MiMo-V2.5: co się zmieniło?
| Wymiar | Generacja MiMo-V2.5 | Przełom MiMo-V2.6 |
|---|---|---|
| Skupienie treningu | Silne multimodalne agenty, długi kontekst i efektywność tokenów | Znacznie większy mieszany program RL w obszarach kodu, ogólnych agentów, wizji, cyberbezpieczeństwa i wielu ram |
| Zdolności agentów | V2.5-Pro celował w trudną pracę długohoryzontową | Xiaomi informuje, że V2.6-Flash kompleksowo przewyższa V2.5-Pro w jego zestawie benchmarków agentów |
| Efektywność nauki | Poprzedni checkpoint produkcyjny | Około 750 000 trajektorii w 30 krokach RL; zyski na wydzielonym DeepSWE rzędu ~17 pkt dla Flash i ~14 pkt dla Pro podczas treningu |
| Otwartość | Otwarte wagi i wsparcie ekosystemu | Dodaje pełny kod RL, 7 000+ środowisk zadań, ramę treningową, lekkie ramy i checkpoint destylacji 9B |
| Ekonomia | Istniejący poziom cen API V2.5 | Wyższa zgłaszana inteligencja przy tych samych oficjalnych cenach API, przesuwając granicę możliwości‑kosztów |
Kodowanie i egzekucja agentów
Względem V2.5 najjaśniejszą zmianą jest silniejsza polityka agentów, a nie dłuższe okno kontekstu. Xiaomi informuje, że V2.6-Flash przewyższa V2.5-Pro w jego zestawie benchmarków agentów. Podczas treningu V2.6 wyniki na wydzielonym DeepSWE v1.1 poprawiły się z 48,8 do 65,7 dla Flash i z 58,4 do 72,6 dla Pro; te wyniki z przebiegu treningowego nie są bezpośrednio wymienne z powyższą tabelą benchmarków wydanych modeli.
Rozumowanie, wiedza i szerokość treningu
V2.6 rozszerza uczenie ze wzmocnieniem na kodowanie, ogólnych agentów, wizję, cyberbezpieczeństwo i wiele ram. Xiaomi raportuje około 750 000 trajektorii w ~30 krokach RL. Wspiera to szersze planowanie, użycie narzędzi i odzyskiwanie, ale samo w sobie nie ustanawia uniwersalnego zysku na każdym benchmarku wiedzy czy rozumowania; porównuj dopasowane zadania i ustawienia ewaluacji.
Migracja i otwartość
Wydanie dodaje też kod RL, ponad 7 000 środowisk zadań, infrastrukturę treningową i checkpoint destylacji 9B. Okno kontekstu 1M i wejścia multimodalne są kontynuacją z V2.5, a nie nowymi przełomami V2.6.
Praktyczna zmiana to więc nie nowe obrzeża kontekstu — 1M kontekstu i pełna multimodalność już istniały w V2.5 — lecz silniejsza polityka agenta, trenowana przy znacznie większym nakładzie RL i szerszych, weryfikowalnych środowiskach. Xiaomi zapowiedziało, że nazwy modeli V2.5 i V2.5-Pro przestaną działać 21 października 2026 r., więc nowe wdrożenia powinny celować w V2.6, a istniejące planować testy migracji.
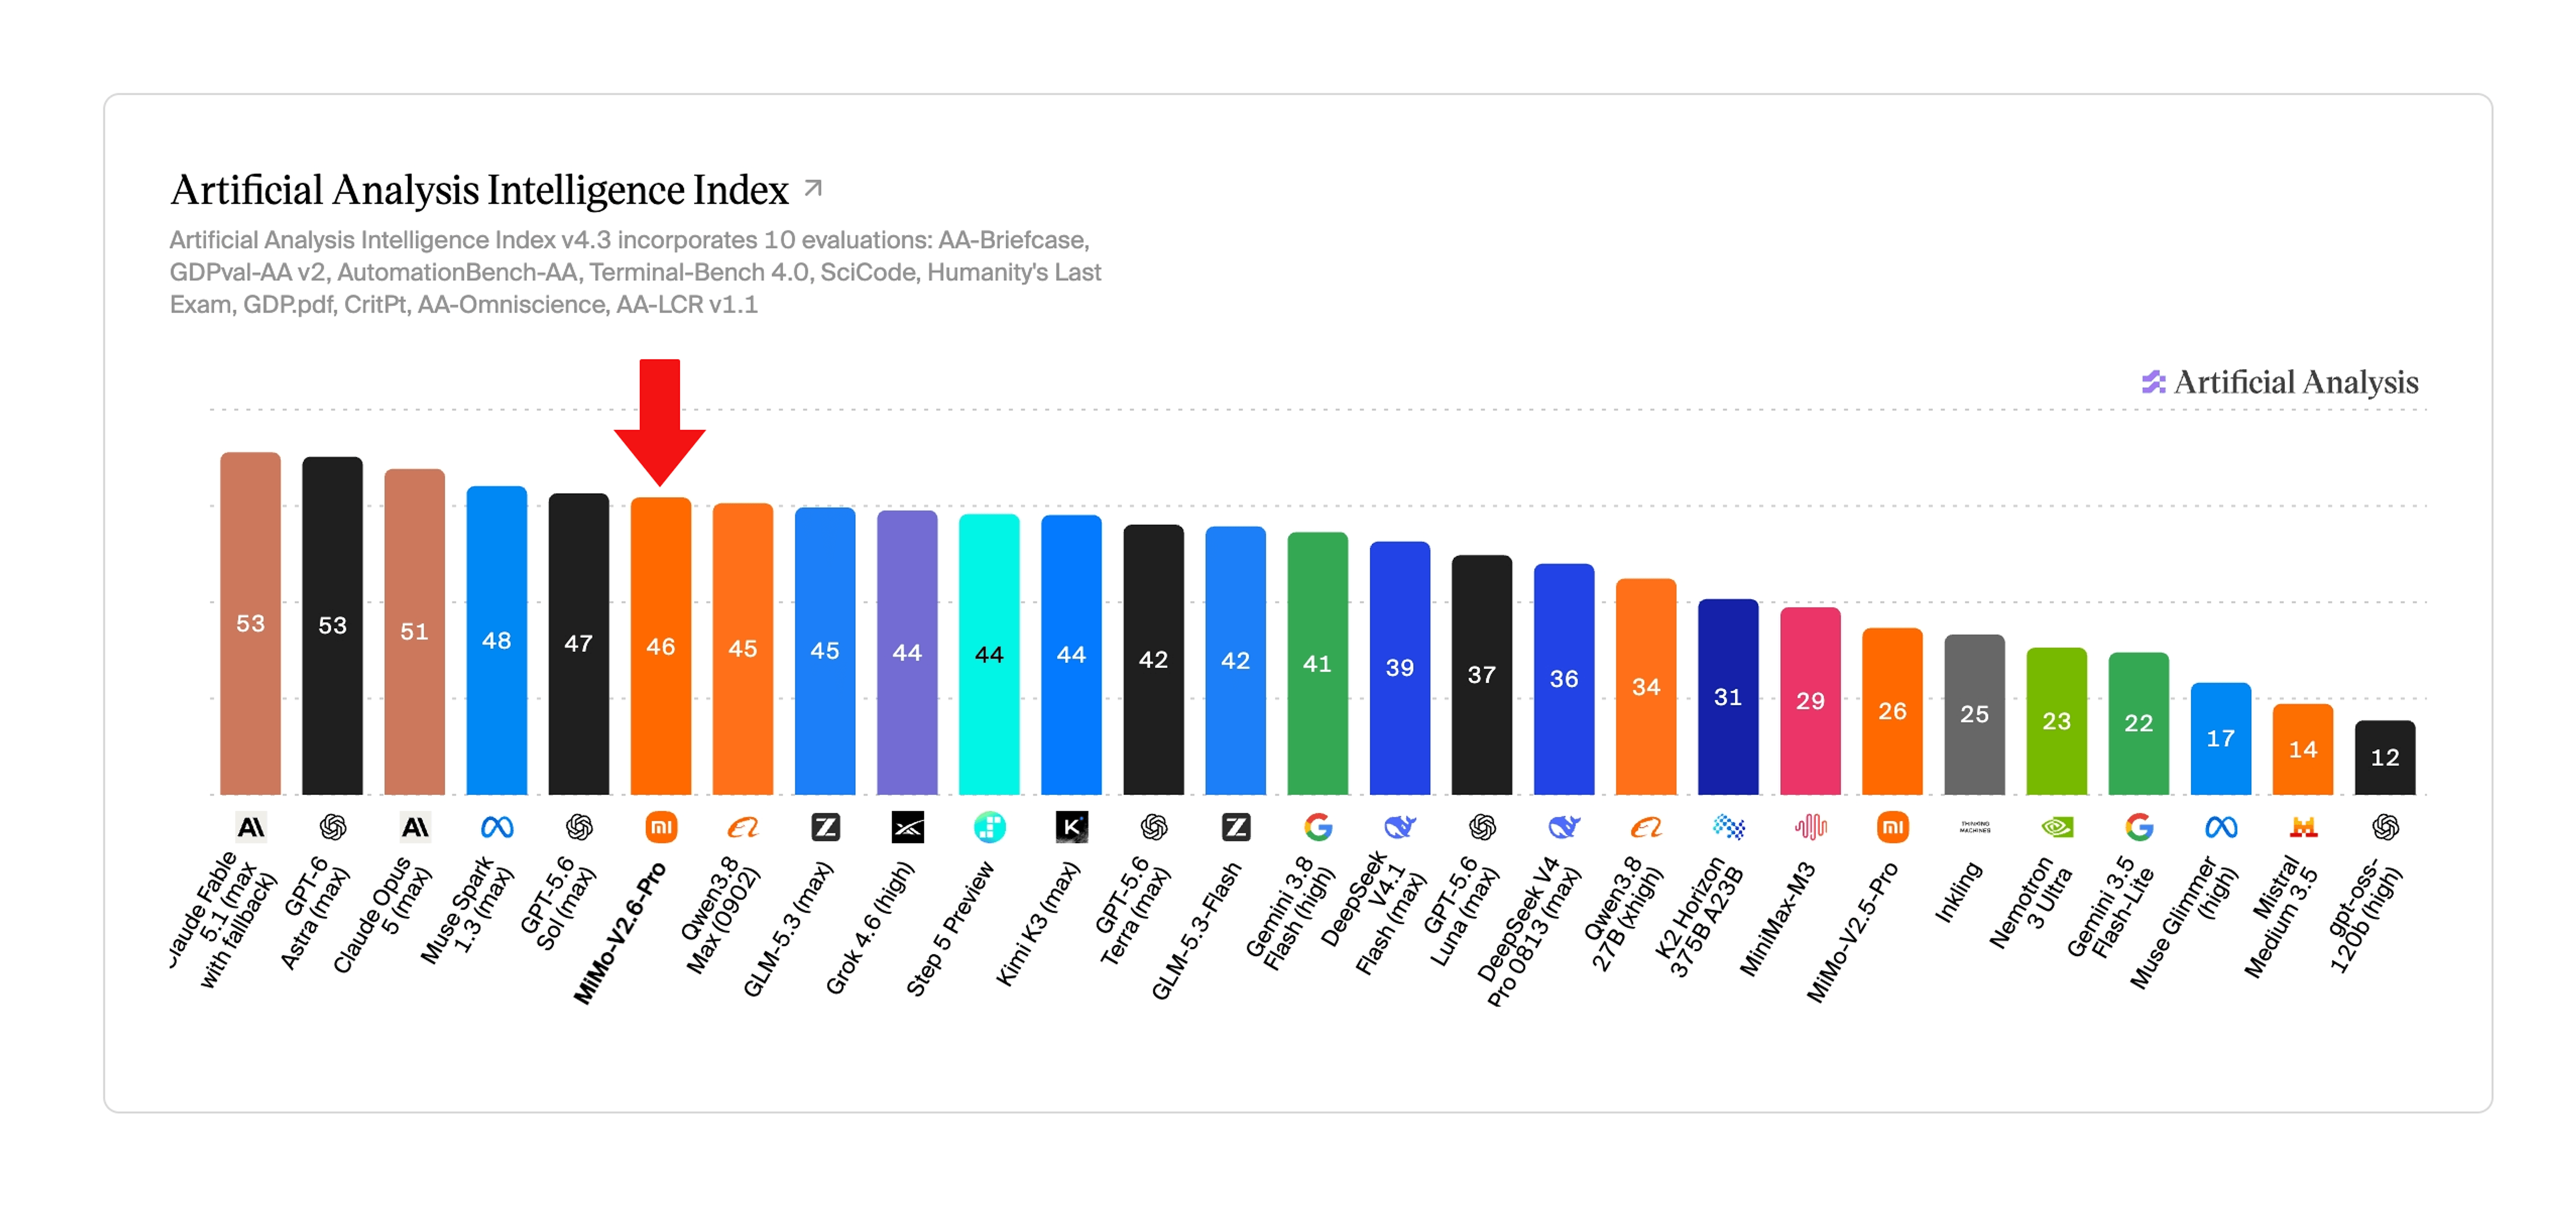
Jak V2.6 porównuje się z innymi modelami czołowymi
| Wymiar | MiMo-V2.6-Pro | Modele czołowe zamknięte | Inne modele z otwartymi wagami |
|---|---|---|---|
| Wagi | Otwarte wagi | Zazwyczaj zamknięte | Zależne od modelu |
| Zweryfikowany kontekst MiMo | 1M tokenów | Sprawdź stronę oficjalną każdego modelu | Sprawdź kartę modelu |
| Zweryfikowane modalności MiMo | Tekst, obraz, wideo, audio | Zależne od dostawcy | Zależne od modelu |
| RL zorientowany na agentów | Silny nacisk w wydaniu | Zależne od modelu i systemu | Zależne od modelu i checkpointu |
| Samohostowanie | Tak, z istotną infrastrukturą | Zwykle nie | Często możliwe dla otwartych checkpointów |
| Główna przewaga MiMo | Otwarte wagi, natywna multimodalność, niskie koszty API | Ekosystem dostawcy i zarządzane narzędzia | Zależne od licencji, rozmiaru i stosu wdrożeniowego |
Dla aktualnego zestawu porównań oceń MiMo-V2.6 względem Claude Opus 5.5 dla długotrwałego agentowego kodowania, Claude Fable 5.1 dla najtrudniejszej pracy autonomicznej, GPT-6 Sol oraz Gemini 4 Pro. Dostępność modeli i ceny są dynamiczne, więc porównania produkcyjne powinny używać żywego katalogu oraz dopasowanych promptów, narzędzi, budżetów wysiłku i kryteriów akceptacji.
What Can Xiaomi MiMo-V2.6 Actually Do?
Agenci do kodowania i inżynierii oprogramowania
MiMo-V2.6 jest zaprojektowany do długich trajektorii inżynierii oprogramowania: inspekcja repozytoriów, modyfikowanie kodu, używanie narzędzi terminalowych, uruchamianie testów, diagnozowanie błędów i kontynuowanie aż do spełnienia celu. Wyniki w DeepSWE, Terminal Bench, AutomationBench i Toolathlon wskazują, że Xiaomi optymalizuje pod egzekucję, a nie tylko autouzupełnianie kodu. Praktyczne obciążenia obejmują agentów kodujących, automatyczne debugowanie, refaktoryzację repozytoriów, rozwiązywanie problemów CI i wielonarzędziowe przepływy pracy inżynierskiej.
Użycie komputera
Xiaomi explicite demonstruje Computer Use Agent (CUA). Model potrafi interpretować interfejsy graficzne, pobierać informacje, edytować treści, przetwarzać dane, inspekcjonować wyniki, diagnozować problemy i zmieniać kolejne działania na podstawie informacji wizualnej. W tym przepływie pracy wynik modelu często nie jest produktem końcowym; może zamiast tego determinuje kolejną akcję w oprogramowaniu lub przeglądarce.
Światy 3D i przepływy pracy w Blenderze
W koncepcji "Vibe World" MiMo-V2.6 potrafi przyjmować odniesienia tekstowe, obrazowe lub wideo i rozbijać żądanie 3D na konstrukcję sceny, programowanie interakcji i zadania weryfikacji wizualnej. Xiaomi demonstruje także sterowanie Blenderem przez model w celu tworzenia obiektów i scen 3D na podstawie opisów lub obrazów referencyjnych. Rozszerza to vibe coding poza kod aplikacji do środowisk interaktywnych.
Robotyka i agenci ucieleśnieni
Xiaomi demonstruje MiMo-V2.6 w ucieleśnionym środowisku symulacyjnym, używając obrazów z kamer wielowidokowych i ramienia robotycznego Franka Panda. Przykładowe zadania obejmują chwytanie obiektów, dopasowywanie kolorów i precyzyjne pozycjonowanie. Nie ustanawia to V2.6 jako uniwersalnego modelu fundamentowego dla robotyki, ale pokazuje, jak natywna wizja i długohoryzontowe podejmowanie decyzji mogą być połączone z pętlami sterowania ucieleśnionego.
Badania naukowe i rozumowanie formalne
Xiaomi raportuje przypadek nauk o materiałach, w którym MiMo-V2.6-Pro wspierał badaczy pracujących nad metal‑organic frameworks dla adsorpcji PFAS, obejmujący przeszukiwanie literatury i patentów, formułowanie kandydatów i wywołania narzędzi obliczeniowych. W innym eksperymencie model pomógł sformalizować główny dowód z "Period Three Implies Chaos" w Lean 4. Xiaomi informuje o ukończonym projekcie przekraczającym 6 000 linii kodu Lean, zweryfikowanych przez kernel Lean bez nieudowodnionych placeholderów. Te przykłady najlepiej interpretować jako demonstracje agentowych przepływów pracy badawczej, a nie dowód autonomicznego odkrywania naukowego.
Strony WWW, prezentacje, wideo i muzyka
MiMo-V2.6 potrafi koordynować front‑end, przepływy projektowe, slajdy, zasoby SVG, pipeline’y wideo i narzędzia produkcji muzyki. Xiaomi demonstruje orkiestrację ze specjalistycznymi systemami medialnymi, w tym narrację poprzez MiMo-V2.5-TTS, zamiast twierdzić, że samo V2.6 zastępuje każdy generator obrazu, wideo czy audio. Model naturalnie wpisuje się więc jako orkiestrator produkcji kreatywnej.
Przypadki użycia w tej sekcji to demonstracje Xiaomi, a nie niezależne dowody, że każde wdrożenie odtworzy te same wyniki. Zespoły produkcyjne powinny testować model z własnymi narzędziami, uprawnieniami, mechanizmami odzyskiwania po błędach i kryteriami ewaluacji.
How Much Does Xiaomi MiMo-V2.6 Cost?
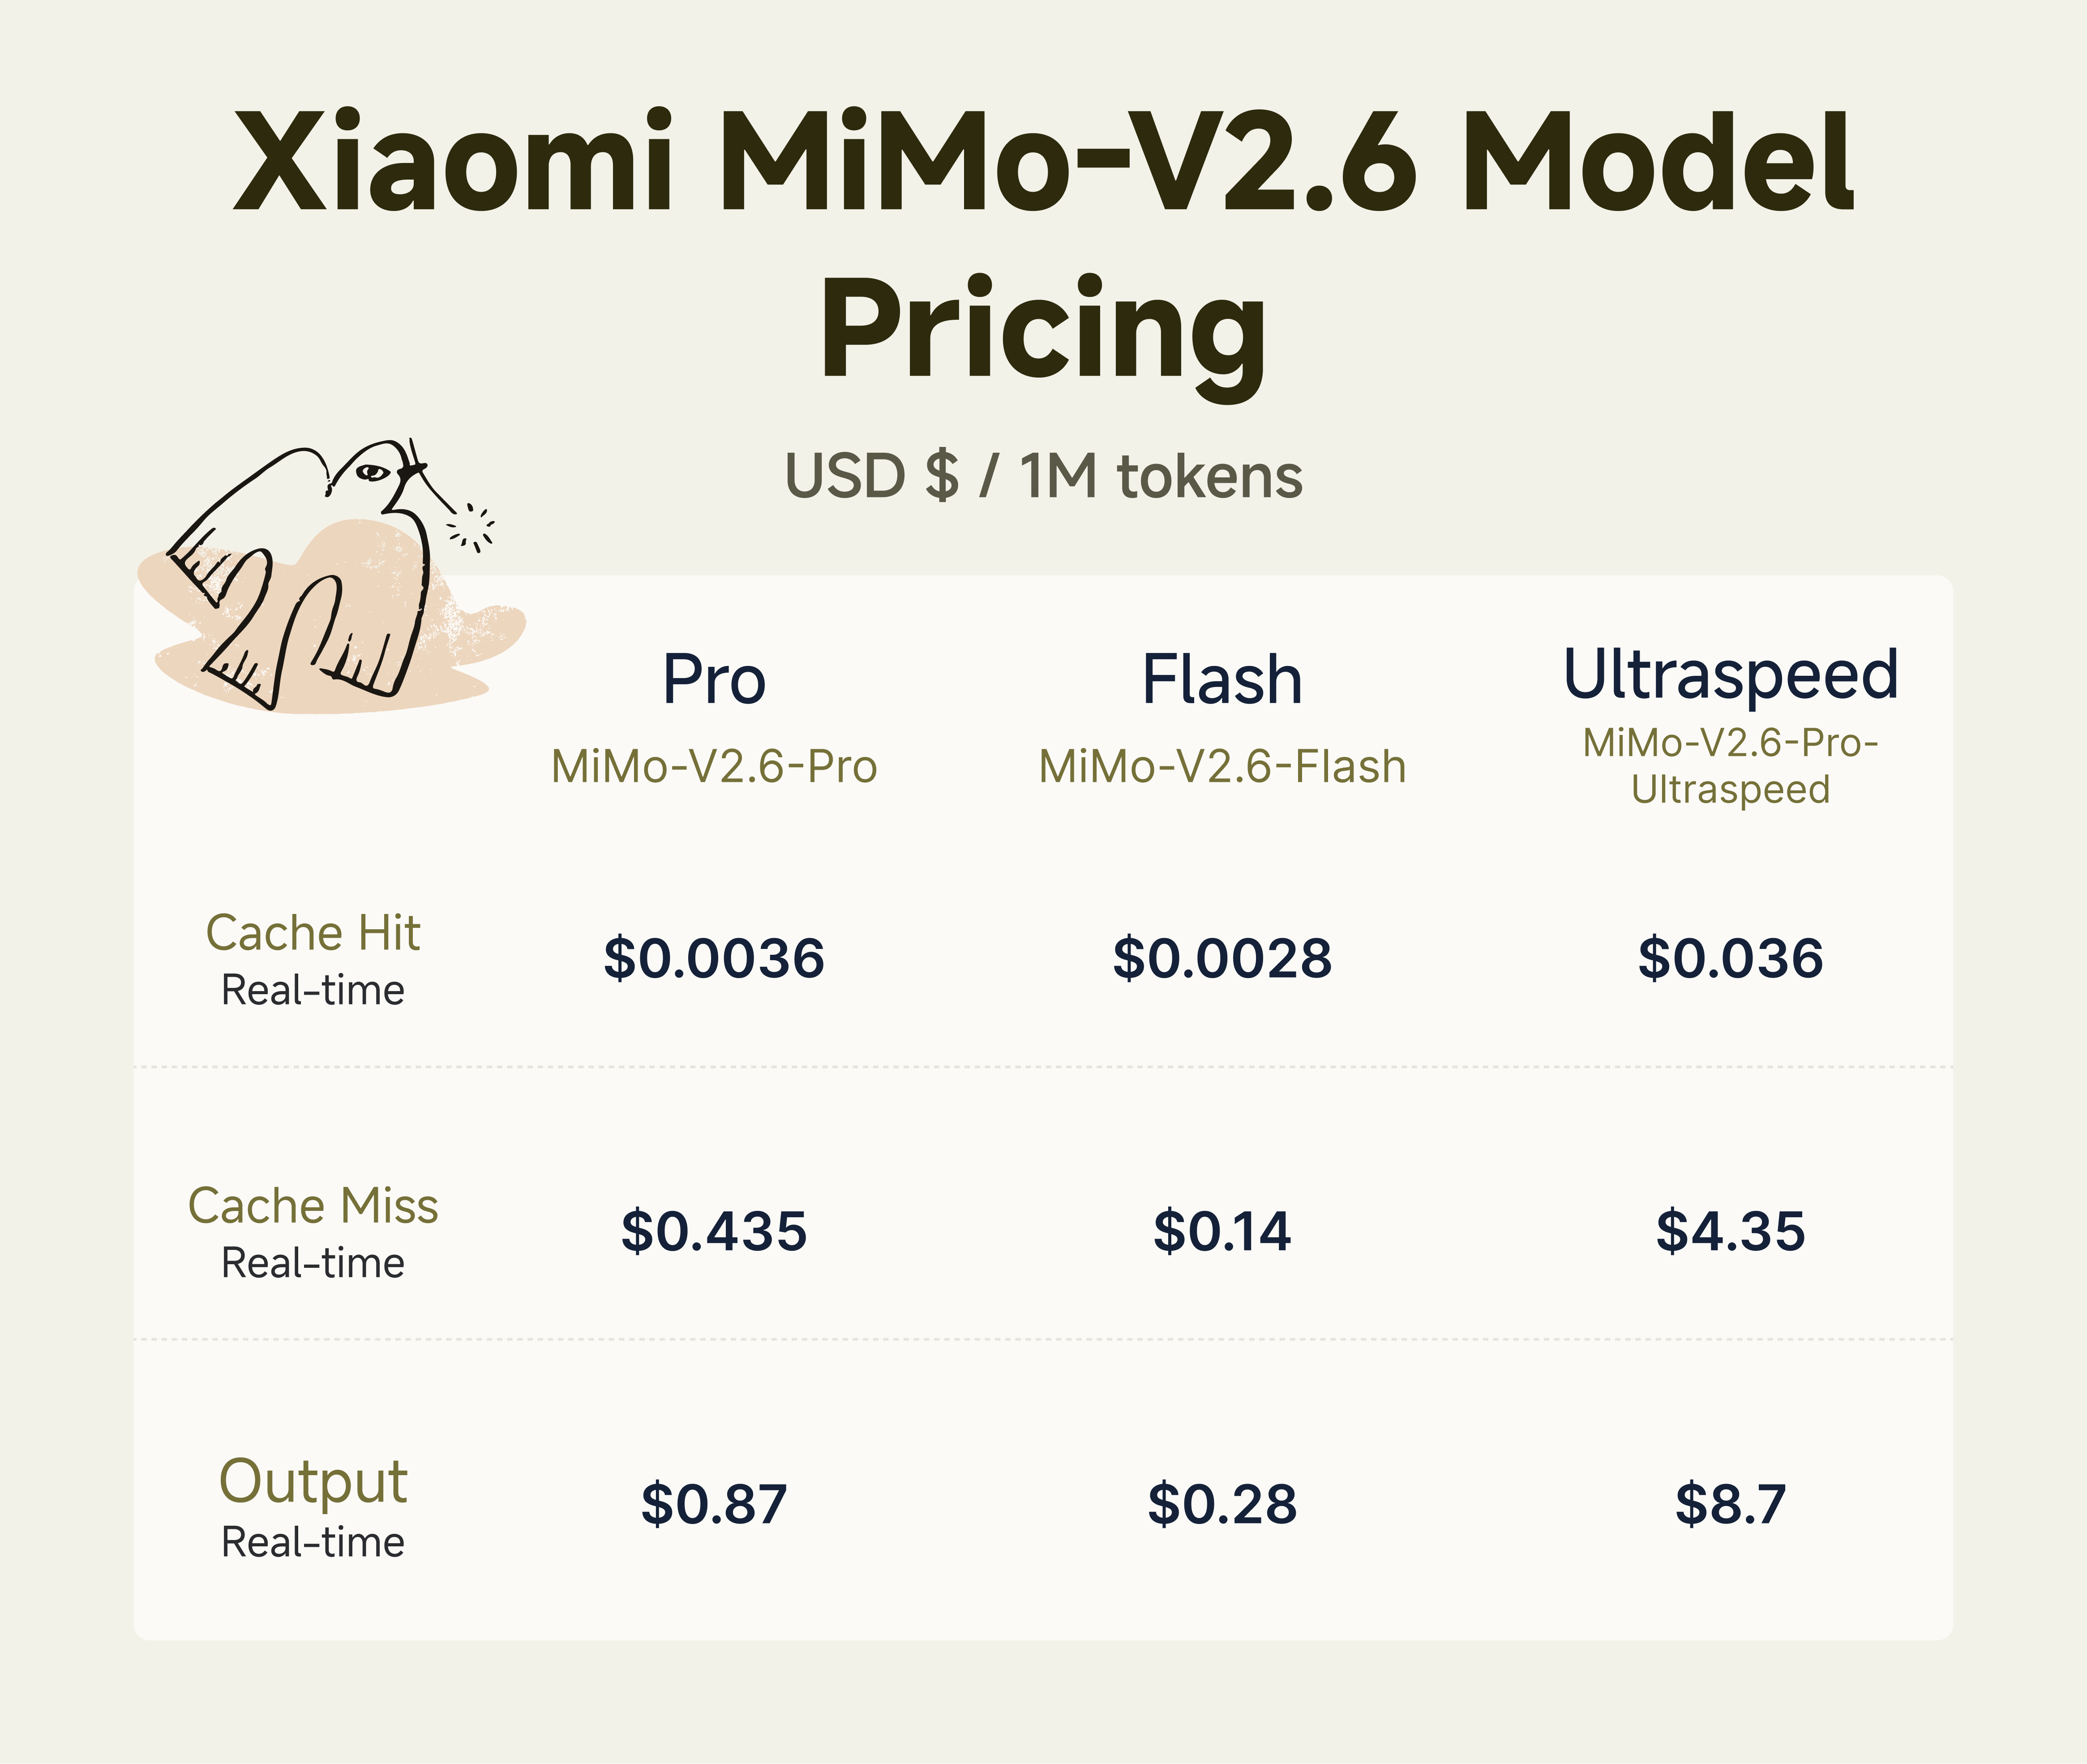
| Cennik | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Buforowane wejście / 1M tokenów | $0.0036 | $0.0028 | $0.036 |
| Niebuforowane wejście / 1M tokenów | $0.435 | $0.14 | $4.35 |
| Wyjście / 1M tokenów | $0.87 | $0.28 | $8.70 |
Xiaomi utrzymuje ceny API V2.6 na podobnym poziomie jak generacja V2.5. Flash jest szczególnie godny uwagi przy obciążeniach wysokowolumenowych: oficjalne ceny Xiaomi pokazują $0.14 za milion niebuforowanych tokenów wejściowych i $0.28 za milion tokenów wyjściowych.
Cennik i dostępność CometAPI
| Trasa CometAPI | Wejście / 1M | Wyjście / 1M | Status w katalogu |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Dostępny; 20% poniżej wymienionych oficjalnych stawek niebuforowanych |
| mimo-v2.6-pro | $0.348 | $0.6960 | Dostępny; 20% poniżej wymienionych oficjalnych stawek niebuforowanych |
| mimo-v2.6-flash | $0.112 | $0.2240 | Dostępny; 20% poniżej wymienionych oficjalnych stawek niebuforowanych |
How Can Developers Access Xiaomi MiMo-V2.6?
Xiaomi udostępnia modele poprzez API kompatybilne z OpenAI i dokumentuje zgodność z protokołem Anthropic na oficjalnych stronach modeli. Oficjalne identyfikatory to mimo-v2.6-pro, mimo-v2.6-flash i mimo-v2.6-pro-ultraspeed. Xiaomi dokumentuje wywoływanie narzędzi, ustrukturyzowane wyjście, streaming, kontrolę rozumowania, buforowanie kontekstu i wyszukiwanie w sieci. Interfejs kompatybilny z OpenAI używa wartości thinking.type, takich jak enabled lub disabled, z głębokim rozumowaniem domyślnie włączonym dla modeli V2.6.
Deweloperzy mają trzy praktyczne ścieżki dostępu. Po pierwsze, pobrać otwarto‑wagowy checkpoint Pro lub Flash do integracji samohostowanej, z zastrzeżeniem znacznych wymogów serwowania. Po drugie, użyć zarządzanego API Xiaomi z kluczem Xiaomi i udokumentowanym endpointem. Po trzecie, użyć wspieranej trasy CometAPI z kluczem CometAPI i bazowym URL; może to uprościć ewaluacje wielomodelowe i rozliczenia. Asystenci kodowania tacy jak Claude Code mogą użyć trasy kompatybilnej z Anthropic, gdy ta trasa i model są wspierane, ale zgodność należy przetestować, a nie zakładać.
Dostęp do MiMo-V2.6 przez CometAPI
CometAPI zapewnia ujednolicony endpoint i warstwę rozliczeń dla wspieranych modeli. Główną przewagą operacyjną jest prostota migracji: zespoły mogą zachować znajomy SDK, zmienić bazowy URL i ID modelu, porównać MiMo z innymi modelami czołowymi w tym samym koncie i scentralizować sprawdzanie użycia, cen i dostępności. Jest to użyteczne dla trasowania wielomodelowego, strategii awaryjnych, skonsolidowanych faktur i ewaluacji wymagających identycznych promptów u wielu dostawców.
CometAPI dokumentuje trzy formaty żądań tekstowych na poziomie platformy: OpenAI Chat Completions, Anthropic Messages i OpenAI Responses. Dla kompatybilnego SDK migracja zazwyczaj oznacza zmianę bazowego URL, klucza API i ID modelu zamiast przepisywania całej aplikacji. Wsparcie endpointów i parametrów może się różnić w zależności od modelu, więc przetestuj dokładny wariant MiMo‑V2.6 i format żądania zanim stwierdzisz, że wszystkie trzy trasy dla niego działają.
Sprawdzone 23 września 2026 r., MiMo-V2.6-Pro-UltraSpeed ma dostępną trasę katalogową z wymienionymi cenami wejścia i wyjścia. Dedykowane strony Pro i Flash pokazują Coming soon w migawkach katalogu, mimo że ich panele stanu API mówią Available. Traktuj to jako niespójny sygnał strony, a nie potwierdzoną dostępność produkcyjną lub ceny. Sprawdź żywy katalog, dashboard i żądanie testowe przed wdrożeniem.
Poniższy przykład podąża za opublikowanym wzorcem Anthropic‑SDK CometAPI i wywołuje obecnie wymienioną trasę UltraSpeed. Przechowuj klucz API w zmiennej środowiskowej.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analyze this project and propose the next implementation steps.' }],
});
Is Xiaomi MiMo-V2.6 Open Source?
Xiaomi opublikowało wagi modelu, materiały techniczne, zasoby RL, środowiska treningowe i powiązaną infrastrukturę. Wydanie obejmuje ponad 7 000 środowisk zadań RL, obejmujących inżynierię oprogramowania, reprodukcję podatności, pracę wiedzochłonną i projektowanie/rozwój WWW. Xiaomi wydało również MiMo‑V2.6‑Distill‑Qwen‑9B, aby badacze mogli studiować pipeline RL w znacznie mniejszej skali.
Oficjalne karty modelu: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
What Are the Limitations of Xiaomi MiMo-V2.6?
Nagłówek o bilionie parametrów nie powinien być traktowany jako dowód, że V2.6 jest uniwersalnie silniejszy niż zamknięte systemy czołowe. Tabela benchmarków Xiaomi pokazuje mieszany obraz: Claude Opus 5 pozostaje z przodu w niektórych testach kodowania, użycia narzędzi i OS, podczas gdy GPT‑5.6 Sol również prowadzi w wybranych testach. Dlatego bardziej sensowna jest ocena specyficzna dla obciążenia niż etykietowanie jednego zwycięzcy.
Samohostowanie pełnego checkpointu Pro to także zadanie mocno infrastrukturalne. Otwarte wagi nie oznaczają łatwego wdrożenia na stacji roboczej. Ponadto kilka nagłówkowych demonstracji — badania, sterowanie ucieleśnione, światy 3D i produkcja wideo — zależy od zewnętrznych narzędzi i ram agentowych. MiMo‑V2.6 należy oceniać jako model w systemie, a nie tylko jako samodzielny model czatowy.
Why Does Xiaomi MiMo-V2.6 Matter?
MiMo‑V2.6 łączy trzy ważne kierunki: bardzo duże rzadkie modele MoE, natywną multimodalność i uczenie ze wzmocnieniem w rzeczywistych środowiskach agentowych. Liczba 1.02T parametrów przyciąga uwagę, ale bardziej konsekwalnym wyborem projektowym jest inwestycja Xiaomi w powtarzalną interakcję ze środowiskiem, ocenianie trajektorii, użycie narzędzi i autokorektę.
Jeśli to podejście będzie skalowane, otwarte modele mogą być coraz częściej różnicowane nie tylko przez to, ile zawierają wiedzy statycznej, ale przez to, jak skutecznie działają, oceniają, odzyskują i kończą długie zadania. MiMo‑V2.6 najlepiej rozumieć jako otwarty model fundamentowy zorientowany na agentów, a nie kolejnego chatbota z bilionem parametrów.
Conclusion
MiMo‑V2.6 to znaczące, otwarto‑wagowe wydanie, ponieważ łączy natywne wejście tekstu, obrazu, wideo i audio z długim kontekstem, rzadką inferencją MoE oraz uczeniem ze wzmocnieniem w realnych środowiskach agentów. Pro lepiej pasuje do trudnych zadań długohoryzontowych, Flash celuje w obciążenia wysokowolumenowe i wrażliwe na koszt, a UltraSpeed wymienia znacząco wyższą cenę API na niższe opóźnienia.
Rodzina modeli jest konkurencyjna na kilku vendor‑raportowanych benchmarkach agentowych, ale nie prowadzi w każdej ewaluacji i nie powinna być traktowana jako uniwersalny zamiennik dla zamkniętych modeli czołowych. Najbardziej niezawodna ścieżka adopcji to testowanie MiMo‑V2.6 względem dokładnych narzędzi, celów opóźnień, trybów awarii i profilu kosztów docelowego przepływu pracy produkcyjnej.
FAQ
Co zespoły powinny przetestować przed wdrożeniem MiMo‑V2.6 do produkcji?
Przetestuj kompletny system, a nie tylko model. Mierz ukończenie zadania, dokładność wywołań narzędzi, odzyskiwanie po nieudanych działaniach, opóźnienia, zużycie tokenów, zarządzanie kontekstem i granice uprawnień. Benchmarki agentowe dają orientację, ale ewaluacje wewnętrzne powinny odzwierciedlać rzeczywiste repozytorium, przeglądarkę, dokument lub przepływ badawczy.
Dlaczego samohostowanie MiMo‑V2.6‑Pro może być trudne mimo rzadkiej architektury?
Rzadkie aktywacje redukują obliczenia na token względem gęstego modelu o bilionie parametrów, ale pełny checkpoint nadal ma bardzo duży ślad pamięci i serwowania rozproszonego. Wdrożenie produkcyjne może wymagać inferencji wielowęzłowej, równoległości na ekspertach, wyspecjalizowanych jąder i starannego planowania pojemności.
Jak deweloperzy powinni interpretować tabelę benchmarków krzyżowych Xiaomi?
Traktuj ją jako dowód raportowany przez dostawcę, nie niezależnie odtworzoną uniwersalną klasyfikację. Wyniki mogą zmieniać się wraz z ramą agenta, budżetem inferencji, narzędziami, obrazem środowiska, metodą próbkowania i wersją benchmarku. Porównuj trendy w wielu zadaniach i odtwarzaj najbardziej relewantne obciążenia wewnętrznie.
Kiedy MiMo‑V2.6‑Flash jest lepszym wyborem niż Pro?
Flash jest silniejszym domyślnym wyborem, gdy dominują wolumen wywołań i koszt, szczególnie dla przetwarzania dokumentów, analizy multimodalnej i powtarzanych kroków agentów. Pro jest bardziej odpowiedni, gdy trudne rozumowanie lub długohoryzontowa egzekucja przynosi wystarczającą wartość biznesową, by uzasadnić wyższą cenę.
Czy okno kontekstu 1M tokenów eliminuje potrzebę retrievalu lub zarządzania promptem?
Nie. Większe okno zwiększa pojemność, ale wysyłanie zbędnej historii może zwiększyć opóźnienia i koszt oraz rozcieńczyć relewantne dowody. Retrieval, streszczanie, ustrukturyzowana pamięć i przycinanie kontekstu pozostają ważne dla niezawodnych agentów produkcyjnych.