Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
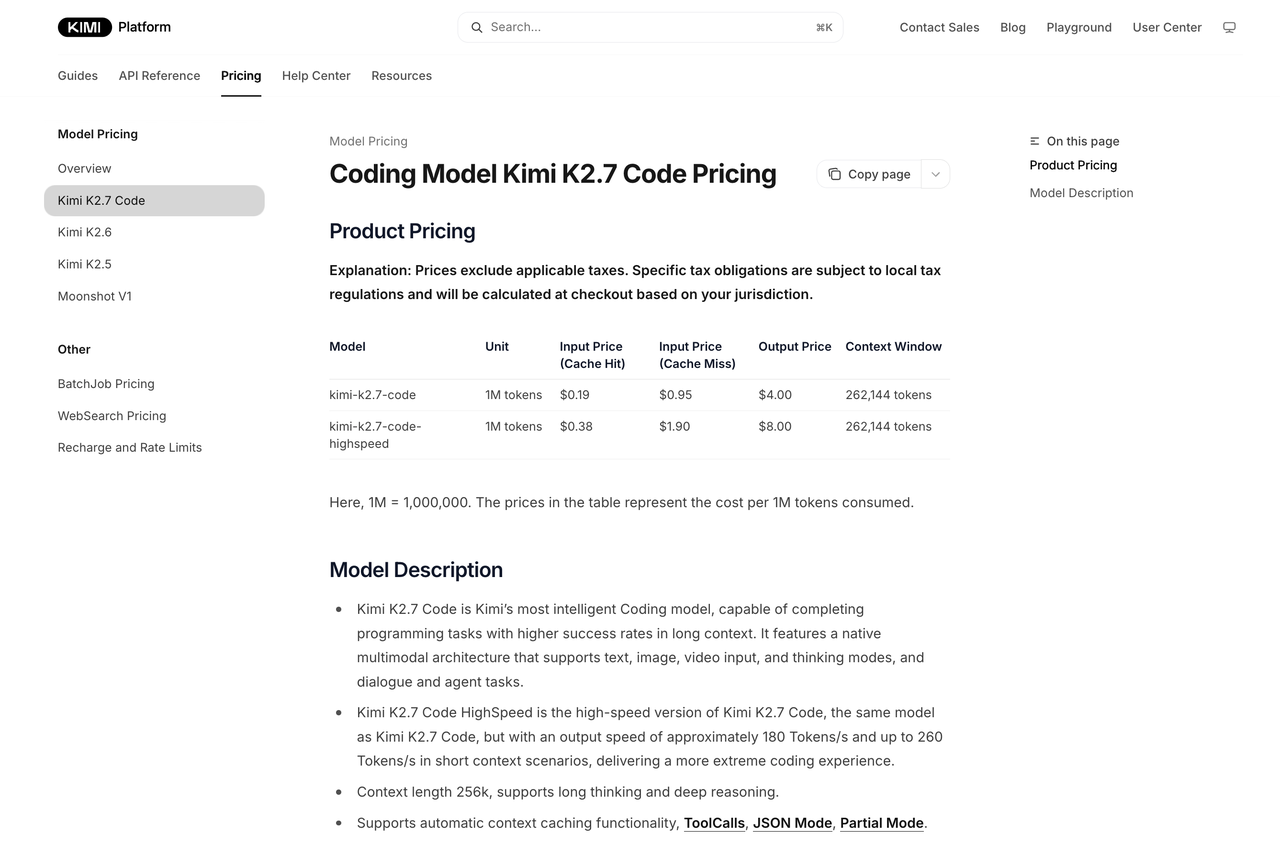
TLDR A Moonshot AI atualmente cobra do Kimi K2.7 Code $0.19 por 1M de tokens de entrada com acerto de cache, $0.95 por 1M de tokens de entrada com falha de cache e $4.00 por 1M de tokens de saída. O Kimi K2.7 Code HighSpeed dobra essas tarifas para $0.38 / $1.90 / $8.00.
As principais considerações de custo são:
Cache: a entrada com acerto de cache do K2.7 da Moonshot é 80% mais barata do que a entrada com falha de cache.
HighSpeed: a rota mais rápida custa o dobro por token.
os modelos compatíveis custam 60% das tarifas em tempo real, equivalente a uma economia de 40%.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
Batch API:
WebSearch: a Moonshot cobra $0.005 por chamada bem-sucedida de pesquisa integrada, além dos tokens usados para processar os resultados da pesquisa.
Compatibilidade: o K2.7 Code exige o modo Thinking, enquanto o WebSearch integrado da Moonshot exige o Thinking desativado.
Para agentes de código, a métrica mais útil não é o preço por milhão de tokens. É o custo por tarefa concluída, incluindo raciocínio, cache, tentativas, chamadas de ferramentas, latência e correções humanas.
Os preços do K2.7 da Moonshot são promocionais no momento. Moonshot e CometAPI também utilizam estruturas de cobrança de entrada diferentes, portanto suas tarifas listadas não devem ser consideradas diretamente intercambiáveis.
Preços do Moonshot Kimi K2 explicados
K2.7 Code e K2.6 compartilham os mesmos preços de entrada com falha de cache e de saída. As principais diferenças ao nível de token são que o K2.7 Code cobra um pouco mais por entrada em cache, enquanto o HighSpeed dobra todas as tarifas do K2.7.
Modelo
Mais adequado para
kimi-k2.7-code
Agentes de código, edições de repositório e tarefas de engenharia de longo prazo
kimi-k2.7-code-highspeed
Codificação interativa em que menor latência tem valor mensurável
kimi-k2.6
Raciocínio multimodal geral, agentes e WebSearch integrado
kimi-k2.5
Cargas gerais e multimodais de menor custo
A Moonshot descreve o HighSpeed como o mesmo modelo K2.7 Code subjacente servido por uma rota mais rápida. Sua velocidade de saída documentada é de aproximadamente 180 tokens por segundo, chegando a 260 tokens por segundo em cenários de contexto mais curto. A capacidade pode flutuar enquanto a Moonshot amplia os recursos.
Portanto, o HighSpeed é principalmente uma escolha de latência, não um nível separado de qualidade do modelo.
Uma alternativa direta à API Moonshot: CometAPI
Os desenvolvedores podem acessar o Kimi K2.7 Code diretamente pela Moonshot AI ou pela API compatível com OpenAI da CometAPI.
Rota de acesso
Entrada padrão
Entrada em cache
Saída
API direta Moonshot
$0.95 / 1M cache miss
$0.19 / 1M
$4.00 / 1M
CometAPI
$0.76 / 1M
Não listado separadamente
Aprox. $3.20 / 1M
Os preços de entrada e saída listados da CometAPI estão cerca de 20% inferiores, enquanto a Moonshot pode ser mais econômica para cargas com alta taxa de acertos de cache.
Escolha a CometAPI se você quiser uma única API para o Kimi e outros provedores de modelos. Escolha o acesso direto da Moonshot se seu fluxo de trabalho reutiliza frequentemente os mesmos prompts ou o contexto do repositório.
Nas tarifas atualmente listadas, a CometAPI é aproximadamente 20% mais barata do que os preços de entrada com falha de cache e saída da Moonshot.
No entanto, a CometAPI não mostra um preço separado para acerto de cache na página do modelo K2.7. Seu preço padrão de entrada de $0.76 não deve ser comparado diretamente com a tarifa de $0.19 de entrada em cache da Moonshot.
Equipes que reutilizam repetidamente prompts de sistema longos, definições de ferramentas ou contexto de repositório devem testar ambas as rotas usando seu tráfego real. Uma carga com taxa de acerto de cache muito alta pode produzir um resultado diferente de outra que envia principalmente novo contexto.
Como o cache de contexto altera o custo da API do Kimi
O Kimi cobra tokens de entrada como acertos de cache ou falhas de cache.
Falhas de cache normalmente incluem conteúdo novo ou modificado, como:
novos arquivos de repositório
instruções atualizadas
resultados recentes de ferramentas
histórico de conversa variável
Acertos de cache podem incluir conteúdo repetido, como prompts de sistema estáveis, esquemas de ferramentas, convenções de codificação e contexto de repositório inalterado.
Para o K2.7 Code, a entrada em cache custa $0.19 por 1M de tokens, em comparação com $0.95 para entrada sem cache. Isso torna um token com acerto de cache 80% mais barato.
Calcular os mesmos 1M de tokens inteiramente à taxa de falha de cache custaria $0.95. Neste exemplo, o perfil misto de cache reduz o custo de entrada em $0.608.
É por isso que painéis de produção devem registrar tokens de acerto e de falha de cache separadamente, em vez de relatar apenas o uso total de entrada.
Preços da Kimi Batch API
A Batch API da Moonshot cobra 60% do preço do modelo em tempo real correspondente, proporcionando uma economia de 40% em cargas assíncronas compatíveis. A documentação atual lista K2.7 Code, K2.6 e K2.5 como modelos compatíveis com Batch.
Modelo Batch
Entrada com acerto de cache
Entrada com falha de cache
Saída
kimi-k2.7-code
$0.114 / 1M
$0.57 / 1M
$2.40 / 1M
kimi-k2.6
$0.096 / 1M
$0.57 / 1M
$2.40 / 1M
kimi-k2.5
$0.06 / 1M
$0.36 / 1M
$1.80 / 1M
Batch API é ideal para:
análise de código em nível de repositório
grandes execuções de avaliação
classificação offline
enriquecimento noturno
geração de testes sintéticos
análise de migração
pendências de revisão de segurança
É menos adequada para assistentes de IDE, chat ao vivo e outros fluxos de trabalho em que o usuário aguarda uma resposta imediata.
Para processamento em background, a economia de 40% pode ser mais valiosa do que trocar por um modelo mais barato com menor taxa de conclusão de tarefas.
Preços e compatibilidade do Kimi WebSearch
A Moonshot cobra $0.005 por cada chamada bem-sucedida de$web_searchintegrada. Nenhuma taxa de ferramenta separada é cobrada quando o modelo termina sem acionar a ferramenta de pesquisa.
O conteúdo dos resultados de pesquisa também pode ser adicionado à próxima solicitação do modelo e cobrado como tokens de entrada. A Moonshot define o cálculo resultante de tokens como:
Um fluxo de pesquisa completo pode, portanto, incluir:
Initial model request
+ WebSearch tool fee
+ search-result input tokens
+ follow-up model request
+ retries
Há também uma restrição importante do modelo. O WebSearch integrado da Moonshot requer o Thinking desativado, enquanto o K2.7 Code não oferece suporte ao modo não-thinking. O exemplo oficial de WebSearch, portanto, usa o K2.6 com o Thinking desativado.
Para a pesquisa integrada da Moonshot, use K2.6 ou K2.5 com o Thinking desativado.
Um agente de código K2.7 ainda pode chamar um serviço de pesquisa implementado de forma independente por meio de chamadas de função normais. Nesse caso, o preço da pesquisa é determinado pelo provedor externo, e não pela tarifa integrada de $0.005 da Moonshot.
Exemplo 1: custo do K2.7 Code para uma tarefa de codificação
Suponha que um fluxo de trabalho de agente de código use:
30,000 tokens de entrada com falha de cache
8,000 tokens de saída, incluindo raciocínio
nenhuma chamada de WebSearch integrada
K2.7 Code padrão
Componente
Cálculo
Custo
Entrada
30,000 ÷ 1M × $0.95
$0.03
Saída
8,000 ÷ 1M × $4.00
$0.03
Total
$0.06
K2.7 Code HighSpeed
Componente
Cálculo
Custo
Entrada
30,000 ÷ 1M × $1.90
$0.06
Saída
8,000 ÷ 1M × $8.00
$0.06
Total
$0.12
Para o mesmo uso de tokens, o HighSpeed custa exatamente o dobro.
CometAPI K2.7 Code
Usando as tarifas atuais da CometAPI:
Componente
Cálculo
Custo
Entrada
30,000 ÷ 1M × $0.76
$0.02
Saída
8,000 ÷ 1M × $3.19998
Aprox. $0.0256
Total
Aprox. $0.0484
Isso é aproximadamente 20% abaixo do custo de tokens de $0.0605 da Moonshot em entrada com falha de cache neste exemplo. O cálculo exclui impostos, ferramentas externas e outros serviços de plataforma.
Exemplo 2: K2.6 com WebSearch integrado
Suponha um fluxo de trabalho com K2.6 e Thinking desativado que use:
30,000 tokens de entrada com falha de cache ao longo do fluxo completo
8,000 tokens de saída
uma chamada de WebSearch integrada bem-sucedida
Os 30,000 tokens de entrada incluem conteúdo de resultados de pesquisa levado à solicitação de acompanhamento.
Componente
Cálculo
Custo
Entrada
30,000 ÷ 1M × $0.95
0.0285
Saída
8,000 ÷ 1M × $4.00
0.0320
WebSearch
1 × $0.005
0.0050
Total
0.0655
Neste exemplo, a taxa direta do WebSearch representa cerca de 7.6% do total. Em fluxos de pesquisa mais longos, os tokens adicionados pelos resultados podem custar mais do que a própria chamada de ferramenta.
Detalhes de engenharia que podem alterar a conta final
O K2.7 Code retorna um erro se o Thinking for desativado. Seu raciocínio é retornado por meio de reasoning_content, e tanto o raciocínio quanto a resposta visível contribuem para o uso de tokens.
Durante chamadas de ferramenta em várias etapas, os aplicativos devem preservar o reasoning_content do assistente no contexto da conversa. Loops de agente mais longos podem, portanto, aumentar tanto o uso de saída atual quanto o uso de entrada posterior.
max_tokens é um limite, não uma cobrança fixa
O parâmetro max_tokens define o máximo que o modelo pode gerar. Um valor mais alto dá espaço suficiente para o modelo concluir seu raciocínio e resposta, mas a cota completa não é cobrada automaticamente.
Os custos são baseados nos tokens realmente processados e gerados.
Vários parâmetros de solicitação são fixos
O K2.7 Code exige valores fixos para vários parâmetros:
Parâmetro
Valor obrigatório
temperature
1
top_p
0.95
n
1
presence_penalty
0
frequency_penalty
0
Passar outro valor pode retornar um erro. Aplicativos que usam o mesmo wrapper compatível com OpenAI entre vários provedores devem inspecionar padrões codificados antes de trocar de modelo.
A documentação oficial de preços explica como o modelo é cobrado. A adoção externa fornece contexto adicional sobre onde ele está sendo usado e como os desenvolvedores o avaliam.
GitHub Copilot
O GitHub disponibilizou o Kimi K2.7 Code de forma geral no Copilot em 1º de julho de 2026, descrevendo-o como o primeiro modelo de pesos abertos oferecido no seletor de modelos do Copilot. A disponibilidade inicialmente cobria planos individuais e foi expandida para os planos Business e Enterprise em 7 de julho.
A adoção pelo GitHub é um sinal útil de distribuição, mas não prova que o K2.7 superará outros modelos em toda carga de trabalho de codificação.
A Moonshot publica o Kimi K2.7 Code no Hugging Face sob uma licença MIT modificada. A ficha do modelo descreve uma arquitetura mixture-of-experts de 1 trilhão de parâmetros com 32 bilhões de parâmetros ativados e janela de contexto de 256K. Também inclui instruções de implantação para frameworks como Transformers, vLLM e SGLang.
A Moonshot relata aproximadamente 30% menos uso de tokens de raciocínio que o K2.6 e uma melhoria de 10% em capacidade de agentes. Esses são resultados relatados pelo fornecedor e devem ser validados com cargas independentes.
A discussão no Hacker News é mais mista do que o material de lançamento. Alguns desenvolvedores focam na disponibilidade de pesos abertos do Kimi, eficiência de tokens e integração com ferramentas de agentes de código. Outros argumentam que um preço de token menor não garante um custo de projeto menor se o modelo exigir mais tentativas, supervisão ou contexto.
Esse debate reforça a recomendação central deste guia: compare modelos usando repositórios reais e meça conclusão de tarefas, tentativas e edições humanas — não apenas tarifas de tokens anunciadas.
O DeepSeek V4 Pro atualmente lista uma janela de contexto de 1M com entrada de acerto de cache a $0.003625, entrada com falha de cache a $0.435 e saída a $0.87 por milhão de tokens.
A tarifa introdutória do Claude Sonnet 5 é $2 por milhão de tokens de entrada, $0.20 por milhão de tokens de leitura de cache e $10 por milhão de tokens de saída até 31 de agosto de 2026. Suas gravações de cache são precificadas separadamente, e a Anthropic observa que o tokenizador mais novo do modelo pode gerar mais tokens para o mesmo texto do que modelos Claude anteriores.
A tarifa padrão de contexto curto do GPT-5.6 Sol é $5 por milhão de tokens de entrada, $0.50 por milhão de tokens de entrada em cache e $30 por milhão de tokens de saída. A OpenAI também lista tarifas separadas para gravação de cache, contexto longo, Batch, Flex e Priority.
Nas tarifas de tokens listadas, o Kimi K2.7 Code é menos caro que o Claude Sonnet 5 e o GPT-5.6 Sol, enquanto o DeepSeek V4 Pro é mais barato. Isso não determina qual modelo oferece o menor custo para um fluxo de trabalho específico de codificação.
Qual modelo Kimi você deve usar?
Carga de trabalho
Ponto de partida recomendado
Edições de repositório e tarefas longas
kimi-k2.7-code
Codificação interativa em que a latência importa
kimi-k2.7-code-highspeed
Raciocínio multimodal geral e agentes
kimi-k2.6
WebSearch integrado da Moonshot
kimi-k2.6 ou kimi-k2.5 com Thinking desativado
Cargas gerais de menor custo
kimi-k2.5
Avaliações offline e processamento em massa
Batch API
O K2.7 Code é o ponto de partida natural para trabalhos de codificação sensíveis à qualidade. O HighSpeed vale o teste quando respostas mais rápidas melhoram a experiência do desenvolvedor, conversão ou throughput.
O K2.6 é mais flexível para fluxos gerais multimodais e baseados em pesquisa, enquanto o K2.5 possui as menores tarifas padrão de tokens do Kimi.
Como avaliar o custo real
Construa um conjunto de avaliação a partir de tarefas de produção em vez de depender apenas de benchmarks públicos.
Casos de teste úteis incluem:
implementação de recursos em nível de repositório
revisão de pull requests
depuração e geração de testes
análise de código com contexto longo
chamadas de ferramenta em várias etapas
suporte ao desenvolvedor com pesquisa
Acompanhe:
conclusão bem-sucedida da tarefa
taxa de acerto de cache
tokens de entrada e saída
volume de tokens de raciocínio
sucesso de chamadas de ferramenta
contagem de tentativas
latência p50 e p95
correções humanas
custo total do fluxo de trabalho
Calcule:
Cost per completed task =
total workflow cost ÷ successfully completed tasks
Por exemplo, se uma equipe gasta $10 e conclui com sucesso 80 tarefas:
Cost per completed task = $10 ÷ 80 = $0.125
Um modelo com tokens mais baratos ainda pode custar mais se exigir tentativas repetidas, raciocínio mais longo ou correção manual extensa.
Para exemplos de roteamento, fallback e avaliação, explore o CometAPI Cookbook.
Perguntas frequentes
Quanto custa o Kimi K2.7 Code?
A Moonshot atualmente lista o K2.7 Code em:
$0.19 por 1M de tokens de entrada com acerto de cache
$0.95 por 1M de tokens de entrada com falha de cache
$4.00 por 1M de tokens de saída
As tarifas estão marcadas como preços promocionais por tempo limitado.
Quanto custa o K2.7 Code pela CometAPI?
A CometAPI atualmente lista o K2.7 Code a $0.76 por 1M de tokens de entrada e $3.19998 por 1M de tokens de saída.
Um preço separado para acerto de cache não é mostrado na página do modelo.
A Kimi Batch API reduz custos e oferece suporte ao K2.7 Code?
Sim. A inferência em lote custa 60% do preço em tempo real, equivalente a uma economia de 40%.
A documentação atual de Batch da Moonshot lista K2.7 Code, K2.6 e K2.5 como modelos compatíveis.
Quanto custa o Kimi WebSearch?
O $web_search integrado da Moonshot custa $0.005 por chamada bem-sucedida.
O conteúdo dos resultados de pesquisa também pode ser cobrado como tokens de entrada quando incluído na próxima solicitação do modelo.
O Thinking pode ser desativado no K2.7 Code?
Não. Solicitações que desativam o Thinking retornam um erro.
O Kimi é compatível com a OpenAI?
Sim. A Moonshot documenta compatibilidade com o formato da API da OpenAI, embora restrições específicas do modelo ainda se apliquem ao Thinking, parâmetros e chamadas de ferramenta em várias etapas.
Teste o Kimi K2.7 Code com a CometAPI
O Kimi K2.7 Code oferece preços competitivos para cargas de trabalho de agentes de código, mas a melhor rota depende de mais do que a tarifa de token anunciada.
Antes de escolher um provedor, compare:
Total workflow cost =
tokens + retries + tools + latency + human correction
A CometAPI permite que os desenvolvedores testem o Kimi junto com GPT, Claude, Gemini, DeepSeek, Grok e outras famílias de modelos por meio de um workflow de API unificado.