Especificações técnicas do GLM-5.2
| Item | GLM-5.2 |
|---|---|
| Provedor | Zhipu AI |
| Data de lançamento | 13 de junho de 2026 |
| Tipo de modelo | LLM Mixture-of-Experts (MoE) de pesos abertos |
| Parâmetros totais | ~744B |
| Parâmetros ativos | ~40B por token |
| Janela de contexto | 1,000,000 tokens |
| Saída máxima | 131,072 tokens |
| Modos de raciocínio | High, Max |
| Licença | MIT |
| Foco principal | Codificação orientada a agentes, engenharia de software, raciocínio de longo horizonte |
| Disponibilidade da API | Plataforma Z.ai e provedores compatíveis |
| Pesos abertos | Sim |
O GLM-5.2 é o mais recente modelo carro-chefe da família GLM da Zhipu AI. Ao contrário dos modelos de ponta de uso geral, o GLM-5.2 é posicionado principalmente como um modelo voltado primeiro para código e orientado a agentes, projetado para engenharia de software em escala de repositório, fluxos de trabalho autônomos e raciocínio com contextos extremamente longos. Seu principal destaque é uma janela de contexto nativa de 1 milhão de tokens, tornando-o uma das maiores janelas de contexto publicamente disponíveis entre os modelos de pesos abertos.
Principais recursos do GLM-5.2
- Janela de contexto de 1M tokens para repositórios inteiros, conjuntos extensos de documentação e fluxos de trabalho de agentes com múltiplas sessões.
- Otimização voltada ao código com foco em refatoração, depuração, geração de código e tarefas de engenharia de software.
- Suporte a fluxos de trabalho orientados a agentes para ferramentas como Claude Code, Cline, Roo Code, OpenCode e agentes de codificação similares.
- Lançamento com pesos abertos sob licença MIT, permitindo hospedagem própria e ajuste fino.
- Dois modos de raciocínio (High e Max) que permitem equilibrar latência e profundidade de raciocínio.
- Grande arquitetura MoE com aproximadamente 744B de parâmetros totais, ativando apenas ~40B por token para eficiência.
Desempenho em benchmarks do GLM-5.2
A Zhipu não publicou resultados oficiais abrangentes de benchmark no lançamento, o que torna a comparação direta mais incerta do que para modelos como GPT-5 ou Claude. Vários relatórios do setor observam a ausência de resultados de benchmark validados de forma independente.
| Benchmark | Pontuação reportada |
|---|---|
| Terminal-Bench 2.1 | 81.0 |
| SWE-Bench Pro | 62.1 |
| NL2Repo | 48.9 |
| AIME 2026 | 99.2 |
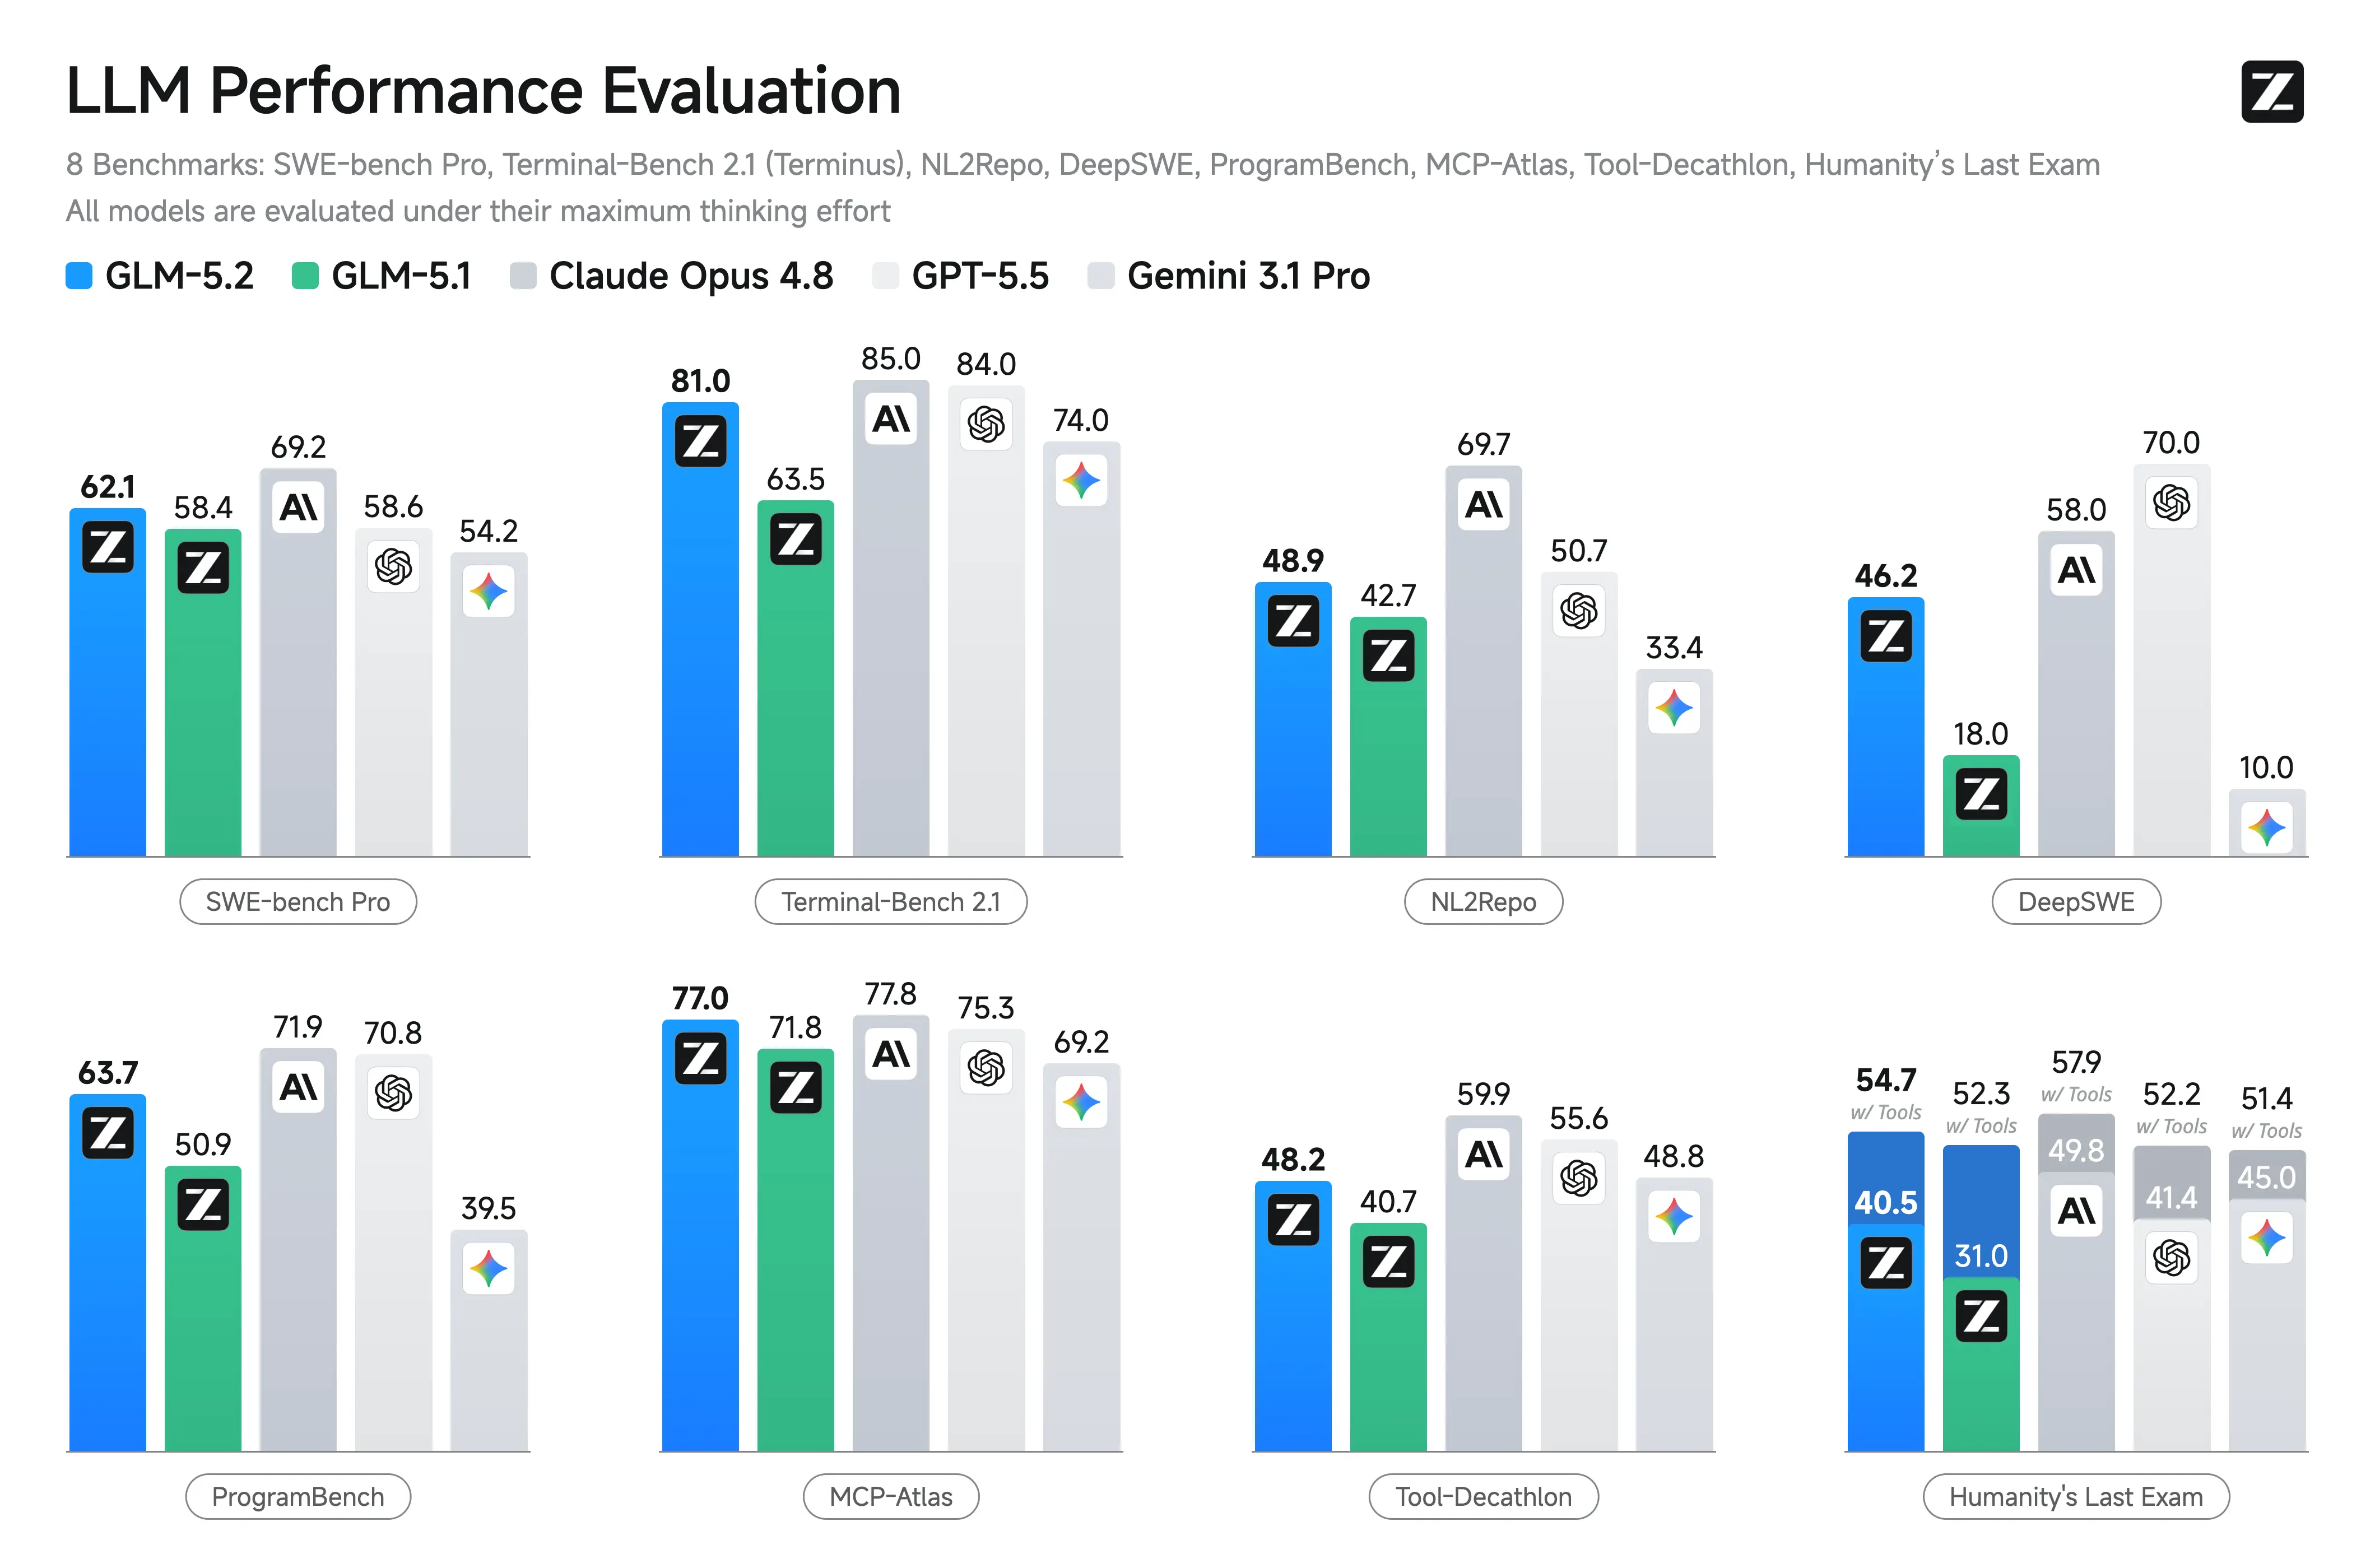
GLM-5.2 vs GLM-5.1 vs Claude Opus 4.8
| Especificação | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 |
|---|---|---|---|
| Data de lançamento | 2026-06-13 | 2026 | 2026 |
| Janela de contexto | 1,000,000 | ~200,000 | 1,000,000 |
| Pesos abertos | Sim (MIT) | Sim | Não |
| Modos de raciocínio | High, Max | Standard | Extended Thinking |
| Parâmetros totais | 744B | 744B | Não divulgado |
| Parâmetros ativos | 40B | 40B | Não divulgado |
| Dados oficiais de benchmark | Não publicado | Publicado no lançamento | Publicado |
A principal melhoria documentada do GLM-5.2 em relação ao GLM-5.1 é sua expansão para uma janela de contexto de 1M tokens e a introdução de modos de raciocínio selecionáveis High e Max. No lançamento, a Z.ai não publicou resultados oficiais de benchmarks como SWE-Bench, LiveCodeBench, HumanEval ou similares, portanto comparações de desempenho com Claude Opus 4.8, GPT-5, DeepSeek ou Qwen permanecem não verificadas.
Comparado a outros modelos abertos, o principal diferencial do GLM-5.2 é a combinação de uma janela de contexto muito grande, especialização em código e licença MIT. Seu apelo mais forte é para engenharia de software em escala de repositório, em vez de aplicativos de chat gerais.
Por que usar o GLM-5.2 por meio do CometAPI?
O CometAPI permite que desenvolvedores integrem o GLM-5.2 usando a mesma interface empregada por dezenas de modelos de IA líderes.
Os benefícios incluem:
- Autenticação unificada em vários provedores
- Integração via API compatível com OpenAI
- Faturamento e gestão de uso simplificados
- Experimentação rápida com modelos alternativos
- Alternância fácil entre modelos de código, raciocínio, imagem, áudio e vídeo
- Redução da dependência de fornecedor em sistemas de produção
Se você está criando um IDE de IA, um assistente interno de engenharia ou uma plataforma de automação corporativa, o CometAPI minimiza o esforço de integração ao mesmo tempo que preserva a flexibilidade.
Como acessar a API do GLM-5.2 no CometAPI
Comece a usar nosso produto em apenas alguns passos...
Etapa 1: Cadastre-se para obter sua chave de API do GLM-5.2
Crie uma conta no CometAPI e navegue até o painel da API para gerar sua chave de API do GLM-5.2. Essa chave autentica todas as suas solicitações e lhe dá acesso imediato a todos os recursos da API do GLM-5.2, incluindo a janela de contexto de 1M tokens e 128k tokens de saída.
Etapa 2: Envie solicitações para a API do GLM-5.2
Use sua chave de API do GLM-5.2 para enviar solicitações POST ao endpoint do CometAPI. Passe seu prompt, defina parâmetros do modelo como effort level e max tokens, e a API do GLM-5.2 processa sua solicitação — lidando com tudo, de geração de código a análise de documentos e uso de ferramentas orientadas a agentes.
Etapa 3: Recupere resultados e integre a API do GLM-5.2
A API do GLM-5.2 entrega respostas estruturadas, incluindo texto de conclusão, instruções de chamada de ferramentas e metadados de uso de tokens. Ela oferece suporte tanto a respostas síncronas padrão quanto a streaming em tempo real via Server-Sent Events (SSE) quando stream: true estiver configurado. O endpoint pode ser facilmente integrado aos seus fluxos de trabalho existentes usando clientes HTTP padrão ou SDKs compatíveis com OpenAI, roteando as solicitações por meio de url(//api.cometapi.com/v1) com seu Bearer Token.