
TL;DR
Z.AI публично обозначила GLM-6.0 и поместила Full Self-Training в центр своей дорожной карты следующего поколения. Раскрытое направление связывает самогенерируемый опыт на стадиях предобучения, промежуточного обучения и постобучения с самооценкой и исправлением, превращая обучение в управляемый контур обратной связи, а не в разовый проход генерации данных.
Сложность в управлении: GLM-6.0 потребуется очищать синтетические данные, обнаруживать и исправлять ошибки, останавливать непродуктивные итерации и предотвращать ситуацию, когда её оценщик вознаграждает обходные решения. Эти механизмы порождают практические вопросы о независимой верификации, безопасности, стоимости и управлении. Поскольку публично нет полной карточки модели, набора бенчмарков, спецификации API, цены или даты релиза, статья оценивает архитектуру обучения и имеющиеся свидетельства — а не спекулятивные спецификации.
Ключевые выводы для GLM 6.0?
- Наиболее убедительные публичные свидетельства касаются системы Full Self-Training, а не утёкшего числа параметров или результатов бенчмарков.
- Раскрытое направление охватывает самопроизводимые данные, самоконструируемые тренировочные среды и оптимизацию инфраструктуры при помощи модели.
- Задуманный контур обратной связи охватывает предобучение, промежуточное обучение и постобучение, а не рассматривает самообучение как технику только финального дообучения.
- Нативное мультимодальное моделирование, обучение с подкреплением с более длинным горизонтом, планирование, использование инструментов, восстановление и верификация — релевантные направления исследований, но это ещё не опубликованные спецификации GLM 6.0.
- Ox Alpha не является свидетельством утечки производительности GLM 6.0; Z.AI указала, что это предрелизное обозначение GLM-5.3-Flash.
Что Z.AI фактически подтвердила о GLM 6.0?
Публичные материалы Z.AI фиксируют четыре конкретных сигнала: название GLM-6.0, Full Self-Training как центральное направление обучения, задуманный контур через предобучение, промежуточное обучение и постобучение, а также механизм самооценки и исправления. Компания также заявляет, что около 60% чистых поступлений предполагается направить на модели следующего поколения, Full Self-Training, крупномасштабное обучение, инференс, вычислительные ресурсы и связанную инфраструктуру.
Рамочная система Full Self-Training Z.AI
Full Self-Training представлена как системообразующая идея для GLM-6.0, а не как небольшой постобучающий прием. Предполагаемая система будет генерировать обучающий опыт, учиться на исходах, отфильтровывать слабые примеры и повторять цикл под явными контрольными мерами качества.
GLM-6.0: самообучение на стадиях пред-, промежуточного и постобучения
Раскрытая последовательность — предобучение, промежуточное обучение и постобучение — подразумевает, что самогенерируемый опыт может влиять на базовые знания, формирование способностей и выравнивание задач, а не появляться только на этапе финальной настройки. Z.AI не раскрыла датасеты, границы стадий или доли смешивания, поэтому это следует трактовать как подтвержденное направление, а не как полный рецепт.
Механизм самооценки и исправления GLM-6.0
Дорожная карта связывает Full Self-Training с самооценкой, обнаружением ошибок, исправлением и самоочищением данных. На практике модели нужно будет оценивать траектории, пересматривать неудачные шаги, отбрасывать ненадежные данные и решать, когда дальнейшая итерация больше не улучшает показатели, измеренные независимо. Дизайн оценщика и правила остановки не раскрыты.
Материал GLM-6.0 and Full Self-Training disclosure следует читать вместе с public proceeds allocation.
Что мы знаем и чего не знаем
Публичные данные подтверждают дорожную карту, но не готовую спецификацию. Таблица отделяет подтвержденное направление от открытых вопросов, чтобы изложение не превращало заявленные намерения в неподтвержденные продуктовые заявления.
| Утверждение | Статус доказательств | Что подтверждено | Что остаётся неизвестным |
|---|---|---|---|
| Имя GLM-6.0 | Публично обозначено | Z.AI назвала модель следующего поколения GLM-6.0. | Дата релиза и окончательное позиционирование. |
| Full Self-Training | Подтверждённая карта | Это заявленный стратегический приоритет. | Детали реализации и масштабируемость. |
| Предобучение → Промежуточное → Постобучение | Подтверждённое направление | Самообучение предполагается на всём жизненном цикле обучения. | Датасеты, валидаторы, границы стадий и доли данных. |
| Самооценка и исправление | Подтверждённая цель | Дорожная карта включает самоочищение, обнаружение ошибок и исправление. | Надёжность, независимая верификация и критерии остановки. |
| Спецификации | Не раскрыты | Нет полной публичной спецификации. | Параметры, окно контекста, модальности, цена и идентификатор API. |
| Бенчмарки | Не раскрыты | Нет официальных результатов GLM-6.0. | Баллы, методология и воспроизводимые независимые результаты. |
Что такое Full Self-Training и как это работает
Full Self-Training — это замкнутый цикл обучения, в котором модель помогает создавать задачи или среды, пытается их решить, оценивает получившиеся траектории, исправляет слабые шаги и возвращает принятый опыт обратно в обучение. Важный сдвиг — от одноразового конвейера синтетических данных к непрерывно управляемому процессу.
- Генерация: конструировать задачи, инструментальные среды и возможные пути решения.
- Действие: выполнять задачи и сохранять действия, наблюдения и промежуточные рассуждения как траектории.
- Оценка и исправление: оценивать исходы валидаторами, обнаруживать ошибки, пересматривать неудачные шаги и отклонять низкоуверенные примеры.
- Обучение и остановка: учиться на принятых примерах, продолжая цикл только пока независимые оценки показывают полезное улучшение.
Расширение этого контура на предобучение, промежуточное обучение и постобучение позволит GLM-6.0 улучшать качество данных, формирование способностей и выравнивание задач на разных стадиях. Архитектура по-прежнему зависит от надёжных оценщиков: без независимых проверок самообучение может вознаграждать собственные слепые зоны.
Как Full Self-Training может изменить GLM 6.0?
Задуманную конструкцию разумнее понимать как архитектуру системы, а не как один новый блок в Transformer. Она стремится замкнуть контур вокруг модели, чтобы модель всё больше помогала создавать ресурсы, необходимые для следующего цикла обучения.
Как GLM 6.0 может производить тренировочные данные?
Первый контур — самопроизводство данных. Вместо зависимости только от человеческих или внешне собранных датасетов модели могут использовать самоигру, проверки на основе правил, результаты исполнения, оценку моделью и выборочные проверки человеком для генерации и фильтрации новых примеров. Принятые примеры затем возвращаются в предобучение, промежуточное обучение и постобучение.
Ключевое ограничение — верификация: недорогая синтетическая генерация полезна только тогда, когда система способна выявлять корректные, разнообразные и не вырождающиеся примеры. Практический контур: генерация моделью → исполнение задачи → проверка правилами или инструментами → фильтрация → переобучение.
Как GLM 6.0 может конструировать тренировочные среды?
Второй контур — самоконструирование сред. Агенты могут собирать или преобразовывать реальные задачи, пытаться их решать, создавать валидаторы и проверять, является ли задача вообще разрешимой, прежде чем она станет обучающим материалом. Это особенно важно для кодинга и агентной работы, где терминальное состояние, вывод инструментов, состояние браузера, результаты тестов и восстановление после отказов дают более сильную супервизию, чем текстовые ответы.
Цель оценки смещается от правдоподобности ответа к тому, достигается ли успех действия, является ли результат независимо проверяемым и способен ли агент восстанавливаться после неудачи.
Как GLM 6.0 может оптимизировать свою обучающую инфраструктуру?
Третий контур — самооптимизация инфраструктуры. На практике это лучше трактовать как инженерии систем с помощью ИИ: сильная кодовая модель предлагает изменения для операторов, ядер, планирования, кэширования или кода сервинга, а автоматические бенчмарки и подконтрольная человеку валидация решают, какие изменения принять.
Получающийся цикл: лучшая модель → лучшие системные предложения → подтверждённые приросты эффективности → больше обучающих экспериментов → ещё лучшая модель. Человеческая проверка и воспроизводимые бенчмарки остаются контрольными точками, а не опциональными дополнениями.
Что текущая база GLM 5.3 Flash говорит о GLM 6.0?
Поскольку у GLM 6.0 нет публичной карточки модели, наиболее корректное сравнение — разделить текущие измеренные возможности GLM и направление следующего поколения. Z.AI описывает GLM-5.3-Flash как MoE-модель с 320B total и 18B active, обученную на 30T-токенах мультимодального корпуса. Это спецификации GLM-5.3-Flash, а не GLM 6.0.
| Измерение сравнения | GLM-5.3-Flash API в CometAPI | Раскрытое направление GLM 6.0 |
|---|---|---|
| Статус релиза | Доступна | В разработке; окончательное имя продукта не подтверждено цитируемой публикацией |
| Параметры | 320B total / 18B active | Не раскрыты |
| Ядро архитектуры | MoE; гибридная разреженная + линейная attention; mHC | Не раскрыто на уровне блоков |
| Обучающие данные | Мультимодальный корпус на 30T токенов | Самопроизводимые данные, задуманные для рекурсивного контура |
| Мультимодальность | Нативный мультимодальный ввод | Единое мультимодальное моделирование — направление исследований, не опубликованная спецификация |
| Стадии обучения | Опубликованный поэтапный рецепт обучения | Самообучение на стадиях пред-, промежуточного и постобучения |
| Обучающие среды | Среды, спроектированные исследователями и забенчмаркенные | Агенты помогают конструировать и валидировать среды |
| Верификация | Существующие пайплайны оценки и обучения | Более сильная самооценка, обратная связь исполнения и самоверификация |
| Инфраструктура | Оптимизированный стек инференса | Модели помогают оптимизировать инфраструктуру |
| Детали API | Опубликованный ID модели и живой API | Не раскрыты |
В релизном тексте Z.AI указывает приблизительно 3,0× меньше вычислений на attention и 4,4× меньший размер KV-cache для GLM-5.3-Flash по сравнению с GLM-5.3 API. Сопровождающая официальная графика маркирует сравнение на одном миллионе токенов как 3,40× для вычислений attention и 3,80× для KV-cache на слой. Поскольку два официальных материала используют разные цифры, их следует приводить в соответствующих контекстах, а не объединять в одно измерение.
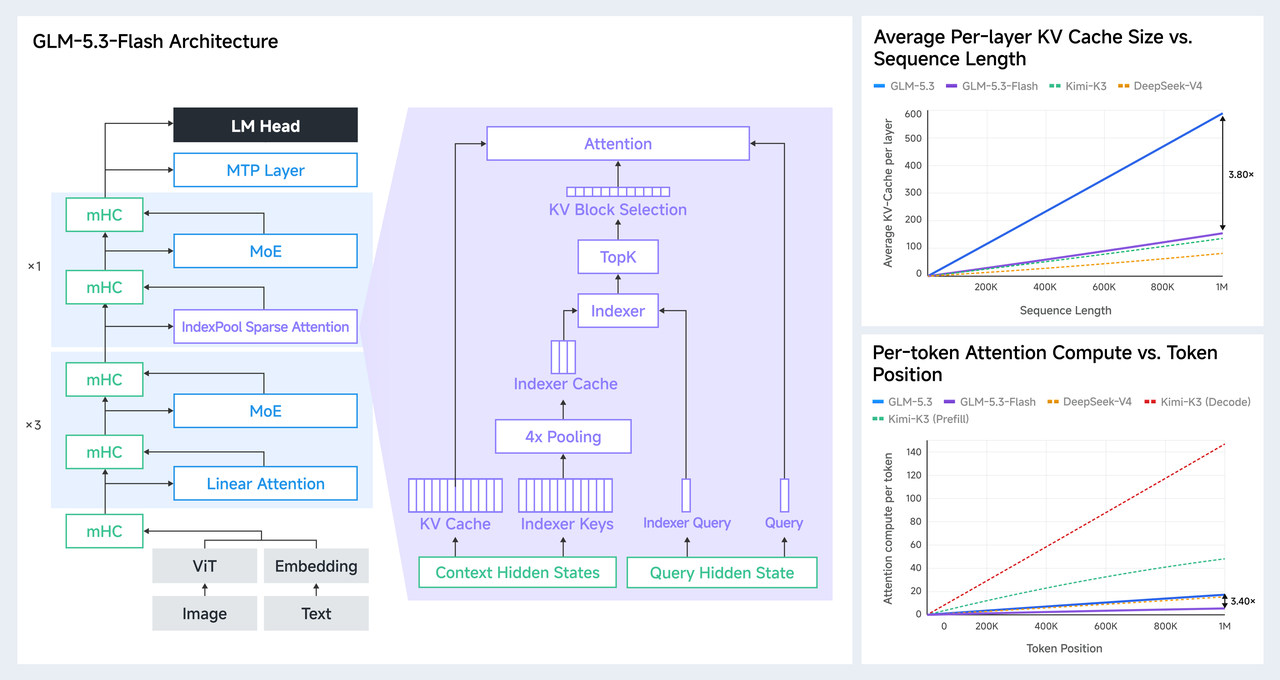
Официальная схема архитектуры и сравнение эффективности GLM-5.3-Flash, опубликованные Z.AI
Какие результаты бенчмарков формируют базовый уровень GLM 6.0?
Проверенной публичной таблицы бенчмарков GLM 6.0 нет. Текущее поколение GLM служит лишь базой, поскольку оценки ниже измеряют планирование, кодинг, использование инструментов, автоматизацию и длинные траектории исполнения — способности, наиболее релевантные заявленному направлению Full Self-Training.
| Официальная оценка Z.AI | GLM-5.3-Flash | GLM-5.2 | Сообщаемая разница |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
Сравнение многомерно, а не сводится к одному интегральному баллу. GLM-5.3-Flash демонстрирует наибольшие заявленные приросты на AutomationBench (+22,6), Toolathlon Verified (+18,5) и DeepSWE (+17,2), в то время как разница на HLE-with-Tools составляет лишь +0,6. Этот рисунок намекает на более сильные приросты в задачах агентного исполнения, чем во всех формах рассуждений с инструментами. Это не предсказывает баллы GLM 6.0.
Почему эти бенчмарки важны
Бенчмарки важны здесь только если они выявляют способности, которые призван улучшить Full Self-Training. Шесть категорий в таблице ниже образуют прогрессию от получения корректной работы к поддержанию эффективного поведения в реальных средах. Кодинг проверяет, может ли модель выполнить сложную задачу; использование инструментов — может ли она превратить действие в обратную связь и выбрать следующий шаг; а автоматизация — может ли она сохранять этот цикл на длинном рабочем процессе.
| Категория бенчмарка | Почему это важно для GLM-6.0 |
|---|---|
| Coding | Проверяет выполнение сложных задач |
| Tool Use | Проверяет цикл «действие → обратная связь» |
| Automation | Проверяет выполнение длинных рабочих процессов |
| HLE | Проверяет решение сложных задач экспертного уровня |
| GDPval | Проверяет качество профессиональной работы |
| Multimodal | Проверяет использование визуальной обратной связи |
Затем HLE повышает сложность решаемых задач, GDPval спрашивает, полезен ли результат в профессиональной работе, а мультимодальная оценка проверяет, могут ли визуальные наблюдения направлять последующие действия. Вместе взятые, шесть категорий переходят от изолированной компетентности к сквозному завершению задач: сгенерировать план, действовать, получать обратную связь, исправлять ошибки и продолжать до достижения цели.
Будущий результат GLM-6.0 будет значим не потому, что даст более высокий агрегированный балл, а потому, что приросты по этим измерениям покажут перенос самогенерируемого обучающего опыта в надёжное реальное исполнение. Итоговая цель Full Self-Training — не повышение тестовых баллов, а повышение способности модели завершать реальные задачи.
Почему Full Self-Training может быть важен для GLM 6.0?
Суть не в том, что GLM 6.0 просто «будет тренироваться сама». Более существенное изменение — всё большая часть конвейера разработки может стать машинно-генерируемой и машинно-верифицируемой. Сегодня исследователи всё ещё выполняют большую часть работы вокруг модели: собирают данные, конструируют задачи, строят оценщики, конструируют среды, диагностируют отказы и настраивают системное ПО. Full Self-Training продвигает модель в большее число этих стадий.
Если подход сработает, важной масштабной переменной станет меньше «сколько параметров можно добавить», и больше — «сколько полезных, проверенных циклов обучения можно выполнить на единицу вычислений». Это практическая интерпретация рекурсивного самоулучшения, а не научно-фантастическая версия неограниченной автономной само модификации.
Обозначенную стратегию следует оценивать как инженерный контур обратной связи с валидаторами, воспроизводимыми средами, инфраструктурными бенчмарками и человеческими контролями — а не как свидетельство неограниченного автономного самоулучшения.
Что может пойти не так с Full Self-Training?
Контур самообучения может так же эффективно накапливать ошибки, как и полезный опыт. Четыре режима отказа заслуживают особого внимания:
- Усиление ошибок: слабые синтетические траектории могут стать будущими обучающими данными, позволяя правдоподобным, но неверным паттернам подкреплять себя.
- Манипулирование вознаграждением и оценщиком: если одна и та же система генерирует работу и оценивает её, она может оптимизироваться под щели в валидаторе, а не под реальный успех задачи.
- Сужение распределения: повторное обучение на модель-генерируемых данных может снижать разнообразие и ухудшать обработку редких реальных случаев.
- Давление со стороны затрат, безопасности и управления: конструирование сред, доступ к инструментам и длительные итерации увеличивают потребление вычислений и расширяют поверхность атаки.
Достоверная реализация GLM-6.0, таким образом, нуждается в независимых валидаторах, происхождении данных, порогах приёма, тестах «красной команды», человеческих аудитах и явных правилах остановки. Самоисправление полезно только тогда, когда сигнал исправления надёжнее исправляемого поведения.
Когда может стать доступен API GLM 6.0?
Z.AI не публиковала дату релиза API GLM 6.0, ID модели, окно контекста, максимальную длину вывода, цену за токен, обязательства по открытию весов или требования к развёртыванию. Любое конкретное значение сейчас было бы спекуляцией.
Разработчики могут оценить текущее направление через GLM-5.3-Flash API в CometAPI для нативных мультимодальных и ориентированных на эффективность нагрузок, GLM-5.3 API в CometAPI для текущей флагманской ветки, или GLM-5.2 API в CometAPI как базу предыдущего поколения.
Заключение
GLM-6.0 важен меньше как обещанный продукт, и больше — как проверка, сможет ли Z.AI превратить Full Self-Training в воспроизводимую инженерную систему. Дорожная карта связывает самогенерируемый опыт, стадийное обучение, самооценку, исправление и управляемую итерацию; решающими свидетельствами будет то, улучшат ли эти механизмы надёжность на длинных, инструментально насыщенных реальных рабочих процессах.
Этих свидетельств пока недостаточно. Z.AI не опубликовала карточку модели GLM-6.0, дату релиза, идентификатор API, цены или набор бенчмарков. Пока эти артефакты не появятся, защитимый вывод узок: компания раскрыла направление обучения, а не готовый профиль возможностей.
Итоговая цель Full Self-Training — не повышение тестовых баллов, а повышение способности модели завершать реальные задачи.