
Сводка
GPT-6 Astra демонстрирует выдающиеся headline-показатели. Наибольшие приросты наблюдаются там, где рассуждение нужно превратить в действие: работа в терминале, использование ПО, автоматизация, извлечение информации из длинного контекста, научные рабочие процессы и кибербезопасность. На уже насыщенных академических тестах улучшения относительно предыдущего поколения OpenAI часто значительно скромнее.
Модель сочетает контекстное окно на 1 050 000 токенов с широким набором инструментов. Опубликованные OpenAI эталонные результаты выполнения задач предполагают, что практический апгрейд наиболее заметен в работе с длинным горизонтом, однако конструкция harness’а, уровень рассуждения, задержка и доступ к инструментам существенно влияют на результат.
Ключевые выводы
- Наиболее явные превосходства Astra — в агентном выполнении действий, а не во всех видах ответов на вопросы.
- Результаты Terminal-Bench, AutomationBench, computer-use и миграции баз данных показывают существенно больший прогресс, чем GPQA или DeepSWE.
- Результат ARC-AGI-3 демонстрирует, что состояние модели, управление контекстом и evaluation harness могут определять итоговый балл.
- Большое контекстное окно важно только тогда, когда информация остаётся извлекаемой у предела; MRCR даёт больше информации, чем одна лишь заявленная ёмкость.
- Более высокие цены за токены не означают автоматически более высокую стоимость задачи, если модели требуется меньше токенов, шагов, повторов или человеческих правок.
- Производственные решения должны сопоставлять вместе долю успеха, затраченное время, полную стоимость, надёжность инструментов и нагрузку на коррекцию.
GPT-6 Astra кратко
OpenAI указывает до 128 000 выходных токенов, вход по тексту и изображениям, выход по тексту и уровень рассуждения от low до max. Эти спецификации делают возможными крупные, многосоставные рабочие процессы, но сами по себе не доказывают, что модель извлечёт правильные доказательства или надёжно завершит задачу.
| Официальная спецификация | GPT-6 Astra в CometAPI | Практическое значение |
|---|---|---|
| Model ID | gpt-6-astra | Стабильный идентификатор для маршрутизации по API |
| Context window | 1,050,000 tokens | Поддерживает крупные репозитории, архивы и истории агентов |
| Maximum output | 128,000 tokens | Позволяет большие отчёты, патчи и структурированные артефакты |
| Knowledge cutoff | April 30, 2026 | Более поздние факты требуют инструментов или предоставленных источников |
| Input | Text and images | Поддерживает документы, скриншоты, диаграммы и смешанные данные |
| Output | Text | Генерирует прозу, код и структурированный текст |
| Reasoning effort | low, medium, high, xhigh, max | Обмен задержки и стоимости на более глубокий поиск |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | Обеспечивает сквозные рабочие процессы, а не изолированные ответы |
| OpenAI Standard input | $10 per million tokens | Размер ввода и повторное использование кэша влияют на общую стоимость |
| OpenAI cached input | $1 per million tokens | Применяется при повторном использовании префикса подсказки из кэша |
| OpenAI cache writes | $12.50 per million tokens | Биллингуется по 1.25× от тарифа неcached-ввода |
| OpenAI Standard output | $50 per million tokens | Объёмные выходы могут доминировать в стоимости задачи |
| Requests above 272K input tokens | Input и cache ставки ×2; output ставка ×1.5 | Повышенные ставки применяются ко всему запросу |
Предел контекста измеряет ёмкость, а не пригодную к использованию память. Список инструментов измеряет доступность, а не успешность выполнения. Бенчмарки необходимы, чтобы проверить, превращаются ли эти спецификации в выполненную работу.
Что показывают результаты бенчмарков GPT-6 Astra?
Портфель демонстрирует неоднородную картину. Astra едва выходит за пределы Sol на некоторых академических и программно-логических тестах, но даёт двузначные приросты в работе в терминале, автоматизации, миграции баз данных, визуальном взаимодействии, извлечении из длинного контекста и продвинутой математике.
| Опубликованный бенчмарк | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 п. п. |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 п. п. |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 п. п. |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 п. п. |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 п. п. |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 п. п. |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 п. п. |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 п. п. |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 п. п. |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 п. п. |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 п. п. |
Выделяются три кластера. Во-первых, разрывы на 1,4 пункта в DeepSWE и GPQA указывают на ограниченное приращение на задачах, где сильные модели уже работают хорошо. Во-вторых, приросты свыше 20 пунктов в Terminal-Bench, AutomationBench, миграции баз данных и извлечении на миллионных токенах показывают гораздо более существенное изменение в исполнении. В-третьих, ARC-AGI-3 — выброс, интерпретация которого зависит от harness’а.
Результат независимого тестирования
Artificial Analysis показывает у Astra и Sol примерно 61 в своём Intelligence Index, при этом фиксируя гораздо более явный прирост в своём Coding Agent Index. Это независимо подтверждает картину из данных OpenAI: наибольшее улучшение сосредоточено в агентном выполнении.
При максимальном усилии в Codex harness Astra reportedly использует примерно треть токенов от Sol в Coding Agent Index. В Intelligence Index её использование токенов падает всего на ~10%. Поскольку ставка за токен у Astra выше, эти два профиля эффективности создают разную экономику.
| Независимая оценка | Наблюдаемый результат | Производственная интерпретация |
|---|---|---|
| Intelligence Index | Небольшое отделение от Sol | Широкое рассуждение может не оправдывать большой ценовой премии |
| Coding Agent Index | Явное агентное улучшение | Меньше токенов может компенсировать более высокую ставку |
| AA-Omniscience | Hallucination rate падает с 92% до 51% на max effort | Лучшая воздержанность важна для систем исследований и извлечения |
| Длиннорамочные знания | Смешанный прогресс по задачам | Нужна локальная оценка |
Ни один независимый бенчмарк не сертифицирует производственную фактичность или безопасность. Командам следует отдельно оценивать правильные ответы, обоснованную неопределённость, неподкреплённые заявления и нарушения исходных ограничений.
Почему Astra лучше подходит для долгосрочной агентной работы?
GPT-6 Astra добавляет три управления, предназначенные для работы, которая меняется по ходу выполнения. Долговременная надёжность также зависит от всей системы контекста: окно контекста задаёт ёмкость; компакция контролирует, как сжимается старый материал; persisted reasoning переносит вперёд релевантное состояние модели; retrieval делает ранние доказательства доступными для поиска; а приложение должно сохранять важные выводы инструментов, результаты тестов, неудачные подходы и требования пользователя. Эти механизмы следует тестировать вместе с harness’ом агента.
- Async tool calling: Astra может продолжать независимые рассуждения или вызывать другие инструменты, пока приложение выполняет долго работающий инструмент.
- Mid-turn steering: приложение может отправить коррекцию или новое требование по WebSocket, не отбрасывая уже выполненную работу.
- Mid-conversation reasoning adjustment: обновление конфигурации может повысить или понизить уровень рассуждения при сохранении кэшированного префикса подсказки.
Где Astra действительно улучшилась
Агентное кодирование: работа в терминале — более крупное обновление
Terminal-Bench 4.0 оценивает способность агента проходить сложные терминальные задачи, а не просто генерировать изолированный код-ответ. Astra достигает 57.9%, что на 20.6 процентных пункта выше Sol и на 2.1 пункта выше Fable. Это существенное поколенческое улучшение для OpenAI, но куда более узкое преимущество над другой фронтирной агентной системой.
DeepSWE рассказывает иную историю: 74.1% у Astra и 72.7% у Sol. Разрыв в 1.4 пункта предостерегает от обобщения по одному кодовому бенчмарку. Похоже, Astra прибавляет больше там, где кодирование требует взаимодействия со средой, итераций, сохранения состояния и верификации.
Database Migration Tasks усиливает эту интерпретацию. Результат 63.9% на 21.2 пункта выше Sol и на 6.1 пункта выше Fable. Миграция объединяет понимание кода, использование инструментов, последовательность шагов и операционное суждение — такой составной workflow, где небольшие улучшения в рассуждении могут складываться в гораздо более крупные приросты завершённости.
Для кодовых агентов оценивайте модель и harness вместе. Инструкции к репозиторию, терминальные инструменты, поведение ретраев, сохранение контекста и выполнение тестов — всё это влияет на измеряемый результат.
Использование компьютера: важны и доля успеха, и время выполнения
На Agents’ Last Exam GPT-6 Astra набирает 59.3% против 53.6% у GPT-5.6 Sol: прирост 5.7 п. п. Это добавляет более широкий результат по агентным задачам к показателям OSWorld 2.0 и ScreenSpot-Pro в обзоре выше.
Помимо точности, сравнение runtime в OSWorld добавляет ещё одно практическое измерение: OpenAI сообщает около 40 минут на задачу для Astra против примерно 75 минут для Sol, то есть примерно на 47% меньше времени при одновременном росте доли успешных задач.
Агент, который лишь немного чаще достигает успеха и при этом заканчивает куда быстрее, может обеспечить большой рост пропускной способности. Поэтому в тестах закупки следует указывать долю успеха, затраченное время, вызовы инструментов, повторы и человеческие вмешательства — а не одну только точность.
Автоматизация и профессиональная работа
AutomationBench поднимается с 18.1% до 41.4%, прирост 23.3 пункта. Абсолютный балл всё ещё далёк от совершенства, но изменение профиля отказов значимее, чем одно очко возле насыщения. На BenchCAD Astra достигает 95.9%, опережая Sol на 12.6 пункта и Fable на 11.6 пункта.
Эти результаты подтверждают конкретный тезис: Astra лучше превращает инструкции в последовательности проверенных действий. Они не доказывают равных приростов для каждого бизнес-процесса. Производственный процесс может включать шаги аутентификации, проприетарные интерфейсы, неоднозначные политики или форматы данных, отсутствующие в бенчмарке.
Наука
Наука — одно из наиболее ярких усилений Astra. На FrontierMath Tier 4 v2 Astra достигает 97.6% против 83.0% у Sol и 87.8% у Fable. Превосходство над Sol на 14.6 пункта существенно, хотя бенчмарк охватывает выбранное распределение задач, а не весь научный workflow.
Кибербезопасность
Кибербезопасность — второе крупное усиление, с большими ставками, чем обычное движение в таблице лидеров. На ExploitBench за июнь—август 2026 Astra набирает 39.0% против 5.5% у Sol. OpenAI сообщает, что этот более новый набор ориентирован на уязвимости последних трёх месяцев для сокращения исторической огласки. В оценке кибербезопасности OpenAI Astra продемонстрировала способность обнаруживать и эксплуатировать две ранее неизвестные уязвимости нулевого дня в ходе контролируемого тестирования. Это важно, поскольку оценка была построена на недавно раскрытых уязвимостях, а не давних проблемах, снижая вероятность, что результат объясняется запоминанием примеров. Этот результат позволил Astra достичь порога Critical по кибербезопасности у OpenAI и, следовательно, изменил требования к средствам защиты при развёртывании. Важность не в том, что Astra способна автономно проводить неограниченные кибероперации, а в том, что уровень её возможностей меняет требования к средствам защиты. Системы с более сильными способностями к обнаружению и эксплуатации уязвимостей требуют более строгих механизмов контроля доступа, мониторинга, изоляции и человеческой проверки.
Долговременные задачи: контекстное окно — не вся история
Контекстное окно Astra на 1 050 000 токенов описывает ёмкость, а не непрерывность. Долговременная производительность также зависит от компакции, постоянного состояния, возможности поиска по раннему контексту, сохранения состояния рассуждений и сохранения выводов инструментов. В MRCR v2 Astra набирает 100.0% при 256K–512K и 96.3% при 512K–1M, в то время как Sol показывает 91.5% и 73.8%. Разрыв в 22.5 пункта на самой длинной дистанции показывает, что пригодная к использованию извлекаемость у предела важнее одной лишь заявленной ёмкости.
MRCR остаётся синтетическим тестом извлечения, поэтому производственная оценка должна сохранять свидетельства, которые часто теряются в суммаризациях: почему предыдущая правка провалилась, поведение конкретного компонента, результаты тестов, исторические требования и детали, скрытые в выводах инструментов. Репозитории и исследовательские архивы следует тестировать также с дублирующимися именами, перекрёстными ссылками, устаревшими политиками, противоречивыми источниками и длинными отвлекающими отрывками. Это отделяет чистую ёмкость контекста от поведения сохранения контекста и извлечения, которое реально нужно длиннорамочному агенту.
Сохранение контекста: почему Astra отличается от традиционных систем длинного контекста
Традиционные длинноконтекстные workflow обычно следуют шаблону:
context → compaction → summary → continue
Этот подход снижает использование токенов, но вводит критический риск: важная промежуточная информация может исчезнуть во время суммаризации.
Утерянной информацией часто оказывается не сам окончательный ответ, а операционные детали, необходимые для будущих решений:
- почему провалилась предыдущая правка;
- какой компонент проявил аномальное поведение;
- какой результат теста изменил направление реализации;
- какое требование пользователя было добавлено позже;
- какой вывод инструмента содержал важные доказательства.
GPT-6 Astra устраняет это ограничение, сочетая механизмы сохранения контекста и извлечения внутри долгосрочных агентных workflow.
Вместо того чтобы опираться только на сжатые суммаризации, система может сохранять важные заметки, извлекать раннюю информацию по требованию и поддерживать непрерывность между несколькими взаимодействиями с инструментами.
Для кодовых агентов, таких как Codex, это означает, что в длинной отладке можно сохранить:
- предыдущие неудачные эксперименты;
- изменения в репозитории;
- выводы тестов;
- архитектурные решения;
- нерешённые проблемы.
Следовательно, ценность контекстного окна Astra на 1 млн токенов — не только объём принимаемой информации, но и способность системы сохранять и возвращать нужную информацию спустя часы взаимодействия.
Рассуждение и интерпретация
ARC-AGI-3: harness — часть результата
ARC-AGI-3 — самое наглядное доказательство того, что фронтирный бенчмарк может измерять систему, а не изолированную модель. ARC Prize сообщает 62.7% со Standard harness при max effort и 99.9% с Provider Adapter при high effort.
| Оценка ARC Prize | Standard Harness | Provider Adapter | Прирост Adapter |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 п. п. |
| xhigh | 59.3% | 98.4% | +39.1 п. п. |
| high | 54.8% | 99.9% | +45.1 п. п. |
| medium | 38.6% | 98.4% | +59.8 п. п. |
| low | 17.5% | 98.0% | +80.5 п. п. |
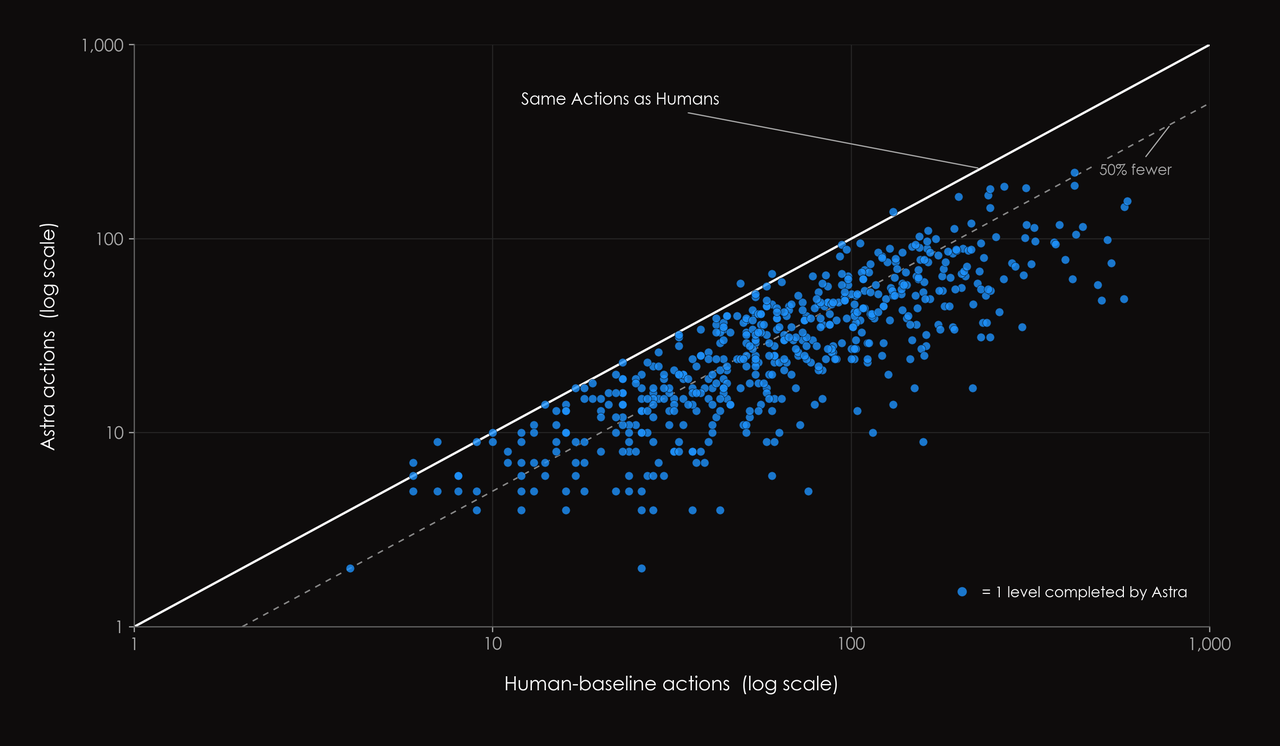
Сравнение ARC Prize по эффективности действий Astra в разных evaluation harness’ах
Политика provider-neutral harness требует, чтобы модель сохраняла важную информацию в видимом состоянии. Provider Adapter сохраняет дополнительное состояние рассуждений и использует специфичное для провайдера управление контекстом. На общих решённых парах задач с рассуждением ARC Prize сообщает о 3.66× более быстром выполнении и на 49% меньшем общем числе токенов с адаптером.
Результат 99.9% измеряет конкретную систему model–provider–adapter и не должен считаться независимой от harness оценкой «сырого» интеллекта модели. Архитектура контекста — часть оцениваемой системы.
Усилие на рассуждение масштабируется не линейно
Таблица ARC также показывает, что максимальное усилие не всегда даёт лучший балл. High effort достигает 99.9% с Provider Adapter, тогда как max — 98.6%. В Standard harness наилучший результат показывает max.
OpenAI отмечает, что значения в таблице запуска обычно используют лучший наблюдавшийся уровень рассуждения. Такой подход оценивает потолок производительности, но не определяет лучшую производственную конфигурацию. Командам следует тестировать несколько уровней усилий и рассчитывать предельный прирост качества на каждую дополнительную секунду и доллар.
Математика и академическое рассуждение
FrontierMath Tier 4 v2 поднимается с 83.0% до 97.6%, прирост 14.6 пункта. Это крупное улучшение в бенчмарке, но не доказательство того, что фронтирная математика решена. Оценка охватывает выбранное распределение задач и не измеряет каждую стадию математических исследований, включая выбор задач, формальную проверку доказательств, долгосрочную программу разработки или состязательное рецензирование.
GPQA Diamond даёт противоположную картину: 96.0% у Astra, 94.6% у Sol, 93.7% у Fable и 95.3% у Gemini 3.8 Flash. Модели плотной группой подходят к потолку. Сообщить о разнице Astra–Sol в 1.4 пункта корректно, но объявлять это широкой «революцией интеллекта» — преувеличение.
Критическая способность + меры защиты
| Оценка по кибербезопасности | Astra | Sol | Абс. прирост |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 п. п. |
| ExploitGym | 42.4% | 30.3% | +12.1 п. п. |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 п. п. |
| SRE-Bench | 88.0% | 55.9% | +32.1 п. п. |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 п. п. |
OpenAI создала ExploitBench (June–August 2026) из уязвимостей, раскрытых в предыдущие три месяца, уменьшая шанс, что результат завышен исторической осведомлённостью. Astra набирает 39.0% на этом наборе против 5.5% у Sol, и OpenAI сообщает, что Astra обнаружила и эксплуатировала две ранее неизвестные zero-day уязвимости. Эти результаты способствовали тому, что Astra стала первой широко развёрнутой моделью OpenAI, достигшей порога Critical по кибербезопасности, что напрямую повлияло на меры защиты и политику доступа.
Как читать баллы у насыщения
Баллы выше 90% требуют более аккуратной формулировки, чем средние значения. Переход с 50% на 60% решает десять дополнительных задач из ста. Переход с 95% на 96% решает лишь одну дополнительную задачу из ста, хотя сокращает число оставшихся ошибок с пяти до четырёх — на 20%. Оба описания математически верны, но поддерживают очень разные заголовки.
Обратная осторожность применима к низкобалльным бенчмаркам. Рост с 18.1% до 41.4% всё ещё далёк от надёжной автономной работы, но более чем удваивает число успешных случаев и может преобразить надзорный workflow. Абсолютный балл определяет готовность системы; размер улучшения показывает скорость изменения возможностей. Производственные решения нуждаются в обоих.
Многомерное сравнение
| Измерение | Astra | Sol | Fable | Сигнал для решения |
|---|---|---|---|---|
| Общая академическая логика | Отлично; часто близко к насыщению | Рядом | Конкурентоспособна | Небольшие разрывы редко решают развёртывание |
| Выполнение в терминале | Топ-уровень | Большой поколенческий разрыв | Близкий конкурент | Тестируйте полный кодовый harness |
| Использование компьютера | Выше успех и ниже runtime | Медленнее и менее точно | Недостаточно сопоставимых данных в таблице запуска | Мерите успех на час |
| Извлечение из длинного контекста | Сильно на ~1M токенов | Существенное ухудшение у предела | Недостаточно напрямую сопоставимых данных | Применяйте продуктообразные тесты извлечения |
| Управление рассуждением | low через max | Иной «профиль» усилия | Adaptive-thinking подход | Настраивайте конфигурацию, а не только модель |
| Киберспособность | Качественно более высокий риск-уровень | Более низкие опубликованные результаты | Здесь не сравнивалось | Важны меры защиты и политика доступа |
| Экономика токенов | Выше ставка; иногда меньше токенов | Ниже ставка | Зависит от нагрузки | Сравнивайте стоимость за успешную задачу |
Результат зависит от нагрузки. Astra наиболее убедительна, когда задача требует устойчивого взаимодействия с инструментами и средой, восстановления после отказа или надёжного извлечения по очень большим контекстам. Sol может оставаться более экономичным для ограниченной работы с умеренным контекстом и небольшим числом итераций. Fable — близкий конкурент в терминале и лидирует в некоторых внешних академических оценках, поэтому бенчмарк на уровне приложения полезнее, чем заключение на уровне провайдера.
Кому стоит использовать GPT-6 Astra?
| Сценарий использования | Рекомендация |
|---|---|
| Простая классификация | Не обязательно оправдывает использование Astra |
| Простая суммаризация | Не обязательно оправдывает использование Astra |
| Стандартный RAG | Сначала сравните стоимость и производительность |
| Синтез и анализ длинных документов | Стоит протестировать Astra |
| Агентное кодирование | Настоятельно рекомендуется тестировать |
| Использование компьютера | Настоятельно рекомендуется тестировать |
| Многошаговая автоматизация | Настоятельно рекомендуется тестировать |
| Сложные исследования | Стоит протестировать |
| Научные вычисления / спец. ПО | Стоит протестировать |
| Кибербезопасность | Сильные возможности, но требуют адекватных мер безопасности |
| Высокий поток простых задач | Модели с более низкой стоимостью могут быть выгоднее |
Окупают ли приросты производительности GPT-6 Astra более высокую цену?
GPT-6 Astra заметно дороже GPT-5.6 Sol, но улучшения по бенчмаркам не равномерны по рабочим нагрузкам. Поэтому вопрос цены нельзя решить, сравнивая только ставки за токены.
| Сценарий | Прирост производительности | Обоснование премии |
|---|---|---|
| Простое Q&A | Небольшое улучшение | Обычно не стоит премии |
| Кодовый агент | Большое улучшение | Премия может быть оправдана |
| Длинноконтекстный анализ | Существенное улучшение | Зависит от потребностей извлечения |
| Компьютерная автоматизация | Сильное улучшение | Часто стоит тестировать |
| Общее рассуждение | Ограниченное улучшение | Внимательно сравните стоимость |
По стандартным ставкам OpenAI GPT-6 Astra стоит $10 за миллион входных токенов, $1 за миллион токенов кэшированного ввода, $12.50 за миллион токенов записи в кэш и $50 за миллион выходных токенов. Стандартный ввод и вывод — в 2.5× от $4 и $20 для GPT-5.6 Sol. Когда запрос превышает 272K входных токенов, у Astra ставки за ввод и кэш удваиваются, а ставка за вывод повышается в 1.5× для всего запроса.
Премия в цене наиболее чётко соответствует агентной работе. Astra прибавляет более 20 п. п. в Terminal-Bench, AutomationBench, миграции баз данных и в самом длинном диапазоне MRCR; независимые тесты также сообщают примерно о трети токенов от Sol в Coding Agent Index. Соответствие слабее в широкой логике, где Intelligence Index практически вровень, а использование токенов падает лишь примерно на 10%. Поэтому решение о покупке следует принимать по стоимости за успешную задачу, включая выход, активность кэша, использование инструментов, затраченное время, ретраи, отказы и человеческие правки.
Cost per successful task
Cost per successful task = (Input cost + Output cost + Tool cost + Retry cost + Human review cost) / Successful tasks
Expected business cost
Expected business cost = API cost + Tool cost + Retry cost + Human-review cost + Failure cost
Метрика решения должна быть равна общей стоимости, делённой на число успешных задач, оцененной на приемлемом пороге качества — а не номинальной цене за миллион токенов.
Как разработчикам бенчмаркать Astra
Публичные таблицы лидеров должны определять, что заслуживает тестирования, а не принимать окончательное решение о развёртывании. Соберите репрезентативный набор задач с рутинными случаями, сложными кейсами, случаями с отсутствующим контекстом, отказами инструментов и противоречивыми инструкциями. Используйте один и тот же производственный промпт, разрешения, исходные файлы, бюджет времени и критерии завершения для каждой модели.
| Измерение оценки | Метрика | Почему это важно |
|---|---|---|
| Успех задачи | Пройдены критерии приёмки | Предотвращает засчёт убедительных, но неполных ответов |
| Надёжность | Распределение успеха по повторным прогонам | Выявляет нестабильные разовые выигрыши |
| Выполнение инструментов | Подтверждённые успешные действия | Отделяет вызовы инструментов от корректных результатов |
| Фактичность | Подкреплённые фактические утверждения | Измеряет качество доказательств и воздержанность |
| Задержка | Медиана и хвостовое время завершения | Охватывает операционную пропускную способность |
| Стоимость | Общая стоимость за успешную задачу | Включает повторы и неудачные попытки |
| Человеческие усилия | Минуты на правки и ревью | Часто доминируют в реальных развёртываниях |
| Управляемость | Восстановление после изменения требований | Тестирует поведение агента в долгосрочной работе |
API Astra в CometAPI использует model ID gpt-6-astra. Мульти-модельный API делает практичным запуск одной и той же оценки для Astra, Sol, Fable и Gemini без переработки бенчмарка под график одного провайдера. Направляйте требовательные агентные задачи в модель, которая оправдывает свою премию, и используйте более дешёвые модели там, где измеренное преимущество исчезает.
Заключение
Листинг бенчмарков Astra впечатляет, но самые эффектные баллы не автоматически самые полезные. ARC-AGI-3 демонстрирует потенциал провайдер-специфичного агентного harness’а; балл со Standard harness показывает, насколько сильно инфраструктура влияет на результат. GPQA и независимый Intelligence Index показывают, что приросты в обычном рассуждении могут быть скромными. Работа в терминале, автоматизация, использование компьютера, извлечение из длинного контекста, научные рабочие процессы и кибербезопасность рассказывают более важную историю.
Релиз — это меньше про чат-бот, который пропорционально умнеет во всех вопросах, и больше про фронтирный интеллект, который лучше завершает работу. Оправданность переплаты зависит от всей конфигурации модель–система и экономики успешных производственных задач.