Технические характеристики GLM-5-Turbo
| Параметр | GLM-5-Turbo (оценочно / ранний релиз) |
|---|---|
| Семейство моделей | GLM-5 (вариант Turbo – оптимизирован для низкой задержки) |
| Провайдер | Zhipu AI (Z.ai) |
| Архитектура | Смесь экспертов (MoE) с разрежённым вниманием |
| Типы ввода | Текст |
| Типы вывода | Текст |
| Контекстное окно | ~200,000 токенов |
| Макс. число токенов на выходе | До ~128,000 (по ранним сообщениям) |
| Ключевой фокус | Агентные рабочие процессы, использование инструментов, быстрый инференс |
| Статус выпуска | Экспериментальный / частично закрытый исходный код |
Что такое GLM-5-Turbo
GLM-5-Turbo — это вариант семейства моделей GLM-5, оптимизированный по задержке, разработанный специально для рабочих процессов агентов производственного уровня и приложений реального времени. Он основан на крупномасштабной архитектуре MoE GLM-5 (~745B параметров) и смещает акцент на скорость, отзывчивость и надёжность оркестрации инструментов, а не на максимальную глубину рассуждения.
В отличие от базовой GLM-5 (ориентированной на передовые бенчмарки по рассуждению и программированию), версия Turbo настроена для интерактивных систем, конвейеров автоматизации и многошагового выполнения инструментов.
Ключевые возможности GLM-5-Turbo
- Инференс с низкой задержкой: оптимизирован для более быстрого времени отклика по сравнению со стандартной GLM-5, что делает его пригодным для приложений реального времени.
- Обучение с приоритетом агентности: спроектирован вокруг использования инструментов и многошаговых рабочих процессов уже на этапе обучения, а не только за счёт постобучающей тонкой настройки.
- Большое контекстное окно (200K): обрабатывает длинные документы, кодовые базы и многошаговые цепочки рассуждений в одной сессии.
- Высокая надёжность вызова инструментов: улучшено выполнение функций и связывание этапов рабочих процессов для агентных систем.
- Эффективная архитектура MoE: активирует лишь подмножество параметров на токен, балансируя стоимость и производительность.
- Дизайн, ориентированный на продакшн: отдаёт приоритет стабильности и пропускной способности над максимальными показателями бенчмарков.
Бенчмарки и показатели производительности
Хотя специфичные для GLM-5-Turbo бенчмарки пока полностью не раскрыты, он наследует характеристики производительности от GLM-5:
- ~77.8% на SWE-bench Verified (база GLM-5)
- Сильная производительность в агентном программировании и задачах с длинным горизонтом
- Конкурирует с моделями, такими как Claude Opus, и системами класса GPT в рассуждении и программировании
👉 Turbo обменивает часть пиковой точности на более быстрый инференс и лучшую пригодность для работы в реальном времени.
GLM-5-Turbo и сопоставимые модели
| Модель | Сильные стороны | Слабые стороны | Лучший сценарий использования |
|---|---|---|---|
| GLM-5-Turbo | Быстрый, ориентирован на агентность, длинный контекст | Меньшая пиковая глубина рассуждений по сравнению с флагманом | Агенты реального времени, автоматизация |
| GLM-5 (base) | Сильные рассуждения, высокие бенчмарки | Более медленный инференс | Исследования, сложное программирование |
| Модели класса GPT-5 | Лучшие рассуждения, мультимодальность | Более высокая стоимость, закрытость | AI корпоративного уровня |
| Claude Opus (последняя версия) | Надёжные рассуждения, безопасность | Медленнее в агентных циклах | Длительные рассуждения |
Лучшие сценарии использования
- ИИ-агенты и конвейеры автоматизации (многошаговые рабочие процессы)
- Системы чатов реального времени, требующие низкой задержки
- Приложения с интеграцией инструментов (API, поиск, вызовы функций)
- Копилоты для разработчиков с быстрыми циклами обратной связи
- Приложения с длинным контекстом, такие как анализ документов
Как получить доступ к GLM-5 Turbo API
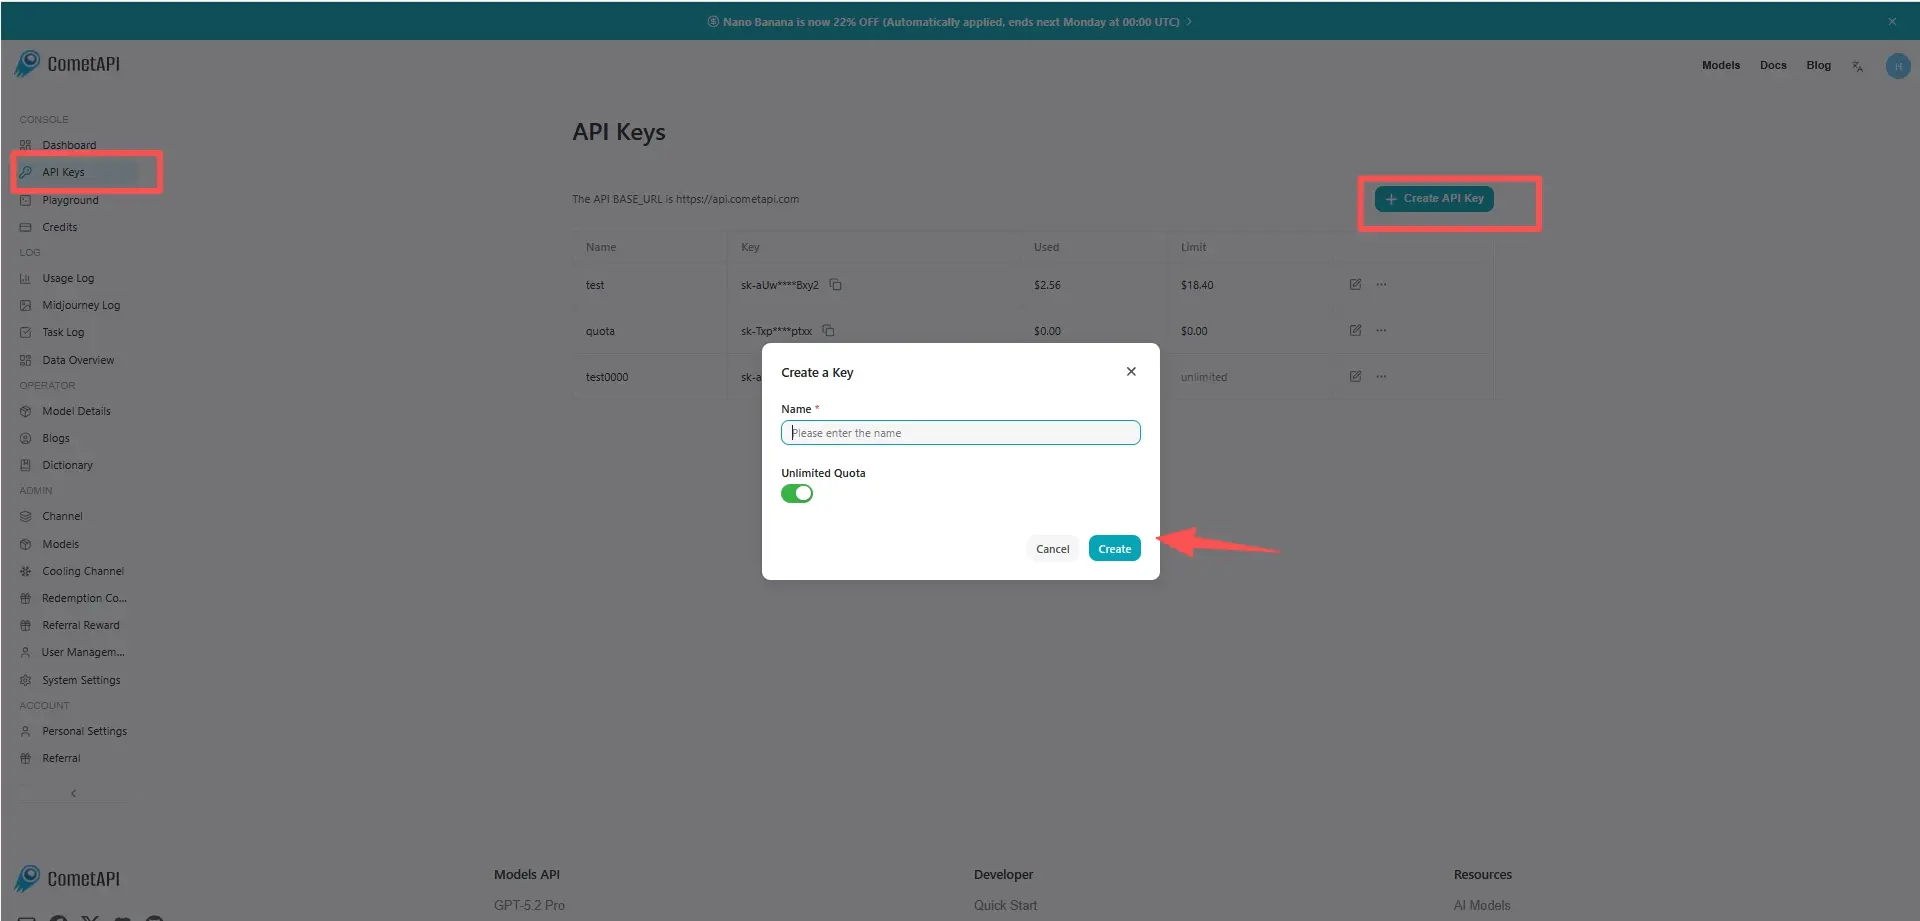
Шаг 1: Зарегистрируйтесь, чтобы получить ключ API
Войдите на cometapi.com. Если вы ещё не являетесь нашим пользователем, сначала зарегистрируйтесь. Войдите в свою консоль CometAPI. Получите учётные данные — ключ API интерфейса. В личном кабинете в разделе токена API нажмите «Add Token», получите ключ токена: sk-xxxxx и отправьте.
Шаг 2: Отправляйте запросы к GLM-5 Turbo API
Выберите конечную точку “glm-5-turbo” для отправки запроса к API и задайте тело запроса. Метод и тело запроса берите из документации API на нашем сайте. Наш сайт также предоставляет тест в Apifox для вашего удобства. Замените <YOUR_API_KEY> на ваш фактический ключ CometAPI из вашего аккаунта. Базовый URL — Chat Completions
Вставьте ваш вопрос или запрос в поле content — именно на него модель ответит. Обработайте ответ API, чтобы получить сгенерированный ответ.
Шаг 3: Получите и проверьте результаты
Обработайте ответ API, чтобы получить сгенерированный результат. После обработки API возвращает статус задачи и выходные данные.