

TL;DR
Claude Opus 5.5 เป็นตัวเลือกเริ่มต้นที่แข็งแรง เพราะมีราคาโทเคนต่ำกว่ามากขณะที่ทำคะแนนเทียบเท่าหรือดีกว่า Fable 5.1 บนการประเมินที่เปิดเผยหลายรายการ โดยคิดราคา $4 ต่อหนึ่งล้านโทเคนอินพุต และ $20 ต่อหนึ่งล้านโทเคนเอาต์พุต เทียบกับ Fable 5.1 ที่ $10 และ $50
Fable 5.1 ยังมีบทบาทเมื่อภารกิจยากผิดปกติ ทำงานยาวนาน มีค่าใช้จ่ายในการลองซ้ำสูง หรือคาดว่าจะทำงานโดยไม่ถูกกำกับใกล้ชิด กฎเชิงปฏิบัติเรียบง่าย: เริ่มด้วย Opus 5.5 แล้วค่อยยกระดับก็ต่อเมื่อการทดสอบในสภาพการผลิตที่เป็นตัวแทนแสดงว่า Fable 5.1 ลดอัตราล้มเหลว การแก้ไข หรือการลองซ้ำได้มากพอที่จะคุ้มค่ากับราคาแบบพรีเมียม
Claude Opus 5.5 vs Claude Fable 5.1 โดยสรุป
| มิติ | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| วันที่เปิดตัว | Sep. 22, 2026 | Sep. 1, 2026 |
| API model ID | claude-opus-5-5 | claude-fable-5-1 |
| คอนเท็กซ์ / เอาต์พุตสูงสุด | 1M / 128K | 1M / 128K |
| อินพุต / เอาต์พุต ต่อ MTok | $4 / $20 | $10 / $50 |
| อ่านแคช ต่อ MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| ย้าย HAProxy C-to-Rust | 9.5 ชั่วโมง; ต้นทุนงานลดลง 51% | 12 ชั่วโมง; ต้นทุนงานฐาน |
| ตัวเลือกความเร็ว | โหมดเร็ว สูงสุด 2.5× ของความเร็วปกติ | ไม่มีโหมดเปิดตัวเทียบเท่า |
| ระดับความพยายามตั้งต้น | เน้นระดับกลาง | สูง |
| การใช้งานเริ่มต้นที่เหมาะสุด | โค้ดแนวหน้าในชีวิตประจำวัน เอเจนต์ การผลิตภายใต้การกำกับ และทราฟฟิก API ปริมาณสูง | งานมูลค่าสูง ยาก ใช้เวลานาน หรือทำงานอัตโนมัติโดยไม่ดูแลใกล้ชิด |
| การเข้าถึง API | Anthropic API และผู้ให้บริการที่เข้ากันได้ รวมถึง CometAPI | Anthropic API และผู้ให้บริการที่เข้ากันได้ รวมถึง CometAPI |
ข้อสังเกตการอ่าน: ตัวเลขเบนช์มาร์กเป็นข้อมูลที่ Anthropic รายงาน และขึ้นอยู่กับระดับความพยายาม ฮาร์เนส มาตรการป้องกัน รุ่นของภารกิจ จำนวนครั้งทดลอง และค่าคลาดเคลื่อนมาตรฐาน ควรเทียบเฉพาะภายใต้เงื่อนไขการประเมินที่ตรงกัน
ข้อสรุปสำคัญ
- อัตราอินพุตและเอาต์พุตมาตรฐานของ Opus 5.5 ต่ำกว่า Fable 5.1 อยู่ 60%
- ทั้งสองรุ่นรองรับหน้าต่างคอนเท็กซ์ 1M โทเคน และเอาต์พุตสูงสุด 128K ดังนั้นต้นทุน การตั้งค่าความพยายาม และความเหมาะสมของงานสำคัญกว่าขนาดคอนเท็กซ์ตามสเปก
- ผลลัพธ์ที่เผยแพร่โดย Anthropic ให้น้ำหนักกับ Opus 5.5 ในการประเมินด้านโค้ดและเอเจนต์หลายรายการ แต่การตั้งค่าเบนช์มาร์กมีผลอย่างมีนัยสำคัญ
- การประเมินอิสระสนับสนุนตำแหน่งแนวหน้าของ Opus 5.5 แม้รายงานคะแนนสัมบูรณ์ต่างกัน ย้ำว่าควรทดสอบให้ตรงกัน
- สำหรับงานการผลิตที่มีผู้กำกับส่วนใหญ่ Opus 5.5 เป็นจุดเริ่มต้นที่ดีกว่า Fable 5.1 เป็นชั้นยกระดับ ไม่ใช่ค่าตั้งต้นอัตโนมัติ
Claude Opus 5.5 คืออะไร?
Claude Opus 5.5 เป็นรุ่น Claude 5.5 ตัวแรกของ Anthropic วางตำแหน่งสำหรับเอเจนต์ด้านโค้ด งานเอเจนต์ระยะยาว งานความรู้ระดับมืออาชีพ เวิร์กโฟลว์องค์กร การวิเคราะห์การเงิน วิชัน และการใช้งานคอมพิวเตอร์
API model ID คือ claude-opus-5-5 เปิดใช้การคิดแบบปรับได้ตลอดเวลา และนักพัฒนาควบคุมความเข้มข้นของการให้เหตุผลได้ผ่านระดับความพยายาม low, medium, high, xhigh และ max นอกจากนี้ Anthropic ยังมี โหมดเร็ว (Fast mode) ที่ทำงานได้สูงสุด 2.5 เท่าของความเร็วปกติ โดยคิด $8/M อินพุต และ $40/M เอาต์พุต
Claude Fable 5.1 คืออะไร?
Claude Fable 5.1 วางตำแหน่งสำหรับโปรเจ็กต์ที่ต้องการสูงและใช้เวลานาน เช่น การเขียนโค้ดหลายชั่วโมง งานวิจัยซับซ้อน การใช้งานเบราว์เซอร์ เอเจนต์อัตโนมัติ และเวิร์กโฟลว์ที่ครอบคลุมหลายแอป
API model ID คือ claude-fable-5-1 ใช้การคิดแบบปรับได้ เริ่มจากระดับความพยายามของ API ที่สูงกว่า และเหมาะที่จะมองเป็นตัวเลือกพรีเมียมเมื่อความคาดหวังเรื่องต้นทุนความล้มเหลวหรือการลองซ้ำสูงกว่าค่าอินเฟอเรนซ์ที่เพิ่มขึ้น
การอ่านแบบง่ายคือ Opus 5.5 ให้ขอบเขตความสามารถเกือบเท่ากันในราคาโทเคนมาตรฐานเพียง 40% ของ Fable แต่อันนี้เองที่ทำให้ตารางสเปกอย่างเดียวอาจทำให้เข้าใจผิด
การเปรียบเทียบโค้ดและเบนช์มาร์ก
Anthropic รายงานว่า Opus 5.5 นำ Fable 5.1 บน Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 และ Chartography
วิธีอ่านผลเบนช์มาร์ก
Anthropic รายงานว่า Opus 5.5 นำ Fable 5.1 บน Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 และ Chartography ตัวเลขเหล่านี้คือผลการประเมิน ไม่ใช่ค่าคงที่ของโมเดลที่ไม่ขึ้นกับการตั้งค่า
คะแนนพาดหัวของ Opus 5.5 ส่วนใหญ่ใช้ระดับความพยายามสูงสุด ขณะที่ Terminal-Bench 4.0 ใช้ xhigh การออกแบบฮาร์เนส การตั้งค่าเครื่องมือ มาตรการป้องกัน จำนวนการทดสอบ ค่าคลาดเคลื่อนมาตรฐาน พฤติกรรมสำรอง และเพดานต้นทุน ล้วนเปลี่ยนผลลัพธ์ได้ Anthropic เองก็เตือนว่าระยะห่างในเบนช์มาร์กอาจโอเวอร์สเตทช่องว่างเชิงปฏิบัติระหว่างโมเดลแนวหน้า
ประสิทธิภาพด้านโค้ด
| เบนช์มาร์ก | Claude Opus 5.5 | Claude Fable 5.1 | คำอธิบาย |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | นำ 10.6 จุดสำหรับภารกิจเอเจนต์ที่ทำงานผ่านเทอร์มินัล |
| FrontierCode v1.1 | 54.4% สูงสุด; 54.6% กลาง | 50.3% | ระดับกลางของ Opus 5.5 ยังแข่งขันได้ในมุมเศรษฐศาสตร์การผลิต |
| CursorBench 4.0 | 57.8% สูงสุด; 52.5% กลาง | 51.8% | ระดับกลางสูงกว่าผลที่รายงานของ Fable เล็กน้อย |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | ได้เปรียบในงานเอเจนต์ระดับมืออาชีพ |
ตัวเลขเหล่านี้คือผลเบนช์มาร์กที่ Anthropic รายงาน ควรอ่านตารางร่วมกับข้อควรระวังเรื่องการตั้งค่าการประเมินในส่วนถัดไปและหน้ารุ่น Claude Opus อย่างเป็นทางการ
สามผลแรกโดดเด่นเพราะครอบคลุมงานที่ Claude มีความสำคัญเชิงพาณิชย์มากขึ้นเรื่อยๆ: เอเจนต์วิศวกรรมซอฟต์แวร์ Terminal-Bench 4.0 แสดงความต่างสัมบูรณ์ 10.6 จุด FrontierCode ต่าง 4.1 จุด และ CursorBench 4.0 ต่าง 6 จุด
GDPval-AA ซึ่งวัดงานเอเจนต์มืออาชีพ รายงาน 1846 Elo สำหรับ Opus 5.5 เทียบกับ 1735 สำหรับ Fable 5.1 หากตัวเลขเหล่านี้คือทั้งหมด ลำดับผลิตภัณฑ์อาจเหมือนถูกสลับ แต่ความจริงไม่ง่ายเช่นนั้น
การประเมินอิสระ
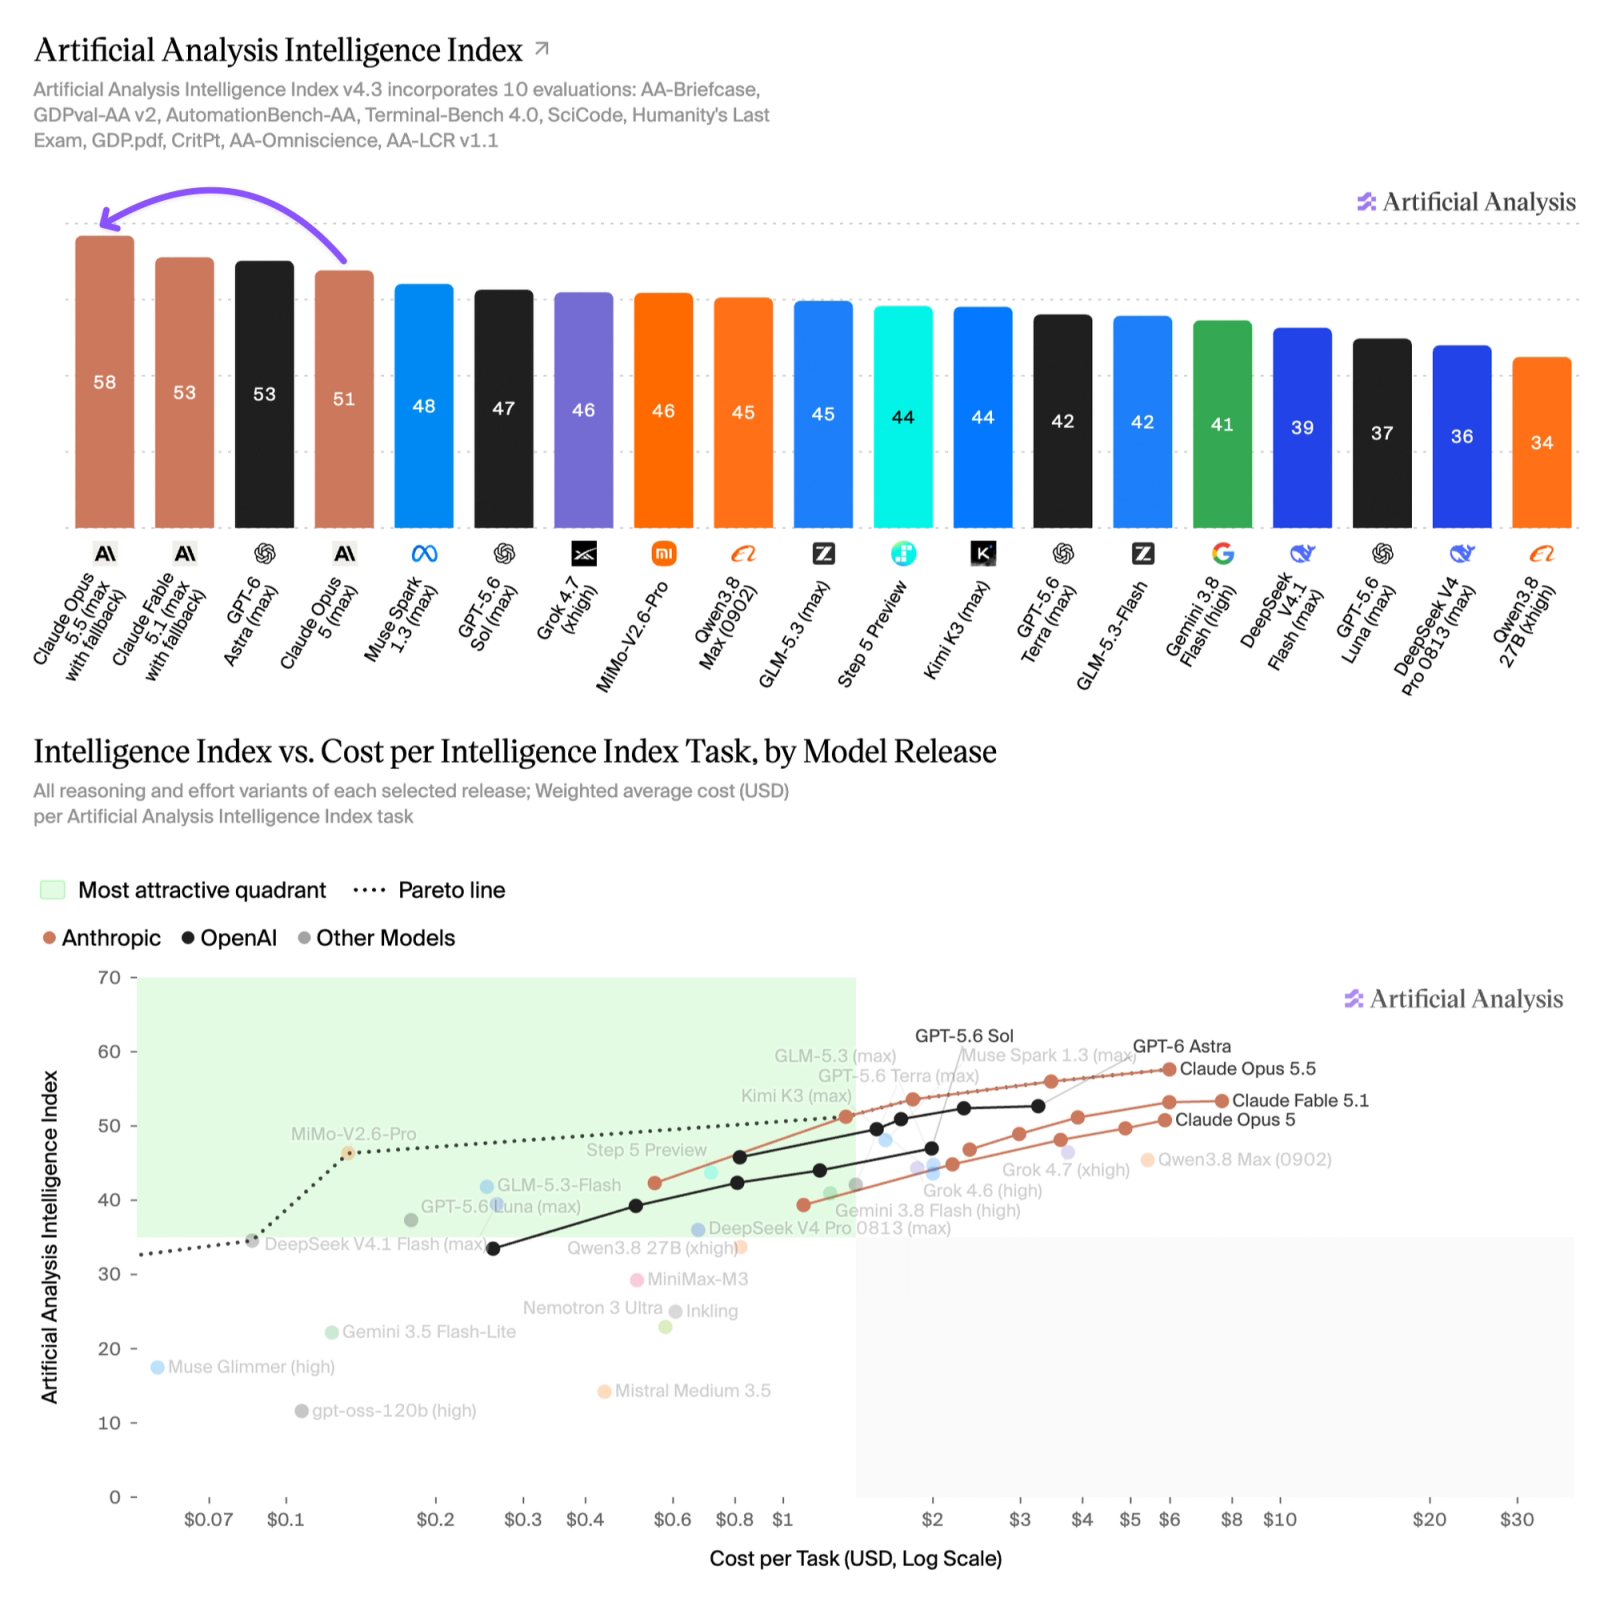
Artificial Analysis ให้คะแนน Opus 5.5 Max ที่ 58 บน Intelligence Index และรายงานผลแข็งแรงใน AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode และ Humanity's Last Exam ผล Terminal-Bench 4.0 อยู่ที่ 59.6% ต่ำกว่าที่ Anthropic รายงาน 66.4% แสดงให้เห็นว่าทีมควรบันทึกรุ่นโมเดล ระดับความพยายาม ฮาร์เนส เครื่องมือ จำนวนครั้งทดลอง และเพดานต้นทุนทุกครั้งที่คะแนนไม่ตรงกัน
การเปรียบเทียบราคาและต้นทุนต่อภารกิจที่เสร็จสมบูรณ์
CometAPI เสนอราคาโทเคนต่ำกว่าราคาทางการ ช่วยให้นักพัฒนาทำได้เทียบเท่า API ทางการด้วยรูปแบบข้อความคำขอมาตรฐาน
ราคาโทเคน
| การตั้งราคา | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| อินพุต | $4 | $10 |
| เอาต์พุต | $20 | $50 |
| เขียนแคช 5 นาที | $5 | $12.50 |
| เขียนแคช 1 ชั่วโมง | $8 | $20 |
| อ่านแคช | $0.20 | $0.25 |
| อินพุต/เอาต์พุตแบบแบตช์ | ส่วนลด 50% | ส่วนลด 50% |
สมมติว่างานใช้โทเคนอินพุตใหม่ 10 ล้าน และเอาต์พุต 2 ล้าน โดยไม่มีผลของแคช:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
ภายใต้สมมตินั้น Opus 5.5 มีต้นทุนต่ำกว่า 60% อย่างไรก็ดี อย่าสับสนตัวเลขนี้กับคำกล่าวของ Anthropic ที่ว่า Opus 5.5 มีต้นทุนรันต่ำกว่า Opus 5 ราว 40%
นั่นคือการเปรียบเทียบคนละแบบ ตัวเลข 40% รวมทั้งราคาแบบ Opus ที่ต่ำลงของ Opus 5.5 และการใช้โทเคนต่อภารกิจที่ลดลงเมื่อเทียบกับ Opus 5 ส่วน 60% มาจากการเทียบราคามาตรฐานของ Opus 5.5 กับ Fable 5.1 โดยตรง
ต้นทุนต่อภารกิจที่เสร็จสมบูรณ์
จริงๆ แล้ว API ของโมเดลไม่ได้ขายโทเคน นักพัฒนาซื้อผลงานที่เสร็จสิ้น
ทีมโค้ดไม่สนใจว่าโมเดลใช้ไป 6.2 ล้านโทเคน สนใจว่าแก้บั๊กสำเร็จ ย้ายระบบเสร็จ ผ่านชุดทดสอบ หรือทำงานวิจัยเสร็จหรือไม่
Anthropic ชี้ตรงนี้ไว้ในต้นทุนของภารกิจบน Opus 5.5: โมเดลที่มีราคาคล้ายกันอาจมีต้นทุนภารกิจต่างกันมาก หากโมเดลหนึ่งต้องคุยนานกว่า อ่านคอนเท็กซ์ซ้ำมากกว่า ลองซ้ำบ่อยกว่า หรือสร้างโทเคนคิดมากกว่า
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
บรรทัดสุดท้ายมักถูกมองข้าม โมเดลที่ถูกกว่าแต่ล้มเหลวสองครั้งอาจแพงกว่าโมเดลที่แพงกว่าแต่ทำสำเร็จรันเดียว เช่นเดียวกัน ระดับความพยายามที่สูงขึ้นซึ่งหลีกเลี่ยงการลองซ้ำ 10 รอบ อาจลดต้นทุนรวมได้จริง
เศรษฐศาสตร์ของการแคชพรอมป์ต์
เอเจนต์ที่ใช้แคชหนักจะนำคำนิยามเครื่องมือ เนื้อหารีโป คำสั่งระบบ ประวัติการสนทนา และผลการทดสอบมาใช้ซ้ำบ่อยๆ เพราะราคาอ่านแคชคือ $0.20/M สำหรับ Opus 5.5 และ $0.25/M สำหรับ Fable 5.1 ช่องว่างจึงเล็กกว่าความต่าง $6/M ในราคาอินพุตใหม่มาก ทีมควรแยกติดตามอินพุตใหม่ การอ่านแคช การเขียนแคช เอาต์พุต รอบเครื่องมือ และการลองซ้ำ
เศรษฐศาสตร์ของระดับความพยายาม
อาจเป็นไปได้ ใช่ Artificial Analysis ทดสอบระดับความพยายาม 5 ระดับของ Opus 5.5 และพบเส้นโค้งความสามารถ-ต้นทุนที่ชัดเจน
| ความพยายามของ Opus 5.5 | Artificial Analysis Intelligence Index | ต้นทุนต่อภารกิจในดัชนี |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
ระดับกลางเป็นจุดเริ่มต้นที่สมเหตุสมผลสำหรับการเปลี่ยนโค้ดประจำ รีแฟกเตอร์ที่ทราบแน่ และการดีบักภายใต้การกำกับ ระดับสูงหรือ xhigh อาจคุ้มค่าสำหรับความล้มเหลวของระบบที่คลุมเครือ การย้ายค้างคืน หรือภารกิจที่แผนผิดสร้างงานแก้ไขจำนวนมาก
การเปรียบเทียบด้านความปลอดภัยและความเชื่อถือได้
ไม่ควรติดป้ายว่ารุ่นใดปลอดภัยกว่าจากเบนช์มาร์กความสามารถเพียงอย่างเดียว การเปรียบเทียบที่ป้องกันได้ต้องใช้พรอมป์ต์ เครื่องมือ สิทธิ์ ระดับความพยายาม ขีดจำกัดการลองซ้ำ และเกณฑ์การยอมรับที่ตรงกัน ความสามารถที่สูงขึ้นอาจลดความผิดพลาดโดยไม่ตั้งใจ แต่ความเป็นอิสระที่มากขึ้นและการรันนานขึ้นก็เพิ่มผลกระทบจากแผนที่ผิด การฉีดพรอมป์ต์ การเรียกเครื่องมือที่ไม่ปลอดภัย หรือการไถลที่ไม่ถูกรู้ตัว
| มิติด้านความปลอดภัย | การเปรียบเทียบเชิงปฏิบัติ | การควบคุมในการผลิต |
|---|---|---|
| การให้เหตุผลและความพยายาม | Opus 5.5 เปิดหลายระดับความพยายาม ขณะที่ Fable 5.1 เริ่มจากท่าทีความพยายามสูงกว่า การให้เหตุผลมากขึ้นไม่ใช่ตัวแทนนโยบายความปลอดภัย | กำหนดนโยบายระดับความพยายามตามงาน และทดสอบพฤติกรรมความปลอดภัยใหม่ทุกครั้งที่มีการเปลี่ยนแปลง |
| ความเป็นอิสระระยะยาว | Fable 5.1 วางตำแหน่งสำหรับงานยากที่ไม่ถูกดูแล; Opus 5.5 ก็รองรับเวิร์กโฟลว์แบบเอเจนต์ ความเสี่ยงเติบโตตามระยะเวลา สิทธิ์ และจำนวนการกระทำที่ย้อนกลับไม่ได้ | ใช้จุดตรวจ เกตการอนุมัติ เพดานเวลาและต้นทุน และเงื่อนไขการย้อนกลับอัตโนมัติหรือปิดการทำงาน |
| การใช้เครื่องมือและคอมพิวเตอร์ | ทั้งสองรุ่นใช้เครื่องมือได้ ดังนั้นการเลือกรุ่นเพียงอย่างเดียวไม่ควบคุมการเปิดเผยข้อมูลหรือการกระทำที่ทำลายได้ | ใช้สิทธิ์ขั้นต่ำ รายการอนุญาต แซนด์บ็อกซ์ การแยกความลับ และการยืนยันก่อนการกระทำที่ภายนอกหรือย้อนกลับไม่ได้ |
| การประเมินและตรวจสอบย้อนกลับ | คะแนนเบนช์มาร์กสาธารณะไม่ได้ยืนยันคุณภาพการปฏิเสธ ความต้านทานการฉีดพรอมป์ต์ หรืออัตราเหตุการณ์ในการผลิต | บันทึกการเรียกเครื่องมือและการตัดสินเชิงนโยบาย; วัดอัตราการยอมทำสิ่งที่ไม่ปลอดภัย การปฏิเสธเกินจำเป็น ความสำเร็จของการฉีดพรอมป์ต์ การรั่วของความลับ ความพยายามที่ทำลาย และคุณภาพการกู้คืน |
กฎความปลอดภัยเชิงปฏิบัติ: เริ่มด้วยการตั้งค่า Opus 5.5 ที่มีสิทธิ์น้อยที่สุดซึ่งเพียงพอต่อภารกิจ และยกระดับไปยัง Fable 5.1 เฉพาะหลังจากผ่านชุดทดสอบความปลอดภัยเดียวกัน สำหรับเวิร์กโฟลว์ผลกระทบสูง ให้มีการอนุมัติโดยมนุษย์ไม่ว่ารุ่นใดจะทำคะแนนความสามารถสูงกว่า
- รันทดสอบการฉีดพรอมป์ต์เชิงปฏิปักษ์และการดึงข้อมูลหลุดด้วยชุดเครื่องมือจริงในโปรดักชัน
- แยกสิทธิ์อ่าน เขียน เผยแพร่ ลบ และการเงิน แทนการให้บทบาทเครื่องมือกว้างๆ เพียงหนึ่งเดียว
- กำหนดทริกเกอร์ย้อนกลับสำหรับการละเมิดนโยบาย ความล้มเหลวของเครื่องมือซ้ำๆ การขยายขอบเขตที่ไม่คาดคิด และการเกินงบ
- ตรวจสอบซ้ำหลังการเปลี่ยนแปลงรุ่นโมเดล พรอมป์ต์ระบบ ระดับความพยายาม เครื่องมือ สิทธิ์ หรือการกำหนดเส้นทาง
วิธีเลือกระหว่าง Opus 5.5 และ Fable 5.1
| เวิร์กโหลด | จุดเริ่มต้นที่แนะนำ | เงื่อนไขการยกระดับ |
|---|---|---|
| งานโค้ดประจำและโค้ดรีวิว | Opus 5.5 ระดับกลาง | ยกระดับเฉพาะกรณีที่ยากหรือมีความเสี่ยงสูงผิดปกติ |
| งานฟีเจอร์หลายไฟล์ | Opus 5.5 ระดับกลางหรือสูง | ใช้ Fable เมื่อความล้มเหลวในการวางแผนซ้ำๆ เป็นต้นทุนหลัก |
| การย้ายทั้งรีโพสิทอรี | ทดสอบ Opus 5.5 ระดับสูงหรือ xhigh ก่อน | ยกระดับสำหรับโปรเจ็กต์อัตโนมัติที่ยากที่สุด |
| รันอัตโนมัติค้างคืน | Opus 5.5 พร้อมจุดตรวจเข้มงวด | ชอบ Fable เมื่อค่าความเสียหายจากทิศทางผิดสูงมาก |
| ทราฟฟิก API ปริมาณสูง | Opus 5.5 | ยกระดับเฉพาะส่วนน้อยของงานที่ล้มเหลวบ่อย |
| ดีพลอย Fable ที่ผ่านการยืนยันแล้ว | คงดีพลอยเดิมระหว่างการทดสอบ | สลับเมื่อ Opus ผ่านเกณฑ์ยอมรับเดียวกัน |
การทดสอบการผลิตเชิงปฏิบัติ
รันภารกิจตัวแทนเดียวกัน พรอมป์ต์ เครื่องมือ นโยบายความพยายาม เกณฑ์การยอมรับ และขีดจำกัดการลองซ้ำให้ทั้งสองรุ่น บันทึกอัตรางานที่ยอมรับ ระยะหน่วง อินพุตใหม่และแบบแคช เอาต์พุตและโทเคนคิด การเรียกเครื่องมือ การลองซ้ำ การแก้โดยมนุษย์ และต้นทุนรวมต่อผลลัพธ์ที่ยอมรับ รวมทั้งงานประจำและกรณีล้มเหลวยากๆ
แนวทางย้ายสำหรับผู้ใช้ Claude Opus 5 เดิม
ผู้ใช้ Opus 5 เดิมควรทดสอบ Opus 5.5 เป็นผู้สืบทอด แทนที่จะสมมติว่าแค่สลับ model ID จะปลอดภัย เปรียบเทียบความลึกในการวางแผน รูปแบบการเรียกเครื่องมือ ความยาวคำตอบ การยึดรูปแบบ ระยะหน่วง พฤติกรรมแคชพรอมป์ต์ การกู้จากการเรียกเครื่องมือที่ล้มเหลว การกำหนดเส้นทางความปลอดภัย และต้นทุนต่อภารกิจที่เสร็จสิ้น คงเกณฑ์ย้อนกลับและรักษารุ่นเดิมไว้จนกว่า Opus 5.5 จะผ่านเกณฑ์ยอมรับที่เหมือนการผลิต
ผู้ใช้ Fable 5.1 เดิมไม่จำเป็นต้องมีส่วนย้ายแบบทั่วไป ควรมอง Opus 5.5 เป็นผู้สมัครเพื่อเพิ่มประสิทธิภาพ และประเมินภายใต้เกณฑ์ยอมรับการผลิตเดียวกันก่อนเปลี่ยนดีพลอยที่ยืนยันแล้ว
การเข้าถึงผ่าน CometAPI
นักพัฒนาที่ประเมินทั้งสองรุ่นสามารถดูไกด์ที่เกี่ยวข้องของ CometAPI สำหรับ Claude Opus 5.5 และ Claude Fable 5.1 เมื่อผสานผ่านผู้ให้บริการ API ที่เข้ากันได้ ตรวจสอบให้แน่ใจว่า model ID ที่แน่นอน พารามิเตอร์ความพยายามที่รองรับ พฤติกรรมแคช ขีดจำกัดเรต ความพร้อมให้บริการตามภูมิภาค และราคาปัจจุบัน ก่อนดีพลอยจริง
ใช้ claude-opus-5-5 สำหรับ Opus 5.5 และ claude-fable-5-1 สำหรับ Fable 5.1 ในที่ที่รองรับตัวระบุเหล่านี้ หลีกเลี่ยงการกำหนดเส้นทางเวิร์กโหลดทั้งสองคลาสผ่านระดับความพยายามตายตัวตัวเดียวโดยไม่แจ้งให้ทราบ; การเลือกรุ่นและนโยบายความพยายามควรถูกกำหนดค่าแยกจากกัน
Python — Anthropic Messages API ผ่าน CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
บทสรุป
Claude Opus 5.5 เปลี่ยนขอบเขตเชิงปฏิบัติระหว่างรุ่นแนวหน้าประจำวันของ Anthropic กับชั้นยกระดับแบบพรีเมียม มีราคามาตรฐานถูกกว่ามาก นำหน้าหลายเบนช์มาร์กด้านโค้ดและเอเจนต์ และมีความยืดหยุ่นด้านความพยายามเพียงพอเพื่อครอบคลุมช่วงการผลิตกว้าง
Claude Fable 5.1 ยังมีความเกี่ยวข้องเมื่อภารกิจยาก มูลค่าสูง ใช้เวลานาน หรือทำงานโดยไม่มีผู้ดูแล และต้นทุนความล้มเหลวสูงกว่าบิลอินเฟอเรนซ์ที่มากขึ้น สำหรับหลายทีม นโยบายที่ดีที่สุดคือเริ่มด้วย Opus 5.5 วัดผลลัพธ์ภารกิจที่เสร็จสมบูรณ์ แล้วค่อยยกระดับอย่างเลือกสรร
คำถามที่พบบ่อย
ทีมควรออกแบบการทดสอบ A/B ในการผลิตสำหรับ Opus 5.5 และ Fable 5.1 อย่างไร?
ใช้ภารกิจตัวแทนเดียวกัน พรอมป์ต์ เครื่องมือ นโยบายความพยายาม เกณฑ์การยอมรับ และขีดจำกัดการลองซ้ำกับทั้งสองรุ่น บันทึกอัตรางานที่ยอมรับ ระยะหน่วง อินพุตใหม่และแบบแคช เอาต์พุตและโทเคนคิด การเรียกเครื่องมือ การลองซ้ำ การแก้ไขโดยมนุษย์ และต้นทุนรวมต่อผลลัพธ์ที่ยอมรับ รันให้มากพอที่จะครอบคลุมงานประจำและกรณียากที่ล้มเหลว
เมื่อใดราคาต่อโทเคนที่ต่ำกว่าอาจไม่ลดต้นทุนต่อภารกิจ?
โมเดลราคาต่ำกว่าอาจยังแพงกว่าหากใช้รอบมากกว่า อ่านคอนเท็กซ์ซ้ำมากกว่า สร้างโทเคนคิดมากกว่า หรือจำเป็นต้องลองซ้ำหลายครั้ง พฤติกรรมแคชก็สำคัญ: ช่องว่างราคาอินพุตจะแคบลงในเซสชันยาวที่ครอบงำด้วยการอ่านแคช เปรียบเทียบต้นทุนต่อภารกิจ ไม่ใช่แค่ราคาป้าย
ควรบันทึกอะไรเมื่อผลเบนช์มาร์กไม่ตรงกัน?
บันทึกรุ่นโมเดล ระดับความพยายาม ฮาร์เนส การตั้งค่าพฤติกรรมสำรองและความปลอดภัย จำนวนครั้งทดลอง รุ่นของภารกิจ ค่าคลาดเคลื่อนมาตรฐาน และเพดานต้นทุน ติดป้ายว่าเป็นผลอย่างเป็นทางการหรืออิสระ และหลีกเลี่ยงการรวมคะแนนจากการตั้งค่าที่ไม่ตรงกันในอันดับเดียว
ผู้ใช้ Fable 5.1 เดิมควรเฝ้าระวังความเสี่ยงการย้ายอะไรบ้าง?
จับตาความลึกในการวางแผน รูปแบบการเรียกเครื่องมือ ความยาวคำตอบ การยึดรูปแบบ ระยะหน่วง พฤติกรรมแคชพรอมป์ต์ การกู้คืนจากความล้มเหลวของเครื่องมือ และการกำหนดเส้นทางความปลอดภัย รักษาดีพลอยเดิมระหว่างการประเมิน กำหนดเกณฑ์ย้อนกลับ และย้ายเมื่อ Opus 5.5 ผ่านเกณฑ์ยอมรับเดียวกันบนภารกิจที่เหมือนการผลิต
ข้อมูลเมตา SEO
Meta title: Claude Opus 5.5 vs Fable 5.1: โค้ด ต้นทุน และเกณฑ์วัดผล
Meta description: เปรียบเทียบ Claude Opus 5.5 และ Claude Fable 5.1 ในด้านเบนช์มาร์กการเขียนโค้ด การตั้งราคา API ความเร็ว การแคช ระดับความพยายาม ต้นทุนต่อภารกิจที่เสร็จสมบูรณ์ และความเหมาะสมของเวิร์กโหลด
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude coding benchmarks, Claude API pricing, CometAPI, AI coding models
URL slug: claude-opus-5-5-vs-claude-fable-5-1