สร้างด้วย CometAPIต้องการ API เดียวสำหรับหลายโมเดลใช่ไหมทดสอบเวิร์กโฟลว์ใน Playground แล้วสร้างคีย์ API เมื่อโมเดลและค่าใช้จ่ายเหมาะกับกรณีการใช้งานของคุณ
GPT-6.1 Terra vs GPT-6.1 Sol: ผลการทดสอบเบนช์มาร์ก, ราคา, และควรเลือกตัวใด
เปรียบเทียบ GPT-6.1 Terra และ GPT-6.1 Sol ในด้านเบนช์มาร์กอย่างเป็นทางการ ความสามารถในการให้เหตุผล ราคา API และเวิร์กโหลดการใช้งานจริง พร้อมตัวอย่าง CometAPI ในภาษา Python
เริ่มต้นด้วย GPT-6.1 Terra สำหรับงานปริมาณมากที่ตรวจสอบได้และอ่อนไหวต่อค่าใช้จ่าย ประเมิน GPT-6.1 Sol สำหรับการโค้ดที่ซับซ้อน การใช้เครื่องมือหลายขั้นตอน และเวิร์กโฟลว์ที่ความล้มเหลวมีต้นทุนสูง ค่าเริ่มต้นที่ใช้งานได้จริงคือใช้ Terra ก่อน และยกระดับไปใช้ Sol เมื่อการทดสอบหรือการตรวจสอบความถูกต้องที่กำหนดไว้ล้มเหลว
API features: ทั้งสองโมเดลรองรับ Structured Outputs, การสตรีม และ Batch API การเรียกใช้เครื่องมือใช้ Responses API และไม่รองรับการฝึกปรับแต่ง ตรวจสอบให้แน่ใจว่าโพรไวเดอร์และเอ็นด์พอยต์ที่คุณเลือกมีฟีเจอร์ที่แอปของคุณต้องการ
ผลลัพธ์ที่รายงานแสดงภาพผสม: Terra นำเล็กน้อยบนการประเมินเอเจนต์และการโค้ดด้านวิทยาศาสตร์บางรายการ ขณะที่ Sol ทำคะแนนสูงกว่าบนการโค้ดผ่านเทอร์มินัลทั่วไป การทำงานเดสก์ท็อป และงานด้านภาพ การเปรียบเทียบด้านล่างแยกผลเปิดตัวของ OpenAI ออกจากการประเมินอิสระและอธิบายว่าสิ่งเหล่านี้บอกได้—และบอกไม่ได้—เกี่ยวกับประสิทธิภาพในการผลิต
Official Benchmark Results and Test Conditions
ผลต่อไปนี้มาจากการประเมินเปิดตัว Terra ของ OpenAI Terra แสดงที่ระดับความพยายามปานกลางและสูงสุด; Sol แสดงที่ความพยายามสูงสุด คอลัมน์สุดท้ายเปรียบเทียบเฉพาะการกำหนดค่าที่ความพยายามสูงสุด
สำหรับวิศวกรรมซอฟต์แวร์ ช่องว่างของ Sol บน Terminal-Bench และความได้เปรียบเพียงเล็กน้อยของ Terra บน Terminal-Bench-Science บ่งชี้ว่าผลลัพธ์ขึ้นกับชนิดของงานโค้ด สำหรับเวิร์กโฟลว์แอปพลิเคชัน คะแนน OSWorld ที่สูงกว่าของ Sol สนับสนุนการประเมินสำหรับระบบอัตโนมัติบนเดสก์ท็อป ขณะที่ผล Agents’ Last Exam ของ Terra ทำให้เป็นผู้สมัครสำหรับงานเอเจนต์ระดับมืออาชีพ รูปแบบใดรูปแบบหนึ่งไม่ได้สร้างผู้ชนะสากล
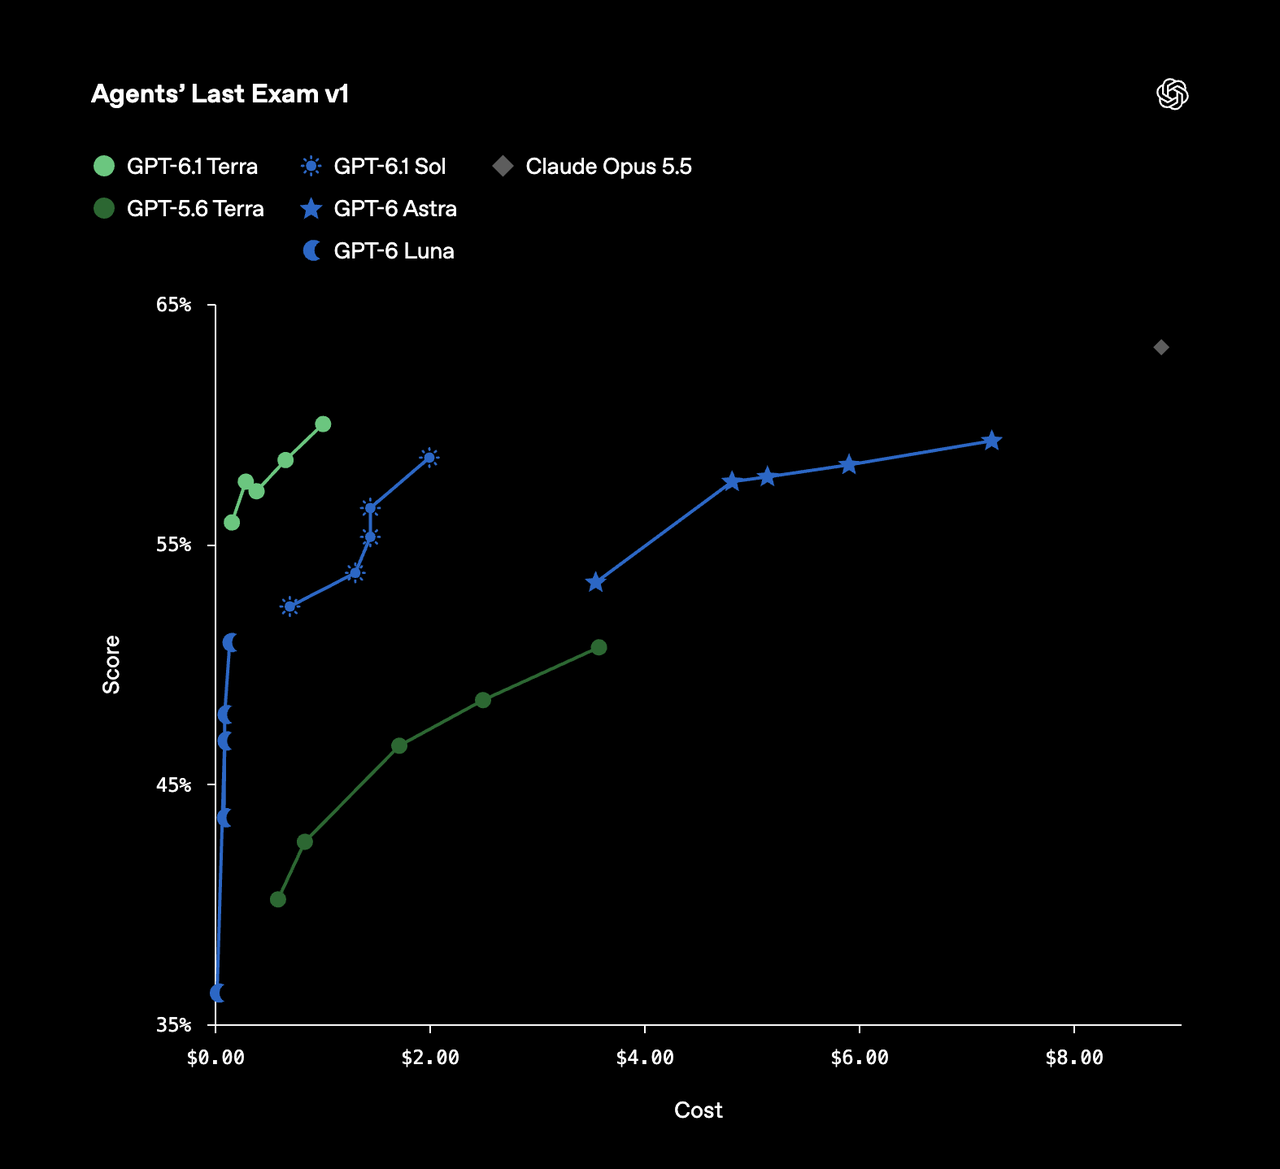
แผนภูมิ Agents’ Last Exam v1 ของ OpenAI วางกราฟคะแนนเทียบกับต้นทุนงานโดยประมาณทั่วการกำหนดค่าโมเดล เพิ่มมุมมองความคุ้มค่าต้นทุนให้กับตารางคะแนนด้านบน; ต้นทุนที่พล็อตเป็นไปตามการตั้งค่าการประเมินเฉพาะ
Independent Intelligence and Coding Evaluations
การประเมินของ Artificial Analysis วันที่ 26 ตุลาคม วาง Terra ต่ำกว่า Sol สี่คะแนนบน Intelligence Index ที่ความพยายามสูงสุด Coding Agent Index v2.0 ให้ Terra 48 และ Sol 54 นี่คือการประเมินแยกที่มีวิธีการและสเกลคะแนนของตนเอง; ไม่ควรรวมเชิงตัวเลขกับผลเบนช์มาร์กของ OpenAI
การวิเคราะห์เดียวกันระบุว่าการตั้งค่าความพยายามต่ำและปานกลางของ Terra มีความคุ้มค่าต้นทุนเป็นพิเศษบนการประเมินด้านสติปัญญา ซึ่งสนับสนุนการทดสอบการกำหนดค่าปฏิบัติ ควบคู่กับการตั้งค่าความพยายามสูงสุด อย่างไรก็ตาม ต้นทุนการประเมินยังคงเฉพาะกับการตั้งค่าการทดสอบ และไม่ควรถือเป็นประมาณการการใช้จ่ายของแอปพลิเคชันคุณ
Speed and Latency: Task Completion vs. Token Generation
OpenAI รายงานว่า Terra ทำภารกิจ Agents’ Last Exam ที่ประเมินเสร็จมากกว่า Sol ถึงสามเท่า นี่คือการวัดงานตั้งแต่ต้นจนจบที่รวมการให้เหตุผลและการโต้ตอบกับซอฟต์แวร์ ไม่ได้หมายถึงอัตราการสร้างโทเคนเอาต์พุตที่สูงกว่า 3 เท่าหรือการเร่งความเร็วแบบเดียวกันสำหรับทุกคำขอ API
สำหรับแอปแบบโต้ตอบ แยกความแตกต่างระหว่าง time to first token ซึ่งวัดเวลารอจนเอาต์พุตเริ่ม และ output tokens per second ซึ่งวัดความเร็วที่คำตอบดำเนินต่อ สำหรับเอเจนต์ ให้ให้ความสำคัญกับเวลาสิ้นสุดตั้งแต่ต้นจนจบ รวมถึงการเรียกเครื่องมือ การลองใหม่ และการกู้คืน
ราคาต่อโทเคนที่ต่ำกว่าไม่ได้ทำให้ต้นทุนการปฏิบัติการต่ำเสมอไป การประหยัดของ Terra อาจลดลงหากต้องใช้ความพยายามมากขึ้น โทเคนการให้เหตุผลมากขึ้น หรือการมีส่วนร่วมของมนุษย์มากขึ้น อัตราที่สูงกว่าของ Sol อาจคุ้มค่า หากมันทำงานสำเร็จมากขึ้นตั้งแต่ครั้งแรก
Effective model-and-tool cost per successful task = total model and tool spending across all attempts ÷ number of successful tasks.
Which Model Should You Choose: GPT-6.1 Terra or GPT-6.1 Sol?
เลือกตามความซับซ้อนของงาน คุณภาพเอาต์พุตที่ตรวจสอบได้ และต้นทุนการทำงานให้เสร็จ Terra เป็นจุดเริ่มที่มีประโยชน์สำหรับเวิร์กโฟลว์ตามปกติ; Sol ควรประเมินเมื่อการให้เหตุผลที่ยากหรือความล้มเหลวที่มีต้นทุนสูงทำให้การใช้จ่ายเพิ่มเติมมีคุณค่า
When to Choose GPT-6.1 Terra
เริ่มด้วย Terra สำหรับการสกัดข้อมูลปริมาณมาก การร่างเอกสาร การจับคู่แคตาล็อก และเวิร์กโฟลว์แอปพลิเคชันที่คาดเดาได้ งานเหล่านี้เหมาะเมื่อผลลัพธ์สามารถตรวจสอบกับเอกสารต้นทาง ช่องข้อมูลที่จำเป็น หรือกฎการตรวจสอบอัตโนมัติ
เลือก Terra เมื่อมันตอบโจทย์ความแม่นยำและเป้าหมายการทำงานให้เสร็จภายในงบประมาณการลองใหม่และการทบทวนโดยมนุษย์ อัตราโทเคนที่ต่ำกว่าไม่มีประโยชน์มาก หากความล้มเหลวที่ซ้ำซ้อนลบล้างการประหยัด
When to Choose GPT-6.1 Sol
ประเมิน Sol สำหรับการดีบักที่ยาก การเปลี่ยนแปลงในรีโพซิทอรีที่เกี่ยวข้องกับการพึ่งพาจำนวนมาก และเวิร์กโฟลว์เดสก์ท็อปที่มีโซ่การกระทำที่พึ่งพากันยาว
เลือก Sol เมื่อการทดสอบแสดงว่ามันผลิตแพตช์ที่ได้รับการยอมรับมากขึ้น ผ่านการทดสอบมากขึ้น หรือใช้การแก้ไขด้วยมือที่น้อยลง ค่าโทเคนที่สูงขึ้นนั้นคุ้มค่าเมื่อการปรับปรุงเหล่านั้นลดต้นทุนรวมของการทำงานให้เสร็จ
When to Use Terra First and Escalate to Sol
เวิร์กโฟลว์แบบไฮบริดสามารถใช้ Terra สำหรับความพยายามครั้งแรก และยกระดับไปใช้ Sol เมื่อการตรวจสอบที่กำหนดไว้ล้มเหลว ตั้งฐานการยกระดับบนผลลัพธ์ที่สังเกตได้แทนที่จะเป็นความมั่นใจของโมเดลเพียงอย่างเดียว
ตัวอย่าง เวิร์กโฟลว์การสร้างโค้ดอาจ:
ขอให้ Terra ผลิตการเปลี่ยนแปลงที่ร้องขอ
รันการทดสอบและการตรวจสอบความถูกต้องที่เกี่ยวข้อง
ยกระดับไปใช้ Sol หากการเปลี่ยนแปลงนั้นไม่ผ่านการตรวจสอบเหล่านั้น หรืออยู่นอกความสามารถที่ตรวจสอบได้ของ Terra