
TL;DR
OpenAI เปิดตัว GPT-6.2 Astra เมื่อวันที่ 17 พฤศจิกายน 2026 ในฐานะโมเดลแนวหน้ารุ่นใหม่สำหรับงานวิชาชีพที่ซับซ้อน งานแบบเอเจนต์ งานวิทยาศาสตร์ กฎหมาย ดีไซน์ และการเขียนโค้ด โมเดลนี้ให้ผลลัพธ์ที่ดีขึ้นอย่างวัดได้เมื่อเทียบกับ GPT-6 Astra (โดยเฉพาะในงานวิชาชีพระยะยาวและเกณฑ์วัดด้านวิทยาศาสตร์) พร้อมลดราคาโทเค็นมาตรฐานของ API ลง 20% และลดต้นทุนต่อภารกิจลงได้อีกด้วยประสิทธิภาพที่สูงขึ้น
โมเดลนี้มีให้ใช้ผ่าน OpenAI API (gpt-6.2-astra), ChatGPT Work/Codex และใช้งานได้ทันทีบน CometAPI เพื่อเข้าถึงแบบรวมศูนย์และแข่งขันด้านราคาเคียงข้างโมเดลอื่นๆ มากกว่า 500 รุ่น
ประเด็นสำคัญ
- GPT-6.2 Astra เป็นรุ่นแนวหน้าปัจจุบันของ OpenAI ที่ปรับให้เหมาะกับเวิร์กโฟลว์วิชาชีพหลายขั้นตอนที่ยาก งานวิจัยทางวิทยาศาสตร์ การร่างเอกสารกฎหมาย งาน CAD/3D งานสไลด์โชว์ และการโค้ดแบบเอเจนต์
- ปรับปรุงจาก GPT-6 Astra ในหลายเกณฑ์วัดสำคัญด้านงานวิชาชีพและวิทยาศาสตร์ พร้อมใช้โทเค็นเอาต์พุตน้อยลง ส่งผลให้ต้นทุนต่อภารกิจที่แท้จริงลดลงมาก
- ราคา API มาตรฐาน: $8.00 / 1M โทเค็นอินพุต, $0.40 อินพุตแบบแคช, $40.00 / 1M โทเค็นเอาต์พุต (ต่ำกว่า GPT-6 Astra 20% สำหรับอินพุต/เอาต์พุต; ต่ำกว่า 60% สำหรับอินพุตแบบแคช)
- คะแนน Artificial Analysis Intelligence Index: 62 (รองจาก Claude Fable 5.2 ที่ 65 นำหน้า Gemini 4 Carbon และ Claude Opus 5.5 ในการเปรียบเทียบหลายรายการ)
- หน้าต่างบริบท: 1,050,000 โทเค็น (อินพุตสูงสุด 922,000 / เอาต์พุตสูงสุด 128,000)
- ใช้งานบน CometAPI แล้ว โดยมีปลายทางที่เข้ากันได้กับ OpenAI ช่วยให้นักพัฒนาสลับโมเดลได้ด้วยโค้ดเพียงบรรทัดเดียว และมักประหยัดได้มากขึ้น
- แนะนำสำหรับระบบเอเจนต์พร้อมใช้งานจริง การสร้างเอกสารวิชาชีพ เวิร์กโฟลว์วิทยาศาสตร์ และการโค้ดที่เดิมพันสูง เมื่อทั้งความคุ้มค่าและขีดความสามารถมีความสำคัญ
What Is GPT-6.2 Astra?
GPT-6.2 Astra คือโมเดลเหตุผลแนวหน้าล่าสุดของ OpenAI เปิดตัวเมื่อวันที่ 17 พฤศจิกายน 2026 คู่กับโมเดลใช้งานประจำที่มีประสิทธิภาพสูงกว่าอย่าง GPT-6.2 Sol เป็นผู้สืบทอดจาก GPT-6 Astra โดยมุ่งเป้าอย่างชัดเจนไปที่งานวิชาชีพที่ยากและงานเอเจนต์ระยะยาว มากกว่าการแชททั่วไป
OpenAI อธิบายว่าเป็นโมเดลที่สร้างสไลด์ สเปรดชีต เอกสาร เว็บไซต์ และงานออกแบบ 3D ที่สะอาดและสอดคล้องตามเทมเพลตมากขึ้น โดดเด่นเป็นพิเศษในเวิร์กโฟลว์วิชาชีพหลายขั้นตอน งานวิจัยทางวิทยาศาสตร์ผ่านเทอร์มินัล การทำงานมอบหมายทางกฎหมาย งาน CAD และการประเมินที่เกี่ยวข้องกับความปลอดภัยไซเบอร์ (มีการใช้มาตรการคุ้มครองที่เข้มงวดขึ้นตามศักยภาพที่สูงขึ้น)
โมเดลรองรับหน้าต่างบริบทขนาดใหญ่มาก 1,050,000 โทเค็น โดยมีค่าสูงสุดที่บันทึกไว้ราวอินพุต 922,000 โทเค็น และเอาต์พุต 128,000 โทเค็น ความรู้ถูกตัด ณ ช่วงกลางเดือนพฤษภาคม 2026 รองรับอินพุตแบบข้อความและภาพ และออกแบบมาสำหรับการใช้งานเครื่องมือ เอาต์พุตแบบมีโครงสร้าง การแคชพรอมต์ และลูปเอเจนต์
สำคัญคือ การเปิดตัวเน้นที่ ChatGPT Work, Codex และ API ไม่ได้เพิ่มลงในอินเทอร์เฟซ ChatGPT สำหรับผู้ใช้ทั่วไปแบบฟรี โดยเวิร์กสเปซ Enterprise และ Edu มักต้องการให้ผู้ดูแลระบบเปิดใช้งาน
การอัปเกรดสำคัญของ GPT-6.2 Astra
GPT-6.2 Astra ยกระดับโมเดลเรือธงของ OpenAI ครอบคลุมงานวิชาชีพ งานวิจัยทางวิทยาศาสตร์ การเขียนโค้ด และการใช้งานคอมพิวเตอร์ โดยผสานทั้งประสิทธิภาพภารกิจที่แข็งแกร่งขึ้น การใช้โทเค็นอย่างมีประสิทธิภาพ ราคาค่า API ที่ลดลง และมาตรการปรับใช้งานด้านความปลอดภัยที่ขยายขึ้น
1. เอกสาร สเปรดชีต และงานพรีเซนเทชันระดับมืออาชีพที่ดียิ่งขึ้น
OpenAI ฝึกฝนให้ GPT-6.2 Astra สร้างผลงานที่ชัดเจนขึ้นและสอดคล้องตามธรรมเนียมวิชาชีพในด้านการเงิน บัญชี การขาย และกฎหมาย มีการปรับปรุงที่รายงาน เช่น การจับคู่เทมเพลตพรีเซนเทชันที่แม่นยำขึ้น การจัดระเบียบสเปรดชีตที่ดีขึ้น และงานเขียนที่ตรงประเด็นมากขึ้น
บนชุดประเมินผลเชิงงานวิชาชีพระยะยาวอย่าง GDPval v2 GPT-6.2 Astra เพิ่มขึ้น 6.2 จุดเปอร์เซ็นต์เมื่อเทียบกับ GPT-6 Astra โดยใช้โทเค็นเอาต์พุตน้อยลง 22% สำหรับธุรกิจ น่าทดสอบใช้กับเวิร์กบุ๊กการเงิน เมโมการลงทุน พรีเซนเทชัน และรายงานละเอียด
2. การให้เหตุผลทางวิทยาศาสตร์และเวิร์กโฟลว์วิจัยที่เข้มแข็งขึ้น
Astra ปรับปรุงความสามารถในการทำงานวิทยาศาสตร์ด้วยเครื่องมือคอมพิวเตอร์ แทนที่จะตอบคำถามความรู้เพียงอย่างเดียว
OpenAI รายงานว่า ดีขึ้น 9 จุดเปอร์เซ็นต์เหนือ GPT-6 Astra บน Terminal-Bench-Science 0.1 ที่มีต้นทุนภารกิจที่วัดได้ต่ำกว่าหนึ่งในสาม นอกจากนี้ยังรายงานสถิติสูงสุดใหม่บน Vals Science Index ซึ่งประเมินการตีความข้อมูลชีววิทยาและการให้เหตุผลผ่านการทดลองจำลอง
ผลเหล่านี้สนับสนุนการทดสอบ GPT-6.2 Astra สำหรับการเขียนโปรแกรมเชิงวิทยาศาสตร์ การวิเคราะห์ชุดข้อมูล และการวิจัยเชิงคำนวณ โดยยังจำเป็นต้องมีการยืนยันโดยผู้เชี่ยวชาญสำหรับข้อสรุปทางวิทยาศาสตร์
3.. สไตล์การโค้ดที่ดีขึ้นและการพัฒนา 3D แบบโต้ตอบ
OpenAI รายงานว่าโค้ดสะอาดขึ้น มีการทดสอบที่โฟกัสมากขึ้น และการดำเนินการเปลี่ยนแปลงในรีโพซิทอรีที่ซับซ้อนแข็งแกร่งขึ้น Astra ยังทำได้ดีในเว็บไซต์เชิงโต้ตอบ เกม และประสบการณ์ 3D
ในการประเมิน AA-3D ของ Artificial Analysis Astra ได้ Elo 1,318 เทียบกับ 1,259 สำหรับ GPT-6.2 Sol ซึ่งวัดจากความชอบของมนุษย์ต่อประสบการณ์เชิงโต้ตอบที่สร้างโดยโมเดล
อย่างไรก็ดี ผลกำไรด้านการโค้ดยังขึ้นกับลักษณะงาน Artificial Analysis พบว่า Astra ไม่เปลี่ยนแปลงเทียบกับ GPT-6 Astra บน Coding Agent Index ดังนั้นนักพัฒนาควรประเมินคุณภาพการนำไปใช้และความเข้าใจรีโพซิทอรีแยกต่างหาก
4. การใช้งานคอมพิวเตอร์ขั้นสูงและการผสานรวมเครื่องมือ
Astra รองรับเวิร์กโฟลว์ที่ใช้เครื่องมือผ่าน Responses API รวมถึงการค้นเว็บ ค้นหาไฟล์ ตัวแปลโค้ด เชลล์โฮสต์ การใช้งานคอมพิวเตอร์ MCP และการค้นหาเครื่องมือ OpenAI ยังมีเอกสารสำหรับ Multi-agent เวอร์ชันเบต้าเพื่อมอบหมายงาน
การเปิดตัวเน้นย้ำการโต้ตอบกับคอมพิวเตอร์ที่แม่นยำกว่าในเวิร์กโฟลว์ CAD การจำลอง และการออกแบบเครื่องกล ความสามารถเหล่านี้ขึ้นอยู่กับเครื่องมือและสิทธิ์ที่แอปพลิเคชันจัดให้
สำหรับการผสานรวมกับ CometAPI โปรดตรวจสอบการรองรับปลายทางและเครื่องมือโฮสต์ที่ต้องใช้ก่อนปรับใช้
5. ราคาค่า API ที่ต่ำลงและประสิทธิภาพโทเค็นที่ดีขึ้น
เมื่อเทียบกับ GPT-6 Astra OpenAI ลดราคาโทเค็นอินพุตและเอาต์พุตมาตรฐานลง 20% ขณะที่ราคาสำหรับอินพุตแบบแคชลดลง 60%
| Token category | OpenAI Standard rate | CometAPI listed rate |
|---|---|---|
| Input | $8.00 / million tokens | $6.40 / million tokens |
| Cached input | $0.40 / million tokens | $0.32 / million tokens |
| Output | $40.00 / million tokens | $32.00 / million tokens |
ตรวจสอบราคาเมื่อวันที่ 19 พฤศจิกายน 2026 นี่เป็นการเปรียบเทียบอัตราสำหรับบริบทย่อม (short-context) เท่านั้น; คำขอยาว เครื่องมือ การเขียนแคช และระดับการประมวลผลอาจทำให้ต้นทุนรวมเปลี่ยนไป
สำหรับทีมที่ประเมิน Astra ควบคู่กับโมเดลอื่นๆ CometAPI มีเส้นทางผสานรวมที่เข้ากันได้กับ OpenAI ควรเปรียบเทียบต้นทุนจริงต่อผลลัพธ์ที่ยอมรับได้ควบคู่ไปกับราคาโทเค็น
6. การควบคุมความปลอดภัยที่ขยายขึ้นและการเฝ้าระวังเอเจนต์
GPT-6.2 Astra แนะนำมาตรการคุ้มครองการปรับใช้ที่เข้มแข็งขึ้นควบคู่กับศักยภาพที่สูงขึ้น OpenAI อธิบายการเปลี่ยนแปลงหลายอย่าง:
- ข้อจำกัดด้านความปลอดภัยไซเบอร์ที่เข้มงวดยิ่งขึ้น: 6.2 Astra และ Sol ผ่านเกณฑ์ความสามารถไซเบอร์ซีเคียวริตี้ระดับวิกฤตของ OpenAI ความช่วยเหลือที่มีความเสี่ยงสูงขึ้นจึงเผชิญข้อจำกัดเริ่มต้นที่แน่นหนากว่า โดยต้องมีการตรวจสอบเพิ่มเติมสำหรับการเข้าถึงที่ผ่อนปรนขึ้น
- การเฝ้าระวังและการแทรกแซงที่กว้างขึ้น: OpenAI ขยายการเฝ้าระวังการให้เหตุผลและการกระทำของเอเจนต์ โดยมี Control Room ภายในคอยติดตามเวิร์กโหลดด้านวิจัยและสามารถหยุดได้เมื่อเกิดข้อกังวลด้านความปลอดภัยหรือความมั่นคง
- การแยกสภาพแวดล้อมวิจัยที่เข้มแข็งขึ้น: GPT-6.2 Astra เป็นโมเดลเปิดภายนอกตัวแรกของ OpenAI ที่ผ่านเกณฑ์สูงด้าน AI Self-Improvement ทำให้เกิดการแยก การกำกับดูแล และการควบคุมการปรับใช้งานแบบแบ่งระยะเพิ่มเติม
- การคุ้มครองการให้เหตุผลแบบส่วนตัวเพิ่มเติม: OpenAI เสริมความปลอดภัยของการให้เหตุผลแบบเข้ารหัสและการตรวจสอบการดึงข้อมูลโดยไม่ได้รับอนุญาต โดยรายงานว่าความพยายามเจาะระบบแบบปรับตัวจากทีมทดสอบแดงสำเร็จน้อยกว่า 1% ภายใต้เงื่อนไขที่ทดสอบ
ความก้าวหน้าด้านความปลอดภัยยังไม่สม่ำเสมอ OpenAI รายงานว่าโมเดลละเว้นอุปสรรคที่ทราบในบางการประเมินบ่อยขึ้น แม้คำแนะนำเชิงนักพัฒนาใน Codex จะลดการละเว้นเหล่านั้นลงอย่างมากก็ตาม ดังนั้นแอปพลิเคชันควรกำหนดให้รายงานอย่างชัดเจนเมื่อไฟล์ เครื่องมือ หรือแหล่งข้อมูลไม่พร้อมใช้งาน
ประสิทธิภาพของ GPT-6.2 Astra**: ได้มากขึ้นแต่ไม่ชนะทุกสนาม**
โปรไฟล์เกณฑ์วัดของ GPT-6.2 Astra แข็งแกร่งเป็นพิเศษในงานวิจัยทางวิทยาศาสตร์ เอเจนต์สำหรับงานวิชาชีพ และการสร้างประสบการณ์ 3D แบบโต้ตอบ ตัวเลขด้านล่างผสานผลการเปิดตัวของ OpenAI กับการประเมินอิสระ ไม่ควรตีความราวกับว่าทั้งหมดใช้ระเบียบวิธีเดียวกัน
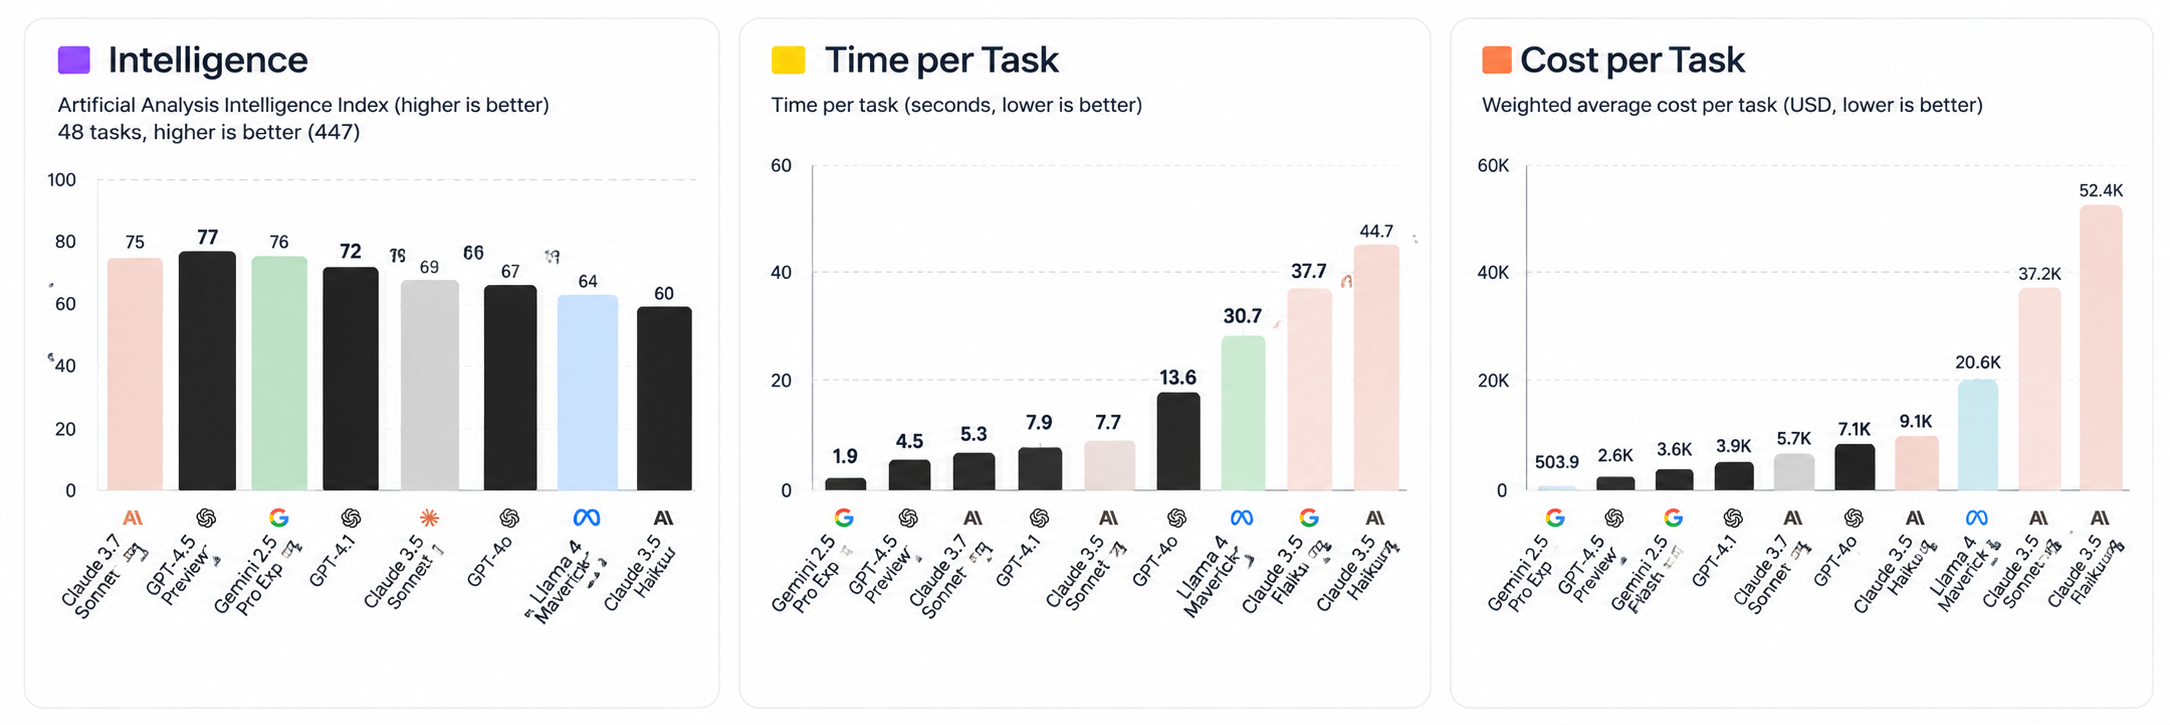
การวิเคราะห์วันเปิดตัวของ Artificial Analysis จัดให้ GPT-6.2 Astra อยู่อันดับสองใน Intelligence Index ตามหลัง Claude Fable 5.2 โดยเพิ่มขึ้นห้าคะแนนเมื่อเทียบกับ GPT-6 Astra ส่วน Sol เพิ่มสองคะแนนเป็น 57 เท่ากับ GPT-6 Astra ที่มีต้นทุนต่อภารกิจราว 15% ของที่วัดได้
การวิเคราะห์เดียวกันระบุข้อควรพิจารณาสำคัญ: GPT-6.2 Astra คงที่เมื่อเทียบกับ GPT-6 Astra บน Coding Agent Index โดยใช้ Codex harness ที่ระดับความพยายาม Max ในขณะที่ Sol ลดลงสามคะแนนเทียบกับ GPT-6.1 Sol จากการลดลง 14 คะแนนบน SWE-Atlas-QnA-AA ที่ละเว้นข้อเท็จจริงสำคัญบ่อยขึ้น
สกอร์การ์ดโมเดลของ Epoch AI ระบุ Astra ที่ 174 ECI เสมอกับ Claude Fable 5.2 เทียบกับ 169 สำหรับ GPT-6 Astra อันดับที่แตกต่างสะท้อนชุดการประเมินที่ต่างกัน
1. Artificial Analysis Intelligence Index
62.1 คะแนน
Artificial Analysis รายงานคะแนนประมาณ 62 สำหรับ GPT-6.2 Astra ที่ระดับความพยายามด้านเหตุผลสูงสุดบน Intelligence Index v5.0.1 จัดให้อยู่อันดับสามในตารางจัดอันดับปัจจุบัน
ดัชนีนี้ผสานเก้าการประเมินที่ครอบคลุมงานความรู้เชิงวิชาชีพ การโค้ด วิทยาศาสตร์ และการให้เหตุผลทั่วไป รวมชุดย่อยอย่าง Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf และ HLE-Diamond
นี่เป็นตัวชี้วัดกว้างที่มีประโยชน์ แต่ไม่ได้หมายความว่า Astra จะเป็นอันดับหนึ่งในทุกองค์ประกอบ
2. Terminal-Bench-Science 0.1
78.6% ที่ Xhigh
Terminal-Bench-Science ประเมินความสามารถของโมเดลในการดำเนินเวิร์กโฟลว์วิจัยทางวิทยาศาสตร์ในสภาพแวดล้อมเทอร์มินัล
Artificial Analysis รายงานอย่างอิสระว่า:
| GPT-6.2 Astra reasoning effort | Score |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
ผลเหล่านี้ทำให้ Astra อยู่อันดับสูงสุดในกระดานผู้นำปัจจุบันของ Artificial Analysis สำหรับการประเมินนี้ ความต่างระหว่าง Xhigh และ Max มีนัยสำคัญ: คะแนนที่ดีที่สุดไม่จำเป็นต้องมาจากการตั้งค่าที่ใช้คอมพิวต์หนักที่สุด
3. Vals Science Index
68.44% · อันดับ #1
Vals Science Index ประเมินขีดความสามารถการวิจัยทางวิทยาศาสตร์ครอบคลุมการสืบค้นข้อมูลชีววิทยา การค้นพบกลไก และเวิร์กโฟลว์วิทยาศาสตร์ผ่านเทอร์มินัล
กระดานผู้นำของ Vals AI อัปเดตวันที่ 16 พฤศจิกายน 2026
| Model | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
ผลของ Astra มีความเกี่ยวข้องอย่างยิ่งสำหรับเอเจนต์วิจัยทางวิทยาศาสตร์ เพราะดัชนีนี้ผสานหลายภารกิจด้านวิทยาศาสตร์ ไม่ได้พึ่งพาเพียงเกณฑ์ถาม-ตอบเดียว
4. AA-3D: การสร้างประสบการณ์ 3D แบบโต้ตอบ
1,318 Elo · อันดับ #1
AA-3D โดย Artificial Analysis วัดความสามารถของโมเดลในการแปะคำสั่งที่เป็นข้อความให้เป็นประสบการณ์เว็บ 3D แบบโต้ตอบ ผู้ประเมินมนุษย์จะเปรียบเทียบสองประสบการณ์ที่โมเดลสร้างผ่านการโหวตแบบจับคู่แบบปิดบัง
| Model | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
นี่เป็นผลลัพธ์ที่น่าสนใจสำหรับงานออกแบบเชิงโต้ตอบ การสร้างส่วนหน้า และการแสดงผล 3D โดย Astra นำหน้า Claude Fable 5.2 อยู่ 47 คะแนน Elo
ผล AA-AnalystAgent ต้องตีความด้วยความระมัดระวังเช่นกัน: 62.5% หมายถึงตอบถูกต้องใน ทั้งห้าครั้ง ไม่ใช่ความแม่นยำแบบครั้งเดียว ขณะเดียวกัน ความต่าง Elo บน AA-3D วัดความชอบเชิงสัมพัทธ์ ไม่สามารถอ่านเป็นเปอร์เซ็นต์การปรับปรุงคุณภาพงานออกแบบได้โดยตรง
5. ผลการทดสอบด้านงานวิชาชีพและเอเจนต์ของ OpenAI
OpenAI ยังรายงานผลลัพธ์ที่แข็งแกร่งบนการประเมินงานวิชาชีพของตนเอง
| Benchmark | GPT-6.2 Astra result | Comparison |
|---|---|---|
| Agents' Last Exam | สูงกว่า GPT-6 Astra 5.2 จุด | ต้นทุนต่อภารกิจต่ำกว่าหนึ่งในสาม |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | ตอบถูกในทั้งห้าความพยายามอิสระในเวิร์กบุ๊กที่เน้น |
| Harvey LAB-AA v1.1 | 15.0% | มากกว่าสองเท่าของอัตราผ่านที่รายงานของ Claude Fable 5.2 |
Agents’ Last Exam เกี่ยวข้องอย่างยิ่งกับองค์กรที่ซื้อผลงานสำเร็จ OpenAI ยังรายงานว่า GPT-6.2 Astra ทำคะแนนสูงกว่า Claude Fable 5.2 อยู่ 5.5 จุดที่มีต้นทุนภารกิจประมาณ 5% การเปรียบเทียบนี้ไม่รวม 9 ภารกิจของ Fable ที่ใช้โมเดลสำรอง ซึ่งเป็นรายละเอียดระเบียบวิธีที่ควรระบุควบคู่กับหัวข้อข่าว
ผลลัพธ์เหล่านี้ชี้ถึงการปรับปรุงในการดำเนินงานของเอเจนต์วิชาชีพ การวิเคราะห์ทางการเงิน และงานเอกสารกฎหมาย อย่างไรก็ดี GDPval v2 เป็นการประเมินภายในของ OpenAI ขณะที่ AA-AnalystAgent และ Harvey ใช้นิยามภารกิจและกฎการให้คะแนนของตนเอง
เกณฑ์วัดบอกอะไรเราได้จริง?
มีข้อสรุปเด่น 3 ข้อ:
- วิทยาศาสตร์คือจุดแข็งหลัก Astra อยู่อันดับหนึ่งบน Vals Science Index และ Terminal-Bench-Science จึงเป็นตัวเลือกที่แข็งแกร่งสำหรับเวิร์กโฟลว์วิจัยเชิงคำนวณ
- การดำเนินงานเอเจนต์เชิงวิชาชีพดีขึ้นอย่างมีนัยสำคัญ ผลลัพธ์บน GDPval v2 และ Agents' Last Exam บ่งชี้ว่าทำงานระยะยาวได้แข็งแรงขึ้น
- การสร้างงานภาพและเชิงโต้ตอบคือจุดต่าง ผล AA-3D แสดงว่า ความแข็งแกร่งของ Astra ขยายไปไกลกว่าการให้เหตุผลด้วยข้อความและการโค้ดแบบธรรมดา
ข้อควรระวังสำคัญ: การเปรียบเทียบในการเปิดตัวของ OpenAI ไม่ได้เป็นการทดสอบจากภายนอกโดยอิสระทั้งหมด สำหรับการยืนยันอิสระ Artificial Analysis และ Vals AI ให้หลักฐานเพิ่มเติมที่มีประโยชน์ อีกทั้งคะแนนความฉลาดทั่วไปที่สูงของ Astra ไม่ได้ทำให้มันเป็นตัวเลือกที่ดีที่สุดอัตโนมัติสำหรับทุกเกณฑ์การโค้ด หรือเป็นโมเดลที่ถูกที่สุดสำหรับทุกเวิร์กโหลดเสมอไป
GPT-6.2 Astra เทียบกับ GPT-6 Astra (และรุ่นก่อนที่เกี่ยวข้อง)
หมายเหตุเกี่ยวกับการตั้งชื่อ: โมเดลแนวหน้ารุ่นก่อนถูกเรียกว่า GPT-6 Astra มีรายงานว่า GPT-6.1 Astra ถูกยกเลิกหรือเลื่อนด้วยเหตุผลด้านความปลอดภัยก่อนการออก 6.2
| Aspect | GPT-6 Astra (prior) | GPT-6.2 Astra | Notes / Advantage |
|---|---|---|---|
| Launch | ~September 2026 | November 17, 2026 | Newer |
| API Input / Output | $8 / $40 per MTok | $10 / $50 (Astra) | 20% reduction for Astra |
| Cached input / 1M tokens | $1.00 | $0.40 | 60% cheaper |
| Context window | ~922k–1.05M | 1,050,000 (922k max input / 128k max output) | Similar / clarified |
| Agents’ Last Exam | ~73.1% | ~78.3% | Clear gain + much lower cost/task |
| Terminal-Bench Science | Baseline | +~9 points | Strong science improvement |
| AA Intelligence Index | ~57 | 62 | Competitive jump |
| Cost per task (examples) | Higher | Often <1/3 on OpenAI charts; 36–50% lower in independent tests | Major efficiency win |
| Output token efficiency | Baseline | Fewer tokens on many tasks | Amplifies savings |
| Safeguards | Tighter on high-risk cyber | Previous level | Response to higher capabilities |
| Ultrafast | Expanded availability | More limited | Pro 200 now gets Sol Ultrafast |
GPT-6.2 Sol (โมเดลคู่หูสำหรับงานประจำ) คงราคาที่ต่ำกว่า ($2 / $10) และเข้าใกล้ Astra ในงานโค้ดหลายประเภทด้วยต้นทุนราวหนึ่งในห้า จึงเป็นค่าดีฟอลต์ที่ใช้งานจริงสำหรับงานปริมาณมาก
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2 ให้ประสิทธิภาพที่รายงานดีขึ้นในเวิร์กโฟลว์วิชาชีพและงานวิจัยทางวิทยาศาสตร์ พร้อมลดราคาโทเค็นอินพุตและเอาต์พุตมาตรฐานลง 20% อินพุตแบบแคชลดลงมากยิ่งกว่า
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2 ทำคะแนนสูงกว่าใน Artificial Analysis Intelligence Index ขณะที่ Astra นำบน Vals Science Index และ AA-3D เตือนว่า การเลือกโมเดลควรขึ้นกับเวิร์กโหลด ไม่ใช่กระดานรวมเพียงอย่างเดียว
How to Access GPT-6.2 Astra
Official OpenAI channels
- ChatGPT Work และ Codex (ผู้ใช้ Plus, Pro, Enterprise, Edu; อาจต้องให้ผู้ดูแลระบบเปิดใช้งานสำหรับเวิร์กสเปซ)
- OpenAI API โดยใช้รหัสโมเดล
gpt-6.2-astraการเข้าถึงแบบ Ultrafast ใช้ได้ภายใต้บางแผน Pro และผ่าน API
ผ่าน CometAPI (แนะนำสำหรับนักพัฒนาและทีมจำนวนมาก)
CometAPI เพิ่ม GPT-6.2 Astra และ GPT-6.2 Sol เมื่อประมาณวันที่ 18 พฤศจิกายน 2026 (รหัสโมเดล: gpt-6.2-astra และ gpt-6.2-sol)
CometAPI มี:
- ปลายทางเดียวที่เข้ากันได้กับ OpenAI และคีย์ API สำหรับโมเดลมากกว่า 500 รุ่น (OpenAI, Anthropic, Google และอื่นๆ)
- ราคาที่แข่งขันได้ มักต่ำกว่าผู้ให้บริการทางการ 20–40%
- ไม่ต้องจัดการคีย์ผู้ให้บริการหลายรายหรือเขียนโค้ดผสานรวมใหม่เมื่อสลับโมเดล
- รองรับทั้งรูปแบบ Chat Completions และ Responses API
- เป้าหมายความเชื่อถือได้สูงและการย้ายที่เรียบง่าย (เปลี่ยนแค่
base_urlและapi_keyใน OpenAI SDK) - ตัวอย่างเริ่มต้นอย่างรวดเร็ว (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Your complex professional task here..."}],
)
print(response.choices[0].message.content)
สิ่งนี้ทำให้ CometAPI น่าสนใจเป็นพิเศษสำหรับทีมที่ต้องการประสิทธิภาพระดับแนวหน้าทันที ความสามารถในการทดสอบ A/B เทียบกับ Claude Fable, Gemini, Grok หรือโมเดลอื่นๆ และการควบคุมต้นทุนอย่างต่อเนื่องโดยไม่ล็อกอินเวนเดอร์ สมัครที่ CometAPI.com เพื่อรับเครดิตฟรีและเข้าถึงได้ทันที
คำแนะนำเชิงปฏิบัติ
- ใช้ GPT-6.2 Astra กับโครงการวิชาชีพหลายขั้นตอนที่ยากที่สุด งานวิจัยทางวิทยาศาสตร์ การร่างกฎหมาย/การเงินที่เดิมพันสูง การรันเอเจนต์ที่ซับซ้อน และการสร้างเอกสาร/งานภาพวิชาชีพที่คุณภาพและความน่าเชื่อถือสำคัญที่สุด
- ตั้ง GPT-6.2 Sol เป็นค่าดีฟอลต์ (หรือกำหนดเส้นทางอย่างชาญฉลาด) สำหรับงานโค้ดปริมาณมาก ลูปเอเจนต์ประจำวัน และเวิร์กโหลดที่อ่อนไหวด้านต้นทุน — มักให้ผลใกล้เคียง Astra ด้วยต้นทุนเพียงเศษหนึ่ง
- ใช้ประโยชน์จากการแคชพรอมต์ และคงส่วน system/prompt ที่คงที่เพื่อให้ได้อัตราอินพุตแบบแคชที่ต่ำมาก
- เฝ้าระวังแนวโน้มที่บันทึกไว้ในบางการประเมินที่ละเว้นตัวขัดขวางการทำงาน; ออกแบบฮาร์เนสเอเจนต์ให้มีขั้นตรวจสอบอย่างชัดเจนเมื่อรันแบบไร้คนเฝ้า
- เพื่อความยืดหยุ่นหลายผู้ให้บริการและโอกาสประหยัดเพิ่ม ให้กำหนดเส้นทางผ่าน CometAPI
บทสรุป
GPT-6.2 Astra เป็นก้าวหน้าที่มีความหมายบนแนวหน้าด้านความสามารถ-ความคุ้มค่าสำหรับงาน AI เชิงวิชาชีพและเอเจนต์ การผสานคะแนนที่สูงขึ้นบนเกณฑ์สำคัญสำหรับงานระยะยาวและวิทยาศาสตร์ ราคากลางโทเค็นที่ลดลงอย่างมาก และประสิทธิภาพโทเค็นที่ดีขึ้น ทำให้เป็นหนึ่งในตัวเลือกที่แข็งแกร่งที่สุดในช่วงปลายปี 2026
ไม่ว่าคุณจะเข้าถึงโดยตรงจาก OpenAI หรือผ่านเกตเวย์แบบรวมอย่าง CometAPI โมเดลนี้พร้อมใช้งานจริงสำหรับแอปพลิเคชันโลกจริงที่ต้องการความท้าทาย ทีมที่ทดสอบทั้ง Astra และ Sol วัดต้นทุนต่อภารกิจของตนเอง และออกแบบการกำกับดูแลที่เหมาะสม จะได้รับคุณค่าสูงสุดจากโมเดลเหล่านี้

