
TL;DR
Grok 4.7 และ Xiaomi MiMo-V2.6 เปิดตัวห่างกันเพียงหนึ่งวัน แต่สะท้อนแนวทางสู่เอไอแนวหน้าที่แตกต่างกันชัดเจน โดย Grok 4.7 เน้นสแตกเอเจนต์เชิงกรรมสิทธิ์ที่บูรณาการแน่นสำหรับงานโค้ดและความรู้เชิงอาชีพ ขณะที่ MiMo-V2.6-Pro ผสานน้ำหนักโมเดลแบบเปิด หน้าต่างบริบทที่ยาวกว่า ความเข้าใจมัลติโหมดแบบเนทีฟ และการตั้งราคา API ที่ดุดัน
SpaceXAI วางตำแหน่ง Grok 4.7 เป็นโมเดลแนวหน้าสำหรับ งานโค้ด เอเจนต์ และงานความรู้ ด้วยหน้าต่างบริบท 500K โทเค็นและระดับความพยายามในการให้เหตุผลที่กำหนดค่าได้
Xiaomi วางตำแหน่ง MiMo-V2.6-Pro เป็น เรือธงมัลติโหมดพร้อมบริบท 1M ที่มีน้ำหนักโมเดลแบบเปิดและรองรับความเข้าใจข้อความ ภาพ เสียง และวิดีโอ
สรุปสั้นๆ: Grok 4.7 เป็นผลิตภัณฑ์เอเจนต์แบบจัดการที่บูรณาการเชิงตั้งฉากมากกว่า; MiMo-V2.6-Pro ให้การควบคุมการดีพลอยที่มากขึ้นสำหรับนักพัฒนาและราคาต่อโทเค็นดิบที่ต่ำกว่ามาก ความเหมาะสมขึ้นกับลักษณะงาน มากกว่าคะแนนเบนช์มาร์กตัวเดียว
Key Takeaways
- Grok 4.7 ถูกสร้างมาเพื่อการโค้ดระยะยาวและเอเจนต์เชิงอาชีพ ในการประเมินที่ผู้ขายเผยแพร่ SpaceXAI รายงาน 46.3% บน CursorBench 4.0, 71.0% บน DeepSWE v1.1 ที่ความพยายามสูง, และ 1,657 บน AA Briefcase v1.1
- MiMo-V2.6-Pro แข่งขันได้อย่างโดดเด่นสำหรับโมเดลแบบเปิด Xiaomi เผยแพร่น้ำหนักโมเดลและรายงานผลใกล้เคียงระบบแนวหน้าเชิงกรรมสิทธิ์บนหลายเบนช์มาร์กโค้ดและเอเจนต์ แต่คะแนนข้ามผู้ขายไม่สามารถเทียบตรงกันได้
- MiMo ได้เปรียบเรื่องบริบทและมัลติโหมด MiMo-V2.6-Pro รองรับหน้าต่างบริบท 1M โทเค็น และความเข้าใจข้อความ ภาพ เสียง และวิดีโอ เมื่อเทียบกับ Grok 4.7 ที่บริบท 500K และรับอินพุตข้อความและภาพ
- MiMo ถูกกว่ามากในโทเค็น API ดิบ ราคามาตรฐานทางการคือ $0.435/$0.87 ต่อหนึ่งล้านโทเค็นอินพุต/เอาต์พุตที่ไม่แคช สำหรับ MiMo-V2.6-Pro เทียบกับ $2/$6 สำหรับ Grok 4.7
- สถาปัตยกรรมการดีพลอยคือข้อแลกเปลี่ยนชี้ขาด Grok เสนอชุดเครื่องมือโฮสต์โดยผู้ให้บริการที่แข็งแรงกว่า ส่วน MiMo มีน้ำหนักเปิดที่ทำให้ดีพลอยแบบส่วนตัว ปรับแต่งการเสิร์ฟ และควบคุมโครงสร้างพื้นฐานได้ลึกกว่า
Grok 4.7 vs MiMo-V2.6-Pro at a Glance
| Dimension | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Release | September 21, 2026 | September 22, 2026 |
| Access and control | Proprietary API and managed agent ecosystem | Open weights, self-hosting option, and API access |
| Performance evidence | Provider-reported strength in coding and long-running agent tasks; validate on the same task harness | Provider-reported strength across reasoning, coding, and multimodal tasks; validate on the same task harness |
| Distinctive strengths | First-party tools, managed workflows, and web/X-connected agents | Deployment control, 1M-token context, and text/image/audio/video understanding |
| Context window | 500K tokens | 1M tokens |
| Input modalities | Text and image | Text, image, audio, and video |
| Official standard uncached input / output per 1M tokens | $2 / $6 | $0.435 / $0.87 |
| Reasoning | Low to xHigh | Deep reasoning |
| Open weights | No | No |
| Best fit | Managed coding and agent workflows | Private deployment, multimodal input, and lower raw token cost |
What Is Grok 4.7?
SpaceXAI เปิดตัว Grok 4.7 เมื่อวันที่ 21 กันยายน 2026 อย่างเป็นทางการ โดยเป็นโมเดลที่ทรงความสามารถที่สุดสำหรับงานโค้ดและงานความรู้ การเปิดตัวนี้สำคัญเพราะก่อนหน้านั้นมีรายงานที่ผสมผสานข้อเท็จจริงยืนยันกับข้ออ้างอิงทางสถาปัตยกรรมที่รั่วไหล เอกสารเปิดตัวสุดท้ายไม่ได้เผยแพร่นับจำนวนพารามิเตอร์ทั้งหมดหรือที่ทำงานอยู่ ดังนั้นค่าประมาณพารามิเตอร์ก่อนเปิดตัวจึงไม่ควรถูกมองว่าเป็นสเปกทางการ
ตามโพสต์เปิดตัวอย่างเป็นทางการ Grok 4.7 ใช้ โมเดลฐานใหม่ที่ใหญ่กว่า Grok 4.6 และได้รับการฝึกฝนด้วยช่วงการเรียนรู้การเสริมแรงที่ยาวขึ้น โดยให้น้ำหนักกับปัญหาที่ใช้เวลาหลายชั่วโมงในการทำให้เสร็จ
โมเดลทั้งสองปรับให้เหมาะกับเลเยอร์ต่างกันของสแตก Grok 4.7 ให้สภาพแวดล้อมแบบจัดการที่เข้มข้นรอบโมเดล ขณะที่ MiMo-V2.6-Pro เปิดให้ผู้พัฒนาควบคุมเลเยอร์ของโมเดลและการดีพลอยได้มากกว่า
สำหรับพรอมต์ที่เกิน 200K โทเค็น SpaceXAI ใช้อัตราราคาแบบบริบทยาว โดยเผยแพร่เป็น $4 ต่อหนึ่งล้านโทเค็นอินพุต, $1 ต่อหนึ่งล้านโทเค็นอินพุตที่ถูกแคช, และ $12 ต่อหนึ่งล้านโทเค็นเอาต์พุต
Changes in Grok 4.7
การเปลี่ยนแปลงที่สำคัญที่สุดคือวัตถุประสงค์การฝึก ไม่ใช่เพียงแค่ตัวเลขเบนช์มาร์กที่สูงขึ้น SpaceXAI ระบุว่าการผสมผสานการเรียนรู้แบบเสริมแรงเปลี่ยนไปทางงานที่ยาวขึ้น หลายชั่วโมง ขณะที่โมเดลได้รับการฝึกให้ตรวจสอบงานของตัวเองอย่างรอบคอบขึ้นและเข้าใจฮาร์เนส Grok Bot แบบเนทีฟ การผสมผสานนั้นมุ่งเป้าไปที่การปฏิบัติการเอเจนต์จริง: รักษาสถานะ ใช้เครื่องมือ ตรวจงานระหว่างทาง และคงความสอดคล้องผ่านวิถีงานที่ยาว
Grok 4.7 Performance
| SpaceXAI-published benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
* SpaceXAI ระบุว่า Grok 4.7 บน DeepSWE เป็นโหมดความพยายามสูง ค่านี้เป็นการประเมินที่ผู้ให้บริการเผยแพร่และควรตีความภายใต้ฮาร์เนสและการตั้งค่าการให้เหตุผลที่เอกสารไว้
SpaceXAI นำเสนอชาร์ตเปิดตัวเป็นคอนเทนต์บนเว็บในหน้าประกาศอย่างเป็นทางการ ตารางด้านบนถอดค่าที่เปิดเผยจากแหล่งดังกล่าวโดยไม่วาดชาร์ตใหม่
What Is Xiaomi MiMo-V2.6?
Xiaomi เปิดตัวและโอเพ่นซอร์ส MiMo-V2.6 เมื่อวันที่ 22 กันยายน 2026 อย่างเป็นทางการ ตระกูลนี้รวม MiMo-V2.6-Pro และ MiMo-V2.6-Flash โดยมีตัวเลือกการเสิร์ฟ Pro-UltraSpeed สำหรับงานที่ไวต่อดีเลย์ หากจะเทียบตรงกับ Grok 4.7 นั้น MiMo-V2.6-Pro คือเรือธงคู่เทียบที่เหมาะสม
เอกสารทางการของ Xiaomi แยกกันระบุ น้ำหนักโมเดลแบบเปิด, อินพุตมัลติโหมดแบบเนทีฟ, และ ราคา API การผสมผสานนี้ทำให้ MiMo-V2.6 มีความหมายเกินกว่าเพียงอันดับบนกระดานเบนช์มาร์ก
MiMo-V2.6 vs MiMo-V2.5: What was improved?
หัวข้อทางสถาปัตยกรรมไม่ใช่แค่เช็คพอยต์ที่ใหญ่ขึ้น การออกเผยแพร่สาธารณะของ Xiaomi เน้นหนักที่โพสต์เทรนและ Live RL ตาม หมายเหตุเวอร์ชันทางการ Pro และ Flash แต่ละตัวทำขั้นตอนการเรียนรู้แบบเสริมแรง 30 สเต็ป และร่วมกันสร้างทราเจกทอรีราว 750,000 เส้น โดยต้นทุนเฟส RL ที่เปิดเผยอยู่ที่ประมาณ $2.62 ล้านสำหรับ Pro และ $850,000 สำหรับ Flash
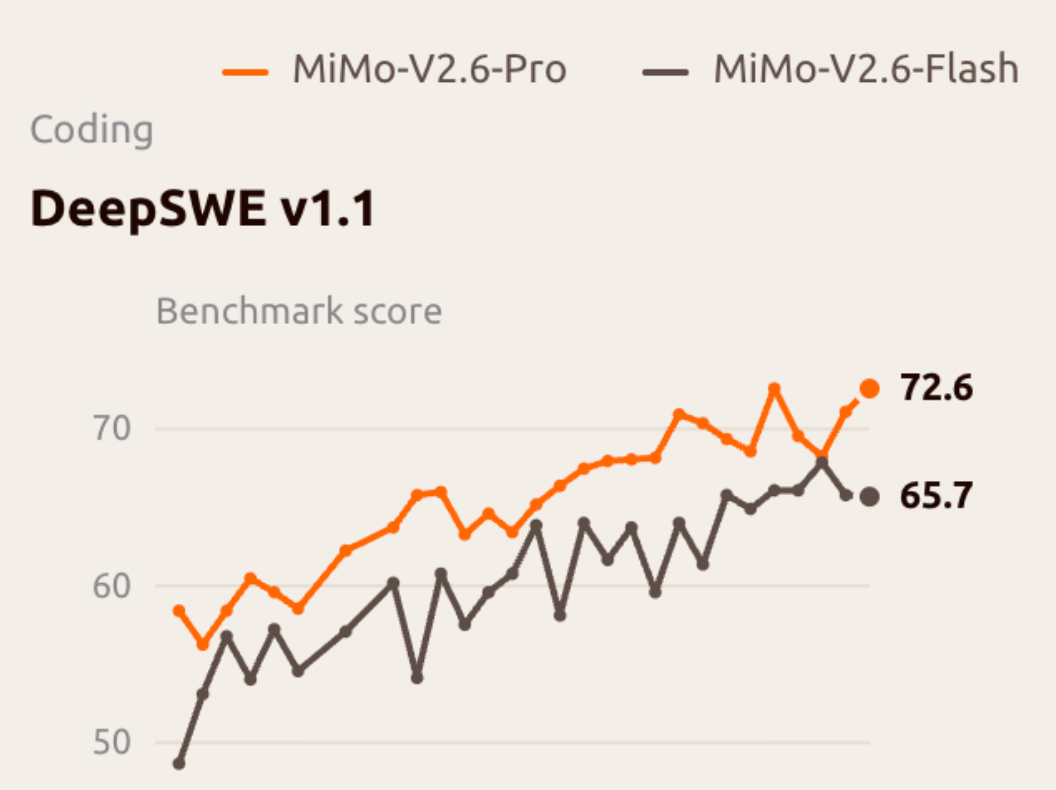
มีรายละเอียดเบนช์มาร์กหนึ่งที่ควรระวัง: กราฟ Live RL ของ Xiaomi แสดง MiMo-V2.6-Pro แตะราว 72.6 บน DeepSWE v1.1 ระหว่างการฝึก ขณะที่ตารางเปรียบเทียบสุดท้ายรายงาน 71.9 ตัวเลขเหล่านี้อ้างถึงบริบทการประเมินที่ต่างกันและไม่ควรถูกรวมเข้าด้วยกันโดยไม่ระบุที่มา
Grok 4.7 vs MiMo-V2.6-Pro: Benchmark Comparison
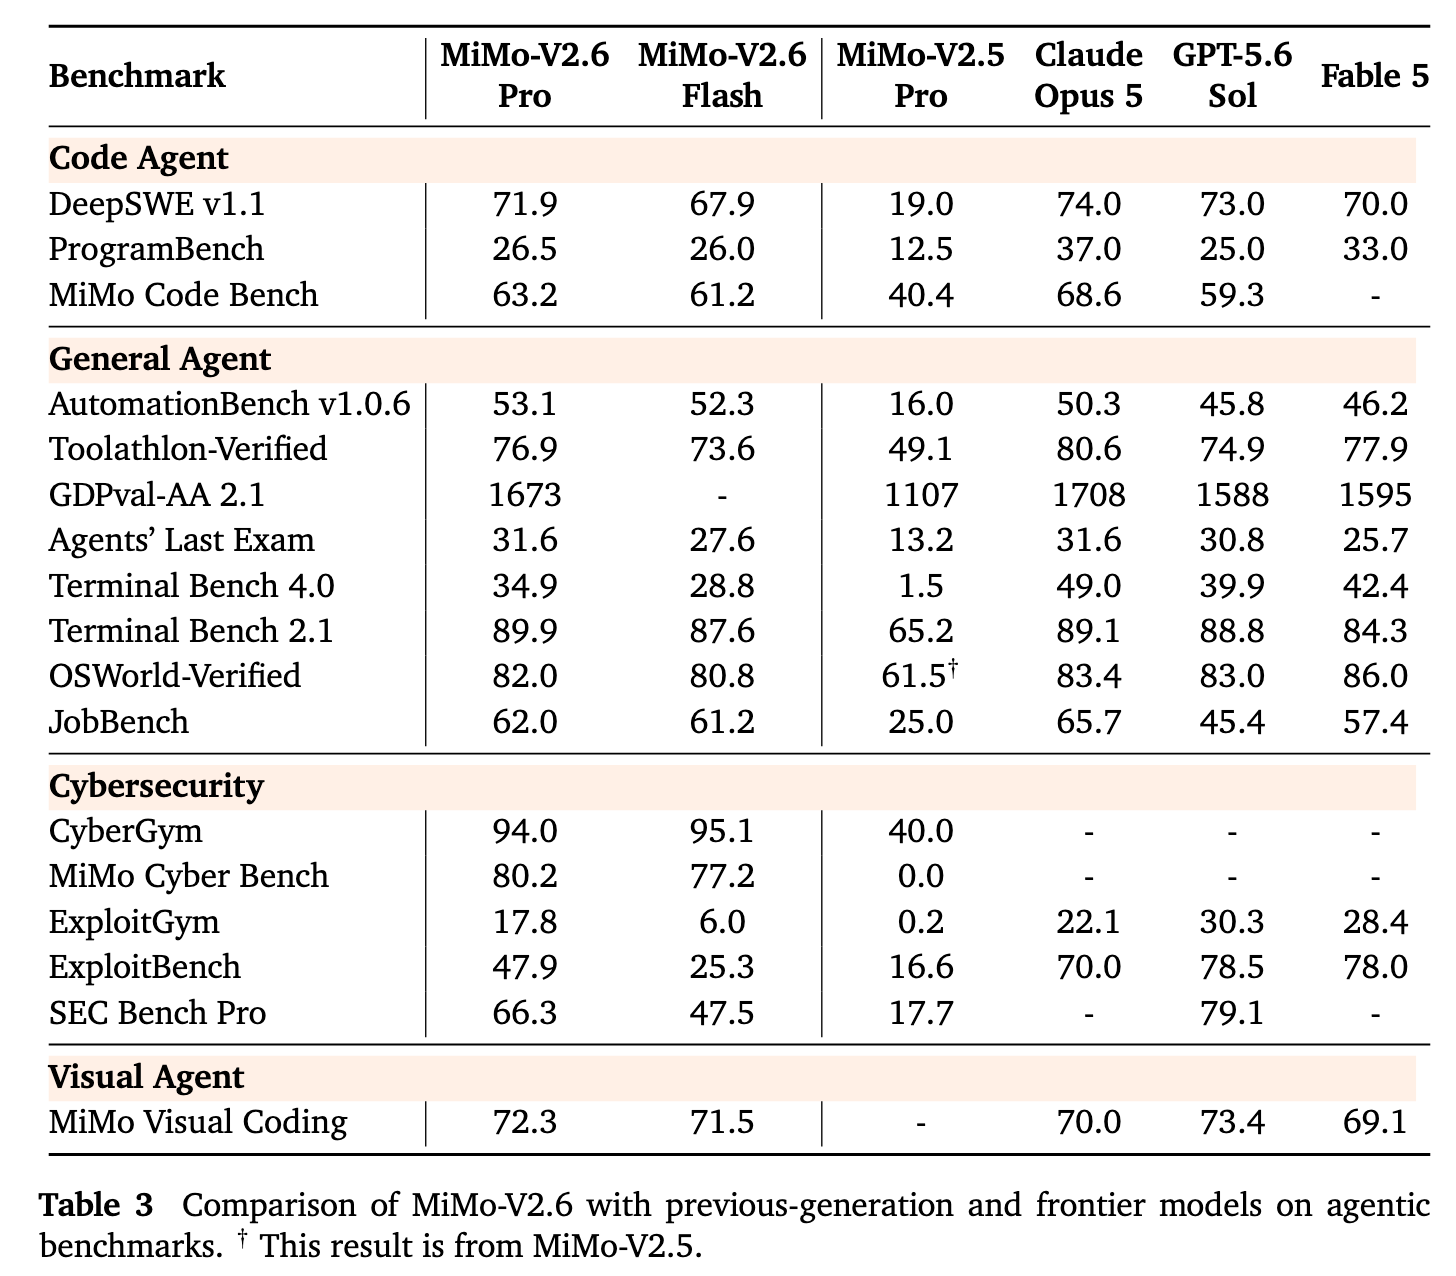
การเปรียบเทียบเบนช์มาร์กโดยตรงต้องระวัง ผู้ขายไม่ได้ใช้ฮาร์เนส งบประมาณการให้เหตุผล เช็คพอยต์ หรือคอนฟิกเครื่องมือที่เหมือนกันเสมอ แม้ชื่อเบนช์มาร์กจะเหมือนกัน ความแตกต่างเล็กน้อยของคะแนนอาจมีนัยน้อยกว่าที่เห็น วิธีที่ปลอดภัยคือแยกการวัดที่สอดคล้องจริงออกจากหลักฐานเชิงทิศทาง
Artificial Analysis Intelligence Index
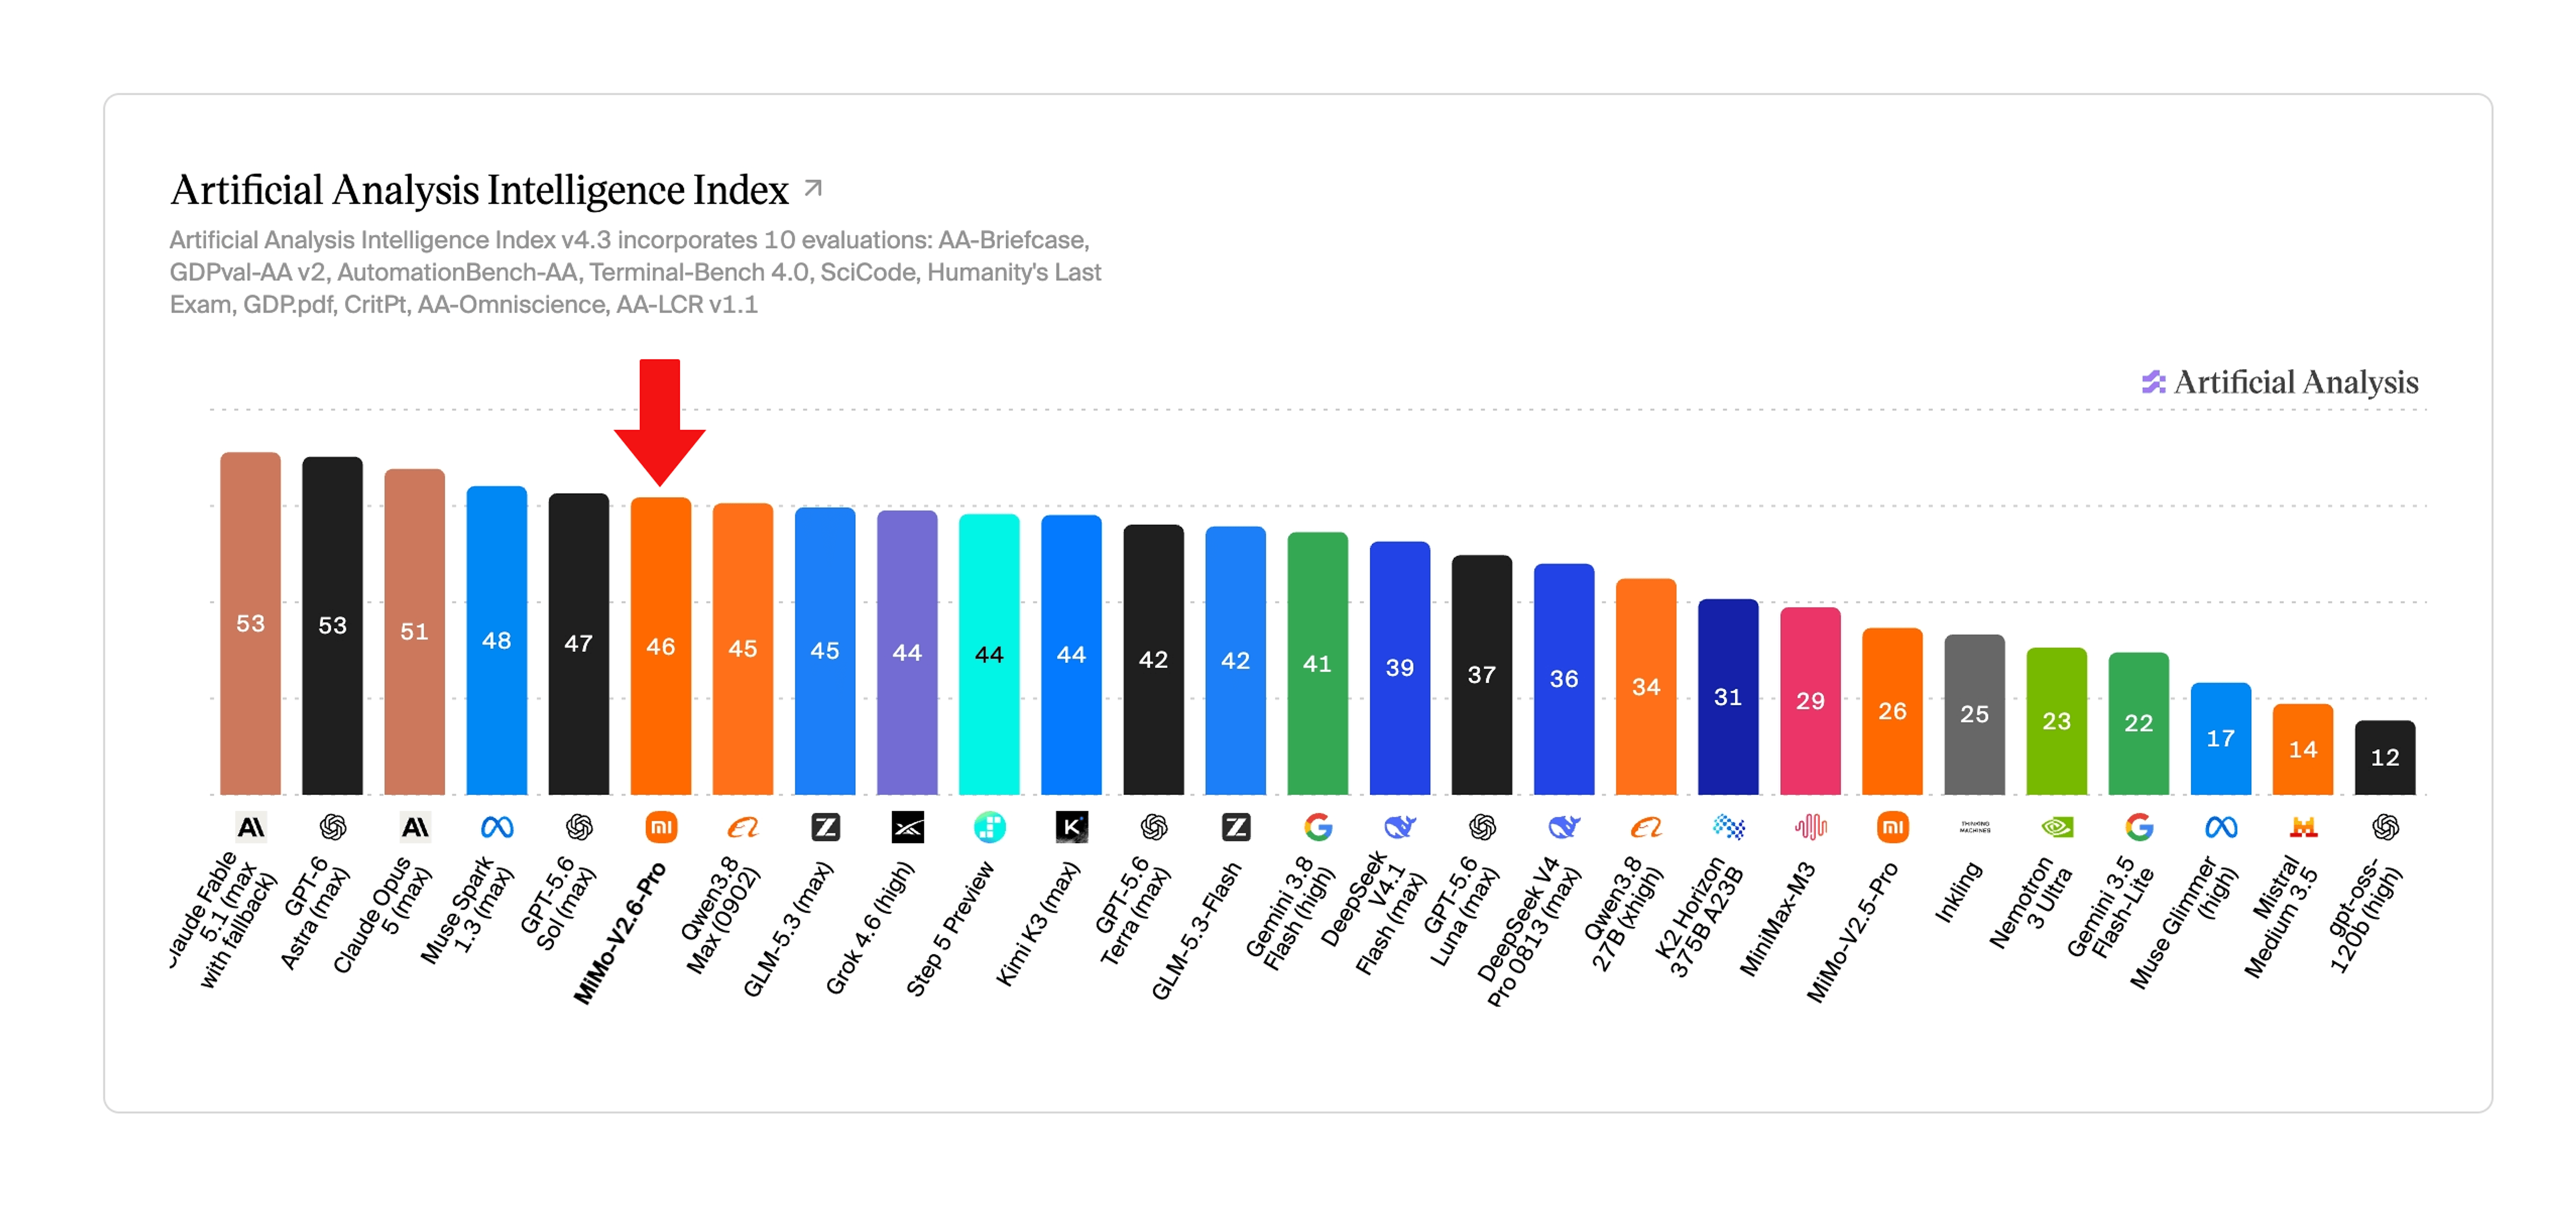
Xiaomi รายงาน 46.32 สำหรับ MiMo-V2.6-Pro บนดัชนีรวม Artificial Analysis การเปรียบเทียบกับ Grok ควรผูกกับสแนปช็อต Artificial Analysis และคอนฟิกโมเดลเดียวกัน การอ้างความเท่ากันโดยปัดเศษไม่ควรถูกนำเสนอโดยไม่มีแหล่งข้อมูลนั้น
Coding and Agent Performance
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Interpretation |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | ใกล้กันในตัวเลข; การรันและการตั้งค่าที่เผยแพร่ต่างกัน |
| GDPval-AA | ดูชาร์ตของ SpaceXAI | 1,673 | เป็นเชิงทิศทางเท่านั้นหากฮาร์เนสไม่สอดคล้องกัน |
| AA Briefcase | 1,657 | ดูชาร์ตของ Xiaomi | ใช้ค่าที่ผู้ขายรายงานพร้อมบริบทแหล่งที่มา |
| Terminal-Bench 4.0 | 38.0 | 34.9 | แนวโน้มคล้ายกัน; ฮาร์เนสมีผล |
| Context window | 500K | 1M | MiMo รองรับบริบทการทำงานมากกว่า |
* SpaceXAI รายงาน Grok 4.7 DeepSWE ที่ความพยายามสูง ** ตารางเปรียบเทียบสุดท้ายของ Xiaomi รายงาน 71.9; กราฟ Live RL แตะราว 72.6 ตัวเลขเหล่านี้มาจากบริบทการประเมินต่างกัน
Coding Workflow Fit
สำหรับงานโค้ด ความแตกต่างขึ้นกับว่า “การโค้ด” หมายถึงการแก้ปัญหาในรีโปแบบดิบ หรือประสบการณ์เอเจนต์โค้ดแบบจัดการครบวงจร บน DeepSWE v1.1 ตัวเลขที่เผยแพร่ใกล้กันพอที่ช่องว่างต่ำกว่า 1 จุดไม่ควรเป็นปัจจัยตัดสินการผลิตเพียงลำพัง
ข้อได้เปรียบของ Grok 4.7 สูงกว่าในสแตก มันบูรณาการกับ Grok Build ใช้ได้ใน Cursor ออกแบบให้เข้าใจฮาร์เนส Grok Bot และจับคู่กับเครื่องมือรันโค้ดและค้นหาแบบเฟิร์สปาร์ตี้
ข้อได้เปรียบของ MiMo-V2.6-Pro ต่ำกว่าในสแตก น้ำหนักเปิดทำให้การสร้างผู้ช่วยโค้ดแบบส่วนตัวเป็นจริง ปรับแต่งการเสิร์ฟ บังคับใช้การกำกับดูแลข้อมูล หรือทดลองกับฮาร์เนสเอเจนต์เฉพาะได้
สำหรับทีมที่ต้องเลือก ควรทำ A/B test ในการผลิตบนรีโปที่เป็นตัวแทน จะให้ข้อมูลมากกว่าการพึ่งเบนช์มาร์กสาธารณะตัวเดียว
Grok 4.7 vs MiMo-V2.6-Pro: Multimodal Capability Differences
นี่คือความแตกต่างที่ชัดเจนที่สุด Grok 4.7 รับอินพุตข้อความและภาพ และสร้างข้อความ แพลตฟอร์ม Grok ที่กว้างกว่ามีผลิตภัณฑ์สื่อแยกต่างหาก แต่ไม่ควรนำมาปะปนกับพื้นผิวโมดัลของโมเดล grok-4.7 เอง
MiMo-V2.6-Pro รองรับความเข้าใจข้อความ ภาพ เสียง และวิดีโอ เมื่อรวมกับหน้าต่างบริบท 1M โทเค็น จะขยายขอบเขตเวิร์กโฟลว์ที่จัดการได้ในคอนเทกซ์ของโมเดลเดียว
- การวิเคราะห์สกรีนช็อตและโค้ดในงานเดียว
- ความเข้าใจวิดีโอพร้อมคำสั่งประกอบ
- การประมวลผลเสียงแบบยาว
- เอเจนต์ใช้งานคอมพิวเตอร์พร้อมฟีดแบ็กเชิงภาพ
- ผู้ช่วยวิจัยแบบมัลติโหมด
- การสกัดและ QA แบบมัลติโหมดขนาดใหญ่
Grok 4.7 vs MiMo-V2.6-Pro: API Pricing Comparison
| Official API pricing | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M tokens | $2.00 | $0.435 |
| Cached input / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Long-context surcharge | Yes, above 200K prompt tokens | No comparable standard tier published |
| Open-weight/self-host option | No | Yes |
ในราคาฐาน MiMo-V2.6-Pro ถูกกว่าหลายเท่าทั้งในอินพุตปกติและเอาต์พุต โดยเฉพาะความแตกต่างใหญ่สำหรับบริบทที่ถูกแคช ซึ่งมีผลอย่างมีนัยต่อเศรษฐศาสตร์ของเอเจนต์ที่ประมวลผลรีโป เอกสารยาว หรือบริบทถาวรซ้ำๆ
Important pricing note: หน้าต่างบริบท 500K ของ Grok 4.7 ไม่ได้หมายความว่าบริบททั้งหมดจะคิดราคาตามอัตรามาตรฐาน คำขอที่เกิน 200K โทเค็นพรอมต์จะถูกคิดอัตราบริบทยาว
ณ วันที่ 24 กันยายน 2026 CometAPI ระบุ Grok 4.7 ที่ $1.60 อินพุต และ $4.80 เอาต์พุต ต่อหนึ่งล้านโทเค็น เทียบกับอัตราทางการ $2.00 และ $6.00 และระบุ MiMo-V2.6-Pro ที่ $0.348 อินพุต และ $0.696 เอาต์พุต ต่อหนึ่งล้านโทเค็น เทียบกับอัตราทางการ $0.435 และ $0.87 อัตราที่ระบุเหล่านี้ต่ำกว่า 20% จากอัตราทางการที่สอดคล้องกัน ราคาและคุณสมบัติอาจเปลี่ยนแปลงได้ โปรดยืนยันจากหน้ารุ่นสดก่อนวางงบประมาณ
ราคาต่อโทเค็นไม่เท่ากับต้นทุนต่อภารกิจสำเร็จ โมเดลให้เหตุผลอาจบริโภคโทเค็นต่างกัน ใช้จำนวนการเรียกเครื่องมือต่างกัน และต้องรีทรายต่างกัน ดังนั้นการประเมินการผลิตควรติดตามต้นทุนต่อภารกิจสำเร็จ เวลาแฝง และอัตราสำเร็จควบคู่กัน
Grok 4.7 vs MiMo-V2.6-Pro: Access and Availability
ความต่างด้านการเข้าถึงตรงไปตรงมา: Grok 4.7 มีผ่าน API และเวิร์กโฟลว์ Grok แบบจัดการ โดยไม่มีน้ำหนักโมเดลให้โฮสต์เอง MiMo-V2.6-Pro มีผ่าน API และเป็นน้ำหนักเปิด จึงให้เส้นทางโฮสต์เองเพิ่มเติมแก่ทีม
ความพร้อมใช้งานแยกจากการออกใบอนุญาตหรือความยืดหยุ่นการดีพลอย ณ วันที่ 24 กันยายน 2026 ทั้งสองโมเดลมีหน้าคatalogใน CometAPI ทีมควรยืนยันเอ็นด์พอยต์ ภูมิภาค ข้อจำกัดเรต และคุณสมบัติบัญชีก่อนใช้งานจริง รายการโมเดลไม่ได้รับประกันว่าความพร้อมใช้งานหรือระดับบริการจะเหมือนกันสำหรับทุกบัญชี
| Availability question | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Official API | Available through xAI | Available through Xiaomi MiMo |
| CometAPI catalog | Listed as available | Listed as available |
| Self-hosted weights | Not available | Open-weight option |
| Operational check | Confirm account access, region, rate limits, and tool availability | Confirm account access, endpoint readiness, and self-hosting requirements |
Open Weights and Proprietary Access
การที่ MiMo-V2.6-Pro เป็นน้ำหนักเปิดเปลี่ยนการเปรียบเทียบมากกว่าช่องว่างคะแนนหนึ่งจุด มันสร้างตัวเลือกสำหรับดีพลอยส่วนตัว ปรับแต่งเอนจิ้นอินเฟอเรนซ์ โพสต์เทรนแบบกำหนดเอง ควบคุมที่ตั้งข้อมูล และบูรณาการโครงสร้างพื้นฐานในระดับลึก
Grok 4.7 เลือกข้อแลกเปลี่ยนตรงกันข้าม: ควบคุมภายในโมเดลน้อยลง แลกกับบริการแบบจัดการที่ดำเนินงานต่อเนื่องและระบบนิเวศเฟิร์สปาร์ตี้ที่บูรณาการแน่น สำหรับหลายองค์กร ข้อกำหนดกำกับดูแลและโครงสร้างพื้นฐานจะคัดกรองตัวเลือกก่อนที่ประสิทธิภาพเบนช์มาร์กจะเข้ามามีบทบาท
How to Use Grok 4.7 and MiMo V2.6 APIs in CometAPI
นักพัฒนาสามารถเข้าถึง Grok 4.7 API ใน CometAPI ผ่านเวิร์กโฟลว์ API แบบรวม ลดความจำเป็นต้องดูแลการผสานกับผู้ให้บริการแต่ละรายแยกกัน
สำหรับทีมที่เบนช์มาร์กโมเดลแนวหน้าหลายตัว เลเยอร์ API แบบรวมมีประโยชน์อย่างยิ่งเพราะพรอมต์ผลิตจริง ฮาร์เนสทดสอบ การนับโทเค็น และโค้ดแอปพลิเคชันเดียวกันสามารถรันซ้ำข้ามโมเดล โดยลดตัวแปรการผสาน
CometAPI ขณะนี้ระบุ MiMo-V2.6-Pro ว่าพร้อมใช้งาน โดยยืนยันความพร้อมของ API เมื่อวันที่ 22 กันยายน 2026 ตรวจสอบคatalogสดและสิทธิ์บัญชีก่อนใช้งานจริง
เมื่อหน้ารุ่นทั้งสองแสดงว่าพร้อมใช้งานแล้ว การทดสอบ A/B ในระดับแอปพลิเคชันสามารถคงพรอมต์ เครื่องมือ การตั้งค่าการให้เหตุผล และเกณฑ์ความสำเร็จให้สอดคล้องที่สุด จากนั้นเปรียบเทียบอัตราสำเร็จ เวลาแฝง การใช้โทเค็น และรูปแบบความล้มเหลว
Grok 4.7 vs MiMo-V2.6-Pro: Model Fit by Use Case
| Requirement | Model fit / evaluation guidance |
|---|---|
| First-party web and X search | Grok 4.7 |
| Managed long-running agents | Grok 4.7 |
| Grok Build / Cursor workflows | Grok 4.7 |
| 1M-token context | MiMo-V2.6-Pro |
| Native audio/video understanding | MiMo-V2.6-Pro |
| Open weights, self-hosting, and model control | MiMo-V2.6-Pro |
| Lowest raw API token cost | MiMo-V2.6-Pro |
| Repository coding | Benchmark both on representative repositories |
| Professional knowledge agents | Benchmark both on production tasks |
ดังนั้นการตัดสินใจควรกรอบตามสถาปัตยกรรมเวิร์กโหลด Grok 4.7 ถูกออกแบบมาเพื่อทำให้สแตกเอเจนต์แบบจัดการมีศักยภาพมากขึ้น; MiMo-V2.6-Pro ถูกออกแบบมาเพื่อทำให้สติปัญญาระดับสูงถูกลง รองรับมัลติโหมดมากขึ้น และควบคุมได้มากขึ้น
Which one should you choose?
เลือก Grok 4.7 หากคุณต้องการประสบการณ์เอเจนต์แบบจัดการพร้อมการค้นเว็บและ X โดยเฟิร์สปาร์ตี้ การรันโค้ดแบบเนทีฟ และโครงสร้างพื้นฐานที่ต้องดูแลน้อยกว่า มันเป็นตัวเลือกที่ใช้งานได้จริงกว่าสำหรับทีมที่ให้คุณค่ากับชุดเครื่องมือบูรณาการและเวิร์กโฟลว์อาชีพหรือโค้ดระยะยาว
เลือก MiMo-V2.6-Pro หากคุณต้องการน้ำหนักเปิด ดีพลอยแบบส่วนตัว หน้าต่างบริบท 1M ความเข้าใจเสียงและวิดีโอแบบเนทีฟ หรือราคาต่อโทเค็นดิบที่ต่ำกว่าอย่างมาก มันแข็งแรงกว่าเมื่อข้อจำกัดหลักคือการควบคุมการดีพลอย ความครอบคลุมมัลติโหมด และประสิทธิภาพด้านต้นทุน
หากยังเลือกไม่ชัด ให้รันโมเดลทั้งสองบนงานตัวแทนเดียวกันด้วยพรอมต์ เครื่องมือ งบประมาณการให้เหตุผล ไทม์เอาต์ และนโยบายรีทรายที่เหมือนกัน เลือกโมเดลที่ให้ส่วนผสมดีที่สุดของอัตราสำเร็จ เวลาแฝง ต้นทุนรวมต่อภารกิจสำเร็จ และความพยายามในการรีวิวโดยมนุษย์
Conclusion
กรณี Grok 4.7 vs MiMo V2.6 เผยให้เห็นว่าความฉลาดดิบไม่ใช่ตัวสร้างความแตกต่างเพียงอย่างเดียวอีกต่อไป ทั้งสองโมเดลอยู่ในแถบความสามารถสูงใกล้เคียงกันในประเมินสาธารณะปัจจุบัน แต่กลยุทธ์ผลิตภัณฑ์แตกต่างกันอย่างชัดเจน
Grok 4.7 ผสานหน้าต่างบริบท 500K การให้เหตุผลที่กำหนดค่าได้ การฝึกเอเจนต์ระยะยาวที่แข็งแรง และสแตกการค้นหาและปฏิบัติการแบบเฟิร์สปาร์ตี้ที่สุกงอม MiMo-V2.6-Pro ผสานบริบท 1M อินพุตมัลติโหมดแบบเนทีฟ น้ำหนักเปิด และราคา API ที่ต่ำกว่าระบบแนวหน้าหลายตัวอย่างมาก
สำหรับนักพัฒนา คำถามเชิงปฏิบัติจริงจึงไม่ใช่ “คะแนนเบนช์มาร์กไหนสูงกว่า?” แต่คือ “ปัญญาควรอยู่ที่ไหน?” ระบบนิเวศเอเจนต์แบบจัดการและสแตกโมเดลแบบเปิดที่ปรับแต่งได้ แก้ปัญหาเชิงปฏิบัติการต่างกัน ตัวเลือกที่ถูกต้องคือสิ่งที่ตรงกับเวิร์กโหลดการผลิต ข้อจำกัดโครงสร้างพื้นฐาน และโมเดลต้นทุนดีที่สุด
FAQs
Grok 4.7 เป็นโมเดล 2.1 ล้านล้านพารามิเตอร์หรือไม่?
มีตัวเลขราว 2.1T เผยแพร่ก่อนเปิดตัว แต่เอกสารทางการของ SpaceXAI สำหรับ Grok 4.7 ไม่ได้เผยแพร่จำนวนพารามิเตอร์ทั้งหมดหรือที่ทำงานอยู่ ข้อความที่ยืนยันคือ Grok 4.7 ใช้โมเดลฐานที่ใหญ่กว่า Grok 4.6
MiMo-V2.6 เป็นโอเพ่นซอร์สหรือไม่?
Xiaomi เปิดเผย MiMo-V2.6 เป็นตระกูลโมเดลแบบเปิดพร้อมน้ำหนักที่ดาวน์โหลดได้และทรัพยากรวิจัยที่เกี่ยวข้อง ในการวางแผนผลิตจริง ทีมยังควรตรวจสอบใบอนุญาตโมเดลและเงื่อนไขการแจกจ่ายสำหรับการใช้งานที่ตั้งใจ
Grok 4.7 vs MiMo-V2.6-Pro มีต้นทุนต่อภารกิจเอเจนต์สำเร็จเท่าไร?
ทำให้ชุดงาน พรอมต์ สิทธิ์เครื่องมือ นโยบายรีทราย และเกณฑ์ความสำเร็จเป็นมาตรฐานเดียวกัน ติดตามโทเค็นอินพุต อินพุตที่แคช การให้เหตุผล และเอาต์พุต การเรียกเครื่องมือ เวลาแฝง รีทราย และเวลาทบทวนโดยมนุษย์ ราคาต่อโทเค็นเป็นเพียงองค์ประกอบหนึ่งของต้นทุนต่อภารกิจสำเร็จ
ความน่าเชื่อถือของการเปรียบเทียบเบนช์มาร์ก Grok 4.7 vs MiMo-V2.6-Pro เป็นอย่างไร?
ใช้รีโปหรือชุดงานเดียวกัน ฮาร์เนสเอเจนต์ เครื่องมือ งบประมาณการให้เหตุผล ไทม์เอาต์ นโยบายรีทราย และรูบริกการให้คะแนนเดียวกัน รายงานช่วงความเชื่อมั่นหรือความแปรปรวนจากการรันซ้ำ และแยกตัวเลขที่ผู้ขายเผยแพร่ออกจากผลภายใน
Grok 4.7 คิดราคาเพิ่มสำหรับพรอมต์บริบทยาวหรือไม่?
SpaceXAI ระบุอัตราที่สูงขึ้นเมื่อโทเค็นพรอมต์เกิน 200K เนื่องจากระดับสูงกว่านี้ใช้กับคำขอ ทีมที่ใช้รีโปขนาดใหญ่หรือบริบทเอเจนต์ถาวรควรจำลองเกณฑ์ดังกล่าวอย่างชัดเจน