
สรุปย่อ
MiniMax M3.1 Flash นำ AI แบบเปิดน้ำหนักมาใช้กับเวิร์กโฟลว์การเขียนโค้ดและเอเจนต์ที่ต้องการสูง แต่การรันแบบโลคัลต้องใช้ฮาร์ดแวร์ระดับจริงจัง สถาปัตยกรรม MoE ที่มีพารามิเตอร์ 428B ของมันจะเปิดใช้งานเพียง 23B พารามิเตอร์ต่อโทเค็น ช่วยลดภาระคำนวณ แต่ไม่ได้ตัดความจำเป็นในการเก็บโมเดลฉบับเต็ม นักพัฒนาที่มีระบบหลาย GPU ที่รองรับสามารถดีพลอยด้วย vLLM หรือ SGLang สำหรับผู้ที่ต้องการข้ามการดูแลโครงสร้างพื้นฐาน MiniMax M3.1 Flash API in CometAPI มอบวิธีเริ่มต้นที่ง่ายกว่า
ประเด็นสำคัญ
- ฮาร์ดแวร์คืออุปสรรคใหญ่สุด คอนฟิก vLLM ที่เผยแพร่ใช้ Blackwell หรือ AMD MI355X จำนวน 4 GPU หรือ H100/H200 จำนวน 8 GPU
- คอนเท็กซ์ยาวแลกมาด้วยหน่วยความจำ โมเดลรองรับได้สูงสุดหนึ่งล้านโทเค็น แต่ขีดจำกัดการให้บริการจริงขึ้นกับหน่วยความจำ GPU ที่มีและระดับความขนาน
- การดีพลอยขึ้นกับฮาร์ดแวร์ ใช้เอนจินอินเฟอเรนซ์ รูปแบบควอนไทเซชัน และการตั้งค่าแอ็กเซเลอเรเตอร์ที่เข้ากันได้ แทนการใช้คำสั่งติดตั้งแบบทั่วไป
- เบนช์มาร์กเป็นเพียงจุดเริ่ม ประเมินความแม่นยำการเขียนโค้ด การทำงานสำเร็จของเอเจนต์ เวลาแฝง และอัตราการประมวลผลภายใต้งานของคุณเอง
- อินเฟอเรนซ์แบบโลคัลกับแบบโฮสต์ตอบโจทย์ต่างกัน โฮสต์เองให้การควบคุมโครงสร้างพื้นฐานมากกว่า ขณะที่การใช้ API ลดความซับซ้อนในการตั้งค่าและภาระดูแลรักษา
MiniMax M3.1 Flash คืออะไร?
MiniMax M3.1 Flash รับอินพุตเป็นข้อความ รูปภาพ และวิดีโอ และสร้างผลลัพธ์เป็นข้อความ ออกแบบมาสำหรับเวิร์กโฟลว์ด้านการเขียนโค้ด อัตโนมัติ ปฏิสัมพันธ์กับคอมพิวเตอร์ และความปลอดภัย น้ำหนักถูกแจกจ่ายภายใต้ MiniMax Community License ก่อนให้บริการเชิงพาณิชย์ โปรดอ่าน ไลเซนส์ที่มาพร้อมเช็คพอยต์ และตรวจสอบเงื่อนไขที่เกี่ยวข้องกับการใช้งานของคุณ
สเปกของ MiniMax M3.1 Flash
MiniMax M3.1 Flash ใช้สถาปัตยกรรม 428B/23B อย่างไร?
โมเดล Mixture-of-Experts (MoE) จะกำหนดเส้นทางให้แต่ละโทเค็นผ่านผู้เชี่ยวชาญที่เลือกไว้ ใน MiniMax M3.1 Flash มีพารามิเตอร์ที่ใช้งานประมาณ 23B ต่อโทเค็น ขณะที่พูลพารามิเตอร์ทั้งหมดอยู่ที่ประมาณ 428B การเปิดใช้งานแบบเบาบางช่วยลดภาระคำนวณ แต่ไม่ได้ทำให้เช็คพอยต์กลายเป็นโมเดล dense ขนาด 23B
มีอะไรเปลี่ยนไปใน MiniMax M3.1 Flash?
- Sparse attention: ใช้งานทั่วทั้งโมเดลเพื่อลดงาน attention บนอินพุตยาวๆ; ประโยชน์ขึ้นกับเคอร์เนลที่ใช้ให้บริการและพรอมป์ต
- น้ำหนักแบบความแม่นยำผสม: ส่วน dense เป็น MXFP8 และ experts เป็น NVFP4 ช่วยลดการจัดเก็บและการคำนวณ แต่ยังต้องใช้ฮาร์ดแวร์และเคอร์เนลที่เข้ากันได้
- DSpark decoding: หัวร่างแบบบูรณาการสามารถเร่งการสร้างโทเค็นในเรซิพีที่รองรับ; ผลลัพธ์ขึ้นกับอัตราการยอมรับโทเค็นและลักษณะงาน
- การให้บริการแบบคำนึงถึงพลังงาน: การจัดตารางงานระดับโครงสร้างพื้นฐานสามารถเพิ่มการใช้ทรัพยากร แต่ไม่ใช่สิ่งที่จะได้มาโดยอัตโนมัติจากการดาวน์โหลดน้ำหนัก
ต้องใช้ฮาร์ดแวร์แบบใดสำหรับ MiniMax M3.1 Flash?
วางแผนหน่วยความจำ GPU เป็นสี่ส่วน: น้ำหนักเช็คพอยต์ แคชคีย์-ค่า (KV) สำหรับโทเค็นก่อนหน้า บัฟเฟอร์ระหว่างรันไทม์ และเฮดรูมสำหรับงาน ประมาณการด้านล่างครอบคลุมเฉพาะการจัดเก็บพารามิเตอร์ดิบเท่านั้น ส่วนความแม่นยำผสม สเกลควอนไทเซชัน ส่วนประกอบมัลติโหมด และโอเวอร์เฮดของการให้บริการจะทำให้ความต้องการจริงเปลี่ยนไป
โทโพโลยี GPU ที่ผ่านการยืนยัน
ประมาณการหน่วยความจำ: การจัดเก็บดิบสำหรับพารามิเตอร์ 428B อยู่ที่ประมาณ 856 GB ที่ BF16, 428 GB ที่ 8 บิต หรือ 214 GB ที่ 4 บิตในอุดมคติ เช็คพอยต์ทางการผสมรูปแบบดังนั้นตัวเลขนี้ไม่ใช่ความต้องการ VRAM ระหว่างรันไทม์ อนุเคราะห์พื้นที่สำหรับสเกลควอนไทเซชัน แคช KV บัฟเฟอร์ระหว่างรันไทม์ และความขนาน; ใช้ ไฟล์เช็คพอยต์จริง และเรซิพีสำหรับ GPU ของคุณเพื่อคำนวณขนาดระบบ
สำรองพื้นที่ NVMe สำหรับเช็คพอยต์ ไฟล์ดาวน์โหลดชั่วคราว และสำเนาสำหรับย้อนกลับ
ควรเลือกวิธีดีพลอยแบบใด?
สำหรับคลัสเตอร์โลคัลที่รองรับ vLLM เป็นจุดเริ่มต้นที่ใช้งานได้จริงด้วยคอนฟิกอ้างอิงและการผสาน API ที่คุ้นเคย; SGLang เหมาะกับทีมที่ต้องการปรับแต่งการให้บริการหลังตรวจสอบความเข้ากันได้แล้ว ขณะที่ CometAPI มอบเส้นทางโฮสต์สำหรับการต้นแบบและสลับโมเดล
เลือกเฟรมเวิร์กที่มีเรซิพีตรวจสอบแล้วสำหรับฮาร์ดแวร์ของคุณ จากนั้นเปรียบเทียบเวลาแฝงและอัตราการประมวลผลโดยใช้พรอมป์ต ความแม่นยำ และความขนานเดียวกัน
วิธีรัน MiniMax M3.1 Flash แบบโลคัลด้วย vLLM?
ขั้นตอนต่อไปนี้สมมติว่าโฮสต์ Linux มี NVIDIA Blackwell ที่เข้ากันได้ 4 ตัว สภาพแวดล้อมไดรเวอร์/CUDA ที่รองรับ และเข้าถึงเช็คพอยต์ทางการ ใช้ vLLM รุ่นที่ตรวจสอบแล้ว; การติดตั้งทั่วไปบนฮาร์ดแวร์ GPU ที่ไม่รองรับอาจล้มเหลวแม้แพ็กเกจจะติดตั้งสำเร็จ
ขั้นตอนที่ 1: ติดตั้งเครื่องมือให้บริการ
python3 -m venv minimax-env
source minimax-env/bin/activate
python -m pip install --upgrade pip
python -m pip install -U huggingface_hub
python -m pip install "vllm>=0.33.0"
python -c "import vllm; print(vllm.__version__)"
ตรวจสอบให้แน่ใจว่า wheel ที่ติดตั้งและรันไทม์ CUDA ตรงกับตระกูล GPU ของคุณ หากต้องใช้บิลด์พัฒนาเฉพาะโปรเจ็กต์ ให้ทำตามหมายเหตุการติดตั้งอ้างอิงก่อนใช้พารามิเตอร์เปิดใช้งาน
ขั้นตอนที่ 2: ดาวน์โหลดเช็คพอยต์ทางการ
hf download MiniMaxAI/MiniMax-M3.1-Flash \
  --local-dir ./MiniMax-M3.1-Flash
ใช้โทเค็น Hugging Face ที่เหมาะสมหากจำเป็น รักษาโครงสร้างไดเรกทอรี และยืนยันการดาวน์โหลดชาร์ดครบถ้วนก่อนเปิดเซิร์ฟเวอร์
ขั้นตอนที่ 3: เปิดใช้งานบน NVIDIA GB200 4 ตัว
export CUDA_VISIBLE_DEVICES=0,1,2,3
export VLLM_FLOAT32_MATMUL_PRECISION=high

vllm serve ./MiniMax-M3.1-Flash \
  --tensor-parallel-size 4 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype nvfp4 \
  --attention-config '{"indexer_kv_dtype":"nvfp4","use_prefill_query_quantization":true}' \
  --compilation-config '{"cudagraph_mode":"FULL_AND_PIECEWISE"}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"attention_backend":"FLASHINFER_TS","kv_cache_dtype":"fp8","draft_sample_method":"probabilistic","rejection_sample_method":"block"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --disable-hybrid-kv-cache-manager \
  --host 127.0.0.1 \
  --port 8000
รอจนกว่าเซิร์ฟเวอร์โหลดเสร็จและรายงานสถานะพร้อมก่อนส่งคำขอ คำสั่งข้างต้นจำกัดคอนเท็กซ์ไว้ที่ 32,768 โทเค็นและซีเควนซ์พร้อมกันที่สี่รายการเพื่อทดสอบเบื้องต้น ขีดจำกัดที่ลดลงนี้ไม่ได้ใช้สำหรับการทดสอบสมรรถนะ; ปรับหลังจากวัดการใช้หน่วยความจำและพฤติกรรมคำขอบนฮาร์ดแวร์ของคุณ
ขั้นตอนที่ 4: ส่งคำขอแบบโลคัล
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "./MiniMax-M3.1-Flash",
    "messages": [{"role":"user","content":"Explain sparse attention in three bullets."}],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 1024
  }'
หากตัวระบุที่ให้บริการไม่ตรงกับชื่อไดเรกทอรี ให้เรียก /v1/models และใช้ ID ที่ส่งกลับมาอย่างแม่นยำ การตอบกลับข้อความที่สำเร็จยืนยันได้เพียงอินเฟอเรนซ์พื้นฐาน; ทดสอบวิชวล การเรียกใช้เครื่องมือ ความขนาน และคอนเท็กซ์ยาวแยกกัน
ขั้นตอนที่ 5: ผสานกับไคลเอนต์ Python ที่เข้ากันได้กับ OpenAI
python -m pip install openai
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
model_id = client.models.list().data[0].id

response = client.chat.completions.create(
    model=model_id,
    messages=[{"role": "user", "content": "Write a Python duplicate filename detector."}],
    temperature=1.0,
    top_p=0.95,
    max_tokens=2048,
)
print(response.choices[0].message.content)
ตัวอย่างนี้รับฟังที่ 127.0.0.1 สำหรับการทดสอบโลคัล ก่อนเชื่อมต่อไคลเอนต์ระยะไกล ให้ตั้งการควบคุมการเข้าถึงหน้าเอนด์พอยต์ และกำหนดค่าไคลเอนต์ด้าน timeouts การลองใหม่แบบมีขอบเขต และการมอนิเตอร์
ตัวเลือก H100/H200: ใช้เรซิพี Hopper แบบ 8 GPU
บน H100/H200 แปดตัว ให้ใช้เส้นทางแคช FP8 และ Marlin MoE ที่เฉพาะ Hopper แทนคอนฟิก NVFP4 สำหรับ Blackwell คำสั่งด้านล่างเป็นไปตาม เรซิพี vLLM สำหรับ Hopper อย่างเป็นทางการ พร้อมลดคอนเท็กซ์และความขนานลงที่ 32K และสี่ซีเควนซ์สำหรับการทดสอบเบื้องต้น ปิดการรับวิดีโอให้สอดคล้องกับเรซิพีนั้น ควรเก็บเอนด์พอยต์นี้ไว้หลังการควบคุมการเข้าถึงที่คุณมีอยู่
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
วิธีรัน MiniMax M3.1 Flash ด้วย SGLang?
SGLang มีเรซิพีการดีพลอย M3.1 เฉพาะฮาร์ดแวร์และการให้บริการที่เข้ากันได้กับ OpenAI ณ สแน็ปช็อตวันที่ 23 ตุลาคม เอกสารมีอิมเมจคอนเทนเนอร์สำหรับพัฒนาแบบเฉพาะ ดังนั้นไม่ควรถือว่าการติดตั้ง SGLang ทั่วไปมีการรองรับเฉพาะโมเดลครบถ้วน
ดึงอิมเมจคอนเทนเนอร์เฉพาะทาง
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
จากนั้นทำตาม SGLang MiniMax M3.1 cookbook สำหรับแอ็กเซเลอเรเตอร์ของคุณ การดึงอิมเมจเป็นเพียงการดาวน์โหลดรันไทม์; คุณยังต้องเริ่มคอนเทนเนอร์พร้อมการเข้าถึง GPU และเปิดการให้บริการด้วยคอนฟิกที่ตรงกันภายในนั้น ใช้คำสั่งสำหรับฮาร์ดแวร์ครบถ้วนใน cookbook รอจนพร้อม แล้วคิวรีรายการโมเดลของเอนด์พอยต์ก่อนส่งคำขอทดสอบ เส้นทาง NVIDIA และ AMD ที่บันทึกไว้ใช้การพึ่งพาที่ต่างกันและควรตั้งค่าแยกจากกัน
MiniMax M3.1 Flash เปรียบเทียบในเบนช์มาร์กอย่างไร?
เมื่อเอนด์พอยต์ของคุณผ่านการตรวจสอบพื้นฐานแล้ว ใช้เบนช์มาร์กที่เผยแพร่เพื่อเลือกว่าจะทดสอบงานใดต่อไป ตัวเลขด้านล่างเป็น การประเมินโดยผู้จำหน่าย ไม่ใช่การวัดการดีพลอยโลคัลของคุณ
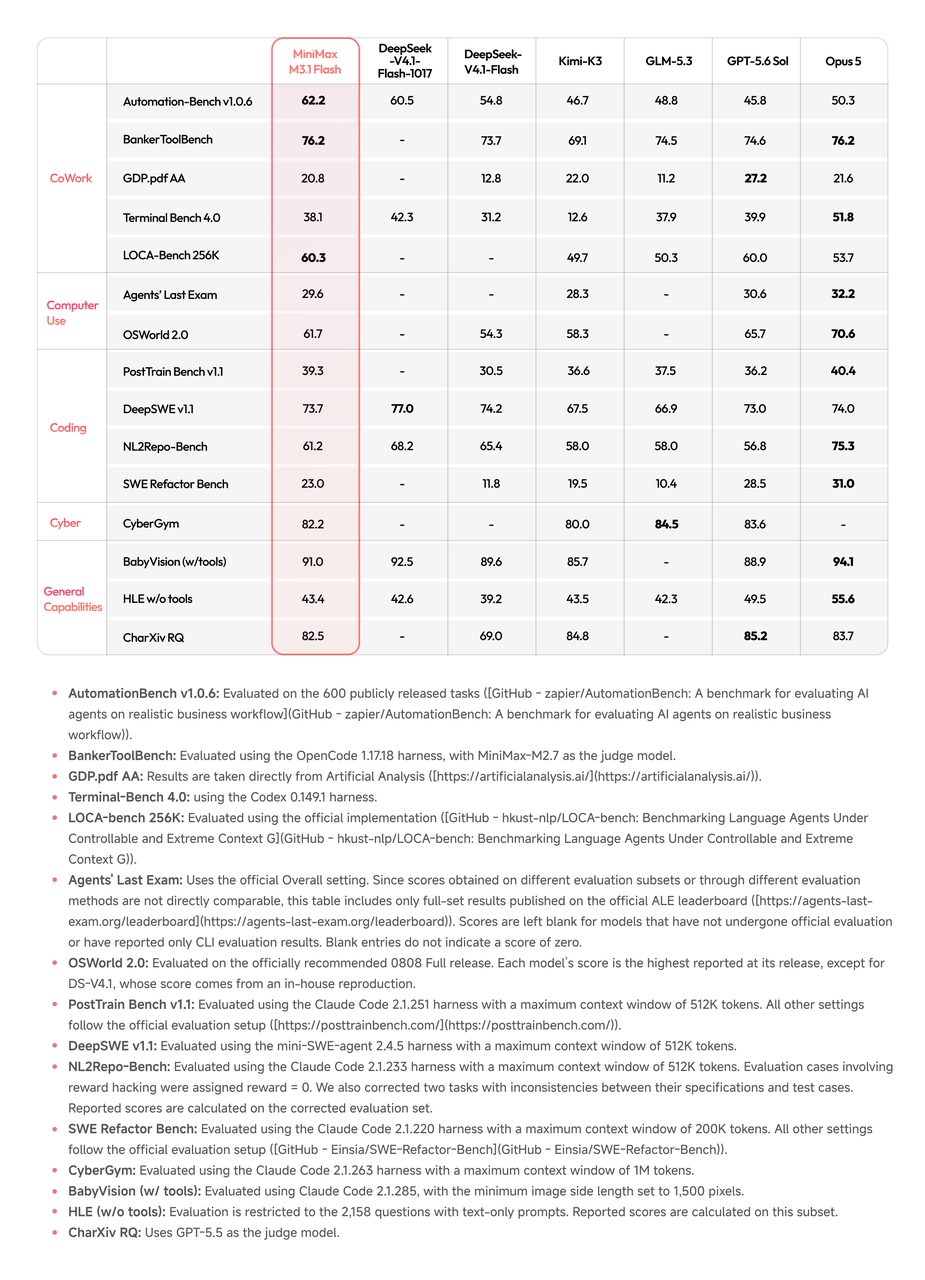
ในการเปรียบเทียบนี้ MiniMax นำหน้าบน Automation-Bench ที่ระบุ ขณะที่ DeepSeek นำหลายเบนช์มาร์กด้านโค้ด อ่าน การ์ดโมเดลและตั้งค่าการประเมิน ก่อนสรุปผล และทดสอบพรอมป์ตและเครื่องมือที่แอปของคุณใช้จริง คะแนนจากเวอร์ชันหรือการตั้งค่าที่ต่างกันไม่สามารถเปรียบเทียบกันได้โดยตรง
จะปรับแต่งประสิทธิภาพของ MiniMax M3.1 Flash ได้อย่างไร?
ควบคุมคอนเท็กซ์และความขนาน
หลังจากคำขอแรกสำเร็จ ให้เพิ่มตัวแปรโหลดทีละอย่าง: ความยาวอินพุต ความยาวเอาต์พุต หรือคำขอพร้อมกัน บันทึกหน่วยความจำพีกและเวลาแฝงตอบกลับของแต่ละรัน เก็บค่าการตั้งค่าที่ยังเสถียรล่าสุดไว้เป็นจุดย้อนกลับ เพื่อไม่ให้การทดลองที่ล้มเหลวกลายเป็นเบสไลน์ใหม่ของคุณ
เลือกระดับ reasoning effort อย่างมีเป้าหมาย
M3.1 Flash รองรับ low, medium, high, xhigh และ max ระดับที่สูงขึ้นอาจเพิ่มคะแนนงานที่ยาก แต่โดยมากต้องใช้โทเค็น reasoning มากขึ้นและเวลาแฝงยาวขึ้น ใช้คุณภาพการทำงานสำเร็จร่วมกับต้นทุนการคำนวณที่ใช้จริง
สำหรับความสัมพันธ์ที่เผยแพร่ระหว่าง reasoning effort กับต้นทุนงาน ดู กราฟคะแนน–ต้นทุนของ Automation-Bench อย่างเป็นทางการ
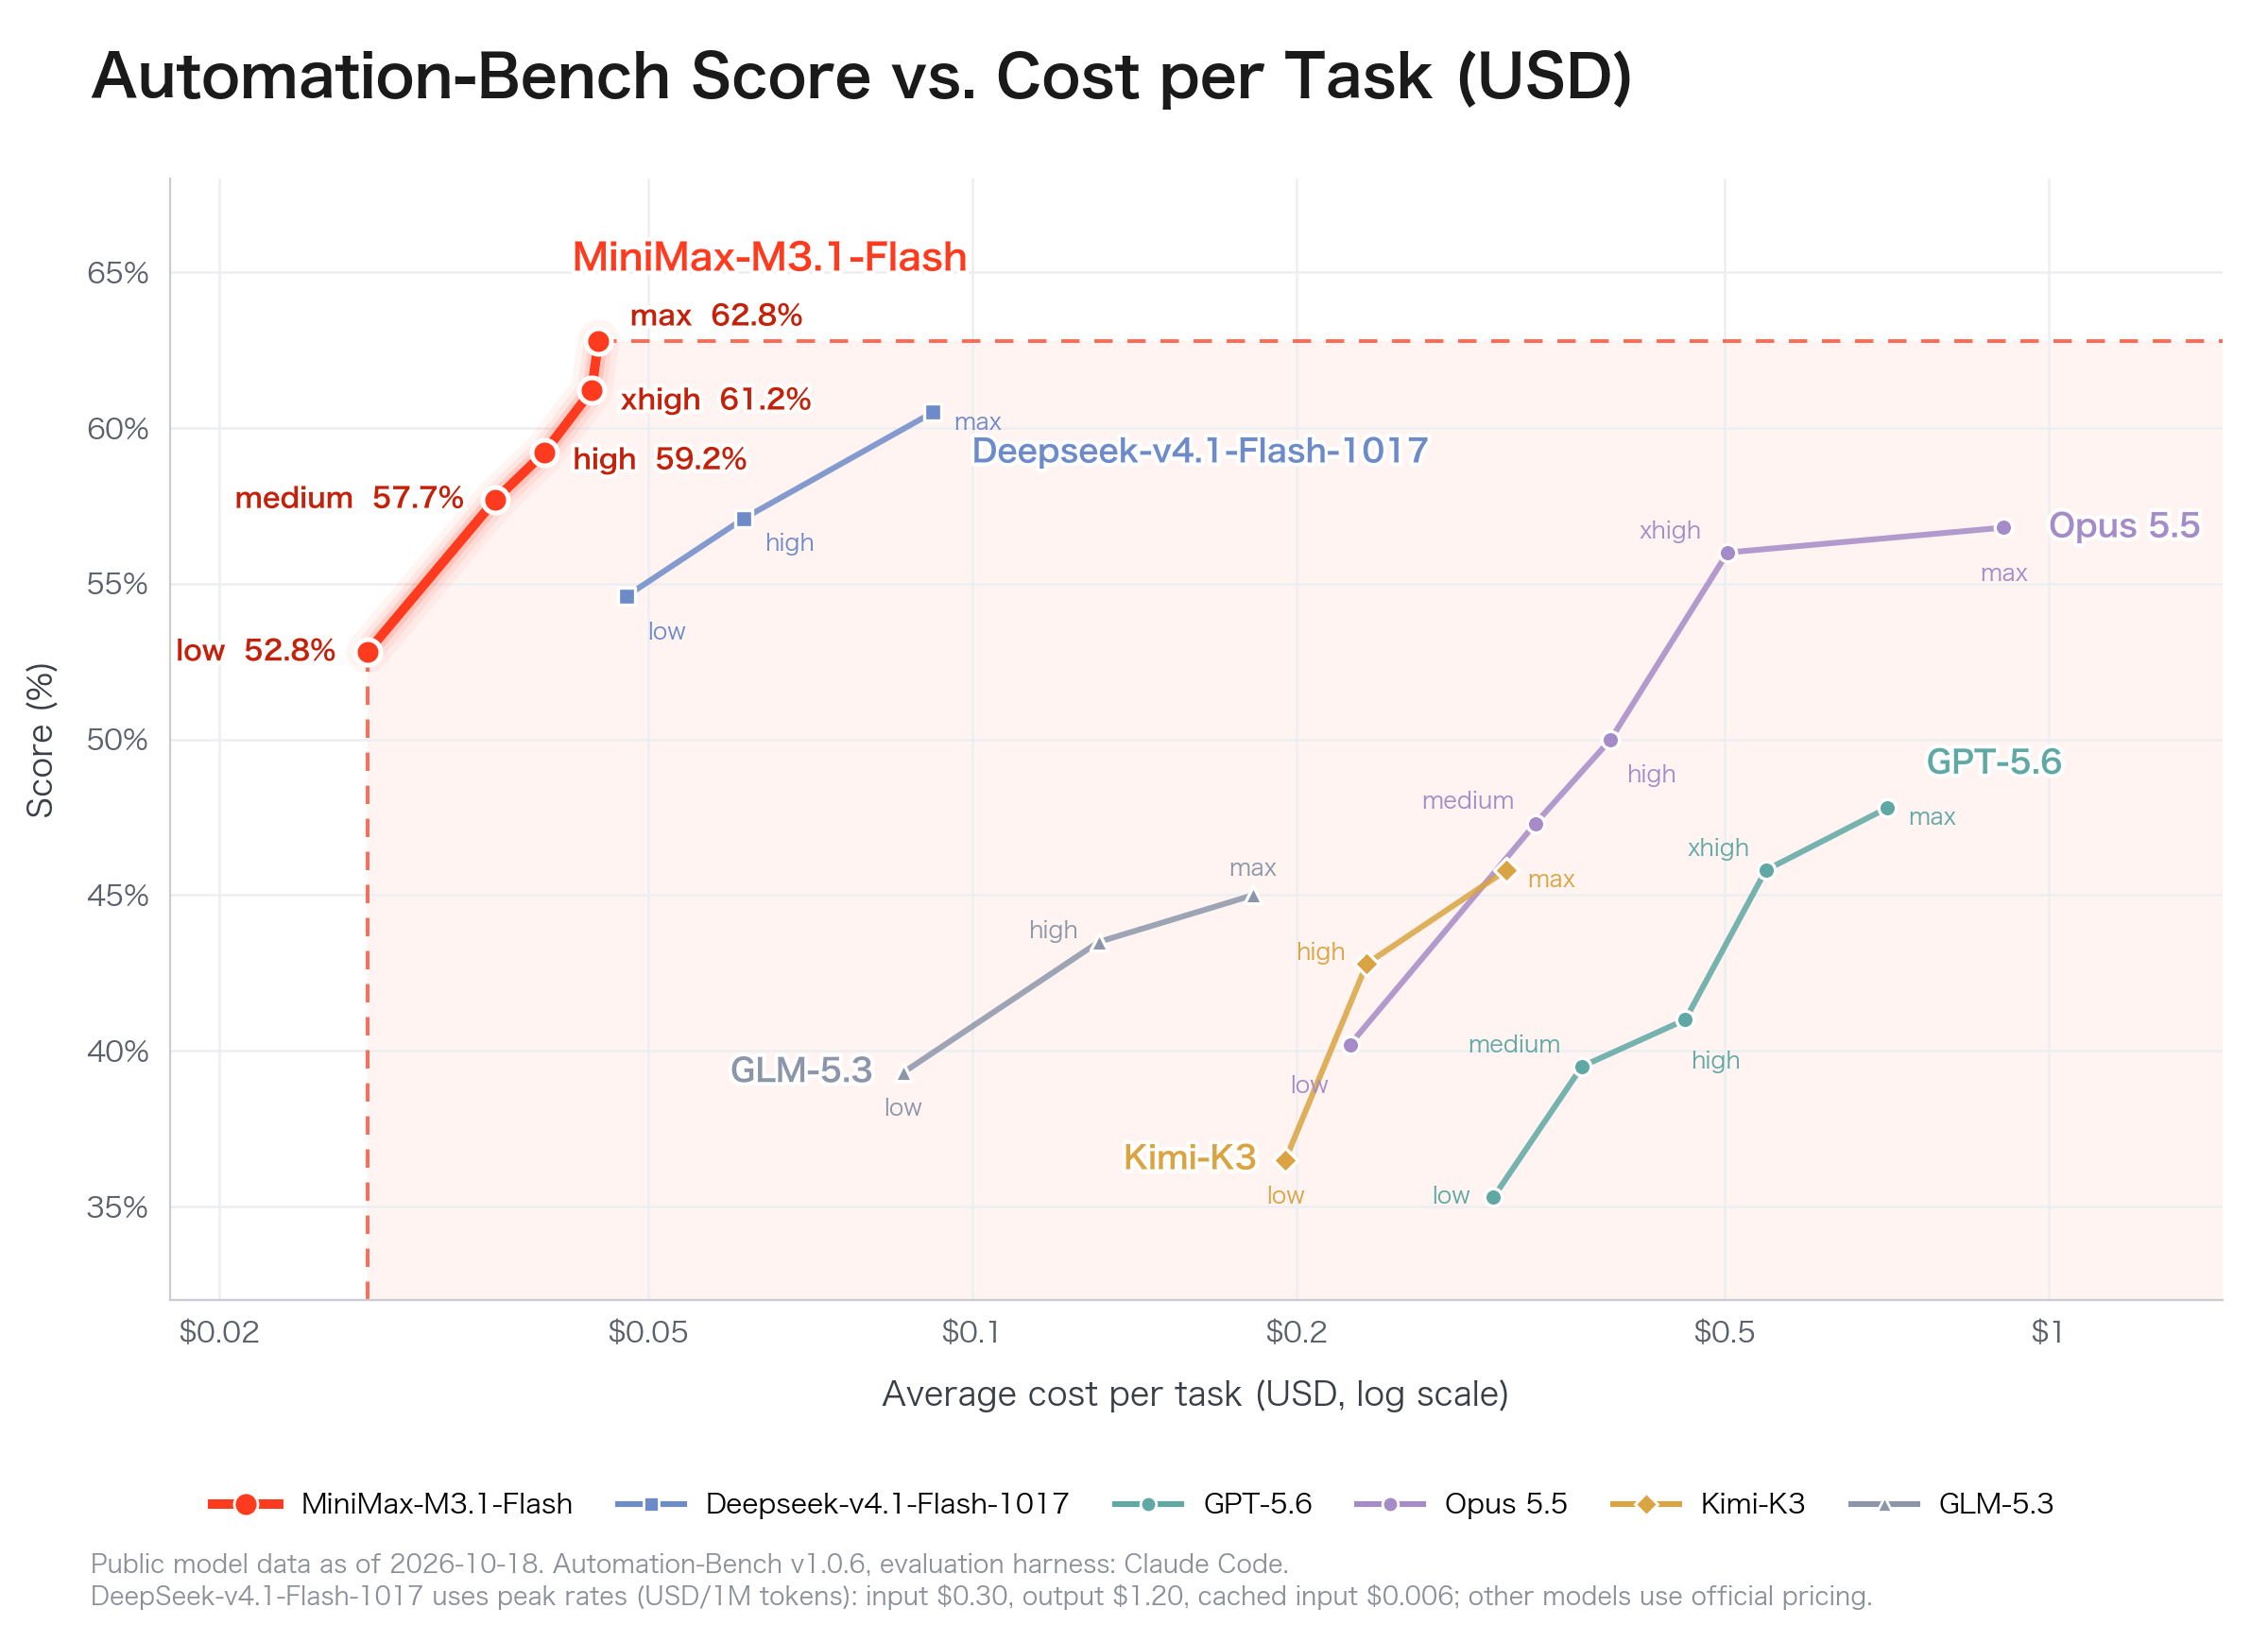
| Reasoning effort | Reported Automation-Bench score |
|---|---|
| Low | 52.8% |
สำหรับคำขอ vLLM แบบโลคัล เรซิพีจะแสดง การตั้งค่า reasoning-effort ภายใต้ค่า chat_template_kwargs ตรวจสอบทั้งคำตอบสุดท้ายและฟิลด์ reasoning ที่ส่งกลับแยกต่างหากเมื่อยืนยันไคลเอนต์ของคุณ เนื่องจากเอนด์พอยต์แบบโฮสต์และโลคัลอาจเปิดเผยฟิลด์เหล่านี้ต่างกัน
ติดตามต้นทุนต่อภารกิจที่เสร็จสิ้น
สำหรับเอเจนต์ จำนวนโทเค็นต่อวินาทีไม่เพียงพอ บันทึกเวลาโทเค็นแรก อัตราการเอาต์พุต อัตราการยอมรับสำหรับ speculative decoding ตลอดจนการประมวลผลพร้อมกัน อัตราความล้มเหลวของการเรียกเครื่องมือ การใช้หน่วยความจำ และต้นทุนต่อภารกิจที่เสร็จสิ้น การตอบช้าลงแต่มีการเรียกเครื่องมือล้มเหลวน้อยกว่าอาจให้เศรษฐศาสตร์โดยรวมที่ดีกว่า
จะใช้ MiniMax M3.1 Flash API ใน CometAPI ได้อย่างไร?
ทีมที่ไม่ต้องการโครงสร้างพื้นฐานแอ็กเซเลอเรเตอร์เฉพาะสามารถใช้เอนด์พอยต์โฮสต์ที่เข้ากันได้กับ OpenAI ได้ วิธีนี้ตัดความจำเป็นต้องดาวน์โหลดเช็คพอยต์และใช้งาน GPU แต่ย้ายการประมวลผลคำขอออกนอกสภาพแวดล้อมที่โฮสต์เอง
ใช้ MiniMax M3.1 Flash API เพื่อเข้าถึงแบบโฮสต์ เพื่อเปรียบเทียบโมเดลผ่านเกตเวย์เดียวกัน ลองใช้ DeepSeek V4.1 Flash API หรือ Kimi K3 API กับการทดสอบแอปเดียวกัน
ตัวอย่างคำขอ CometAPI
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
ยืนยันตัวระบุโมเดลในคอนโซล CometAPI ของคุณก่อนรันตัวอย่างนี้ ใช้เกตเวย์เมื่อ API ร่วมข้ามผู้ให้บริการช่วยแอปของคุณได้; เปรียบเทียบโควตาปัจจุบันกับการเข้าถึงโดยตรงสำหรับการใช้งานที่คุณคาดการณ์
ราคา MiniMax M3.1 Flash API
| ราคาต่อหนึ่งล้านโทเค็น | MiniMax official API | CometAPI |
|---|---|---|
| อินพุต | $0.15 | $0.80 |
อัตรา API โดยตรงของ MiniMax ใน ประกาศเปิดตัววันที่ 19 ตุลาคม 2026 คือ $0.15 ต่ออินพุต, $0.60 ต่อเอาต์พุต และ $0.015 ต่ออินพุตแบบแคช ต่อหนึ่งล้านโทเค็น สำหรับ CometAPI โปรดตรวจสอบเส้นทางโมเดลที่ใช้งานจริง อัตราอินพุต/เอาต์พุต กฎการแคช และส่วนลดบัญชี (ถ้ามี) ก่อนประเมินค่าใช้จ่าย เปรียบเทียบต้นทุนรวมตามสัดส่วนโทเค็นและการลองใหม่ที่คุณคาดการณ์
ปัญหาใดบ้างที่อาจเกิดขึ้นเมื่อรัน MiniMax M3.1 Flash?
หน่วยความจำไม่พอระหว่างโหลดหรือขณะให้บริการ
- หากโหลดน้ำหนักไม่สำเร็จ: ตรวจสอบขั้นตอนที่ล้มเหลวในล็อกเริ่มต้น ยืนยันว่าเช็คพอยต์ครบถ้วน และยืนยันว่าโทโพโลยี GPU และแบ็กเอนด์ควอนไทเซชันตรงกับเรซิพี หากน้ำหนักเกินหน่วยความจำที่มีอยู่ ให้ใช้คอนฟิกที่มีความจุเพียงพอ; การย่อคำขอไม่สามารถแก้ปัญหาการโหลดน้ำหนักล้มเหลวได้
- หากโหลดน้ำหนักสำเร็จแต่จัดสรรแคชไม่ผ่านตอนเริ่มต้น: ตรวจสอบการตั้งค่าแคชและหน่วยความจำที่มี จากนั้นลดคอนเท็กซ์หรือความขนานตามที่เหมาะสมกับเรซิพี
- หากเซิร์ฟเวอร์เริ่มได้แต่คำขอใช้หน่วยความจำไม่พอ: ลองใหม่ด้วยพรอมป์ตสั้นๆ แบบคำขอเดียวก่อน จากนั้นเพิ่มความยาวอินพุต ความยาวเอาต์พุต และความขนานแยกกันพร้อมมอนิเตอร์หน่วยความจำ
เคอร์เนลควอนไทเซชันหรือ attention ไม่เข้ากัน
การรัน NVFP4 แตกต่างกันระหว่าง Blackwell, Hopper และฮาร์ดแวร์ AMD จับคู่เวอร์ชันเอนจินอินเฟอเรนซ์ แบ็กเอนด์ควอนไทเซชัน เวอร์ชัน CUDA/ROCm และตระกูลแอ็กเซเลอเรเตอร์ แทนการนำแฟลกมาใช้ซ้ำโดยไม่พิจารณา
การตั้งค่าแคชของ sparse attention
หากตอนเริ่มรายงานเลย์เอาต์แคชที่ไม่รองรับ ให้เปรียบเทียบการตั้งค่าแคชทั้งหมดกับเรซิพีเฉพาะฮาร์ดแวร์ เรซิพี vLLM ปัจจุบันต้องใช้ --block-size 128 สำหรับ MSA sparse/index cache ถ้าตอนเริ่มรายงานข้อผิดพลาดเลย์เอาต์แคชหรือ block-size ให้เปรียบเทียบคอนฟิกทั้งหมดกับเรซิพีสำหรับฮาร์ดแวร์ของคุณ
ตัวระบุโมเดลที่ไม่คาดคิด
พาธโลคัลและชื่อโมเดลของเกตเวย์ระยะไกลไม่จำเป็นต้องเหมือนกัน คิวรีการตอบกลับ /v1/models ของโลคัลและหลีกเลี่ยงการฮาร์ดโค้ดสมมติฐานจากเอนด์พอยต์อื่น
อัตราการประมวลผลที่สังเกตได้ต่ำ
แยกการประมวลผลพรอมป์ตช้าออกจากการสร้างโทเค็นช้า เปรียบเทียบรันที่มีความยาวอินพุตและขีดจำกัดเอาต์พุตเดียวกัน จากนั้นตรวจสอบการใช้ GPU และพฤติกรรมอินเตอร์คอนเน็กต์ก่อนเพิ่มขนาดแบตช์ ตัวเลขความเร็วจากผู้ให้บริการโฮสต์ไม่ใช่เบสไลน์สำหรับคลัสเตอร์โลคัลของคุณ
สรุป
เลือกเส้นทางการดีพลอยแรกจากฮาร์ดแวร์ที่คุณสามารถใช้งานได้วันนี้ ใช้การแนะนำ vLLM สำหรับคลัสเตอร์โลคัลที่รองรับ ใช้ cookbook เฉพาะฮาร์ดแวร์ของ SGLang สำหรับสแตกการให้บริการทางเลือก หรือใช้ API แบบโฮสต์เมื่อคุณต้องการโฟกัสที่การผสานแอป รักษาคอนฟิกที่ตอบเป้าหมายคุณภาพงานและเวลาแฝงด้วยต้นทุนการปฏิบัติการที่ยั่งยืน
วิธีที่เชื่อถือได้ที่สุดในการเลือกวิธีให้บริการ คือให้เหมาะกับ “จำนวนงานที่เสร็จสมบูรณ์ถูกต้องต่อดอลลาร์และต่อนาที” ไม่ใช่เพียงโทเค็นต่อวินาทีสูงสุด
คำถามที่พบบ่อย
จะทำให้การดีพลอยสามารถทำซ้ำได้หลังอัปเกรดรันไทม์อย่างไร?
ตรึงรีวิชันเช็คพอยต์ เวอร์ชันอิมเมจรันไทม์หรือแพ็กเกจ สแตกไดรเวอร์ และการตั้งค่าเปิดใช้งาน รันชุดยอมรับเล็กๆ เดิมก่อนอัปเกรดทุกครั้ง และเก็บคอนฟิกที่ทำงานได้ก่อนหน้าไว้สำหรับการย้อนกลับ
ควรจัดการการลองใหม่อย่างไรเมื่อเอเจนต์เรียกใช้เครื่องมือ?
แยกการลองใหม่ของโมเดลออกจากการทำซ้ำการกระทำของเครื่องมือ ใช้ idempotency keys สำหรับการกระทำที่เปลี่ยนข้อมูล ตรวจสอบว่าความพยายามครั้งแรกสำเร็จหรือไม่ และตรวจสอบอาร์กิวเมนต์ของเครื่องมือให้ครบก่อนรัน
สามารถสลับระหว่างเอนด์พอยต์โลคัลกับ CometAPI โดยไม่เปลี่ยนพฤติกรรมแอปได้หรือไม่?
ทำให้เอนด์พอยต์ หลักฐานยืนยันตัวตน และ ID โมเดลปรับได้ ทดสอบสตรีมมิง การเรียกเครื่องมือ ฟิลด์ reasoning และอินพุตมัลติโหมดบนทั้งสองเส้นทาง และยืนยันข้อกำหนดการกำหนดเส้นทางข้อมูลของคุณก่อนเปิดใช้การสำรอง
ควรทดสอบอะไรบ้างก่อนยอมรับอินพุตมัลติโหมด?
ทดสอบรูปภาพและวิดีโอที่เป็นตัวแทน รวมถึงไฟล์คุณภาพต่ำและไฟล์ที่ไม่รองรับ ตรวจสอบการพรีโพรเซสซิง ขีดจำกัดขนาด คุณภาพคำตอบ และ timeouts แยกกัน; คำขอข้อความที่สำเร็จไม่ได้ยืนยันเส้นทางมัลติโหมด
จะทราบได้อย่างไรว่าการดีพลอยพร้อมสำหรับผู้ใช้จริง?
ตั้งเป้าหมายสำหรับความสำเร็จของงาน การเรียกเครื่องมือที่ถูกต้อง เวลาแฝง ข้อผิดพลาด และต้นทุน ทดสอบทราฟฟิกสมจริง ยืนยันการมอนิเตอร์และพฤติกรรมสำรอง แล้วค่อยๆ ขยายจากการเปิดให้ใช้แบบจำกัดเฉพาะเมื่อเป้าหมายเหล่านั้นยังคงรักษาได้อยู่