Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog วิธีใช้ GPT Image 2.6 API: การสร้าง SVG และการแก้ไขภาพ guide / งานวิจัย CometAPI
วิธีใช้ GPT Image 2.6 API: การสร้าง SVG และการแก้ไขภาพ เรียนรู้เวิร์กโฟลว์ของ GPT Image 2.6 API ด้วย CometAPI: การสร้าง SVG, PNG แบบโปร่งใส, การแก้ไขหลายภาพ, มาร์กอัป, พารามิเตอร์, ราคา และการย้าย.
Deon Goodwin ทีมวิจัยโมเดล AI และ API เรียนรู้เวิร์กโฟลว์ของ GPT Image 2.6 API ด้วย CometAPI: การสร้าง SVG, PNG แบบโปร่งใส, การแก้ไขหลายภาพ, มาร์กอัป, พารามิเตอร์, ราคา และการย้าย.
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)สรุปย่อ
GPT Image 2.6 API บน CometAPI มอบแนวทางที่ใช้งานได้จริงสำหรับการสร้างและแก้ไขภาพ โดยมี 2 รุ่นย่อยคือ Sunburst และ Flare
สร้างสินทรัพย์ภาพด้วย Python และคีย์ CometAPI: เริ่มจากคำขอแบบแรสเตอร์ จากนั้นจึงเพิ่มเอาต์พุต SVG, ภาพอ้างอิง หรือเลเยอร์คำอธิบายประกอบแบบ PNG โปร่งใส เมื่อเส้นทางของคุณรองรับ ตัวอย่างใช้ Python 3.10 ขึ้นไป และเก็บคีย์ API ไว้บนเซิร์ฟเวอร์ของคุณ
ความแตกต่างที่สำคัญที่สุด: เอาต์พุต PNG โปร่งใสคือสินทรัพย์ที่เสร็จสมบูรณ์; ส่วนไฟล์มาร์กอัป PNG โปร่งใสคืออินพุตที่บอกโมเดลว่าจะให้แก้ไขตรงไหน
สาระสำคัญ
ใช้ GPT Image 2.6 Flare สำหรับงานร่างเร็ว และ Sunburst สำหรับการปรับแก้ที่ละเอียด
ส่งคำขอสร้างและคำขอแก้ไขไปยังเอ็นด์พอยต์ของ Image API ตามชนิดงานที่ถูกต้อง
ใช้ SVG สำหรับสินทรัพย์เวกเตอร์ และ PNG โปร่งใสสำหรับงานตัดฉากแบบแรสเตอร์
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
แยกไฟล์มาร์กอัปออกจากภาพต้นทาง และให้มีมิติที่สอดคล้องกันตามการจัดวาง
ยืนยันการรองรับของเส้นทางก่อนเปิดใช้ฟิลด์ขั้นสูงในแอปของคุณ
GPT Image 2.6 API คืออะไร? OpenAI เปิดตัว GPT Image 2.6 เมื่อวันที่ 4 พฤศจิกายน 2026 โมเดลตระกูลนี้รับอินพุตได้ทั้งข้อความและภาพสำหรับการสร้างและแก้ไขเชิงภาพ
ทั้งสองรุ่นมีบทบาทที่เน้นเวิร์กโฟลว์เหมือนกัน แต่ลำดับความสำคัญต่างกัน
ตัวระบุ API gpt-image-2.6-sunburst gpt-image-2.6-flare จุดโฟกัสหลัก งานภาพที่ลงรายละเอียด เวียนทำรวดเร็ว รูปแบบอินพุต ข้อความและภาพ ข้อความและภาพ รูปแบบเอาต์พุต ภาพ ภาพ จุดเริ่มต้นเชิงปฏิบัติ สินทรัพย์ขั้นสุดท้ายและการปรับแก้อย่างพิถีพิถัน ร่างงานและการแก้ไขแบบโต้ตอบ รองรับเสียง ไม่ ไม่
GPT Image 2.6 API รองรับพารามิเตอร์ใดบ้าง? เริ่มจากการตั้งค่าที่เล็กและชัดเจน
model ตัวระบุรุ่นอย่างชัดเจน ทำให้การเลือกโมเดลทำซ้ำได้ prompt คำแนะนำเป็นข้อความ อธิบายสินทรัพย์และข้อจำกัด quality เริ่มจาก low, medium หรือ high ปรับคุณภาพการเรนเดอร์ complexity low, medium หรือ high ปรับระดับการวางแผน size เช่น 1024x1024 ตรึงมิติสำหรับการเปรียบเทียบ n ใช้ 1 ในระยะแรก ลดความซับซ้อนของการทดสอบและทบทวนค่าใช้จ่าย output_format PNG, JPEG, WebP, SVG หรือ GIF ตามที่เอ็นด์พอยต์รองรับ ให้ตรงกับสินทรัพย์ปลายทาง background auto, opaque หรือ transparent ควบคุมพฤติกรรมพื้นหลังแรสเตอร์
สำหรับงานแก้ไข คำขอยังต้องส่งภาพต้นทางด้วย image-edit schema รองรับภาพอ้างอิงได้สูงสุด 16 ภาพ
ปล่อยให้ complexity เป็นค่าเริ่มต้นสำหรับการสร้างครั้งแรก สำหรับการแก้ไขเฉพาะจุด เช่น เปลี่ยนสีของวัตถุหนึ่งชิ้น ให้เริ่มจาก low และตรวจสอบว่ารายละเอียดรอบข้างยังคงเดิม
ทำตาม คู่มือการตั้งค่า CometAPI เพื่อสร้างคีย์ จากนั้นเก็บไว้ในตัวแปรสภาพแวดล้อมด้านล่าง คุณยังต้องมีไฟล์ PNG ต้นทางในเครื่องสำหรับตัวอย่างการแก้ไข
ตัวอย่างใช้ไลบรารี requests ของ Python เพื่อแสดงเนื้อหา JSON และ multipart ของบอดีคำขอโดยตรง
ตัวอย่างเหล่านี้ใช้รูปแบบคำขอของ OpenAI’s Image API ผ่าน CometAPI ก่อนรัน ให้ยืนยันว่าเส้นทาง CometAPI ที่คุณเลือก รองรับโมเดลและฟิลด์ที่ใช้ในตัวอย่าง
ติดตั้งไลบรารีที่ต้องใช้ pip install requests pillow
ตั้งค่าคีย์ในเชลล์ของคุณ:
export COMETAPI_KEY="YOUR_COMETAPI_KEY"
$env:COMETAPI_KEY = "YOUR_COMETAPI_KEY"
สร้างตัวช่วยคำขอที่ใช้ร่วมกัน บันทึกตัวช่วยร่วมกันเป็น image_workflows.py วางแต่ละเวิร์กโฟลว์ในสคริปต์แยกกันและ import ตัวช่วยที่ใช้ รันเฉพาะเวิร์กโฟลว์ที่คุณต้องการทดสอบ
import base64
import os
from pathlib import Path
import requests

BASE_URL = "https://api.cometapi.com/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['COMETAPI_KEY']}"}
MODEL = "gpt-image-2.6-flare"

def save_result(response, destination):
    response.raise_for_status()
    payload = response.json()
    Path(destination).write_bytes(
        base64.b64decode(payload["data"][0]["b64_json"], validate=True)
    )
    print(f"Saved: {destination}; usage: {payload.get('usage', 'Not returned')}")

def generate(prompt, destination, **options):
    response = requests.post(
        f"{BASE_URL}/images/generations", headers=HEADERS,
        json={"model": MODEL, "prompt": prompt, "n": 1, "size": "1024x1024",
              "quality": "medium", "complexity": "low", **options},
        timeout=(15, 300),
    )
    save_result(response, destination)
ตัวช่วยนี้จะยกข้อผิดพลาดเมื่อ HTTP ไม่สำเร็จหรือข้อมูล base64 ไม่ถูกต้อง คาดหวังโครงสร้าง data[0].b64_json; หากเส้นทางของคุณส่งกลับโครงสร้างต่างออกไป ให้ตรวจสอบคำตอบนั้นก่อนแก้ฟังก์ชันบันทึก
เก็บบันทึกการใช้งานที่ส่งกลับไว้กับเอาต์พุต หากคำขอหมดเวลา ให้ตรวจสอบสถานะหรือบันทึกการคิดค่าบริการก่อนส่งใหม่: การหมดเวลาไม่ได้ยืนยันว่าการสร้างล้มเหลว
สร้างภาพแรก รันคำเรียกนี้หลังตัวช่วยร่วมกันเพื่อสร้างภาพสินค้าหนึ่งภาพ และบันทึกเป็น cup.png
สำหรับตัวอย่างการแก้ไขภายหลัง ให้ทำสำเนา cup.png ชื่อ product.png ในไดเรกทอรีทำงานเดียวกัน เก็บ cup.png ไว้เป็นต้นฉบับ คุณสามารถใช้ภาพถ่ายสินค้าของคุณเองแทนได้ โดยบันทึกเป็น product.png
เตรียม setting.png แยกต่างหาก: ใช้ภาพถ่าย PNG ของฉากหรือพื้นหลังที่ต้องการวางแก้ว โดยมีพื้นที่ว่างพอสำหรับสินค้า ใช้ภาพที่คุณมีสิทธิ์อัปโหลด บันทึกไว้ข้าง product.png; คำขอแบบอ้างอิงหลายไฟล์จะใช้มันเป็นฉาก ไม่ใช่สินค้าชิ้นที่สอง
generate(
    prompt=(
        "Create a studio product photograph of an unbranded teal "
        "ceramic travel cup on a warm cream background. "
        "Show one cup, a clean silhouette, and a soft contact shadow. "
        "No text or decorative objects."
    ),
    destination="cup.png",
    output_format="png",
)
ตรวจสอบผลลัพธ์ตามเช็กลิสต์สั้นๆ: มีแก้วหนึ่งใบ สีถูกต้อง ขอบคมชัด และไม่มีวัตถุอื่น
จะสร้าง SVG ด้วย GPT Image 2.6 ได้อย่างไร? ใช้ เอาต์พุต SVG สำหรับสินทรัพย์เวกเตอร์ที่แก้ไขได้ ขอผ่านเอ็นด์พอยต์ generation ด้วย n=1 แล้วถอดรหัสคำตอบเป็นไฟล์ .svg เอาต์พุต SVG ไม่รองรับการสตรีม
generate(
    prompt=(
        "Design an original minimalist icon of a teal travel cup "
        "with a small leaf motif. Use simple closed vector shapes, "
        "two flat colors, and generous negative space. "
        "No text, gradients, photographs, or background scenery."
    ),
    destination="cup-icon.svg",
    output_format="svg",
)
การทดสอบรับงาน SVG ที่เป็นประโยชน์ควรทำมากกว่าการเปิดไฟล์:
ตรวจไอคอนทั้งขนาดเล็กและใหญ่
ตรวจว่าง่ายต่อการแก้ไขรูปร่างและสีหรือไม่
ยืนยันว่าเข้ากับระบบภาพที่ตั้งใจไว้
ตรวจ XML ก่อนฝัง SVG ที่ได้มาจากภายนอกลงในแอปพลิเคชัน
อย่าส่ง SVG กลับเข้าไปเป็นอินพุตแก้ไขแบบแรสเตอร์ แยกเวิร์กโฟลว์ปรับแก้เวกเตอร์และงานแก้ภาพออกจากกัน
จะสร้าง PNG โปร่งใสด้วย GPT Image 2.6 ได้อย่างไร? generate(
prompt=(
"Create a single teal ceramic travel cup as an isolated "
"e-commerce asset. Center the entire cup with generous padding. "
"Keep clean edges and a fully transparent background. "
"No floor, backdrop, checkerboard pattern, or text."
),
destination="cup-transparent.png",
output_format="png",
background="transparent",
)
from PIL import Image

with Image.open("cup-transparent.png") as image:
    alpha = image.convert("RGBA").getchannel("A")
    minimum, maximum = alpha.getextrema()

    if minimum == 255:
        raise RuntimeError("The output contains no transparent pixels.")

    if maximum == 0:
        raise RuntimeError("The output is entirely transparent.")

    print("The output contains visible content and transparency.")
สิ่งนี้จะจับภาพทึบที่แสดงตัวเป็นงานตัดฉาก แต่ไม่ได้ประเมินคุณภาพขอบ; ให้ตรวจสินทรัพย์บนพื้นหลังสว่างและมืดทั้งคู่
จะใช้การแก้ไขภาพด้วยภาพอ้างอิงหลายไฟล์ใน GPT Image 2.6 อย่างไร? กำหนดบทบาทเฉพาะให้แต่ละภาพอ้างอิง ในตัวอย่างนี้ ภาพแรกให้ตัวตนของสินค้า และภาพที่สองให้ฉากที่ต้องการ
with (
    open("product.png", "rb") as product,
    open("setting.png", "rb") as setting,
):
    response = requests.post(
        f"{BASE_URL}/images/edits",
        headers=HEADERS,
        data={
            "model": "gpt-image-2.6-sunburst",
            "prompt": (
                "Use the cup in the first image as the exact product "
                "reference. Use the second image only for the setting. "
                "Place the cup naturally in that setting. Preserve its "
                "silhouette, lid, color, and printed details. "
                "Do not copy other products from the second image."
            ),
            "quality": "high",
            "complexity": "medium",
            "output_format": "png",
        },
        files=[
            ("image[]", ("product.png", product, "image/png")),
            ("image[]", ("setting.png", setting, "image/png")),
        ],
        timeout=(15, 300),
    )

save_result(response, "product-in-setting.png")
ตัวอย่าง multipart ใช้ image[] คำขอแก้ไขแบบ JSON ใช้แอเรย์ images; อย่าผสมผสานสองรูปแบบการเข้ารหัส
เพื่อการทดสอบที่ทำซ้ำได้ ให้รักษาลำดับภาพอ้างอิงให้คงที่ เปรียบเทียบสินค้าต้นฉบับกับเอาต์พุตที่ความละเอียดเต็ม โดยเฉพาะหูจับ ป้าย ขอบ และเงาสะท้อน
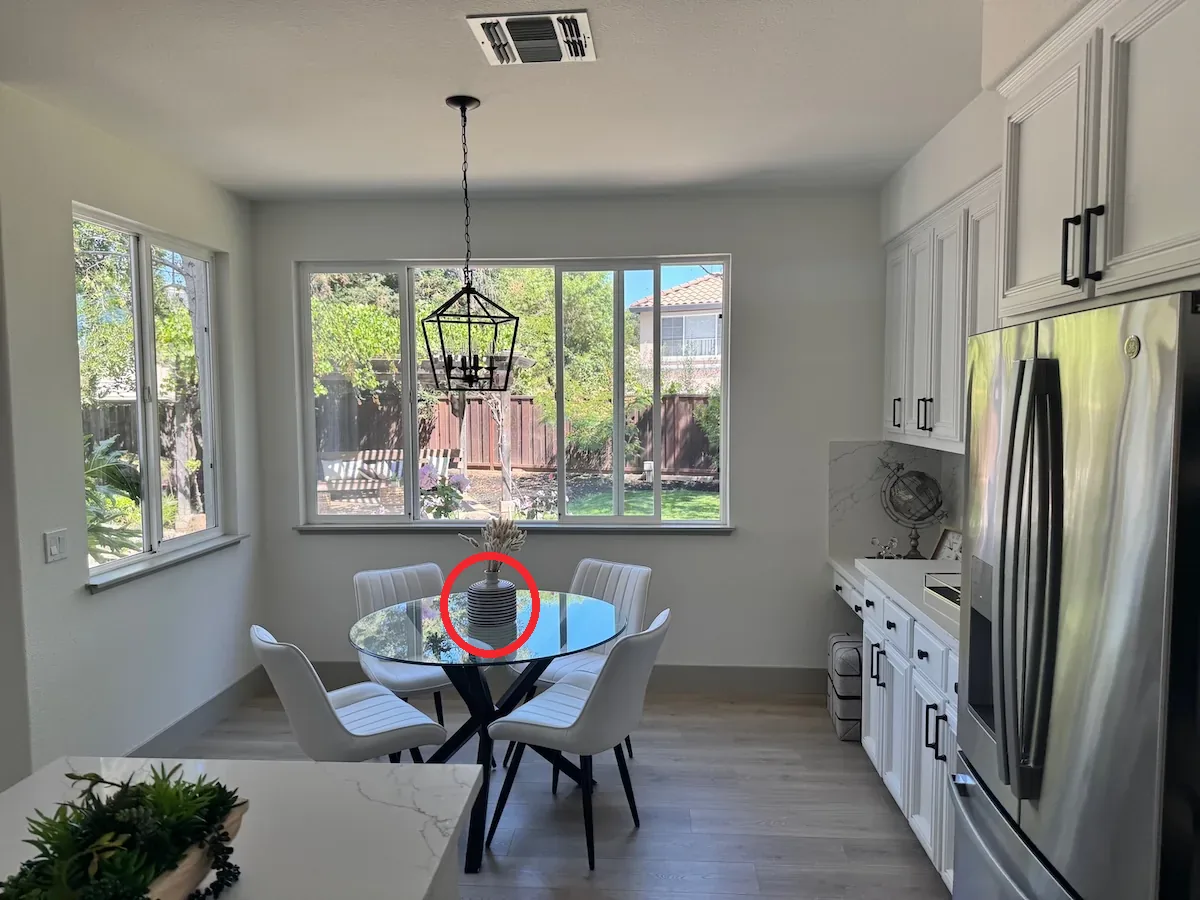
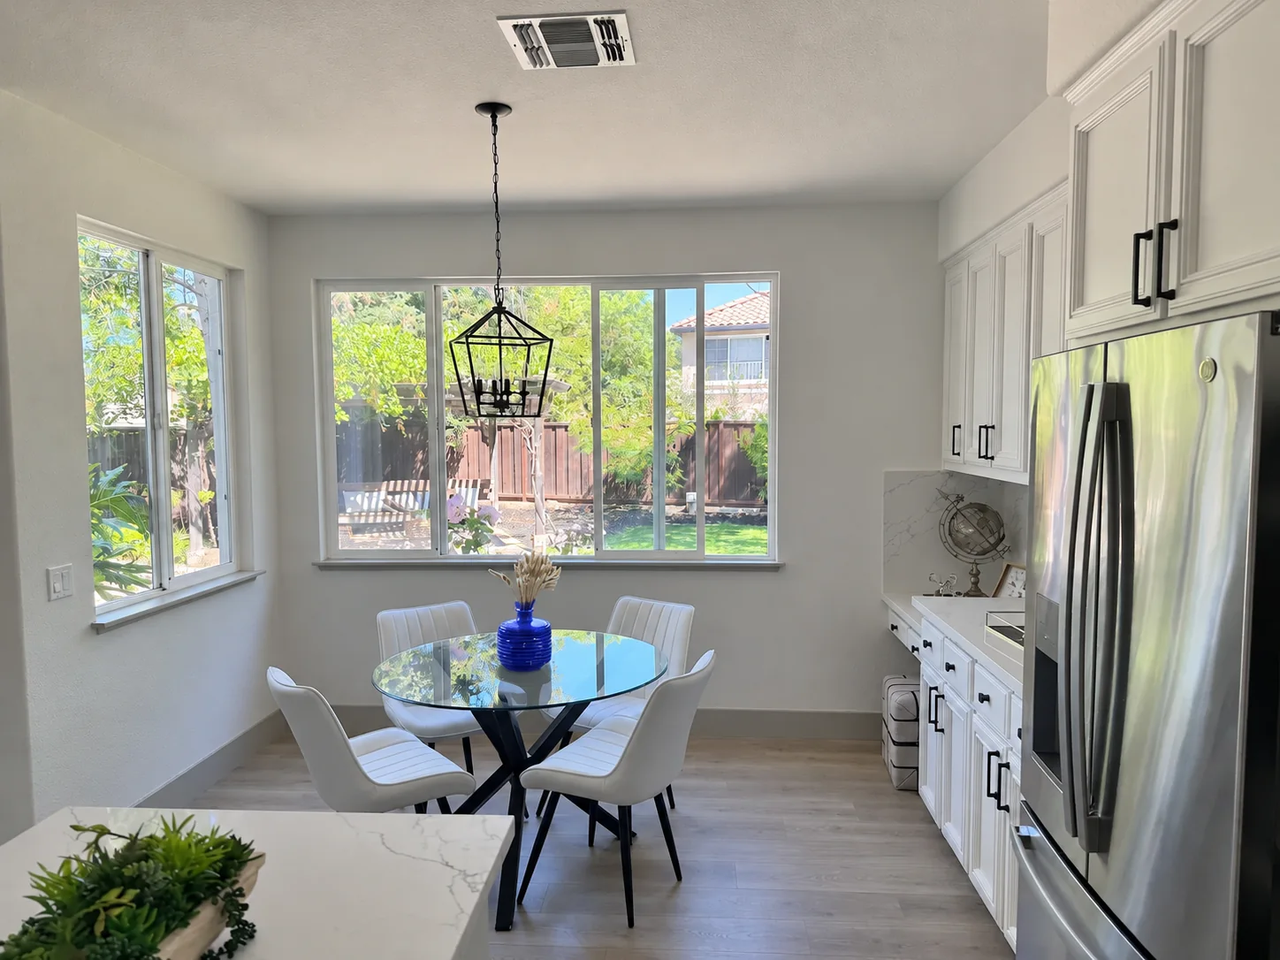
มาร์กอัป PNG โปร่งใสใน GPT Image 2.6 ทำงานอย่างไร? มาร์กอัปคือเลเยอร์คำอธิบายประกอบ วาดวงกลมหรือคำสั่งเชิงภาพอื่นๆ บนไฟล์ PNG โปร่งใสที่แยกต่างหาก แล้วส่งไฟล์นั้นไปพร้อมกับภาพต้นฉบับ
เวิร์กโฟลว์มาร์กอัป จะนำคำอธิบายประกอบไปใช้กับภาพอินพุตภาพแรก ออเวอร์เลย์ต้องมีมิติที่ตรงกับภาพตามการจัดวาง มีพิกเซลโปร่งใส และแยกจากต้นฉบับ อย่ารวม markup เข้ากับ mask หรือ prompt_rewriter
การสาธิตของ OpenAI แสดงแจกันที่ทำมาร์กอัปไว้:
การแก้ไขที่ได้เปลี่ยนแจกัน:
เหล่านี้เป็นภาพสาธิตอย่างเป็นทางการ ไม่ใช่เอาต์พุตจากโค้ดด้านล่าง
เตรียมเลเยอร์คำอธิบายประกอบ กรอบสี่เหลี่ยมด้านล่างกำหนดวงรีคำอธิบายประกอบ ปรับพิกัดให้ล้อมวัตถุที่คุณต้องการแก้ไข จากนั้นตรวจสอบออเวอร์เลย์ก่อนส่ง
from PIL import Image, ImageDraw, ImageOps

with Image.open("product.png") as source:
    oriented = ImageOps.exif_transpose(source).convert("RGBA")
    oriented.save("product-oriented.png")

overlay = Image.new("RGBA", oriented.size, (0, 0, 0, 0))
draw = ImageDraw.Draw(overlay)

width, height = oriented.size
region = (
    int(width * 0.25),
    int(height * 0.15),
    int(width * 0.75),
    int(height * 0.85),
)

draw.ellipse(region, outline=(255, 0, 0, 255), width=6)
overlay.save("markup.png")
ส่งคำขอแก้ไขแบบมีไกด์ with (
open("product-oriented.png", "rb") as source,
open("markup.png", "rb") as markup,
):
response = requests.post(
f"{BASE_URL}/images/edits",
headers=HEADERS,
data={
"model": MODEL,
"prompt": (
"Change the body of the cup inside the red circle "
"to matte cobalt blue. Preserve the lid, shape, "
"lighting, and surrounding scene. "
"Remove the annotation from the finished image."
),
"quality": "medium",
"complexity": "low",
"output_format": "png",
},
files={
"image": ("product.png", source, "image/png"),
"markup": ("markup.png", markup, "image/png"),
},
timeout=(15, 300),
)
save_result(response, "cup-edited.png")
ประเด็นการออกแบบที่สำคัญคือ ระบุทั้งการเปลี่ยนแปลงที่ร้องขอและรายละเอียดที่ต้องการคงไว้ มาร์กอัปใช้ชี้เป้าวัตถุ ส่วนข้อความกำหนดการกระทำ
ราคา GPT Image 2.6 API: อัตราโทเค็นและค่าใช้จ่ายสำหรับ SVG ทั้งสองรุ่นใช้อัตราโทเค็นของ OpenAI ดังนี้
อินพุตข้อความ $5.00 $5.00 อินพุตข้อความแบบแคช $1.25 $1.25 อินพุตภาพ $8.00 $8.00 อินพุตภาพแบบแคช $2.00 $2.00 เอาต์พุตภาพ $30.00 $30.00
นี่คืออัตราของ OpenAI ไม่ใช่ใบเสนอราคาที่ตรวจสอบโดย CometAPI
สำหรับคำขอที่ไม่แคช การคำนวณที่สอดคล้องคือ:
Cost =
(text input tokens × $5
 + image input tokens × $8
 + image output tokens × $30)
÷ 1,000,000
ตัวอย่างเช่น คำขอแรสเตอร์ที่ใช้อินพุตข้อความ 1,000 โทเค็น ไม่มีอินพุตภาพ และเอาต์พุตภาพ 2,000 โทเค็น จะมีค่าใช้จ่าย $0.065
สำหรับ GPT Image 2.6 API บน CometAPI ให้ใช้อัตราที่แสดงสำหรับเส้นทางที่คุณเลือก และทบทวนค่าใช้จ่ายที่บันทึกสำหรับคำขอของคุณ อัตราของ OpenAI ข้างต้นเป็นเพียงการคำนวณอ้างอิง ไม่ใช่ใบเสนอราคาของ CometAPI
ตัวชี้วัดทางธุรกิจที่เป็นประโยชน์คือ:
Cost per accepted asset =
total workflow spending ÷ number of approved assets
ให้นับงานที่ถูกปฏิเสธและรอบการปรับแก้รวมในตัวหารด้วย
จะย้ายเวิร์กโฟลว์ภาพเดิมไปยัง GPT Image 2.6 ได้อย่างไร? หากคุณใช้งาน GPT Image 2.5 อยู่แล้ว ให้ปรับตัวระบุโมเดลก่อน และคงเอ็นด์พอยต์กับการจัดการคำตอบให้ชัดเจน เพิ่มรูปแบบเอาต์พุตเพิ่มเติมหลังจากคำขอพื้นฐานสำเร็จเท่านั้น
ตั้งค่า model="gpt-image-2.6-flare" หรือ model="gpt-image-2.6-sunburst" แทนการพึ่งโมเดลเริ่มต้น คงไฟล์อินพุตและพรอมป์ต์เดิมไว้ขณะตรวจคำตอบแรก
สำหรับ SVG ใช้เอ็นด์พอยต์ generation บันทึกไบต์ที่ถอดรหัสด้วยนามสกุล .svg และไม่ใช้สตรีม สำหรับการแก้ไขแรสเตอร์ ให้คงภาพต้นทางไว้ในคำขอแก้ไข เพิ่ม markup หลังจากเตรียมออเวอร์เลย์โปร่งใสแยกต่างหากแล้วเท่านั้น
อัปเดตเลเยอร์ให้บริการไฟล์ของคุณด้วย: สินทรัพย์ SVG และ PNG ต้องใช้ชนิดสื่อที่ต่างกัน เก็บไฟล์ต้นฉบับและเวอร์ชันที่อนุมัติไว้ เริ่มการแก้ไขใหม่แต่ละครั้งจากเวอร์ชันที่มีการเปลี่ยนแปลงที่คุณต้องการคงไว้
สรุป เริ่มจากตัวอย่างภาพสินค้า จากนั้นเลือกเวิร์กโฟลว์ให้ตรงกับเอาต์พุตที่ต้องการ: SVG สำหรับงานเวกเตอร์ที่แก้ไขได้, PNG โปร่งใสสำหรับงานตัดฉาก, ภาพอ้างอิงสำหรับการผสมอินพุตเชิงภาพ, หรือมาร์กอัปสำหรับการเปลี่ยนแปลงแบบกำหนดเป้าหมาย เปรียบเทียบ Flare และ Sunburst ด้วยพรอมป์ต์และการตั้งค่าเดียวกัน และติดตามต้นทุนต่อสินทรัพย์ที่ยอมรับ
คำถามที่พบบ่อย
ควรจัดการอย่างไรหากคำขอ GPT Image 2.6 หมดเวลา? การหมดเวลาอาจเกิดขึ้นในขณะที่เซิร์ฟเวอร์ยังประมวลผลอยู่ ให้บันทึก request ID และตรวจบันทึกคำขอของผู้ให้บริการก่อนลองใหม่ เพื่อหลีกเลี่ยงงานซ้ำและการคิดค่าบริการซ้ำ
ทำไมแอปของฉันบันทึกภาพที่ส่งกลับไม่สำเร็จ? ตัวช่วยคาดหวังคำตอบ JSON ที่มี data[0].b64_json ก่อนอื่นตรวจสถานะ HTTP และโครงสร้างคำตอบ หากเส้นทางของคุณส่งกลับเป็น URL ของภาพแทน ให้ทำตามกระบวนการดาวน์โหลดผ่าน URL ตามเอกสาร แทนที่จะส่ง URL นั้นเข้า base64 decoder ให้คงนามสกุลไฟล์ที่บันทึกให้สอดคล้องกับรูปแบบที่ร้องขอ
จะป้องกันไม่ให้ไฟล์แก้ไขถูกเขียนทับได้อย่างไร? บันทึกไฟล์ต้นทาง ออเวอร์เลย์ และเอาต์พุตแต่ละครั้งด้วยชื่อแยกกัน เช่น product-source.png, product-markup.png, และ product-edit-01.png เก็บพรอมป์ต์ไว้ข้างเอาต์พุต วิธีนี้ช่วยให้ย้อนดูการแก้ไขรอบใดรอบหนึ่งได้โดยไม่สูญเสียต้นฉบับหรืออัปโหลดภาพพรีวิวที่มีคำอธิบายประกอบเป็นต้นฉบับโดยไม่ตั้งใจ
ควรตรวจอะไรบ้างก่อนฝัง SVG ที่สร้างขึ้น? เปิดสินทรัพย์ใน renderer เป้าหมายของคุณและตรวจ XML ด้วยเครื่องมือตรวจสอบ SVG มาตรฐานของคุณ ตรวจมิติ การครอบตัด พาธ และข้อความ (ถ้ามี) ก่อนเผยแพร่ ใช้นโยบายการทำความสะอาด SVG ของแอป เสิร์ฟด้วยชนิดสื่อที่ถูกต้อง และยืนยันว่ายังคงอ่านออกได้ที่ขนาดเล็กสุดที่ใช้ในอินเทอร์เฟซของคุณ