ข้อกำหนดทาง技术ของ GLM-5.3-Flash
| ข้อกำหนด | GLM-5.3-Flash |
|---|---|
| ผู้ให้บริการ | Z.ai (Zhipu AI) |
| ตระกูลโมเดล | GLM-5 |
| ประเภทโมเดล | โมเดล Mixture-of-Experts แบบมัลติโหมดโดยกำเนิด |
| จำนวนพารามิเตอร์ทั้งหมด | 320B |
| พารามิเตอร์ที่ใช้งาน | 18B |
| สถาปัตยกรรม | ความสนใจ (attention) แบบ sparse + linear แบบไฮบริด |
| หน้าต่างบริบท | 1,048,576 โทเคน (1M) |
| เอาต์พุตสูงสุด | 131,072 โทเคน |
| โหมดอินพุต | ข้อความ, รูปภาพ, วิดีโอ |
| โหมดเอาต์พุต | ข้อความ |
| การให้เหตุผล | รองรับ |
| วิสัยทัศน์ | รองรับ |
| การเรียกใช้ฟังก์ชัน | รองรับ |
| การใช้เครื่องมือ | รองรับ |
| การค้นหาเว็บ | รองรับผ่านการผสานรวม API ที่รองรับ |
| น้ำหนักโมเดลเปิดเผย | ใช่ |
| สัญญาอนุญาต | MIT |
| เผยแพร่ | August 26, 2026 |
Z.ai อธิบายว่า GLM-5.3-Flash คือโมเดลมัลติโหมดโดยกำเนิดตัวแรกในตระกูล GLM-5 มีพารามิเตอร์ทั้งหมด 320B แต่เปิดใช้งานเพียง 18B พารามิเตอร์ต่อขั้นตอนอนุมาน โมเดลนี้แนะนำสถาปัตยกรรมแบบไฮบริดที่ผสมผสานความสนใจแบบ sparse และแบบเชิงเส้น และใช้ mHC เพื่อปรับปรุงประสิทธิภาพการสเกล
GLM-5.3-Flash คืออะไร?
GLM-5.3-Flash เป็นสมาชิกที่มุ่งเน้นประสิทธิภาพของรุ่น GLM-5 ออกแบบมาเพื่อผสานความสามารถในการให้เหตุผลระดับแนวหน้าและความสามารถด้าน agentic coding เข้ากับต้นทุนการอนุมานที่ต่ำลงอย่างมาก
ความแตกต่างที่สำคัญที่สุดจากโมเดล "Flash" แบบดั้งเดิมคือว่า Flash ไม่ได้หมายถึงโมเดลขนาดเล็ก GLM-5.3-Flash มีพารามิเตอร์ทั้งหมด 320B แต่ด้วยสถาปัตยกรรม MoE จะเปิดใช้งานเพียง 18B พารามิเตอร์ต่อโทเคน ช่วยให้ Z.ai เล็งเป้าต้นทุนการอนุมานที่ต่ำกว่ามาก ขณะยังคงกลุ่มพารามิเตอร์ขนาดใหญ่เพื่อความจุของโมเดล
นอกจากนี้ ยังเป็นโมเดล GLM-5 ตัวแรกที่มีความสามารถมัลติโหมดโดยกำเนิด โมเดลรองรับอินพุตภาพนอกเหนือจากข้อความ และวางตำแหน่งไว้สำหรับการเขียนโค้ด การทำงานกับเบราว์เซอร์ ความเข้าใจเอกสาร การโค้ดจากภาพ และเวิร์กโฟลว์แบบเอเจนต์
Z.ai ระบุว่า GLM-5.3-Flash ได้รับการฝึกจากโมเดลฐานที่ฝึกใหม่ ไม่ใช่เพียงเวอร์ชันบีบอัดของ GLM-5.2 การฝึกใช้ คอร์ปัสพรีเทรนแบบมัลติโหมดขนาด 30 ล้านล้านโทเคน ในขณะที่สถาปัตยกรรมได้รับการออกแบบใหม่โดยเน้นความสามารถและประสิทธิภาพการอนุมาน
คุณสมบัติหลักของ GLM-5.3-Flash
- MoE 320B พร้อมพารามิเตอร์ที่ใช้งาน 18B: GLM-5.3-Flash ผสานความจุพารามิเตอร์รวมที่ใหญ่มากเข้ากับรอยเท้าพารามิเตอร์ที่ใช้งานค่อนข้างเล็ก ทำให้โมเดลให้บริการได้มีประสิทธิภาพกว่ามากเมื่อเทียบกับโมเดล dense 320B
- ความเข้าใจแบบมัลติโหมดโดยกำเนิด: แตกต่างจาก GLM-5 รุ่นก่อน GLM-5.3-Flash ประมวลผลอินพุตภาพได้โดยกำเนิด การ์ดโมเดลแสดงตัวอย่างความเข้าใจภาพและระบุว่าเป็นโมเดลมัลติโหมด
- บริบท 1M โทเคน: โมเดลถูกออกแบบมาสำหรับแอปพลิเคชันบริบทยาวที่เกี่ยวข้องกับคลังขนาดใหญ่ เอกสารขนาดยาว เส้นทางเอเจนต์ยาว และเวิร์กโฟลว์หลายขั้นตอนที่ซับซ้อน ทั้ง Cloudflare และ Vercel ระบุหน้าต่างบริบท 1,048,576 โทเคน
- ความสนใจแบบ sparse + linear แบบไฮบริด: GLM-5.3-Flash เป็นโมเดล GLM ตัวแรกที่ผสานความสนใจแบบ sparse และแบบเชิงเส้น Z.ai ระบุว่าสถาปัตยกรรมนี้ลดต้นทุนการให้บริการบริบทยาว ขณะยังคงความแม่นยำของความสามารถบริบทยาว
- การเขียนโค้ดแบบเอเจนต์และการใช้เครื่องมือ: โมเดลได้รับการปรับให้เหมาะกับวิศวกรรมซอฟต์แวร์ งานเทอร์มินัล ปฏิสัมพันธ์กับเบราว์เซอร์ และเวิร์กโฟลว์ที่ขับเคลื่อนด้วยเครื่องมือ โดยรายงานคะแนน Terminal-Bench 2.1 อยู่ที่ 84.3
- การปรับใช้ด้วยน้ำหนักที่เปิดเผย: น้ำหนักที่ได้รับอนุญาตตาม MIT สามารถปรับใช้กับ Transformers, vLLM, SGLang, TokenSpeed และ KTransformers ให้ตัวเลือกสำหรับผู้พัฒนาด้านการโฮสต์เองและการเพิ่มประสิทธิภาพการอนุมาน
ประสิทธิภาพบेंชมาร์กของ GLM-5.3-Flash
GLM-5.3-Flash มีโปรไฟล์ที่แข็งแกร่งเป็นพิเศษในบेंชมาร์กด้านการเขียนโค้ดและงานเอเจนต์
| บेंชมาร์ก | GLM-5.3-Flash | GLM-5.2 | หมายเหตุ |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 81.0 | เทอร์มินัล / การโค้ดแบบเอเจนต์ |
| DeepSWE v1.1 | 63.4 | 46.2 | วิศวกรรมซอฟต์แวร์ |
| AutomationBench | 48.8 | 26.2 | ระบบอัตโนมัติสำหรับการใช้งานคอมพิวเตอร์ |
| Toolathlon-Verified | 78.4 | 59.9 | ความสามารถในการใช้เครื่องมือ |
| NL2Repo-Bench | 56.3 | 48.9 | การโค้ดจากภาษาธรรมชาติเป็นรีโพ |
| Agent's Last Exam | 26.3 | 20.4 | การให้เหตุผลแบบเอเจนต์ |
| Humanity's Last Exam | 55.3 | — | พร้อมเครื่องมือ |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | งานเพิ่มผลผลิต / งานความรู้ |
| OfficeQA-Pro | 62.4 | — | ผลิตภาพแบบมัลติโหมด |
| CharXiv RQ | 89.4 | — | การให้เหตุผลแบบมัลติโหมด |
ส่วนการประเมินบน Hugging Face อย่างเป็นทางการระบุ 84.3 บน Terminal-Bench 2.1, 63.4 บน DeepSWE และ 55.3 บน HLE วัสดุเปิดตัวของ Z.ai รายงานผลเพิ่มเติมรวมถึง AutomationBench, Toolathlon, NL2Repo และ GDPval
Independent Artificial Analysis ขณะนี้ให้ Intelligence Index ที่ 57 วางโมเดลนี้ไว้ในอันดับที่ 3 จาก 108 โมเดลในชุดการเปรียบเทียบปัจจุบัน
ตัวเลขเหล่านี้ยังควรถูกตีความพร้อมข้อจำกัดเฉพาะบेंชมาร์ก: หลายผลลัพธ์มาจากผู้ขาย รายการเครื่องมือประเมินต่างกัน และคะแนนบेंชมาร์กไม่ควรถูกมองว่าเป็นการจัดอันดับคุณภาพโมเดลแบบสากล
GLM-5.3-Flash เทียบกับ GLM-5.3 และ GLM-5.2
| คุณลักษณะ | GLM-5.3-Flash | GLM-5.3 | GLM-5.2 |
|---|---|---|---|
| รุ่นของโมเดล | GLM-5 | GLM-5 | GLM-5 |
| การวางตำแหน่ง | โมเดลมัลติโหมด/เอเจนต์ที่มีประสิทธิภาพ | โมเดลให้เหตุผลระดับไฮเอนด์ทั่วไป | โมเดลรุ่นก่อนที่ใช้งานทั่วไป |
| วิสัยทัศน์โดยกำเนิด | ใช่ | ไม่ | ขึ้นกับโมเดล |
| พารามิเตอร์ทั้งหมด | 320B | การกำหนดค่าสู่ธงที่ใหญ่กว่า | โมเดลขนาดใหญ่ |
| พารามิเตอร์ที่ใช้งาน | 18B | — | — |
| บริบท | 1M | การปรับใช้ระดับ 200K | การปรับใช้ระดับ 200K |
| ความสนใจแบบไฮบริด sparse/linear | ใช่ | ไม่ | ไม่ |
| การโค้ดแบบเอเจนต์ | เยี่ยม | เยี่ยม | แข็งแกร่ง |
| น้ำหนักโมเดลเปิดเผย | ใช่ | ขึ้นอยู่กับการปรับใช้ | ขึ้นอยู่กับการปรับใช้ |
| ข้อได้เปรียบหลัก | ความสามารถต่อหน่วยการคำนวณอนุมาน | ศักยภาพการให้เหตุผลสูงสุดของ GLM-5 | เจเนอเรชัน GLM ที่สุกงอมและต้นทุนต่ำกว่า |
ความแตกต่างสำคัญคือ GLM-5.3-Flash ไม่ใช่เพียง GLM-5.3 ที่มีขนาดเล็กลง Z.ai ระบุว่าเริ่มจากโมเดลฐานที่ฝึกใหม่และแนะนำสถาปัตยกรรมความสนใจแบบไฮบริด mHC และการพรีเทรนแบบมัลติโหมด
GLM-5.3-Flash เทียบกับ DeepSeek V4 Flash — สรุปการเปรียบเทียบ
| มิติ | GLM-5.3-Flash (Z.ai / Zhipu) | DeepSeek V4 Flash (DeepSeek) | ความได้เปรียบ |
|---|---|---|---|
| วันที่เปิดตัว | August 26, 2026 | พรีวิว April 2026; เช็คพอยต์หลัก (0731) July 31, 2026 | — |
| พารามิเตอร์ทั้งหมด / ที่ใช้งาน | 320B / 18B | 284B / 13B | GLM ใหญ่กว่าเล็กน้อย |
| หน้าต่างบริบท | 1M โทเคน | 1M โทเคน | เสมอกัน |
| เอาต์พุตสูงสุด | ~131K โทเคน | สูงสุด 384K โทเคน | DeepSeek |
| โหมด | มัลติโหมดโดยกำเนิด (อินพุตข้อความ + ภาพ + วิดีโอ) | หลักคือข้อความ (มีรุ่นวิสัยทัศน์แบบทดลองใช้อยู่) | GLM |
| ไฮไลต์สถาปัตยกรรม | ความสนใจแบบไฮบริด sparse + linear (คอมพิวต์ attention ~3× ต่ำลง, KV cache ~4.4× เล็กกว่ารุ่น GLM-5.3 เต็ม) | Compressed Sparse Attention (CSA) + Heavily Compressed Attention (HCA) | ต่างฝ่ายมีจุดแข็ง |
| สัญญาอนุญาต | MIT (น้ำหนักอยู่บน Hugging Face) | MIT (มีน้ำหนักให้ใช้งาน) | เสมอกัน |
| ราคามาตรฐานของ API ($ / 1M โทเคน) | อินพุต $0.15 / เอาต์พุต $0.50 (อินพุตที่แคช ~ $0.03) | ช่วงทั่วไป อินพุต $0.14–$0.44 / เอาต์พุต $0.28–$1.32 (แตกต่างตามช่วงคาบเกี่ยว/นอกคาบเกี่ยว) | GLM ถูกกว่า |
| ราคาโปรโมชันเปิดตัว | ~$0.075 อินพุต / $0.25 เอาต์พุต (ระยะเวลาจำกัด, ~ต้น Sep 2026) | ไม่มีโปรโมชันเทียบเท่า | GLM |
| AA Intelligence Index | 57 (รายงานโดยผู้ขาย) | ~50 (การวัดจากภายนอก) | GLM |
| Terminal-Bench 2.1 | 84.3 | 82.7 | GLM |
| DeepSWE | 63.4 | 54.4 | GLM |
| SWE-bench Verified | ข้อมูลอิสระยังจำกัด | ~79% (ผลอิสระแข็งแกร่ง) | DeepSeek |
| จุดแข็งหลัก | ราคาต่ำกว่า, มัลติโหมดโดยกำเนิด, นำบนหลายบेंชมาร์กเอเจนต์/โค้ด, ประสิทธิภาพบริบทยาวดี | การตรวจสอบจากภายนอกที่สุกงอมกว่า, ผลงานเด่นด้านโค้ด/เอเจนต์, ออกแบบบริบทยาวที่มีประสิทธิภาพสูง, ระบบนิเวศแข็งแกร่ง | — |
| จุดอ่อนหลัก | รุ่นใหม่กว่า (บางคะแนนยังรายงานโดยผู้ขาย); ความเร็วเฉลี่ย | รองรับมัลติโหมดอ่อนกว่า; ราคาที่มีผลจริงสูงกว่าบนหลายเส้นทาง | — |
| เหมาะกับ | การใช้งานทั่วไป, งานมัลติโหมด, โครงการที่อ่อนไหวต่อต้นทุน, ความสามารถเอเจนต์แบบสมดุล | เอเจนต์โค้ดล้วน, การให้เหตุผลข้อความบริบทยาว, สถานการณ์ที่ต้องการบेंชมาร์กอิสระที่พิสูจน์แล้ว | — |
สรุปหนึ่งประโยค:
ณ ปลายเดือนสิงหาคม 2026, GLM-5.3-Flash นำหน้าด้านราคา ความสามารถมัลติโหมด และหลายบेंชมาร์กที่ทับซ้อนกัน มอบความคุ้มค่าโดยรวมที่ดีกว่า ขณะที่ DeepSeek V4 Flash ยังคงเป็นตัวเลือกที่เชื่อถือได้สูงสำหรับเอเจนต์ที่เน้นการโค้ดด้วยการยืนยันอิสระที่แข็งแรงและประสิทธิภาพบริบทยาว ทดสอบทั้งสองบนเวิร์กโหลดของคุณก่อนตัดสินใจ
กรณีการใช้งาน GLM-5.3-Flash
1. วิศวกรรมซอฟต์แวร์แบบเอเจนต์
GLM-5.3-Flash เหมาะอย่างยิ่งสำหรับเอเจนต์โค้ดที่ต้องตรวจสอบรีโพ ปรับแก้หลายไฟล์ รันคำสั่งเทอร์มินัล รันทดสอบ และวนซ้ำการพัฒนา
คะแนน 84.3 บน Terminal-Bench 2.1 และ 63.4 บน DeepSWE แสดงว่าวิศวกรรมซอฟต์แวร์เป็นหนึ่งในจุดแข็งที่สุดของมัน
2. การโค้ดจากภาพ
ด้วยความเป็นมัลติโหมดโดยกำเนิด นักพัฒนาสามารถให้สกรีนช็อต แผนภาพ และอินพุตภาพอื่น ๆ ควบคู่กับคำสั่งโค้ด ซึ่งมีประโยชน์สำหรับการทำ UI การดีบักภาพ และเวิร์กโฟลว์ design-to-code
3. การวิเคราะห์เอกสารบริบทยาว
หน้าต่างบริบท 1M โทเคนทำให้โมเดลเหมาะกับเอกสารเทคนิคชุดใหญ่ รีโพขนาดใหญ่ รายงานยาว และประวัติเอเจนต์หลายช่วงขั้นตอน
4. เอเจนต์สำหรับเบราว์เซอร์และการใช้คอมพิวเตอร์
ความสามารถในการใช้เครื่องมือและมัลติโหมดของโมเดลทำให้เหมาะกับเวิร์กโฟลว์ที่เกี่ยวข้องกับเบราว์เซอร์ อินเทอร์เฟซกราฟิก และเครื่องมือภายนอก
5. งานความรู้ในองค์กร
GLM-5.3-Flash สามารถประมวลผลข้อมูลโครงสร้างและไม่มีโครงสร้างจำนวนมาก พร้อมใช้เครื่องมือดำเนินงานหลายขั้นตอน เหมาะกับการวิเคราะห์เอกสาร ผู้ช่วยวิจัย และระบบอัตโนมัติเวิร์กโฟลว์
6. โครงสร้างพื้นฐาน AI แบบโฮสต์เอง
สัญญาอนุญาต MIT และน้ำหนักที่เปิดเผยทำให้ GLM-5.3-Flash น่าสนใจสำหรับองค์กรที่ต้องการควบคุมการปรับใช้ การประมวลผลข้อมูล และโครงสร้างพื้นฐานการอนุมาน
พารามิเตอร์ API ของ GLM-5.3-Flash
| พารามิเตอร์ | คำอธิบาย |
|---|---|
| model | ตัวระบุโมเดลเฉพาะผู้ให้บริการ |
| messages | อินพุตการสนทนาแบบมีโครงสร้าง |
| prompt | อินพุตพรอมต์เดี่ยวบน API ที่รองรับ |
| max_tokens / max_completion_tokens | ขีดจำกัดโทเคนของเอาต์พุต |
| temperature | ควบคุมความสุ่มในการสุ่มตัวอย่าง |
| tools | คำจำกัดความของเครื่องมือ/ฟังก์ชัน |
| stream | เปิดใช้งานการสตรีมเอาต์พุต |
| reasoning | ควบคุมความพยายามด้านการให้เหตุผลบนเกตเวย์ที่รองรับ |
| Image content | รองรับ |
| Function calling | รองรับ |
| Context | สูงสุด 1M โทเคน |
Vercel AI Gateway ขณะนี้เอกสารระบุเอาต์พุตสูงสุด 131,000 โทเคน โดยโทเคนสำหรับการให้เหตุผลจะถูกนับรวมในขีดจำกัดเอาต์พุต
วิธีใช้ GLM-5.3-Flash API บน CometAPI
ขั้นตอนที่ 1: ขอสิทธิ์ API
เข้าสู่ระบบ cometAPI หากคุณยังไม่ใช่ผู้ใช้ของเรา กรุณาลงทะเบียนก่อน ลงชื่อเข้าใช้ CometAPI console รับคีย์ API สิทธิ์เข้าถึงของอินเทอร์เฟซ คลิก “Add Token” ที่ส่วน API token ในศูนย์ส่วนบุคคล รับคีย์โทเคน: sk-xxxxx และส่ง
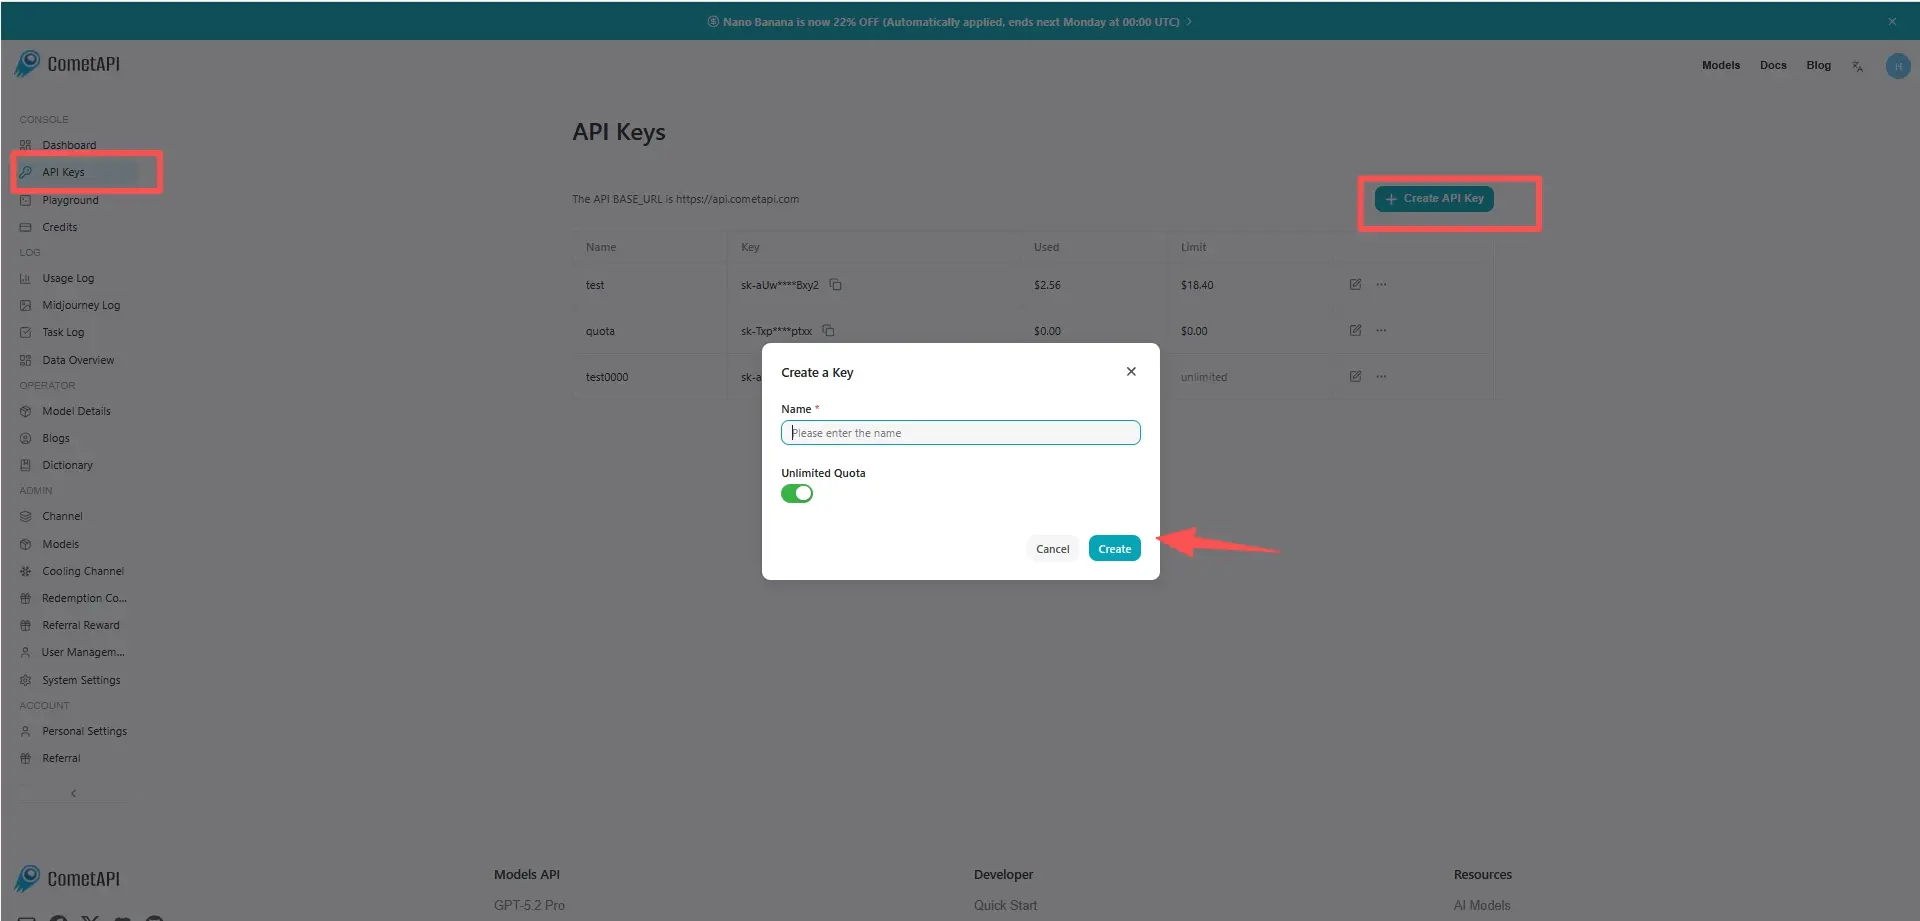
ขั้นตอนที่ 2: ส่งคำขอไปยัง GLM-5.3-Flash API
เลือกเอ็นด์พอยต์ “GLM-5.3-Flash” เพื่อส่งคำขอ API และตั้งค่า request body วิธีการและ request body ได้จากเอกสาร API บนเว็บไซต์ของเรา เว็บไซต์ยังมีการทดสอบผ่าน Apifox เพื่อความสะดวกของคุณ แทนที่ <YOUR_API_KEY> ด้วย CometAPI key จริงจากบัญชีของคุณ
แทรกคำถามหรือคำขอของคุณในฟิลด์ content — นี่คือสิ่งที่โมเดลจะตอบสนอง ประมวลผลการตอบกลับ API เพื่อรับคำตอบที่สร้างขึ้น
ขั้นตอนที่ 3: ประมวลผลการตอบกลับ
API จะส่งกลับการตอบแบบมีโครงสร้างซึ่งรวมถึงข้อความที่สร้าง การอ้างอิง เมทาดาต้าด้านความปลอดภัย และเอาต์พุตเครื่องมือแบบเลือกได้ สำหรับคำขอแบบมัลติโหมด เนื้อหาข้อความสามารถถูกจัดโครงสร้างด้วยอินพุตข้อความและภาพเมื่อเอ็นด์พอยต์ CometAPI ที่เลือกเปิดเผยความสามารถด้านวิสัยทัศน์ของโมเดล
เอ็นด์พอยต์ CometAPI ที่แน่นอน พารามิเตอร์ที่รองรับ และความพร้อมให้บริการปัจจุบันควรอ้างอิงจากเอกสาร API แบบสดของ CometAPI ไม่ใช่อนุมานจาก API ต้นทางของ Z.ai
สำหรับ CometAPI การผสานรวมควรใช้ model ID ที่แสดงบนเอ็นด์พอยต์โมเดลสดของ CometAPI แทนการคัดลอก ID เฉพาะผู้ให้บริการจาก Z.ai, Cloudflare หรือ Vercel โดยอัตโนมัติ
ข้อจำกัดของ GLM-5.3-Flash
- ขนาดโมเดลใหญ่: แม้จะเปิดใช้งานเพียง 18B พารามิเตอร์ แต่โมเดลที่ปล่อยประกอบด้วยประมาณ 321B พารามิเตอร์ ทำให้การโฮสต์เองต้องการทรัพยากรมากกว่าการปรับใช้โมเดล 7B–70B แบบเดิมอย่างมาก
- ความเร็วในการอนุมานไม่ได้ "เร็วปานสายฟ้า" เสมอไป: ขณะนี้ Artificial Analysis วัดได้ประมาณ 50 โทเคนเอาต์พุตต่อวินาทีในสภาพแวดล้อมเปรียบเทียบ จัดโมเดลไว้ต่ำกว่ารุ่นเล็กที่เร็วที่สุดพอสมควร
- บริบทยาวมากเพิ่มความต้องการโครงสร้างพื้นฐาน: บริบท 1M โทเคนมีประโยชน์ แต่สามารถเพิ่มความซับซ้อนด้านหน่วยความจำและการให้บริการ
- ประสิทธิภาพบेंชมาร์กแตกต่างตามงาน: GLM-5.3-Flash แข็งแกร่งเป็นพิเศษในบेंชมาร์กการโค้ดแบบเอเจนต์และการใช้เครื่องมือ แต่ไม่มีบेंชมาร์กใดที่ยืนยันความเหนือชั้นแบบสากลเหนือโมเดลเชิงพาณิชย์ระดับแนวหน้า
- เอาต์พุตมัลติโหมดมีข้อจำกัด: ความสามารถมัลติโหมดโดยกำเนิดของโมเดลอยู่ฝั่งอินพุตเป็นหลัก; เอาต์พุตมาตรฐานเป็นข้อความ ไม่ใช่ภาพหรือวิดีโอที่สร้างขึ้น