Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog การแคชพรอมต์คืออะไร? เปรียบเทียบ OpenAI, Claude และ Gemini ในปี 2026 ai-comparisons / งานวิจัย CometAPI
การแคชพรอมต์คืออะไร? เปรียบเทียบ OpenAI, Claude และ Gemini ในปี 2026 เรียนรู้ว่าการแคชพรอมป์ทำงานอย่างไรในปี 2026 เปรียบเทียบวิธีการแคชของ OpenAI, Claude และ Gemini, ค่า TTL, ราคา, ประสิทธิภาพ, ตัวอย่างภาษา Python และการเข้าถึง CometAPI.
Deon Goodwin ทีมวิจัยโมเดล AI และ API เรียนรู้ว่าการแคชพรอมป์ทำงานอย่างไรในปี 2026 เปรียบเทียบวิธีการแคชของ OpenAI, Claude และ Gemini, ค่า TTL, ราคา, ประสิทธิภาพ, ตัวอย่างภาษา Python และการเข้าถึง CometAPI.
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
การแคชพรอมต์ช่วยให้โมเดลภาษานำพรีฟิกซ์ของพรอมต์ที่ประมวลผลไว้แล้วกลับมาใช้ซ้ำ แทนที่จะคำนวณอินพุตซ้ำๆ ช่วยลดค่าใช้จ่ายโทเค็นอินพุตและปรับปรุงเวลาแฝง โดยเฉพาะในเวิร์กโฟลว์ของเอเจนต์ งานสนับสนุนลูกค้า RAG และการวิเคราะห์เอกสารขนาดใหญ่ ในปี 2026 OpenAI มีการแคชอัตโนมัติและตัวควบคุมแคชแบบระบุชัดเจนใหม่ๆ Claude รองรับการแคชอัตโนมัติและจุดแบ่งแคชช่วงบล็อก ส่วน Gemini เน้นการแคชโดยปริยายสำหรับโมเดลรุ่นใหม่ ผู้ให้บริการคิดค่าบริการต่างกันสำหรับการเขียนแคช การอ่านแคช และ (หากมี) การจัดเก็บ การหมดอายุอาจทำให้ต้องเขียนใหม่หรือคิดค่าบริการอินพุตเต็ม ดังนั้นการประหยัดจริงขึ้นกับความถี่การใช้งานซ้ำและอัตรา cache hit ที่วัดได้
คู่มือนี้เปรียบเทียบการแคชพรอมต์ใน GPT-6.1 Sol, Claude Opus 5.5 และ Gemini 4 Argon สำหรับนักพัฒนาที่สร้างแอปพลิเคชันซึ่งมีอินพุตซ้ำ เน้นตัวควบคุมแคช การกำหนดราคา และวิธีตรวจสอบการใช้งานซ้ำ
Key Takeaways
การแคชพรอมต์นำกลับมาใช้ซ้ำเฉพาะอินพุตที่ประมวลผลแล้ว ไม่ใช่คำตอบเดิมของโมเดล
การแคชพรอมต์ของ OpenAI ขึ้นกับพรีฟิกซ์ที่คงที่ คุณสมบัติของโมเดลที่รองรับ และขั้นต่ำ/การคงอยู่ตามรุ่นของโมเดล
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
การแคชของ Claude มี TTL 5 นาที และตัวเลือก 1 ชั่วโมง พร้อมการควบคุมแคชทั้งอัตโนมัติและแบบกำหนดเอง
การแคชบริบทของ Gemini เป็นแบบโดยปริยายในโมเดลสมัยใหม่; ทรัพยากรแคชแบบระบุชัดเจนยังขึ้นกับโมเดล
การประหยัดจากการแคชขึ้นกับการเขียน การอ่าน การจัดเก็บ และ cache hit จริง ตรวจสอบการรองรับเอ็นด์พอยต์และการคิดค่าบริการโทเค็นที่แคชเมื่อใช้ CometAPI
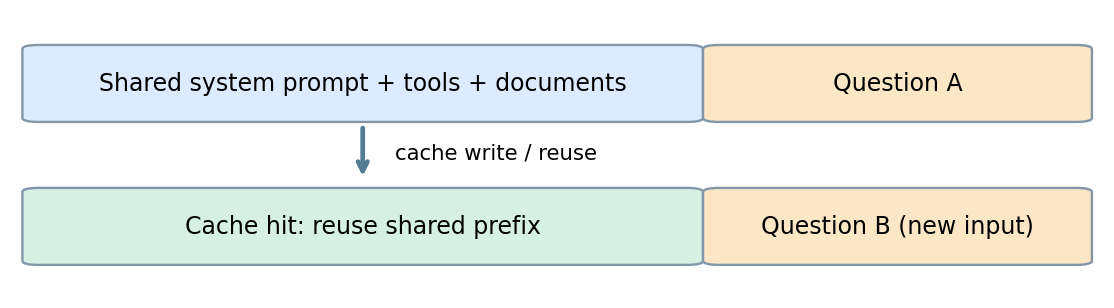
What Is Prompt Caching in LLMs? การแคชพรอมต์คือการเพิ่มประสิทธิภาพการ suyบผลที่ช่วยให้นำสถานะการคำนวณที่ได้จากพรีฟิกซ์ที่เคยประมวลผลกลับมาใช้ซ้ำ พรอมต์มักประกอบด้วยคำสั่งที่คงที่ คำจำกัดความของเครื่องมือ หรือเอกสาร แล้วตามด้วยคำถามของผู้ใช้ที่เปลี่ยนไป หากคำขอภายหลังซ้ำพรีฟิกซ์ที่เข้าเกณฑ์ได้ ผู้ให้บริการอาจนำสถานะคีย์-ค่า (KV) ที่แคชไว้กลับมาใช้ และประมวลผลเฉพาะส่วนที่ไม่ได้แคช แตกต่างจากการแคชคำตอบซึ่งจะเล่นคำตอบเดิมซ้ำ การแคชพรอมต์ทำให้โมเดลสร้างคำตอบใหม่ตามคำขอปัจจุบัน
คำขอแรก: ส่งพรีฟิกซ์ขนาดใหญ่ที่ใช้ซ้ำได้และคำถามเฉพาะ
สร้างแคช: ผู้ให้บริการจัดเก็บสถานะการคำนวณระหว่างทางที่เข้าเกณฑ์
คำขอถัดไป: ใช้พรีฟิกซ์เดียวกันแล้วเปลี่ยนคำถาม
อ่านแคช: นำโทเค็นที่ประมวลผลไว้กลับมาใช้ ส่วนโทเค็นใหม่ประมวลผลตามปกติ
ภาพประกอบเชิงแนวคิดที่แนบมากับร่างต้นฉบับ: เนื้อหาพรอมต์ที่ซ้ำอยู่ก่อนคำถามที่เปลี่ยนไป ไม่ใช่ไดอะแกรมสถาปัตยกรรมของผู้ให้บริการอย่างเป็นทางการ
หลักการร่วมคือความคงที่ของพรีฟิกซ์ สัญญา API ตระกูลโมเดลที่เข้าเกณฑ์ อายุแคช และค่าธรรมเนียมไม่สามารถใช้แทนกันได้
OpenAI, Claude, and Gemini Caching at a Glance หลักการพรีฟิกซ์คงที่ใช้ร่วมกันระหว่างผู้ให้บริการ แต่ตัวควบคุมด้านล่างนี้เฉพาะสำหรับโมเดลที่ใช้ในคู่มือนี้ ตรวจสอบโมเดลและเอ็นด์พอยต์ร่วมกันก่อนคัดลอกการตั้งค่าใดๆ
Cache activation การจับคู่แบบโดยปริยาย; รองรับจุดแบ่งแคชแบบกำหนดชัดเจน เลือกใช้ด้วยระดับคำขอหรือ cache_control ระดับคอนเทนต์บล็อก การแคชโดยปริยายเปิดใช้ตามค่าเริ่มต้น Minimum prefix 1,024 โทเค็นอินพุตที่มองเห็นได้ 512 โทเค็นก่อนถึงขอบเขตแคช 4,096 โทเค็นอินพุต Lifetime controls Responses API: prompt_cache_options.ttl; ค่าเริ่มต้น 30m หรือ 12h ค่าเริ่มต้น 5 นาที; ตัวเลือก TTL 1 ชั่วโมง อายุการใช้งานที่ผู้ให้บริการจัดการโดยปริยาย Where to place stable content คำสั่งนำ เครื่องมือ และเอกสารอ้างอิงที่ส่วนต้น คำจำกัดความเครื่องมือคงที่ เนื้อหา system หรือบล็อกข้อความก่อนจุดแบ่งแคช เนื้อหาขนาดใหญ่ที่ใช้ร่วมกันไว้ที่ต้นพรอมต์ Usage to inspect input_tokens_details.cached_tokens และการรายงานการเขียนแคช cache_creation_input_tokens และ cache_read_input_tokens cached_content_token_count ใน usage_metadata เมื่อมี Important distinction prompt_cache_key แยกบัญชีการใช้งานได้; ไม่จำเป็นสำหรับการจัดเส้นทางอัตโนมัติของ Sol จุดแบ่งแคชต้องสิ้นสุดบนเนื้อหาที่ไม่เปลี่ยน ไม่มีทรัพยากรแคชแบบระบุชัดเจนสำหรับ Argon; โมเดลที่รองรับรุ่นก่อนอาจมีอินเทอร์เฟซแยก
Prompt Caching Controls and Python Examples แต่ละตัวอย่างส่งเนื้อหาอ้างอิงเดียวกันพร้อมสองคำถามที่ต่างกัน รักษาเนื้อหาที่ใช้ร่วมกันให้เหมือนเดิม รันคำขอต่อเนื่อง แล้วตรวจสอบการใช้งานเพื่อดูว่าคำขอที่สองใช้แคชอินพุตหรือไม่
OpenAI: Cache Controls and Python Example OpenAI จับคู่พรีฟิกซ์พรอมต์ที่เข้าเกณฑ์โดยอัตโนมัติ และบนโมเดลรุ่นใหม่ที่รองรับ อนุญาตให้กำหนดจุดแบ่งและการเก็บรักษาอย่างชัดเจน การใช้ซ้ำของแคชมีประโยชน์มากเมื่อมีคำสั่ง system ยาวๆ สคีมาของเครื่องมือ หรือบริบทจาก repository ที่เกิดซ้ำ ความยาวพรีฟิกซ์ที่ต้องการและตัวคูณราคาต่อโทเค็นขึ้นกับรุ่นของโมเดลและระดับการเก็บรักษาที่เลือก
ตัวอย่างนี้ใช้ Responses API โดยตั้งค่า prompt_cache_options เป็นโหมดโดยปริยายและอายุ 30 นาที รุ่นโมเดลเก่ากว้าใช้พารามิเตอร์การเก็บรักษาต่างกัน โปรดปฏิบัติตาม การตั้งค่าสำหรับโมเดลของคุณโดยเฉพาะ
ติดตั้ง openai SDK และตั้งค่า OPENAI_API_KEY ใช้พรีฟิกซ์ที่คงที่อย่างน้อย 1,024 โทเค็น รันทั้งสองคำขอต่อเนื่อง และตรวจสอบ input_tokens_details.cached_tokens และ cache_write_tokens ใน usage ค่าจำนวนโทเค็นที่แคชเป็นบวกยืนยันการอ่านแคชที่คิดค่าบริการ แต่มิได้การันตีเวลาแฝงที่ต่ำกว่าในทุกคำขอ
เพื่อรันตัวอย่าง ติดตั้ง Python SDK ที่เกี่ยวข้อง ตั้งค่าคีย์ API ของผู้ให้บริการ และสร้างไฟล์ reference.txt แบบ UTF-8 ที่มีเนื้อหาคงที่เพียงพอให้ถึงขั้นต่ำของโมเดลนั้น
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Cache Controls and Python Example ใน Claude Messages API การแคชพรอมต์เป็นแบบ opt-in เพิ่ม cache_control ที่ระดับคำขอเพื่อให้ระบบวางจุดแบ่งแคชอัตโนมัติ หรือแนบไปที่คอนเทนต์บล็อกเพื่อกำหนดจุดแบ่งอย่างชัดเจน นักพัฒนาสามารถกำหนดคำสั่งคงที่ เอกสาร และบล็อกพรอมต์ที่เลือก พร้อมกับเปลี่ยนอินพุตของผู้ใช้ที่ตามมา ค่าแคชมาตรฐานมีอายุ 5 นาที โดยมีตัวเลือก 1 ชั่วโมงสำหรับเวิร์กโหลดที่เหมาะสม
ติดตั้ง anthropic SDK และตั้งค่า ANTHROPIC_API_KEY สำหรับ Claude Opus 5.5 ให้มีอย่างน้อย 512 โทเค็นก่อนถึงขอบเขตแคช รักษาบล็อก system ให้เหมือนเดิมในทุกคำขอ รายการแคชจะพร้อมใช้งานเมื่อคำตอบแรกเริ่มออกมา; ตัวอย่างนี้รอคำตอบครบเพื่อให้การสาธิตเรียบง่าย ตรวจสอบจำนวนการสร้างแคชและการอ่านแคช พรีฟิกซ์สั้นอาจให้ค่าเป็นศูนย์ทั้งสองโดยไม่เกิดข้อผิดพลาด
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Implicit Caching and Python Example Google เรียกการใช้งานนี้ว่า context caching Gemini 4 Argon ใช้การแคชโดยปริยายและไม่รองรับทรัพยากรแคชแบบระบุชัดเจน บางตระกูลโมเดลรุ่นก่อนรองรับแคชแบบชัดเจนพร้อม TTL ที่กำหนดได้ เลือกอินเทอร์เฟซการแคชตามสัญญาของโมเดลแต่ละรุ่นแทนที่จะถือว่าโมเดล Gemini ทั้งหมดมีตัวควบคุมเดียวกัน
ติดตั้ง google-genai และตั้งค่า GEMINI_API_KEY ใช้คอนเทนต์ร่วมที่นำหน้าด้วยความยาวอย่างน้อย 4,096 โทเค็นสำหรับ Gemini 4 Argon และส่งคำขอที่สองภายหลังจากคำขอแรกในเวลาไม่นาน ตรวจสอบ cached_content_token_count ใน usage_metadata เมื่อมี การแคชโดยปริยายอาจพลาดแม้พรีฟิกซ์เข้าเกณฑ์
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
How Much Does Prompt Caching Cost Across OpenAI, Claude, and Gemini? ต้นทุนการแคชควรประเมินเป็นส่วนผสมของการเขียน การอ่าน และ—ในระบบแคชแบบชัดเจนบางระบบ—การเก็บรักษาหรือการจัดเก็บ ตัวคูณต่อไปนี้เป็นภาพรวมการออกแบบที่พบบ่อย ไม่ใช่คำสัญญาราคาแบบสากลข้ามรุ่นโมเดล
Uncached input อัตราโทเค็นอินพุตปกติ อัตราโทเค็นอินพุตปกติ อัตราโทเค็นอินพุตปกติ Cache write อาจมีค่าพรีเมียมสำหรับการเขียนในโมเดลรุ่นใหม่ ค่าพรีเมียม 5m/1h แบบโดยปริยายหรือขึ้นกับโมเดล Cache read อัตราลดลงขึ้นกับโมเดล อัตราลดลงขึ้นกับโมเดล อัตราลดลงขึ้นกับโมเดล Cache lifetime ขึ้นกับโมเดล 5 นาที / 1 ชั่วโมง จัดการโดยปริยาย / กำหนดได้อย่างชัดเจน Additional storage ขึ้นกับโมเดล มักสะท้อนในระดับการเขียน อาจมีค่าจัดเก็บอย่างชัดเจน
ตัวอย่างประกอบ: พรีฟิกซ์ 10,000 โทเค็นถูกใช้ซ้ำข้าม N คำขอ การเขียนแคชครั้งแรกมีค่า 1.25 เท่าของอินพุตปกติ และการอ่านแคชถัดไปมีค่า 0.1 เท่า สมมติราคาอินพุตพื้นฐาน $2 ต่อหนึ่งล้านโทเค็น และ cache hit สมบูรณ์หลังคำขอแรก
10 $0.200 $0.043 78.50% 100 $2.000 $0.223 88.85%
สูตร: ต้นทุนพรีฟิกซ์ที่แคช = 1.25P + (N − 1) × 0.1P โดย P คือค่าปกติของการประมวลผลพรีฟิกซ์ที่ใช้ร่วมกันหนึ่งครั้ง ตัวอย่างนี้ไม่นับอินพุตแบบไดนามิก เอาต์พุต การหมดอายุ การพลาด การจัดเก็บ และบริการอื่นๆ
ตัวอย่างข้างต้นใช้ค่าอ่าน 10% เพื่อประกอบ ไม่ใช่อัตราปัจจุบันของ GPT-6.1 Sol ราคามาตรฐานสำหรับบริบทสั้นของ Sol คือ $2 ต่อหนึ่งล้านโทเค็นอินพุตที่ไม่แคช $0.10 ต่อหนึ่งล้านโทเค็นอินพุตที่แคช และ $2.50 ต่อหนึ่งล้านโทเค็นที่เขียนด้วยอายุเริ่มต้น คำนวณใหม่โดยใช้อัตรา โมเดล ระดับ และบิลเอ็นด์พอยต์จริงของคุณ
การเพิ่มอายุยืนยาวคุ้มค่าเฉพาะเมื่อช่วยหลีกเลี่ยงการเขียนซ้ำหรืออินพุตที่ไม่แคชเพียงพอเพื่อชดเชยราคา Claude มีค่าเขียน 5 นาที และ 1 ชั่วโมง ที่คิด 1.25× และ 2× ของอินพุตพื้นฐานตามลำดับ แคชแบบชัดเจนของ Gemini ในโมเดลที่รองรับรุ่นก่อนอาจมีค่าจัดเก็บด้วย วัดการใช้งานซ้ำในช่วงเวลาว่างจริง ไม่ใช่แค่การเรียกต่อเนื่องติดๆ กัน
พิจารณาการพลาด การหมดอายุ และการสร้างเอาต์พุตเป็นส่วนหนึ่งของค่าใช้จ่าย หากพรีฟิกซ์หมดอายุก่อนใช้งานครั้งถัดไป คำขอถัดไปอาจต้องเขียนใหม่หรือประมวลผลอินพุตเต็ม พรอมต์สั้นอาจไม่เข้าเกณฑ์ ขณะที่คำตอบยาวอาจทำให้โทเค็นเอาต์พุตเป็นต้นทุนหลักแม้มีการใช้แคชมาก เปรียบเทียบต้นทุนรวมต่อภารกิจที่สำเร็จก่อนเพิ่มความซับซ้อนของการแคช
Which Prompt Caching API Is Best for Different Workloads? สำหรับเอเจนต์ด้านการเขียนโค้ดและงานสนับสนุนลูกค้า ให้วางคำจำกัดความเครื่องมือคงที่ บริบทของ repository นโยบาย และความรู้ไว้ก่อนงานที่เปลี่ยน OpenAI และ Claude มีจุดแบ่งที่ช่วยกำหนดขอบเขตที่ใช้ซ้ำ ตรวจสอบการอ่านแคชของเอ็นด์พอยต์จริงแทนการสมมติว่าข้อความที่ซ้ำจะถูกแคช
สำหรับการวิเคราะห์เอกสารและงานมัลติมีเดีย ให้วางเอกสารต้นทางหรือสื่อที่รองรับไว้ก่อนคำถาม การใช้แบบโดยปริยายของ Gemini ลดงานจัดการแคช ขณะที่ Claude ให้คุณมาร์กบล็อกคงที่ได้โดยตรง ตรวจสอบการรองรับชนิดสื่อและโมเดลเฉพาะก่อนพึ่งพาการใช้ซ้ำ
สำหรับการสนทนายาว ให้ต่อท้ายเทิร์นใหม่แทนที่จะเขียนส่วนต้นซ้ำทุกครั้ง และเลือกอายุการใช้งานที่มีให้ซึ่งเหมาะกับช่องว่างระหว่างเทิร์น หากแอปของคุณต้องการทรัพยากรแคชแบบมีชื่อที่สามารถสร้างและอ้างอิงได้โดยชัดเจน ให้ประเมินโมเดล Gemini ที่รองรับอินเทอร์เฟซนั้น; Argon ไม่รองรับ
ไม่มีผู้ชนะสากล: เปรียบเทียบอัตรา cache hit ต้นทุนต่อภารกิจที่สำเร็จ และเวลาแฝงภายใต้รูปแบบทราฟฟิกจริงของคุณ
การเกิด cache hit ลดการประมวลผลอินพุตซ้ำ และอาจทำให้เวลาถึงโทเค็นแรกสั้นลง แต่ไม่ได้ปรับปรุงคุณภาพคำตอบโดยเนื้อแท้หรือเร่งการสร้างเอาต์พุต และอินพุตที่แคชยังคงกินพื้นที่ในหน้าต่างบริบท วัดทั้งเวลาไปยังโทเค็นแรกและเวลาตอบสนองรวมบนคำขอที่เทียบเคียงกัน การเกิด cache hit เพียงอย่างเดียวไม่ใช่หลักฐานว่าผู้ใช้ได้รับคำตอบสุดท้ายเร็วขึ้น
How to Optimize Prompt Caching and Troubleshoot Misses
Start with a Stable, Useful Prefix วางคำสั่งที่ใช้ซ้ำ คำจำกัดความเครื่องมือ นโยบาย และเอกสารไว้ก่อน แล้วค่อยใส่ timestamp รหัสคำขอ บริบทที่เปลี่ยน และคำถามของผู้ใช้ในตอนหลัง รักษาลำดับและสคีมาของเครื่องมือให้คงที่ เมื่อใช้การแคชแบบชัดเจน ให้จบจุดแบ่งบนบล็อกสุดท้ายที่ไม่เปลี่ยน เพิ่มเอกสารอ้างอิงที่เป็นประโยชน์เมื่อช่วยงาน อย่าพองคำขอทุกครั้งเพียงเพื่อไล่ตัวชี้วัดแคช
If Cached Tokens Stay at Zero ตรวจสอบคุณสมบัติก่อนเปลี่ยนพรอมต์: ยืนยันโมเดล เอ็นด์พอยต์ ความยาวโทเค็นขั้นต่ำ และการตั้งค่า cache-control ที่ต้องการ จากนั้นส่งคำขอสองครั้งต่อเนื่องที่มีเนื้อหาคงที่เหมือนกัน ตรวจสอบการสร้างแคชและการอ่านแคชแยกกัน; คำขอแรกอาจสร้างรายการที่คำขอถัดไปจะใช้ การแคชโดยปริยายมีสิทธิ์เกิด hit แต่ไม่การันตี
สำหรับ Claude คำขอที่ต่ำกว่าขั้นต่ำอาจให้ค่าโทเค็นการสร้างและการอ่านแคชเป็นศูนย์โดยไม่เกิดข้อผิดพลาด รายการแคชพร้อมใช้งานเมื่อคำตอบแรกเริ่มออกมา คำแนะนำการแคชของ Claude ยังอธิบายว่าการวางจุดแบ่งและการเปลี่ยนการตั้งค่าคำขอมีผลต่อการใช้ซ้ำอย่างไร
If Hits Disappear Between Requests เปรียบเทียบเพย์โหลดจริง ไม่ใช่แค่เท็มเพลตพรอมต์ มองหาข้อความเอกสารที่เปลี่ยน ลำดับเครื่องมือที่สลับ สคีมาที่แก้ไข เทิร์นต้นของบทสนทนาที่เขียนใหม่ หรือฟิลด์แบบไดนามิกที่แทรกก่อนขอบเขตที่ใช้ซ้ำ ตรวจสอบเวลาที่ผ่านไปจากคำขอก่อนหน้าและว่าอายุที่เลือกครอบคลุมหรือไม่ เปลี่ยนทีละตัวแปรและบันทึกการใช้งานที่เกิดขึ้น
If Hits Do Not Produce Savings แยกอินพุตที่แคช การเขียน อินพุตที่ไม่แคช เอาต์พุต และค่าจัดเก็บใดๆ การเขียนซ้ำหลังช่วงว่าง การใช้ซ้ำต่ำ หรือคำตอบยาวอาจกลบส่วนลดอินพุต ใช้การคำนวณต้นทุนด้านบนพร้อมการใช้งานที่วัดได้และอัตราคิดจริงของเอ็นด์พอยต์ คงการเพิ่มประสิทธิภาพไว้เฉพาะเมื่อมันลดต้นทุนรวมต่อภารกิจหรือเวลาแฝงที่ผู้ใช้เห็น
Check Endpoint Support and Data Boundaries เอ็นด์พอยต์แบบความเข้ากันได้อาจยอมรับคำขอโดยไม่เปิดเผยตัวควบคุมแคชหรือฟิลด์การใช้งานเหมือน API ต้นทาง ยืนยันการรองรับพารามิเตอร์และเปรียบเทียบการใช้งานที่ส่งกลับกับบิลบัญชีก่อนจะถือว่าเป็นการประหยัด รักษาการแยกเช่าร่วมและการควบคุมการเข้าถึง และปฏิบัติตามนโยบายการเก็บรักษาและการประมวลผลข้อมูลของผู้ให้บริการ การแคชไม่ใช่ตัวแทนของการควบคุมเหล่านั้น
CometAPI มอบจุดบูรณาการเดียวสำหรับทดสอบคำขอข้ามตระกูลโมเดล สำหรับการแคช ให้ตรวจสอบว่าควบคุมเฉพาะผู้ให้บริการใดที่เอ็นด์พอยต์ที่เลือกยอมรับ และอินพุตที่แคชแสดงใน usage และการเรียกเก็บเงินอย่างไร นักพัฒนาสามารถรวมศูนย์การทดสอบโมเดลขณะยังคงการตรวจสอบแยกสำหรับพฤติกรรมการแคชและการบัญชี เนื่องจากตัวเลือกแบบ native ของผู้ให้บริการไม่การันตีว่าจะเหมือนกันข้ามพร็อกซีหรือเอ็นด์พอยต์ความเข้ากันได้
ติดตั้ง openai SDK และตั้งค่า COMETAPI_KEY ตัวอย่างนี้ส่งคำขอพรีฟิกซ์ซ้ำผ่านอินเทอร์เฟซ Chat Completions ที่เข้ากันได้กับ OpenAI ของ CometAPI ยืนยันความพร้อมของโมเดล แล้วตรวจสอบ usage ที่ส่งกลับและบิลบัญชีเพื่อหลักฐานการใช้แคช อย่าคัดลอกพารามิเตอร์การแคชของ Responses API ลงในเอ็นด์พอยต์นี้โดยไม่ตรวจสอบการรองรับ
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusion สำหรับแอป AI ที่มีภารกิจซ้ำสูง การแคชพรอมต์สามารถสร้างความแตกต่างอย่างมีนัยสำคัญต่อเศรษฐศาสตร์การ suyบผล OpenAI มอบตัวควบคุมพรอมต์และการเก็บรักษาที่ละเอียดมากขึ้น Claude ให้การควบคุมอัตโนมัติและระดับบล็อกที่สะดวก Gemini ทำให้การใช้ซ้ำแบบโดยปริยายเป็นเรื่องง่ายในโมเดลสมัยใหม่ การเลือกที่เหมาะขึ้นกับปริมาณพรอมต์คงที่ อัตรา hit การหมดอายุ และต้นทุนรวม เริ่มจากพรีฟิกซ์ร่วมที่ชัดเจน ตรวจสอบเทเลเมทรีการใช้งาน แล้วปรับการเก็บรักษาและผู้ให้บริการโดยใช้การวัดที่คล้ายสภาพโปรดักชัน
FAQ
How can I compare caching providers fairly? เล่นซ้ำเอกสารต้นทางที่มีประโยชน์และคำถามเทียบเท่ากัน แต่ใช้จำนวนโทเค็นและอัตราคิดค่าบริการจริงของแต่ละผู้ให้บริการ รักษาข้อกำหนดเอาต์พุตให้เทียบเคียง และรายงานคำขอที่ไม่สำเร็จเช่นเดียวกับที่สำเร็จ จำนวนตัวอักษรคงที่ไม่ได้หมายถึงจำนวนโทเค็นเท่ากัน ดังนั้นเปรียบเทียบต้นทุนต่อภารกิจที่สำเร็จควบคู่กับการวัด cache hit
Should I cache every document in a changing knowledge base? จัดกลุ่มเอกสารตามความถี่ที่เปลี่ยนและความถี่ที่ถูกใช้งานซ้ำ เอกสารที่อัปเดตบ่อยอาจทำให้พรีฟิกซ์ร่วมขนาดใหญ่ถูกทำให้ไม่ใช้ได้ซ้ำๆ; วางวัสดุนโยบายคงที่ไว้ก่อน และเนื้อหาที่เปลี่ยนไว้ภายหลังเพื่อลดความเสี่ยงนั้น กำหนดเวอร์ชันของต้นทางโดยเจตนาและรีเฟรชเมื่อความถูกต้องต้องการ แม้ว่าจะลดการใช้แคชก็ตาม