Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Mistral Large 3 คืออะไร? คำอธิบายเชิงลึก technology / งานวิจัย CometAPI
Mistral Large 3 คืออะไร? คำอธิบายเชิงลึก Mistral Large 3 เป็นตระกูลโมเดล “แนวหน้า” ล่าสุดที่ Mistral AI เปิดตัวในช่วงต้นเดือนธันวาคม 2025 เป็นโมเดลพื้นฐานแบบมัลติโมดัลที่มีน้ำหนักเปิด มุ่งเน้นการใช้งานในสภาพแวดล้อมการผลิต สร้างขึ้นโดยยึดการออกแบบ **Mixture-of-Experts (MoE) แบบสแปร์สที่มีความละเอียดสูง** และมุ่งหมายให้มอบการให้เหตุผลระดับ “แนวหน้า” ความเข้าใจบริบทยาว และความสามารถด้านภาพ + ข้อความ ในขณะเดียวกันก็ทำให้การอินเฟอร์เรนซ์ใช้งานได้จริงผ่านความสแปร์สและการควอนไทซ์สมัยใหม่ ระบุว่า Mistral Large 3 มี **พารามิเตอร์ทั้งหมด 675 พันล้าน** โดยมี **~41 พันล้านพารามิเตอร์ที่ใช้งานอยู่** ระหว่างอินเฟอร์เรนซ์ และหน้าต่างบริบท **256k โทเค็น** ในการตั้งค่าเริ่มต้น — การผสมผสานที่ออกแบบมาเพื่อผลักดันทั้งขีดความสามารถและสเกล โดยไม่บังคับให้การอินเฟอร์เรนซ์ทุกครั้งต้องแตะพารามิเตอร์ทั้งหมด
Anna ทีมวิจัยโมเดล AI และ API Mistral Large 3 เป็นตระกูลโมเดล “แนวหน้า” ล่าสุดที่ Mistral AI เปิดตัวในช่วงต้นเดือนธันวาคม 2025 เป็นโมเดลพื้นฐานแบบมัลติโมดัลที่มีน้ำหนักเปิด มุ่งเน้นการใช้งานในสภาพแวดล้อมการผลิต สร้างขึ้นโดยยึดการออกแบบ **Mixture-of-Experts (MoE) แบบสแปร์สที่มีความละเอียดสูง** และมุ่งหมายให้มอบการให้เหตุผลระดับ “แนวหน้า” ความเข้าใจบริบทยาว และความสามารถด้านภาพ + ข้อความ ในขณะเดียวกันก็ทำให้การอินเฟอร์เรนซ์ใช้งานได้จริงผ่านความสแปร์สและการควอนไทซ์สมัยใหม่ ระบุว่า Mistral Large 3 มี **พารามิเตอร์ทั้งหมด 675 พันล้าน** โดยมี **~41 พันล้านพารามิเตอร์ที่ใช้งานอยู่** ระหว่างอินเฟอร์เรนซ์ และหน้าต่างบริบท **256k โทเค็น** ในการตั้งค่าเริ่มต้น — การผสมผสานที่ออกแบบมาเพื่อผลักดันทั้งขีดความสามารถและสเกล โดยไม่บังคับให้การอินเฟอร์เรนซ์ทุกครั้งต้องแตะพารามิเตอร์ทั้งหมด
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)Mistral Large 3 เป็นตระกูลโมเดล “frontier” รุ่นใหม่ล่าสุดที่ Mistral AI เปิดตัวช่วงต้นเดือนธันวาคม 2025 เป็นโมเดลฐานแบบมัลติโมดัลที่เปิดน้ำหนัก มุ่งเน้นการใช้งานระดับผลิตจริง สร้างบนดีไซน์ granular sparse Mixture-of-Experts (MoE) และตั้งใจมอบความสามารถด้านการให้เหตุผลระดับ “frontier” การทำความเข้าใจบริบทยาว และความสามารถภาพ + ข้อความ โดยคงความเป็นไปได้เชิงปฏิบัติในการอนุมานผ่านความเบาบางและการควอนไทซ์สมัยใหม่ Mistral Large 3 ระบุว่ามี พารามิเตอร์ทั้งหมด 675 พันล้าน พร้อม พารามิเตอร์ที่ทำงานจริงประมาณ 41 พันล้าน ระหว่างการอนุมาน และหน้าต่างบริบท 256k โทเคน ในค่าเริ่มต้น — ชุดค่าผสมที่ออกแบบมาเพื่อผลักดันทั้งขีดความสามารถและสเกล โดยไม่บังคับให้การอนุมานทุกครั้งต้องใช้พารามิเตอร์ทั้งหมด
Mistral Large 3 คืออะไร? ทำงานอย่างไร?
Mistral Large 3 คืออะไร?
Mistral
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Dec 13, 2025 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
Large 3
ขนาดใหญ่ แบบเปิดน้ำหนัก มัลติโมดัล Mixture-of-Experts (MoE)
เบาบาง
Mistral Large 3 ถูกอธิบายว่ามี พารามิเตอร์ที่ทำงานจริงประมาณ 41 พันล้าน (พารามิเตอร์ที่มักจะถูกใช้ต่อโทเคน) และ พารามิเตอร์ทั้งหมด 675 พันล้าน ครอบคลุมผู้เชี่ยวชาญทั้งหมด — ดีไซน์แบบเบาบางแต่มหึมาที่ตั้งเป้าสมดุลระหว่างประสิทธิภาพการคำนวณและความจุของโมเดล โมเดลยังรองรับหน้าต่างบริบทที่ยาวมาก (อ้างอิงที่ 256k โทเคน ) และอินพุตแบบมัลติโมดัล (ข้อความ + ภาพ)
โดยสรุป: นี่คือโมเดล MoE ที่มีความจุรวมมหาศาล (เพื่อเก็บความเชี่ยวชาญที่หลากหลาย) แต่คำนวณเพียงส่วนย่อยที่เปิดใช้งานระหว่างอนุมาน — เพื่อมอบสมรรถนะระดับแนวหน้าอย่างมีประสิทธิภาพมากกว่าโมเดลหนาแน่นขนาดใกล้เคียงกัน
สถาปัตยกรรมหลัก: Granular Mixture-of-Experts (MoE) ในภาพรวม Mistral Large 3 แทนที่บางส่วน (หรือหลายส่วน) ของซับเลเยอร์ feed-forward ในทรานส์ฟอร์เมอร์ด้วย เลเยอร์ MoE โดยแต่ละเลเยอร์ MoE ประกอบด้วย:
ผู้เชี่ยวชาญจำนวนมาก — เครือข่ายย่อยอิสระ (ปกติคือบล็อก FFN) โดยรวมกันทำให้เกิดจำนวนพารามิเตอร์รวมของโมเดลที่ใหญ่มาก (เช่น หลายร้อยพันล้าน) ตัวจัดเส้นทาง/เครือข่ายกำกับการเลือก (router/gating) — เครือข่ายขนาดเล็กที่ดูตัวแทนของโทเคนเพื่อตัดสินใจว่า ผู้เชี่ยวชาญคนใด ควรประมวลผลโทเคนนั้น Router ของ MoE สมัยใหม่มักเลือกเฉพาะผู้เชี่ยวชาญอันดับต้นๆ (การกำกับแบบเบาบาง) โดยทั่วไป k=1 หรือ k=2 เพื่อคงการคำนวณให้ต่ำ การเปิดใช้งานแบบเบาบาง — สำหรับโทเคนใดๆ จะรันเฉพาะผู้เชี่ยวชาญที่ถูกเลือก ส่วนที่เหลือถูกข้าม นี่คือแหล่งประสิทธิภาพ: พารามิเตอร์ที่เก็บทั้งหมด >> พารามิเตอร์ที่คำนวณต่อโทเคน Mistral เรียกดีไซน์นี้ว่า MoE แบบละเอียด (granular) เพื่อเน้นว่ามีผู้เชี่ยวชาญขนาดเล็ก/เฉพาะทางจำนวนมากและโครงร่างการจัดเส้นทางที่ปรับให้เหมาะกับการสเกลข้าม GPU จำนวนมากและบริบทยาว ผลลัพธ์คือ: ความสามารถในการแทนเชิงสัญลักษณ์ที่ใหญ่มาก โดยคงการคำนวณต่อโทเคนใกล้เคียงกับโมเดลหนาแน่นที่เล็กกว่ามาก, จำนวนพารามิเตอร์ทั้งหมด:
พารามิเตอร์ทั้งหมด: 675 พันล้าน; ผลรวมของพารามิเตอร์ทั้งหมดที่เก็บไว้ในผู้เชี่ยวชาญทุกตัวและส่วนอื่นๆ ของทรานส์ฟอร์เมอร์ ตัวเลขนี้บ่งชี้ความจุโดยรวมของโมเดล (ความรู้และความเชี่ยวชาญที่สามารถบรรจุได้)
พารามิเตอร์ที่ทำงานจริง: 41 พันล้าน คือส่วนของพารามิเตอร์ที่ถูกใช้/คำนวณจริงใน forward pass ทั่วไป เนื่องจาก router เปิดใช้งานเพียงผู้เชี่ยวชาญไม่กี่ตัวต่อโทเคน นี่คือเมตริกที่สัมพันธ์ใกล้ชิดกับการคำนวณและการใช้หน่วยความจำระหว่างอนุมานต่อคำขอ เอกสารสาธารณะของ Mistral ระบุประมาณ ~41B พารามิเตอร์ที่ทำงานจริง; บางหน้าของโมเดลแสดงจำนวนต่างไปเล็กน้อยตามตัวแปรย่อยเฉพาะ (เช่น 39B) — อาจสะท้อนรุ่น instruct หรือการปัดเศษ
การตั้งค่าการฝึกสอน:
ฝึกจากศูนย์ด้วย NVIDIA H200 จำนวน 3000 ตัว;
ข้อมูลครอบคลุมหลายภาษา หลายงาน และหลายโมดัล;
รองรับอินพุตภาพและอนุมานข้ามภาษา
ตารางคุณสมบัติของ Mistral Large 3 Multimodal Understanding รองรับอินพุตภาพและการวิเคราะห์ ช่วยให้เข้าใจเนื้อหาภาพระหว่างการสนทนาได้ Multilingual Support รองรับหลายภาษาโดยกำเนิด 10+ ภาษา (อังกฤษ ฝรั่งเศส สเปน เยอรมัน อิตาลี โปรตุเกส ดัตช์ จีน ญี่ปุ่น เกาหลี อาหรับ เป็นต้น) System Prompt Support ยึดตามคำสั่งระบบและพรอมต์ตามบริบทได้อย่างสม่ำเสมอ เหมาะสำหรับเวิร์กโฟลว์ที่ซับซ้อน Agent Capabilities รองรับการเรียกฟังก์ชันแบบเนทีฟและเอาต์พุต JSON แบบมีโครงสร้าง ช่วยให้เรียกใช้เครื่องมือหรือเชื่อมต่อระบบภายนอกได้โดยตรง Context Window รองรับหน้าต่างบริบทยาวพิเศษ 256K โทเคน ซึ่งยาวที่สุดในบรรดาโมเดลโอเพนซอร์ส Performance Positioning สมรรถนะระดับผลิตจริง พร้อมความเข้าใจบริบทยาวที่แข็งแรงและเอาต์พุตที่นิ่ง Open-source License สัญญาอนุญาต Apache 2.0 ใช้เชิงพาณิชย์และดัดแปลงได้อย่างอิสระ
สมรรถนะเทียบเคียงโมเดลปิดที่ใช้กันทั่วไป;
โดดเด่นในงานหลายภาษา (โดยเฉพาะในบริบทที่ไม่ใช่ภาษาอังกฤษและภาษาจีน);
มีความสามารถด้านการเข้าใจภาพและการทำตามคำสั่ง;
มีรุ่นพื้นฐาน (Base) และรุ่นปรับจูนตามคำสั่ง (Instruct) โดยรุ่นปรับอนุมาน (Reasoning) จะตามมาเร็วๆ นี้
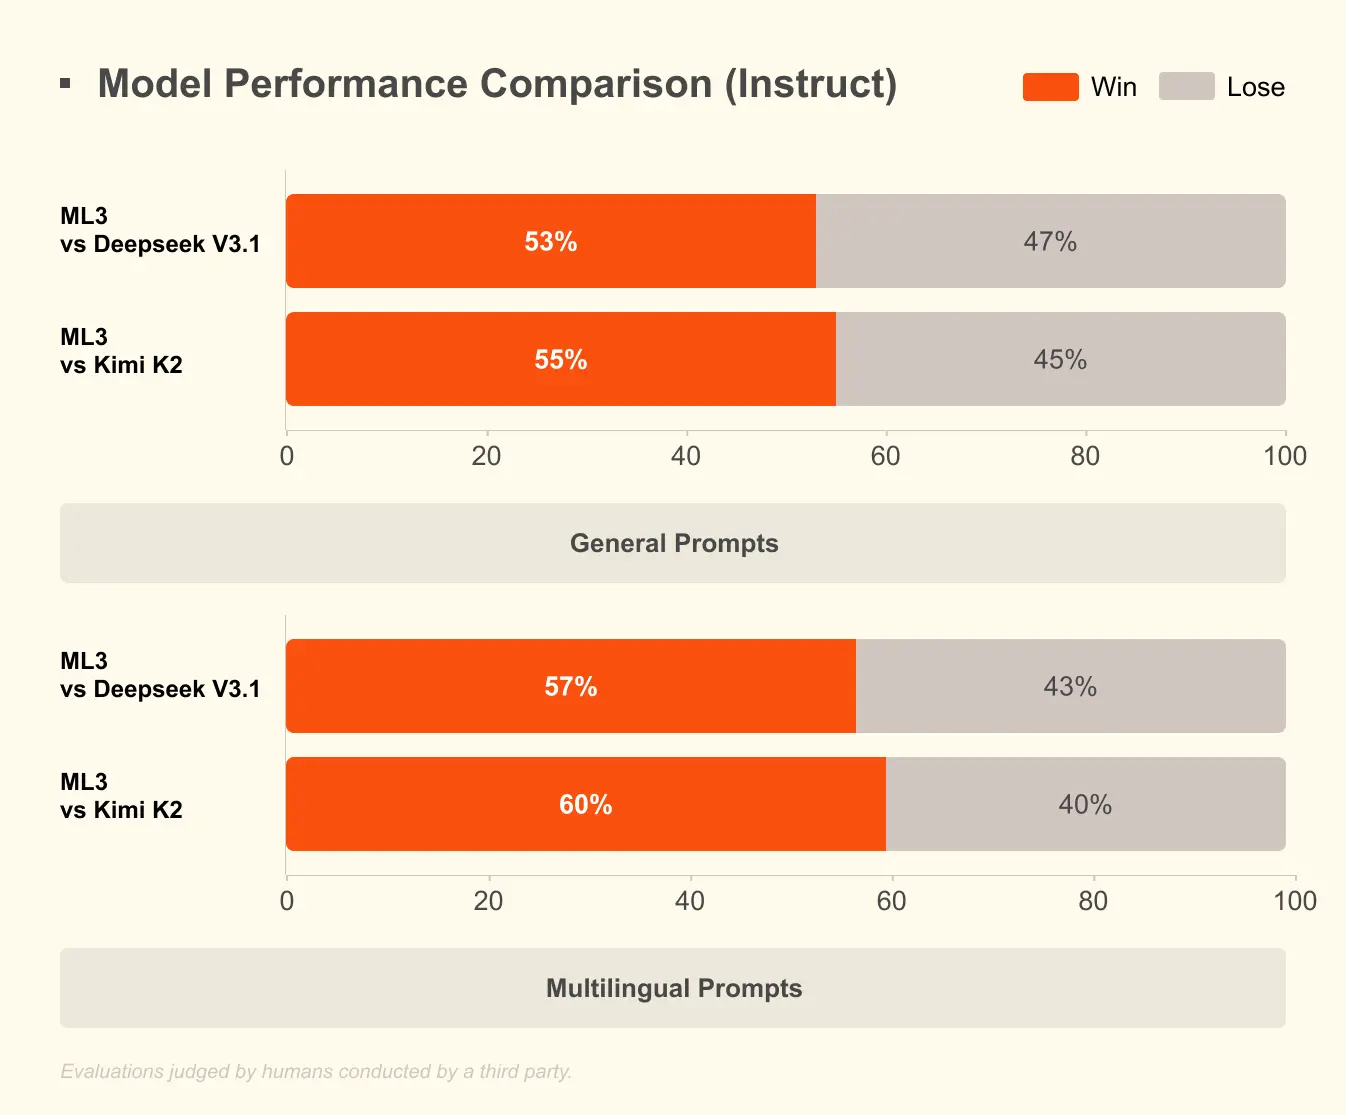
Mistral Large 3 ทำผลงานในเบนช์มาร์กอย่างไร? เบนช์มาร์กและลีดเดอร์บอร์ดสาธารณะช่วงแรกแสดงให้เห็นว่า Mistral Large 3 อยู่ในอันดับสูงในบรรดาโมเดลโอเพนซอร์ส: อันดับ LMArena #2 ในกลุ่ม OSS non-reasoning และถูกกล่าวถึงในตำแหน่งท็อปของลีดเดอร์บอร์ดในงานมาตรฐานหลากหลาย (เช่น GPQA, MMLU และชุดงานให้เหตุผล/ความรู้ทั่วไปอื่นๆ)
![Mistral Large 3 เป็นตระกูลโมเดล “frontier” รุ่นใหม่ล่าสุดที่ Mistral AI เปิดตัวช่วงต้นเดือนธันวาคม 2025 เป็นโมเดลฐานแบบมัลติโมดัลที่เปิดน้ำหนัก มุ่งเน้นการใช้งานระดับผลิตจริง สร้างบนดีไซน์ granular sparse Mixture-of-Experts (MoE) และตั้งใจมอบความสามารถด้านการให้เหตุผลระดับ “frontier” การทำความเข้าใจบริบทยาว และความสามารถภาพ + ข้อความ โดยคงความเป็นไปได้เชิงปฏิบัติในการอนุมานผ่านความเบาบางและการควอนไทซ์สมัยใหม่ Mistral Large 3 ระบุว่ามี พารามิเตอร์ทั้งหมด 675 พันล้าน พร้อม พารามิเตอร์ที่ทำงานจริงประมาณ 41 พันล้าน ระหว่างการอนุมาน และหน้าต่างบริบท 256k โทเคน ในค่าเริ่มต้น — ชุดค่าผสมที่ออกแบบมาเพื่อผลักดันทั้งขีดความสามารถและสเกล โดยไม่บังคับให้การอนุมานทุกครั้งต้องใช้พารามิเตอร์ทั้งหมด
Mistral Large 3 คืออะไร? ทำงานอย่างไร?
Mistral Large 3 คืออะไร? Mistral Large 3 เป็นโมเดลแนวหน้าหลักของ Mistral AI ในตระกูล Mistral 3 — โมเดล ขนาดใหญ่ แบบเปิดน้ำหนัก มัลติโมดัล Mixture-of-Experts (MoE) เผยแพร่ภายใต้สัญญาอนุญาต Apache-2.0 ออกแบบมาเพื่อมอบขีดความสามารถระดับ “frontier” (การให้เหตุผล การเขียนโค้ด การทำความเข้าใจบริบทยาว งานมัลติโมดัล) พร้อมคงการคำนวณระหว่างอนุมานให้ เบาบาง ด้วยการเปิดใช้งานเพียงบางส่วนของผู้เชี่ยวชาญของโมเดลสำหรับแต่ละโทเคน
Mistral Large 3 ใช้แนวทาง Mixture-of-Experts (MoE) : แทนที่จะเปิดใช้งานพารามิเตอร์ทั้งหมดสำหรับแต่ละโทเคน โมเดลจะจัดเส้นทางการประมวลผลโทเคนไปยังเครือข่ายย่อยของผู้เชี่ยวชาญบางส่วน จำนวนที่เผยแพร่สำหรับ Large 3 อยู่ที่ประมาณ พารามิเตอร์ที่ทำงานจริง 41 พันล้าน (พารามิเตอร์ที่มักมีส่วนร่วมต่อโทเคน) และ พารามิเตอร์ทั้งหมด 675 พันล้าน ครอบคลุมผู้เชี่ยวชาญทั้งหมด — ดีไซน์แบบเบาบางแต่มหึมาที่ตั้งเป้าจุดลงตัวระหว่างประสิทธิภาพการคำนวณและความจุของโมเดล โมเดลยังรองรับหน้าต่างบริบทยาวมาก (ระบุไว้ที่ 256k โทเคน ) และอินพุตแบบมัลติโมดัล (ข้อความ + ภาพ)
โดยสรุป: นี่คือโมเดล MoE ที่มีความจุรวมมหาศาล (เพื่อเก็บความเชี่ยวชาญที่หลากหลาย) แต่คำนวณเพียงส่วนย่อยที่เปิดใช้งานระหว่างอนุมาน — เพื่อมอบสมรรถนะระดับแนวหน้าอย่างมีประสิทธิภาพมากกว่าโมเดลหนาแน่นขนาดใกล้เคียงกัน
สถาปัตยกรรมหลัก: Granular Mixture-of-Experts (MoE) ในภาพรวม Mistral Large 3 แทนที่บางส่วน (หรือหลายส่วน) ของซับเลเยอร์ feed-forward ในทรานส์ฟอร์เมอร์ด้วย เลเยอร์ MoE โดยแต่ละเลเยอร์ MoE ประกอบด้วย:
ผู้เชี่ยวชาญจำนวนมาก — เครือข่ายย่อยอิสระ (ปกติคือบล็อก FFN) โดยรวมกันทำให้เกิดจำนวนพารามิเตอร์รวมของโมเดลที่ใหญ่มาก (เช่น หลายร้อยพันล้าน) ตัวจัดเส้นทาง/เครือข่ายกำกับการเลือก (router/gating) — เครือข่ายขนาดเล็กที่ดูตัวแทนของโทเคนเพื่อตัดสินใจว่า ผู้เชี่ยวชาญคนใด ควรประมวลผลโทเคนนั้น Router ของ MoE สมัยใหม่มักเลือกเฉพาะผู้เชี่ยวชาญอันดับต้นๆ (การกำกับแบบเบาบาง) โดยทั่วไป k=1 หรือ k=2 เพื่อคงการคำนวณให้ต่ำ การเปิดใช้งานแบบเบาบาง — สำหรับโทเคนใดๆ จะรันเฉพาะผู้เชี่ยวชาญที่ถูกเลือก ส่วนที่เหลือถูกข้าม นี่คือแหล่งประสิทธิภาพ: พารามิเตอร์ที่เก็บทั้งหมด >> พารามิเตอร์ที่คำนวณต่อโทเคน Mistral เรียกดีไซน์นี้ว่า MoE แบบละเอียด (granular) เพื่อเน้นว่ามีผู้เชี่ยวชาญขนาดเล็ก/เฉพาะทางจำนวนมากและโครงร่างการจัดเส้นทางที่ปรับให้เหมาะกับการสเกลข้าม GPU จำนวนมากและบริบทยาว ผลลัพธ์คือ: ความสามารถในการแทนเชิงสัญลักษณ์ที่ใหญ่มาก โดยคงการคำนวณต่อโทเคนใกล้เคียงกับโมเดลหนาแน่นที่เล็กกว่ามาก, จำนวนพารามิเตอร์ทั้งหมด:
พารามิเตอร์ทั้งหมด: 675 พันล้าน; ผลรวมของพารามิเตอร์ทั้งหมดที่เก็บไว้ในผู้เชี่ยวชาญทุกตัวและส่วนอื่นๆ ของทรานส์ฟอร์เมอร์ ตัวเลขนี้บ่งชี้ความจุโดยรวมของโมเดล (ความรู้และความเชี่ยวชาญที่สามารถบรรจุได้)
พารามิเตอร์ที่ทำงานจริง: 41 พันล้าน คือส่วนของพารามิเตอร์ที่ถูกใช้/คำนวณจริงใน forward pass ทั่วไป เนื่องจาก router เปิดใช้งานเพียงผู้เชี่ยวชาญไม่กี่ตัวต่อโทเคน นี่คือเมตริกที่สัมพันธ์ใกล้ชิดกับการคำนวณและการใช้หน่วยความจำระหว่างอนุมานต่อคำขอ เอกสารสาธารณะของ Mistral ระบุประมาณ ~41B พารามิเตอร์ที่ทำงานจริง; บางหน้าของโมเดลแสดงจำนวนต่างไปเล็กน้อยตามตัวแปรย่อยเฉพาะ (เช่น 39B) — อาจสะท้อนรุ่น instruct หรือการปัดเศษ
การตั้งค่าการฝึกสอน:
ฝึกจากศูนย์ด้วย NVIDIA H200 จำนวน 3000 ตัว;
ข้อมูลครอบคลุมหลายภาษา หลายงาน และหลายโมดัล;
รองรับอินพุตภาพและอนุมานข้ามภาษา]()
![Mistral Large 3 เป็นตระกูลโมเดล “frontier” รุ่นใหม่ล่าสุดที่ Mistral AI เปิดตัวช่วงต้นเดือนธันวาคม 2025 เป็นโมเดลฐานแบบมัลติโมดัลที่เปิดน้ำหนัก มุ่งเน้นการใช้งานระดับผลิตจริง สร้างบนดีไซน์ granular sparse Mixture-of-Experts (MoE) และตั้งใจมอบความสามารถด้านการให้เหตุผลระดับ “frontier” การทำความเข้าใจบริบทยาว และความสามารถภาพ + ข้อความ โดยคงความเป็นไปได้เชิงปฏิบัติในการอนุมานผ่านความเบาบางและการควอนไทซ์สมัยใหม่ Mistral Large 3 ระบุว่ามี พารามิเตอร์ทั้งหมด 675 พันล้าน พร้อม พารามิเตอร์ที่ทำงานจริงประมาณ 41 พันล้าน ระหว่างการอนุมาน และหน้าต่างบริบท 256k โทเคน ในค่าเริ่มต้น — ชุดค่าผสมที่ออกแบบมาเพื่อผลักดันทั้งขีดความสามารถและสเกล โดยไม่บังคับให้การอนุมานทุกครั้งต้องใช้พารามิเตอร์ทั้งหมด
Mistral Large 3 คืออะไร? ทำงานอย่างไร?
Mistral Large 3 คืออะไร? Mistral Large 3 เป็นโมเดลแนวหน้าหลักของ Mistral AI ในตระกูล Mistral 3 — โมเดล ขนาดใหญ่ แบบเปิดน้ำหนัก มัลติโมดัล Mixture-of-Experts (MoE) เผยแพร่ภายใต้สัญญาอนุญาต Apache-2.0 ออกแบบมาเพื่อมอบขีดความสามารถระดับ “frontier” (การให้เหตุผล การเขียนโค้ด การทำความเข้าใจบริบทยาว งานมัลติโมดัล) พร้อมคงการคำนวณระหว่างอนุมานให้ เบาบาง ด้วยการเปิดใช้งานเพียงบางส่วนของผู้เชี่ยวชาญของโมเดลสำหรับแต่ละโทเคน
Mistral Large 3 ใช้แนวทาง Mixture-of-Experts (MoE) : แทนที่จะเปิดใช้งานพารามิเตอร์ทั้งหมดสำหรับแต่ละโทเคน โมเดลจะจัดเส้นทางการประมวลผลโทเคนไปยังเครือข่ายย่อยของผู้เชี่ยวชาญบางส่วน จำนวนที่เผยแพร่สำหรับ Large 3 อยู่ที่ประมาณ พารามิเตอร์ที่ทำงานจริง 41 พันล้าน (พารามิเตอร์ที่มักมีส่วนร่วมต่อโทเคน) และ พารามิเตอร์ทั้งหมด 675 พันล้าน ครอบคลุมผู้เชี่ยวชาญทั้งหมด — ดีไซน์แบบเบาบางแต่มหึมาที่ตั้งเป้าจุดลงตัวระหว่างประสิทธิภาพการคำนวณและความจุของโมเดล โมเดลยังรองรับหน้าต่างบริบทยาวมาก (ระบุไว้ที่ 256k โทเคน ) และอินพุตแบบมัลติโมดัล (ข้อความ + ภาพ)
โดยสรุป: นี่คือโมเดล MoE ที่มีความจุรวมมหาศาล (เพื่อเก็บความเชี่ยวชาญที่หลากหลาย) แต่คำนวณเพียงส่วนย่อยที่เปิดใช้งานระหว่างอนุมาน — เพื่อมอบสมรรถนะระดับแนวหน้าอย่างมีประสิทธิภาพมากกว่าโมเดลหนาแน่นขนาดใกล้เคียงกัน
สถาปัตยกรรมหลัก: Granular Mixture-of-Experts (MoE) ในภาพรวม Mistral Large 3 แทนที่บางส่วน (หรือหลายส่วน) ของซับเลเยอร์ feed-forward ในทรานส์ฟอร์เมอร์ด้วย เลเยอร์ MoE โดยแต่ละเลเยอร์ MoE ประกอบด้วย:
ผู้เชี่ยวชาญจำนวนมาก — เครือข่ายย่อยอิสระ (ปกติคือบล็อก FFN) โดยรวมกันทำให้เกิดจำนวนพารามิเตอร์รวมของโมเดลที่ใหญ่มาก (เช่น หลายร้อยพันล้าน) ตัวจัดเส้นทาง/เครือข่ายกำกับการเลือก (router/gating) — เครือข่ายขนาดเล็กที่ดูตัวแทนของโทเคนเพื่อตัดสินใจว่า ผู้เชี่ยวชาญคนใด ควรประมวลผลโทเคนนั้น Router ของ MoE สมัยใหม่มักเลือกเฉพาะผู้เชี่ยวชาญอันดับต้นๆ (การกำกับแบบเบาบาง) โดยทั่วไป k=1 หรือ k=2 เพื่อคงการคำนวณให้ต่ำ การเปิดใช้งานแบบเบาบาง — สำหรับโทเคนใดๆ จะรันเฉพาะผู้เชี่ยวชาญที่ถูกเลือก ส่วนที่เหลือถูกข้าม นี่คือแหล่งประสิทธิภาพ: พารามิเตอร์ที่เก็บทั้งหมด >> พารามิเตอร์ที่คำนวณต่อโทเคน Mistral เรียกดีไซน์นี้ว่า MoE แบบละเอียด (granular) เพื่อเน้นว่ามีผู้เชี่ยวชาญขนาดเล็ก/เฉพาะทางจำนวนมากและโครงร่างการจัดเส้นทางที่ปรับให้เหมาะกับการสเกลข้าม GPU จำนวนมากและบริบทยาว ผลลัพธ์คือ: ความสามารถในการแทนเชิงสัญลักษณ์ที่ใหญ่มาก โดยคงการคำนวณต่อโทเคนใกล้เคียงกับโมเดลหนาแน่นที่เล็กกว่ามาก, จำนวนพารามิเตอร์ทั้งหมด:
พารามิเตอร์ทั้งหมด: 675 พันล้าน; ผลรวมของพารามิเตอร์ทั้งหมดที่เก็บไว้ในผู้เชี่ยวชาญทุกตัวและส่วนอื่นๆ ของทรานส์ฟอร์เมอร์ ตัวเลขนี้บ่งชี้ความจุโดยรวมของโมเดล (ความรู้และความเชี่ยวชาญที่สามารถบรรจุได้)
พารามิเตอร์ที่ทำงานจริง: 41 พันล้าน คือส่วนของพารามิเตอร์ที่ถูกใช้/คำนวณจริงใน forward pass ทั่วไป เนื่องจาก router เปิดใช้งานเพียงผู้เชี่ยวชาญไม่กี่ตัวต่อโทเคน นี่คือเมตริกที่สัมพันธ์ใกล้ชิดกับการคำนวณและการใช้หน่วยความจำระหว่างอนุมานต่อคำขอ เอกสารสาธารณะของ Mistral ระบุประมาณ ~41B พารามิเตอร์ที่ทำงานจริง; บางหน้าของโมเดลแสดงจำนวนต่างไปเล็กน้อยตามตัวแปรย่อยเฉพาะ (เช่น 39B) — อาจสะท้อนรุ่น instruct หรือการปัดเศษ
การตั้งค่าการฝึกสอน:
ฝึกจากศูนย์ด้วย NVIDIA H200 จำนวน 3000 ตัว;
ข้อมูลครอบคลุมหลายภาษา หลายงาน และหลายโมดัล;
รองรับอินพุตภาพและอนุมานข้ามภาษา]()
จุดแข็งที่แสดงให้เห็นจนถึงตอนนี้
การทำความเข้าใจเอกสารยาวและงานที่เสริมด้วยการดึงข้อมูล (RAG): การผสมผสานระหว่างบริบทยาวและความจุแบบเบาบางช่วยให้ Mistral Large 3 ได้เปรียบในงานบริบทยาว (ถามตอบเอกสาร สรุปเอกสารขนาดใหญ่)ความรู้ทั่วไปและการทำตามคำสั่ง: ในรุ่นที่ปรับจูนตามคำสั่ง Mistral Large 3 แข็งแกร่งในงาน “ผู้ช่วยทั่วไป” และการยึดตามคำสั่งระบบ พลังงานและอัตราส่งผ่าน (บนฮาร์ดแวร์ที่ปรับแต่ง): การวิเคราะห์ของ NVIDIA แสดงประสิทธิภาพพลังงานและอัตราส่งผ่านที่น่าประทับใจเมื่อรัน Mistral Large 3 บน GB200 NVL72 ด้วยการปรับแต่งเฉพาะ MoE — ตัวเลขที่แปลงตรงเป็นต้นทุนต่อโทเคนและความสามารถในการสเกลสำหรับองค์กร
เข้าถึงและใช้งาน Mistral Large 3 ได้อย่างไร?
การเข้าถึงผ่านคลาวด์แบบโฮสต์ (ทางลัด) Mistral Large 3 มีให้ใช้งานผ่านพาร์ตเนอร์คลาวด์และแพลตฟอร์มหลายราย:
Hugging Face โฮสต์การ์ดโมเดลและอาร์ติแฟกต์สำหรับอนุมาน (บันเดิลโมเดลรวมรุ่น instruct และอาร์ติแฟกต์ NVFP4 ที่ปรับแต่ง) คุณสามารถเรียกโมเดลผ่าน Hugging Face Inference API หรือดาวน์โหลดอาร์ติแฟกต์ที่เข้ากันได้Azure / Microsoft Foundry ประกาศความพร้อมใช้งานของ Mistral Large 3 สำหรับเวิร์กโหลดระดับองค์กร NVIDIA เผยแพร่รันไทม์เร่งความเร็วและบันทึกการปรับจูนสำหรับตระกูล GB200/H200 และพาร์ตเนอร์อย่าง Red Hat เผยแพร่คำแนะนำ vLLM เส้นทางแบบโฮสต์ช่วยให้เริ่มต้นได้เร็วโดยไม่ต้องจัดการวิศวกรรมรันไทม์ MoE
รันแบบโลคัลหรือบนโครงสร้างพื้นฐานของคุณ (ขั้นสูง) การรัน Mistral Large 3 แบบโลคัลหรือบนโครงสร้างพื้นฐานส่วนตัวเป็นไปได้แต่มีความซับซ้อน:
อาร์ติแฟกต์ Hugging Face + accelerate/transformers — ใช้ได้กับรุ่นที่เล็กลงหรือหากคุณมีฟาร์ม GPU และเครื่องมือ sharding ที่เหมาะสม การ์ดโมเดลระบุข้อจำกัดตามแพลตฟอร์มและฟอร์แมตที่แนะนำ (เช่น NVFP4) vLLM — เซิร์ฟเวอร์อนุมานที่ปรับให้เหมาะกับ LLM ขนาดใหญ่และบริบทยาว; Red Hat และพาร์ตเนอร์รายอื่นเผยแพร่คู่มือรัน Mistral Large 3 บน vLLM เพื่อให้ได้อัตราส่งผ่านและความหน่วงที่มีประสิทธิภาพ สแตกเฉพาะทาง (NVIDIA Triton / NVL72 / เคอร์เนลกำหนดเอง) — จำเป็นสำหรับความหน่วงต่ำ/ประสิทธิภาพสูงสุดในสเกลใหญ่; NVIDIA เผยบล็อกเกี่ยวกับการเร่ง Mistral 3 ด้วย GB200/H200 และรันไทม์ NVL72 Ollama / ตัวจัดการ VM โลคัล — ชุมชนมีคู่มือการตั้งค่าโลคัล (Ollama, Docker) สำหรับทดลองใช้งาน; คาดการณ์การใช้ RAM/GPU ขนาดใหญ่และความจำเป็นในการใช้รุ่นย่อยหรือเช็คพอยต์ที่ควอนไทซ์
ตัวอย่าง: อนุมานผ่าน Hugging Face (python) # Example: call Mistral Large 3 via Hugging Face Inference APIimport requests, json, osHF_API_KEY = os.environ.get("HF_API_KEY")MODEL = "mistralai/Mistral-Large-3-675B-Instruct-2512"headers = {"Authorization": f"Bearer {HF_API_KEY}", "Content-Type": "application/json"}payload = { "inputs": "Summarize the following document in 3 bullet points: <paste your long text here>", "parameters": {"max_new_tokens": 256, "temperature": 0.0}}r = requests.post(f"https://api-inference.huggingface.co/models/{MODEL}", headers=headers, data=json.dumps(payload))print(r.json())
หมายเหตุ: สำหรับบริบทที่ยาวมาก (หลายหมื่นโทเคน) โปรดตรวจสอบคำแนะนำด้านสตรีมมิง/การแบ่งส่วนของผู้ให้บริการและความยาวบริบทที่รองรับของรุ่นโมเดลนั้นๆ
ตัวอย่าง: เริ่มเซิร์ฟเวอร์ vLLM (เชิงแนวคิด) vLLM เป็นเซิร์ฟเวอร์อนุมานประสิทธิภาพสูงที่องค์กรใช้งาน ด้านล่างเป็นตัวอย่างเชิงแนวคิด (ตรวจสอบเอกสาร vLLM สำหรับแฟล็ก เส้นทางโมเดล และการรองรับ MoE):
# conceptual example — adjust to your environment and model pathvllm --model-path /models/mistral-large-3-instruct \ --num-gpus 4 \ --max-batch-size 8 \ --max-seq-len 65536 \ --log-level info
จากนั้นใช้ไคลเอนต์ Python ของ vLLM หรือ HTTP API เพื่อส่งคำขอ สำหรับโมเดล MoE ต้องแน่ใจว่า build และรันไทม์ของ vLLM รองรับเคอร์เนลผู้เชี่ยวชาญแบบเบาบางและฟอร์แมตเช็คพอยต์ของโมเดล (NVFP4/FP8/BF16)
แนวทางปฏิบัติที่แนะนำสำหรับการปรับใช้ Mistral Large 3
เลือกรุ่นและความละเอียดตัวเลขให้เหมาะสม
เริ่มจากเช็คพอยต์ที่ปรับจูนตามคำสั่ง สำหรับเวิร์กโฟลว์ผู้ช่วย (ตระกูลโมเดลมีรุ่น Instruct) ใช้รุ่นฐานเมื่อคุณวางแผนจะปรับจูนเองหรือทำการปรับจูนตามคำสั่งของคุณเอง ใช้รุ่นความละเอียดต่ำที่ปรับแต่ง (NVFP4, FP8, BF16) เมื่อพร้อมสำหรับฮาร์ดแวร์ของคุณ; ทางนี้ให้ประสิทธิภาพมหาศาลโดยคุณภาพลดลงเพียงเล็กน้อย หากเช็คพอยต์ถูกผลิตและตรวจสอบโดยผู้พัฒนาโมเดล
หน่วยความจำ การแบ่งชิ้นส่วน และฮาร์ดแวร์
อย่าคาดหวังว่าจะรันเช็คพอยต์ 675B พารามิเตอร์ทั้งหมดบน GPU สินค้าทั่วไปตัวเดียว — แม้มีเพียง ~41B ที่ทำงานต่อโทเคน เช็คพอยต์เต็มมีขนาดมหึมาและต้องใช้ยุทธศาสตร์ sharding พร้อมตัวเร่งที่มีหน่วยความจำสูง (ตระกูล GB200/H200) หรือการจัดสรรงานร่วม CPU+GPU ใช้การขนานโมเดล + การวางตำแหน่งผู้เชี่ยวชาญ : โมเดล MoE ได้ประโยชน์จากการวางผู้เชี่ยวชาญข้ามอุปกรณ์เพื่อสมดุลทราฟฟิกการจัดเส้นทาง ทำตามคำแนะนำของผู้พัฒนาเกี่ยวกับการจัดวางผู้เชี่ยวชาญ
วิศวกรรมสำหรับบริบทยาว
แบ่งส่วนและดึงข้อมูล : สำหรับงานเอกสารยาวจำนวนมาก ให้ผสานองค์ประกอบการดึงข้อมูลเข้ากับบริบท 256k เพื่อลดความหน่วงและต้นทุน — เช่น ดึงส่วนที่เกี่ยวข้องแล้วส่งบริบทที่เจาะจงให้โมเดล สตรีมมิงและหน้าต่างเลื่อน : สำหรับสตรีมต่อเนื่อง ให้คงหน้าต่างเลื่อนและสรุปบริบทเก่าเป็นบันทึกย่อแบบย่อเพื่อรักษางบประมาณความสนใจของโมเดลให้มีประสิทธิภาพ
วิศวกรรมพรอมต์สำหรับโมเดล MoE
ให้คำสั่งอย่างชัดเจน : รุ่นที่ปรับจูนตามคำสั่งตอบสนองต่อภารกิจที่ชัดเจนและตัวอย่างได้ดีกว่า ใช้ตัวอย่างแบบ few-shot ในพรอมต์สำหรับเอาต์พุตโครงสร้างที่ซับซ้อนChain-of-thought และข้อความระบบ : สำหรับงานให้เหตุผล จัดโครงพรอมต์เพื่อสนับสนุนการคิดเป็นขั้นตอนและตรวจสอบผลลัพธ์กลาง แต่ควรระวัง: การกระตุ้น chain-of-thought เพิ่มจำนวนโทเคนและความหน่วง
บทสรุป Mistral Large 3 เป็นหมุดหมายสำคัญในภูมิทัศน์โมเดลแบบเปิดน้ำหนัก: โมเดล 675B รวม / ~41B ทำงานจริง แบบ MoE พร้อมหน้าต่างบริบท 256k ความสามารถมัลติโมดัล และสูตรการปรับใช้ที่ร่วมปรับจูนกับพาร์ตเนอร์โครงสร้างพื้นฐานรายใหญ่ มอบโปรไฟล์สมรรถนะต่อค่าใช้จ่ายที่น่าสนใจสำหรับองค์กรที่สามารถรับสแตก MoE และฮาร์ดแวร์ ขณะเดียวกันยังต้องประเมินอย่างรอบคอบสำหรับงานให้เหตุผลเฉพาะทางและความพร้อมเชิงปฏิบัติการ
เริ่มต้นได้โดยสำรวจความสามารถของโมเดล AI เพิ่มเติม (เช่น Gemini 3 Pro ) ใน Playground และดู API guide สำหรับคำแนะนำโดยละเอียด ก่อนเข้าถึง โปรดตรวจสอบว่าคุณได้เข้าสู่ระบบ CometAPI และรับ API key แล้ว CometAPI เสนอราคาที่ต่ำกว่าราคาทางการเพื่อช่วยคุณบูรณาการ