
สรุปสั้น ๆ
Muse Ember เป็นโมเดลการให้เหตุผลแบบมัลติโหมดที่เล็กที่สุดของ Meta ออกแบบมาสำหรับงานเอเจนต์ปริมาณสูง เช่น การกำหนดเส้นทาง การสกัดข้อมูล การเรียกใช้เครื่องมือ และการเขียนโค้ดแบบเจาะจงขอบเขต Meta เปิดตัว Muse Ember เมื่อวันที่ 9 พฤศจิกายน 2026
หน้าต่างบริบท 1,048,576 โทเค็น รองรับแหล่งข้อมูลจำนวนมาก Meta เปิดให้ใช้งานผ่าน Model API และ Muse Code; CometAPI แสดงรายการ muse-ember โดยสถานะการเปิดใช้งานอยู่ด้านล่าง เริ่มจากงานที่ทำซ้ำได้ซึ่งคุณตรวจสอบผลลัพธ์ได้ แล้วเทียบต้นทุนต่อผลลัพธ์ที่สำเร็จ รวมเหตุผล เครื่องมือ และการลองใหม่
ประเด็นสำคัญ
- บทบาท: Muse Ember ถูกสร้างมาเพื่อการรันเอเจนต์ซ้ำ ๆ รวมถึงการจำแนก การสกัดข้อมูล การเรียกใช้เครื่องมือ และงานโค้ดที่มีขอบเขตจำกัด
- อินพุตและความจุ: Muse Ember รับข้อความ รูปภาพ เสียง และวิดีโอ มีหน้าต่างบริบท 1M โทเค็น และเอาต์พุตสูงสุด 512K โทเค็น
- ประสิทธิภาพ: ผลของ Meta ชี้ว่า Muse Ember ได้เปรียบในหลายเบนช์มาร์กด้านเอเจนต์ ขณะที่การทดสอบเชิงวิเคราะห์โดยอิสระพบว่า ราคาต่อโทเค็นต่ำไม่ได้หมายความว่าจะมีต้นทุนต่อภารกิจต่ำเสมอไป
- การตั้งราคา: คำขอที่เกิน 200K โทเค็นอินพุตจะเข้าสู่ระดับราคาที่สูงกว่า; ต้นทุนรวมของภารกิจยังขึ้นกับการใช้เหตุผลและเครื่องมือ
- การเข้าถึง: มี Meta Model API และ Muse Code; รายการของ CometAPI ตอนนี้แสดงสถานะรุ่นว่า Coming soon
Muse Ember เหมาะกับงานประเภทใดที่สุด?
Muse Ember รับผิดชอบขั้นตอนการปฏิบัติในเวิร์กโฟลว์เอเจนต์ ขณะที่โมเดลที่ใหญ่กว่าเป็นผู้วางแผน เหมาะกับงานปริมาณสูงที่มีอินพุตชัดเจน ขอบเขตจำกัด และผลลัพธ์ที่แอปของคุณตรวจสอบได้ งานหลักคือ:
- การจำแนกและการกำหนดเส้นทาง: ติดป้ายคำขอและส่งไปยังคิวหรือบริการที่ถูกต้อง
- การสกัดข้อมูล: แปลงเอกสารและสื่อเป็นฟิลด์แบบมีโครงสร้างพร้อมหลักฐานแหล่งที่มา
- การเรียกใช้เครื่องมือ: เลือกฟังก์ชันและระบุอาร์กิวเมนต์ที่แอปของคุณจะนำไปใช้งาน
- การประมวลผลแบบแบตช์: ใช้งานที่ทำซ้ำได้กับไฟล์หรือเรคอร์ดจำนวนมาก
การกำหนดเส้นทางทิกเก็ตสนับสนุน
เวิร์กโฟลว์สนับสนุนที่ใช้งานได้จริงสามารถให้ Ember สกัดอ้างอิงคำสั่งซื้อ กำหนดหมวดหมู่ และติดธงข้อมูลที่ขาด แอปของคุณสามารถตรวจสอบอ้างอิงกับเรคอร์ดก่อนจัดส่งทิกเก็ต เก็บการคืนเงิน การเปลี่ยนบัญชี และการกระทำที่มีผลกระทบไว้หลังการตรวจสอบสิทธิ์ของแอปเอง
การสกัดข้อมูลเอกสารพร้อมหลักฐาน
สำหรับการประมวลผลใบแจ้งหนี้หรือสัญญา ให้ขอทั้งค่าที่สกัดและหน้าหรือข้อความที่สนับสนุนค่าเหล่านั้น ปฏิบัติต่อฟิลด์ที่ไม่มีหรืออ่านไม่ได้เป็นผลลัพธ์ที่ชัดเจนแทนการชวนโมเดลให้เดา สิ่งนี้ให้เรคอร์ดที่ผู้ตรวจทานสามารถตรวจสอบได้โดยไม่ต้องอ่านเอกสารทุกฉบับใหม่
งานโค้ดแบบเจาะจงขอบเขต
มอบหมายขอบเขตความรับผิดชอบที่เล็กให้กับคนงานโค้ด: ไฟล์ที่สามารถแก้ไข พฤติกรรมที่ต้องรักษาไว้ และชุดทดสอบที่กำหนดนิยามของความสำเร็จ ตัวอย่าง การย้ายโค้ดแบบขนาน ของ Meta แสดงการแบ่งงานเช่นนี้ เอเจนต์โดยรอบจะรันคำสั่งและตรวจผลลัพธ์; คำตอบของโมเดลเพียงอย่างเดียวไม่ใช่หลักฐานว่าการเปลี่ยนแปลงผ่านการทดสอบแล้ว
ภาพเปิดตัว Muse Ember มาพร้อมคู่มือการผสานโมเดลสำหรับการปฏิบัติการเข้ากับโมเดลสำหรับการวางแผนที่ใหญ่กว่า
Meta ระบุว่า Muse Ember เป็นโมเดลแรกที่ฝึกด้วย Muse Wonder Full ซึ่งต่อยอดกลยุทธ์การใช้โมเดลขนาดใหญ่เพื่อพัฒนาโมเดลเฉพาะทาง
ข้อมูลจำเพาะของ Muse Ember
ข้อมูลจำเพาะหลัก ได้แก่:
| ข้อมูลจำเพาะ | Muse Ember |
|---|---|
| ผู้พัฒนา | Meta Superintelligence Labs |
| วันที่ประกาศ | November 9, 2026 |
| หมวดหมู่โมเดล | Multimodal reasoning and agent execution |
| หน้าต่างบริบท | 1,048,576 tokens |
| ขนาดผลลัพธ์สูงสุด | 524,288 tokens |
| รูปแบบอินพุต | Text, images, audio, video |
| อินพุตไฟล์ | Supported through the Responses API |
| รูปแบบเอาต์พุต | Text |
| ระดับการใช้เหตุผล | Minimal, Low, Medium, High, XHigh, Max |
| ระดับการใช้เหตุผลเริ่มต้น | Max |
| การเรียกใช้เครื่องมือ | Supported |
| ผลลัพธ์แบบมีโครงสร้าง | Supported |
| การยึดโยงการค้นหา | Supported through the Model API |
Meta ยังไม่ปล่อยน้ำหนักของ Muse Ember หรือเปิดเผยจำนวนพารามิเตอร์ ขีดจำกัดคำขอและโทเค็นมีผลต่อทีม โดยคีย์ API ทั้งหมดในทีมเดียวกันใช้โควตาร่วมกัน
บริบทและอินพุตมัลติโหมด
สำหรับเวิร์กโฟลว์ PDF, Meta จะสกัดข้อความจาก 100 หน้าแรกและรูปภาพจาก 50 หน้าแรก ดังนั้นควรแบ่งไฟล์ที่ยาวกว่าออกก่อนประมวลผล ส่งเฉพาะวัสดุที่จำเป็นต่อภารกิจ; โทเค็นสำหรับการให้เหตุผลใช้โควตาเอาต์พุต 524,288 โทเค็นร่วมกับคำตอบสุดท้าย
ใช้ภาพหน้าจอเมื่อเลย์เอาต์มีความสำคัญ ใช้สแกนสำหรับการสกัดเอกสาร ใช้เสียงสำหรับวิเคราะห์การประชุม และใช้วิดีโอสำหรับเหตุการณ์ที่ดำเนินไปตามเวลา ทรานสคริปต์ก็เพียงพอสำหรับสรุปแบบข้อความ อินพุตไฟล์รองรับผ่าน Responses API และผลลัพธ์ส่งกลับเป็นข้อความ
ระดับการใช้เหตุผลที่ตั้งค่าได้
Muse Ember มี 6 ระดับการใช้เหตุผล: Minimal, Low, Medium, High, XHigh และ Max Meta ตั้งค่าเริ่มต้นเป็น Max; หากระบุระดับที่ไม่มีอยู่จะได้ HTTP 400 เริ่มงานจัดเส้นทางและจำแนกแบบประจำด้วยระดับต่ำกว่า แล้วเพิ่มเฉพาะเมื่ออัตราคำตอบที่ผ่านเพิ่มขึ้นคุ้มกับความหน่วงและต้นทุนโทเค่นเอาต์พุตที่มากขึ้น
การเรียกใช้เครื่องมือและผลลัพธ์แบบมีโครงสร้าง
Muse Ember รองรับ การเรียกใช้เครื่องมือและผลลัพธ์แบบมีโครงสร้าง การเรียกเครื่องมือเชื่อมการตัดสินใจของโมเดลกับฟังก์ชันของแอป ส่วนผลลัพธ์แบบมีโครงสร้างทำให้ฟิลด์ที่สกัดตรวจสอบและส่งต่อไปยังขั้นตอนถัดไปได้ง่ายขึ้น
ตัวอย่างผลลัพธ์ทิกเก็ตสนับสนุนนี้ให้แอปสำหรับกำหนดเส้นทางทราบหมวดหมู่ ลำดับความสำคัญ และธงการตรวจทาน:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API ยังรองรับการยึดโยงการค้นหาและเวิร์กโฟลว์การใช้งานคอมพิวเตอร์ แอปที่เชื่อมต่อเป็นผู้จัดเตรียมเครื่องมือ ดำเนินการ และควบคุมสิทธิ์
Muse Ember ทำงานบนเบนช์มาร์กอย่างไร?
ผลเปิดตัวของ Meta ใช้ระดับการใช้เหตุผลสูงสุด Agents’ Last Exam ครอบคลุมส่วนย่อย Linux ในการประเมินภายในของ Meta ขณะที่ Terminal-Bench ใช้ฮาร์เนสที่ดีที่สุดตามที่เผยแพร่ของแต่ละโมเดล พวกเขารวมผลจาก Artificial Analysis ภายนอกกับการประเมินภายในของ Meta; Personal Superintelligence Index เป็นดัชนีรวมภายในของ Meta ไม่ใช่ลีดเดอร์บอร์ดอิสระแยกต่างหาก
ผลลัพธ์เบนช์มาร์กของ Muse Ember
| เบนช์มาร์ก | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 ใช้ mini-swe-agent สำหรับ Muse Ember, Claude Code สำหรับ Haiku 5.5 และ Codex สำหรับ GPT-6 Luna ซึ่งไม่ใช่สภาพแวดล้อมการรันที่เหมือนกัน OSWorld 2.1 รายงานทั้งคะแนนบางส่วนและคะแนนแบบไบนารี ขณะที่ PerceptionBench รวมเครื่องมือ ผลของ Artificial Analysis Intelligence Index มาจากเวอร์ชัน 5 ณ วันที่ 9 พฤศจิกายน 2026
วิเคราะห์เบนช์มาร์กของ Muse Ember
การปฏิบัติการแบบเอเจนต์เป็นจุดแข็งที่สุดของ Muse Ember
บน AutomationBench-AA, Muse Ember ได้ 37.8 เมื่อเทียบกับ 13.9 สำหรับ Haiku 5.5 และ 20.2 สำหรับ GPT-6 Luna สิ่งนี้สนับสนุนการวางตำแหน่งของ Meta ว่า Muse Ember เป็นโมเดลสำหรับเวิร์กโฟลว์ธุรกิจแบบครบวงจรและการรันเอเจนต์ซ้ำ ๆ
ประสิทธิภาพด้านการเขียนโค้ดแข่งขันได้ แต่ไม่ได้เหนือกว่าทุกบริบท
Muse Ember ได้ 40.9 บน Terminal-Bench 4.0 และ 46 บน Coding Agent Index-AA อย่างไรก็ตามได้ 27.2 บน FrontierCode 2.0-AA ต่ำกว่า 34.9 ของ Haiku 5.5 แสดงว่า Muse Ember เป็นตัวเลือกที่มีประโยชน์สำหรับงานย่อยด้านโค้ดที่มีขอบเขตจำกัด ขณะที่งานวิศวกรรมที่ยากกว่า ควรทดสอบกับทางเลือกที่แข็งแกร่งกว่า
ผลลัพธ์ด้านมัลติโหมดและการใช้งานคอมพิวเตอร์มีแนวโน้มที่ดี
Muse Ember ได้ 80.6 บน PerceptionBench พร้อมเครื่องมือ และ 69.5 บน OSWorld 2.1 แบบคะแนนบางส่วน ซึ่งสนับสนุนการวางตำแหน่งสำหรับเวิร์กโฟลว์ที่ต้องเข้าใจภาพและปฏิสัมพันธ์กับคอมพิวเตอร์
ความฉลาดทั่วไปใกล้เคียงกับ Haiku 5.5
Muse Ember และ Haiku 5.5 ปัดเศษได้ 36 บน Artificial Analysis Intelligence Index เหนือ GPT-6 Luna ที่ 28 สำหรับการตัดสินใจเลือก ควรจับคู่การเปรียบเทียบกว้างนี้กับผลเฉพาะตามงานด้านบน
ความฉลาดของ Muse Ember เทียบกับต้นทุนต่อภารกิจ
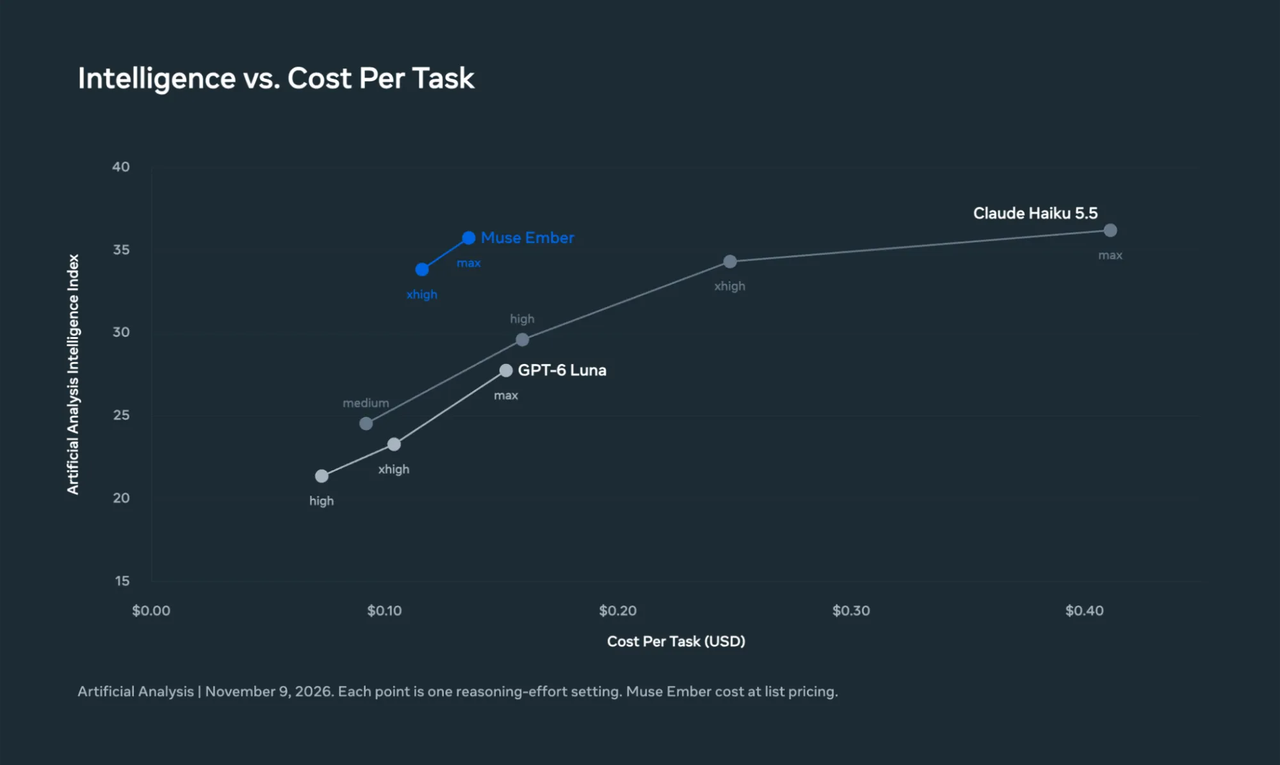
กราฟของ Meta เปรียบเทียบคะแนน Artificial Analysis Intelligence Index กับต้นทุนต่อภารกิจโดยประมาณในระดับการใช้เหตุผลต่าง ๆ
ที่ระดับการใช้เหตุผลสูงสุด Muse Ember ได้คะแนน 35.8 บน Artificial Analysis Intelligence Index ที่ต้นทุนประมาณ $0.136 ต่อภารกิจ Haiku 5.5 ได้ 36.2 ที่ $0.411 ส่วน GPT-6 Luna ได้ 27.8 ที่ $0.152 บนเบนช์มาร์กนี้ Ember เข้าใกล้คะแนนของ Haiku ด้วยต้นทุนต่อภารกิจประมาณหนึ่งในสาม และเหนือกว่า Luna ด้วยต้นทุนที่ต่ำกว่าเล็กน้อย
ประมาณการอ้างอิงการใช้โทเค็นของเบนช์มาร์กและราคาตามประกาศ การประเมินถัดไปอธิบายว่ากิจกรรมเครื่องมือมีผลต่อการเลือกโมเดลสำหรับเวิร์กโฟลว์เฉพาะอย่างไร
ผลการทดสอบการวิเคราะห์ข้อมูลโดยอิสระ
การประเมินวันที่ 10 พฤศจิกายน 2026 ของ Plotly ด้านการวิเคราะห์ข้อมูล ทดสอบคำถาม 43 ข้อใน Plotly Studio Embedded กับชุดข้อมูลพลังงานลมแบบสังเคราะห์ Muse Ember รันผ่าน OpenRouter; ต้นทุนที่รายงานใช้อัตราราคา ณ เวลาที่แต่ละโมเดลรัน เป็นผลลัพธ์เฉพาะภาระงาน ไม่ใช่การทดสอบการเรียกเก็บเงินผ่าน API เนทีฟของ Meta
| ตัวชี้วัดการประเมิน | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| จำนวนคำถามที่ผ่าน | 38/43 | 38/43 | 37/43 |
| ต้นทุนการทดสอบทั้งหมด | $1.04 | $0.13 | $0.38 |
| เวลาแบบมัธยฐานต่อคำถาม | 28 seconds | 18 seconds | 14 seconds |
สำหรับภาระงานวิเคราะห์ข้อมูลนี้ GPT-6 Luna ให้ผลผ่าน 38/43 เท่ากับ Ember ที่ต้นทุนรวมหนึ่งในแปด พร้อมเวลาในการตอบต่ำกว่า Haiku เร็วที่สุดที่ 14 วินาทีต่อคำถาม โดยผ่าน 37/43 Luna เป็นตัวเลือกตั้งต้นที่แข็งแกร่งกว่าสำหรับเวิร์กโฟลว์วิเคราะห์ที่อ่อนไหวต่อต้นทุนที่คล้ายกัน; อัตราโทเค็นต่ำของ Ember เพียงอย่างเดียวไม่ได้ทำให้ถูกกว่าเสมอไป
Plotly พบว่า Muse Ember ส่งคำถามเครื่องมือเฉลี่ย 78 ครั้งในคำถามที่มีแพตเทิร์นซ่อนอยู่ เมื่อเทียบกับมัธยฐาน 25 ครั้งในโมเดลที่ทดสอบ กิจกรรมเครื่องมือที่เพิ่มขึ้นทำให้การใช้โทเค็นและต้นทุนรวมสูงขึ้น
การทดสอบยังแสดงจุดแข็ง: Muse Ember ตอบถูกทุก 20 คำถามวิเคราะห์ที่นิยามชัดเจน ทุก 5 คำถามกำกวม ทุก 5 คำขอที่เป็นไปไม่ได้ และตรวจสอบคุณภาพข้อมูลทั้ง 3 ข้อได้ถูกต้อง จุดที่ลำบากที่สุดคือแพตเทิร์นที่ซ่อนอยู่ในข้อมูล
Plotly รันแต่ละโมเดลเพียงครั้งเดียว และพบความแปรผันถึง 3 คำถามเมื่อรันโมเดลอื่นซ้ำ จึงควรมองความต่าง 38 เทียบ 37 เป็นใกล้เคียง; ความต่างที่ชัดเจนกว่าที่นี่คือการใช้เครื่องมือและต้นทุนรวม
Muse Ember เทียบกับ Muse Wonder และ Muse Spark
เลือกโมเดล Muse ตามความรับผิดชอบที่ถือครอง: การวางแผน วงลูปเอเจนต์หลัก หรือการปฏิบัติการซ้ำ
| มิติ | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| บทบาทหลัก | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| จุดแข็งหลัก | Planning, long-running tasks, complex coding | Coding and agentic workflows | Repetitive subtasks and tool calls |
| ภาระงานทั่วไป | Repository-scale engineering | Main agent execution | Classification, routing, extraction |
| รหัสโมเดลใน API | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| หน้าต่างบริบท | 1M tokens | 1M tokens | 1M tokens |
| การใช้เหตุผลเริ่มต้น | Max | High | Max |
| ราคาอินพุตมาตรฐาน / 1M | $4.00 | $1.25 | $0.10 |
| ราคาเอาต์พุตมาตรฐาน / 1M | $20.00 | $4.25 | $0.50 |
ตารางใช้อัตรา ราคาต่อโทเค็นโหมดมาตรฐานของ Meta ราคาของ Ember ที่นี่ใช้กับคำขอที่มีอินพุตไม่เกิน 200K โทเค็น; Wonder และ Spark ไม่มีค่าพรีเมียมบริบทยาวแบบ Ember
การเลือกโมเดล Muse
เลือก Wonder สำหรับการวางแผนที่ยาก งานวิศวกรรมทั้งรีโพ และการกู้คืนผ่านลำดับขั้นตอนยาว เลือก Spark เพื่อรันวงลูปโค้ดหรือเอเจนต์หลัก เลือก Ember สำหรับงานย่อยที่ทำซ้ำได้และตรวจสอบผลลัพธ์ได้เอง เช่น การกำหนดเส้นทาง การสกัดข้อมูล และการเปลี่ยนไฟล์แบบเจาะจง
ตัวอย่างเช่น การย้ายรีโพสามารถมอบหมายการวิเคราะห์ dependency ให้โมเดลใหญ่ และการเปลี่ยนไฟล์ที่มีขอบเขตชัดให้ Ember การส่งต่อควรระบุชื่อไฟล์ พฤติกรรมที่คาดหวัง และการตรวจรับ งานแบ่งส่วนจะมีประโยชน์เมื่อการประสานงานและการตรวจทานงานเล็กใช้ต้นทุนน้อยกว่าทำทั้งงานด้วยโมเดลหลัก
เพื่อเลือก ระบุงานตัวแทนเดียวกันให้ผู้สมัครแต่ละราย และใช้เกณฑ์รับรองเดียวกัน ปฏิเสธการตั้งค่าที่ไม่ถึงอัตราสำเร็จหรือความหน่วงตามต้องการ ในกลุ่มที่ผ่าน ให้เทียบค่าใช้จ่ายรวมต่อผลลัพธ์ที่รับ รวมการลองใหม่และการเรียกเครื่องมือ มอบหมายงานให้ Ember เฉพาะประเภทที่ลดต้นทุนได้ และส่งกรณีที่ยังแก้ไม่ได้กลับไปยัง Spark หรือ Wonder
Muse Ember มีค่าใช้จ่ายเท่าไร?
ตารางนี้จับคู่ อัตราทางการของ Meta กับประมาณการลด 20% สำหรับ CometAPI เป็น USD ต่อ 1 ล้านโทเค็น แต่ละช่องแสดง Meta / ประมาณการที่ลดแล้ว รายการของ CometAPI ยังไม่เผยแพร่ราคาแบบสด ให้ใช้ตัวเลขลดแล้วเพื่อวางงบประมาณ
| อัตราใช้ต่อ 1M โทเค็น (Meta / ประมาณลด 20%) | สูงสุด 200K โทเค็นอินพุต | มากกว่า 200K โทเค็นอินพุต |
|---|---|---|
| อินพุต | $0.10 / $0.08 | $0.30 / $0.24 |
| อินพุตที่แคชแล้ว | $0.004 / $0.0032 | $0.012 / $0.0096 |
| เอาต์พุต | $0.50 / $0.40 | $1.50 / $1.20 |
โทเค็นอินพุตรวมของคำขอ (รวมอินพุตที่แคชแล้ว) เป็นผู้กำหนดระดับราคา คำขอที่เกิน 200K โทเค็นอินพุตจะใช้อัตราที่สูงขึ้นกับทั้งคำขอ รวมถึงเอาต์พุต ด้วย previous_response_id ของ Meta ประวัติการสนทนาที่เก็บไว้จะนับรวมกับยอดอินพุตนั้น
ตัวอย่างต้นทุนคำขอของ Muse Ember
เมื่อไม่มีการแคชอินพุตและมีเอาต์พุตที่ถูกเรียกเก็บ 20K โทเค็นรวมเหตุผล คำขออินพุต 200K มีต้นทุน $0.0300 ตามอัตรา Meta หรือ $0.0240 ในสถานการณ์ลด 20% เพิ่มอินพุตเป็น 220K จะย้ายคำขอทั้งชุดไปสู่ระดับราคาที่สูงกว่า: เอาต์พุต 20K เดิมให้ต้นทุนรวม $0.0960 ตามอัตรา Meta หรือประมาณ $0.0768 เมื่อมีส่วนลด ตัวอย่างนี้ไม่รวมค่าธรรมเนียมเครื่องมือแยก Keeping relevant context within the lower tier can save more than a 20% discount alone.
| สถานการณ์ | โทเค็นอินพุต | โทเค็นเอาต์พุตที่ถูกเรียกเก็บเงิน | ต้นทุน Meta | ต้นทุน CometAPI |
|---|---|---|---|---|
| คำขอมาตรฐาน | 200K | 20K | $0.0300 | $0.0240 |
| คำขอบริบทยาว | 220K | 20K | $0.0960 | $0.0768 |
โทเค็นสำหรับการให้เหตุผลนับรวมเป็นเอาต์พุตที่ถูกเรียกเก็บ สำหรับ API เนทีฟของ Meta การยึดโยงการค้นหาบนเว็บมีค่าใช้จ่ายเพิ่มเติม $2.50 ต่อ 1,000 คำค้น และ Ember ไม่มีรุ่น Contributor-mode การเปรียบเทียบราคาต่อโทเค็นด้านบนไม่ได้นำส่วนลด 20% ไปใช้กับค่าธรรมเนียมเครื่องมือแยกต่างหาก
วิธีเข้าถึง Muse Ember
รายการ CometAPI: หน้ารุ่น ระบุรุ่นเป็น muse-ember แต่สถานะในแคตตาล็อกเป็น Coming soon ณ วันที่ 16 พฤศจิกายน 2026 ติดตามหน้านี้เพื่อดูการเปิดใช้งานและราคา; หากต้องการใช้งานทันที ให้ใช้ Meta Model API หรือ Muse Code
ผ่าน Meta Model API: ใช้ muse-ember-1.0 กับ https://api.meta.ai/v1. API เนทีฟรองรับ Responses, Chat Completions และรูปแบบ Messages อินพุตไฟล์ใช้ Responses รักษาจุดเชื่อมต่อของผู้ให้บริการและรหัสโมเดลให้ถูกคู่กันเมื่อกำหนดค่าไคลเอนต์
ขีดจำกัด Native API และช่องทางอื่น: Meta ระบุ 3,000 คำขอต่อนาที และ 4,000,000 โทเค็นต่อนาทีต่อทีม ใช้ร่วมกันโดยคีย์ API ของทีม Muse Ember ยังมีให้ใช้งานใน Muse Code ตรวจสอบขีดจำกัดของเส้นทางที่เลือกเมื่อกำหนดขนาดแบตช์ และใช้ คู่มือการผสานของ Meta สำหรับการตั้งค่า API เนทีฟ
ข้อจำกัดของ Muse Ember คืออะไร?
มีสามปัจจัยที่กำหนดว่า Ember เหมาะกับเวิร์กโฟลว์ถัดไปหรือไม่:
- วิศวกรรมที่ซับซ้อนยังขึ้นกับภาระงาน: Ember ตามหลัง Haiku 5.5 บน FrontierCode 2.0-AA แม้จะทำได้ดีกว่าบางส่วนบน Terminal-Bench ชัยชนะเฉพาะด้านโค้ดที่แคบไม่ได้ยืนยันความเหมาะสมสำหรับการเปลี่ยนทั้งรีโพเสมอไป
- บริบทยาวและราคาโทเค็นต่ำไม่ได้รับประกันต้นทุนต่อภารกิจต่ำ: คำขอขนาดใหญ่ย้ายไปยังระดับราคาที่สูงขึ้น และการใช้เครื่องมือซ้ำ ๆ อาจใช้โทเค็นมากพอที่จะกลบอัตราต่อโทเค็นที่ต่ำ
- การรองรับเครื่องมือยังต้องมีแอปพลิเคชัน: ระบบโดยรอบเป็นผู้เรียกใช้ ควบคุมสิทธิ์ และตรวจสอบผลลัพธ์ ความสามารถของโมเดลในการร้องขอการกระทำไม่ได้สร้างเวิร์กโฟลว์ที่เชื่อถือได้ด้วยตัวเอง
บทสรุป
นำ Ember ไปใช้กับขั้นตอนที่เกณฑ์รับรองชัดเจนพอจะวัดได้ การใช้งานครั้งแรกที่มีประโยชน์คือขั้นตอนปริมาณสูงที่มีผลลัพธ์ที่รู้แน่แล้ว เช่น การจัดเส้นทางทิกเก็ตที่ติดป้าย หรือการสกัดฟิลด์จากเอกสารที่มีการตรวจทาน เทียบต้นทุนต่อภารกิจที่สำเร็จ อัตราความผิดพลาด และความหน่วงกับโมเดลปัจจุบันก่อนขยายบทบาท หลักฐานนั้นจะบอกว่าการใช้ Ember ลดต้นทุนเวิร์กโฟลว์ของคุณโดยยังคงคุณภาพที่ต้องการไว้หรือไม่
คำถามที่พบบ่อย
ควรตรวจสอบความถูกต้องของผลการสกัดข้อมูลจาก Muse Ember อย่างไร?
สร้างชุดเอกสารอ้างอิงพร้อมคำตอบที่ตรวจโดยมนุษย์ รวมถึงฟิลด์ที่หายไป สแกนที่อ่านไม่ได้ และค่าที่ขัดแย้ง วัดความแม่นยำเป็นรายฟิลด์แทนการนับ JSON ที่มีรูปแบบถูกต้องว่าเป็นความสำเร็จ ตรวจว่าค่าที่สกัดแต่ละค่าได้รับการสนับสนุนจากข้อความแหล่งที่อ้างอิงหรือไม่ และส่งกรณีที่ไม่ตรงให้ตรวจทาน วิธีนี้แยกความเชื่อถือได้ด้านรูปแบบออกจากความเชื่อถือได้ด้านข้อเท็จจริง
เมื่อใดที่งานย่อยของ Muse Ember ควรส่งคืนให้เอเจนต์หลัก?
กำหนดเงื่อนไขการยกระดับก่อนเริ่มปฏิบัติการ: ไฟล์ที่ต้องใช้ถูกอยู่นอกขอบเขตที่มอบหมาย แหล่งข้อมูลให้ข้อมูลขัดแย้ง การตรวจรับล้มเหลวซ้ำ ๆ หรือภารกิจต้องการการตัดสินใจที่คนงานไม่ได้รับอนุญาตให้ทำ ส่งคืนหลักฐาน ขั้นตอนที่พยายามทำ และคำถามที่ยังแก้ไม่ได้ให้เอเจนต์หลัก การส่งต่อที่ชัดเจนมีประโยชน์กว่าการปล่อยให้คนงานขยายขอบเขตงานไปเรื่อย ๆ
ควรบันทึกอะไรบ้างเมื่อทดสอบ Muse Ember ในการใช้งานจริง?
บันทึกผู้ให้บริการและรหัสโมเดลที่ใช้ ระดับการใช้เหตุผล โทเค็นอินพุตและเอาต์พุตที่ถูกเรียกเก็บ อินพุตที่แคชแล้ว จำนวนการเรียกเครื่องมือ จำนวนการลองใหม่ ความหน่วง และผลการรับรองสุดท้าย เก็บผลการตรวจสอบความถูกต้องเคียงกับบันทึกการใช้งานเพื่อคำนวณต้นทุนต่อภารกิจที่รับ เทียบแต่ละประเภทงานแยกกัน; ค่าเฉลี่ยรวมระหว่างงานจัดเส้นทาง งานโค้ด และเอกสารยาว อาจซ่อนจุดที่โมเดลช่วยหรือเพิ่มต้นทุน
จะป้องกันการกระทำซ้ำในเวิร์กโฟลว์ของ Muse Ember ได้อย่างไร?
มอบหมายให้แอปพลิเคชันรับผิดชอบเอกลักษณ์ของการกระทำและสถานะความสำเร็จ สำหรับปฏิบัติการอย่างการสร้างทิกเก็ต กำหนดคีย์ปฏิบัติการที่คงที่ ตรวจว่าดำเนินการเสร็จแล้วหรือยัง และใช้การรองรับ idempotency ของ API ปลายทางเมื่อมี หลังหมดเวลา ให้ตรวจสอบสถานะของการกระทำก่อนลองใหม่ การออกแบบนี้หลีกเลี่ยงการตีความคำตอบที่ไม่แน่ชัดว่าเป็นหลักฐานว่าการกระทำเดิมไม่เคยเกิดขึ้น