

TL;DR
Claude Opus 5.5, belirgin ölçüde daha düşük token fiyatları sunarken yayımlanmış birçok değerlendirmede Fable 5.1 ile eşleşen veya onu aşan sonuçlar verdiği için güçlü bir başlangıç adaydır. Opus 5.5, milyon başına girişte $4 ve çıkışta $20 ücretlendirirken, Fable 5.1 sırasıyla $10 ve $50 talep eder.
Fable 5.1 yine de olağandışı derecede zor, uzun süreli, yeniden denemesi maliyetli veya yakından gözetim olmadan çalışması beklenen görevlerde rol sahibidir. Pratik kural basittir: Opus 5.5 ile başlayın, ardından yalnızca temsilî üretim testleri Fable 5.1’in başarısızlık, düzeltme veya yeniden deneme maliyetlerini primi haklı çıkaracak kadar azalttığını gösterdiğinde yükseltin.
Claude Opus 5.5 vs Claude Fable 5.1 Kısa Karşılaştırma
| Boyut | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Yayın tarihi | 22 Eyl. 2026 | 1 Eyl. 2026 |
| API model kimliği | claude-opus-5-5 | claude-fable-5-1 |
| Bağlam / azami çıktı | 1M / 128K | 1M / 128K |
| MTok başına giriş/çıkış | $4 / $20 | $10 / $50 |
| MTok başına önbellek okuma | $0.20 | $0.25 |
| Terminal-Bench 4.0 | %66,4 | %55,8 |
| FrontierCode v1.1 | %54,4 | %50,3 |
| CursorBench 4.0 | %57,8 | %51,8 |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| HAProxy C'den Rust'a geçiş | 9,5 saat; görev maliyetinde %51 düşüş | 12 saat; baz görev maliyeti |
| Hız seçeneği | Fast mode, normal hızın 2,5×’ine kadar | Eşdeğer bir başlatma modu yok |
| Başlangıç efor düzeyi | Orta odaklı | Yüksek |
| Varsayılan en iyi kullanım | Günlük frontier kodlama, ajanlar, denetimli üretim ve yüksek hacimli API trafiği | En değerli, zor, uzun süreli veya gözetimsiz otonom işler |
| API erişimi | Anthropic API ve CometAPI dahil uyumlu sağlayıcılar | Anthropic API ve CometAPI dahil uyumlu sağlayıcılar |
Okuma notu: Kıyaslama rakamları Anthropic tarafından raporlanmıştır ve efor düzeyi, harness, koruma önlemleri, görev sürümü, deneme sayısı ve standart hataya bağlıdır. Yalnızca eşleştirilmiş değerlendirme koşulları altında karşılaştırılmalıdır.
Önemli Çıkarımlar
- Opus 5.5’in standart giriş ve çıkış oranları Fable 5.1’e göre %60 daha düşüktür.
- Her iki model de 1M-token bağlam penceresini ve 128K’ya kadar çıktıyı destekler, bu nedenle nominal bağlam boyutundan ziyade maliyet, efor ayarları ve iş yükü uyumu daha önemlidir.
- Anthropic’in yayımladığı sonuçlar, birçok kodlama ve ajan değerlendirmesinde Opus 5.5’i öne çıkarır, ancak kıyaslama ayarları sonucu maddi olarak etkiler.
- Bağımsız değerlendirme, farklı mutlak puanlar rapor ederken Opus 5.5’in frontier konumunu destekler; bu da eşleştirilmiş testlerin gerekliliğini pekiştirir.
- Çoğu denetimli üretim işi için Opus 5.5 daha güçlü bir başlangıçtır. Fable 5.1 otomatik varsayılan değil, bir yükseltme katmanıdır.
Claude Opus 5.5 Nedir?
Claude Opus 5.5, Anthropic’in ilk Claude 5.5 modelidir. Ajanik kodlama, uzun süreli ajanlar, profesyonel bilgi işleri, kurumsal iş akışları, finansal analiz, görsel yetenekler ve bilgisayar kullanımı için konumlandırılmıştır.
API model kimliği claude-opus-5-5’tir. Uyarlamalı düşünme her zaman etkindir; geliştiriciler düşük, orta, yüksek, xhigh ve max efor ayarlarıyla muhakeme yoğunluğunu kontrol eder. Anthropic ayrıca Fast mode sunar; bu mod, $8/M giriş ve $40/M çıkış karşılığında normal hızın 2,5 katına kadar çalışabilir.
Claude Fable 5.1 Nedir?
Claude Fable 5.1, çok saatlik kodlama, karmaşık araştırma, tarayıcı etkileşimi, otonom ajanlar ve birden çok uygulamayı kapsayan iş akışları gibi zorlu, uzun soluklu projeler için konumlandırılmıştır.
API model kimliği claude-fable-5-1’dir. Uyarlamalı düşünme kullanır, daha yüksek bir API efor ayarından başlar ve beklenen hatalı sonuç veya tekrarlı yeniden denemelerin maliyeti ek çıkarım maliyetini aşarsa primli seçenek olarak değerlendirilmelidir.
Basitleştirilmiş bir okumayla, Opus 5.5’in Fable’ın standart token fiyatının %40’ı karşılığında neredeyse aynı zarfı sunduğu söylenebilir. Ancak tam da burada basit bir özellik tablosu yanıltıcı olur.
Kod ve Kıyaslama Karşılaştırması
Anthropic, Opus 5.5’in Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 ve Chartography’de Fable 5.1’in önünde olduğunu rapor ediyor.
Kıyaslama Sonuçları Nasıl Okunmalı
Anthropic, Opus 5.5’in Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 ve Chartography’de Fable 5.1’in önünde olduğunu rapor ediyor. Bu rakamlar değerlendirme sonuçlarıdır; yapılandırmadan bağımsız model sabitleri değildir.
Başlıca Opus 5.5 skorları genellikle max efor ile, Terminal-Bench 4.0 ise xhigh efor ile alınmıştır. Harness tasarımı, araç yapılandırması, koruma önlemleri, deneme sayısı, standart hata, geri dönüş davranışı ve maliyet tavanları sonucu değiştirebilir. Anthropic, kıyaslama marjlarının pratikteki farkı abartabileceği konusunda bizzat uyarıyor.
Kodlama Performansı
| Kıyaslama | Claude Opus 5.5 | Claude Fable 5.1 | Yorum |
|---|---|---|---|
| Terminal-Bench 4.0 | %66,4 | %55,8 | Terminal tabanlı ajan görevlerinde 10,6 puanlık raporlanan fark |
| FrontierCode v1.1 | %54,4 max; %54,6 orta | %50,3 | Orta eforlu Opus 5.5, üretim ekonomisi için rekabetçi kalır |
| CursorBench 4.0 | %57,8 max; %52,5 orta | %51,8 | Orta efor, raporlanan Fable sonucunu az da olsa aşar |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Profesyonel ajanik işlerde raporlanan avantaj |
Bu rakamlar Anthropic tarafından raporlanan kıyaslama sonuçlarıdır. Tablo, aşağıdaki bölümlerdeki değerlendirme ayarı uyarıları ve resmî Claude Opus model sayfası ile birlikte okunmalıdır.
İlk üç sonuç, Claude’un ticari olarak giderek daha önemli olduğu iş yükünü kapsadığı için öne çıkıyor: yazılım mühendisliği ajanları. Terminal-Bench 4.0, mutlak olarak 10,6 yüzde puanlık bir fark gösteriyor; FrontierCode 4,1 puan; CursorBench 4.0 ise 6 puan.
Profesyonel ajanik işi ölçen GDPval-AA, ayrıca Opus 5.5 için 1846 Elo, Fable 5.1 için 1735 Elo rapor ediyor. Hikâye yalnızca bu rakamlardan ibaret olsaydı, ürün hiyerarşisi tersine dönmüş görünürdü. O kadar basit değil.
Bağımsız Değerlendirme
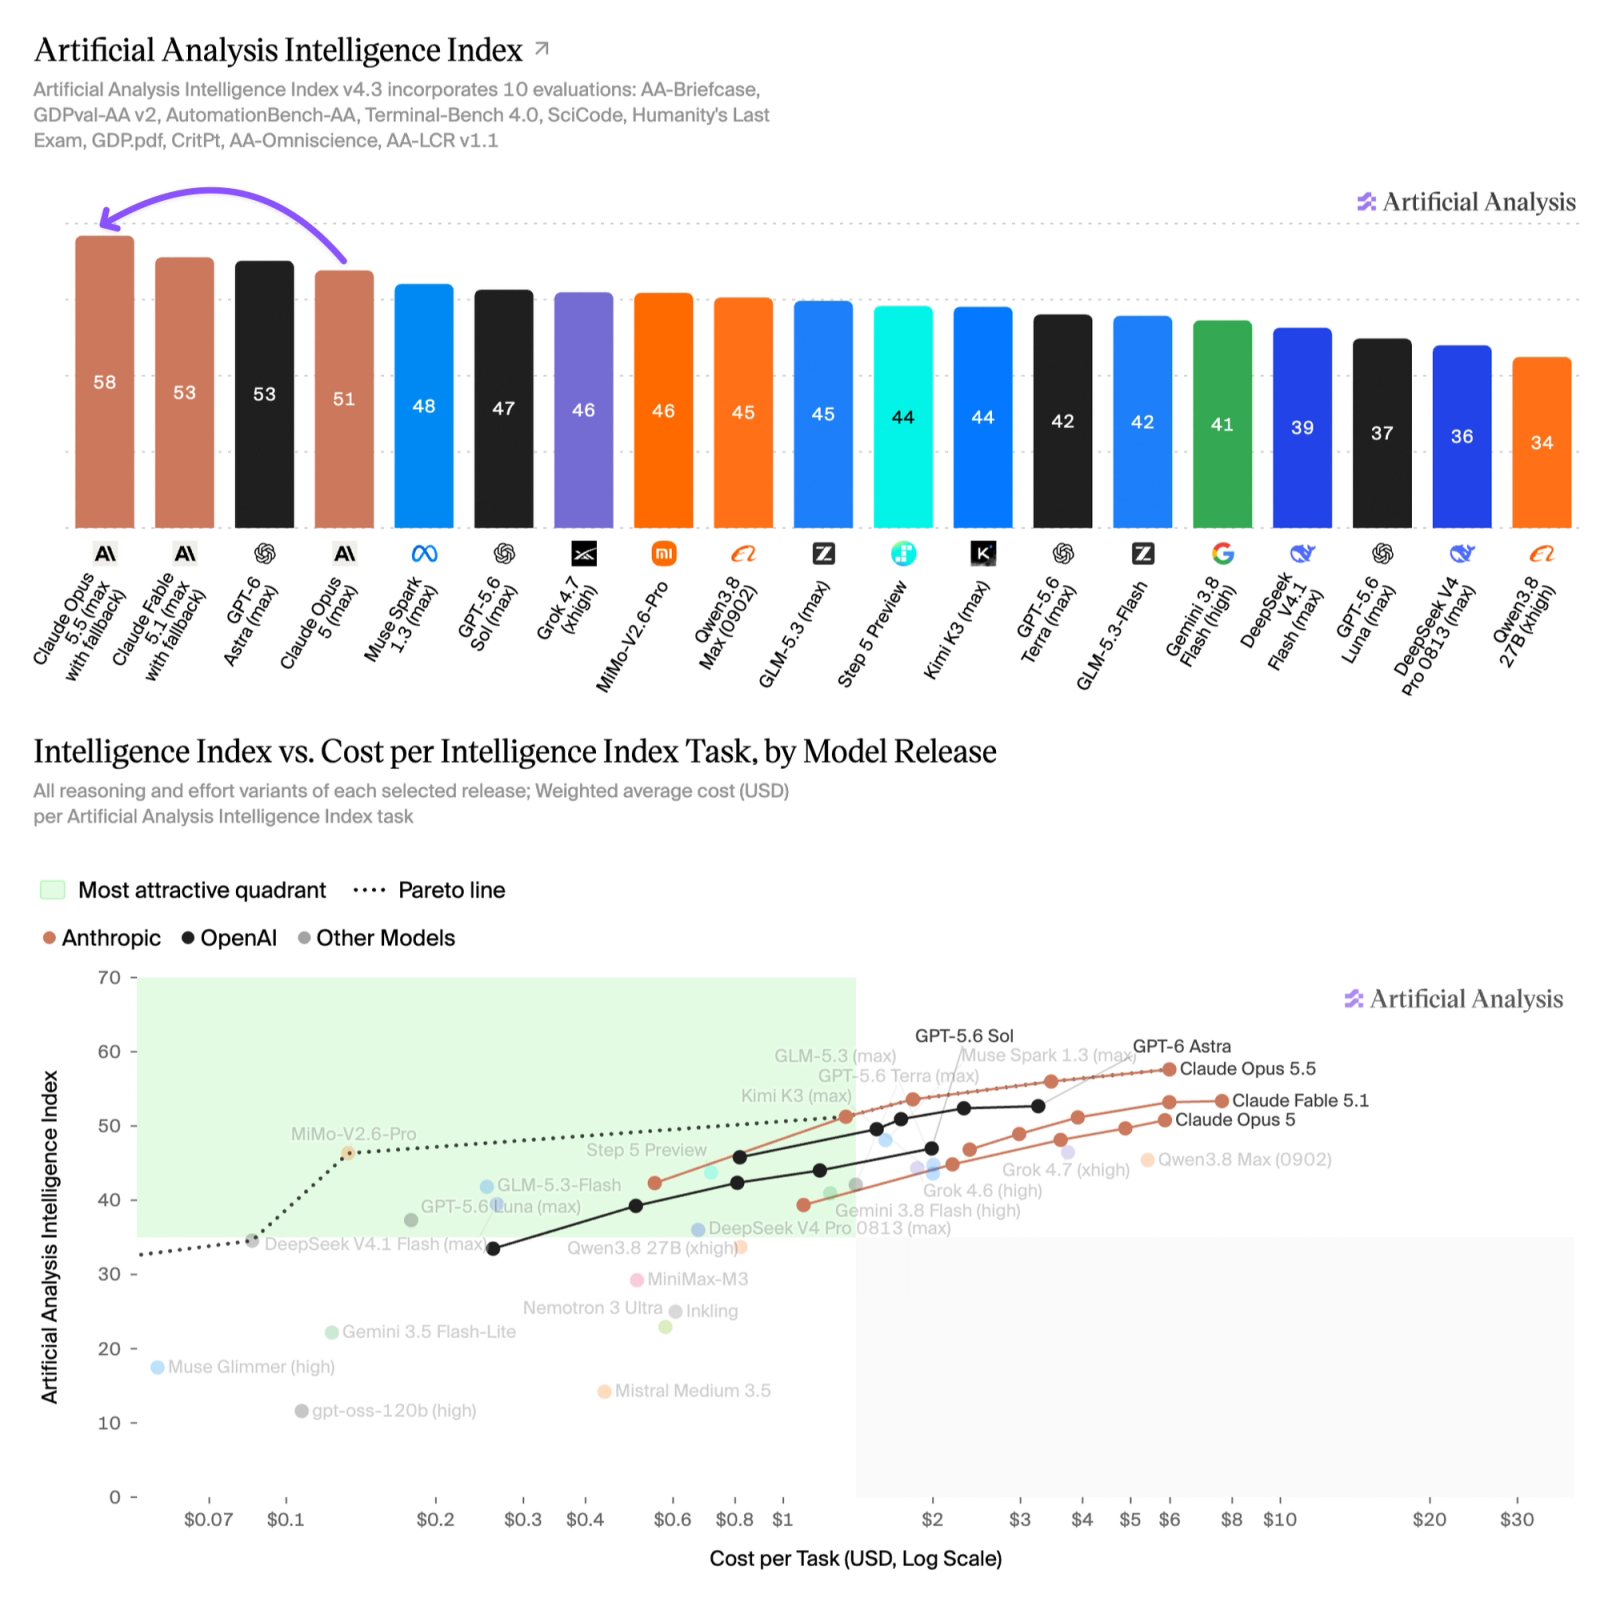
Artificial Analysis, Opus 5.5 Max’i Zekâ Endeksi’nde 58 olarak konumlandırdı ve AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode ve Humanity's Last Exam genelinde güçlü sonuçlar raporladı. Terminal-Bench 4.0 sonucu %59,6 ile Anthropic’in %66,4’ünün altında kalarak, puanlar uyuşmadığında model sürümü, efor ayarı, harness, araçlar, deneme sayısı ve maliyet sınırının belgelenmesi gerektiğini gösterdi.
Fiyat ve Tamamlanan Görev Başına Maliyet Karşılaştırması
CometAPI, resmî tarifelerden daha düşük token fiyatları sunarak geliştiricilerin standart mesaj isteği biçimini kullanarak resmî API ile aynı performansı elde etmesini sağlar.
Token Fiyatlandırması
| Fiyatlar | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Giriş | $4 | $10 |
| Çıkış | $20 | $50 |
| 5 dak. cache write | $5 | $12.50 |
| 1 saat cache write | $8 | $20 |
| Cache read | $0.20 | $0.25 |
| Batch giriş/çıkış | %50 indirim | %50 indirim |
Varsayalım ki bir iş yükü 10 milyon taze giriş token’ı ve 2 milyon çıkış token’ı tüketiyor. Önbellek etkisi yoksa:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Bu varsayımlar altında Opus 5.5, %60 daha ucuzdur. Ancak bu sayı, Opus 5.5’in çalıştırma maliyetinin Opus 5’e göre yaklaşık %40 daha düşük olduğu yönündeki Anthropic ifadesiyle karıştırılmamalıdır.
Bunlar tamamen farklı iki karşılaştırmadır. %40 rakamı, Opus 5.5’in Opus katmanındaki daha düşük fiyatlarını ve Opus 5’e kıyasla görev başına daha az token tüketimini içerir. %60 rakamı ise doğrudan Opus 5.5 ve Fable 5.1’in standart liste fiyatlarının karşılaştırmasından gelir.
Tamamlanan Görev Başına Maliyet
Bir model API’si gerçekte token satmaz. Geliştiriciler tamamlanmış iş satın alır.
Bir kodlama ekibi, bir modelin 6,2 milyon token tüketmesiyle ilgilenmez. Modelin hatayı düzeltip düzeltmediği, migrasyonu tamamlayıp tamamlamadığı, test paketini geçirip geçirmediği veya araştırma görevini bitirip bitirmediği önemlidir.
Anthropic, bunu doğrudan Opus 5.5’te bir görevin maliyeti analizinde ifade eder: Benzer fiyatlı iki model, biri daha fazla tur atıyorsa, daha fazla bağlam tekrar okuyorsa, daha fazla yeniden deneme yapıyorsa veya daha fazla düşünme token’ı üretiyorsa çok farklı görev maliyetlerine sahip olabilir.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Genellikle gözden kaçan son kalem budur. İki kez başarısız olan daha ucuz bir model, görevi tek seferde tamamlayan daha pahalı bir modelden daha maliyetli hâle gelebilir. Benzer şekilde, on yeniden deneme turunu önleyen yüksek efor ayarı toplam maliyeti fiilen düşürebilir.
İstem Önbellekleme Ekonomisi
Önbellek ağırlıklı ajanlar araç tanımlarını, depo bağlamını, sistem talimatlarını, konuşma geçmişini ve test çıktısını tekrar tekrar kullanır. Önbellek okuma fiyatlandırması Opus 5.5 için $0.20/M ve Fable 5.1 için $0.25/M olduğundan, fark taze giriş fiyatlandırmasındaki $6/M farkına göre çok daha küçüktür. Bu nedenle ekipler taze girişi, önbellek okumalarını, önbellek yazılarını, çıkışı, araç turlarını ve yeniden denemeleri ayrı ayrı takip etmelidir.
Efor Düzeyi Ekonomisi
Potansiyel olarak evet. Artificial Analysis, beş Opus 5.5 efor ayarını test etti ve belirgin bir yetenek-maliyet eğrisi buldu.
| Opus 5.5 eforu | Artificial Analysis Intelligence Index | Dizin görevi başına maliyet |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Orta efor, rutin kod değişiklikleri, bilinen refaktörler ve denetimli hata ayıklama için makul bir başlangıç noktasıdır. Belirsiz sistem arızaları, gece boyunca migrasyonlar veya yanlış bir planın önemli yeniden işleme yol açtığı görevlerde high veya xhigh haklı olabilir.
Güvenlik ve Güvenilirlik Karşılaştırması
Hiçbir model salt yetenek kıyaslamalarına dayanarak daha güvenli etiketlenmemelidir. Savunulabilir bir karşılaştırma, eşleşmiş istemleri, araçları, izinleri, efor ayarlarını, yeniden deneme sınırlarını ve kabul kriterlerini gerektirir. Daha yüksek yetenek kazara hataları azaltabilir, ancak daha büyük otonomi ve daha uzun yürütme, kötü bir planın, istem enjeksiyonunun, güvensiz bir araç çağrısının veya fark edilmeyen sapmanın etkisini artırır.
| Güvenlik boyutu | Pratik karşılaştırma | Üretim kontrolü |
|---|---|---|
| Muhakeme ve efor | Opus 5.5 birden fazla efor düzeyi sunar; Fable 5.1 daha yüksek efor duruşundan başlar. Daha fazla muhakeme, politika uygulanmasının yerine geçmez. | Efor politikasını iş yüküne göre sabitleyin ve değiştiğinde güvenlik davranışını yeniden test edin. |
| Uzun süreli otonomi | Fable 5.1 zor, gözetimsiz işler için konumlandırılmıştır; Opus 5.5 de ajanik iş akışlarını destekler. Risk, süre, izinler ve geri döndürülemez eylem sayısıyla artar. | Kontrol noktaları, onay kapıları, süre ve maliyet tavanları, otomatik geri alma veya kapatma koşulları uygulayın. |
| Araç ve bilgisayar kullanımı | Her iki model de araç çalıştırabilir; tek başına model seçimi veri maruziyetini veya yıkıcı eylemleri kontrol etmez. | En az ayrıcalık, allowlist’ler, sandboxing, gizli bilgilerin izolasyonu ve dışsal veya geri döndürülemez eylemler öncesinde onay uygulayın. |
| Değerlendirme ve denetlenebilirlik | Kamuya açık kıyaslama skorları, reddetme kalitesini, istem enjeksiyonu direncini veya üretim olay oranlarını kanıtlamaz. | Araç çağrılarını ve politika kararlarını kaydedin; güvensiz-uyum oranı, yanlış retler, enjeksiyon başarısı, gizli sızıntısı, yıkıcı girişimler ve toparlanma kalitesini ölçün. |
Pratik güvenlik kuralı: görevi karşılayan en az ayrıcalıklı Opus 5.5 yapılandırmasıyla başlayın ve aynı güvenlik paketi geçtiğinde ancak o zaman Fable 5.1’e yükseltin. Yüksek etkili iş akışlarında, hangi modelin yetenek testlerinde daha yüksek puan aldığına bakılmaksızın insan onayı gerektirin.
- Gerçek üretim araç setiyle adversaryal istem enjeksiyonu ve veri sızdırma testleri çalıştırın.
- Geniş bir araç rolü vermek yerine okuma, yazma, yayımlama, silme ve finans izinlerini ayırın.
- Politika ihlalleri, tekrarlanan araç hataları, beklenmedik kapsam genişlemesi ve maliyet aşımları için geri alma tetikleyicileri tanımlayın.
- Model, sistem istemi, efor, araç, izin veya yönlendirme değişikliklerinden sonra yeniden doğrulayın.
Opus 5.5 ile Fable 5.1 Arasında Nasıl Seçim Yapılır?
| İş yükü | Önerilen başlangıç noktası | Yükseltme koşulu |
|---|---|---|
| Günlük kodlama ve kod incelemesi | Opus 5.5, orta efor | Sadece olağandışı zor veya yüksek riskli durumlarda yükseltin |
| Çok dosyalı özellik çalışması | Opus 5.5, orta veya yüksek | Planlama hataları maliyete hakimse Fable kullanın |
| Depo genelinde migrasyon | Önce Opus 5.5 high veya xhigh’ı test edin | En zorlu, gözetimsiz projeler için yükseltin |
| Gecelik otonom çalıştırmalar | Sıkı kontrol noktalarıyla Opus 5.5 | Yanlış yönün maliyeti aşırıysa Fable’ı tercih edin |
| Yüksek hacimli API trafiği | Opus 5.5 | Sadece hataya yatkın azınlık görevleri için yükseltin |
| Mevcut doğrulanmış Fable dağıtımı | Test sırasında mevcut dağıtımı koruyun | Opus aynı kabul eşiğini karşıladıktan sonra geçiş yapın |
Pratik Bir Üretim Testi
Aynı temsilî görevleri, istemleri, araçları, efor politikasını, kabul kriterlerini ve yeniden deneme sınırlarını her iki modelde de çalıştırın. Kabul edilen görev oranını, gecikmeyi, taze ve önbellekli girişi, çıkış ve düşünme token’larını, araç çağrılarını, yeniden denemeleri, insan düzeltmelerini ve kabul edilen sonuç başına toplam maliyeti kaydedin. Rutin görevleri ve zor başarısızlık vakalarını dahil edin.
Mevcut Claude Opus 5 Kullanıcıları İçin Geçiş Rehberi
Mevcut Opus 5 kullanıcıları, model kimliğini risksizce değiştirmenin mümkün olduğunu varsaymak yerine Opus 5.5’i halef olarak test etmelidir. Planlama derinliğini, araç çağrı desenlerini, yanıt uzunluğunu, biçim uyumunu, gecikmeyi, istem önbelleği davranışını, başarısız araç çağrılarından toparlanmayı, güvenlik yönlendirmesini ve tamamlanan görev başına maliyeti karşılaştırın. Opus 5.5 üretime benzer kabul testlerini geçene kadar geri alma kriterlerini koruyun ve mevcut modeli erişilebilir tutun.
Mevcut Fable 5.1 kullanıcılarının genel bir geçiş bölümüne ihtiyacı yoktur. Onlar, Opus 5.5’i bir aday optimizasyon olarak ele almalı ve doğrulanmış bir dağıtımı değiştirmeden önce aynı üretim kabul kriterleri altında değerlendirmelidir.
CometAPI Üzerinden Erişim
Her iki modeli değerlendiren geliştiriciler, Claude Opus 5.5 ve Claude Fable 5.1 ile ilgili CometAPI kılavuzlarını inceleyebilir. Herhangi bir uyumlu API sağlayıcısı üzerinden entegrasyon yaparken, tam model kimliği, desteklenen efor parametreleri, önbellek davranışı, hız sınırları, bölgesel erişilebilirlik ve güncel fiyatlandırmayı üretime geçmeden önce doğrulayın.
Opus 5.5 için claude-opus-5-5 ve Fable 5.1 için claude-fable-5-1 kimliklerini, bu tanımlayıcıların desteklendiği yerlerde kullanın. Her iki iş yükünü de tek bir sabit efor düzeyinden sessizce yönlendirmekten kaçının; model seçimi ve efor politikası bağımsız olarak yapılandırılmalıdır.
Python — CometAPI aracılığıyla Anthropic Messages API
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Sonuç
Claude Opus 5.5, Anthropic’in günlük frontier modeli ile primli yükseltme katmanı arasındaki pratik sınırı değiştiriyor. Standart token oranlarında belirgin ölçüde daha ucuz, yayımlanan birçok kodlama ve ajanik kıyaslamada önde ve geniş bir üretim yelpazesini kapsayacak kadar efor esnekliği sunuyor.
Claude Fable 5.1, görev zor, yüksek değerli, uzun süreli veya gözetimsiz olduğunda ve hatanın maliyeti daha yüksek çıkarım faturasından ağır bastığında önemini korur. Çoğu ekip için en iyi politika Opus 5.5 ile başlamak, tamamlanan görev sonuçlarını ölçmek ve seçici biçimde yükseltmektir.
SSS
Opus 5.5 ile Fable 5.1 için üretim A/B testi nasıl tasarlanmalı?
Her iki model için de aynı temsilî görevleri, istemleri, araçları, efor politikasını, kabul kriterlerini ve yeniden deneme sınırlarını kullanın. Kabul edilen görev oranını, gecikmeyi, taze ve önbellekli girişi, çıkış ve düşünme token’larını, araç çağrılarını, yeniden denemeleri, insan düzeltmelerini ve kabul edilen sonuç başına toplam maliyeti kaydedin. Rutin işleri ve zor başarısızlık vakalarını kapsayacak kadar çok görev çalıştırın.
Daha düşük token fiyatlandırması ne zaman toplam görev maliyetini düşürmeyebilir?
Daha düşük fiyatlı bir model, daha fazla tur atarsa, bağlamı yeniden okursa, daha çok düşünme token’ı üretirse veya tekrar tekrar yeniden denemeye ihtiyaç duyarsa yine daha pahalıya mâl olabilir. Önbellek davranışı da önemlidir: giriş fiyatı farkı, önbellek okumalarının egemen olduğu uzun oturumlarda daralır. Sadece liste fiyatına değil, tamamlanan görev maliyetine göre karşılaştırın.
Kıyaslama sonuçları uyuşmadığında neler belgelenmeli?
Model sürümü, efor düzeyi, harness, geri dönüş ve güvenlik ayarları, deneme sayısı, görev sürümü, standart hata ve maliyet tavanını kaydedin. Her sonucu resmî veya bağımsız olarak etiketleyin ve eşleşmemiş yapılandırmalardan gelen skorları tek bir sıralamada birleştirmekten kaçının.
Mevcut Fable 5.1 kullanıcılarının izlemesi gereken geçiş riskleri nelerdir?
Planlama derinliği, araç çağrı desenleri, yanıt uzunluğu, biçim uyumu, gecikme, istem önbelleği davranışı, hatadan toparlanma ve güvenlik yönlendirmelerindeki değişiklikleri izleyin. Değerlendirme sırasında mevcut dağıtımı erişilebilir tutun, geri alma kriterleri belirleyin ve yalnızca Opus 5.5 üretime benzer kabul eşiklerini karşıladıktan sonra geçiş yapın.
SEO Meta Verileri
Meta başlık: Claude Opus 5.5 vs Fable 5.1: Kod, Maliyet ve Kıyaslamalar
Meta açıklama: Compare Claude Opus 5.5 ve Claude Fable 5.1’i kodlama kıyaslamaları, API fiyatlandırması, hız, önbellekleme, efor ayarları, tamamlanan görev maliyeti ve iş yükü uyumu açısından karşılaştırın.
Anahtar kelimeler: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude kodlama kıyaslamaları, Claude API fiyatlandırması, CometAPI, AI kodlama modelleri
URL slug: claude-opus-5-5-vs-claude-fable-5-1