
Kısaca
OpenAI Responses araçlarını zaten kullanıyorsanız veya açık akıl yürütme çaba basamaklarına ihtiyaç duyuyorsanız GPT-6.1 Sol ile başlayın; iyi sınırlandırılmış kodlama yinelemeleri ve şablon odaklı profesyonel teslimatlar için Claude Sonnet 5.5’i test edin. Bunlar kanıtlanmış bir kalite sıralaması değil, değerlendirme öncelikleridir. Her ikisi de $2/M girdi ve $10/M çıktıdan başlar ve temel önbellek okumaları için $0.10/M ücret alır. Yaklaşık 1M bağlam ve 128K standart maksimum çıktı ile pratik farklar, bir temel önbellek-okuma indiriminden ziyade entegrasyon, görev davranışı, önbellek saklama ve uzun bağlam faturalandırmasıdır.
Temel değiş tokuş, görev davranışı ve faturalandırma koşullarıdır. GPT-6.1 Sol beş çaba düzeyi kullanır ve araç çağırma için Responses gerektirir; Sonnet 5.5 uyarlanabilir düşünme kullanır. 272K girdi belirtecinin üzerinde GPT-6.1 Sol, daha yüksek oranları tüm isteğe uygular. Burada incelenen kaynaklar, eşleşmiş ve tam sürüm karşılaştırmasında bir kazananı ortaya koymamaktadır; bu nedenle kabul kriterlerinizi en düşük toplam iş akışı maliyetiyle karşılayan modeli seçin.
Temel Çıkarımlar
- Eşit temel fiyatlar: her iki model de $2/M girdi, $10/M çıktı ve $0.10/M önbellek okuma ücretine sahiptir. Önbellek yazma, saklama, uzun bağlam kademeleri ve fiili faturalandırılan kullanımı karşılaştırın.
- Bağlam yakın: 1.05M ve 1M belirteç; her ikisi de 128K standart maksimum çıktıyı destekler.
- Entegrasyon farklı: GPT-6.1 Sol araç çağırma için Responses gerektirir ve none veya minimal kabul etmez; Sonnet 5.5 uyarlanabilir düşünme ve modele özgü araç kısıtları kullanır.
- Kanıtı sürüme özgü tutun: GPT-6 Sol puanları GPT-6.1 Sol sonuçları olarak etiketlenemez.
- Tamamlanan işle göre seçin: kalite, gecikme, yeniden denemeler, önbellek yazma/okuma, araç ücretleri ve insan düzeltmesini ölçün.
GPT-6.1 Sol vs Claude Sonnet 5.5 Bir Bakışta
| Karar faktörü / özellik | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Sağlayıcı | OpenAI | Anthropic |
| Yayın tarihi | 29 Eylül 2026 | 28 Eylül 2026 |
| Model ID | gpt-6.1-sol | claude-sonnet-5-5 |
| Bağlam / standart maksimum çıktı | 1,050,000 / 128,000 belirteç | 1,000,000 / 128,000 belirteç |
| Girdi → çıktı | Metin ve görseller → metin | Metin ve görseller → metin |
| Akıl yürütme kontrolleri | low, medium, high, xhigh, max; varsayılan medium | Uyarlanabilir düşünme; Claude Platform’da varsayılan high |
| Varsayılan çaba | medium | Claude Platform’da high |
| Bilgi kesim tarihi | 30 Nisan 2026 | Haziran 2026 |
| Resmi temel girdi/çıktı 1M belirteç başına | $2 / $10; 272K girdi belirtece kadar Standart istekler | $2 / $10 |
| Resmi temel önbellek okuma 1M başına | $0.10 | $0.10 |
| Resmi temel önbellek yazma 1M başına | $2.50 | 5 dakika için $2.50; 1 saat için $4.00 |
| Uzun bağlam faturalandırması | 272K girdinin üzerinde: 1M başına $4 girdi, $0.20 önbellek okuma, $5 önbellek yazma, $15 çıktı; tüm Standart isteğe uygulanır | Alıntılanan model özetinde eşdeğer ek ücret belirtilmemiş |
| Birincil konumlandırma | Karmaşık kodlama, bilgisayar kullanımı ve profesyonel işler | Hızlı kodlama yinelemesi ve profesyonel iş akışları |
| Önce test edin ne zaman | Responses araçlarını zaten kullanıyorsanız veya açık çaba kontrollerine ihtiyacınız varsa | İşiniz kodlama, belgeler, slaytlar veya elektronik tablolar etrafında dönüyorsa |
| Kanıt ve karar sınırı | Belgelendirilmiş yetenekler; burada eşleşmiş tam sürüm sayısal kazanan kurulmamıştır | Yayınlanan kodlama ve bilgi-işi sonuçları; GPT-6.1 Sol üzerinde kontrollü bir üstünlük değil |
GPT-6.1 Sol Genel Bakış
GPT-6.1 Sol, karmaşık kodlama, bilgisayar kullanımı ve profesyonel işler için OpenAI’nin 29 Eylül 2026 tarihli Sol sürümüdür. OpenAI, bunu daha düşük maliyetle Astra’ya yakın performans olarak tanımlar; bu konumlandırma, görevlerinizde doğrulanmalıdır. Geniş bağlamı ve ayarlanabilir akıl yürütmesi, depo ajanları ve çok adımlı profesyonel iş akışları için uygun bir aday yapar.
Operasyonel kısıtlar konumlandırma kadar önemlidir: varsayılan çaba medium’dur, en düşük desteklenen ayar low’dur ve araç çağırma Responses gerektirir. Akıl yürütmesiz bir yol veya Chat Completions araçları etrafında kurulmuş bir iş akışı, bu modeli güvenilir biçimde kullanmadan önce geçiş çalışması gerektirir.
Claude Sonnet 5.5 Genel Bakış
Claude Sonnet 5.5, iyi sınırlandırılmış günlük kodlama, ajanlar ve profesyonel işler için Anthropic’in 28 Eylül 2026 sürümüdür. Model özeti uyarlanabilir düşünmeyi, Claude Platform’da yüksek varsayılan çabayı, metin ve görsel girdi desteğini ve 128K standart maksimum çıktıyı belgeler. Anthropic, hata düzeltme, net belgeler, cilalı slaytlar ve verimli yinelemeyi vurgular.
Bir geliştirme ekibi için bu, tekrarlanan uygulama ve inceleme döngüleri açısından Sonnet’i kullanışlı bir aday yapar. Ofis iş akışında da ilk taslak kalitesini ve şablona uyumu değerlendirin. Sağlayıcının hız iddiası, Sonnet 5.5’i Sonnet 5 ile karşılaştırır; GPT-6.1 Sol üzerinde bir hız avantajı ortaya koymaz.
GPT-6.1 Sol vs Claude Sonnet 5.5: Performans
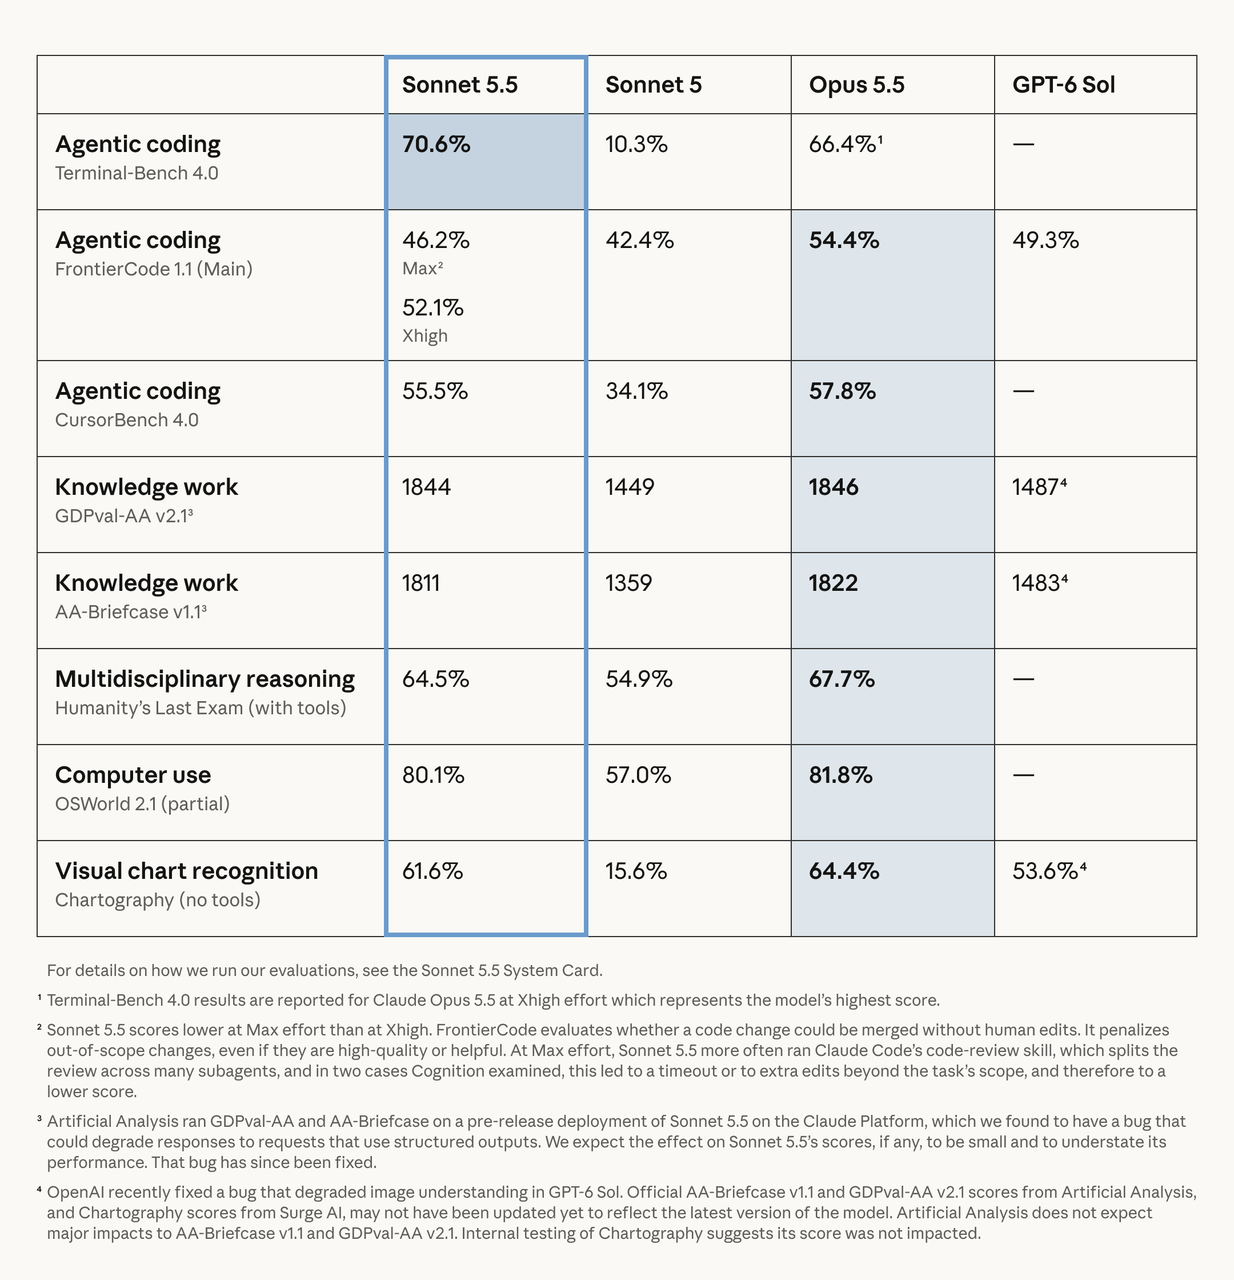
Anthropic’in Sonnet 5.5 lansman sonuçları yararlı bir iş yükü sinyali seti sunar. Karşılaştırma, daha eski GPT-6 Sol’u içerir; bu nedenle OpenAI sütunundaki değerler aşağıdaki güncel-model tablosundan hariç tutulmuştur. “Burada belirlenmedi” ifadesi, alıntılanan kaynakların bu karşılaştırma için tam sürüm eşleşmesine sahip bir puanı desteklemediği anlamına gelir; sıfır performans anlamına gelmez.
| Kıyas / koşullar | GPT-6.1 Sol | Claude Sonnet 5.5 | Ne ölçüyor |
|---|---|---|---|
| Terminal-Bench 4.0 | Burada belirlenmedi | 70.6% | Terminal kodlama görevleri |
| FrontierCode 1.1 Main | Burada belirlenmedi | 52.1% Xhigh; 46.2% Max | Birleştirilebilir depo değişiklikleri |
| CursorBench 4.0 | Burada belirlenmedi | 55.5% | Cursor görevlerinde ajan geliştirme |
| GDPval-AA v2.1 | Burada belirlenmedi | 1844 | Profesyonel bilgi işi |
| AA-Briefcase v1.1 | Burada belirlenmedi | 1811 | Uzun ufuklu bilgi işi |
| Humanity’s Last Exam, araçlar | Burada belirlenmedi | 64.5% | Disiplinlerarası akıl yürütme |
| OSWorld 2.1, kısmi | Burada belirlenmedi | 80.1% | Bilgisayar kullanımı kısmi ödül |
| Chartography, araçsız | Burada belirlenmedi | 61.6% | Görsel grafik tanıma |
Test koşulları: çaba ve ajan kurgusu kodlama sonuçlarını etkiler. GDPval-AA ve AA-Briefcase, Artificial Analysis değerlendirmeleridir; Chartography sonuçları ise Surge AI’dan gelir. Anthropic, ön sürüm Sonnet dağıtımındaki bir yapılandırılmış çıktı hatasının daha sonra düzeltildiğini ve bunun profesyonel iş sonuçlarını biraz olduğundan düşük göstermiş olabileceğini belirtir. Test ortamları ve tam metodoloji için duyurudaki System Card bağlantısını kullanın; farklı ölçümleri tek bir genel sıralamaya dönüştürmeyin.
Orijinal Anthropic görseli aşağıda yer alır ve değerlendirme dipnotlarını içerir. GPT-6 Sol sütunu yalnızca tarihsel bağlamdır ve GPT-6.1 Sol performansını raporlamaz.
Ajan Tabanlı Kodlama ve Yazılım Mühendisliği
Sonnet 5.5’in terminal kodlama, birleştirilebilir kod değişiklikleri ve IDE tarzı ajan görevleri üzerinde raporlanmış kanıtı vardır. GPT-6.1 Sol, karmaşık kodlama için belgelidir ve OpenAI araç ekosistemiyle bütünleşir. Ne ürün konumlandırması ne de bir selefin puanı mevcut bir kodlama galibini kanıtlar. Faydalı bir değerlendirme için, regresyon testlerine sahip gerçek değişiklikleri seçin ve kapsam, sürdürülebilirlik ve birleştirmeye hazır olma açısından değerlendirilmelerini isteyin.
Bilgi İşi, Akıl Yürütme, Matematik ve Bilim
Sonnet’in GDPval-AA ve AA-Briefcase sonuçları, raporlar, analizler ve ofis teslimatlarını makul değerlendirme hedefleri yapar. GPT-6.1 Sol da profesyonel işleri hedefler, ancak burada kullanılan kaynaklar bu modeller arasında eşleşmiş bir karşılaştırma sağlamaz. Kendi belge, elektronik tablo ve sunum şablonlarınızı kullanın. İleri matematik ve bilimsel iddialar, genel akıl yürütme kontrollerinden çıkarım yapmak yerine göreve özgü kanıt gerektirir.
Bilgisayar Kullanımı, Tarayıcı Otomasyonu ve Çok Modlu İş Akışları
Her iki model de görselleri kabul eder; bu, ekran görüntüsüyle hata ayıklama ve görsel analiz sağlar. Sonnet’in OSWorld ve Chartography sonuçları, bu özel değerlendirmeler için kanıttır. GPT-6.1 Sol, bilgisayar kullanımını Responses araçları üzerinden belgelendirir. Tüm iş akışını test edin: gezinme doğruluğu, başarısız araç çağrısından kurtarma, çıktı doğruluğu ve tamamlanma süresi. Metin ve görsel girdi desteği tek başına aynı bilgisayar kullanımı entegrasyonunu garanti etmez.
Bağımsız Değerlendirme ve Kanıt Kalitesi
Bir sağlayıcı tarafından yayınlanan bir tablo, üçüncü taraf sonuçlarını içerebilir; bu onu tek bir kontrollü deney haline getirmez. Herhangi bir bağımsız karşılaştırma için tam model ID’leri, dağıtım tarihleri, çaba, araçlar, korumalar, zaman aşımı, yeniden deneme politikası ve durdurma kurallarını kaydedin. Bir toplam zekâ endeksi, bir kodlama başarı oranı ve bilgisayar kullanımı için kısmi ödül puanı farklı soruları yanıtlar. İncelenen kaynaklar, bu çifti tam eşleşmiş bağımsız bir sonuç setiyle kapsamaz.
GPT-6.1 Sol vs Claude Sonnet 5.5: Maliyet
Resmi API Fiyatlandırması
| Fiyatlandırma metriği | GPT-6.1 Sol resmi oranlar | Claude Sonnet 5.5 resmi oranlar |
|---|---|---|
| Girdi / 1M belirteç, temel Standart | $2.00 | $2.00 |
| Çıktı / 1M belirteç, temel Standart | $10.00 | $10.00 |
| Önbellek okuma / 1M belirteç, temel | $0.10 | $0.10 |
| Önbellek yazma / 1M belirteç, temel | $2.50 | 5 dk için $2.50; 1 saat için $4.00 |
| Toplu işleme | Standartın %50 altında | Girdi/çıkışta %50 indirim |
| 272K üzeri girdi, Standart tam istek | 1M başına $4 girdi / $0.20 önbellek okuma / $5 önbellek yazma / $15 çıktı | Alıntılanan özetten eşdeğer ek ücret belirtilmemiş |
Tüm oranlar milyon belirteç başına USD cinsindendir. GPT-6.1 Sol temel önbellek okumaları $0.10/M ve Sonnet 5.5 önbellek okumaları da $0.10/M tutar. Sol’un 272K üzeri girdi koşulu, oranları yalnızca fazla belirteçlere değil, tüm Standart isteğe yükseltir. Önbellek yazma, saklama, uzun bağlam kademeleri, bölgesel işleme ve hizmet kademelerini karşılaştırın; temel okuma fiyatı tek başına hiçbir modele avantaj sağlamaz.
Tamamlanan Görev Başına Maliyet
Kabul edilen sonuç başına maliyet = tüm denenen görevlerdeki toplam maliyet / kabul edilen sonuç sayısı. Toplam maliyet; faturalandırılan taze girdi, önbellek okumaları ve yazmaları, çıktı (varsa faturalandırılan akıl yürütme belirteçleri dahil), ücretli araç çağrıları ve insan incelemesi veya düzeltmesini içerir. Yeniden deneme maliyetleri, mükerrer bir ücret gibi ayrıca eklenmek yerine fiili kullanımlarıyla sayılır.
Tamamı temel oranda faturalandırılan bir milyon önbellek okuma belirteci için her iki model de $0.10 tutar; temel okuma fiyatı farkı $0.00’dır. Bu bir oran örneğidir; bir milyon girdili bir Sol isteğinin temel kademede fiyatlandırıldığı anlamına gelmez. Gerçek oturum maliyeti taze girdi, önbellek yazma, çıktı, araçlar ve yeniden denemeleri de içerir. Uygulanan bağlam kademesi altındaki soğuk ve sıcak oturumları karşılaştırın ve kabul edilen-sonuç oranını faturalandırılan kullanımın yanında raporlayın.
CometAPI Fiyatlandırması
| Yayınlanan CometAPI katmanı | CometAPI’de GPT-6.1 Sol API | CometAPI’de Claude Sonnet 5.5 API |
|---|---|---|
| Temel girdi/çıktı 1M başına | $1.60 / $8.00 | $1.60 / $8.00 |
| Sağlayıcıya göre temel indirim | %20 | %20 |
| GPT uzun bağlam girdi/çıkış | $3.20 / $12.00 | Mevcut rota-özel koşulları kontrol edin |
| GPT önbellek okuma, temel/uzun | $0.08 / $0.16 | Alıntılanan temel tabloda belirtilmemiş |
Bunlar, bu revizyon için kontrol edilen, sağlayıcı oranlarından ayrı yayınlanmış model-rota fiyatlarıdır. GPT-6.1 Sol’un CometAPI fiyatlandırması kısa ve uzun bağlamı ayırır. Alıntılanan Sonnet temel tablosu girdi ve çıktıyı listeler; bu, aynı ağ geçidi önbellek politikasını varsaymayı gerekçelendirmez. Üretim maliyeti tahmini yapmadan önce seçilen rotanın güncel faturalandırma koşullarını kontrol edin.
Bağlam Pencereleri, Hız ve Teknik Özellikler Nasıl Karşılaştırılır?
GPT-6.1 Sol 1.05M belirteci, Claude Sonnet 5.5 ise 1M belirteci destekler. Nominal fark yalnızca yaklaşık %5’tir; bu nedenle bağlam kapasitesi tek başına çoğu dağıtımı belirlemez.
GPT-6.1 Sol’un çaba merdiveni low, medium, high, xhigh ve max’tır; varsayılan medium’dur. Sonnet 5.5 uyarlanabilir düşünme kullanır ve Claude Platform’da varsayılan high’tır. Bu adlar eşit akıl yürütme bütçelerini ima etmez. Eşdeğer kalite gereksinimlerinde, ilk belirtece kadar geçen zaman, çıktı aktarım hızı, araç döngüsü gecikmesi ve uçtan uca tamamlamayı ayrı ayrı ölçün.
Anthropic, Sonnet 5.5’in Sonnet 5’e göre çıktı üretiminde %30’dan fazla hızlandığını bildirir. Bunu selef karşılaştırması olarak ele alın. Bu yazının kanıtları GPT-6.1 Sol için tek bir evrensel gecikme değeri veya mevcut modeller arasında doğrudan bir hız kazananı ortaya koymaz. Etkileşimli iş yükleri için, en iyi dağıtım ayarı olduğu varsayılmak yerine, aynı kabul ölçütüne karşı daha düşük çaba ayarlarını test edin.
Güvenlik, Uyum ve Dağıtımda Ne Önemlidir?
Dağıtım kararları, belgelenmiş model davranışını uygulama kontrollerinden ayırmalıdır. Tek başına bir model karşılaştırması, hangi dağıtımın kuruluşunuzun veri işleme veya erişim gereksinimlerini karşıladığını kanıtlayamaz. Kullandığınız sağlayıcı veya ağ geçidini; istek günlüğe alma, veri yerleşimi, araç izinleri ve hata yönetimi dahil değerlendiriniz.
- Akıl yürütme geçişi: GPT-6.1 Sol none veya minimal’ı desteklemez. OpenAI’nin geçiş rehberi, araç çağırma iş akışlarını Responses’a yönlendirir.
- Claude araç davranışı: Sonnet 5.5’in belgelenmiş uyumluluk değişiklikleri, desteklenmeyen zorunlu araç kipleri ve sohbete bağlı düşünme bloklarını içerir. Bu yolları yayına almadan önce test edin.
- Operasyonel kontroller: ajanlara yalnızca görev için gerekli araçları verin, başarısız çağrıları kaydedin ve dış dünyaya yönelik sonuç doğuran eylemler için insan incelemesini koruyun. Bunlar uygulama tasarım seçimleridir; herhangi bir model için ölçülmüş bir avantaj değildir.
GPT-6.1 Sol vs Claude Sonnet 5.5: Hangisini Seçmelisiniz?
Responses araçlarını zaten kullanıyor veya öngörülebilir bir çaba merdivenine ihtiyaç duyuyorsanız önce GPT-6.1 Sol’u test edin. İyi sınırlandırılmış kodlama yinelemesi, slaytlar, elektronik tablolar ve belgeler için Sonnet 5.5’i test edin; raporlanan kanıtlar görevlerinizle eşleştiğinde faydalıdır. Önbellekli-önek oturumlarında ikisini de test edin: temel önbellek okuma oranları eşittir; ancak yazma maliyetleri, saklama, uzun bağlam kademeleri ve görev başarısı toplam faturayı değiştirebilir. Temsil gücü olan değerlendirmeler fayda, maliyet veya gecikme farkı kurduktan sonra işi yönlendirin.
İş Yüküne Dayalı Seçim
| İş yükü | Başlangıç noktası | Doğrulanacaklar |
|---|---|---|
| Mevcut OpenAI Responses ajanı | GPT-6.1 Sol | Araç uyumluluğu ve çaba değişiklikleri |
| Kodlama yinelemesi / hata düzeltme | Önce Sonnet 5.5, sonra Sol ile karşılaştırın | Birleştirme hazırlığı, gecikme ve yeniden denemeler |
| Slaytlar / elektronik tablolar / raporlar | Önce Sonnet 5.5, sonra Sol ile karşılaştırın | Şablona uyum ve insan düzenleme süresi |
| Kararlı önbelleğe alınmış önek oturumları | Her ikisi; eşit temel önbellek okuma oranları | İsabet oranı, yazmalar, bağlam kademesi ve kabul edilen kalite |
| 272K üzeri girdi içeren tam istekler | Her ikisi | Fiili uzun bağlam faturası ve getirme kalitesi |
| Bilgisayar / tarayıcı otomasyonu | Her ikisi | Kurtarma, görev tamamlama ve izinler |
| Matematik / bilimsel analiz | Göreve özgü testlerde her ikisi | Doğrulanabilir cevaplarla doğruluk |
| Maliyete duyarlı üretim | Her ikisi | Kabul edilen sonuç başına toplam maliyet |
Bir üretim karşılaştırması çevredeki sistemi sabit tutmalıdır. Aynı komutları, depoları veya belgeleri, araç izinlerini, zaman aşımı ve yeniden deneme politikasını ve çıktı kabul ölçütlerini kullanın.
Taze girdi, önbellek yazma ve okumaları, çıktı kullanımı, ücretli araç çağrıları, yeniden denemeler, insan inceleme süresi, görev başarısı ve uçtan uca gecikmeyi kaydedin. Daha ucuz bir ilk yanıt, daha pahalı bir kabul edilen sonuca yol açabilir.
GPT-6.1 Sol ve Claude Sonnet 5.5’e Nasıl Erişebilirsiniz?
Geliştiriciler, belgelenmiş model rotaları üzerinden CometAPI’deki GPT-6.1 Sol API’sine ve CometAPI’deki Claude Sonnet 5.5 API’sine erişebilir. Bir API anahtarı oluşturun, güvenle saklayın ve üretim öncesi model erişimini ve rota-özel faturalandırmayı doğrulayın.
GPT-6.1 Sol Erişimi
Sol için, araç çağırma gerektiğinde belgelenmiş Responses rotasını kullanın. gpt-6.1-sol ve desteklenen bir çaba düzeyini seçin; varsayılan medium’dur. Görev girdisini iletin, yalnızca gerekli araçları yapılandırın ve dönen metni, araç çağrılarını, hataları ve kullanımı doğrulayın. Her OpenAI seçeneğinin mevcut olduğunu varsaymak yerine sağlayıcıya özgü özellikler için ağ geçidi desteğini teyit edin.
Claude Sonnet 5.5 Erişimi
Sonnet için, belgelenmiş uyumlu bir arayüzde claude-sonnet-5-5’i seçin ve görevi uygun bir çıktı bütçesi ile konuşma mesajları olarak gönderin. Bu rotanın yerel düşünme ve araç parametrelerini nasıl ele aldığını doğrulayın; OpenAI akıl yürütme alanları Claude seçenekleriyle otomatik olarak birbirinin yerine geçmez. Ajan dağıtımından önce konuşma devamlılığını ve hata yönetimini doğrulayın.
Bir uç nokta kontrolü bağlantıyı doğrular; karşılaştırmalı performansı değil. Değerlendirme için komutları, etkin çıktı ve akıl yürütme bütçelerini, araçları, yeniden denemeleri, zaman aşımlarını ve kabul kriterlerini hizalayın; ardından kabul edilen iş, gecikme ve toplam fatura edilen maliyeti karşılaştırın.
Sonuç
GPT-6.1 Sol ve Claude Sonnet 5.5 aynı temel girdi, çıktı ve önbellek okuma oranlarını paylaşır ve benzer bağlam kapasitesine sahiptir. Sol, mevcut Responses ajanları ve açık çaba kontrolleri için doğal bir adaydır. Sonnet’in uyarlanabilir düşünmesi ve raporlanan kodlama ile profesyonel iş sonuçları, onu günlük teslimatlar için kullanışlı bir aday yapar. Önbellek ağırlıklı iş akışlarında tam oturum karşılaştırması gerekir: eşit temel okuma oranları, eşit yazma, saklama, uzun bağlam veya tamamlanan görev maliyetlerini garanti etmez.
Kalite, gecikme ve maliyet gereksinimleriniz içinde gerçek işinizi tamamlayan modeli seçin. Selef puanlarını güncel model kanıtlarından ayrı tutun, iş yükünüzün kullandığı bağlam kademesini fiyatlayın ve varsayılanı benimsemeden önce her iki rotayı da karşılaştırın.
SSS
GPT-6.1 Sol ve Sonnet 5.5 tek bir araç şemasını paylaşabilir mi?
Ortak bir JSON araç tanımı başlangıç noktası olabilir; ancak uç nokta desteği, zorunlu araç davranışı, düşünme blokları ve yanıt işleme farklıdır. Her modelin araç çağrılarını bağımsız sözleşme testleriyle (argümanlar, hata yolları ve sohbet devamlılığı) doğrulayın. Başarılı bir metin isteğinin ajan uyumluluğunu kanıtladığını varsaymak yerine desteklenmeyen seçenekler için modele özgü adaptörler kullanın.
Her iki modelde akıl yürütme çabası nasıl eşleştirilmelidir?
Aynı adlandırılmış ayarları eşdeğer hesaplama bütçeleri olarak değerlendirmeyin. Bir kabul ölçütü ve bir maliyet sınırı veya gecikme hedefi tanımlayın; ardından her model için çaba ayarlarını tarayın. Yalnızca her iki modelin en yüksek ayarlarını karşılaştırmak yerine, aynı operasyonel kısıtı karşılayan en iyi yapılandırmayı (yeniden denemeler ve insan düzeltmesi dahil) karşılaştırın.
1M bağlamlı bir iş akışı ne zaman bunun yerine geri getirme (retrieval) kullanmalıdır?
Bir görev büyük bir korpusun küçük, tanımlanabilir bir kısmına ihtiyaç duyduğunda ve geri getirme testleriniz ilgili materyali tutarlı biçimde bulduğunda geri getirmeyi kullanın. Kanıt dağıtılmış veya dosyalar arası ilişkiler önemli olduğunda tam bağlam isteklerini test edin. Yanıt doğruluğunu, atıf kapsamını, girdi maliyetini ve gecikmeyi karşılaştırın; büyük bağlam sınırı tek başına pencereyi tamamen doldurmanın ekonomik veya güvenilir olduğunu kanıtlamaz.
Ekipler yanıltıcı bir önbellek-maliyet karşılaştırmasından nasıl kaçınabilir?
Soğuk ve sıcak önbellek çalıştırmalarını ayrı ölçün, önbellek yazmaları kadar okumaları da kaydedin ve doğru saklama penceresi ile uzun bağlam kademesini uygulayın. Paylaşılan önekleri stabil tutun ve tek bir indirimli istek yerine tekrarlanan gerçekçi oturumları karşılaştırın. Görünen tasarrufu yeniden üretebilmek için isabet oranını ve toplam faturalandırılan kullanımı raporlayın.
Yeni bir GPT-6.1 Sol vs Sonnet 5.5 değerlendirmesini ne tetiklemelidir?
Bir dağıtım güncellemesi, sağlayıcı hata düzeltmesi, yönlendirme değişikliği, araç veya komut değişikliği ya da önemli bir fiyatlandırma revizyonu sonrasında etkilenen görev setini yeniden çalıştırın. Değerlendirme tarihi, model ID’si, uç nokta, çaba ve çerçeve sürümünü kaydedin. Önceki çalışmayı temel çizgi olarak koruyun; böylece kalite veya gecikme değişiklikleri çevre sistemdeki değişikliklerle karıştırılmaz.