
TL;DR
DeepSeek-V4.1-Flash açık ağırlıklıdır ve kendi başınıza barındırabilirsiniz, ancak “yerel” ifadesi “oyuncu PC’sinde” anlamına gelmez. DeepSeek, modeli Causal Encoder-Decoder mimarisini kullanan bir 552B-parametre Uzman Karışımı (MoE) omurgası olarak tanımlar; istem ön işleme sırasında yalnızca 8B, üretim sırasında 16B parametre aktiftir. Tam model hâlâ sınır ölçekli bir dağıtım hedefidir.
Mevcut vLLM dağıtım tarifi kontrol noktasını diskte yaklaşık 511 GB ve minimum yaklaşık 614 GB VRAM olarak konumlandırır; bu da 8×H200 sınıfı bir sunucuyu veya karşılaştırılabilir yüksek bellekli bir sistemi tüketici iş istasyonlarına göre çok daha gerçekçi kılar.
Sadece erişime ihtiyaç duyan, ağırlık düzeyi kontrol gerektirmeyen ekipler için CometAPI’deki DeepSeek V4.1 Flash API, çoklu GPU çıkarım sunucusunu sürdürmekten önemli ölçüde daha basittir.
Öne Çıkarımlar
- DeepSeek-V4.1-Flash, girişte 8B ve çıkışta 16B etkin parametre kullanan 552B MoE omurgaya sahiptir; etkin parametreler yerleşik bellek gereksinimini temsil etmez.
- 1.048.576 token’lık bağlam penceresi ve token başına 890 baytlık global KV önbelleği, önbellek baskısını azaltır; ancak kapasite planlamasında model ağırlıkları hâlâ baskındır.
- Resmî kontrol noktası diskte yaklaşık 511 GB’tır. vLLM tarifi, modeli ve çalışma zamanı ek yükünü yüklemek için minimum yaklaşık 614 GB toplam kullanılabilir VRAM tahmin eder; bu, her yığın boyutu, bağlam uzunluğu veya çok modlu yapılandırma için garanti değil, temel bir tahmindir.
- vLLM, en net üretim sunum yoludur; SGLang gelişmiş dağıtık çıkarımı hedefler; Ollama’nın mevcut rotası tam yerel çıkarımdan ziyade bulut barındırmalıdır.
- Kendi barındırmanız; gizlilik, hava boşluklu operasyonlar, ağırlık düzeyi araştırma veya sürekli küme kullanımı için en çekici seçenektir; çoğu geliştirici barındırılan bir API’yi daha basit bulacaktır.
DeepSeek-V4.1-Flash Nedir? Mimari, Parametreler ve Model Boyutu
DeepSeek, V4.1-Flash’ı 10 Eylül 2026’da yeni mimari ailesinin en küçük modeli olarak, yerel görsel anlama kabiliyetiyle birlikte resmen yayımladı. “Flash” adına rağmen, bu küçük, yoğun bir model değildir.
Temel mimari değişiklik, Causal Encoder-Decoder (CED) tasarımıdır. Model, etkin hesaplamayı büyük bir uzman havuzunu korurken azaltmak amacıyla, hesaplamayı istem alımı ile token üretimi arasında asimetrik şekilde böler.
| Özellik | DeepSeek-V4.1-Flash |
|---|---|
| Mimari | Nedensel Encoder-Decoder ile çok modlu MoE |
| Omurga parametreleri | 552B |
| Etkin parametreler, giriş | 8B |
| Etkin parametreler, çıkış | 16B |
| Transformer katmanları | 40: 20 encoder + 20 decoder |
| Bağlam penceresi | 1.048.576 token |
| Global KV önbelleği | 890 bayt/token |
| Modaliteler | Metin + görsel girdi, metin çıktı |
| Ağırlık lisansı | MIT |
| Önerilen örnekleme | Sıcaklık 1.0; top_p 0.95 veya 1.0 |
| Resmî ağırlıklar | Hugging Face |
| Birincil yerel sunum seçenekleri | vLLM, SGLang, DeepSeek referans çıkarım |
Etkin parametreler ile yerleşik parametreler arasındaki ayrım kritik önemdedir. MoE yönlendirmesi, tek bir token için kullanılan hesaplamayı azaltır; ancak sunucunun seçilebilecek uzman ağırlıklarına erişmesi gerekir. Bu nedenle “8B etkin” bir modelin yine de yüzlerce gigabayt depolama ve hızlandırıcı belleği gerektirmesi mümkün olur.
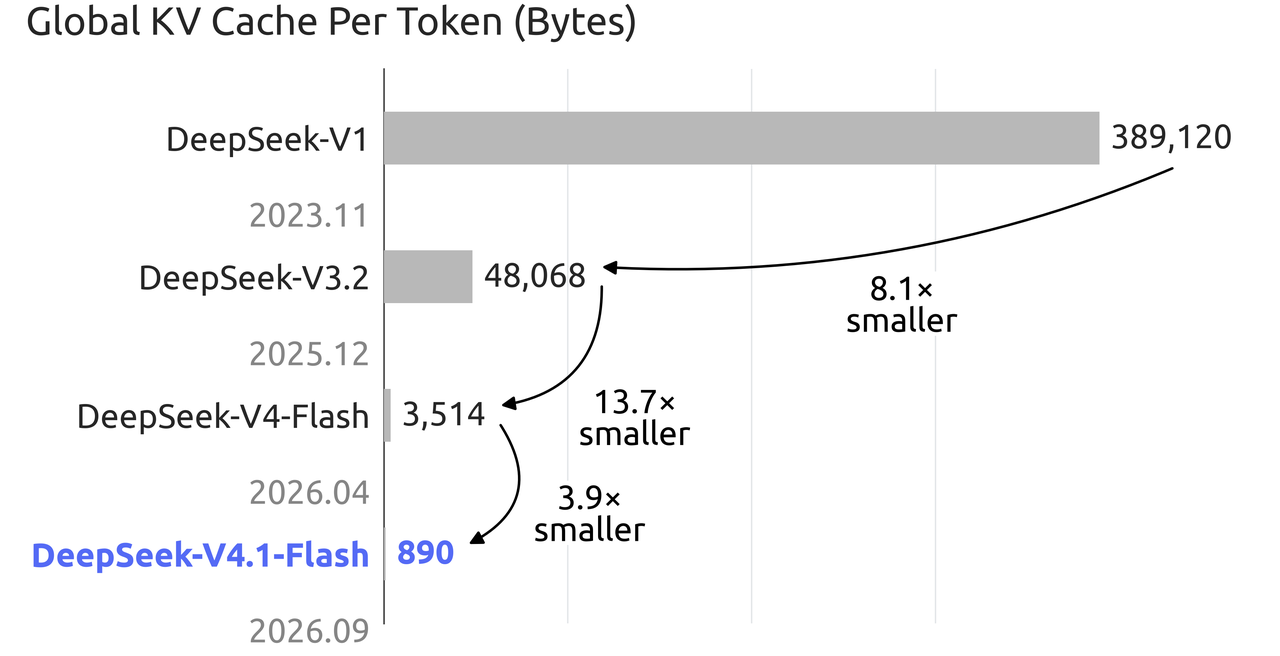
DeepSeek’in resmî KV önbellek grafiği, global önbelleğin V4 Flash’ta token başına 3.514 bayttan V4.1 Flash’ta 890 bayta düştüğünü, yani yaklaşık 3,9× azaldığını gösterir. Bu, milyon-token çıkarımı için önemlidir; ancak model ağırlıklarının oluşturduğu çok daha büyük bellek gereksinimini ortadan kaldırmaz.
DeepSeek-V4.1-Flash Dağıtmadan Önce Ne Kadar İyi?
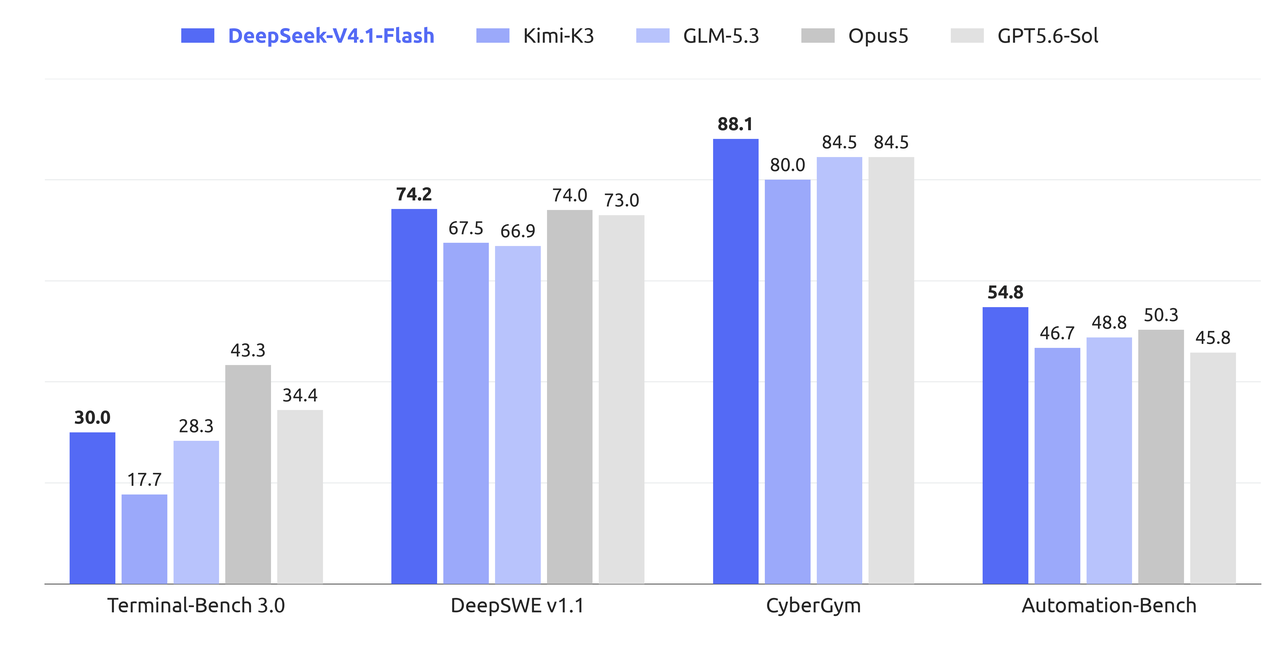
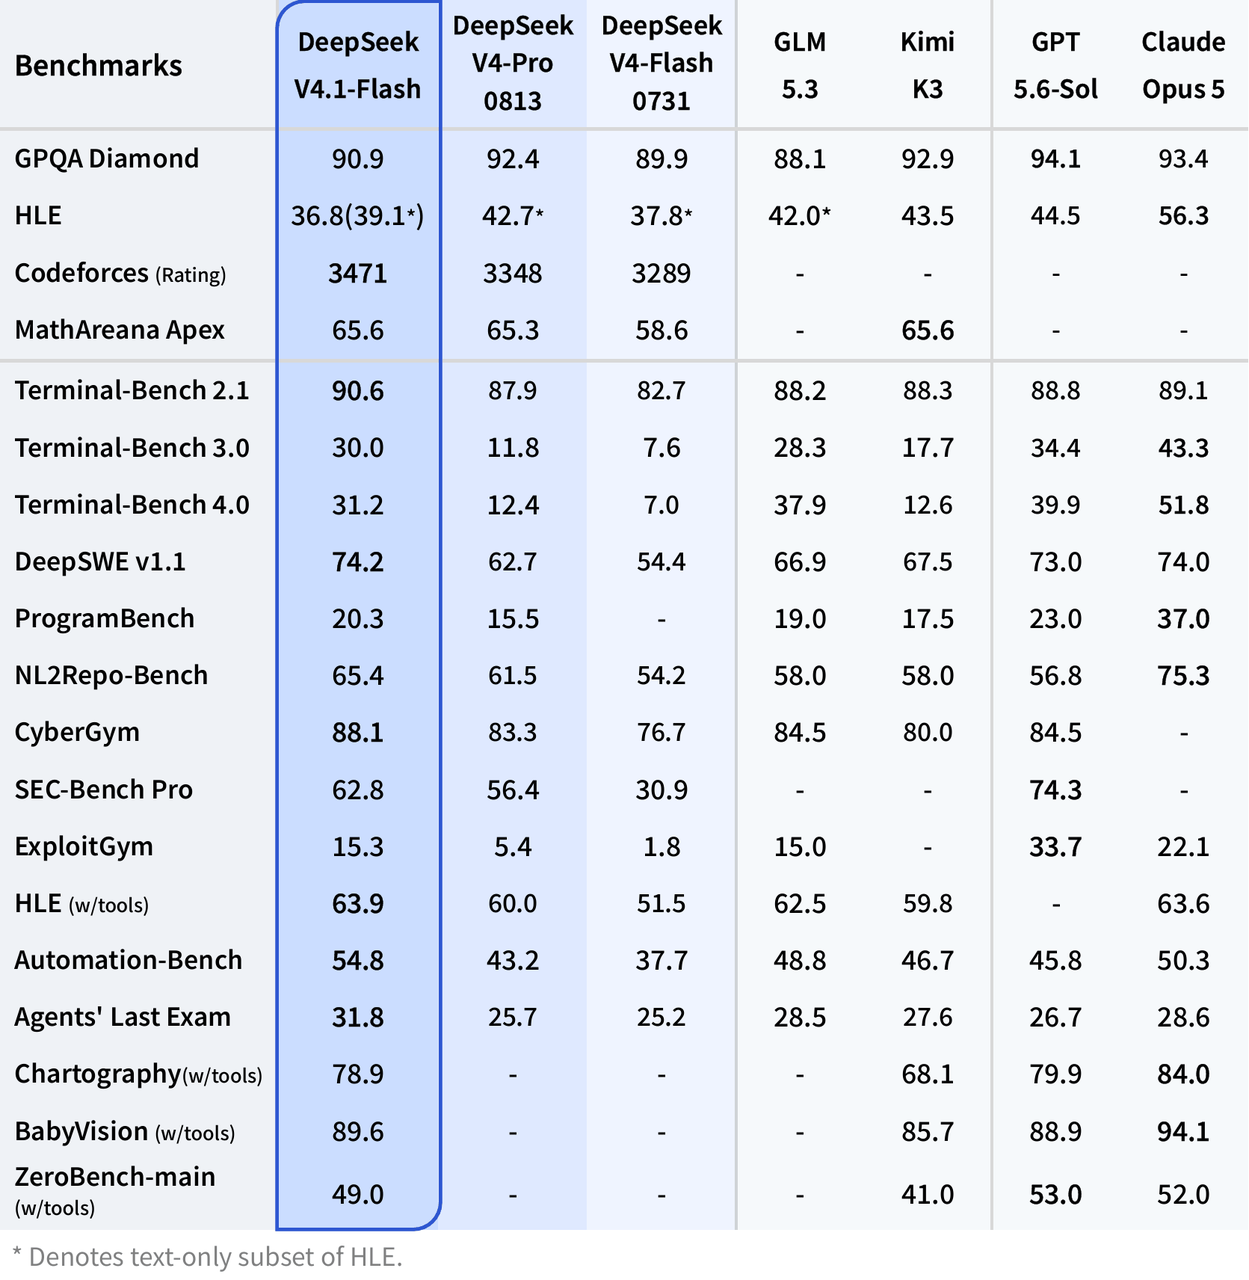
DeepSeek’in yayımladığı kıyaslama tablosu, V4.1-Flash’ı öncelikle aracılık kodlama, terminal işlemleri, otomasyon ve yazılım mühendisliği iş yüklerinde büyük bir yükseltme olarak konumlandırır. Bunlar sağlayıcı tarafından raporlanan kıyaslama sonuçlarıdır, dolayısıyla garantili uygulama performansı yerine referans ölçümler olarak değerlendirilmelidir.
Yeniden üretilebilirlik için, resmî model kartı sıcaklık 1.0 ve top_p 0.95’i önerir; akıl yürütme çabası ve token bütçeleri değerlendirmeye göre değişir. Aşağıdaki rakamlar, donanımdan bağımsız performans garantileri değil, sağlayıcı tarafından yürütülen referans sonuçlardır; yeniden üretimden önce kıyaslamaya özgü çerçeve ayrıntıları incelenmelidir.
| Kıyaslama | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Burada tek bir skordan ziyade desen önemlidir. V4.1-Flash her kıyaslamada lider değildir; ancak V4 Flash 0731’den V4.1’e sıçrama özellikle Terminal-Bench, DeepSWE, otomasyon ve siber güvenlik iş yüklerinde büyüktür. Bu, yerel dağıtımı; özel kodlama ajanları, depo ölçeğinde analiz, dahili otomasyon ve hava boşluklu ajan altyapıları için özellikle anlamlı kılar.
DeepSeek-V4.1-Flash’ı Gerçekten Yerelde Çalıştırabilir misiniz?
Evet, ancak “yerel” kelimesinin nitelendirilmesi gerekir. En güncel vLLM DeepSeek-V4.1-Flash tarifi, kontrol noktasını yaklaşık yarım terabayt olarak parçalar ve çalışma zamanı ek yükü dâhil edildiğinde çok daha büyük bir VRAM bütçesi önerir.
| Bileşen | Yaklaşık depolanan boyut |
|---|---|
| Yönlendirilen + DSpark uzmanları | 259,5 GiB |
| Engram tabloları | 183,1 GiB |
| Dikkat, yoğun yansıtımlar ve yönlendiriciler | 6,9 GiB |
| Gömlemeler, LM başlığı ve normlar | 3,9 GiB |
| UE8M0 blok ölçekleri | 21,9 GiB |
| Tam kontrol noktası | ~476 GiB / ~511 GB |
| vLLM önerilen minimum VRAM bütçesi | ~614 GB |
Temel sürpriz, V4.1-Flash’ın halihazırda dahili olarak yoğun şekilde sıkıştırılmış olmasıdır. Yönlendirilen uzman ağırlıkları düşük hassasiyetli biçimler kullanır; bu nedenle resmî kontrol noktası, kolay bir 4-bit dönüşümü bekleyen devasa bir BF16 model değildir.
DeepSeek-V4.1-Flash Donanım Gereksinimleri
| Donanım yapılandırması | Pratik durum | Yorumlar |
|---|---|---|
| 1× RTX 4090 / 5090 | Hayır | Modelin bellek ayak izinin çok altındadır |
| 2–4 tüketici GPU | Resmî tam kontrol noktası için hayır | Toplam VRAM yetersiz kalır |
| 128 GB iş istasyonu | Hayır | Etkin parametreler, yerleşik ağırlık belleğini belirlemez |
| 256 GB iş istasyonu | Resmî sunum yolu için hayır | Resmî kontrol noktası ayak izinin hâlâ oldukça altında |
| 512 GB sistem RAM + GPU offload | Deneysel | Topluluk/offload alanı; doğrulanmış üretim sunumuyla eşdeğer değildir |
| 4× yüksek bellekli DC GPU | Donanıma bağlı | Yeterince büyük modern hızlandırıcılarla mümkün; çalışma zamanı tarifini kontrol edin |
| 8× H200 | Evet, belgelendirilen sınıf | Yaklaşık 1.128 GB toplam HBM |
| GB200 NVL4 sınıfı sistem | Evet | vLLM, 768 GB’lık bir tepsinin modele uyduğunu belirtir |
Önemli: 8B etkin parametre, 8 GB VRAM anlamına gelmez. “Etkin”, bir tokenın hesaplamasına MoE ağının ne kadarının katıldığını tanımlar. Tüm uzman kümesi yine de çıkarım motoru tarafından erişilebilir bir yerde saklanmalıdır.
DeepSeek-V4.1-Flash için Hangi Çalışma Zamanını Kullanmalısınız?
| Çalışma zamanı | Mevcut V4.1-Flash durumu | En iyi kullanım |
|---|---|---|
| vLLM | Mevcut dağıtım tarifi mevcut; güncel imaj gerekir | Üretim OpenAI uyumlu sunum |
| SGLang | Mevcut DeepSeek-V4.1 dağıtımlarıyla desteklenir | Yüksek performanslı dağıtık çıkarım |
| DeepSeek referans çıkarım | Resmî TP8 referans uygulaması | Mimari araştırma ve doğrulama |
| Transformers | Model entegrasyonu Hugging Face’te sunulur | Geliştirme ve denemeler; donanım hâlâ gereklidir |
| Ollama | Resmî kütüphane rotası şu anda :cloud kullanır | Kolay bulut çağrımı; kendi kendine barındırmaya eşdeğer değildir |
Üretim kendin barındırmada, vLLM şu anda en net başlangıç noktasıdır. SGLang dağıtım rehberi gelişmiş dağıtık çıkarım için başka bir desteklenen yol sunar.
vLLM ile DeepSeek-V4.1-Flash’ı Yerelde Nasıl Çalıştırırsınız?
Bu, çoklu GPU’lu bir Linux sunucusu için pratik bir yoldur.
Aşağıdaki tüm komut örnekleri, dil spesifik kod blokları olarak yeniden biçimlendirilmiş ve kısa İngilizce açıklamalarla verilmiştir.
Adım 1: Ortamınızı Kontrol Edin
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Yüzlerce gigabayt boş SSD alanı.
- Desteklenen çoklu GPU yapılandırması.
- Mevcut resmî ağırlık sunum profili için yaklaşık 614 GB toplam kullanılabilir hızlandırıcı belleği.
- Model yerel olarak önbelleğe alınmadıysa hızlı bir ağ.
Adım 2: DeepSeek-V4.1-Flash Ağırlıklarını İndirin
Resmî ağırlıklar, MIT lisansı altında DeepSeek-V4.1-Flash Hugging Face deposunda barındırılır.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
~/.cache/huggingface klasörünü barındıran dosya sisteminin 511 GB’tan çok daha fazla boş alanı olduğundan emin olun. Geçici dosyalar ve ilave motor yapıları tepe disk kullanımını artırabilir.
Adım 3: vLLM ile DeepSeek-V4.1-Flash’ı Başlatın
Mevcut vLLM tarifine göre, DeepSeek-V4.1 desteği yeterince güncel bir vLLM imajı gerektirir. Sadece metin için sekiz GPU’lu bir başlangıç yapılandırması şu şekilde olabilir:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Burada iki kasıtlı tercih vardır. Birincisi, --language-model-only yalnızca metin iş yükleri için görsel kodlayıcıyı devre dışı bırakır. İkincisi, 131.072 token’dan başlamak, bir milyon token’lık tam bağlamı hemen etkinleştirmekten daha güvenlidir. Sunucu kararlı hâle geldikten sonra artırabilirsiniz:
--max-model-len 1048576
Uygun tensor-parallel ayarı hızlandırıcı topolojisine bağlıdır; bu yüzden --tensor-parallel-size 8’ı her sunucuya körlemesine kopyalamayın.
Adım 4: Yerel DeepSeek-V4.1-Flash Uç Noktasını Test Edin
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Adım 5: Python ile Yerel DeepSeek-V4.1-Flash Sunucunuzu Çağırın
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
DeepSeek-V4.1-Flash Düşünme Modunu Yerelde Nasıl Etkinleştirirsiniz?
V4.1-Flash, sohbet şablonu aracılığıyla açık akıl yürütme denetimlerini destekler. Bir örnek:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Model küçük bir max_tokens değeriyle çok az veya hiç nihai içerik döndürüyormuş gibi görünürse, dağıtımın bozuk olduğunu varsaymadan önce düşünme modunun üretim bütçesini tüketip tüketmediğini kontrol edin.
DeepSeek-V4.1-Flash’ı Referans Kodla Nasıl Çalıştırırsınız?
DeepSeek, model deposu içinde minimal TP8 çıkarım uygulaması da içerir. Bu, esas olarak okunabilir referans kod olarak amaçlanmıştır; yüksek verimli bir üretim sunucusu değildir.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Bu yol, CED, MoE yönlendirmesi, Engram belleği, spekülatif çıkarım ve ilgili uygulama ayrıntılarını incelemek için kullanışlıdır. Normal üretim sunumu için vLLM veya SGLang işletmesi daha kolaydır.
DeepSeek-V4.1-Flash’ı Ollama ile Yerelde Çalıştırabilir misiniz?
Normal bir 7B veya 32B Ollama modeli çalıştırmakla aynı anlamda değil. Ollama şu anda V4.1-Flash’ı şuradan sunar:
ollama run deepseek-v4.1-flash:cloud
Önemli olan kısım :cloud’dur. Mevcut Ollama kütüphane girişi bir bulut rotası kullanır; bu komut, modelin tamamını indirip çıkarımı tamamen kendi makinenizde gerçekleştirmekle aynı değildir.
DeepSeek-V4.1-Flash Yerel Dağıtım vs API: Hangisi Daha Mantıklı?
| Boyut | Yerel DeepSeek-V4.1-Flash | Barındırılan API |
|---|---|---|
| Peşin donanım | Çok yüksek | Yok |
| Hızlandırıcı belleği | ~614 GB pratik resmî hedef | Sağlayıcı tarafından yönetilir |
| Model kontrolü | Tam | Sınırlı |
| Veriler yerinde kalır | Evet | Hayır |
| Ağırlık değiştirme | Evet | Hayır |
| Bakım | Sizin sorumluluğunuz | Sağlayıcı tarafından yönetilir |
| Kurulum karmaşıklığı | Yüksek | Düşük |
| Ölçekleme | Altyapı gerektirir | API tabanlı |
| En uygun | Hava boşluklu, özel, araştırma, yüksek kullanım kümeleri | Çoğu geliştirici ve üretim uygulaması |
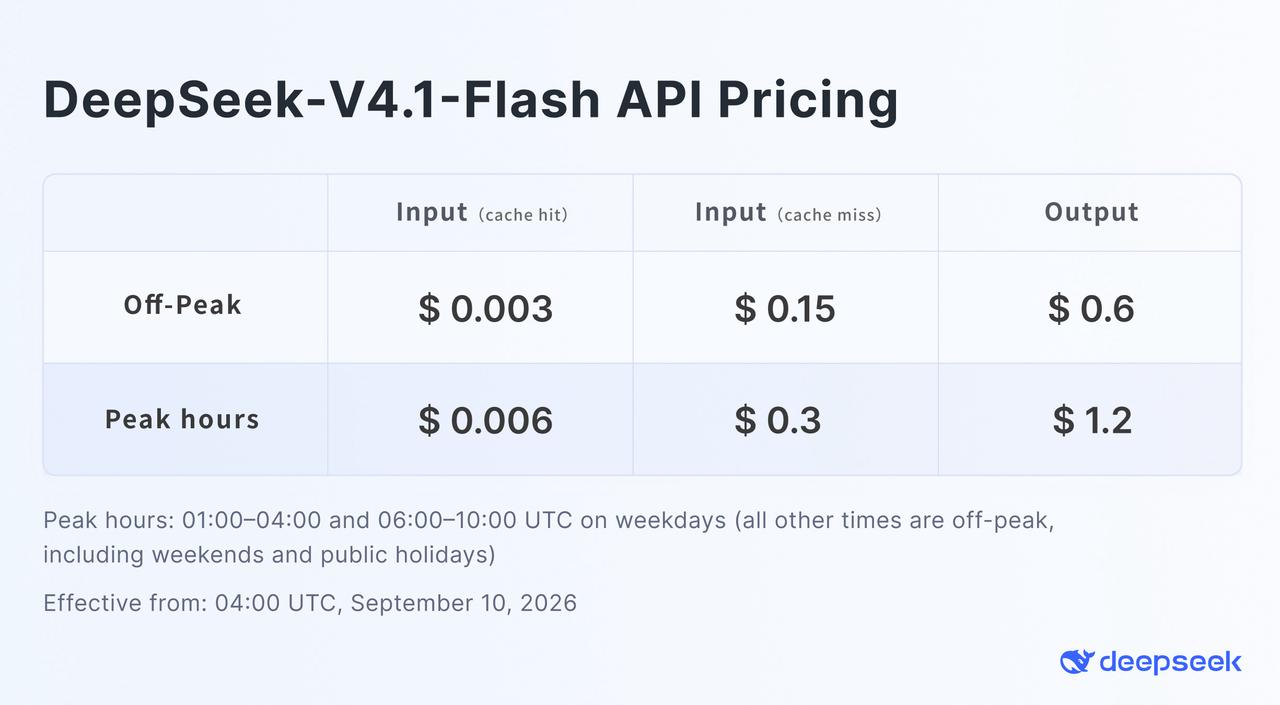
DeepSeek’in resmî yoğun olmayan saat fiyatlandırması, V4.1-Flash fiyatlandırma grafiğinde gösterilir. Ağırlıklara fiziksel olarak sahip olma ihtiyacı olmayan geliştiriciler için CometAPI’deki DeepSeek V4.1 Flash API, çok sayıda model yönetimi ve çoklu GPU orkestrasyonuna girmeden modele OpenAI uyumlu bir alternatif sunar.
Aşağıdaki örnek, CometAPI’nin model tanımlayıcısını kullanır. Bu, DeepSeek’in resmî API’sinde kullanılan tanımlayıcı değildir.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
Pratik karar basittir: gizlilik, hava boşluklu operasyon, ağırlık düzeyi deneysellik, öngörülebilir ağır kullanım veya düzenleyici gereksinimler, altyapı maliyetinden daha ağır bastığında yerel dağıtım cazip hâle gelir. Sıradan uygulama geliştirmede, barındırılan bir uç nokta yüzlerce gigabaytlık model yönetimi ve çoklu GPU orkestrasyonundan kaçınır.
DeepSeek-V4.1-Flash’ı Yerelde Çalıştırırken Hangi Sorunlarla Karşılaşabilirsiniz?
Sunucu, üretim başlamadan önce belleği tüketiyor
Bellek gereksiniminin çoğunu 8B/16B etkin parametre sayısı değil, tam kontrol noktası belirler. Tensor parallelism, GPU bellek kullanım oranı, görsel yükleme ve mevcut HBM’yi kontrol edin.
DeepSeek-V4.1-Flash başlatılması uzun sürüyor
Yarım terabaytlık bir kontrol noktasını indirmek, eşlemek, başlatmak ve parçalamak zaman alır. Bu sınıf model için uzun motor-hazır zaman aşımları normaldir.
Yanıt boş veya finish_reason=length ile bitiyor
Düşünme modu, üretim bütçesini tüketiyor olabilir. max_tokens’ı artırın, akıl yürütme çabasını düşürün veya basit istekler için düşünmeyi devre dışı bırakın.
Araç çağrıları doğru ayrıştırılmıyor
Sunucunun DeepSeek V4.1 belirteçleyici, araç çağrısı ayrıştırıcı, akıl yürütme ayrıştırıcısı ve otomatik araç seçimi bayraklarını kullandığından emin olun.
Görsel girdi çalışmıyor
--language-model-only ile başlattıysanız, görsel kodlayıcıyı bilerek devre dışı bıraktınız. Görsel testi yapmadan önce çok modlu desteği etkinleştirerek yeniden başlatın.
DeepSeek-V4.1-Flash’ı Yerelde Çalıştırmalı mısınız?
DeepSeek-V4.1-Flash, mimarisi token başına hesaplamayı ve KV önbellek maliyetini önemli ölçüde azaltmasına rağmen, açık ağırlıklı sınır ölçekli bir modeli masaüstü modeline dönüştürmediği için kendi barındırma perspektifinden alışılmadık derecede ilgi çekicidir.
Bir araştırma laboratuvarı, kurumsal yapay zekâ platformu, özel kodlama ajan yığını veya hava boşluklu ortam için vLLM ve SGLang kendi barındırmayı teknik olarak gerçekçi kılar. Bir veya iki GPU’lu bir geliştirici için ise pratik bir tam model dağıtım hedefi değildir. Bu durumda, CometAPI üzerinden DeepSeek V4.1 Flash kullanmak modeli, sunumu büyük bir altyapı projesine dönüştürmeden erişilebilir kılar.
SSS
DeepSeek-V4.1-Flash açık kaynak mı?
Model ağırlıkları ve deposu, lisans koşullarına tabi olarak geniş kullanım, değiştirme ve yeniden dağıtım izni veren MIT lisansı altında yayımlanmıştır.
DeepSeek-V4.1-Flash’ı RTX 4090 veya RTX 5090’da çalıştırabilir miyim?
Resmî tam modeli hayır. Tek bir tüketici GPU, tam kontrol noktası için gereken belleğin yalnızca küçük bir kısmına sahiptir.
8B etkin parametre DeepSeek-V4.1-Flash’ın sadece 8 GB VRAM’e ihtiyaç duyduğu anlamına mı gelir?
Hayır. 8B rakamı, istem işleme sırasında katılan parametreleri açıklar. Tam uzman ağı ve destekleyici durum yine de saklanmalı ve erişilebilir olmalıdır.
DeepSeek-V4.1-Flash ne kadar VRAM’e ihtiyaç duyar?
Mevcut vLLM tarifi, resmî kontrol noktası ve çalışma zamanı ek yükü için planlama rakamı olarak yaklaşık 614 GB kullanır. Gerçek ihtiyaçlar donanım, yığın boyutu, bağlam, görsel destek ve sunum yapılandırmasına göre değişir.
DeepSeek-V4.1-Flash diskte ne kadar büyük?
Mevcut vLLM dökümü, kontrol noktasını yaklaşık 476 GiB, yani yaklaşık 511 GB olarak belirtir.
DeepSeek-V4.1-Flash yerelde 1M-token bağlamı çalıştırabilir mi?
Mimari 1.048.576 token’a kadar destekler; ancak pratik bellek kullanımı yığın boyutu, çalışma zamanı tamponları, görsel durumu ve diğer ek yükler gibi unsurlara da bağlıdır.
DeepSeek-V4.1-Flash’ı yerelde Ollama ile çalıştırabilir miyim?
Mevcut Ollama girişi :cloud rotasını kullanır; bu, ağırlıkların tamamını indirip çıkarımı tamamen kendi makinenizde çalıştırmakla aynı değildir.
DeepSeek-V4.1-Flash için vLLM mi SGLang mi daha iyi?
Her ikisi de yüksek performanslı sunumu hedefler. vLLM’nin şu anda özellikle ayrıntılı bir V4.1’e özgü tarifi vardır; SGLang da gelişmiş dağıtık dağıtımlar için uygundur.
Yerel donanım olmadan DeepSeek-V4.1-Flash’ı kullanmanın en kolay yolu nedir?
Barındırılan bir API kullanın. DeepSeek kendi API’sini sağlarken, CometAPI diğer yapay zekâ modelleriyle birlikte OpenAI uyumlu bir DeepSeek-V4.1-Flash uç noktası sunar.