CometAPI ile geliştirinBirden çok model için tek bir API mi gerekiyor?İş akışını Playground'da test edin, ardından model ve maliyet kullanım senaryonuza uyduğunda bir API anahtarı oluşturun.
Kimi K3.1 Pro'yu Yerel Olarak Dağıtma: Donanım Gereksinimleri, vLLM Kurulumu - CometAPI
Kimi K3.1 Pro'yu Yerel Olarak Dağıtma: Donanım Gereksinimleri, vLLM Kurulumu
vLLM ile Kimi K3.1 Pro’yu kendi ortamınızda barındırmayı öğrenin, GPU gereksinimlerini kontrol edin, ağırlıkları indirin, çıkarımı test edin ve yerel dağıtımı API erişimiyle karşılaştırın.
Kimi K3.1 Pro’yu bir Linux GPU sunucusunda dağıtın ve ardından yerel bir uygulamayı çıkarım uç noktasına bağlayın. Bu rehber, vLLM ile sekiz GPU’lu tek bir NVIDIA B300 düğümü kullanır. Sunucuya kabuk erişimine, uyumlu sürücülere ve tam kontrol noktasını saklayacak depolamaya ihtiyacınız olacak. Daha uzun girişler veya ajan iş akışlarını denemeden önce kısa bir metin isteğini başarıyla tamamlayarak başlayın.
Uygun GPU’lar yoksa, uygulamanızı yerelde çalıştırıp resmi Kimi API’sine veya CometAPI gibi üçüncü taraf bir sağlayıcıya bağlayabilirsiniz.
Önemli Noktalar
Modelin 104B aktif parametresi, tam depolama gereksinimini temsil etmez.
Donanım uyumluluğu; GPU belleği, ara bağlantılar, kuantizasyon desteği ve çıkarım çekirdeklerini kapsar.
Netlik, kaynak ataması ve güncel API terminolojisi açısından gözden geçirildi.
Güçlü kıyaslama sonuçları modeli denemeye değer kılar; ancak uygulamanızda aynı performansı garanti etmez.
Çalışan bir çıkarım uç noktası, kendiliğinden bir tarayıcıyı, kod alanını veya tam bir ajan çalışma zamanını içermez.
Yeniden denemeler ve bakım dahil olmak üzere, başarılı görev başına maliyetle kendi kendine barındırmayı ve API erişimini karşılaştırın.
Kimi K3.1 Pro Nedir?
Kimi K3.1 Pro, Moonshot AI’nin kodlama, belge analizi ve araç kullanımı için açık ağırlıklı çok modlu modelidir. Başlıca özellikleri, resmi model kartına göre aşağıda listelenmiştir.
Özellik
Yayınlanan yapılandırma
Mimari
MoE; toplam 2.8T parametre, 104B aktif
Attention
93 katman: 69 KDA + 24 Gated DSA
Uzmanlar
896 yönlendirmeli; belirteç başına 16 seçilen; 2 paylaşılan
Model, belirteç başına 104B parametreyi etkinleştirir; ancak dağıtım yine de tam 2.8T-parametreli kontrol noktasını gerektirir. Çıkarım motoru, KDA ve Gated DSA katmanlarını ve MXFP4 kuantizasyonunu da desteklemelidir.
Kimi K3.1 Pro’yu Yerelde Çalıştırmak İçin Hangi Donanım Gerekir?
Aşağıdaki tablo, bu rehberle ilgili vLLM yapılandırmalarını özetler. Yürütme, sekiz GPU’lu bir B300 düğümü kullanır; GB300 ve AMD dağıtımları kendi yapılandırmalarını gerektirir.
Donanım
Belgelendirilen rota
Planlama notları
NVIDIA B300
Tek sekiz GPU’lu düğüm, TP8
Aşağıdaki yürütme için temel
NVIDIA GB300
İki tepsiye yayılmış sekiz GPU, TP8
Çok düğümlü yapılandırma ve ara bağlantı kurulumunu gerektirir
AMD MI355X
AMD’ye özel yapılandırmalı sekiz GPU’lu düğüm
ROCm/AITER yolunu kullanın; NVIDIA ortam ayarlarını yeniden kullanmayın
Tek 24–32 GB tüketici GPU’su
Tam kontrol noktasını doğrudan yüklemek için yetersiz
Bu eğitim için pratik bir hedef değildir
Sadece ölçek açısından, 2.8T parametre yaklaşık olarak BF16’da 5.6 TB, sekiz bitte 2.8 TB veya idealize dört bitte 1.4 TB kaplar. Bunlar ham parametre depolama hesaplarıdır; gerçek kontrol noktası boyutları veya çalışma zamanı VRAM alt sınırları değildir. Karma hassasiyet ve meta veriler dosya boyutunu değiştirir; önbellek ve çalışma zamanı ayrımları sunum gereksinimini artırır.
Tam indirme, geçici dosyalar ve geri alım kopyası için NVMe kapasitesi ayırın. Çok düğümlü sistemlerde, modeli yüklemeden önce iletişimi doğrulayın.
Kimi K3.1 Pro Nasıl Dağıtılır?
Uygun donanımınız varsa kendi kendine barındırmayı kullanın; aksi halde barındırılan bir API ile başlayın. Aşağıdaki adımlar vLLM kullanır; bu bölümün sonunda SGLang alternatifi yer alır. Çalışan bir isteği aldıktan sonra barındırma maliyetlerini karşılaştırın.
Kurulumu, indirme, başlatma ve ilk doğrulama komutlarını GPU sunucusunda bir Bash kabuğunda çalıştırın. Bir dizüstü bilgisayardan çalışıyorsanız önce SSH ile o sunucuya bağlanın. Python istemcisi daha sonra aşağıdaki bağlantı talimatlarını kullanarak her iki makinede de çalışabilir.
Bu yürütme, resmi dağıtım tarifini izler; bu makale için bağımsız olarak test edilmemiştir.
1. GPU görünürlüğünü, depolamayı ve bağlantıyı kontrol edin
Temel altyapı kontrolleriyle başlayın:
nvidia-smi
nvidia-smi topo -m
df -h
Tüm hedef GPU’ların göründüğünü ve model dizininde yeterli alan olduğunu doğrulayın. İndirme önbellekleri, günlükler ve gelecekteki kontrol noktası sürümleri için ek depolama bütçesi ayırın.
Çok düğümlü dağıtımlarda, model başlatmayı denemeden önce düğümler arası iletişimi doğrulayın.
İlk kilometre taşını dar tutun: kontrol noktasını yükleyin ve kısa bir metin isteğini tamamlayın. Bu, hataları teşhis etmeyi kolaylaştırır.
2. Sunum ortamını hazırlayın
Bu tek düğümlü örnek için sekiz B300 GPU’lu bir Linux ana bilgisayarı kullanın. Yayınlanan tarifle uyumlu bir CUDA ortamında, izole bir ortam oluşturun ve sunum araçlarını kurun:
Sürüm tabanı her sürücü veya wheel ile uyumluluk garantisi vermez. Donanım tarifinin özel bir container veya derleme gerektirmesi durumunda, onun ortamını kullanın. Üretime geçmeden önce başarıyla test edilmiş sürümü sabitleyin.
3. Tam kontrol noktasını indirin
Hugging Face CLI’yi kurun ve model deposunu indirin:
Yapılandırma, tokenizer, işlemci dosyaları ve ağırlık indeksini, ağırlık parçalarıyla birlikte tutun. Yalnızca seçili tensör dosyalarını kopyalamak dağıtımı eksik bırakabilir.
Yeniden üretilebilir üretim dağıtımları için, doğruladığınız depo revizyonunu kaydedin ve sabitleyin. Ticari kullanım öncesinde deponun özel lisansını gözden geçirin.
4. vLLM sunucusunu başlatın
Resmi tarif, vLLM 0.34.0 veya daha yenisini belirtir. Donanıma özel ortam yapılandırması ile başlayın, ardından testlerinizi geçen sürümü ve bağımlılıkları sabitleyin.
Ortamı hazırladıktan sonra aşağıdaki temel komutu kullanın. Bu komut, sekiz yönlü tensör paralelliğini başlatır ve başlangıç bağlam penceresini 32.768 belirteçle sınırlar:
kimi-local adı uygulamaya dönük bir takma addır. Sonraki isteklerde aynı adı kullanın.
32.768 belirteç ayarı, bu yürütme için temkinli bir başlangıç noktasıdır; modelin desteklediği maksimum bağlam değildir.
--trust-remote-code seçeneği, özel depo kodunun yüklenmesine izin verir. Bunu incelenmiş, sabit bir kontrol noktası revizyonuyla eşleştirin.
Burada 127.0.0.1, istemciyi çalıştıran makineyi ifade eder. Aşağıdaki curl kontrolleri GPU sunucusunda çalışır ve onun çıkarım sürecine erişir. Python istemcisini dizüstü bilgisayarınızdan kullanmak için, ayrı bir dizüstü bilgisayar terminalinde bir SSH tüneli açın ve çalışır durumda tutun:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
user@gpu-server yerine SSH girişinizi ve sunucu adresinizi yazın. Bu tünel açıkken, dizüstü bilgisayar istemcisi http://127.0.0.1:8000/v1 adresini kullanabilir. 8000 numaralı port dizüstü bilgisayarınızda zaten doluysa, farklı bir yerel port seçin ve istemci URL’sini güncelleyin.
Yanıtı ve sunucu günlüklerini şunlar için kontrol edin:
Beklenen model adı.
Yanıtta nihai bir cevap.
Üretimin tamamlandığını veya sınırına ulaştığını belirten bir finish_reason.
GPU belleği veya desteklenmeyen işlem hataları.
Muhakeme, üretim bütçesinin bir kısmını tüketebilir. İstek, nihai bir cevap üretmeden önce sınırına ulaşırsa, sunucunun bozuk olduğuna karar vermeden önce bütçeyi artırıp tekrar deneyin.
6. Yerel bir Python uygulaması bağlayın
python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Write a Python function that removes duplicate filenames while preserving order."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
EMPTY, API anahtarı kimlik doğrulaması olmayan bu yalnızca-loopback sunucusu için bir yer tutucudur. Kimlik doğrulamalı bir uç nokta için yapılandırdığınız kimlik bilgisini kullanın. Bir ajan bağlamadan önce görsel girdi ve araç yürütmeyi ayrı ayrı doğrulayın.
SGLang alternatifi
SGLang için, resmi donanıma özel yemek kitabını kullanın. Bu tek düğümlü yürütmeye en yakın eşleşme için B300, Unified ve Low-Latency (TP8) seçeneklerini belirleyin. Görüntülenen doğrulama durumunu kontrol edin; oluşturulan bir yapılandırma mutlaka test edilmiş bir yapılandırma değildir.
GPU sunucusunda, Docker’ı kurun ve NVIDIA Container Toolkit’i yapılandırın; ardından indirilen kontrol noktasını /models/Kimi-K3.1-Pro konumuna bağlayarak bir container oluşturun. Aynı GPU’lar için rekabet etmemeleri adına önce vLLM’i durdurun.
Container içinde, seçtiğiniz yapılandırma için yemek kitabının ürettiği tam başlatma komutunu yapıştırın. Model yolunu /models/Kimi-K3.1-Pro ile değiştirin, servis ana bilgisayarını 0.0.0.0 ve portu 30000 olarak ayarlayın ve donanıma özel bayrakları koruyun. Docker port yönlendirmesinin çalışması için container’ın ağ arayüzünde dinlemesi gerekir; yukarıdaki ana makine tarafındaki port loopback’e bağlı kalır. Test etmeden önce hizmetin hazır olduğunu belirten mesajı bekleyin.
GPU sunucusunda ikinci bir kabukta, sunulan modeli listeleyin ve ardından dönen model kimliğini tam olarak kullanarak bir istek gönderin:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Explain database indexes in three sentences.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
Başarılı bir yanıt nihai bir cevap içermelidir. Başlatma başarısız olursa, container günlüklerini inceleyin ve seçilen donanım tarifinin ve imajın eşleştiğini doğrulayın. Dizüstü bilgisayar erişimi için, 30000 portuyla aynı SSH tüneli modelini kullanın. Container önkoşulları için SGLang Docker kurulum kılavuzuna bakın.
Kimi K3.1 Pro Kıyaslamalarda Nasıl Performans Gösteriyor?
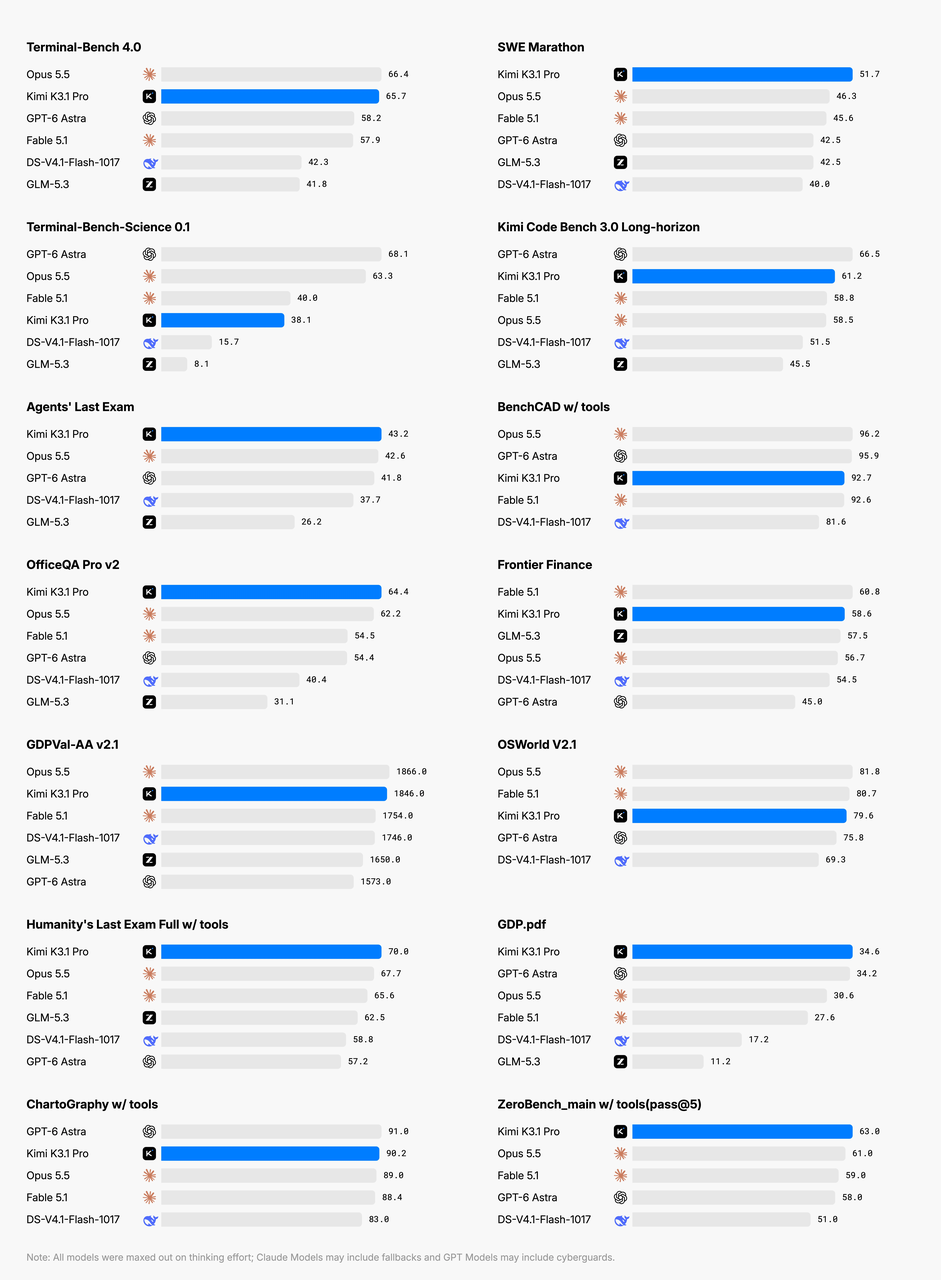
Dağıtım testiniz için görev seçerken aşağıdaki resmi değerlendirme sonuçlarını kullanın. Bu puanlar, bu rehberde yapılandırılan yerel sunucuyu değil, yayımlanan değerlendirme kurulumunu açıklar.
Aşağıdaki tablo, seçili sonuçları ve model kartında yayınlanan karşılaştırma seti içindeki konumlarını göstermektedir.
Kıyas ve resmi sonuçlar
Model puanı
Bu karşılaştırmadaki konum
Terminal-Bench 4.0
65.7
İkinci
SWE Marathon v1.1
51.7
Birinci
Program Bench
31.5
Dördüncü
OfficeQA Pro v2
64.4
Bildirilen sonuçlar arasında birinci
Frontier Finance
58.6
İkinci
Sonuçlar, modeli kapsamlı mühendislik görevleri ve belge iş akışları için test etmeyi destekler. Kimi K3.1 Pro, bu karşılaştırmada SWE Marathon’da liderdir; ancak ProgramBench’te dördüncüdür; bu da her ikisini de uygulamaya özgü testler için faydalı adaylar yapar.
Bu konumlar, canlı bir küresel liderlik tablosunda değil, resmi karşılaştırma tablosu içinde hesaplanmıştır. Değerlendirme harness’ları, araçlar, muhakeme bütçeleri ve örnek seçimleri kıyaslar arasında farklılık gösterir.
Bir dağıtım kararı için, gerçek işten küçük bir değerlendirme seti oluşturun: depo düzeltmeleri, belgeler arası sorular ve çok adımlı araç görevleri. Tamamlama kalitesini, insan düzeltmelerini ve geçen süreyi ölçün. Yayınlanan puanlar kısa liste için faydalıdır; değerli olup olmadığına uygulama testleri karar verir.
Kimi K3.1 Pro Yerel Çıkarımı Nasıl Optimize Edilir?
Bağlamı ve eşzamanlılığı kontrol edin
Kısa istekler çalıştıktan sonra, uzun belgeler, görseller, çok turlu konuşmalar ve araç çağrılarını ayrı ayrı test edin.
Hedef bağlam uzunluğunuz ve eşzamanlılığınızda ilk belirteç gecikmesi, saniye başına çıkış belirteçleri ve tepe GPU belleğini izleyin. Ayrıca görev başarısını ve başarılı görev başına maliyeti kaydedin; böylece daha hızlı çıktı daha fazla yeniden deneme veya insan düzeltmesini gizlemesin.
Aynı anda tek bir büyük değişkeni değiştirin. Bağlam uzunluğunu, eşzamanlılığı ve optimizasyon ayarlarını aynı anda artırmak, performans gerilemelerini açıklamayı zorlaştırır.
Muhakeme çabasını ve önbellek ayarlarını bilinçli seçin
Göreve göre low, high veya max reasoning effort kullanın. Arayüz kontrolleri için low ile başlayın; ardından zor görevlerde, hem tamamlama kalitesi hem de geçen süreyi kullanarak high ve max’i karşılaştırın. Daha uzun bir muhakeme izinin kendisi daha iyi bir sonucun kanıtı değildir.
Uzun oturumlar için, spekülatif kodlama veya daha fazla eşzamanlılık eklemeden önce önbellek kapasitesini ve önek yeniden kullanımını değerlendirin. Bilinen iyi bir temel tutun ve ayarları birer birer değiştirin.
Kimi K3.1 Pro Araç Çağrısı Dağıtımdan Sonra Neden Başarısız Olabilir?
Uygulamanız araç çağrılarını yürütür, sonuçlarını döndürür ve konuşmaya devam eder. Tam yardımcı mesajını—reasoning_content ve tool_calls dahil—koruyun ve her araç sonucunu eşleşen tool_call_id ile geri döndürün.
Çok turlu işleme de önemlidir. Modelin kullanım yönergeleri, yalnızca nihai metni saklamak yerine tam yardımcı mesajını korumayı, muhakeme ve araç çağrısı alanları dahil olmak üzere, gerektirir.
Belirti
İlk kontroller
Tanınmayan model mimarisi
Çalışma zamanı sürümü, özel kod ve yapılandırma
Yükleme sırasında bellek yetersizliği
GPU kapasitesi, paralellik ve rekabet eden süreçler
Kısa istekler çalışıyor, uzunlar başarısız
Bağlam sınırı, önbellek kapasitesi ve eşzamanlılık
Araç çağrıları ayrıştırılamıyor
Ayrıştırıcı ayarları ve araç şeması
Ajan bir araç istedikten sonra duruyor
Uygulama yürütmesi ve araç sonucu işleme
Çok turlu yanıtlar tutarsız hale geliyor
Eksik yardımcı-mesaj alanları
Her hatayı izole etmek için minimal, yeniden üretilebilir bir istek kullanın. Çalıştıktan sonra, uygulamanın ek ayarlarını teker teker geri ekleyin.
Kendi Kendine Barındırmalı mı, Barındırılan API mi?
Ağırlıklar, altyapı veya veri konumu üzerinde kontrole ihtiyaç duyduğunuzda ve GPU’ları verimli şekilde meşgul tutabildiğinizde kendi kendine barındırmayı seçin. İlk değerlendirme veya değişken talep için, aynı istemler ve kabul kriterleriyle resmi Kimi API’sini ve CometAPI’yi karşılaştırın. Her hizmetin model erişimini, desteklenen parametreleri, kotaları ve veri işleme koşullarını doğrulayın.
Maliyet veya işletim faktörü
Kendi kendine barındırma
Resmi Kimi API / CometAPI
Kapasite maliyeti
Boşta kalma dahil GPU satın alma veya kiralama
Faturalı API kullanımı; her sağlayıcının güncel tarifelerine bakın
Depolama ve ağ
Kontrol noktası depolaması, önbellek ve ağ ücretleri
Uygulama tarafı depolama ve ağ ücretleri
Operasyonlar
Dağıtım, izleme, yükseltmeler ve kurtarma
Entegrasyon, kota yönetimi ve istek izleme
Yeniden denemeler
GPU sürelerini hesaplama maliyetine dahil edin
Yeniden denemelerin belirteçlerini veya çağrılarını API ücretine dahil edin
İnsan incelemesi
Aynı oranla düzeltme süresini sayın
Aynı oranla düzeltme süresini sayın
En uygun
Sürekli talep ve altyapı kontrolü
Değerlendirme ve değişken talep
Faydalı bir karşılaştırma:
Başarılı görev başına maliyet = (GPU hesaplama veya API ücretleri + depolama ve ağ + operasyonlar + insan düzeltmesi) / başarıyla tamamlanan görevler.
Aynı ölçüm döneminden maliyetleri ve başarılı görev sayılarını kullanın. Başarısız girişimleri ve yeniden denemeleri, hesaplama veya API toplamına bir kez dahil edin; ikinci bir yeniden deneme ücreti eklemeyin. Hibrit bir iş akışı için hem hesaplama hem de API ücretlerini dahil edin. İstek denemelerini değil, benzersiz tamamlanan görevleri sayın.
Kuramsal verimi mükemmel olsa bile, az kullanılan bir sunucu pahalı kalabilir. Tersine, mevcut altyapısı, sürekli talebi ve sıkı veri gereksinimleri olan bir ekip, kendi kendine barındırmadan önemli değer elde edebilir.
Dağıtım yollarını karşılaştırırken aynı istemleri ve kabul kriterlerini kullanın. Karara uçtan uca gecikmeyi ve çıktı kalitesini dahil edin.
Resmi Kimi API hızlı başlangıcı, aşağıdaki uç noktayı kullanır. MOONSHOT_API_KEY’i ortamınızda ayarlayın ve hesabınızda model erişimini doğrulayın. Bu istek, sağlayıcının altyapısında çalışır.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
CometAPI’de Kimi K3.1 Pro API için, COMETAPI_API_KEY’i ortamınızda ayarlayın ve hesabınızın istenen modele erişimi olduğunu doğrulayın. İstek uzakta çalışır:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
Aynı kabul kriterleriyle sonucu yerel uç noktanızla karşılaştırın. Üretim maliyetini tahmin etmeden önce güncel rota fiyatını ve desteklenen parametreleri kontrol edin.
Sonuç
Kimi K3.1 Pro, desteklenen bir GPU yapılandırması ve eşleşen çıkarım ortamıyla pratik olarak kendi kendine barındırılabilir. Yukarıdaki dağıtım adımlarını kullanarak çalışan bir uç nokta kurun; ardından kendi iş yükünüzde görev kalitesini, gecikmeyi ve maliyeti ölçün. Uygulamayı hâlâ doğruluyorsanız veya uygun donanımınız yoksa barındırılan bir API’yi seçin.
SSS
Normal bir dizüstü bilgisayar tüm modeli çalıştırabilir mi?
Orijinal kontrol noktasının kapasite gereksinimleri için normal bir dizüstü bilgisayar pratik bir hedef değildir. Kendi çıkarım sunucunuza veya barındırılan bir API’ye bağlı bir istemci olarak davranabilir.
Masaüstü uygulamasını kurmak yerel dağıtım sayılır mı?
Uygulamanın kurulum yeri, çıkarımın nerede gerçekleştiğini belirlemez. Kendi kendine barındırma, model ağırlıkları ve çıkarım sürecinin kontrol ettiğiniz altyapıda çalışmasını gerektirir.
Yalnızca 104B parametre aktifse model neden bu kadar çok belleğe ihtiyaç duyuyor?
Farklı belirteçler farklı uzmanları seçebilir. Aktif parametreler, hesaplamaya katılımı açıklar; dağıtım, yine de ağırlıkların tam kümesini saklamayı ve erişmeyi gerektirir.
Tam bir milyon belirteçlik bağlamı hemen etkinleştirebilir miyim?
Bağlam uzunluğunu kademeli olarak artırın ve hedef eşzamanlılığınızda GPU bellek kullanımını ölçün. Model 1,048,576 belirteci destekler; ancak kullanılabilir sunum kapasitesi, önbellek ve paralellik ayarlarınıza bağlıdır.
Yerel dağıtım, yayınlanan kıyas puanlarını yeniden üretir mi?
Otomatik olarak değil. Kuantizasyon, muhakeme bütçeleri, araçlar, istemler ve değerlendirme çerçeveleri sonuçları etkileyebilir. Yapılandırmayı kendi görevlerinize karşı doğrulayın.
Donanım satın almadan önce API üzerinden test etmeli miyim?
Modelin kalite gereksinimlerinizi karşıladığını henüz göstermediyseniz, API testi daha az altyapı çalışmasıyla bir başlangıç sağlar. Uygun donanıma ve net veri yerleşimi gereksinimlerine sahip ekipler, doğrudan kontrollü bir kendi kendine barındırma değerlendirmesine geçebilir.