

Kısaca
Muse Wonder, Claude Opus 5.5 ve GPT-6 Sol, kodlama ve ajan iş akışları için konumlandırılmış yüksek kapasiteli modellerdir. Meta’nın yeni Muse Wonder’ı kalıcı bellek ve sürdürülebilir yürütmeye vurgu yapar; Opus 5.5, atıf yapılan bileşik zeka indeksinde öndedir; GPT-6 Sol, bu karşılaştırmada standart kısa bağlam giriş ve çıkış ücretlerinde en düşük oranlara sahiptir; uzun bağlam katmanı ise ayrı fiyatlanır. Seçimi tek bir liderlik tablosu puanı yerine, temsili görev kalitesi, güvenilirlik ve toplam maliyete göre yapın.
Öne Çıkanlar
- Genel zeka: Claude Opus 5.5, raporlanan Intelligence Index v4.3’te 58 alırken Muse Wonder 52 alıyor.
- Uzun ufuklu kodlama: Muse Wonder, DeepSWE 1.1’de 78.8 ve SWE-Marathon’da 53.1 alıyor; Opus 5.5, Meta’nın tablosunda sırasıyla 74.2 ve 46.3 kaydediyor.
- Düşük maliyetli akıl yürütme: GPT-6 Sol, OpenAI’nin kısa bağlam standart API’si üzerinden 1 milyon token başına $2 giriş / $10 çıkış ile başlar.
- Bellek odaklı ajanlar: Muse Wonder, Active Memory ve Active Focus’u sunar.
- Erişilebilirlik önemlidir: Muse Wonder Full, geliştiricilerin erişebildiği standart Muse Wonder’dan ayrı, daha kısıtlı bir üründür.
Muse Wonder, Claude Opus 5.5 ve GPT-6 Sol: Hızlı Bakış
Kalıcı ajanlar ve uzun süreli mühendislik için Muse Wonder’ı, geniş kodlama ve terminal ağırlıklı işler için Claude Opus 5.5’i, daha düşük standart kısa bağlam token maliyetleri için GPT-6 Sol’u seçin.
| Karar faktörü | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Başlangıç kullanım alanı | Kalıcı ajanlar ve uzun soluklu mühendislik | Terminal ağırlıklı kodlama ve profesyonel iş akışları | Bütçe duyarlı kodlama ve otomasyon |
| Bağlam penceresi | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Yayımlanan güçlü yön | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Standart giriş/çıkış $2/$10 (1M token başına) |
| Standart giriş / çıkış (1M token başına) | $4 / $20 | $4 / $20 | $2 / $10; kısa bağlam katmanı |
| Sağlayıcı erişimi | Meta Model API; Full ayrı bir abonelik ürünüdür | Anthropic API | OpenAI API |
| Seçim ölçütü | Kabul edilen görev kalitesi ve toplam maliyet | Kabul edilen görev kalitesi ve toplam maliyet | Kabul edilen görev kalitesi ve toplam maliyet |
| Geliştirici | Meta | Anthropic | OpenAI |
| Yayın tarihi | 12 Ekim 2026 | 22 Eylül 2026 | 16 Eylül 2026 |
| Girdi kipleri | Metin, görsel, ses, video; PDF girdileri belgelenmiştir | Metin, görsel | Metin, görsel |
| Çıktı | Metin | Metin | Metin |
| Ayırt edici yetenek | Active Memory ve Active Focus | Araç ve alt ajan iş akışları | Yapılandırılabilir akıl yürütme çabası ve API araçları |
Bu genel bakış, aşağıda incelenen tarihli özellikleri ve yayımlanmış sonuçları özetler. Kıyas satırları farklı değerlendirme yöntemleri kullanır ve düşük token oranları, her başarılı görev başına daha düşük maliyeti garanti etmez. Standart Muse Wonder ve Muse Wonder Full, farklı erişim seçenekleridir.
Özellikler 13 Ekim 2026 tarihinde kontrol edilmiştir. Desteklenen kipler ve özellikler, seçilen uç nokta ve yayın yüzeyine bağlıdır; ses kullanılabilirliği buna dahildir. Model düzeyi yetenekler, her ağ geçidi rotasında destek garantisi vermez.
Muse Wonder, Claude Opus 5.5 ve GPT-6 Sol: Genel Bakış ve Özellikler
Muse Wonder: Kalıcı Ajan İş Akışları
Meta, 12 Ekim 2026’da Muse Wonder ve Muse Wonder Full’ü tanıttı. Standart Muse Wonder, uzun süreli profesyonel görevler, kalıcı ajan belleği ve engellerden kurtulma üzerine vurgu yapar. Active Memory, önceki yararlı bağlamı geri getirmeyi amaçlarken, Active Focus çok adımlı çalışmalarda ilerlemeyi sürdürmeyi hedefler. Meta; kodlama, araştırma, finansal analiz ve kişisel yardım gibi başlıca senaryoları tanımlıyor.
Claude Opus 5.5: Profesyonel Kodlama ve Araç Kullanımı
Claude Opus 5.5, kodlama, akıl yürütme ve çoklu araçlı profesyonel iş akışlarını hedefler. Anthropic, modeli 22 Eylül 2026’da yayımladı. Bağlam penceresi bir milyon token’dır; aşağıda raporlanan kodlama sonuçları, kıyasa göre değişen güçlü yönler gösterir.
GPT-6 Sol: Maliyet Odaklı Akıl Yürütme
GPT-6 Sol, güçlü akıl yürütme ve araç kullanımını nispeten uygun çıkarım maliyetiyle birleştirmeyi hedefler. OpenAI’nin API ekosistemi üzerinden programatik iş akışlarını destekler. Standart kısa bağlam ücretleri, listelenen Claude Opus 5.5 ücretlerinden daha düşüktür; ancak uçtan uca ekonomi, yeniden denemeler ve akıl yürütme token kullanımı gibi etkenlere de bağlıdır.
OpenAI, GPT-6 Sol’u karmaşık kodlama ve ajansal iş akışları için bir model olarak tanımlar; yayın duyurusu aşağıda kullanılan değerlendirme sonuçlarını sunar. Bu makale, satıcıların tüm daha yeni modelleri yerine, belirtilmiş model sürümlerini karşılaştırır.
Mimari ve Akıl Yürütme Kontrolleri
Atıf yapılan kaynaklar, üç modelin tümü için karşılaştırılabilir parametre sayısı ve mimari dökümü sunmuyor. Bu nedenle yoğun ağlar ile uzman karışımı (Mixture-of-Experts) arasında bir sıralama yapmak uygun değildir. Active Memory ve Active Focus, Meta’nın ajan yeteneklerini tanımlar; açıklanmış bir sinir ağı mimarisinin yerine geçmezler. GPT-6 Sol, yapılandırılabilir akıl yürütme çabasını açığa çıkarır; Meta ve Claude’un raporlanan puanları da çaba ve değerlendirme kurulumuna bağlıdır. Bu ayarları, karşılaştırılan yapılandırmanın bir parçası olarak ele alın; değiştirilebilir hesaplama ölçüleri olarak değil.
Karşılaştırma sonucu: Üçü de geniş bağlam pencereleri ve geliştirici API’leri sunar. Muse Wonder, model düzeyinde daha geniş girdi kiplerini belgeliyor; Opus 5.5 ve GPT-6 Sol, metin ve görsel iş akışlarına vurgu yapıyor. Bağlam kapasitesi ve özellik kullanılabilirliği yine de seçilen uç noktada doğrulanmalıdır.
Muse Wonder, Claude Opus 5.5 ve GPT-6 Sol: Performans
Yayımlanan Kıyaslar ve Kaynak Sınırları
Meta’nın resmi model kartı, Muse Wonder ile Claude Opus 5.5’i doğrudan karşılaştırır. OpenAI, GPT-6 Sol sonuçlarını ayrı yayımlar; bu nedenle üç modeli, sürümler ve ayarlar uyumlaştırılmadan tamamen denetimli tek bir liderlik tablosuna yerleştirmek mümkün değildir.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Daha yüksek puan |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
Resmi model kartı metodolojisi, dahili testleri, üçüncü taraf değerlendirmelerini ve sağlayıcı raporlu rakip puanlarını ayırt eder. Tablo, raporlanan değerleri aynen çoğaltır; tüm satırlar için tekdüze, bağımsızca denetlenen bir deneme teşkil etmez.
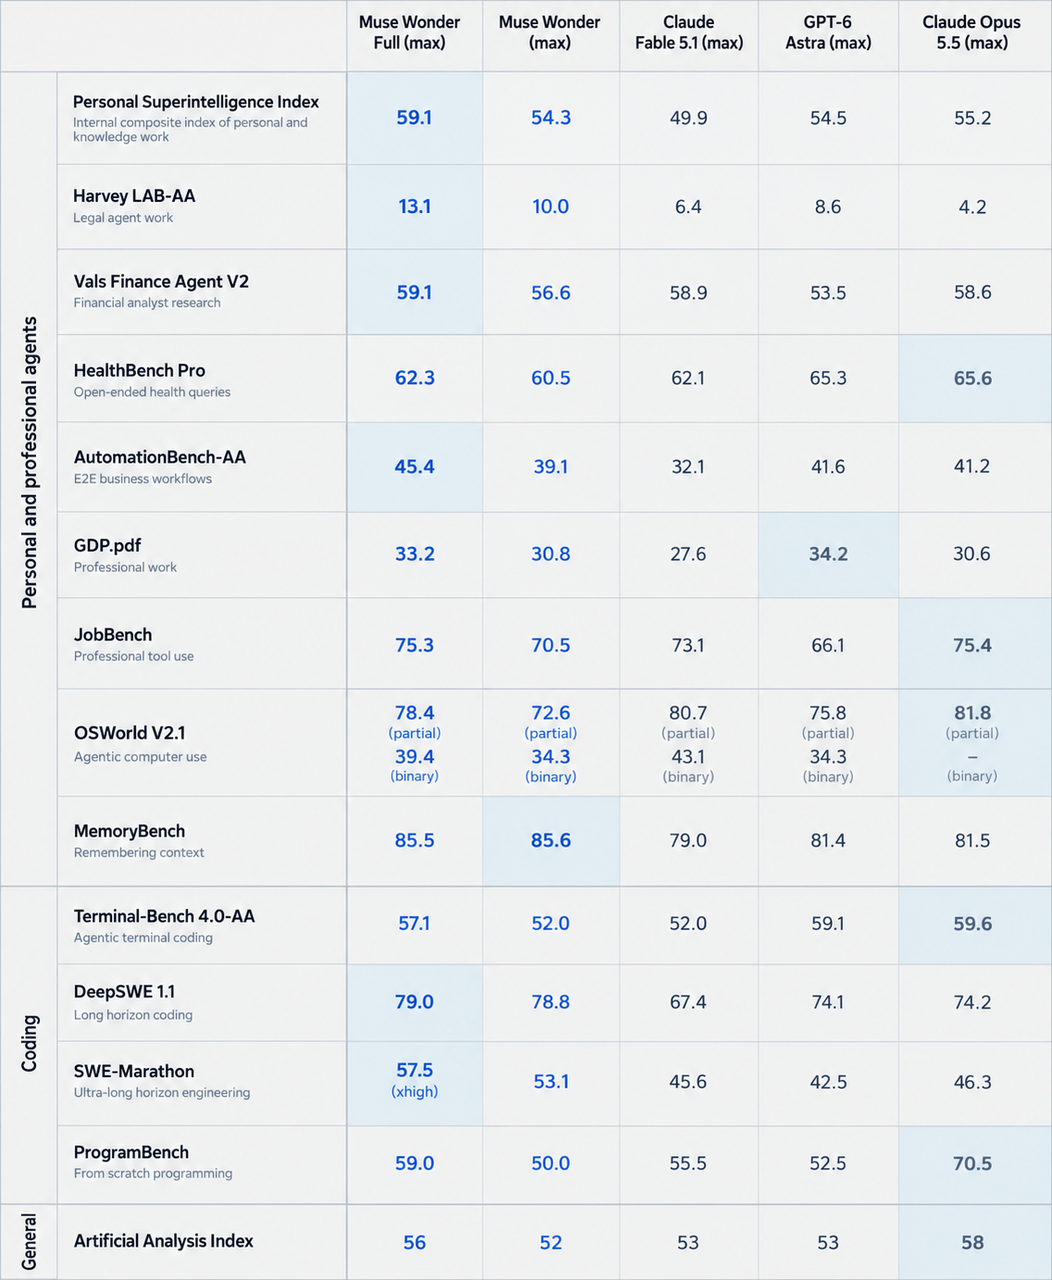
Meta’nın Muse Wonder model kartından alınan orijinal kıyas puan kartı, yeniden çizilmeden çoğaltılmıştır. Bu resmi görselde yer alan ek OpenAI modeli GPT-6 Astra’dır, GPT-6 Sol değildir. Çevreleyen tablolar bu makaleyle ilgili modelleri tanımlar.
Değerlendirme Koşulları
DeepSWE v1.1, 91 depo ve beş dilde 113 görevi kapsar; işlevsel ve regresyon testlerine göre pass@1 ile derecelendirilir; Meta’nın skor kartı Muse Wonder ve Opus 5.5 için Datacurve sonuçlarını kullanır. SWE-Marathon, proje testlerini kullanır ve Abundant AI’den pass@1 raporlar; ajan düzenekleri değişir ve Wonder Full’un puanı xhigh olarak işaretlenmiştir. ProgramBench, mini-swe-agent kullanır ve kurulumdan sonra internet devre dışı iken gizli testlerin en az %95’ini geçen açılımları ölçer. MemoryBench, Meta’nın 64K–100K token’lık konuşma testi olup bir LLM hakemi tarafından puanlanır. Bu ortam ve metrikler tek bir genel doğruluk puanına indirgenmemelidir.
Kodlama ve Yazılım Mühendisliği
Muse Wonder, raporlanan DeepSWE 1.1 ve SWE-Marathon sonuçlarında önde. Claude Opus 5.5, Terminal-Bench 4.0-AA ve ProgramBench’te önde. Bu ayrışma, uzun ufuklu mühendislik, komut satırı araç kullanımı ve program yeniden inşasının farklı becerileri zorladığını gösterir.
GPT-6 Sol Sonuçları ve Kaynaklar Arası Karşılaştırılabilirlik
| Yayımlanan OpenAI değerlendirmesi | GPT-6 Sol | Raporlanan ayar |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maksimum akıl yürütme |
| AutomationBench 1.0.6 | 33.2% | xhigh akıl yürütme |
| Agents' Last Exam V1 | 56.4% | Maksimum akıl yürütme |
| OSWorld 2.0 offline | 60.5% | xhigh akıl yürütme |
OpenAI’nin yayımladığı değerlendirme sonuçları yukarıdaki puanları raporlar. OSWorld sonucu, kurulum v2026.08.08 çevrimdışı setinde kısmi ödüldür; katı bir görev-tamamlama oranı değildir. OpenAI, değerlendirmelerin araştırma ortamı veya API kullanılarak yapıldığını not eder; üretim yapılandırmaları farklı olabilir.
Raporlanan DeepSWE puanları, Muse Wonder ile GPT-6 Sol arasında 10.0 puanlık, Opus 5.5 ile GPT-6 Sol arasında 5.4 puanlık fark ima eder. Bunlar yayınlar arası aritmetik farklardır; model-tek başına üstünlüğün kontrollü bir tahminini oluşturmaz. Farklı ajan kurulumları, istemler, çaba seviyeleri ve araç bütçeleri sonucu etkileyebilir.
Bellek ve Uzun Süreli Ajanlar
Muse Wonder, önceki kararları hatırlaması, bağlamı geri kazanması ve yarım kalan çalışmayı sürdürmesi gereken ajanları hedefler. Active Memory, bir araştırma asistanının proje-özel gerçekleri hatırlamasına yardımcı olabilirken Active Focus, önceki plan başarısız olduğunda yinelemeli eylemi destekler. Bu ürün yetenekleri, hassas işlemler için durum doğrulaması, izinler, denetim izleri veya zorunlu insan onayının yerine geçmez.
Muse Wonder Full Performansı
Muse Wonder Full ayrı bir ürün seçimidir. Meta, standart Muse Wonder’ı API’si üzerinden sunarken Full, Muse Code’da Power Usage ve Maximum Usage abonelikleriyle sınırlıdır. Daha yüksek puan, Full’ü standart modelin API ikamesi yapmaz.
Meta’nın raporladığı Wonder Full sonuçları: Intelligence Index’te 56, Personal Superintelligence’ta 59.1, Harvey LAB-AA’da 13.1 ve AutomationBench-AA’da 45.4. Ayrıca DeepSWE 1.1’de 79.0, SWE-Marathon’da 57.5, MemoryBench’te 85.5 ve JobBench’te 75.3 alır. Bu yayımlanan sonuçlar, ayrı erişilen Full ürünü tanımlar; ortak düzenekte yeni ölçümler değildir.
Yukarıdaki standart Muse Wonder puanlarıyla karşılaştırıldığında, Full bu sekiz ölçümden yedisinde iyileşir; MemoryBench, 85.6’ya karşı 85.5 ile biraz daha düşüktür. Opus 5.5, raporlanan Intelligence Index’te hâlâ 58 ile öndedir.
Gecikme ve Güvenilirlik
Atıf yapılan kanıt, üç model için eşleştirilmiş bir gecikme karşılaştırması sağlamıyor. İlk faydalı çıktıya kadar süreyi, medyan ve %95’lik dilim uçtan uca görev süresini, zaman aşımı sıklığını ve müdahale olmadan tamamlamayı ölçün. Görev girdilerini, araç izinlerini, eşzamanlılığı ve kabul kriterlerini sabit tutun; çaba ayarlarını ve yeniden deneme bütçelerini kaydedin. Yalnızca daha hızlı token üretimi, çok adımlı bir görevin daha hızlı tamamlandığını göstermez.
Karşılaştırma sonucu: Muse Wonder, atıf yapılan sürdürülebilir mühendislik testlerinde önde; Opus 5.5 ise terminal ve program-yeniden-inşa testlerinde önde. GPT-6 Sol, daha düşük token fiyatlı bir aday olarak kalır; ancak mevcut yayınlar, üçü arasında eş ortamda kalite veya hız sıralamasını kanıtlamaz.
Muse Wonder, Claude Opus 5.5 ve GPT-6 Sol: Maliyet
Resmi API Token Fiyatları
| 1M token başına fiyat | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Standart giriş | $4 | $4 | $2 |
| Standart çıkış | $20 | $20 | $10 |
| Önbellekli giriş | $0.20 | $0.20 | $0.20 |
| Uzun bağlam girişi | $4 | $4 | $4 |
| Uzun bağlam çıkışı | $20 | $20 | $15 |
| Uzun bağlam önbellekli giriş | $0.20 | $0.20 | $0.40 |
Meta, 1 milyon token başına $4 giriş, $20 çıkış ve $0.20 önbellekli giriş yayımlar. Anthropic, Opus 5.5’i 1 milyon token başına $4 giriş, $20 çıkış ve $0.20 önbellek isabetleri şeklinde listeler. OpenAI’nin fiyatlandırma tablosu, GPT-6 Sol’u kısa bağlamda giriş/çıkış için $2/$10 ve uzun bağlam için $4/$15 olarak listeler; önbellekli giriş oranları da katmana göre değişir. Bir iş yükünü tahmin etmeden önce ilgili istek başına bağlam katmanını, işleme modunu ve uç nokta koşullarını uygulayın.
GPT-6 Sol için, 272,000’den fazla giriş token’ı içeren istekler daha yüksek oranlardan faturalandırılır:
- Giriş token’ları: Standart oranın 2×’i; 1 milyon token başına $2’den $4’e yükselir.
- Önbellekli giriş token’ları: Standart oranın 2×’i; 1 milyon token başına $0.20’den $0.40’a yükselir.
- Çıkış token’ları: Standart oranın 1.5×’i; 1 milyon token başına $10’dan $15’e yükselir.
Bu yüksek oranlar, yalnızca eşiği aşan kısma değil, tüm isteğe uygulanır. Bu nedenle 272,001 giriş token’lı bir istek, tüm giriş, önbellekli giriş ve çıkış token’ları için uzun bağlam fiyatlandırma katmanına girer.
Karşılaştırıldığında, Muse Wonder ve Claude Opus 5.5, standart API oranları kapsamında eşdeğer bir uzun bağlam fiyat primi uygulamaz.
Bu ayrım, GPT-6 Sol’un kısa bağlam fiyat avantajının istekler büyüdükçe daralabileceği büyük belge analizi, depo genelinde kodlama ve uzun süreli AI ajanları için özellikle önemlidir.
CometAPI Fiyatlandırması ve Faturalandırma Koşulları
İnceleme zamanında, CometAPI; Opus 5.5’i 1 milyon token başına $3.20 giriş / $16 çıkış, GPT-6 Sol’u $1.60 giriş / $8 çıkış olarak listeliyordu. Bunlar CometAPI’ye özgü oranlardır ve yukarıdaki resmi sağlayıcı fiyatlarıyla karıştırılmamalıdır. Maliyet tahmini yapmadan önce geçerli rota, bağlam katmanı ve hesap faturalandırma koşullarını doğrulayın; fiyatlar ve koşullar değişebilir.
Kabul Edilen Görev Başına Maliyet
Kabul edilen görev başına maliyeti, ücretlendirilen yeniden denemeler ve geri dönüşler dâhil olmak üzere toplam faturalandırılan model ve araç harcaması, önceden tanımlanmış kabul kriterlerini karşılayan çıktı sayısına bölünerek hesaplayın. İnsan inceleme süresini ayrı kaydedin ya da açık bir işçilik oranı kullanarak dönüştürün. Başarısız istekleri ve gerçek ücretlendirmeleri bağımsız olarak takip edin: tek başına başarısızlık, bir isteğin faturalanıp faturalandırılmadığını belirlemez.
Karşılaştırma sonucu: GPT-6 Sol, listelenen standart kısa bağlam giriş ve çıkış oranlarında en düşük değerlere sahiptir; Muse Wonder ve Opus 5.5 aynı temel oranları paylaşır. Gerçek kabul edilen görev başına maliyet, seçilen faturalandırma rotası, önbellek kullanımı, bağlam katmanları, araç ücretleri, yeniden denemeler ve inceleme çabasına bağlıdır.
Muse Wonder, Claude Opus 5.5 ve GPT-6 Sol: Karşılaştırma ve Seçim
Yetenek ve İş Yüküne Dayalı Seçim
- Geniş kodlama ve terminal iş akışları için, atıf yapılan Intelligence Index, Terminal-Bench ve ProgramBench sonuçlarında önde olduğu için Claude Opus 5.5 ile başlayın. Yeniden düzenleme, araç yürütme ve program düzeyi tutarlılık üzerinde doğrulayın.
- Uzatılmış mühendislik projeleri için, raporlanan DeepSWE ve SWE-Marathon sonuçları Opus 5.5’ten daha güçlü olduğu için Muse Wonder ile başlayın. Görev tamamlama, engellerden toparlanma ve toplam görev maliyetini ölçün.
- Kalıcı kişisel ajanlar için, Active Memory ve Active Focus sunduğu ve raporlanan MemoryBench puanı Opus 5.5’ten yüksek olduğu için Muse Wonder ile başlayın. Hatırlama, düzeltmeler, süreklilik ve proje izolasyonunu test edin.
- Çok adımlı araç iş akışları için, üçünü de değerlendirin. Muse, Active Focus’u sunar, Opus araç orkestrasyonunu vurgular ve GPT-6 Sol Responses API araçlarını destekler. Araç izinleri, yeniden denemeler ve durum yönetimi dâhil olmak üzere tam ajan yığınını karşılaştırın.
- Profesyonel belgeler ve analiz için, Muse Wonder veya Claude Opus 5.5’i değerlendirin. Muse, uzmanlaşmış güçlü yönlere sahipken Opus, daha güçlü bir atıf yapılan bileşik indekse sahiptir. Temsili belgeler ve görev-özel kabul kriterleri kullanın.
- Yüksek hacimli, maliyet duyarlı otomasyon için, listelenen standart kısa bağlam giriş/çıkış oranları en düşük olduğu için GPT-6 Sol ile başlayın. Kabul edilen görev maliyetini, bağlam katmanlarını, gecikmeyi ve yeniden denemeleri kontrol edin.
- Meta’nın en üst seviye seçeneği için, erişilebilirse Muse Wonder Full’u değerlendirin. Birçok uzmanlaşmış görevde daha yüksek raporlanan puanlara sahiptir; ancak standart API modelinin yerine geçen bir seçenek değildir. Abonelik erişimini ve uygunluğunu testten önce doğrulayın.
Profesyonel Kodlama
Claude Opus 5.5, araç yürütme, yeniden düzenleme ve program düzeyi tutarlılığın önemli olduğu geniş mühendislik asistanı gerektiren ekipler için iyi bir varsayılandır. Raporlanan Terminal-Bench ve ProgramBench avantajları bu durumu güçlendirir; yine de ekiplerin yalnızca modeli değil, tam ajan yığınını doğrulaması gerekir.
Yüksek Hacimli Otomasyon
İstekler çok sayıda ve maliyet duyarlılığı yüksek olduğunda GPT-6 Sol caziptir. Düşük riskli, kolay doğrulanabilir görevlerde (örn. dokümantasyon taslağı çıkarma, yapılandırılmış alanlar çıkarma, kod açıklama) mütevazı bir kalite açığı kabul edilebilir. Uzun otonom çalışmalarda kaliteyi, tokenleri, gecikmeyi ve yeniden denemeleri birlikte takip edin.
Üretim Değerlendirme Kontrol Listesi
Üretim değerlendirmesi altı metriği izlemelidir: doğruluk (kabul edilen yanıtlar veya geçen testlerle ölçülür); güvenilirlik (insan müdahalesi olmadan tamamlanan görevlerle ölçülür); gecikme (uçtan uca görev süresiyle ölçülür); token kullanımı (faturalandırılan toplam giriş ve çıkışla ölçülür); ajan verimliliği (araç çağrıları ve düzeltici yeniden denemelerle ölçülür); ve etkin maliyet (toplam harcama/kabul edilen görevler olarak hesaplanır).
Karşılaştırma sonucu: Kalıcı ajan ve uzatılmış mühendislik görevleri için Muse Wonder’ı kısa listeye alın; güçlü terminal talepli geniş kodlama iş akışları için Opus 5.5’i; token maliyeti büyük bir kısıt olduğunda GPT-6 Sol’u. Bir adayı, görev-özel kalite ve güvenilirlik eşiklerini karşıladıktan sonra terfi ettirin.
Muse Wonder, Claude Opus 5.5 ve GPT-6 Sol’a Nereden Erişebilirsiniz?
Resmi Sağlayıcı Erişimi
Standart Muse Wonder için Meta Model API’yi, Opus 5.5 için Anthropic API’yi veya GPT-6 Sol için OpenAI API’yi kullanın. Muse Wonder Full, standart API modelinin yerine geçen bir seçenek olarak değil, belirtilen Muse Code abonelik planları üzerinden sunulur. Seçtiğiniz rota için hesap erişimini, kullanım sınırlarını ve desteklenen istek özelliklerini kontrol edin.
CometAPI Erişimi
Birleştirilmiş bir ağ geçidi, kimlik doğrulamayı, faturalandırmayı ve yönlendirmeyi basitleştirebilir. Karmaşık mimari incelemesi için daha yüksek performanslı bir model ve tekrarlı, düşük riskli taslaklar için daha ucuz bir model kullanın. Model tanımlayıcısını ve desteklenen istek biçimini hedef API uç noktasıyla her zaman karşılaştırın.
Geliştiriciler, temsili iş yüklerini değerlendirmek için CometAPI’de Claude Opus 5.5 API ve CometAPI’de GPT-6 Sol API erişimini kullanabilir. Ortak bir ağ geçidinin tüm istek biçimlerini değiştirilebilir kıldığı varsayımı yerine, her model için desteklenen API yüzeyini doğrulayın.
Bu makalede belirtilen CometAPI rotaları Opus 5.5 ve GPT-6 Sol’u kapsar. Bu makale, Muse Wonder veya Wonder Full için bir CometAPI rotası oluşturmaz; bu ürünleri değerlendirirken doğrulanmış sağlayıcı rotasını kullanın.
Sonuç
Tek bir model her iş yükünde kazanmaz. Muse Wonder, kalıcı-ajan davranışı ve uzun süreli mühendislik görevleri için test edilecek en güçlü adaydır. Claude Opus 5.5, geniş kodlama, terminal ağırlıklı iş akışları ve bilgi çalışması için güçlü bir adaydır ve Meta’nın raporladığı Artificial Analysis Intelligence Index değerinde öndedir. GPT-6 Sol, en düşük standart kısa bağlam token fiyatlarını sunar ve maliyet duyarlı otomasyon için çekicidir. Üretim ekipleri, temsili iş yüklerinde kabul edilen görev kalitesi, güvenilirlik, gecikme, yeniden denemeler, araç kullanımı ve toplam maliyete göre nihai seçimi yapmalıdır.
SSS
Ekipler Muse Wonder, Opus 5.5 ve GPT-6 Sol’u adil şekilde nasıl test edebilir?
Sabit kabul kriterleri, aynı giriş artefaktları ve belgelenmiş araç izinleriyle ayrılmış gerçek görevler kullanın. Her model sürümünü, çaba ayarını, ajan düzeneğini, zaman aşımını ve token bütçesini kaydedin. Çıktıların değiştiği tekrarlı denemeler yapın, başarısızlıkları başarılarla birlikte raporlayın ve ortak-düzenek karşılaştırmasını en iyi-yapılandırılmış-sistem karşılaştırmasından ayırın. Bu, başka bir ekibin kıyas kurulumundan ziyade sizin iş akışınıza uygulanabilir kanıt üretir.
Bir API ağ geçidi, modeller arasında geçiş yaparken ajan durumunu koruyabilir mi?
Paylaşılan bir ağ geçidi adresi tek başına taşınır konuşma durumu, araç çağrısı tanımlayıcıları veya depolanmış yanıt referanslarını garanti etmez. İletileri, araç çıktıları ve doğrulanmış görev durumunu uygulama tarafında kanonik olarak kaydedin. Devam eden bir işi başka bir modele yönlendirmeden önce her rotanın durum ve araç semantiğini test edin; aksi halde daha ucuz bir geri dönüş doğru bitirmek için gereken bilgiyi kaybedebilir.
Ekipler yeniden denemeler ve insan incelemesi için nasıl bütçe oluşturmalı?
Testten önce kabul edilen bir sonucu tanımlayın, ardından kabul edilen sonuç başına toplam faturalandırılan model ve araç harcamasını bölün. İnceleme işçiliğini ayrı raporlayın veya belirtilmiş bir saatlik oranla dâhil edin. Başarısız girişimleri, düzeltici çağrıları ve geri dönüş modellerini sayın; hem tipik hem de yüksek maliyetli görevleri karşılaştırın. Bu, daha düşük token fiyatını, faydalı işin maliyetinde garantili bir azalma gibi görmekten kaçınır.
Belleğe duyarlı bir ajan değerlendirmesi neleri içermelidir?
Ajanın ilgili gerçekleri hatırlayıp hatırlamadığını, düzeltmeleri dahil edip etmediğini, eski talimatları görmezden gelip gelmediğini ve ayrı projeleri yalıtılmış tuttuğunu test edin. Sadece tek bir uzun istem yerine gecikmeli takipler ve çelişkili güncellemeler ekleyin. Kalıcılık, getirme ve silme dağıtılan sisteme bağlı olduğundan, bellek davranışını model düzeyinde olduğu kadar uygulama düzeyinde de kontrol edin.