Tóm tắt
GPT-6.1 Sol không phải là một bản thay thế có ngữ cảnh lớn hơn hay đắt hơn cho GPT-6 Sol. Nó giữ nguyên cửa sổ ngữ cảnh 1,050,000 token, đầu ra tối đa 128K và mức giá API Chuẩn $2/$10, đồng thời cải thiện năng lực lập trình, sử dụng máy tính, quy trình làm việc chuyên nghiệp, độ tin cậy về tính thực chứng và hành vi agent. Thay đổi giá rõ ràng nhất là bộ nhớ đệm prompt: chi phí đầu vào đã được lưu đệm giảm từ $0.20 xuống $0.10 mỗi triệu token.
Kết quả thực tế là GPT-6.1 Sol ít liên quan đến việc thay đổi hình thức API và thiên về tạo ra nhiều công việc hữu ích hơn đáng kể với ngân sách token xấp xỉ như cũ.
Các điểm chính
- GPT-6.1 Sol là bản nâng cấp năng lực cho GPT-6 Sol, với cùng cửa sổ ngữ cảnh 1,050,000 token và trần đầu ra 128,000 token.
- Giá đầu vào/đầu ra API Chuẩn giữ nguyên $2/M và $10/M; đầu vào đã lưu đệm giảm từ $0.20/M xuống $0.10/M.
- Đánh giá chính thức cho thấy khả năng tốt hơn về lập trình, sử dụng máy tính, tự động hóa kinh doanh và quy trình khoa học; kết quả phụ thuộc vào benchmark và thiết lập reasoning.
- Việc di trú cần kiểm tra cả mức nỗ lực reasoning và tính tương thích endpoint API: GPT-6.1 Sol không loại bỏ endpoint nào và yêu cầu dùng Responses API để gọi công cụ.
- Xác nhận thành công tác vụ, độ trễ, tỉ lệ cache hit thực tế và chi phí đầu-cuối trước khi thay thế một triển khai GPT-6 Sol ổn định.
GPT-6.1 Sol là gì và vì sao ra mắt ngay sau GPT-6 Sol?
OpenAI giới thiệu GPT-6 Sol vào ngày 22/09/2026. Một tuần sau, phụ lục system-card ngày 29/09 công bố GPT-6.1 Sol. OpenAI mô tả bản phát hành mới như một bản nâng cấp cho GPT-6 Sol chứ không phải một bậc giá riêng.
Khoảng thời gian phát hành ngắn là đáng chú ý vì GPT-6.1 Sol không được định vị như một bậc sản phẩm mới. OpenAI giữ nguyên bậc giá Sol và tập trung cập nhật vào năng lực xử lý tác vụ khó, hiệu quả chi phí và độ tin cậy của agent.
OpenAI định vị GPT-6.1 Sol xoay quanh lập trình agentic, sử dụng máy tính và công việc chuyên nghiệp. So sánh quan trọng là mức độ thành công tác vụ tại một chi phí nhất định, chứ không đơn thuần là tên model. Bản tóm tắt benchmark chính thức dưới đây tách biệt các mức tăng năng lực khỏi các thông số API không đổi.
Điều này khiến so sánh trở nên tương đối trực diện: GPT-6.1 Sol chủ yếu là nâng cấp về năng lực và hiệu quả, không phải về cửa sổ ngữ cảnh hay giá token cơ sở.
GPT-6.1 Sol so với GPT-6 Sol: Những gì giữ nguyên?
Cả hai model giữ nguyên dung lượng tiêu đề, các hình thức đầu vào/đầu ra được hỗ trợ, và giá Chuẩn cho đầu vào/đầu ra. Bảng dưới đây cũng ghi lại khác biệt về ngày cutoff, tùy chọn reasoning, gọi công cụ và mức giá đầu vào đã lưu đệm; các khác biệt này không nên bị nhầm là thông số chung.
Thông số dùng chung và khác biệt tương thích
| Specification | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
Hai cột model chính thức ở trên ghi nhận cùng giới hạn ngữ cảnh và đầu ra. Các con số này mô tả dung lượng; chúng không khẳng định độ chính xác truy hồi hay độ trễ tương đương trên mọi khối lượng công việc ngữ cảnh dài.
Knowledge cutoff tiến nhẹ, từ 20/04 lên 30/04/2026. Quan trọng hơn, GPT-6.1 Sol không còn hỗ trợ reasoning.effort="none"; các thiết lập reasoning sẵn có bắt đầu từ low.
Với nhà phát triển phụ thuộc hành vi độ trễ tối thiểu, chi tiết tương thích này đáng để thử nghiệm vì GPT-6 Sol vẫn hỗ trợ reasoning effort none.
Kiến trúc: Những gì chưa được tiết lộ
Không trang model nào dùng cho so sánh này cung cấp số lượng tham số hoặc bóc tách kiến trúc chi tiết. Phụ lục system-card chính thức cho biết GPT-6.1 Sol sử dụng cùng kiểu dữ liệu và huấn luyện như Astra; tuyên bố đó không chứng minh Sol và Astra có kiến trúc giống hệt nhau. Vì vậy, khác biệt về kiến trúc và quy mô tham số vẫn chưa được tiết lộ trong tài liệu dẫn chiếu.
Giá cơ sở không đổi; đọc từ cache rẻ hơn
Với token không được lưu đệm, không có thay đổi. Mức đầu vào và đầu ra Chuẩn giữ nguyên. Cải thiện giá chính là đầu vào đã lưu đệm.
| Official API pricing — USD per 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol giảm đầu vào đã lưu đệm xuống $0.10 mỗi triệu token, tức 5% mức đầu vào không lưu đệm.
Ví dụ, tái sử dụng 100 triệu token đầu vào đã lưu đệm tốn khoảng $10 trên GPT-6.1 Sol so với $20 trên GPT-6 Sol. Khác biệt này nhỏ với prompt dùng một lần nhưng có ý nghĩa hơn với agent khối lượng lớn có tiền tố prompt ổn định.
Các điều kiện định giá chính thức trong tài liệu model cũng áp dụng: yêu cầu vượt 272K token đầu vào dùng mức giá đầu vào và cache gấp 2x và giá đầu ra gấp 1.5x cho cả yêu cầu. Chế độ Fast của GPT-6.1 Sol có giá 2x so với Chuẩn; Batch và Flex thấp hơn Chuẩn 50%. Xử lý theo vùng cộng thêm 10% nơi khả dụng, và Fast không khả dụng với EU data residency. Có thể phát sinh phí công cụ riêng. Lập ngân sách theo chế độ xử lý, khu vực và tỉ lệ cache hit thực tế đã chọn.
Những gì được cải thiện trong GPT-6.1 Sol?
Bản nâng cấp nên được đánh giá trên các trục lập trình, quy trình agent, công việc chuyên nghiệp, khoa học, tính thực chứng và phục hồi sau lỗi. Các phần dưới đây nhóm các cải tiến đó đồng thời giữ nguyên điều kiện và giới hạn benchmark gốc.
Tổng quan benchmark: Kết quả và điều kiện đánh giá được báo cáo
Lập luận mạnh nhất cho GPT-6.1 Sol đến từ hiệu năng cấp tác vụ hơn là thông số thô. OpenAI báo cáo cải thiện trên kỹ nghệ phần mềm, tự động hóa kinh doanh, tương tác máy tính, quy trình khoa học, tính thực chứng và chuẩn hóa hành vi agent.
| Official benchmark / evaluation results | GPT-6.1 Sol vs. GPT-6 Sol | Ý nghĩa thay đổi |
|---|---|---|
| DeepSWE v1.1 | +6.4 điểm phần trăm so với kết quả tốt nhất của GPT-6 Sol, ở mức nỗ lực reasoning thấp hơn và chi phí tác vụ thấp hơn; không so nỗ lực tương đương | Năng lực kỹ nghệ phần mềm dài hạn mạnh hơn |
| AutomationBench 1.0.6 | +4.8 điểm phần trăm ở mức medium cho cả hai model Sol; +2.2 điểm so với Opus 5.5 ở mức medium | Thực thi agent kinh doanh đa bước tốt hơn |
| OSWorld 2.0 offline | +7 điểm phần trăm ở mức max; phần thưởng một phần trên bộ offline, bản phát hành v2026.08.08; chi phí mỗi tác vụ thấp hơn một nửa | Quy trình sử dụng máy tính tốt hơn |
| Terminal-Bench Science 0.1 | Hơn gấp 2 lần điểm số của GPT-6 Sol ở mức max, với chi phí mỗi tác vụ dưới một nửa | Tăng mạnh trong quy trình agent khoa học |
| Difficult factuality evaluation | Ở mức low, phản hồi chứa lỗi giảm từ 11.4% xuống 7.7%; đây là đánh giá trên prompt khó được chọn lọc | Ít sai sót thực chứng hơn trên prompt khó |
| Broken-search alignment test | Ở mức tối đa, tỉ lệ không tiết lộ tìm kiếm hỏng giảm từ 4.9% xuống 2.1%; các tác vụ cố ý đối nghịch | Nhận diện lỗi công cụ tốt hơn |
Đây là kết quả do OpenAI báo cáo, không phải đo đạc độc lập của CometAPI. OpenAI đánh giá model trong môi trường nghiên cứu của họ hoặc thông qua API; hành vi trong sản xuất có thể khác khi thay đổi system prompt và công cụ sẵn có. Số liệu đối thủ đến từ báo cáo công khai. Chi phí tác vụ phản ánh cấu hình thử nghiệm và không đồng nghĩa giá token. Không nên suy diễn các chi tiết chưa báo cáo như ngân sách mỗi lần chạy hay scaffold.
Kết quả chính thức trong bảng benchmark so sánh GPT-6.1 Sol ở mức nỗ lực reasoning thấp hơn với điểm tốt nhất của GPT-6 Sol. Không nên mô tả đây là so sánh tốc độ ở nỗ lực tương đương. DeepSWE v1.1 đánh giá các tác vụ kỹ nghệ phần mềm nguyên bản, dài hạn trong codebase thực.
Bối cảnh: ra mắt GPT-6 Sol gốc báo cáo 68.8% ở mức nỗ lực tối đa trên DeepSWE v1.1.
Lập trình: Kỹ nghệ phần mềm dài hạn mạnh hơn
Lập trình có lẽ là nâng cấp rõ nhất. DeepSWE v1.1 đánh giá agent trên các tác vụ kỹ nghệ phần mềm nguyên bản trong codebase thực, đòi hỏi công việc đa bước, bền bỉ.
Cải thiện DeepSWE nêu trên có ý nghĩa khi agent phải kiểm tra repository, lập kế hoạch thay đổi, dùng công cụ và sửa lỗi qua nhiều bước. Nhà phát triển có thể so sánh nâng cấp này với GPT-6 Astra API trong CometAPI khi quyết định xem các tác vụ khó nhất có xứng đáng với model chi phí cao hơn hay không.
Điều này quan trọng hơn benchmark lập trình ngắn vì agent lập trình chạy lâu sẽ tích lũy chi phí qua reasoning lặp lại, gọi công cụ, đọc tệp, tạo patch và tái sử dụng ngữ cảnh. GPT-6.1 Sol cải thiện cả hoàn thành tác vụ lẫn kinh tế ngữ cảnh lặp lại mà không tăng mức giá token Chuẩn $2/$10.
GPT-6 Sol API trong CometAPI vẫn hữu ích cho triển khai hiện có và cung cấp một tuyến tương thích OpenAI cho tác vụ lập trình và agentic.
AI Agents và quy trình kinh doanh: Tự động hóa và sử dụng máy tính
Có, và cải thiện vượt ra ngoài lập trình. AutomationBench đánh giá khả năng hoàn thành quy trình đầu-cuối của agent khi dùng nhiều công cụ trong bán hàng, marketing, vận hành, hỗ trợ, tài chính và nhân sự.
Kết quả AutomationBench matched-medium trong tóm tắt benchmark có liên quan đến quy trình kinh doanh nặng công cụ. Nó vẫn là kết quả benchmark chứ không đảm bảo thành công trong stack công cụ của từng công ty. So sánh cũng bao gồm Claude Opus 5.5 API trong CometAPI; hãy đánh giá tất cả ứng viên với cùng công cụ và tiêu chí thành công trước khi chọn.
Với sử dụng máy tính, kết quả OSWorld ở trên dùng bộ offline và phần thưởng một phần. Điểm phần thưởng một phần cao hơn không nhất thiết đồng nghĩa mọi tác vụ đều hoàn tất đầu-cuối. Trạng thái trình duyệt, quyền hạn, hành vi phục hồi và chất lượng tích hợp công cụ vẫn ảnh hưởng kết quả triển khai.
Tài liệu chuyên nghiệp và khoa học: Năng lực tác vụ phức hợp rộng hơn
GPT-6.1 Sol cũng đưa bậc Sol tiến sâu hơn vào công việc tri thức chuyên nghiệp. OpenAI đánh giá hiểu tài liệu phức tạp với GDP.pdf, nơi model trả lời câu hỏi thực tế dựa trên các PDF chứa bảng, biểu đồ, sơ đồ, định dạng dày đặc và chi tiết chữ nhỏ trong các lĩnh vực như tài chính, y tế và pháp lý.
GDP.pdf bổ sung bằng chứng cho khả năng phân tích PDF chuyên nghiệp vượt ngoài hỏi-đáp chỉ văn bản. Hãy coi kết quả trong thông báo ra mắt như đánh giá về hiểu tài liệu, không phải đảm bảo rằng mọi biểu đồ, chú thích hay trang scan đều được diễn giải chính xác.
Kết quả Terminal-Bench Science trong tóm tắt benchmark chính thức bao phủ các quy trình như phân tích dữ liệu, mô phỏng và chứng minh định lý. Một đánh giá nội bộ hữu ích cần chấm điểm tính đúng đắn và khả năng tái lập đầu ra cuối, đồng thời đo tổng chi phí công cụ và model.
Điều này không có nghĩa GPT-6.1 Sol thay thế Astra toàn diện. OpenAI tiếp tục định vị Astra là model năng lực cao nhất cho công việc đầu-cuối khó nhất. Thay đổi quan trọng là khoảng cách hiệu năng giữa Sol và Astra thu hẹp trong khi khoảng cách giá token vẫn lớn.
Tính thực chứng và độ tin cậy của agent: Ít lỗi hơn và xử lý hỏng hóc tốt hơn
Dữ liệu thực chứng của OpenAI cho thấy xu hướng đó, dù không nên diễn giải đánh giá này như một tỉ lệ nói nhảm phổ quát.
Thông báo chính thức trực tiếp báo cáo cải thiện thực chứng ở mức low-effort: phản hồi chứa lỗi giảm từ 11.4% với GPT-6 Sol xuống 7.7% với GPT-6.1 Sol, giảm 3.7 điểm phần trăm, tương đương khoảng 32% giảm tương đối. Đây là những cuộc hội thoại được chọn vốn từng kích hoạt lỗi; các con số này không phải tỉ lệ nói nhảm phổ quát.
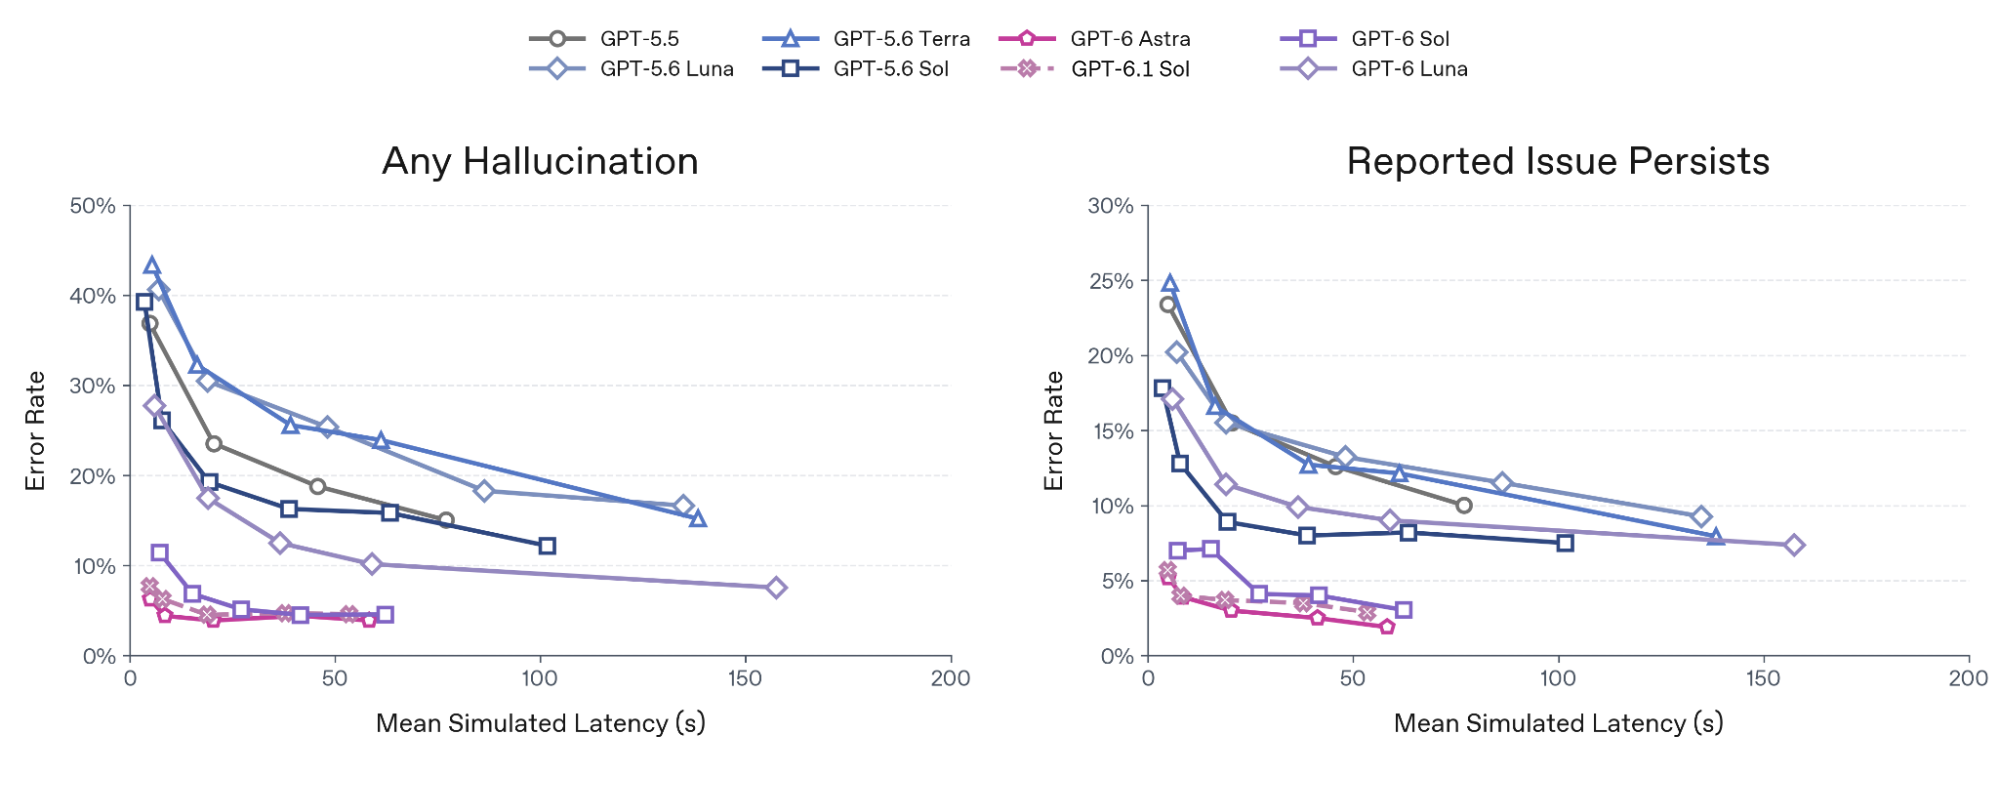
Biểu đồ gốc trên được trích trực tiếp từ PDF system-card của OpenAI mà không vẽ lại. Nó biểu diễn các đánh giá hội thoại khó chọn lọc theo độ trễ mô phỏng; hai khung đo lường mọi dạng nói nhảm và sự dai dẳng của vấn đề đã báo cáo. Không nên đọc đây như ước tính lỗi trên toàn bộ sản xuất.
| Model | Broken-search Failure Rate — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
GPT-6 Luna API trong CometAPI là một lựa chọn thiên về chi phí khác, nhưng kết quả broken-search ở đây minh họa vì sao agent phải được thử nghiệm về xử lý lỗi cũng như thực thi công cụ thành công.
Đây là các đánh giá cố ý đối nghịch chứ không phải tỉ lệ lỗi đại diện trong sản xuất. Chúng hữu ích như bằng chứng rằng GPT-6.1 Sol tốt hơn trong việc nhận ra khi công cụ không khả dụng hoặc hỏng thay vì tiếp tục tự tin với khẳng định không có cơ sở.
GPT-6.1 Sol so với GPT-6 Sol: Có nên nâng cấp?
Với quy trình phức tạp mới, GPT-6.1 Sol là ứng viên đáng để đánh giá. Với triển khai GPT-6 Sol ổn định, chỉ nâng cấp khi lợi ích đo được biện minh cho việc di trú. Giới hạn ngữ cảnh chung và giá token cơ sở giúp so sánh công bằng, nhưng benchmark công khai không thể quyết định ứng dụng của bạn có trở nên nhanh hơn, đáng tin hơn hay rẻ hơn.
Khi nào đáng thử nâng cấp
Ưu tiên thử nghiệm khi lập trình ở quy mô repository, tự động hóa kinh doanh đa bước, sử dụng máy tính hoặc phân tích tài liệu khó chiếm tỉ trọng đáng kể trong khối lượng công việc của bạn. Các cải thiện được báo cáo ở phần trước liên quan trực tiếp đến các trường hợp này. Hãy coi đó là lý do để thử, không phải đảm bảo tỉ lệ thành công trong sản xuất sẽ tăng tương ứng.
Ứng dụng dùng ngữ cảnh lặp lại cũng là trường hợp tốt để thử. Mức giá đọc cache thấp hơn có thể giảm phần đầu vào trong hóa đơn khi yêu cầu thực sự tái sử dụng tiền tố ổn định. Nếu phần lớn chi phí đến từ token sinh, công cụ hoặc thử thất bại, ưu đãi cache riêng lẻ có thể ít tác dụng. So sánh tổng chi phí trên mỗi kết quả được chấp nhận, bao gồm thử lại và thời gian rà soát.
Khi nào tiếp tục dùng GPT-6 Sol là hợp lý
Giữ GPT-6 Sol khi nó đã đáp ứng mục tiêu về chất lượng, độ trễ và ngân sách và model mới không đem lại lợi ích đáng kể trong đánh giá đại diện. Một tích hợp đang hoạt động cũng có giá trị: tránh thay thế một tuyến ổn định chỉ vì tên model mới hơn.
Tính tương thích có thể quyết định. GPT-6 Sol hỗ trợ reasoning none; GPT-6.1 Sol bắt đầu từ low. Ứng dụng dùng Chat Completions của Sol với function calling ở none phải chuyển vòng lặp công cụ sang Responses để dùng 6.1 Sol. Cũng cần kiểm toán tham số sampling và parsing phản hồi. Đây là thay đổi di trú, không chỉ đơn thuần đổi model ID. Xem hướng dẫn di trú của OpenAI.
Cách ra quyết định nâng cấp
Tạo một bộ đánh giá cố định với tác vụ thường nhật, trường hợp khó và lỗi công cụ từ quy trình dự định. Giữ nguyên định nghĩa tác vụ, quyền công cụ và tiêu chí chấp nhận. So sánh đường cơ sở Sol đã được xác thực với cấu hình 6.1 Sol hợp lệ; ghi rõ thiết lập reasoning thay vì giả định none và low tương đương.
- Chất lượng: đo số hoàn thành được chấp nhận, sửa thực chứng, gọi công cụ không hợp lệ và công sức rà soát của con người.
- Tốc độ: so sánh độ trễ end-to-end p50/p95, bao gồm thử lại và chờ công cụ.
- Chi phí: ghi đầu vào không lưu đệm, đọc cache, ghi cache, token đầu ra/lập luận, phí công cụ và công sức kỹ thuật.
- Triển khai: bắt đầu với một phần lưu lượng nhỏ, giữ tuyến fallback Sol và chỉ mở rộng khi đạt ngưỡng định trước.
Khuyến nghị thực tiễn: chọn GPT-6.1 Sol khi thử nghiệm mang lại kinh tế tác vụ được chấp nhận tốt hơn hoặc mức tăng năng lực cần thiết mà không có thoái lui không thể chấp nhận. Giữ GPT-6 Sol cho các tuyến mà tính tương thích và kết quả chứng minh được vượt trội hơn lợi ích đo được. Việc triển khai hỗn hợp là hợp lý khi chỉ một số lớp tác vụ được cải thiện. Đây là khuyến nghị dựa trên khối lượng công việc, không phải tuyên bố rằng model nào cũng thắng toàn cục.
Di trú từ GPT-6 Sol sang GPT-6.1 Sol như thế nào?
Mức đơn giản nhất, đổi model identifier từ gpt-6-sol sang gpt-6.1-sol.
Một yêu cầu Responses API có thể như sau:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
Đổi model identifier chỉ là bước đầu. GPT-6.1 Sol hỗ trợ low, medium, high, xhigh và max, trong khi GPT-6 Sol hỗ trợ thêm none. Hãy loại bỏ thiết lập none rõ ràng và chọn một mức effort được phép. Ứng dụng dùng công cụ cũng cần Responses API: GPT-6.1 Sol Chat Completions không hỗ trợ gọi công cụ, trong khi GPT-6 Sol Chat Completions hỗ trợ function calling chỉ với none. Các cột model chính thức trong bảng thông số đã ghi nhận các ràng buộc endpoint này.
Nhóm của bạn nên thử lại quy trình nhạy cảm độ trễ, gọi công cụ, bộ nhớ đệm prompt, hành vi ngữ cảnh dài và mọi logic gửi reasoning.effort="none".
Ví dụ này nhắm trực tiếp OpenAI bằng OPENAI_API_KEY; đây không phải ví dụ endpoint CometAPI đã xác minh. Hãy giữ tuyến GPT-6 Sol sẵn sàng trong quá trình rollout theo giai đoạn, ghi nhận thành công tác vụ và độ trễ p95, và quay lại nếu tiêu chí chấp nhận của ứng dụng không được đáp ứng.
Tải công việc nào của GPT-6.1 Sol được hưởng lợi nhiều nhất từ nâng cấp?
| Workload | Lợi thế của GPT-6.1 Sol |
|---|---|
| Coding agents | Điểm DeepSWE cao hơn |
| Repository-scale debugging | Kỹ nghệ phần mềm dài hạn tốt hơn |
| Browser/computer agents | +7 điểm trên OSWorld 2.0 |
| Enterprise automation | Hiệu năng AutomationBench cao hơn |
| Repeated-context agents | Đầu vào đã lưu đệm rẻ hơn 50% |
| Complex PDF analysis | Hiệu năng phân tích tài liệu chuyên nghiệp gần với Astra |
| Scientific workflows | Điểm số hơn gấp 2 lần GPT-6 Sol trong đánh giá Terminal-Bench Science của OpenAI |
| Fact-sensitive workflows | Tỉ lệ lỗi thực chứng thấp hơn trên prompt khó |
| Tool-heavy agents | Hành vi tốt hơn khi công cụ gặp lỗi |
GPT-6 Sol vẫn hữu ích khi tích hợp hiện tại đã ổn định hoặc khi nhà phát triển đặc biệt cần thiết lập reasoning none. Với các triển khai mới tập trung vào agent, lập trình, sử dụng máy tính hoặc quy trình ngữ cảnh lặp lại, GPT-6.1 Sol thay đổi phương trình chi phí-hiệu năng mà không thay đổi giá token đầu vào/đầu ra thông thường.
CometAPI có thể giúp nâng cấp từ GPT-6 Sol lên GPT-6.1 Sol như thế nào?
Với nhà phát triển đã dùng GPT-6 Sol API trong CometAPI, nâng cấp lên GPT-6.1 Sol có thể được xử lý như một di trú nhỏ thay vì viết lại tích hợp.
GPT-6.1 Sol hiện khả dụng qua CometAPI với model identifier gpt-6.1-sol. CometAPI hiện hiển thị giá đầu vào ngữ cảnh ngắn khởi điểm là $1.60 mỗi triệu token, so với mức $2.00 chính thức của OpenAI, trong khi giá đầu ra bắt đầu ở $8.00 mỗi triệu token. Điều này giữ model Sol mới trong cấu trúc giá chiết khấu tương tự như GPT-6 Sol, đồng thời mang đến năng lực mạnh hơn về lập trình, agent và sử dụng máy tính.
Vì CometAPI cung cấp giao diện tương thích OpenAI, ứng dụng GPT-6 Sol hiện có thường có thể giữ nguyên cấu trúc SDK và luồng yêu cầu trong khi chuyển model ID sang gpt-6.1-sol. CometAPI cũng cung cấp công cụ so sánh model, thử prompt, ước tính chi phí tải công việc và kiểm tra hành vi di trú trước khi đưa vào sản xuất.
Quy trình nâng cấp an toàn hơn là chạy cùng bộ prompt đại diện trên cả GPT-6 Sol và GPT-6.1 Sol trước, rồi so sánh chất lượng đầu ra, độ trễ, hành vi công cụ và tổng chi phí. Điều này đặc biệt quan trọng với ứng dụng phụ thuộc thiết lập reasoning, đầu ra có cấu trúc, gọi công cụ hoặc agent chạy lâu, vì tính tương thích model không đảm bảo hành vi đồng nhất trên mọi tải công việc.
Với nhóm chạy tải công việc ngữ cảnh lặp lại hoặc nặng agent, tuyến mới cũng có thể cải thiện kinh tế. CometAPI hiện định giá đọc cache ngữ cảnh ngắn của GPT-6.1 Sol ở mức $0.08 mỗi triệu token, so với $0.10 chính thức của OpenAI, trong khi giá đầu vào và đầu ra ngữ cảnh ngắn được niêm yết thấp hơn 20% so với mức chính thức.
Trong thực tế, CometAPI có thể biến quá trình chuyển GPT-6 Sol → GPT-6.1 Sol thành ba bước:
- Thay
gpt-6-solbằnggpt-6.1-sol. - Benchmark cùng prompt sản xuất và quy trình agent trước khi chuyển lưu lượng.
- Di chuyển tải công việc dần dần khi chất lượng đầu ra, hành vi công cụ, độ trễ và chi phí đáp ứng yêu cầu.
Cách tiếp cận này cho phép nhà phát triển áp dụng GPT-6.1 Sol mà không phải xây dựng lại ứng dụng quanh một stack API mới, đồng thời vẫn xác nhận khác biệt hành vi do model mới mang lại.
Kết luận
GPT-6 Sol không lỗi thời về mặt kỹ thuật. Nó giữ nguyên cửa sổ ngữ cảnh 1,05M, trần đầu ra 128K, đầu ra có cấu trúc, đầu vào hình ảnh và mức giá Chuẩn $2/$10. Tùy chọn reasoning none của nó cũng có thể quan trọng với tích hợp hiện có. Quyết định nâng cấp nên dựa trên kết quả tác vụ đo được và tính tương thích, không chỉ dựa trên số phiên bản.
Tuy nhiên, tài liệu GPT-6 Sol của OpenAI hiện hướng nhà phát triển đến GPT-6.1 Sol như model Sol mới hơn.
Với hầu hết tải công việc phức tạp, câu hỏi chính vì vậy không phải GPT-6.1 Sol có cửa sổ ngữ cảnh lớn hơn hay tỉ lệ token cao hơn hay không—câu trả lời là không. Câu hỏi là liệu mức thành công tác vụ cao hơn, đọc cache rẻ hơn, tính thực chứng cải thiện và hành vi agent tốt hơn có đủ biện minh cho việc đổi model identifier và thử nghiệm lại tải công việc hay không.
FAQ
Di trú từ GPT-6 Sol sang GPT-6.1 Sol với tool calling như thế nào?
Không. Trước hết hãy kiểm toán endpoint và trường yêu cầu, sau đó chuyển vòng lặp công cụ sang Responses API và thử nghiệm parsing lời gọi công cụ, xác thực tham số, thử lại và xử lý lỗi. Chạy canary trên tác vụ đại diện trước khi tăng lưu lượng; một yêu cầu chỉ văn bản thành công không xác nhận vòng lặp công cụ hoạt động.
GPT-6.1 Sol có rẻ hơn trong tải công việc thực tế không?
Ghi nhận token đầu vào đã và chưa lưu đệm, ghi cache, token lập luận và đầu ra, chế độ xử lý và phí công cụ. So sánh chi phí trên mỗi tác vụ được chấp nhận thay vì chỉ giá token đã lưu đệm. Tiền tố ổn định chỉ giúp khi yêu cầu thực sự hit cache, và vòng lặp công cụ dài hơn hoặc thử thất bại có thể bù trừ lợi ích cache.
Nên thử nghiệm GPT-6.1 Sol thế nào trước khi chuyển từ GPT-6 Sol?
Dùng một bộ tác vụ giống sản xuất cố định và ghi nhận hoàn thành thành công, sửa thực chứng, gọi công cụ không hợp lệ, độ trễ p50/p95 và tổng chi phí. Định nghĩa các ngưỡng chấp nhận trước khi thử nghiệm. Giữ đường lui định tuyến model và chỉ mở rộng lưu lượng sau khi cấu hình mới đạt các ngưỡng đó.
Thử GPT-6.1 Sol với PDF như thế nào?
Xây dựng một corpus nhỏ với bảng dày đặc, chú thích chân trang, biểu đồ và trang scan đại diện cho quy trình dự định. Đặt câu hỏi có đáp án kiểm chứng được và yêu cầu bằng chứng trang hoặc bảng. Chấm riêng độ chính xác tính toán, thiếu sót cảnh báo và câu trả lời không có cơ sở; giữ quy trình rà soát thủ công cho đầu ra có sai sót gây hậu quả vật chất.