
TL;DR
MiniMax M3.1 Flash đưa AI open-weight vào các quy trình mã hóa và agent đòi hỏi cao, nhưng chạy cục bộ cần phần cứng mạnh. Kiến trúc MoE 428B tham số của nó chỉ kích hoạt khoảng 23B tham số mỗi token, giảm khối lượng tính toán nhưng vẫn cần lưu toàn bộ mô hình. Nhà phát triển có hệ thống đa GPU được hỗ trợ có thể triển khai bằng vLLM hoặc SGLang. Với những ai muốn bỏ qua việc quản lý hạ tầng, MiniMax M3.1 Flash API trong CometAPI là cách bắt đầu đơn giản hơn.
Key Takeaways
- Hardware là rào cản lớn nhất. Các cấu hình vLLM đã công bố dùng bốn GPU Blackwell hoặc AMD MI355X được hỗ trợ, hoặc tám GPU H100/H200.
- Ngữ cảnh dài đi kèm chi phí bộ nhớ. Mô hình hỗ trợ tối đa một triệu token, nhưng giới hạn phục vụ thực tế phụ thuộc vào VRAM sẵn có và độ đồng thời.
- Triển khai phụ thuộc phần cứng. Hãy dùng engine suy luận, định dạng lượng tử hóa và cấu hình tăng tốc tương thích thay vì một lệnh cài đặt chung chung.
- Benchmark chỉ là điểm khởi đầu. Hãy đánh giá độ chính xác mã hóa, tỉ lệ hoàn thành tác vụ của agent, độ trễ và thông lượng với khối lượng công việc của chính bạn.
- Suy luận cục bộ và qua API đáp ứng các nhu cầu khác nhau. Tự lưu trữ cho phép kiểm soát hạ tầng tốt hơn, còn API giảm độ phức tạp thiết lập và chi phí bảo trì.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash nhận văn bản, hình ảnh, và video và sinh văn bản. Mô hình được thiết kế cho các quy trình mã hóa, tự động hóa, tương tác máy tính và bảo mật. Trọng số được phân phối theo MiniMax Community License. Trước khi cung cấp dịch vụ thương mại, hãy đọc giấy phép đi kèm checkpoint và kiểm tra các điều kiện áp dụng cho việc sử dụng của bạn.
MiniMax M3.1 Flash specifications
How does MiniMax M3.1 Flash use its 428B/23B architecture?
Mô hình Mixture-of-Experts (MoE) định tuyến mỗi token qua các expert được chọn. Trong MiniMax M3.1 Flash, khoảng 23B tham số hoạt động cho một token, trong khi tổng pool tham số khoảng 428B. Kích hoạt thưa giảm tính toán; điều này không biến checkpoint thành mô hình dense 23B.
What Changed in MiniMax M3.1 Flash?
- Attention thưa: Áp dụng xuyên suốt mô hình để giảm khối lượng attention trên đầu vào dài; lợi ích phụ thuộc vào kernel phục vụ và prompt.
- Trọng số mixed-precision: Thành phần dense MXFP8 và expert NVFP4 giảm nhu cầu lưu trữ và tính toán, nhưng vẫn đòi hỏi phần cứng và kernel tương thích.
- DSpark decoding: Đầu nháp tích hợp có thể tăng tốc sinh trong các recipe hỗ trợ; kết quả phụ thuộc vào tỉ lệ chấp nhận token và khối lượng công việc.
- Phục vụ nhận thức năng lượng: Lập lịch ở tầng hạ tầng có thể cải thiện mức sử dụng, nhưng không phải tính năng tự có khi chỉ tải trọng số.
What Hardware Is Needed for MiniMax M3.1 Flash?
Dự trù bộ nhớ GPU theo bốn phần: trọng số checkpoint, bộ đệm khóa-giá trị (KV) cho token trước đó, bộ đệm thời gian chạy, và phần dư tải công việc. Ước tính dưới đây chỉ bao phủ lưu trữ thô cho tham số. Mixed precision, thang lượng tử, thành phần đa phương thức, và overhead phục vụ sẽ làm thay đổi yêu cầu thực tế.
Validated GPU topologies
Memory estimate: Lưu trữ thô cho 428B tham số vào khoảng 856 GB ở BF16, 428 GB ở 8-bit, hoặc 214 GB ở 4-bit lý tưởng. Checkpoint chính thức là hỗn hợp định dạng, nên các con số này không phải yêu cầu VRAM khi chạy. Dành chỗ cho thang lượng tử, KV cache, bộ đệm runtime và độ đồng thời; hãy dùng tệp checkpoint thực tế và recipe cho GPU của bạn để tính kích thước hệ thống.
Dự phòng dung lượng NVMe cho checkpoint, tải tạm thời và một bản sao rollback.
Which Deployment Method Should You Choose?
Với cụm cục bộ được hỗ trợ, vLLM là điểm khởi đầu thực tế nhờ cấu hình tham chiếu và API quen thuộc; SGLang phù hợp với đội ngũ muốn tùy biến phục vụ sau khi xác minh tương thích, còn CometAPI cung cấp tuyến hosted để dựng thử nhanh và chuyển đổi mô hình.
Hãy chọn framework có recipe đã xác thực cho phần cứng của bạn, sau đó so sánh độ trễ và thông lượng bằng cùng prompt, độ chính xác và độ đồng thời.
How to Run MiniMax M3.1 Flash Locally With vLLM?
Các bước sau giả định máy chủ Linux có bốn GPU NVIDIA Blackwell tương thích, driver/CUDA hỗ trợ, và quyền truy cập checkpoint chính thức. Dùng bản vLLM đã được xác thực; cài đặt thông thường trên GPU không được hỗ trợ có thể thất bại ngay cả khi cài gói thành công.
Step 1: Install the serving tools
python3 -m venv minimax-env
source minimax-env/bin/activate
python -m pip install --upgrade pip
python -m pip install -U huggingface_hub
python -m pip install "vllm>=0.33.0"
python -c "import vllm; print(vllm.__version__)"
Đảm bảo wheel đã cài và runtime CUDA khớp với dòng GPU của bạn. Nếu cần bản build phát triển riêng cho dự án, hãy theo ghi chú cài đặt tham chiếu trước khi dùng tham số khởi chạy.
Step 2: Download the official checkpoint
hf download MiniMaxAI/MiniMax-M3.1-Flash \
  --local-dir ./MiniMax-M3.1-Flash
Dùng token Hugging Face phù hợp nếu cần, giữ nguyên cấu trúc thư mục, và xác minh tải đầy đủ các shard trước khi khởi chạy server.
Step 3: Launch on four NVIDIA GB200 GPUs
export CUDA_VISIBLE_DEVICES=0,1,2,3
export VLLM_FLOAT32_MATMUL_PRECISION=high

vllm serve ./MiniMax-M3.1-Flash \
  --tensor-parallel-size 4 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype nvfp4 \
  --attention-config '{"indexer_kv_dtype":"nvfp4","use_prefill_query_quantization":true}' \
  --compilation-config '{"cudagraph_mode":"FULL_AND_PIECEWISE"}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"attention_backend":"FLASHINFER_TS","kv_cache_dtype":"fp8","draft_sample_method":"probabilistic","rejection_sample_method":"block"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --disable-hybrid-kv-cache-manager \
  --host 127.0.0.1 \
  --port 8000
Chờ đến khi server tải xong và báo sẵn sàng trước khi gửi yêu cầu. Lệnh trên giới hạn ngữ cảnh ở 32.768 token và số chuỗi đồng thời là bốn cho bài kiểm tra khói ban đầu. Các giới hạn giảm này không phải thiết lập benchmark; hãy điều chỉnh sau khi đo dùng bộ nhớ và hành vi yêu cầu trên phần cứng của bạn.
Step 4: Send a local request
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "./MiniMax-M3.1-Flash",
    "messages": [{"role":"user","content":"Explain sparse attention in three bullets."}],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 1024
  }'
Nếu định danh phục vụ khác tên thư mục, hãy gọi /v1/models và dùng đúng ID trả về. Phản hồi văn bản thành công chỉ xác nhận suy luận cơ bản; hãy kiểm tra thị giác, gọi công cụ, độ đồng thời và ngữ cảnh dài riêng.
Step 5: Integrate with an OpenAI-compatible Python client
python -m pip install openai
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
model_id = client.models.list().data[0].id

response = client.chat.completions.create(
    model=model_id,
    messages=[{"role": "user", "content": "Write a Python duplicate filename detector."}],
    temperature=1.0,
    top_p=0.95,
    max_tokens=2048,
)
print(response.choices[0].message.content)
Ví dụ lắng nghe trên 127.0.0.1 để thử nghiệm cục bộ. Trước khi kết nối client từ xa, hãy đặt lớp kiểm soát truy cập trước endpoint và cấu hình timeout, retry có giới hạn, cùng giám sát cho client.
H100/H200 variant: use the eight-GPU Hopper recipe
Trên tám GPU H100/H200, hãy dùng đường FP8 cache và Marlin MoE dành riêng cho Hopper thay vì cấu hình NVFP4 của Blackwell. Lệnh dưới đây theo recipe vLLM dành cho Hopper chính thức với ngữ cảnh và độ đồng thời giảm còn 32K và bốn chuỗi cho bài thử đầu tiên. Nó tắt đầu vào video theo recipe đó. Hãy để endpoint này sau lớp kiểm soát truy cập hiện có của bạn.
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
How to Run MiniMax M3.1 Flash With SGLang?
SGLang cung cấp các recipe triển khai M3.1 đặc thù phần cứng và phục vụ tương thích OpenAI. Ở bản snapshot ngày 23 tháng 10, tài liệu bao gồm image container phát triển dành riêng, nên không nên giả định cài đặt SGLang chung sẽ chứa đầy đủ hỗ trợ riêng cho mô hình.
Pull the dedicated container image
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Tiếp theo, làm theo cookbook MiniMax M3.1 của SGLang cho bộ tăng tốc của bạn. Việc kéo image chỉ tải runtime; bạn vẫn cần khởi chạy container với quyền truy cập GPU và chạy cấu hình phục vụ tương ứng bên trong. Hãy dùng lệnh đầy đủ đặc thù phần cứng trong cookbook, chờ đến khi sẵn sàng, rồi truy vấn danh sách mô hình của endpoint trước khi gửi yêu cầu thử. Các đường NVIDIA và AMD được ghi tài liệu dùng phụ thuộc khác nhau và nên cấu hình riêng.
How Does MiniMax M3.1 Flash Compare on Benchmarks?
Khi endpoint vượt qua các kiểm tra cơ bản, hãy dùng benchmark đã công bố để quyết định khối lượng công việc cần thử tiếp theo. Các con số dưới đây là đánh giá do nhà cung cấp công bố, không phải đo đạc của triển khai cục bộ của bạn.
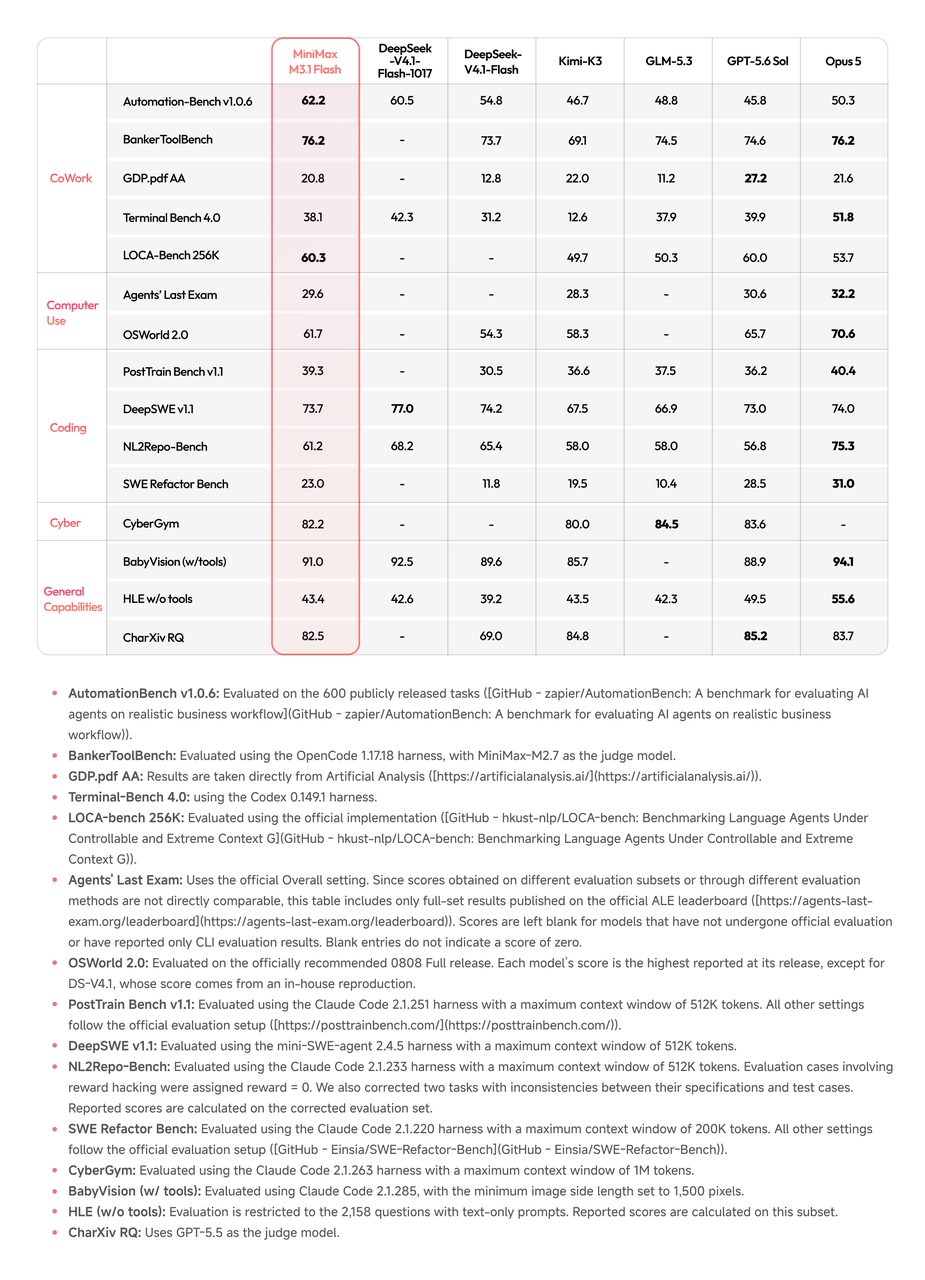
Trong so sánh này, MiniMax dẫn đầu Automation-Bench trong số các mô hình liệt kê, còn DeepSeek dẫn ở một số benchmark mã hóa. Hãy đọc model card và thiết lập đánh giá trước khi kết luận, và kiểm thử các prompt và công cụ ứng dụng của bạn thực sự dùng. Điểm số từ các phiên bản hoặc thiết lập benchmark khác nhau không thể so sánh trực tiếp.
How Can You Optimize MiniMax M3.1 Flash Performance?
Control context and concurrency
Sau yêu cầu thành công đầu tiên, tăng một biến tải mỗi lần: độ dài đầu vào, độ dài đầu ra, hoặc số yêu cầu đồng thời. Ghi nhận bộ nhớ đỉnh và độ trễ phản hồi cho mỗi lượt chạy. Giữ lại thiết lập ổn định gần nhất làm điểm rollback, để một thử nghiệm thất bại không trở thành baseline mới.
Choose reasoning effort deliberately
M3.1 Flash hỗ trợ low, medium, high, xhigh và max. Thiết lập cao hơn có thể cải thiện điểm ở tác vụ khó nhưng thường cần nhiều token suy luận hơn và độ trễ dài hơn. Hãy dùng chất lượng hoàn thành tác vụ cùng chi phí tính toán thực tế.
Để xem mối quan hệ công bố giữa mức suy luận và chi phí tác vụ, xem đồ thị điểm–chi phí Automation-Bench chính thức.
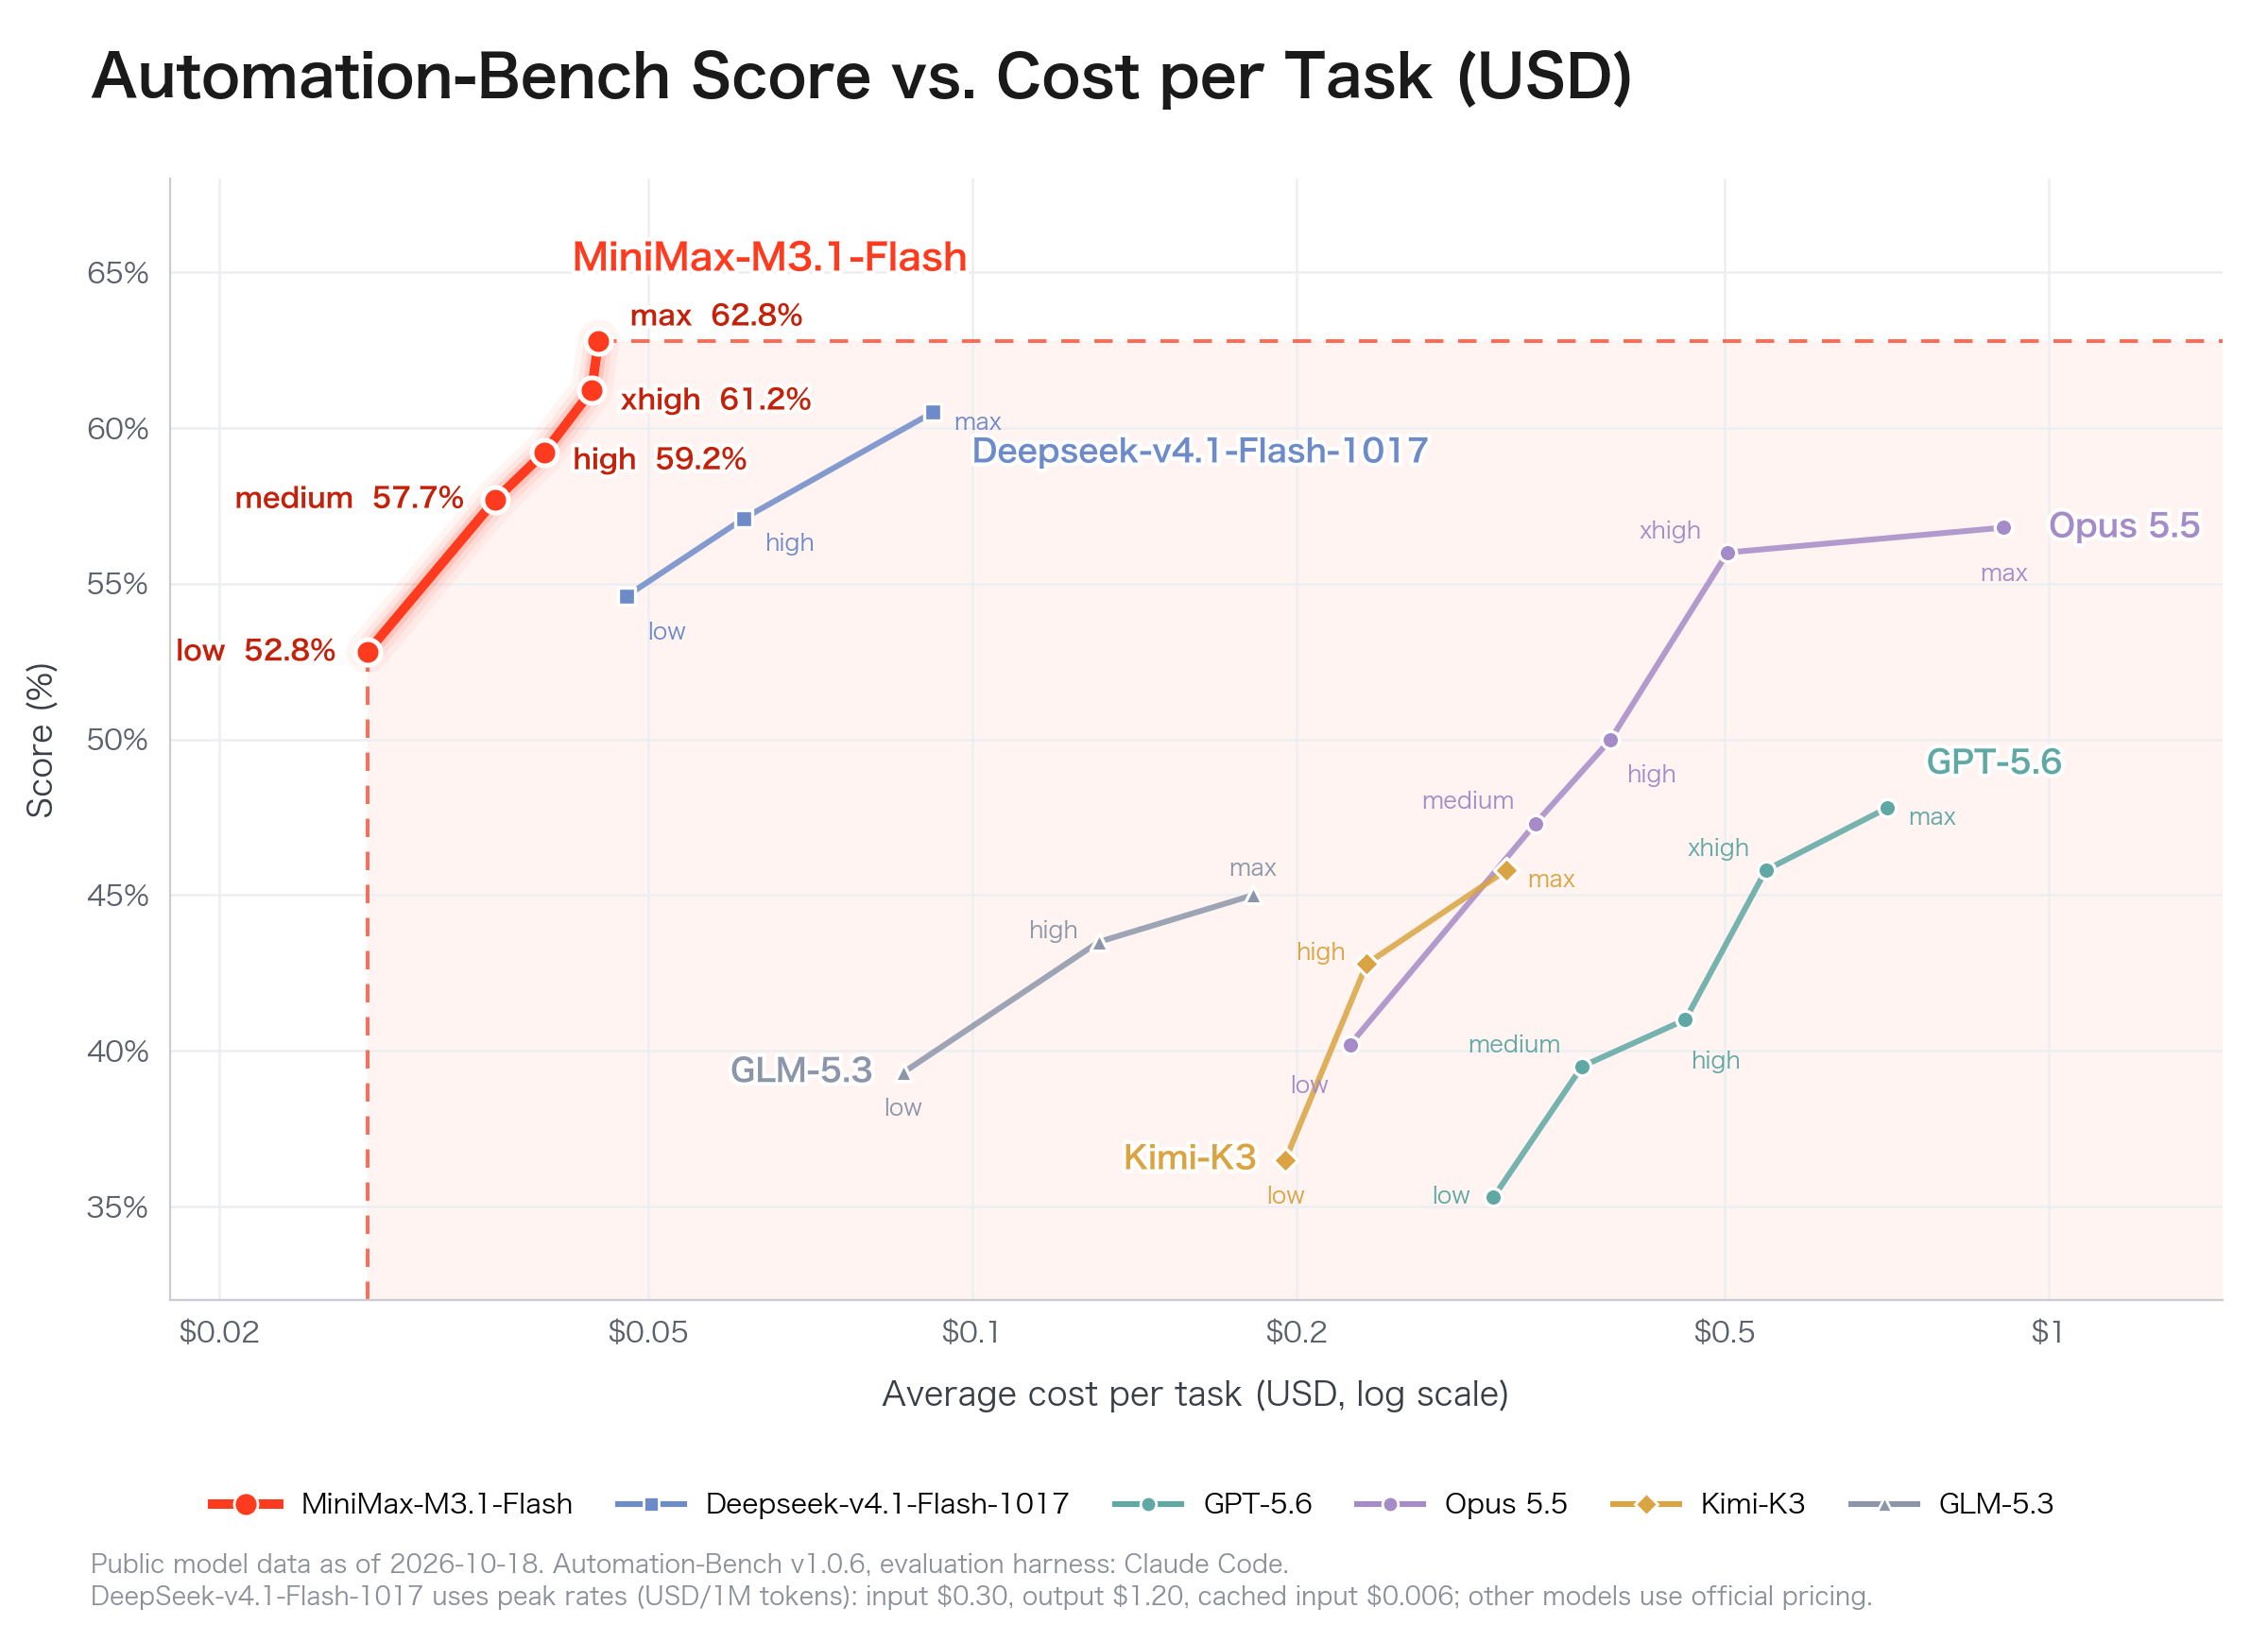
| Mức độ suy luận | Điểm Automation-Bench báo cáo |
|---|---|
| Low | 52.8% |
Với yêu cầu vLLM cục bộ, recipe hiển thị thiết lập reasoning-effort dưới phần chat_template_kwargs. Hãy kiểm tra cả câu trả lời cuối cùng và bất kỳ trường suy luận trả về riêng nào khi xác thực client của bạn, vì endpoint hosted và cục bộ có thể phơi bày các trường này khác nhau.
Track cost per completed task
Với agent, tokens per second là chưa đủ. Hãy ghi nhận thời gian đến token đầu tiên, tốc độ xuất token, tỉ lệ chấp nhận cho speculative decoding, thông lượng đồng thời, lỗi gọi công cụ, mức sử dụng bộ nhớ và chi phí cho tác vụ hoàn thành. Phản hồi chậm hơn nhưng ít lỗi công cụ hơn có thể đem lại kinh tế tổng thể tốt hơn.
How Can You Use MiniMax M3.1 Flash API in CometAPI?
Các đội ngũ không cần hạ tầng tăng tốc chuyên dụng có thể dùng endpoint hosted tương thích OpenAI. Điều này loại bỏ việc tải checkpoint và vận hành GPU nhưng chuyển việc xử lý yêu cầu ra ngoài môi trường tự lưu trữ.
Dùng MiniMax M3.1 Flash API để truy cập hosted. Để so sánh mô hình qua cùng một gateway, thử DeepSeek V4.1 Flash API hoặc Kimi K3 API với cùng bài kiểm thử ứng dụng.
CometAPI request example
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Xác nhận định danh mô hình trong bảng điều khiển CometAPI của bạn trước khi chạy ví dụ. Hãy dùng gateway khi một API chung giữa các nhà cung cấp có ích cho ứng dụng; so sánh báo giá hiện tại của nó với truy cập trực tiếp cho mức sử dụng dự kiến của bạn.
MiniMax M3.1 Flash API pricing
| Giá trên mỗi triệu token | MiniMax official API | CometAPI |
|---|---|---|
| Đầu vào | $0.15 | $0.80 |
Mức giá API trực tiếp của MiniMax trong thông báo ra mắt ngày 19/10/2026 là $0.15 cho đầu vào, $0.60 cho đầu ra, và $0.015 cho đầu vào được cache trên mỗi triệu token. Với CometAPI, hãy kiểm tra route mô hình đang hoạt động, mức giá đầu vào/đầu ra, quy tắc cache và bất kỳ chiết khấu tài khoản nào trước khi ước tính chi tiêu. So sánh chi phí tổng cho tỉ lệ token và retry bạn kỳ vọng.
What Problems Might Occur When Running MiniMax M3.1 Flash?
Out of memory during loading or requests
- Nếu trọng số không tải được: Kiểm tra giai đoạn lỗi trong log khởi động, xác nhận checkpoint đầy đủ, và đảm bảo tô-pô GPU cùng backend lượng tử hóa khớp recipe. Nếu trọng số vượt quá bộ nhớ sẵn có, hãy dùng cấu hình đủ dung lượng; rút ngắn yêu cầu sẽ không khắc phục lỗi không tải được trọng số.
- Nếu trọng số tải được nhưng cấp phát cache thất bại khi khởi động: Kiểm tra thiết lập cache và bộ nhớ sẵn có, rồi giảm ngữ cảnh cấu hình hoặc độ đồng thời theo recipe.
- Nếu server khởi động nhưng yêu cầu hết bộ nhớ: Thử lại với prompt ngắn và chỉ một yêu cầu, rồi tăng độ dài đầu vào, đầu ra và độ đồng thời riêng rẽ trong khi theo dõi bộ nhớ.
Incompatible quantization or attention kernels
Thực thi NVFP4 khác nhau giữa Blackwell, Hopper và phần cứng AMD. Hãy khớp phiên bản engine suy luận, backend lượng tử hóa, phiên bản CUDA/ROCm, và dòng accelerator thay vì dùng cờ tùy tiện.
Sparse-attention cache configuration
Nếu khởi động báo bố cục cache không được hỗ trợ, hãy so sánh toàn bộ cấu hình cache với recipe đặc thù phần cứng. Recipe vLLM hiện tại yêu cầu --block-size 128 cho cache thưa/index MSA. Nếu khởi động báo lỗi bố cục cache hoặc kích thước block, hãy so sánh cấu hình đầy đủ với recipe cho phần cứng của bạn.
Unexpected model identifiers
Đường dẫn cục bộ và tên mô hình ở gateway từ xa không nhất thiết giống nhau. Hãy truy vấn phản hồi /v1/models cục bộ và tránh hardcode giả định từ endpoint khác.
Poor observed throughput
Tách biệt xử lý prompt chậm khỏi sinh token chậm. So sánh các lượt chạy cùng độ dài đầu vào và giới hạn đầu ra, sau đó kiểm tra mức sử dụng GPU và hành vi liên kết liên GPU trước khi tăng kích thước batch. Số liệu tốc độ do nhà cung cấp công bố không phải baseline cho cụm cục bộ của bạn.
Conclusion
Hãy chọn lộ trình triển khai đầu tiên dựa trên phần cứng bạn có thể vận hành hôm nay. Dùng hướng dẫn vLLM cho cụm cục bộ được hỗ trợ, cookbook SGLang đặc thù phần cứng cho ngăn phục vụ thay thế, hoặc API hosted khi bạn muốn tập trung vào tích hợp ứng dụng. Giữ cấu hình đáp ứng mục tiêu chất lượng tác vụ và độ trễ với chi phí vận hành bền vững.
Cách đáng tin cậy nhất để chọn phương pháp phục vụ là tối ưu cho số lượng công việc hoàn thành đúng trên mỗi đô-la và phút, không chỉ đỉnh token mỗi giây.
FAQ
How do I make a deployment reproducible after upgrading the runtime?
Đóng băng revision checkpoint, image runtime hoặc phiên bản gói, stack driver, và thiết lập khởi chạy. Chạy cùng bộ kiểm thử chấp nhận nhỏ trước mỗi lần nâng cấp, và giữ sẵn cấu hình hoạt động trước đó để rollback.
How should I handle retries when an agent calls tools?
Tách retry mô hình khỏi việc lặp lại hành động công cụ. Dùng idempotency key cho các hành động thay đổi dữ liệu, kiểm tra liệu lần thử đầu đã thành công chưa, và xác minh đầy đủ tham số công cụ trước khi thực thi.
Can I switch between a local endpoint and CometAPI without changing application behavior?
Giữ endpoint, thông tin xác thực và ID mô hình ở dạng cấu hình. Kiểm thử streaming, gọi công cụ, trường suy luận và đầu vào đa phương thức trên cả hai tuyến, và xác nhận yêu cầu định tuyến dữ liệu của bạn trước khi bật fallback.
What should I test before accepting multimodal inputs?
Kiểm thử các hình ảnh và video đại diện, bao gồm tệp chất lượng thấp và không được hỗ trợ. Kiểm tra tiền xử lý, giới hạn kích thước, chất lượng câu trả lời và timeout riêng; một yêu cầu văn bản thành công không xác thực tuyến đa phương thức.
How do I know whether a deployment is ready for real users?
Đặt mục tiêu cho tỉ lệ thành công tác vụ, gọi công cụ hợp lệ, độ trễ, lỗi và chi phí. Kiểm thử lưu lượng thực tế, xác minh giám sát và hành vi fallback, rồi chỉ mở rộng từ triển khai nhỏ khi các mục tiêu đó vẫn được đảm bảo.