
Cách nhanh nhất để sử dụng GLM-5.3 Flash API là gọi model qua endpoint chat-completions tương thích OpenAI của CometAPI. Thông tin连接 được汇总在下方的 API 规格表中;请将 API key 保存在服务器端。
Trả lời trước: tạo CometAPI key, cài đặt SDK tương thích OpenAI, gửi yêu cầu POST đến /v1/chat/completions, sau đó chỉ thêm streaming, vision, JSON output hoặc tools khi yêu cầu cơ bản đã chạy thành công.
GLM-5.3 Flash API là gì?
GLM-5.3 Flash là model đa phương thức bản địa hướng hiệu suất của Z.ai trong dòng GLM-5. Model cung cấp năng lực suy luận, ngữ cảnh dài, hiểu thị giác và định hướng tác tử thông qua chat API. Model có 320B tham số tổng nhưng kích hoạt 18B mỗi token; kiến trúc đó quan trọng đối với chi phí, nhưng các nhà phát triển chủ yếu cảm nhận đây là một model có thể duy trì trạng thái với prompt dài và các lần gọi tool lặp lại.
Hướng dẫn này cố ý rút gọn phần kiến trúc và benchmark. Bài tổng quan model đi kèm đã giải thích thiết kế hybrid attention, open weights, ma trận benchmark đầy đủ khi ra mắt, bối cảnh giá và so sánh các model trong cùng họ. Tại đây, trọng tâm là hành vi tích hợp và quyết định triển khai.
Thông số API ảnh hưởng đến tích hợp
| Thông số API | Giá trị | Ý nghĩa thực tiễn |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Cấu hình một lần trong client phía server. |
| Endpoint | POST /v1/chat/completions | Sử dụng route chat-completions tương thích OpenAI. |
| SDK tương thích | Client Python và JavaScript tương thích OpenAI | Tái sử dụng pattern client quen thuộc với CometAPI base URL. |
| Xác thực | Bearer API key | Giữ key trong biến môi trường phía server hoặc secret manager. |
| Mã model | glm-5.3-flash | Dùng đúng giá trị này trong body yêu cầu. |
| Cửa sổ ngữ cảnh | 1,048,576 tokens | Phù hợp cho kho mã lớn, bộ tài liệu, và lịch sử tác tử dài. |
| Đầu ra tối đa | Tối đa 131,072 tokens | Đặt ngưỡng thấp hơn theo ứng dụng để kiểm soát chi phí và độ trễ. |
| Input bản địa | Text, image, video, file | Hỗ trợ từng route có thể khác; xác thực route CometAPI cụ thể trước khi phụ thuộc vào mọi modality. |
| Đầu ra | Text | Model hiểu media nhưng không trả về ảnh hoặc video sinh ra trực tiếp. |
| Reasoning | low, high, max | Dùng mức nỗ lực để đánh đổi độ trễ và token cho chiều sâu. |
| Thinking | Luôn bật | Không gửi tham số để cố tắt thinking. |
| Tính năng cho dev | Streaming, function calling, caching, structured output | Hữu ích cho ứng dụng tương tác, tác tử, và pipeline máy-đọc-được. |
Khả năng của model và khả năng của gateway không đồng nhất. Hãy coi trang model trực tiếp trên CometAPI và schema API là hợp đồng cho route bạn thực sự gọi, đặc biệt với video, file, JSON Schema nghiêm ngặt và các trường thinking đặc thù nhà cung cấp.
Ngữ cảnh hiệu năng ngắn gọn
Z.ai báo cáo kết quả ra mắt tích cực cho các tác vụ quan trọng với người xây API: công việc terminal, kỹ nghệ phần mềm, sử dụng tool và tự động hóa. Đây là điểm số do nhà cung cấp báo cáo với bộ đo và chính sách tool cụ thể, nên hữu ích để nhận diện điểm mạnh tiềm năng hơn là xếp hạng phổ quát.
| Benchmark | GLM-5.3 Flash | Gợi ý cho tải API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Phù hợp mạnh cho tác tử coding điều khiển bằng terminal. |
| DeepSWE v1.1 | 63.4 | Hứa hẹn cho kỹ nghệ phần mềm ở quy mô repository. |
| Toolathlon Verified | 78.4 | Tín hiệu mạnh về lựa chọn và sử dụng công cụ. |
| AutomationBench | 48.8 | Cải thiện tự động hóa nhiều bước so với bản tiền nhiệm. |
Hệ quả thực tiễn hẹp hơn bảng benchmark: GLM-5.3 Flash là ứng viên mạnh khi workflow kết hợp ngữ cảnh dài với tool hoặc phản hồi thị giác. Để so sánh model đầy đủ, dùng tổng quan model hiện có thay vì lặp lại ở đây.
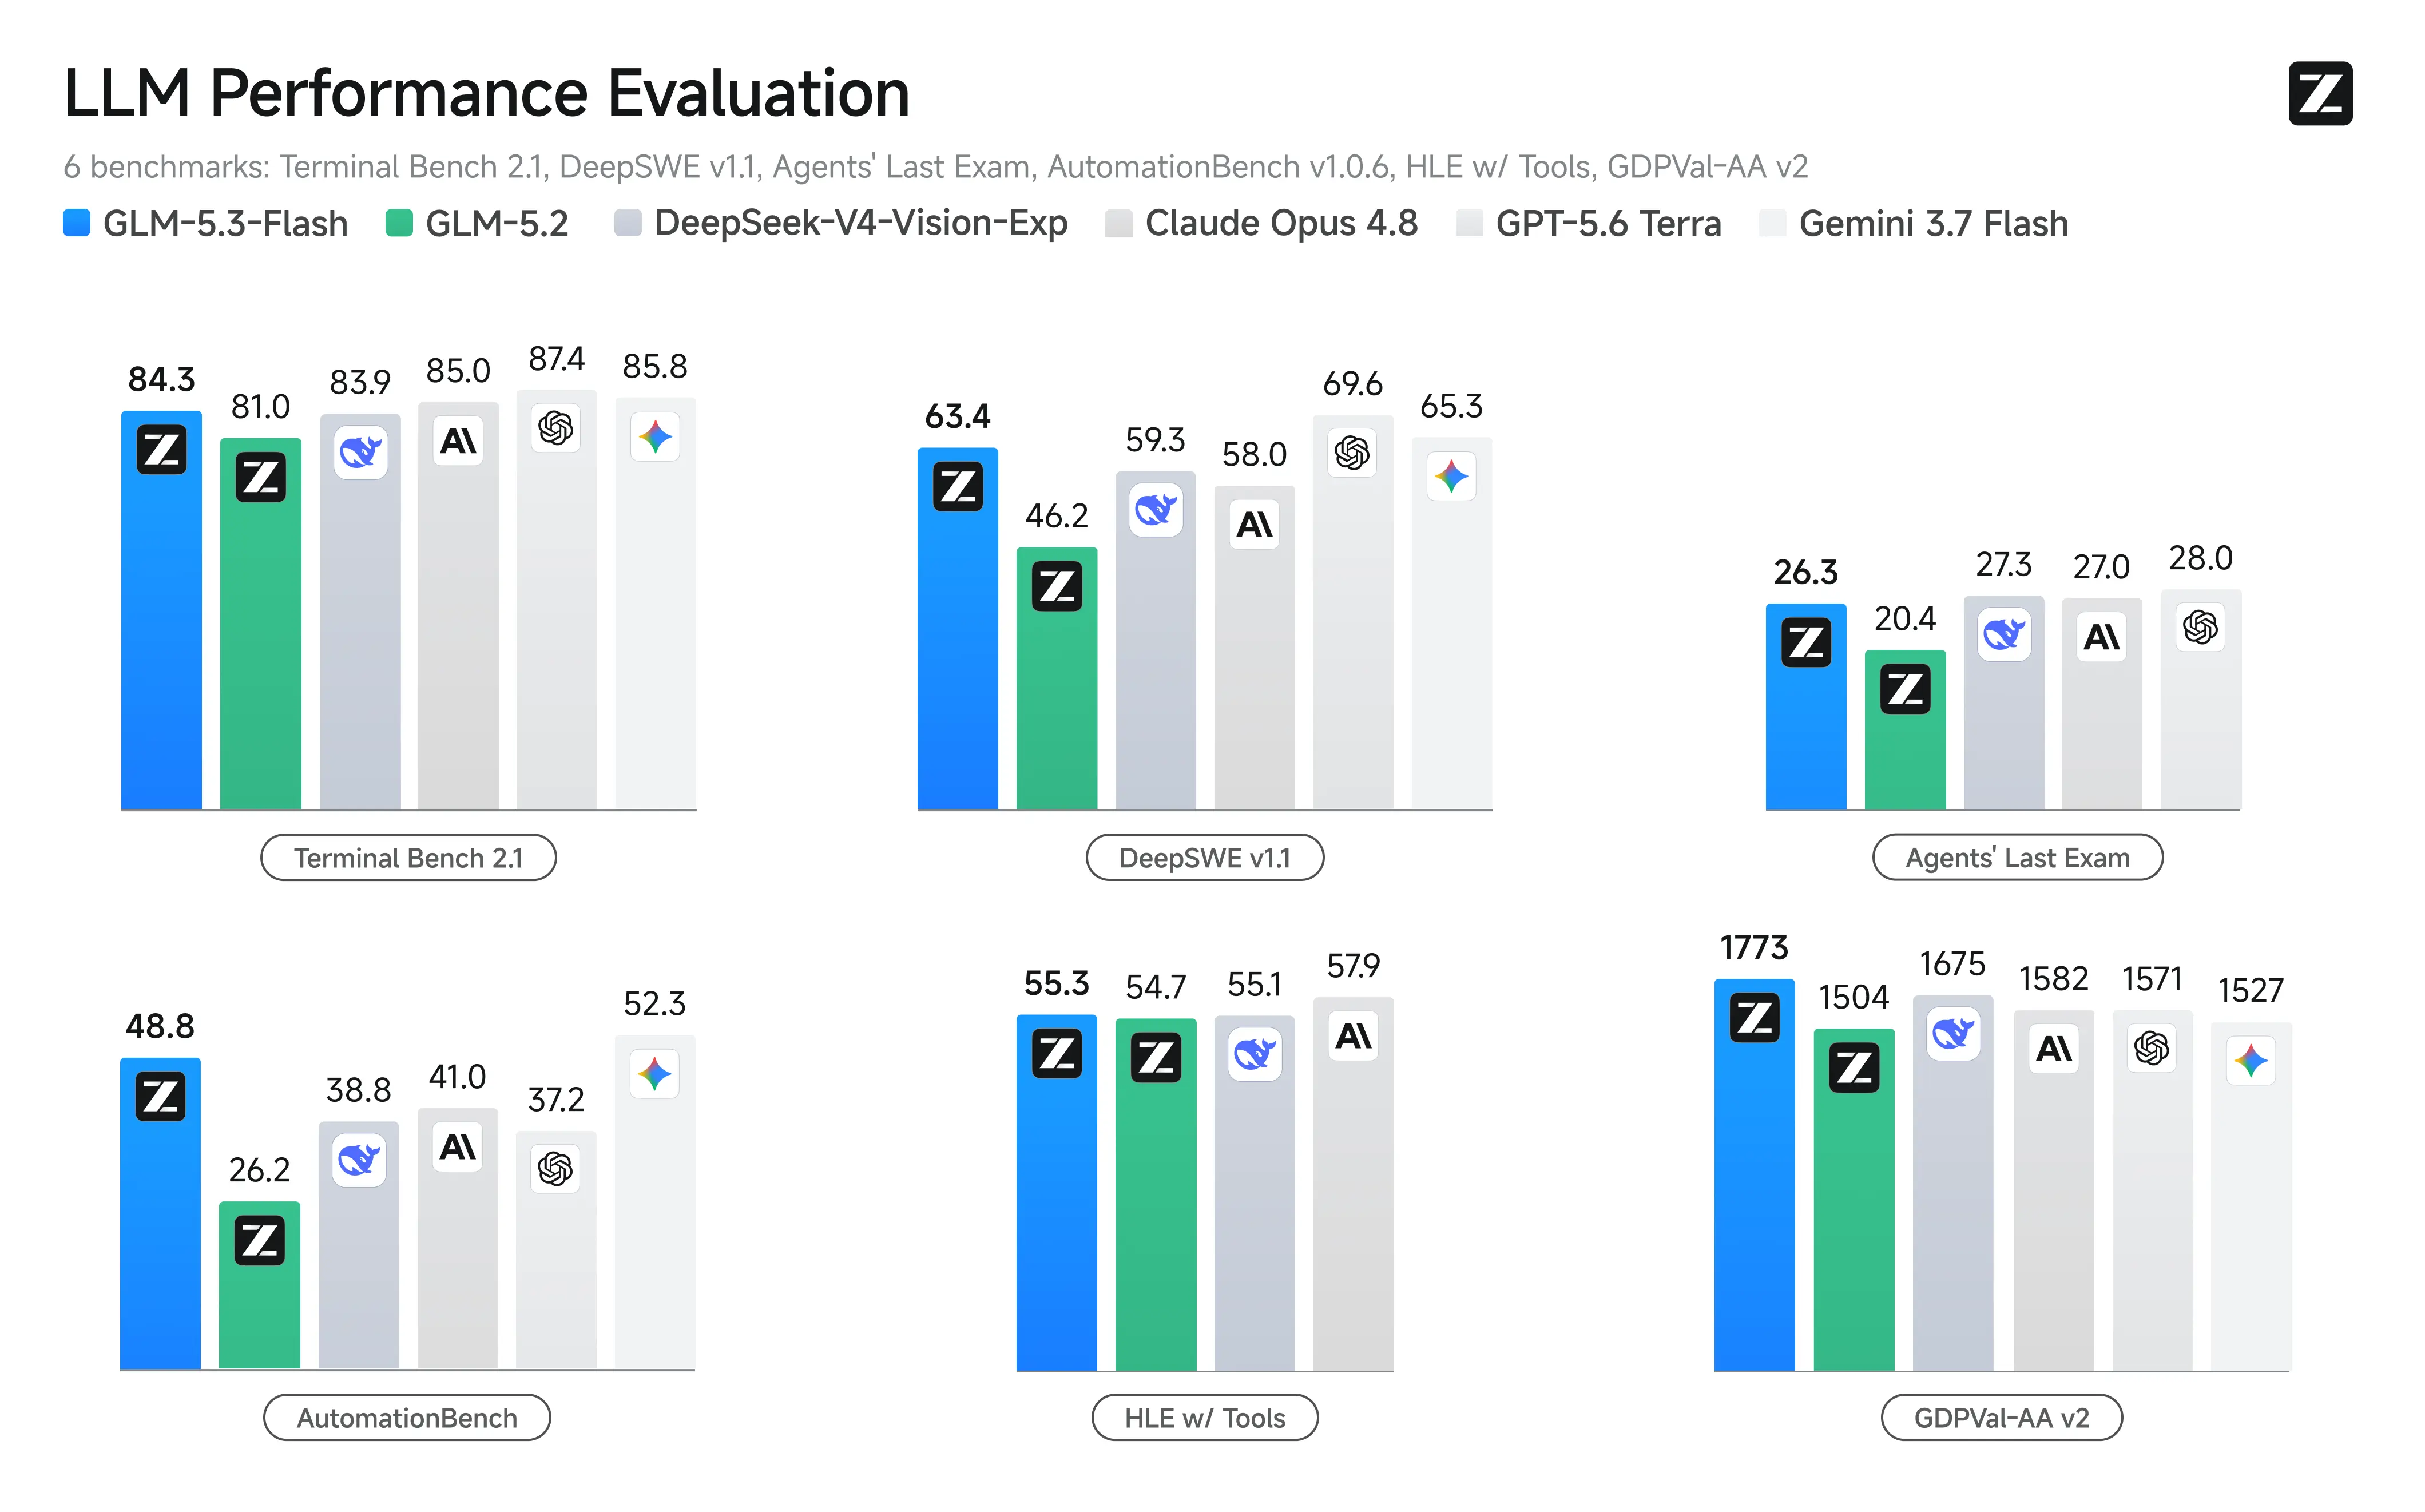
Nguồn: Hình benchmark chính thức của Z.ai
Hình benchmark chính thức so sánh hiệu năng GLM-5.3 Flash theo model và mức nỗ lực. Với hướng dẫn API này, nó cung cấp ngữ cảnh gọn về hiệu năng thay vì lặp lại toàn bộ ma trận. Ứng dụng vẫn nên đo lường tỷ lệ thành công tác vụ, độ trễ end-to-end, và tổng token trên chính prompt của mình.
Vì sao dùng GLM-5.3 Flash qua CometAPI?
CometAPI phơi bày GLM-5.3 Flash qua giao diện tương thích OpenAI. Điều đó cho phép đội ngũ tái sử dụng pattern SDK quen thuộc, tập trung hóa thông tin xác thực và thanh toán, và chuyển model mà không phải xây lại toàn bộ lớp yêu cầu.
• Một pattern tích hợp. Cùng một base client có thể gọi các model được hỗ trợ khác nhau chỉ bằng cách đổi model ID.
• Tầm nhìn tập trung về sử dụng. Nhóm có thể xem usage và chi phí mà không cần bảng điều khiển riêng cho từng nhà cung cấp.
• Đánh giá nhanh hơn. Một harness yêu cầu duy nhất có thể so sánh chất lượng phản hồi, độ trễ và lỗi giữa các model ứng viên.
• Thiết kế fallback đơn giản hơn. Ứng dụng có thể giữ logic retry và định tuyến trong một tầng gateway.
• Giá route niêm yết thấp hơn. Trang model hiện tại ghi $0.06 mỗi triệu input tokens và $0.20 mỗi triệu output tokens; hãy xác nhận trang trực tiếp trước khi lập ngân sách.
Trước khi bắt đầu
Bạn cần tài khoản CometAPI, một API key, và một trong các môi trường cục bộ sau:
• Python 3.9 trở lên với pip
• Node.js 18 trở lên với npm
• cURL cho thử nghiệm tối thiểu trên dòng lệnh
Không bao giờ đặt CometAPI key sản xuất trong JavaScript trình duyệt, ứng dụng di động, kho công khai, ảnh chụp màn hình, hoặc log phía client. Gọi CometAPI từ server tin cậy và giữ key trong biến môi trường hoặc secret manager.
Cách sử dụng GLM-5.3 Flash API với CometAPI
Bước 1: Tạo CometAPI API Key
Đăng nhập CometAPI, mở bảng điều khiển API key, tạo key, và sao chép một lần vào quy trình quản lý bí mật của bạn. Dùng key riêng cho phát triển và sản xuất để có thể xoay vòng hoặc thu hồi một môi trường mà không gián đoạn môi trường kia.
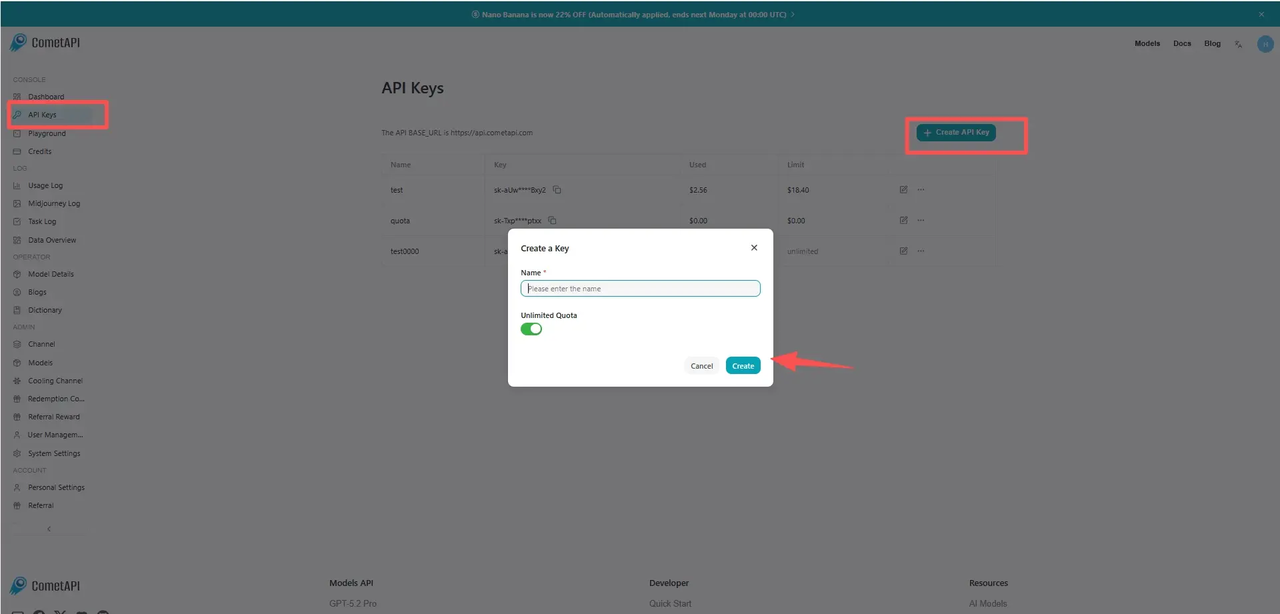
Nguồn: Hình hướng dẫn API key chính thức của CometAPI
Bước 2: Lưu key vào biến môi trường
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
Với sản xuất, thay lịch sử shell bằng secret triển khai, secret container, hoặc kho quản lý bí mật.

### Bước 3: Cài đặt SDK tương thích OpenAI
python -m pip install --upgrade openai
npm install openai
```

### Bước 4: Gửi yêu cầu đầu tiên với cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "Bạn là một trợ lý kỹ thuật chính xác."
      },
      {
        "role": "user",
        "content": "Giải thích ba cách sử dụng thực tế của cửa sổ ngữ cảnh một triệu token."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Phản hồi thành công chứa một tin nhắn assistant dưới choices[0].message.content cùng metadata usage khi route trả về. Bắt đầu với yêu cầu nhỏ này trước khi thêm tham số tùy chọn.

### Bước 5: Gọi API từ Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Bạn là một trợ lý kỹ thuật chính xác.",
        },
        {
            "role": "user",
            "content": "Xem xét kế hoạch di chuyển này và liệt kê năm rủi ro hàng đầu.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Bước 6: Gọi API từ JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "Bạn là một trợ lý kỹ thuật chính xác." },
    { role: "user", content: "Soạn danh sách kiểm tra triển khai an toàn cho API này." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Cách kiểm soát nỗ lực suy luận (reasoning effort)

Tài liệu model chính thức hỗ trợ mức nỗ lực suy luận [low, high, và max](https://docs.z.ai/guides/vlm/glm-5.3-flash). [Thinking luôn bật](https://docs.z.ai/guides/vlm/glm-5.3-flash); cài đặt effort thay đổi ngân sách suy luận mà model có thể dùng.

| Effort | Workload khởi đầu phù hợp                   | Đánh đổi                                           |
| ------ | ------------------------------------------- | -------------------------------------------------- |
| low    | Phân loại, viết lại, trích xuất ngắn        | Độ trễ và token đầu ra thấp; độ sâu hạn chế.       |
| high   | Code review, lập kế hoạch, phân tích tài liệu | Mặc định cân bằng cho nhiều tác vụ sản xuất.       |
| max    | Debug phức tạp, tác tử dùng tool, suy luận khó | Độ sâu cao nhất; có thể tăng độ trễ và chi phí. |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Tìm các chế độ lỗi ẩn trong kế hoạch rollout phân tán này.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

Nếu SDK cài đặt cung cấp reasoning_effort như tham số bậc nhất, bạn có thể truyền trực tiếp. Nếu route CometAPI từ chối trường đặc thù nhà cung cấp, hãy bỏ nó và dùng mặc định của route. Không cố gắng tắt thinking.

## Cách stream phản hồi

Streaming hữu ích cho chat, trợ lý coding, và phân tích dài vì cho phép giao diện hiển thị đầu ra ngay khi đến. Nó không giảm tổng số token sinh ra, nên vẫn giữ ngưỡng đầu ra và kiểm soát chi phí như cũ.

### Streaming với Python

Python

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Tạo kế hoạch di chuyển cơ sở dữ liệu theo giai đoạn."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### Streaming với JavaScript

JavaScript

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Tạo kế hoạch di chuyển cơ sở dữ liệu theo giai đoạn." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Xử lý hủy. Dừng đọc stream khi client ngắt kết nối và hủy công việc upstream khi được hỗ trợ.

• Buffer an toàn. Đừng giả định mỗi chunk chứa đầy đủ một từ, một token JSON, hay một đối tượng tool-call.

• Ghi nhận usage cuối. Usage có thể chỉ xuất hiện trong sự kiện cuối hoặc metadata đặc thù route.

## Cách gửi hình ảnh

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) nhận nội dung thị giác qua các khối image_url trong messages[].content[]. Tài liệu chính thức khuyến nghị URL ảnh truy cập được hoặc Base64 Data URL. Trang model của CometAPI xác nhận khả năng image-to-text, nhưng ứng dụng vẫn nên kiểm thử định dạng, kích thước file và hành vi route trước sản xuất.

### Phân tích một URL ảnh

Python

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Xem xét bảng điều khiển này. Chỉ ra vấn đề khả dụng, "
                        "các chỉ số mơ hồ và rủi ro chất lượng dữ liệu có thể có."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Gửi ảnh cục bộ dưới dạng Base64

Python

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Trích xuất tiêu đề biểu đồ, các trục và xu hướng chính.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Cắt bỏ vùng trắng không liên quan trước khi mã hóa ảnh.

• Giảm kích thước ảnh quá lớn so với thông tin cần xem xét.

• Đặt câu hỏi thị giác cụ thể thay vì yêu cầu mô tả chung chung.

• Đừng giả định URL trang web công cộng là URL ảnh trực tiếp.

• Kiểm thử thứ tự nhiều ảnh vì mỗi ảnh cần được tham chiếu rõ ràng trong prompt.

## Cách yêu cầu JSON có cấu trúc

Đầu ra có cấu trúc hữu ích khi thành phần tiếp theo là code thay vì người đọc. Hãy dùng schema hẹp, xác thực kết quả và giữ phương án dự phòng cho các route không hỗ trợ JSON Schema nghiêm ngặt ở dạng y hệt.

Python

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Chỉ trả về JSON hợp lệ.",
        },
        {
            "role": "user",
            "content": (
                "Trích xuất thiết bị, mức độ nghiêm trọng, triệu chứng quan sát được, "
                "và hành động tiếp theo từ báo cáo này: Feeder 12 xuất hiện các spike "
                "dòng không thứ tự lặp lại sau mưa; kiểm tra cách điện và so sánh các đoạn liền kề."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

Chế độ JSON không loại bỏ nhu cầu xác thực. Hãy kiểm tra trường bắt buộc, kiểu dữ liệu, giá trị cho phép và độ dài tối đa trước khi lưu kết quả hoặc kích hoạt hệ thống khác.

## Cách sử dụng Function Calling

Function calling cho phép model quyết định khi nào cần dữ liệu bên ngoài, trong khi code ứng dụng vẫn chịu trách nhiệm ủy quyền và thực thi. Mẫu an toàn là: model đề xuất gọi tool, server xác thực, server thực thi tool và model nhận kết quả.

Python

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Chỉ trả về JSON hợp lệ.",
        },
        {
            "role": "user",
            "content": (
                "Trích xuất thiết bị, mức độ nghiêm trọng, triệu chứng quan sát được, "
                "và hành động tiếp theo từ báo cáo này: Feeder 12 xuất hiện các spike "
                "dòng không thứ tự lặp lại sau mưa; kiểm tra cách điện và so sánh các đoạn liền kề."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Xác thực tham số. Xem JSON của lời gọi tool như input không tin cậy.

• Thực thi phân quyền. Model không quyết định được người dùng hiện tại được phép làm gì.

• Tách tool đọc và ghi. Yêu cầu xác nhận cho hành động phá hủy hoặc hiển thị ra bên ngoài.

• Giới hạn kho tool. Chỉ phơi bày tool liên quan tới workflow hiện tại.

• Giới hạn vòng lặp. Đặt số vòng tool tối đa, tổng token, thời gian trôi qua và chi phí.

## Tham số API của [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)

| Tham số                | Mục đích                         | Hướng dẫn thực tiễn                                    |
| ---------------------- | -------------------------------- | ------------------------------------------------------ |
| model                  | Chọn route model                 | Dùng glm-5.3-flash.                                    |
| messages               | Hội thoại và input đa phương thức | Giữ đúng thứ tự role; bảo toàn các tin nhắn tool cần thiết. |
| max_completion_tokens  | Giới hạn đầu ra sinh             | Đặt theo workflow thay vì dựa vào tối đa của model.    |
| temperature            | Hành vi sampling                 | Khuyến nghị chính thức là 1.                           |
| top_p                  | Nucleus sampling                 | Khuyến nghị chính thức là 0.95.                        |
| reasoning_effort       | Ngân sách suy luận               | Dùng low, high, hoặc max; cần kiểm thử hỗ trợ route.   |
| stream                 | Đầu ra theo luồng                | Dùng true cho phản hồi tương tác.                      |
| tools                  | Định nghĩa function              | Giữ schema hẹp và xác thực mọi lời gọi.                |
| tool_choice            | Kiểm soát chọn tool              | Bắt đầu với auto trừ khi workflow yêu cầu tool.        |
| response_format        | Yêu cầu đầu ra máy-đọc-được      | Xác nhận hỗ trợ và JSON trả về.                        |

## Z.ai Direct API so với CometAPI

Cả hai route đều có thể phù hợp. Quyết định chủ yếu xoay quanh quyền sở hữu tích hợp, độ rộng model, thanh toán và tốc độ tiếp cận tính năng bản địa nhà cung cấp.

| Khía cạnh        | Z.ai Direct API                             | CometAPI                                           | Hệ quả thực tiễn                                                |
| ---------------- | ------------------------------------------- | -------------------------------------------------- | --------------------------------------------------------------- |
| Tài khoản và key | Tài khoản và key của Z.ai                   | Tài khoản và key của CometAPI                      | Key không thể dùng thay thế cho nhau.                          |
| Mẫu SDK          | Tương thích OpenAI                          | Tương thích OpenAI                                 | Phần lớn code client có thể tái sử dụng.                       |
| Phủ model        | Họ model của Z.ai                           | Nhiều nhà cung cấp và họ model                     | CometAPI hữu ích cho định tuyến và so sánh.                    |
| Tính năng bản địa| Tiếp cận sớm hành vi đặc thù nhà cung cấp   | Phụ thuộc mức phơi bày và pass-through của gateway | Kiểm thử trường nâng cao trên route đã chọn.                   |
| Thanh toán       | Theo nhà cung cấp                           | Tập trung cho các model được hỗ trợ                | Hóa đơn thống nhất giúp đơn giản hóa vận hành đa model.        |
| Thiết kế fallback| Cần tích hợp nhà cung cấp khác              | Có thể ở trong một tầng gateway                    | CometAPI có thể giảm ma sát khi chuyển đổi.                    |
| Phù hợp nhất     | Cam kết sâu với khả năng bản địa của Z.ai   | Truy cập thống nhất, đánh giá và định tuyến sản xuất | Chọn theo kiến trúc hệ thống, không có “kẻ thắng chung”.     |

Dùng API trực tiếp khi tham số bản địa mới nhất hoặc tính năng sản phẩm của nhà cung cấp là bắt buộc. Dùng CometAPI khi một client, hóa đơn thống nhất và khả năng so sánh hoặc thay thế model quan trọng hơn. Với sản xuất, chạy cùng bộ thử nghiệm đại diện trên đúng route bạn dự định triển khai.

## Ước tính chi phí và lập ngân sách token

Trang model CometAPI hiện tại liệt kê [$0.06 mỗi triệu input tokens](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) và [$0.20 mỗi triệu output tokens](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/). Ở mức giá đó, chi phí yêu cầu ước tính là:

chi phí = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Workload                 | Input tokens | Output tokens | Chi phí ước tính |
| ------------------------ | ------------ | ------------- | ---------------- |
| Câu hỏi ngắn            | 2,000        | 400           | $0.00020         |
| Code review              | 50,000       | 4,000         | $0.00380         |
| Phân tích tài liệu lớn  | 250,000      | 10,000        | $0.01700         |
| Chạy tác tử dài         | 800,000      | 30,000        | $0.05400         |

Giá có thể thay đổi theo thời gian. Hãy xác nhận mức giá input, cached-input và output trực tiếp trước khi xuất bản hoặc lập ngân sách sản xuất. Reasoning và vòng lặp tool có thể tăng output tính phí và input lặp lại, nên ước tính toàn bộ workflow thay vì một câu trả lời nhìn thấy đơn lẻ.

## Thực tiễn tốt cho GLM-5.3 Flash API trong sản xuất

### Kiểm soát chi phí và độ trễ

#### Giới hạn đầu ra

Thiết lập sinh mẫu trong benchmark và giới hạn API sản xuất là khác nhau. Đánh giá HLE trích dẫn độ dài sinh tối đa 163,840 token, trong khi một số đánh giá dùng output 64K; không thiết lập nào chứng minh rằng mọi route API được host có thể trả về hơn 100,000 token. Đặt ngưỡng theo schema route trực tiếp và ngân sách workflow. Dùng ngưỡng nhỏ cho phân loại và trích xuất, trung bình cho phân tích, và lớn hơn chỉ cho các tác vụ văn bản dài hoặc tác tử rõ ràng.

Bộ nhớ ngữ cảnh

Cửa sổ một triệu token là dung lượng, không phải mục tiêu. Truy xuất tệp liên quan, loại bỏ log trùng lặp, đặt hướng dẫn ổn định gần phần đầu, và đo lường việc thêm ngữ cảnh có cải thiện thành công tác vụ hay không.

### Trạng thái và độ tin cậy

#### Bảo toàn trạng thái

Lưu trữ đầy đủ tin nhắn assistant cần cho lượt tiếp theo, bao gồm lời gọi tool và các trường đặc thù route mà ứng dụng của bạn đã xác minh. Bỏ lịch sử có cấu trúc có thể phá vỡ vòng lặp tool nhiều bước ngay cả khi văn bản hiển thị có vẻ đầy đủ.

#### Retry có chọn lọc

• Retry lỗi tạm thời 429, 500, 502, 503 và timeout mạng với backoff lũy thừa và jitter.

• Không retry mù quáng với lỗi xác thực, tham số không hợp lệ, hoặc yêu cầu quá kích thước.

• Gắn ID yêu cầu ứng dụng để có thể nhận diện công việc trùng lặp.

• Dùng kiểm soát idempotency quanh tác vụ ghi ra bên ngoài, ngay cả khi bản thân yêu cầu model được retry.

### An toàn và xác thực

#### Xác thực đầu ra máy-đọc-được

Xác thực schema, kiểm tra giá trị cho phép, giới hạn độ dài và luật miền cần đặt giữa model và mọi cơ sở dữ liệu, hàng đợi hoặc API bên ngoài. Một đối tượng JSON hợp lệ về cú pháp vẫn có thể không đầy đủ hoặc không an toàn.

#### Ủy quyền lời gọi tool

Xem lời gọi tool do model đề xuất như yêu cầu không tin cậy: xác thực tham số, thực thi phân quyền người dùng, tách thao tác đọc và ghi, và yêu cầu xác nhận cho hành động phá hủy.

### Quan sát và fallback

#### Đo lường workflow

• Tỷ lệ thành công tác vụ hoặc tỷ lệ chấp nhận của con người

• Thời gian đến token đầu tiên và tổng độ trễ

• Token input, cached input, reasoning, và output

• Số lần gọi tool và tỷ lệ lỗi tool

• Số lần retry, giới hạn tốc độ và lỗi nhà cung cấp

• Chi phí mỗi tác vụ hoàn tất thay vì chi phí mỗi cuộc gọi API riêng lẻ

#### Thiết kế fallback

Chọn fallback theo workload, không theo danh tiếng. Fallback chỉ-text có thể chấp nhận được cho trích xuất tài liệu nhưng thất bại với tác vụ dựa trên ảnh chụp màn hình. Xác định input và schema tool nào có thể mang theo, tham số nào phải loại bỏ, và khi nào người dùng nên thấy lỗi có thể khôi phục thay vì chuyển model tự động.

## Lỗi thường gặp và cách khắc phục

| Triệu chứng              | Nguyên nhân khả dĩ                                                | Cần kiểm tra                                                                  |
| ------------------------ | ----------------------------------------------------------------- | ----------------------------------------------------------------------------- |
| 401 Unauthorized         | Key thiếu, sai định dạng, hoặc đã bị thu hồi                      | Xác nhận header Authorization và biến môi trường phía server.                 |
| 404 hoặc model not found | Sai model ID hoặc route không khả dụng                            | Dùng glm-5.3-flash và xác nhận khả dụng trên trang model trực tiếp.           |
| 429 Rate Limit           | Vượt quota yêu cầu hoặc token                                     | Giãn tần suất, giảm đồng thời, kiểm tra giới hạn tài khoản và retry có jitter. |
| Unsupported parameter    | Trường bản địa nhà cung cấp không được gateway phơi bày           | Bỏ các trường tùy chọn, rồi thêm lại từng cái một.                            |
| Context length exceeded  | Prompt cộng output yêu cầu vượt giới hạn route                    | Cắt, truy xuất, tóm tắt, hoặc hạ max_completion_tokens.                       |
| Invalid image            | URL không truy cập được, định dạng không hỗ trợ, hoặc Base64 lỗi  | Thử URL ảnh HTTPS trực tiếp và sửa tiền tố MIME.                              |
| Broken streamed JSON     | Các chunk bị parse như đối tượng hoàn chỉnh                       | Buffer stream và chỉ parse sau khi nhận đủ payload JSON hoàn chỉnh.           |
| Tool loop never ends     | Không có ngân sách bước hoặc kết quả tool mơ hồ                   | Giới hạn số vòng, cải thiện mô tả tool và trả về lỗi tool rõ ràng.            |

## Khi nào nên dùng GLM-5.3 Flash API?

### Phù hợp

• Hiểu mã ở quy mô repository và review nhiều tệp

• Lập trình trực quan, phân tích ảnh chụp màn hình và QA giao diện

• Bộ tài liệu dài và tổng hợp có dẫn chứng

• Tác tử dùng tool với lập kế hoạch và kiểm chứng lặp lại

• Workflow khối lượng lớn nơi chi phí token ảnh hưởng đáng kể đến đơn giá

• Ứng dụng hưởng lợi từ việc chuyển đổi hoặc so sánh model qua một gateway

### Dùng route hoặc model khác khi

• Sản phẩm cần đầu ra hình ảnh hoặc video thay vì văn bản.

• Tác vụ là phân loại nhỏ, rủi ro thấp mà model nhỏ hơn xử lý ổn định.

• Tính năng bản địa của nhà cung cấp là bắt buộc nhưng gateway chưa phơi bày.

• Workflow không thể chịu được thinking luôn bật hoặc hồ sơ độ trễ đi kèm.

• Ứng dụng chưa kiểm thử model với tool, dữ liệu và tình huống lỗi riêng của mình.

## FAQ

###

### Cần xác minh gì trên đúng route CometAPI trước khi ra mắt?

Xác minh khả dụng model, định dạng đa phương thức được chấp nhận, đầu ra tối đa, các trường reasoning, hành vi structured-output, giới hạn tốc độ, và giá hiện tại bằng các yêu cầu đại diện.

### Nên theo dõi những chỉ số nào trong đánh giá sản xuất?

Theo dõi thành công tác vụ, thời gian đến token đầu tiên, tổng độ trễ, token input và output, lỗi lời gọi tool, tỷ lệ retry, và chi phí mỗi workflow hoàn tất, không chỉ chi phí mỗi cuộc gọi API.

### Nên chọn giữa Z.ai direct và CometAPI như thế nào?

Dùng Z.ai direct khi cần truy cập ngay hành vi bản địa của nhà cung cấp. Dùng CometAPI khi xác thực thống nhất, thanh toán, so sánh model và fallback ở tầng gateway quan trọng hơn.

### Điều gì tạo nên fallback an toàn?

Fallback an toàn chấp nhận cùng modality input, bảo toàn schema tool bắt buộc, loại bỏ tham số không được hỗ trợ, giữ trong ranh giới phân quyền của tác vụ, và thất bại hiển thị khi hành vi không thể bảo toàn.

## Kết luận

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) hữu ích nhất qua API khi ngữ cảnh dài, input thị giác, suy luận và sử dụng tool cùng nằm trong một workflow. Tích hợp CometAPI cơ bản rất gọn: một key phía server, một client tương thích OpenAI, model ID [glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) và endpoint chat-completions. Chất lượng sản xuất đến từ mọi thứ xung quanh yêu cầu đó: prompt có phạm vi, giới hạn đầu ra, xác thực schema, ủy quyền tool, retry, quan sát, và đánh giá theo workload.

Bắt đầu với một cuộc gọi văn bản ngắn, thêm một khả năng nâng cao mỗi lần, và kiểm thử hành trình người dùng hoàn chỉnh trước khi mở rộng. Xác nhận trang model [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) trực tiếp về khả dụng hiện tại, hành vi route được hỗ trợ và giá.

## SEO Metadata

Meta title: Hướng dẫn sử dụng GLM-5.3 Flash API: Dành cho nhà phát triển

Meta description: Tìm hiểu cách sử dụng GLM-5.3 Flash API với CometAPI, gồm ví dụ Python và JavaScript, vision, streaming, tools, JSON output và thực tiễn tốt nhất.

Keywords: GLM-5.3 Flash API, cách sử dụng GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, hướng dẫn GLM API, multimodal API, reasoning API, function calling

URL slug: how-to-use-glm-5-3-flash-api