Xây dựng với CometAPICần một API cho nhiều mô hình?Kiểm thử quy trình trong Playground, sau đó tạo API key khi mô hình và chi phí phù hợp với trường hợp sử dụng của bạn.
Prompt Caching là gì? OpenAI vs Claude vs Gemini vào năm 2026
Tìm hiểu cách bộ nhớ đệm prompt hoạt động vào năm 2026. So sánh phương thức lưu đệm của OpenAI, Claude và Gemini, các TTL, giá, hiệu năng, ví dụ Python, quyền truy cập CometAPI.
Bộ nhớ đệm prompt cho phép các mô hình ngôn ngữ tái sử dụng các tiền tố prompt đã được xử lý trước thay vì lặp lại cùng phép tính đầu vào. Nó có thể giảm chi phí token đầu vào và cải thiện độ trễ, đặc biệt cho quy trình agent, hỗ trợ khách hàng, RAG và phân tích tài liệu lớn. Năm 2026, OpenAI cung cấp bộ nhớ đệm tự động và các điều khiển bộ nhớ đệm tường minh mới hơn, Claude hỗ trợ bộ nhớ đệm tự động và điểm ngắt ở cấp khối, còn Gemini nhấn mạnh bộ nhớ đệm ngầm cho các model mới nhất. Các nhà cung cấp tính phí khác nhau cho ghi vào cache, đọc từ cache và, khi áp dụng, lưu trữ. Hết hạn có thể kích hoạt một lần ghi khác hoặc tính phí đầu vào đầy đủ, nên mức tiết kiệm thực tế phụ thuộc vào tần suất tái sử dụng và số lần trúng cache đo được.
Hướng dẫn này so sánh bộ nhớ đệm prompt trong GPT-6.1 Sol, Claude Opus 5.5 và Gemini 4 Argon dành cho nhà phát triển xây dựng ứng dụng có đầu vào lặp lại. Trọng tâm là điều khiển cache, giá và cách xác minh tái sử dụng.
Các điểm chính
Bộ nhớ đệm prompt tái sử dụng đầu vào đã được xử lý — không phải câu trả lời trước đó của model.
Bộ nhớ đệm prompt của OpenAI phụ thuộc vào một tiền tố ổn định, các tính năng được model hỗ trợ, cùng ngưỡng tối thiểu và cài đặt lưu giữ theo từng model.
Đã được xem xét về độ rõ ràng, ghi nguồn và thuật ngữ API hiện tại.
Bộ nhớ đệm của Claude cung cấp TTL 5 phút và tùy chọn 1 giờ với điều khiển cache tự động và tường minh.
Bộ nhớ ngữ cảnh của Gemini là ngầm trên các model hiện đại; tài nguyên cache tường minh còn phụ thuộc model.
Tiết kiệm từ bộ nhớ đệm phụ thuộc vào ghi, đọc, lưu trữ và số lần trúng thực tế; hãy xác minh hỗ trợ endpoint và cách tính toán token đã được cache khi dùng CometAPI.
Bộ nhớ đệm prompt trong LLM là gì?
Bộ nhớ đệm prompt là một tối ưu suy luận cho phép tái sử dụng trạng thái tính toán được suy ra từ một tiền tố đã xử lý trước đó. Một prompt thường chứa hướng dẫn ổn định, định nghĩa công cụ hoặc tài liệu, theo sau là câu hỏi người dùng thay đổi. Nếu một yêu cầu sau đó lặp lại tiền tố đủ điều kiện, nhà cung cấp có thể tái sử dụng trạng thái khóa-giá trị (KV) đã lưu và chỉ xử lý phần chưa được cache. Khác với bộ nhớ đệm phản hồi, điều này không phát lại câu trả lời trước: model sẽ tạo phản hồi mới cho yêu cầu hiện tại.
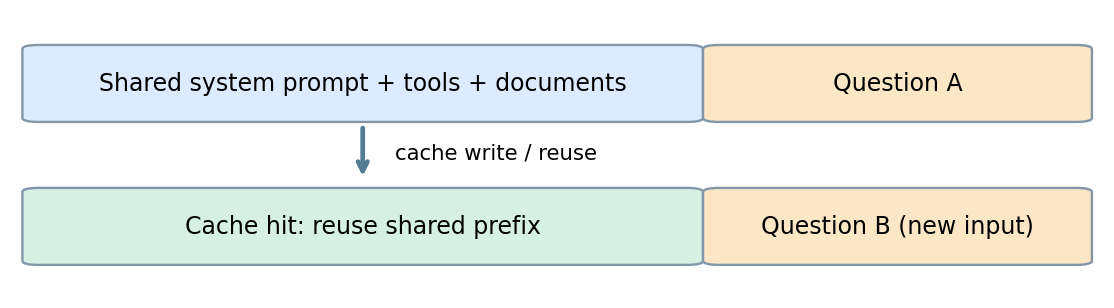
Quy trình bộ nhớ đệm prompt:
Yêu cầu đầu tiên: gửi một tiền tố lớn, có thể lặp lại cùng một câu hỏi cụ thể.
Tạo cache: nhà cung cấp lưu trạng thái tính toán trung gian đủ điều kiện.
Yêu cầu tiếp theo: tái sử dụng tiền tố giống hệt và thay câu hỏi.
Đọc cache: các token đã xử lý trước được tái sử dụng trong khi các token mới được xử lý bình thường.
Minh họa khái niệm đi kèm bản thảo gốc: phần prompt lặp lại đứng trước câu hỏi thay đổi. Đây không phải sơ đồ kiến trúc chính thức của nhà cung cấp.
Nguyên tắc thiết kế chung là tiền tố ổn định. Hợp đồng API, các họ model đủ điều kiện, thời gian sống của cache và phí không thể dùng lẫn cho nhau.
OpenAI, Claude và Gemini: Tổng quan bộ nhớ đệm
Cùng một nguyên tắc tiền tố ổn định được áp dụng trên các nhà cung cấp, nhưng các điều khiển bên dưới là cụ thể cho các model dùng trong hướng dẫn này. Hãy kiểm tra model và endpoint cùng nhau trước khi sao chép một cài đặt.
Tham số
OpenAI: GPT-6.1 Sol
Claude: Opus 5.5
Google: Gemini 4 Argon
Kích hoạt cache
Khớp ngầm; hỗ trợ điểm ngắt tường minh
Đăng ký bằng cache_control ở cấp yêu cầu hoặc cấp khối nội dung
Bộ nhớ đệm ngầm bật mặc định
Tiền tố tối thiểu
1,024 token đầu vào hiển thị
512 token trước ranh giới cache
4,096 token đầu vào
Điều khiển thời gian sống
Responses API: prompt_cache_options.ttl; mặc định 30m hoặc 12h
Mặc định 5 phút; tùy chọn TTL 1 giờ
Thời gian sống ngầm do nhà cung cấp quản lý
Vị trí đặt nội dung ổn định
Hướng dẫn, công cụ và tài liệu tham chiếu ở đầu
Định nghĩa công cụ ổn định, nội dung system, hoặc khối tin nhắn trước điểm ngắt
Nội dung dùng chung lớn ở đầu prompt
Trường usage cần kiểm tra
input_tokens_details.cached_tokens và báo cáo cache-write usage
cache_creation_input_tokens và cache_read_input_tokens
cached_content_token_count trong usage_metadata, khi có
Khác biệt quan trọng
prompt_cache_key có thể tách kế toán; không bắt buộc cho định tuyến tự động của Sol
Điểm ngắt phải kết thúc ở nội dung không đổi
Không có tài nguyên cache tường minh cho Argon; các model cũ hơn hỗ trợ giao diện riêng
Điều khiển bộ nhớ đệm prompt và ví dụ Python
Mỗi ví dụ gửi cùng tài liệu tham chiếu với hai câu hỏi khác nhau. Giữ nguyên phần nội dung dùng chung, chạy các yêu cầu nối tiếp và kiểm tra usage để xem yêu cầu thứ hai có thực sự tái sử dụng đầu vào đã được cache hay không.
OpenAI: Điều khiển cache và ví dụ Python
OpenAI tự động khớp các tiền tố prompt đủ điều kiện với cache và, trên các model mới hơn được hỗ trợ, cho phép cấu hình điểm ngắt và lưu giữ tường minh. Tái sử dụng cache đặc biệt hữu ích khi các hướng dẫn system dài, schema công cụ hoặc ngữ cảnh repository lặp lại qua các yêu cầu. Độ dài tiền tố bắt buộc và hệ số giá token phụ thuộc vào thế hệ model và bậc lưu giữ đã chọn.
Ví dụ sử dụng Responses API với prompt_cache_options ở chế độ ngầm và thời gian sống 30 phút. Các thế hệ model trước dùng tham số lưu giữ khác; làm theo cài đặt cho đúng model của bạn.
Cài đặt SDK openai và đặt OPENAI_API_KEY. Sử dụng ít nhất 1,024 token hiển thị trong tiền tố ổn định. Chạy cả hai yêu cầu nối tiếp và kiểm tra input_tokens_details.cached_tokens và cache_write_tokens trong usage. Số lượng token đã cache dương xác nhận một lần đọc cache được tính phí; điều đó không đảm bảo độ trễ thấp hơn ở mọi yêu cầu.
Để chạy các ví dụ, cài SDK Python tương ứng, đặt khóa API của nhà cung cấp và tạo tệp reference.txt mã hóa UTF-8 chứa đủ nội dung ổn định để đạt mức tối thiểu cho model đó.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Điều khiển cache và ví dụ Python
Trong Claude Messages API, bộ nhớ đệm là dạng đăng ký opt-in. Thêm cache_control ở cấp yêu cầu để đặt điểm ngắt tự động, hoặc gắn vào một khối nội dung để đánh dấu điểm ngắt tường minh. Nhà phát triển có thể đánh dấu các hướng dẫn ổn định, tài liệu và các khối prompt được chọn, trong khi thay đổi đầu vào của người dùng ở phía sau. Cache chuẩn có thời lượng ngắn 5 phút, với tùy chọn 1 giờ cho khối lượng công việc phù hợp.
Cài đặt SDK anthropic và đặt ANTHROPIC_API_KEY. Với Claude Opus 5.5, cung cấp ít nhất 512 token trước ranh giới cache. Giữ khối system giống hệt nhau giữa các yêu cầu. Mục nhập cache sẵn sàng khi phản hồi đầu tiên bắt đầu; ví dụ này đợi phản hồi hoàn chỉnh để đơn giản. Kiểm tra số lượng tạo cache và đọc cache; một tiền tố ngắn có thể trả về số 0 cho cả hai mà không báo lỗi.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Bộ nhớ đệm ngầm và ví dụ Python
Google gọi cách triển khai của mình là bộ nhớ đệm ngữ cảnh. Gemini 4 Argon dùng bộ nhớ đệm ngầm và không hỗ trợ tài nguyên cache tường minh. Một số họ model trước đó hỗ trợ cache tường minh với TTL cấu hình được. Hãy chọn giao diện bộ nhớ đệm dựa trên hợp đồng của từng model thay vì giả định tất cả model Gemini đều có cùng điều khiển.
Cài đặt google-genai và đặt GEMINI_API_KEY. Dùng ít nhất 4,096 token nội dung chung ở đầu cho Gemini 4 Argon, và gửi yêu cầu thứ hai ngay sau yêu cầu đầu. Kiểm tra cached_content_token_count trong usage_metadata khi có. Bộ nhớ đệm ngầm có thể bỏ lỡ ngay cả khi tiền tố đủ điều kiện.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
Bộ nhớ đệm prompt tốn bao nhiêu với OpenAI, Claude và Gemini?
Chi phí bộ nhớ đệm cần được đánh giá như sự kết hợp giữa ghi, đọc và — trên một số hệ thống cache tường minh — lưu giữ hoặc lưu trữ. Các hệ số minh họa dưới đây phản ánh các thiết kế phổ biến và không phải cam kết giá phổ quát trên mọi phiên bản model.
Hạng mục chi phí
OpenAI
Claude
Gemini
Đầu vào chưa cache
Mức giá token đầu vào thông thường
Mức giá token đầu vào thông thường
Mức giá token đầu vào thông thường
Ghi vào cache
Có thể có phụ phí trên model mới
Phụ phí 5m/1h
Ngầm hoặc tường minh, tùy model
Đọc từ cache
Mức giá giảm theo từng model
Mức giá giảm theo từng model
Mức giá giảm theo từng model
Thời gian sống
Theo từng model
5m / 1h
Quản lý ngầm / cấu hình tường minh
Lưu trữ bổ sung
Phụ thuộc model
Thường phản ánh trong bậc ghi
Có thể có phí lưu trữ tường minh
Ví dụ minh họa: một tiền tố 10,000 token được tái sử dụng qua N yêu cầu, lần ghi cache ban đầu tốn 1.25 lần chi phí đầu vào thông thường, và các lần đọc cache sau đó tốn 0.1 lần chi phí đầu vào thông thường. Giả sử giá đầu vào cơ sở là $2 mỗi triệu token và các lần trúng cache hoàn hảo sau yêu cầu đầu tiên.
Số yêu cầu
Không dùng cache
Dùng cache
Tiết kiệm trên tiền tố tái sử dụng
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
Công thức: Chi phí tiền tố đã cache = 1.25P + (N − 1) × 0.1P, với P là chi phí thông thường để xử lý phần tiền tố dùng chung một lần. Ví dụ này không tính đầu vào động, đầu ra, hết hạn, trượt cache, lưu trữ và các dịch vụ khác.
Ví dụ trên dùng mức đọc 10% mang tính minh họa, không phải mức hiện tại của GPT-6.1 Sol. Giá ngữ cảnh ngắn chuẩn của Sol là $2 mỗi triệu token đầu vào chưa cache, $0.10 mỗi triệu token đầu vào đã cache, và $2.50 mỗi triệu token ghi với thời gian sống mặc định. Hãy tính lại ví dụ theo model, bậc và hóa đơn endpoint thực tế của bạn.
Thời gian sống dài hơn chỉ đáng giá nếu nó tránh được đủ số lần ghi lặp lại hoặc yêu cầu chưa cache để bù giá của nó. Ghi 5 phút và 1 giờ của Claude được tính lần lượt ở mức 1.25× và 2× giá đầu vào cơ sở. Các cache tường minh của Gemini trên các model cũ được hỗ trợ cũng có thể phát sinh phí lưu trữ. Đo lường tái sử dụng qua các khoảng nghỉ thực, không chỉ một loạt cuộc gọi dồn dập.
Hãy coi trượt cache, hết hạn và sinh đầu ra là một phần của hóa đơn. Nếu một tiền tố hết hạn trước khi được tái sử dụng, yêu cầu tiếp theo có thể cần một lần ghi khác hoặc xử lý đầu vào đầy đủ. Prompt ngắn có thể không đủ điều kiện, trong khi câu trả lời dài có thể khiến token đầu ra là khoản chi lớn nhất ngay cả khi tái sử dụng cache mạnh. So sánh tổng chi phí mỗi tác vụ hoàn tất trước khi bổ sung thêm độ phức tạp về cache.
API bộ nhớ đệm nào phù hợp nhất cho các khối lượng công việc khác nhau?
Đối với agent lập trình và hỗ trợ khách hàng, hãy đặt định nghĩa công cụ ổn định, ngữ cảnh repository, chính sách và kiến thức trước tác vụ thay đổi. OpenAI và Claude cung cấp điều khiển điểm ngắt giúp định nghĩa ranh giới có thể tái sử dụng; đánh giá các lần đọc cache thực tế của endpoint thay vì giả định rằng văn bản lặp lại đã được cache.
Đối với phân tích tài liệu và công việc đa phương tiện, hãy giữ tài liệu nguồn hoặc media được hỗ trợ trước câu hỏi. Cách tiếp cận ngầm của Gemini giảm công việc quản lý cache, trong khi Claude cho phép bạn đánh dấu khối ổn định trực tiếp. Kiểm tra hỗ trợ cho loại media và model cụ thể trước khi dựa vào tái sử dụng.
Đối với hội thoại dài, hãy nối thêm lượt mới thay vì viết lại phần đầu lặp lại, và chọn thời gian sống phù hợp với khoảng thời gian giữa các lượt. Nếu ứng dụng của bạn cần một tài nguyên cache có tên có thể tạo và tham chiếu tường minh, hãy đánh giá một model Gemini hỗ trợ giao diện đó; Argon thì không.
Không có lựa chọn thắng tuyệt đối: so sánh tỷ lệ trúng cache, chi phí mỗi tác vụ hoàn tất và độ trễ dưới mẫu lưu lượng thực tế của bạn.
Bộ nhớ đệm prompt ảnh hưởng thế nào đến độ trễ và hiệu năng?
Một lần trúng cache giảm xử lý đầu vào lặp lại và có thể rút ngắn thời gian đến token đầu tiên. Nó không tự thân cải thiện chất lượng câu trả lời hoặc tăng tốc sinh đầu ra, và đầu vào đã cache vẫn chiếm dung lượng cửa sổ ngữ cảnh. Hãy đo cả độ trễ token đầu tiên và tổng thời gian phản hồi trên các yêu cầu tương đồng; một lần trúng cache không phải là bằng chứng người dùng nhận câu trả lời cuối cùng sớm hơn.
Cách tối ưu bộ nhớ đệm prompt và khắc phục trượt cache
Bắt đầu với một tiền tố ổn định và hữu ích
Đặt các hướng dẫn có thể tái sử dụng, định nghĩa công cụ, chính sách và tài liệu lên trước; đưa dấu thời gian, ID yêu cầu, ngữ cảnh thay đổi và câu hỏi người dùng ra sau. Giữ thứ tự công cụ và schema ổn định. Khi dùng cache tường minh, kết thúc điểm ngắt ở khối cuối cùng không đổi. Thêm tài liệu tham chiếu hữu ích khi nó giúp nhiệm vụ; đừng phình to mọi yêu cầu chỉ để theo đuổi chỉ số cache.
Nếu số token đã cache vẫn bằng 0
Kiểm tra điều kiện đủ trước khi thay đổi prompt: xác nhận đúng model, endpoint, độ dài token tối thiểu và cài đặt cache-control bắt buộc. Sau đó gửi hai yêu cầu nối tiếp với nội dung dùng chung giống hệt. Kiểm tra riêng việc tạo cache và đọc cache; yêu cầu đầu có thể tạo mục nhập mà yêu cầu sau có thể tái sử dụng. Bộ nhớ đệm ngầm đủ điều kiện để trúng, không được đảm bảo sẽ trúng.
Với Claude, một yêu cầu dưới ngưỡng có thể trả về 0 cho cả tạo cache và đọc cache mà không có lỗi. Mục nhập cache sẵn có khi phản hồi đầu tiên bắt đầu. Hướng dẫn cache của Claude cũng giải thích cách đặt điểm ngắt và thay đổi cài đặt yêu cầu ảnh hưởng đến tái sử dụng.
Nếu lượt trúng biến mất giữa các yêu cầu
So sánh payload thực tế, không chỉ mẫu prompt. Tìm văn bản tài liệu đã đổi, công cụ bị đảo thứ tự, schema thay đổi, các lượt hội thoại đầu bị viết lại, hoặc trường động được chèn trước ranh giới có thể tái sử dụng. Kiểm tra thời gian trôi qua từ yêu cầu trước và liệu thời gian sống đã chọn có bao phủ nó. Thay đổi một biến tại một thời điểm và ghi lại usage thu được.
Nếu lượt trúng không tạo ra tiết kiệm
Tách riêng đầu vào đã cache, ghi, đầu vào chưa cache, đầu ra và mọi phí lưu trữ. Việc ghi lặp lại sau các khoảng nghỉ, tái sử dụng thấp, hoặc câu trả lời dài có thể vượt qua mức chiết khấu đầu vào. Dùng phép tính chi phí ở trên với usage đo được và mức giá billing thực tế của endpoint. Chỉ giữ tối ưu nếu nó cải thiện tổng chi phí tác vụ hoặc độ trễ hiển thị với người dùng.
Kiểm tra hỗ trợ endpoint và ranh giới dữ liệu
Một endpoint tương thích có thể chấp nhận yêu cầu mà không cung cấp cùng điều khiển cache hoặc trường usage như API gốc. Xác nhận hỗ trợ tham số và so sánh usage trả về với hóa đơn tài khoản trước khi coi tái sử dụng là tiết kiệm. Giữ kiểm soát cách ly tenant và truy cập, và tuân thủ chính sách lưu giữ và xử lý dữ liệu của nhà cung cấp. Bộ nhớ đệm không thay thế các kiểm soát đó.
Bạn có thể dùng bộ nhớ đệm prompt với CometAPI như thế nào?
CometAPI cung cấp một điểm tích hợp duy nhất để thử nghiệm yêu cầu trên nhiều họ model. Với bộ nhớ đệm, hãy xác minh các điều khiển đặc thù nhà cung cấp mà endpoint đã chọn chấp nhận và cách đầu vào đã cache xuất hiện trong usage và billing. Nhà phát triển có thể tập trung hóa việc thử nghiệm model đồng thời duy trì xác thực riêng cho hành vi cache và kế toán, vì các tùy chọn gốc của nhà cung cấp không được đảm bảo giống hệt nhau trên proxy hoặc endpoint tương thích.
Cài đặt SDK openai và đặt COMETAPI_KEY. Ví dụ này gửi các yêu cầu có tiền tố lặp lại qua giao diện Chat Completions tương thích OpenAI của CometAPI. Xác nhận tính khả dụng của model, sau đó kiểm tra usage trả về và hóa đơn tài khoản để tìm bằng chứng tái sử dụng cache. Không sao chép tham số cache của Responses API vào endpoint này nếu chưa kiểm tra hỗ trợ.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Kết luận
Với các ứng dụng AI có tần suất lặp lại cao, bộ nhớ đệm prompt có thể tạo khác biệt đáng kể cho kinh tế suy luận. OpenAI cung cấp điều khiển prompt và lưu giữ ngày càng chi tiết; Claude mang đến điều khiển thuận tiện ở mức tự động và cấp khối; Gemini giúp tái sử dụng ngầm trở nên đơn giản trên các model hiện đại. Cách triển khai đúng phụ thuộc vào khối lượng prompt ổn định, tỷ lệ trúng, hết hạn và tổng chi phí. Hãy bắt đầu với một tiền tố dùng chung rõ ràng, xác minh số liệu usage, rồi tối ưu lưu giữ và lựa chọn nhà cung cấp dựa trên đo lường gần với môi trường sản xuất.
Câu hỏi thường gặp
Làm thế nào để so sánh công bằng các nhà cung cấp bộ nhớ đệm?
Phát lại cùng tài liệu nguồn hữu ích và các câu hỏi tương đương, nhưng sử dụng số đếm token và mức giá billing thực tế của từng nhà cung cấp. Giữ yêu cầu đầu ra tương đồng và báo cáo cả yêu cầu thất bại lẫn thành công. Một số ký tự cố định không ngụ ý cùng số token, vì vậy hãy so sánh chi phí mỗi tác vụ hoàn tất song song với số đo tỷ lệ trúng cache.
Tôi có nên cache mọi tài liệu trong một kho kiến thức luôn thay đổi?
Nhóm tài liệu theo tần suất thay đổi và tần suất tái sử dụng. Một tài liệu cập nhật thường xuyên có thể liên tục làm mất hiệu lực một tiền tố dùng chung lớn; đặt tài liệu chính sách ổn định lên trước và tài liệu thay đổi ra sau có thể giảm rủi ro đó. Phiên bản hóa nguồn tài liệu một cách có chủ đích và làm mới khi tính đúng đắn yêu cầu, ngay cả khi điều đó làm giảm tái sử dụng cache.