TL;DR: Alibaba phát hành Qwen4-Max vào ngày 16 tháng 11 năm 2026, là mẫu flagship của thế hệ Qwen4. Đánh giá chính thức báo cáo hiệu năng nhiệm vụ ngành tốt hơn và chi phí thực thi thấp hơn so với Qwen3.8-Max, phản ánh cải thiện về hiệu quả token và giảm giá API.
Điểm chính
- Kích thước mô hình: Qwen4-Max có 2,4 nghìn tỷ tham số backbone, với 71 tỷ tham số được kích hoạt trên mỗi token.
- Cửa sổ ngữ cảnh: Qwen4-Max hỗ trợ cửa sổ ngữ cảnh một triệu token.
- Hỗ trợ đa phương thức: Qwen4-Max nhận văn bản, hình ảnh và video và tạo văn bản.
- Tính năng cho nhà phát triển: Qwen4-Max hỗ trợ gọi hàm (function calling), đầu ra có cấu trúc, bộ nhớ đệm ngữ cảnh (context caching) và tìm kiếm web.
- Tùy chọn truy cập: Người dùng có thể truy cập Qwen4-Max qua các ứng dụng Qwen được hỗ trợ, API QwenCloud tính phí theo mức sử dụng và gói đăng ký Token Plan.
Qwen4-Max là gì?
Trong thông báo chính thức của Alibaba, Qwen mô tả Qwen4-Max như một “đồng đội AI” cho công việc, sáng tạo và khám phá. Năng lực của nó tập trung vào hiểu mục tiêu, vận hành công cụ, phản hồi theo kết quả thực thi và bàn giao qua nhiều giai đoạn.
Đối với các quy trình này, mô hình cung cấp suy luận và điều phối. Ứng dụng, công cụ và môi trường thực thi được kết nối sẽ đảm nhận việc vận hành.
Thông số kỹ thuật của Qwen4-Max
Trang mô hình QwenCloud chính thức liệt kê các thông số sau:
Kích thước ngữ cảnh, giới hạn đầu vào và giới hạn đầu ra là các ràng buộc khác nhau. Ứng dụng phải đồng thời thỏa mãn chúng và dành đủ dung lượng cho câu trả lời được tạo và suy luận.
Những tính năng chính của Qwen4-Max là gì?
Năng lực của Qwen4-Max đặc biệt phù hợp khi một tác vụ trải dài trên nhiều tài liệu, công cụ và bước thực thi. Ngữ cảnh dài giữ nền tảng làm việc, hiểu biết thị giác mở rộng bằng chứng sẵn có, và khả năng agent giúp đẩy tác vụ đến bàn giao.
Cửa sổ ngữ cảnh một triệu token và khả năng hiểu thị giác gốc
Cửa sổ ngữ cảnh lớn cho phép xử lý tài liệu liên quan trong một bối cảnh làm việc chung. Ứng dụng thực tế gồm so sánh hợp đồng, phân tích phụ thuộc giữa các tệp mã, và rà soát báo cáo cùng tài liệu hỗ trợ.
Khả năng hiểu thị giác gốc mở rộng điều này tới ảnh chụp màn hình, sơ đồ, trang quét và video. Người dùng có thể cung cấp bản vẽ kỹ thuật hoặc ảnh giao diện và yêu cầu mô hình diễn giải cùng với yêu cầu bằng văn bản.
Với các tác vụ nặng tài liệu, việc giữ lại tên tệp, ngày tháng và nhãn mục giúp tổ chức bằng chứng và khiến phân tích dễ xác minh hơn.
Lập trình và sử dụng công cụ chuyên nghiệp
Qwen4-Max hỗ trợ gọi hàm, cho phép nhà phát triển kết nối với cơ sở dữ liệu, dịch vụ tìm kiếm, thao tác tệp và hệ thống nghiệp vụ. Đầu ra có cấu trúc giúp chuyển kết quả mô hình vào các quy trình phần mềm tiếp theo.
Các trình diễn chính thức cho thấy quy trình phần mềm rộng hơn. Trong phát triển game, mô hình sử dụng các engine như Unity, Unreal Engine và Godot để dựng cảnh, hiện thực gameplay, và tinh chỉnh kết quả qua kiểm thử. Trong Blender, nó điều phối hình học, vật liệu, ánh sáng và render.
Tái lập các quy trình này đòi hỏi phần mềm liên quan, tài nguyên và quyền thực thi. Các trình diễn cho thấy mô hình có thể làm gì trong những môi trường đó.
Tác nhân dài hạn và Live Delivery
Các tác vụ dài trở nên khó quản lý khi người dùng không thể kiểm tra tiến độ cho đến khi hoàn tất. Cách tiếp cận Live Delivery của Qwen4-Max giới thiệu một kết quả có thể dùng ngay ban đầu, sau đó là các bản cập nhật liên tiếp.
Với một nhiệm vụ nghiên cứu, một agent có thể đầu tiên bàn giao phát hiện sơ bộ và danh sách nguồn, rồi mở rộng phân tích và thêm biểu đồ. Người dùng có thể xem mỗi phiên bản và điều hướng công việc tiếp theo.
Qwen cũng phát hành Qwen-Live-Delivery-Plugin. Với các quy trình kéo dài hàng giờ hoặc hơn, bàn giao theo giai đoạn tạo các điểm kiểm tra thực tế để xem xét chất lượng và chỉnh hướng.
Kiến trúc và hiệu quả token
Qwen4-Max giới thiệu một số thay đổi đối với kiến trúc mixture-of-experts thưa:
- Gated DeltaNet và Qwen Sparse Attention: Kết hợp nén thông tin lịch sử với cơ chế tập trung chọn lọc vào ngữ cảnh liên quan, giảm tính toán chuỗi dài.
- Gated Residual: Sử dụng bốn nhánh residual song song và cổng động để cải thiện truyền tải thông tin và ổn định huấn luyện.
- N-gram Embedding: Thêm 328 tỷ tham số embedding để biểu diễn mẫu token cục bộ qua phép tra cứu, mở rộng dung lượng với chi phí tính toán bổ sung tương đối thấp.
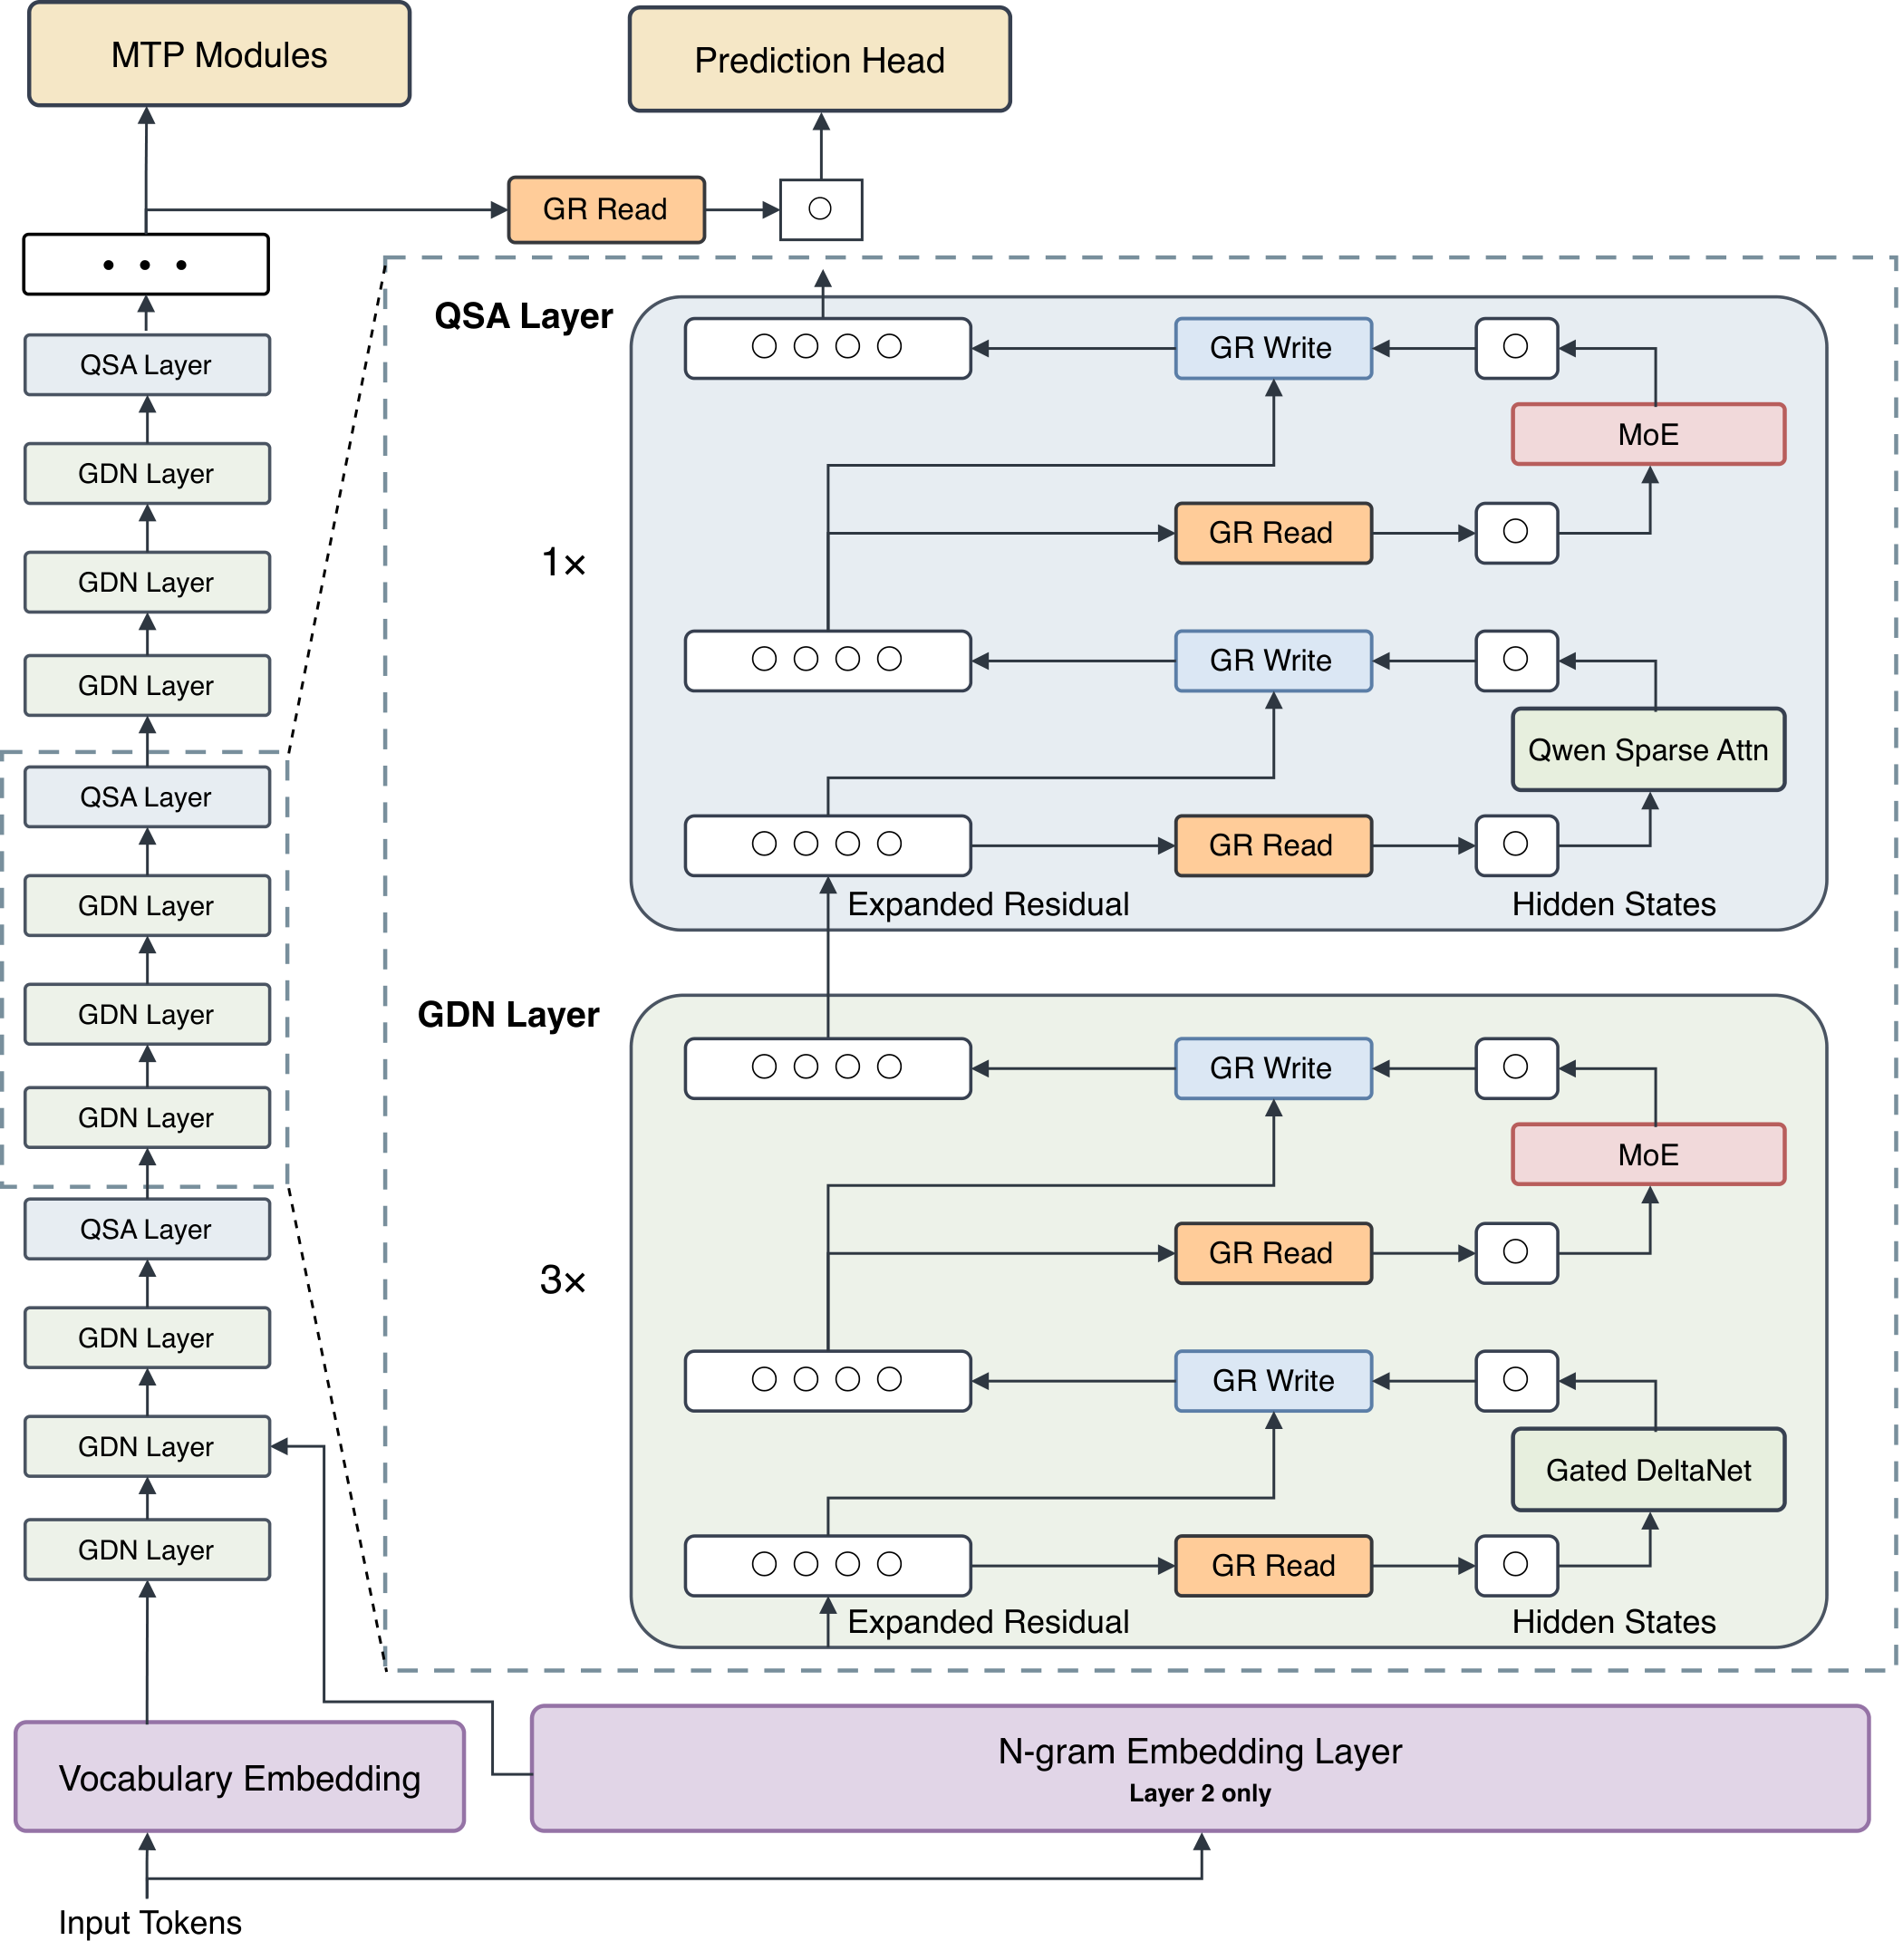
Với người dùng, phép thử thực tế là liệu các thay đổi này có giảm tài nguyên cần thiết để cho ra kết quả chấp nhận được hay không. Các phép đo tiêu thụ token được Qwen công bố cung cấp bằng chứng cải thiện trên các tác vụ được đánh giá.
Qwen4-Max hoạt động ra sao? Benchmark và ví dụ chính thức
Các benchmark được Qwen công bố đo lường hiệu năng nhiệm vụ, tiêu thụ token và chi phí thực thi, trong khi các trình diễn minh họa quy trình thực tế.
Kết quả benchmark của Qwen4-Max
Các kết quả sau so sánh Qwen4-Max với Qwen3.8-Max:
| Chỉ số | Qwen4-Max so với Qwen3.8-Max |
|---|---|
| Điểm Work360 | Tăng từ 47.74 lên 52.69 |
| Tiêu thụ token Work360 |
Sự giảm chi phí phản ánh cả tiêu thụ token thấp hơn và việc điều chỉnh giá API.
Với các ứng dụng gọi công cụ lặp lại, chi phí mỗi tác vụ hoàn tất thành công là so sánh hữu ích hơn so với giá token đơn thuần. Một yêu cầu có giá thấp hơn chỉ tiết kiệm hạn chế nếu quy trình đòi hỏi thử lại nhiều hoặc sửa thủ công.
Ví dụ trong nghiên cứu tài chính và sản xuất
Một số ví dụ chính thức cung cấp sản phẩm bàn giao cụ thể và kết quả đo lường được.
Trong nghiên cứu tài chính, mô hình kết hợp công cụ dữ liệu thị trường và tìm kiếm để tạo bảng tính Excel và báo cáo PowerPoint có thể chỉnh sửa. Liên kết nguồn và biểu đồ khớp cho phép người rà soát truy vết phát hiện trong báo cáo về dữ liệu hỗ trợ.
Trong ví dụ sản xuất, mô hình kết hợp mô hình tham số, sinh đường chạy dao và phản hồi mô phỏng. Nỗ lực lập trình của con người cho một phôi giảm từ khoảng 475 phút xuống còn 24 phút. Kết quả này mô tả phôi và môi trường công cụ được trình diễn và là điểm khởi đầu hữu ích để đánh giá quy trình tương tự.
Cách diễn giải kết quả
Điểm Work360 của Qwen4-Max tăng từ 47.74 lên 52.69, tăng 4.95 điểm. Điều này cho thấy hiệu năng mạnh hơn trên các nhiệm vụ ngành được đánh giá, dù kết quả từng tác vụ có thể khác nhau. Giảm tiêu thụ token cung cấp thước đo hiệu quả riêng, với mức tiết kiệm khác nhau ở thiết lập suy luận High và Xhigh.
Mức giảm 58% chi phí trung bình mỗi tác vụ Work360 phản ánh kết hợp giữa tiêu thụ token thấp hơn và giá API được điều chỉnh. Với nhà phát triển, câu hỏi liên quan là liệu các khoản tiết kiệm đó có duy trì đến mức chi phí mỗi tác vụ hoàn tất thành công sau khi thử lại và sửa thủ công hay không.
Các trình diễn ứng dụng bổ sung bằng chứng về quy trình và sản phẩm cụ thể. Hãy dùng chúng để xác định tác vụ đáng thử nghiệm, rồi so sánh chất lượng hoàn tất, nỗ lực rà soát và tổng chi phí trong điều kiện công cụ nhất quán.
Giá Qwen4-Max: Chi phí API và tùy chọn Token Plan
Qwen4-Max khả dụng qua thanh toán API tính theo mức sử dụng và đăng ký Token Plan. Lựa chọn phù hợp phụ thuộc vào việc bạn xây dựng ứng dụng hay dùng công cụ AI tương tác.
Giá API tính theo mức sử dụng chính thức
QwenCloud liệt kê các mức giá khu vực Singapore như sau:
| Hạng mục tính phí | Giá cho 1 triệu token |
|---|---|
| Đầu vào tiêu chuẩn | $1.50 |
| Đầu ra | $4.50 |
| Đầu vào cache ngầm định | $0.075 |
Tạo cache tường minh có giá $1.875 cho mỗi triệu token đối với cache 5 phút và $3.00 đối với cache 1 giờ.
Một tác vụ sử dụng 100,000 token đầu vào không cache và 10,000 token đầu ra tính phí có chi phí $0.195 tiền token mô hình, chưa gồm công cụ hay dịch vụ tính phí bổ sung.
Đầu vào được cache có giá thấp hơn 95% so với đầu vào tiêu chuẩn. Ứng dụng lặp lại cùng hướng dẫn, định nghĩa công cụ hoặc tiền tố tài liệu có thể giảm chi phí đầu vào bằng cách cải thiện việc dùng cache.
Token Plan hoạt động thế nào
Token Plan sử dụng thanh toán theo thuê bao và khấu trừ Credits. Hiện liệt kê qwen4-max trong các mô hình được hỗ trợ.
Tính đến ngày 17 tháng 11 năm 2026, trang khu vực Singapore hiển thị các gói hàng tháng riêng lẻ sau:
Trang cũng quảng bá khuyến mại cho người dùng mới bắt đầu từ $3. Điều kiện đủ điều kiện và số tiền cuối cùng được hiển thị trong quá trình thanh toán.
Credits là đơn vị tính cước thuê bao chứ không phải hạn mức token trực tiếp. Mức tiêu thụ phụ thuộc vào mô hình và quy tắc công cụ áp dụng.
Theo tài liệu Token Plan, dịch vụ dành cho sử dụng tương tác trong các công cụ AI tương thích và hiện có tại khu vực Singapore.
Cách truy cập Qwen4-Max
Có ba cách thực tế: dùng sản phẩm Qwen, kết nối trực tiếp qua QwenCloud, hoặc cấu hình công cụ AI tương thích. Mỗi cách có yêu cầu thiết lập khác nhau, đặc biệt về thông tin xác thực và endpoint.
Dùng ứng dụng Qwen
Thông báo chính thức liệt kê Qwen Studio, ứng dụng Qwen, QwenWork và Qoder là các kênh truy cập.
Các sản phẩm này là điểm khởi đầu thuận tiện để thử phân tích tài liệu, hỗ trợ lập trình và quy trình văn phòng. Nhà phát triển cần kiểm soát yêu cầu, công cụ và xử lý kết quả có thể chuyển sang tích hợp API trực tiếp.
Truy cập API QwenCloud
Để truy cập Qwen4-Max, đăng nhập QwenCloud, lấy khóa API cho khu vực đã chọn và cấu hình endpoint tương ứng với ID mô hình qwen4-max. QwenCloud cung cấp truy cập tương thích OpenAI. Người dùng chuyển từ bản xem trước cũng nên rà soát tham số yêu cầu và cấu hình thanh toán.
Cấu hình công cụ lập trình và agent
Tài liệu Token Plan cung cấp hướng dẫn tích hợp cho các công cụ gồm Qwen Code, Cline, Cursor và OpenCode.
Việc cấu hình thường cần khóa API riêng, Base URL phù hợp và tên mô hình. Token Plan dùng domain endpoint riêng token-plan.maas.qwencloudapi.com, và khóa của nó không thể hoán đổi với khóa API tính phí theo mức sử dụng.
Làm theo hướng dẫn cho công cụ đã chọn, rồi xác minh cấu hình bằng một tác vụ gồm đọc tài liệu, thực hiện thao tác và kiểm tra kết quả.
Ai nên dùng Qwen4-Max?
Qwen4-Max đáng để đánh giá khi một quy trình lặp lại cần ngữ cảnh lớn, nhiều công cụ và sản phẩm có thể thẩm định.
- Nhà phát triển có thể đánh giá Qwen4-Max cho thay đổi mã nhiều tệp, phát triển frontend và các agent dùng công cụ bên ngoài.
- Nhóm văn phòng và nghiên cứu có thể dùng để phân tích tài liệu, tổ chức dữ liệu và soạn báo cáo với nguồn có thể truy vết.
- Nhóm thiết kế và nội dung có thể thử cho dựng hình 3D, nguyên mẫu game và quy trình video kết nối phần mềm chuyên nghiệp.
- Nhóm doanh nghiệp có thể đánh giá quy trình lặp lại với quyền truy cập dữ liệu xác định, giao diện công cụ và tiêu chí chấp nhận rõ ràng.
Với quy trình tài chính, pháp lý và y tế, hãy dùng cho xử lý bằng chứng và hỗ trợ phân tích, với chuyên gia đủ điều kiện rà soát các kết luận hệ trọng.
Câu hỏi thường gặp
Giới hạn đầu ra của Qwen4-Max có phải một triệu token không?
Không. Cửa sổ ngữ cảnh và độ dài đầu ra tối đa là các giới hạn riêng. QwenCloud liệt kê đầu ra tối đa 131K token ở chế độ tiêu chuẩn và 262K token ở chế độ Thinking. Yêu cầu cũng phải thỏa mãn giới hạn đầu vào và ngữ cảnh áp dụng.
Nên chọn API Qwen4-Max hay Token Plan?
Chọn API tính theo mức sử dụng khi tích hợp Qwen4-Max vào ứng dụng hoặc dịch vụ backend. Token Plan dành cho sử dụng tương tác trong công cụ AI tương thích và dùng Credits theo thuê bao. Hai tùy chọn yêu cầu thông tin xác thực và endpoint riêng.
Tôi có thể dùng Qwen4-Max miễn phí không?
Truy cập API chính thức và Token Plan đều là dịch vụ trả phí. Truy cập miễn phí qua các ứng dụng Qwen, nếu có, tuân theo quy định tài khoản và mức sử dụng của từng sản phẩm; điều này không tạo hạn mức API miễn phí.
Tôi có thể tải Qwen4-Max để triển khai cục bộ không?
Tính đến ngày 17 tháng 11 năm 2026, Qwen chưa cung cấp trọng số mở cho Qwen4-Max, vì vậy phát hành chính thức không có mô hình tải về để triển khai cục bộ. Qwen đã công bố kế hoạch dần mở nguồn các mô hình nhỏ hơn trong dòng Qwen4.
Kết luận
Qwen4-Max là ứng viên mạnh cho phân tích tài liệu dài, lập trình phức tạp và quy trình liên quan nhiều công cụ. Đánh giá chính thức cho thấy điểm cao hơn và chi phí tác vụ thấp hơn Qwen3.8-Max trên các tải công việc được báo cáo.
Hãy bắt đầu với một tác vụ đại diện đã có tiêu chí chấp nhận rõ ràng. So sánh chất lượng đầu ra, thời gian sửa thủ công, thời gian thực thi và tổng chi phí. Cải thiện trên các thước đo đó sẽ là cơ sở thực tế để mở rộng Qwen4-Max sang các quy trình tương tự.