
TL;DR
Muse Ember là mô hình suy luận đa phương thức nhỏ nhất của Meta, được xây dựng cho các tác vụ agent khối lượng lớn như định tuyến, trích xuất, gọi công cụ và coding có phạm vi. Meta giới thiệu Muse Ember vào ngày 9 tháng 11, 2026.
Cửa sổ ngữ cảnh 1,048,576 token chứa được nguồn liệu lớn. Meta cung cấp quyền truy cập qua Model API và Muse Code; CometAPI liệt kê muse-ember, trạng thái kích hoạt nêu bên dưới. Hãy bắt đầu bằng một tác vụ lặp lại có thể kiểm tra đầu ra, rồi so sánh chi phí trên mỗi kết quả thành công, bao gồm suy luận, công cụ và lần thử lại.
Key Takeaways
- Role: Muse Ember được xây cho việc thực thi agent lặp lại, gồm phân loại, trích xuất, gọi công cụ và các tác vụ coding có giới hạn.
- Inputs and capacity: Muse Ember nhận văn bản, hình ảnh, âm thanh và video, với cửa sổ ngữ cảnh 1M token và tối đa 512K token đầu ra.
- Performance: Kết quả của Meta nghiêng về Muse Ember trên một số benchmark agent, trong khi thử nghiệm phân tích độc lập cho thấy giá token thấp không phải lúc nào cũng cho chi phí tác vụ thấp nhất.
- Pricing: Yêu cầu vượt 200K token đầu vào bước vào bậc giá cao hơn; tổng chi phí tác vụ cũng phụ thuộc vào suy luận và sử dụng công cụ.
- Access: Có sẵn qua Meta Model API và Muse Code; mục CometAPI hiện đánh dấu mô hình là Coming soon.
What Is Muse Ember Best Used For?
Muse Ember xử lý các bước thực thi trong một quy trình agent trong khi một mô hình lớn hơn đảm nhận lập kế hoạch. Nó phù hợp các tác vụ khối lượng lớn với đầu vào rõ ràng, phạm vi giới hạn và kết quả mà ứng dụng của bạn có thể xác minh. Công việc cốt lõi:
- Classification and routing: Gán nhãn yêu cầu và gửi đến đúng hàng đợi hoặc dịch vụ.
- Extraction: Biến tài liệu và phương tiện thành các trường có cấu trúc kèm bằng chứng nguồn.
- Tool calling: Chọn một hàm và cung cấp tham số để ứng dụng của bạn thực thi.
- Batch processing: Áp dụng một thao tác lặp lại trên tệp hoặc bản ghi.
Support-Ticket Routing
Một quy trình hỗ trợ thực tế có thể yêu cầu Ember trích xuất mã đơn hàng, gán một danh mục và gắn cờ thông tin còn thiếu. Ứng dụng của bạn có thể xác thực mã tham chiếu với hồ sơ trước khi định tuyến ticket. Giữ hoàn tiền, thay đổi tài khoản và các hành động hệ trọng khác phía sau cơ chế kiểm soát cấp quyền của ứng dụng.
Document Extraction with Evidence
Với hóa đơn hoặc hợp đồng, yêu cầu cả giá trị trích xuất và trang/đoạn văn hỗ trợ. Xem các trường vắng mặt và không thể đọc là kết quả rõ ràng thay vì mời mô hình phỏng đoán. Điều này tạo ra hồ sơ để người duyệt có thể kiểm tra mà không phải đọc lại toàn bộ tài liệu.
Focused Coding Work
Giao cho worker coding một phạm vi sở hữu nhỏ: các tệp được phép thay đổi, hành vi cần giữ và các kiểm thử xác định hoàn tất. Ví dụ di chuyển mã song song của Meta minh họa sự phân chia công việc này. Agent bao quanh chạy lệnh và kiểm tra kết quả; phản hồi của mô hình tự thân không phải bằng chứng rằng thay đổi đã vượt qua kiểm thử.
Hình minh họa ra mắt Muse Ember đi cùng hướng dẫn kết hợp một mô hình thực thi với một mô hình lập kế hoạch lớn hơn.
Meta cho biết Muse Ember là mô hình đầu tiên được huấn luyện bằng Muse Wonder Full, mở rộng chiến lược dùng mô hình lớn để phát triển mô hình chuyên biệt.
Muse Ember Specifications
| Specification | Muse Ember |
|---|---|
| Developer | Meta Superintelligence Labs |
| Announcement date | 9 tháng 11, 2026 |
| Model category | Multimodal reasoning and agent execution |
| Context window | 1,048,576 tokens |
| Maximum output | 524,288 tokens |
| Input modalities | Text, images, audio, video |
| File inputs | Supported through the Responses API |
| Output modality | Text |
| Reasoning effort | Minimal, Low, Medium, High, XHigh, Max |
| Default reasoning effort | Max |
| Tool calling | Supported |
| Structured output | Supported |
| Search grounding | Supported through the Model API |
Meta chưa phát hành trọng số của Muse Ember hoặc công bố số tham số. Giới hạn yêu cầu và token áp dụng theo nhóm, mọi khóa API trong nhóm chia sẻ hạn mức của mô hình.
Context and Multimodal Inputs
Với quy trình PDF, Meta trích xuất văn bản từ 100 trang đầu và hình ảnh từ 50 trang đầu, vì vậy hãy tách tệp dài hơn trước khi xử lý. Gửi đúng tài liệu cần cho tác vụ; token suy luận chia sẻ hạn mức đầu ra 524,288 token với câu trả lời cuối.
Dùng ảnh chụp màn hình khi bố cục quan trọng, bản scan cho trích xuất tài liệu, âm thanh cho phân tích cuộc họp và video cho sự kiện diễn tiến theo thời gian. Bản chép lời là đủ cho tóm tắt chỉ văn bản. Tệp được hỗ trợ qua Responses API, và kết quả trả về ở dạng văn bản.
Configurable Reasoning Effort
Muse Ember cung cấp sáu mức suy luận: Minimal, Low, Medium, High, XHigh và Max. Meta mặc định Max; none không được hỗ trợ và trả về HTTP 400. Hãy bắt đầu định tuyến và phân loại thường lệ ở mức thấp hơn, rồi chỉ tăng khi mức tăng tỷ lệ câu trả lời chấp nhận được biện minh cho độ trễ và chi phí token đầu ra bổ sung.
Tool Calling and Structured Output
Muse Ember hỗ trợ gọi công cụ và đầu ra có cấu trúc. Gọi công cụ nối quyết định của mô hình với hàm của ứng dụng, còn đầu ra có cấu trúc giúp các trường trích xuất dễ xác thực và chuyển sang bước tiếp theo.
Ví dụ kết quả ticket hỗ trợ dưới đây cung cấp cho ứng dụng định tuyến một danh mục, một mức ưu tiên và cờ yêu cầu rà soát:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API cũng hỗ trợ neo bằng tìm kiếm và quy trình sử dụng máy tính. Ứng dụng kết nối cung cấp công cụ, thực thi hành động và kiểm soát quyền hạn.
How Does Muse Ember Perform on Benchmarks?
Kết quả ra mắt của Meta dùng mức suy luận tối đa. Agents’ Last Exam bao phủ tập con Linux trong đánh giá nội bộ của Meta, trong khi Terminal-Bench dùng harness tốt nhất được công bố của mỗi mô hình. Họ kết hợp kết quả Artificial Analysis báo cáo bên ngoài với đánh giá nội bộ của Meta; Personal Superintelligence Index là thang tổng hợp nội bộ của Meta, không phải bảng xếp hạng độc lập riêng.
Muse Ember Benchmark Results
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 dùng mini-swe-agent cho Muse Ember, Claude Code cho Haiku 5.5 và Codex cho GPT-6 Luna. Đây không phải các môi trường thực thi tương đồng. OSWorld 2.1 báo cáo cả điểm một phần và điểm nhị phân, còn PerceptionBench bao gồm công cụ. Kết quả Artificial Analysis Intelligence Index là từ phiên bản 5 đăng ngày 9 tháng 11, 2026.
Muse Ember Benchmark Analysis
Agent execution là thế mạnh nhất của Muse Ember.
Trên AutomationBench-AA, Muse Ember đạt 37.8, so với 13.9 của Haiku 5.5 và 20.2 của GPT-6 Luna. Điều này ủng hộ định vị của Meta về Muse Ember như mô hình cho quy trình kinh doanh đầu-cuối và vận hành agent lặp lại.
Hiệu năng coding cạnh tranh, nhưng không vượt trội mọi nơi.
Muse Ember đạt 40.9 trên Terminal-Bench 4.0 và 46 trên Coding Agent Index-AA. Tuy nhiên, nó đạt 27.2 trên FrontierCode 2.0-AA, thấp hơn 34.9 của Haiku 5.5. Điều này gợi ý Muse Ember là ứng viên hữu ích cho các tiểu nhiệm vụ coding có giới hạn, trong khi công việc kỹ thuật khó hơn nên thử nghiệm với các lựa chọn mạnh hơn.
Kết quả đa phương thức và sử dụng máy tính đầy hứa hẹn.
Muse Ember đạt 80.6 trên PerceptionBench với công cụ và 69.5 trên OSWorld 2.1 theo chấm điểm một phần. Những kết quả này ủng hộ định vị của nó cho các quy trình liên quan hiểu thị giác và tương tác máy tính.
Trí tuệ tổng quát tương đương Haiku 5.5.
Muse Ember và Haiku 5.5 đều làm tròn về 36 trên Artificial Analysis Intelligence Index, vượt GPT-6 Luna ở mức 28. Để chọn lựa, hãy ghép so sánh rộng đó với kết quả cụ thể theo tác vụ ở trên.
Muse Ember Intelligence vs. Cost Per Task
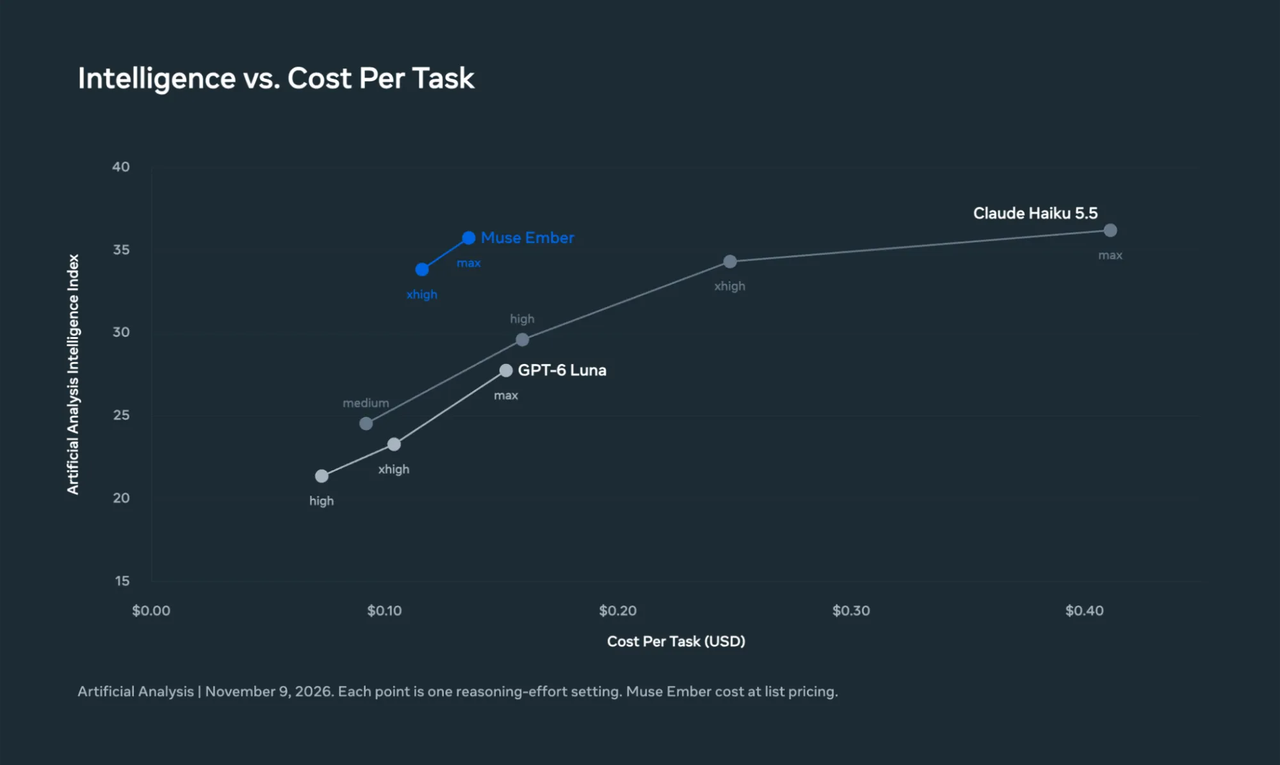
Biểu đồ của Meta so sánh điểm Artificial Analysis Intelligence Index với chi phí ước tính mỗi tác vụ ở các mức suy luận khác nhau.
Ở mức suy luận tối đa, Muse Ember đạt 35.8 trên Artificial Analysis Intelligence Index với chi phí ước tính $0.136 mỗi tác vụ. Haiku 5.5 đạt 36.2 ở $0.411, trong khi GPT-6 Luna đạt 27.8 ở $0.152. Trên benchmark này, Ember tiệm cận điểm của Haiku với khoảng một phần ba chi phí và vượt Luna với chi phí hơi thấp hơn.
Các ước tính này dùng mức tiêu thụ token của benchmark và giá niêm yết. Đánh giá tiếp theo cho thấy vì sao hoạt động công cụ quan trọng khi chọn mô hình cho một quy trình cụ thể.
Independent Data-Analysis Results
Bài đánh giá phân tích dữ liệu ngày 10 tháng 11, 2026 của Plotly kiểm thử 43 câu hỏi trong Plotly Studio Embedded trên một tập dữ liệu gió tổng hợp. Muse Ember chạy qua OpenRouter; chi phí báo cáo dùng mức giá tại thời điểm mỗi mô hình chạy. Đây là kết quả theo khối lượng công việc, không phải thử nghiệm tính phí API gốc của Meta.
| Evaluation metric | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Questions passed | 38/43 | 38/43 | 37/43 |
| Full test cost | $1.04 | $0.13 | $0.38 |
| Median time per question | 28 seconds | 18 seconds | 14 seconds |
Với khối lượng công việc phân tích dữ liệu này, GPT-6 Luna đạt cùng 38/43 như Ember với tổng chi phí chỉ bằng một phần tám, và thời gian phản hồi trung vị thấp hơn. Haiku nhanh nhất ở 14 giây/câu, với 37/43. Luna là ứng viên khởi đầu mạnh hơn cho quy trình phân tích nhạy chi phí tương tự; mức giá token thấp của Ember không tự động tạo ra chi phí thấp hơn.
Plotly thấy rằng Muse Ember thực hiện trung bình 78 truy vấn ở các câu hỏi có mẫu ẩn, so với trung vị 25 trên các mô hình được thử. Hoạt động công cụ bổ sung làm tăng tiêu thụ token và tổng chi phí.
Bài test cũng cho thấy điểm mạnh: Muse Ember trả lời đúng cả 20 câu hỏi phân tích được xác định rõ, cả 5 câu hỏi mơ hồ, cả 5 yêu cầu bất khả thi và cả 3 kiểm tra chất lượng dữ liệu. Nó gặp khó nhất với các mẫu ẩn trong dữ liệu.
Plotly chạy mỗi mô hình một lần và quan sát dao động tới 3 câu hỏi khi lặp ở các mô hình khác. Hãy xem mức 38 so với 37 là sát; khác biệt rõ ràng hơn ở đây là sử dụng công cụ và tổng chi phí.
Muse Ember vs Muse Wonder vs Muse Spark
Chọn mô hình Muse theo trách nhiệm nó đảm nhận: lập kế hoạch, vòng lặp agent chính hoặc thực thi lặp lại.
| Dimension | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Primary role | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| Main strength | Planning, long-running tasks, complex coding | Coding and agentic workflows | Repetitive subtasks and tool calls |
| Typical workload | Repository-scale engineering | Main agent execution | Classification, routing, extraction |
| API model ID | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Context window | 1M tokens | 1M tokens | 1M tokens |
| Default reasoning | Max | High | Max |
| Standard input price / 1M | $4.00 | $1.25 | $0.10 |
| Standard output price / 1M | $20.00 | $4.25 | $0.50 |
Bảng dùng giá token chế độ Standard của Meta. Giá của Ember ở đây áp dụng cho yêu cầu tới 200K token đầu vào; Wonder và Spark không chịu phụ phí ngữ cảnh dài như Ember.
Muse Model Selection
Chọn Wonder cho lập kế hoạch khó, kỹ thuật quy mô repository và phục hồi qua chuỗi bước dài. Chọn Spark để chạy vòng lặp coding hoặc agent chính. Chọn Ember cho các tiểu tác vụ lặp lại với đầu ra có thể xác minh độc lập, như định tuyến, trích xuất và thay đổi tệp mục tiêu.
Ví dụ, một di trú repository có thể giao phân tích phụ thuộc cho mô hình lớn hơn và thay đổi tệp phạm vi hẹp cho Ember. Chuyển giao nên nêu tên tệp, hành vi mong đợi và kiểm tra chấp nhận. Phân chia này chỉ hữu ích khi việc phối hợp và rà soát các tác vụ nhỏ tốn ít chi phí hơn thực hiện toàn bộ bằng mô hình chính.
Để chọn giữa chúng, hãy chạy cùng tác vụ đại diện qua các ứng viên với cùng kiểm tra chấp nhận. Loại bỏ cấu hình không đạt tỷ lệ thành công hoặc mục tiêu độ trễ bắt buộc. Trong số cấu hình đạt yêu cầu, so sánh tổng chi tiêu chia cho số tác vụ được chấp nhận, bao gồm thử lại và gọi công cụ. Giao cho Ember các loại tác vụ mà nó hạ được chi phí đó, và định tuyến các trường hợp chưa giải quyết về Spark hoặc Wonder.
How Much Does Muse Ember Cost?
Bảng ghép mức giá chính thức của Meta với ước tính chiết khấu 20% cho CometAPI, tính theo USD trên mỗi triệu token. Mỗi ô hiển thị Meta / ước tính sau chiết khấu. Mục CometAPI chưa công bố biểu giá trực tiếp; dùng số chiết khấu để lập ngân sách.
| Usage per 1M tokens (Meta / 20%-off estimate) | Up to 200K input tokens | Over 200K input tokens |
|---|---|---|
| Input | $0.10 / $0.08 | $0.30 / $0.24 |
| Cached input | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Output | $0.50 / $0.40 | $1.50 / $1.20 |
Tổng token đầu vào của yêu cầu, gồm cả đầu vào đã cache, quyết định bậc giá. Yêu cầu vượt 200K token đầu vào dùng mức giá cao hơn cho toàn bộ yêu cầu, bao gồm đầu ra. Với previous_response_id của Meta, lịch sử hội thoại đã lưu được tính vào tổng đầu vào đó.
Typical Muse Ember Request Costs
Với đầu vào không cache và 20K token đầu ra tính phí (gồm suy luận), một yêu cầu đầu vào 200K có chi phí $0.0300 theo giá Meta, hoặc $0.0240 trong kịch bản chiết khấu 20%. Tăng đầu vào lên 220K chuyển toàn bộ yêu cầu sang bậc cao hơn: cùng 20K đầu ra khi đó có tổng $0.0960 theo giá Meta, hoặc ước tính $0.0768 sau chiết khấu. Các ví dụ này không bao gồm phí công cụ riêng. Giữ ngữ cảnh liên quan trong bậc thấp hơn có thể tiết kiệm nhiều hơn cả chiết khấu 20%.
| Scenario | Input tokens | Billed output tokens | Meta cost | CometAPI cost |
|---|---|---|---|---|
| Standard request | 200K | 20K | $0.0300 | $0.0240 |
| Long-context request | 220K | 20K | $0.0960 | $0.0768 |
Token suy luận tính vào đầu ra. Với API gốc của Meta, neo kết quả web search tốn thêm $2.50 trên mỗi 1,000 truy vấn, và Ember không có biến thể Contributor-mode. So sánh giá token ở trên không áp dụng chiết khấu 20% cho phí công cụ riêng.
How to Access Muse Ember
CometAPI listing: trang mô hình xác định mô hình là muse-ember, nhưng trạng thái trong danh mục là Coming soon tính đến 16 tháng 11, 2026. Theo dõi trang đó để biết kích hoạt và giá; để truy cập ngay, dùng Meta Model API hoặc Muse Code.
Through Meta Model API: dùng muse-ember-1.0 với https://api.meta.ai/v1. API gốc hỗ trợ định dạng Responses, Chat Completions và Messages. Đầu vào tệp dùng Responses. Khi cấu hình client, giữ cùng nhau endpoint và định danh mô hình của từng nhà cung cấp.
Native API limits and other access: Meta liệt kê 3,000 yêu cầu mỗi phút và 4,000,000 token mỗi phút theo nhóm, được chia sẻ bởi các khóa API của nhóm. Muse Ember cũng có sẵn trong Muse Code. Kiểm tra giới hạn của tuyến truy cập bạn chọn khi lên kích thước batch và dùng hướng dẫn tích hợp của Meta để thiết lập API gốc.
What Are the Limitations of Muse Ember?
Ba yếu tố quyết định liệu Ember phù hợp cho quy trình tiếp theo của bạn:
- Kỹ thuật phức tạp vẫn phụ thuộc khối lượng công việc. Ember kém Haiku 5.5 trên FrontierCode 2.0-AA dù kết quả Terminal-Bench mạnh hơn. Một chiến thắng hẹp về coding không xác lập khả năng phù hợp cho mọi thay đổi quy mô repository.
- Ngữ cảnh dài và giá token thấp không đảm bảo chi phí tác vụ thấp. Yêu cầu lớn chuyển sang bậc giá cao hơn, và gọi công cụ lặp lại có thể tiêu thụ đủ token để lấn át mức giá mỗi token thấp.
- Hỗ trợ công cụ vẫn cần một ứng dụng. Hệ thống bao quanh thực thi lệnh gọi, kiểm soát quyền và xác thực kết quả. Khả năng mô hình yêu cầu hành động tự thân không cung cấp một quy trình đáng tin cậy.
Conclusion
Hãy áp dụng Ember ở nơi tiêu chí chấp nhận đủ rõ để đo lường. Một triển khai đầu tiên hữu ích là bước khối lượng lớn đã có kết quả biết trước, như định tuyến ticket được gán nhãn hoặc trích xuất trường từ tài liệu đã được duyệt. So sánh chi phí tác vụ thành công, tỷ lệ lỗi và độ trễ với mô hình hiện tại trước khi mở rộng vai trò của nó. Bằng chứng đó sẽ cho bạn biết liệu Ember có giảm chi phí quy trình mà vẫn giữ chất lượng cần thiết hay không.
FAQ
Làm thế nào để bạn xác thực kết quả trích xuất của Muse Ember?
Xây một bộ tài liệu tham chiếu với đáp án đã được con người kiểm tra, bao gồm trường thiếu, bản scan không đọc được và giá trị xung đột. Đo độ chính xác theo từng trường thay vì coi mọi phản hồi JSON hợp lệ là thành công. Kiểm tra xem mỗi giá trị trích xuất có được hỗ trợ bởi đoạn nguồn dẫn hay không, và gửi các trường hợp lệch khớp đi rà soát. Cách này tách độ tin cậy định dạng khỏi độ tin cậy thực chứng.
Khi nào nên trả một tiểu tác vụ Muse Ember về agent chính?
Định nghĩa điều kiện leo thang trước khi thực thi: tệp bắt buộc nằm ngoài phạm vi được giao, nguồn mâu thuẫn, kiểm tra chấp nhận liên tiếp thất bại, hoặc tác vụ đòi hỏi quyết định mà worker không được ủy quyền. Trả về bằng chứng, các bước đã thử và câu hỏi chưa giải quyết cho agent chính. Một chuyển giao rõ ràng hữu ích hơn việc cho phép worker mở rộng nhiệm vụ vô thời hạn.
Bạn nên log gì khi thử nghiệm Muse Ember trong sản xuất?
Ghi lại chính xác nhà cung cấp và định danh mô hình, thiết lập mức suy luận, token đầu vào và đầu ra tính phí, token đã cache, số lần gọi công cụ, số lần thử lại, độ trễ và kết quả chấp nhận cuối cùng. Giữ kết quả xác thực cùng bản ghi sử dụng để bạn có thể tính chi phí trên mỗi tác vụ được chấp nhận. So sánh riêng các loại tác vụ tương tự; một trung bình gộp giữa định tuyến, coding và tài liệu dài có thể che khuất nơi mô hình đang giúp hoặc đang làm tăng chi phí.
Làm sao ngăn hành động trùng lặp trong quy trình Muse Ember?
Để ứng dụng chịu trách nhiệm về định danh hành động và trạng thái hoàn tất. Với thao tác như tạo ticket, gán một khóa thao tác ổn định, kiểm tra liệu nó đã hoàn tất hay chưa, và dùng hỗ trợ idempotency của API đích khi có. Sau khi hết thời gian chờ, kiểm tra trạng thái hành động trước khi thử lại. Thiết kế này tránh coi một phản hồi không chắc chắn là bằng chứng rằng hành động gốc chưa từng xảy ra.