
在快速演進的人工智慧領域,DeepSeek 作為一個強而有力的競爭者脫穎而出,挑戰 OpenAI 與 Google 等既有巨頭。DeepSeek 由梁文峰於 2023 年 7 月創立,是一家中國的 AI 公司,因其對大型語言模型(LLM)的創新方法以及對開源開發的承諾而備受關注。本文將深入探討 DeepSeek 模型的架構、創新與影響,特別聚焦其專家混合(Mixture-of-Experts, MoE)框架,以及在 DeepSeek-V2 與 DeepSeek-R1 模型上的進展。
什麼是 DeepSeek,為何重要?
人工智慧(AI)正在快速發展,DeepSeek 作為目前最具野心的專案之一格外引人注目。DeepSeek 由前頂尖 AI 工程師與研究人員組成的團隊研發,代表一代新的開源語言模型,旨在縮小大型專有模型(如 GPT-4)與開放研究社群之間的差距。
DeepSeek 於 2024 年底推出,提出了多項關於訓練效率、擴展與記憶檢索的新思路,將開源模型的上限推得更高。
DeepSeek 的架構與傳統模型有何不同?
什麼是 MoE?
在傳統的稠密神經網路中,每個輸入都會通過整個網路,無論輸入的性質為何都會啟用所有參數。此作法雖然直接,但在模型擴大後會導致效率低下。
專家混合(Mixture-of-Experts)架構透過將網路拆分為多個子網路(即「專家」),讓每個專家專注於不同的任務或資料模式。門控機制會根據每次輸入動態選擇其中一部分專家,確保只有最相關的網路部分被啟用。這種選擇性啟用降低了計算開銷,並促進更高程度的模型專門化。
專家混合架構是一種提升大型神經網路效率與可擴展性的技術。MoE 並非對每個輸入啟用全部參數,而是依據輸入資料選擇性地啟用一部分專門化的「專家」網路。這種方法降低了計算負擔,並能進行更有針對性的處理。
DeepSeek 的 MoE 實作
DeepSeek 的模型,如 DeepSeek-R1 與 DeepSeek-V2,採用了先進的 MoE 框架。以 DeepSeek-R1 為例,其包含 6710 億個參數,但在任一前向傳播中僅啟用 370 億個參數。這種選擇性啟用由精巧的門控機制管理,將輸入導向最相關的專家,藉此在不犧牲效能的前提下優化計算效率。
簡化的 DeepSeek Transformer 長什麼樣?
以下是 DeepSeek 可能如何實作稀疏專家混合機制的簡化程式碼範例:
pythonimport torch
import torch.nn as nn
import torch.nn.functional as F

class Expert(nn.Module):
    def __init__(self, hidden_dim):
        super(Expert, self).__init__()
        self.fc = nn.Linear(hidden_dim, hidden_dim)

    def forward(self, x):
        return F.relu(self.fc(x))

class SparseMoE(nn.Module):
    def __init__(self, hidden_dim, num_experts=8, k=2):
        super(SparseMoE, self).__init__()
        self.experts = nn.ModuleList()
        self.gate = nn.Linear(hidden_dim, num_experts)
        self.k = k

    def forward(self, x):
        scores = self.gate(x)
        topk = torch.topk(scores, self.k, dim=-1)
        output = 0
        for idx in range(self.k):
            expert_idx = topk.indices
            expert_weight = F.softmax(topk.values, dim=-1)
            expert_output = torch.stack((x) for j, i in enumerate(expert_idx)])
            output += expert_weight.unsqueeze(-1) * expert_output
        return output

# 範例用法

batch_size, hidden_dim = 16, 512
x = torch.randn(batch_size, hidden_dim)
model = SparseMoE(hidden_dim)
out = model(x)
print(out.shape)  # 輸出形狀: (16, 512)
這個基本範例模擬了根據輸入動態選擇 2 個專家,並聚合其輸出。

DeepSeek 採用了哪些訓練策略?
如何進行資料蒐集與策劃?
DeepSeek 的創建者高度重視「資料品質」而非資料量。與 OpenAI 等從整體公開網路大規模抓取資料不同,DeepSeek 結合了:
- 經策劃的開放資料集(Pile、Common Crawl 部分資料)
- 學術語料
- 程式碼倉庫(如 GitHub)
- 由較小的監督式模型產生的特殊合成資料集
其訓練採用「多階段」課程學習方式:
- 早期階段訓練較簡單、事實性強的資料集
- 後期階段著重於偏重推理與程式設計的任務
採用了哪些最佳化技術?
高效訓練大型語言模型仍是一項重大挑戰。DeepSeek 採用了:
- ZeRO-3 Parallelism:將最佳化器狀態、梯度與參數分散到多個 GPU 上
- 訓練期間的 Int8 量化:在不降低模型品質的前提下降低記憶體使用
- 自適應學習率:使用帶預熱的餘弦退火等技術
以下是一段展示自適應學習率排程的簡單程式碼:
pythonfrom torch.optim.lr_scheduler import CosineAnnealingLR

optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
scheduler = CosineAnnealingLR(optimizer, T_max=100)

for epoch in range(100):
    train(model)
    validate(model)
    scheduler.step()
這段程式碼可在訓練過程中平滑調整學習率。
DeepSeek 如何實現更優異的效能?
檢索扮演什麼角色?
DeepSeek 整合了內建的檢索系統——類似於在神經網路中插入搜尋引擎。當接收到提示時,模型可以:
- 將查詢編碼
- 從外部記憶中檢索相關文件
- 將文件與其內部知識融合
這讓 DeepSeek 相較於傳統封閉模型更能保持事實準確且與時俱進。
概念上大致如下:
pythonclass Retriever:
    def __init__(self, index):
        self.index = index  # 假設已有預先建立的搜尋索引

    def retrieve(self, query_embedding):
        # 基於相似度進行搜尋

        return self.index.search(query_embedding)

class DeepSeekWithRetriever(nn.Module):
    def __init__(self, model, retriever):
        super().__init__()
        self.model = model
        self.retriever = retriever

    def forward(self, query):
        embedding = self.model.encode(query)
        docs = self.retriever.retrieve(embedding)
        augmented_input = query + " " + " ".join(docs)
        output = self.model.generate(augmented_input)
        return output
這類「檢索增強生成(RAG)」大幅提升了 DeepSeek 的長期推理能力。
DeepSeek 如何進行評估?
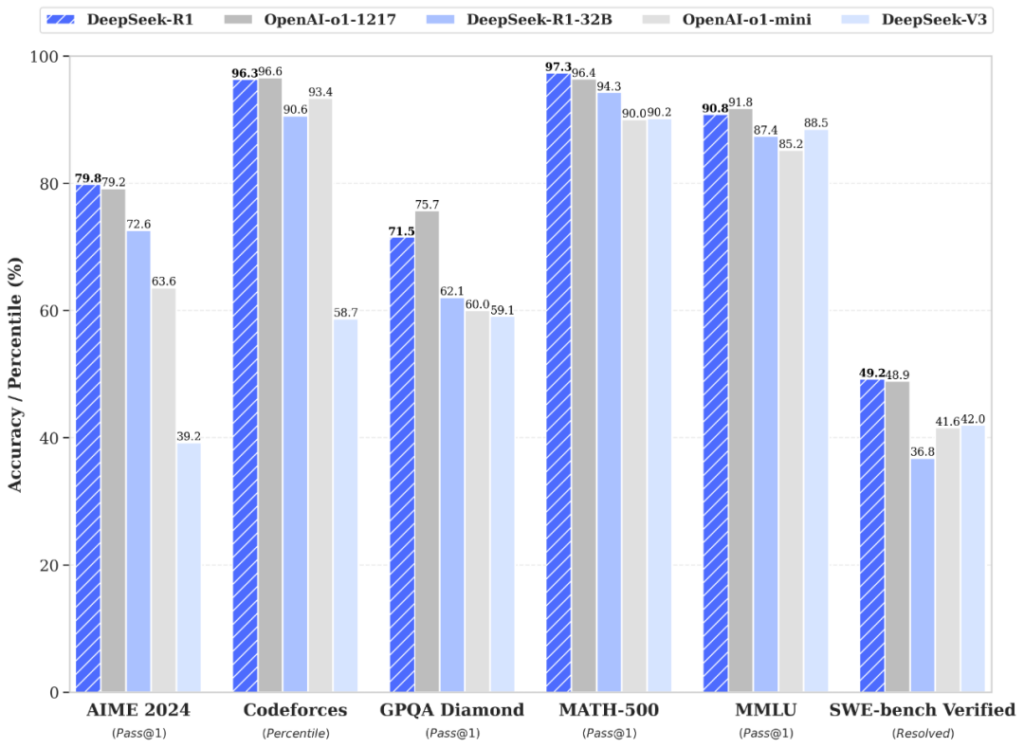
該模型使用以下基準進行評測:
- MMLU:多任務語言理解
- HumanEval:程式碼生成準確性
- TruthfulQA:回答真實性
- BIG-bench:廣泛通用的 AI 評測
在多數情況下,DeepSeek 最大的模型(30B、65B 參數)在推理任務上可與 GPT-4-turbo 比肩甚至超越,同時運行成本顯著更低。
DeepSeek 仍面臨哪些挑戰?
儘管令人印象深刻,DeepSeek 仍非毫無瑕疵:
- 偏見與毒性:即使是經策劃的資料集仍可能產生問題輸出
- 檢索延遲:RAG 系統可能比純生成模型更慢
- 計算成本:即使使用 MoE,訓練與服務這些模型仍然昂貴
DeepSeek 團隊正積極研究模型剪枝、更智慧的檢索演算法與偏見緩解。
結論
自 Transformer 架構興起以來,DeepSeek 代表了開源 AI 發展中最重要的轉變之一。透過稀疏專家、檢索整合與更聰明的訓練目標等架構創新,它為開源模型能達到的成就樹立了新標準。
隨著 AI 生態持續演進,預期 DeepSeek(及其衍生專案)將在塑造下一波智慧應用方面扮演重要角色。
快速開始
開發者可透過 CometAPI 存取 DeepSeek R1 API 與 DeepSeek V3 API。開始前,請在 Playground 探索模型能力,並參考 API guide 以取得詳細指引。請注意,部分開發者在使用模型前可能需要完成組織驗證。