
TL;DR
Claude Fable 5.1 يمتلك حجة معيارية أقوى للبرمجة الذاتية الصعبة والعمل بعيد المدى. GPT-5.6 Sol يوفّر تكاليف رموز عادية أقل، وحزمة أدوات أصلية واسعة، ووقتًا أقل للوصول إلى أول رمز في المقارنة المستقلة بأقصى جهد. الاختيار الافتراضي الصحيح يعتمد على تكلفة فشل المهمة، لا على أعلى نتيجة معيارية فقط.
في لقطة 8 سبتمبر 2026 من Intelligence Index snapshot، سجّل Fable 5.1 نتيجة 53 مقابل 47 لـ GPT-5.6 Sol. إنتاجية الإخراج متعادلة فعليًا عند 69.9 مقابل 69.8 رمز/ث. هذه النتائج تدعم قرار الجودة مقابل التكلفة؛ لكنها لا تثبت فائزًا عالميًا في السرعة.
النقاط الرئيسية
- اختر Fable 5.1 لأصعب المهام الذاتية عندما تبرر تقييماتك الداخلية السعر الأعلى.
- ابدأ بـ GPT-5.6 Sol للاستدلال الحدّي الحساس للتكلفة وللتطبيقات التي تستفيد من أدواته المدمجة.
- قارن تأخر البدء منفصلًا عن سرعة الإخراج: لدى GPT-5.6 Sol وقت وصول أقل إلى أول رمز، بينما الإنتاجية شبه متساوية.
- افصل نمذجة كتابات وقراءات واحتفاظ التخزين المؤقت وأسعار السياق الطويل. أسعار الإدخال/الإخراج العناوينية لا تصف كل أحمال الوكلاء.
تم التحقق من البيانات في 8 سبتمبر 2026. النتائج المستقلة تستخدم GPT-5.6 Sol عند أقصى جهد وFable 5.1 مع Adaptive Reasoning وMax Effort وDefault Fallback. معايير البائعين والمعايير المستقلة تستخدم إعدادات تقييم مختلفة. الأسعار بالدولار الأمريكي لكل مليون رمز (MTok) ما لم يُذكر خلاف ذلك.
GPT-5.6 Sol مقابل Fable 5.1: حكم سريع
| البعد | GPT-5.6 Sol | Claude Fable 5.1 | الخيار الأفضل |
|---|---|---|---|
| Intelligence Index المستقلة v4.3 (8 سبتمبر) | 47 | 53 | Fable 5.1 |
| Terminal-Bench 4.0 المستقلة (7 سبتمبر) | 39.9% | 52.0% | Fable 5.1 |
| Terminal-Bench 4.0 بإدارة Anthropic | 37.3% | 55.8% | Fable 5.1 |
| نافذة السياق | 1.05M | 1M | تعادل فعليًا |
| الإخراج الأقصى | 128K | 128K | تعادل |
| إدخال نص/صورة | Yes | Yes | تعادل |
| سعر الإدخال الرسمي / MTok | $4 | $10 | Sol |
| سعر الإخراج الرسمي / MTok | $20 | $50 | Sol |
| قراءة التخزين المؤقت الرسمية / MTok | $0.40 | $0.25 | Fable 5.1 |
| سرعة الإخراج المستقلة (8 سبتمبر) | 69.8 tok/s | 69.9 tok/s | تعادل فعليًا |
| سعة أدوات API | Very broad | Strong | Sol |
| العمل الذاتي طويل المدى | Excellent | Core strength | Fable 5.1 |
| الإنتاج الحساس للتكلفة | Better default | Premium escalation | Sol |
سياسة انطلاق مفيدة هي استخدام Sol للأعمال الحدّية الروتينية، مع Fable 5.1 كمسار تصعيد عندما تفشل مهمة في تجاوز حد الجودة أو الاستقلالية لديك. تحقق من صحة هذه السياسة مقابل التكلفة لكل مهمة ناجحة.
يُظهر GPT-5.6 Sol ستة مستويات لجهد الاستدلال، من none إلى max، مع medium كافتراضي. يستخدم Fable 5.1 تفكيرًا تكيفيًا دائم التشغيل؛ يتحكم effort في عمق الاستدلال، والافتراضي مرتفع.
الـ 50,000 رمز الإضافية في سياق GPT-5.6 Sol غير مرجّحة لأن تحسم معظم البنى. يصبح التسعير وإعادة استخدام التخزين المؤقت أكثر أهمية كلما اقترب الطلب من مليون رمز؛ يوضح قسم السياق الطويل أدناه السبب.
ما هو GPT-5.6 Sol؟
GPT-5.6 Sol هو طبقة عالية القدرات ضمن عائلة GPT-5.6 من OpenAI للبرمجة، والبحث، والتخطيط، وتدفقات عمل الوكلاء المتطلبة. جاذبيته الرئيسية هنا هي مزيج ضوابط الاستدلال وبيئة التنفيذ المحيطة.
من خلال Responses API، يدعم GPT-5.6 Sol حافظة أدوات أصلية واسعة: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills, وtool search. هذا يمكن أن يقلل عدد مكونات التشغيل المنفصلة التي يحتاج تطبيقك إلى دمجها.
تصف OpenAI أيضًا الاستدعاء البرمجي للأدوات والتنفيذ متعدد الوكلاء للعائلة. هذه ميزات منصة مهمة عندما يجب على النموذج تنسيق العمل عبر الأدوات بدلًا من إرجاع إجابة واحدة.
ما هو Claude Fable 5.1؟
Claude Fable 5.1 يستهدف البرمجة المتطلبة، والعمل المعرفي المهني، والبحث، والوكلاء طويلة التشغيل. نتائجه المعيارية المباشرة تجعله مرشحًا قويًا للمهام حيث يهم التعافي والمواظبة والإكمال الناجح أكثر من قِصَر الاستجابة.
تؤكد Anthropic على تنفيذ ذاتي مستدام عبر التطبيقات، بما يشمل التخطيط، والتعافي من الخطوات الفاشلة، والتواصل حول التقدم. ينبغي التعامل مع هذا التموضع كسبب لاختبار مهام أطول، وليس كضمان بأن كل تدفق عمل سينتهي بشكل صحيح.
يختلف Fable 5.1 أيضًا عن GPT-5.6 Sol في سلوك API: قيود الاختيار الإجباري للأدوات مهمة لتدفقات العمل التي تتطلب من النموذج استدعاء أداة محددة. تحقق من أوضاع tool_choice المدعومة عند ترحيل حلقة وكيل حتمية.
سؤال التكامل عملي بالتالي: هل يمكن لتطبيقك تحمل حلقة استدلال أكثر استقلالية، أم يحتاج إلى تحكم أدق بكل خطوة؟ اختبر سلوك الأدوات الدقيق قبل اختيار المسار.
مقارنة المعايير: لدى Fable 5.1 دليل مباشر أقوى
مقارنات المعايير بين الموردين المتنافسين يسهل إساءة استخدامها. تقييمات إطلاق GPT-5.6 الأصلية من OpenAI تسبق Fable 5.1، بينما إصدار Fable 5.1 من Anthropic يحتوي على مقارنات مباشرة أحدث مع GPT-5.6 Sol.
أنظف طريقة لقراءة الأدلة هي بثلاث طبقات: مقارنة Fable 5.1 المباشرة من Anthropic، والاختبارات المستقلة الحالية، وملف قدرات GPT-5.6 Sol الخاص بـ OpenAI.
نتائج Anthropic المباشرة: Fable 5.1 مقابل GPT-5.6 Sol
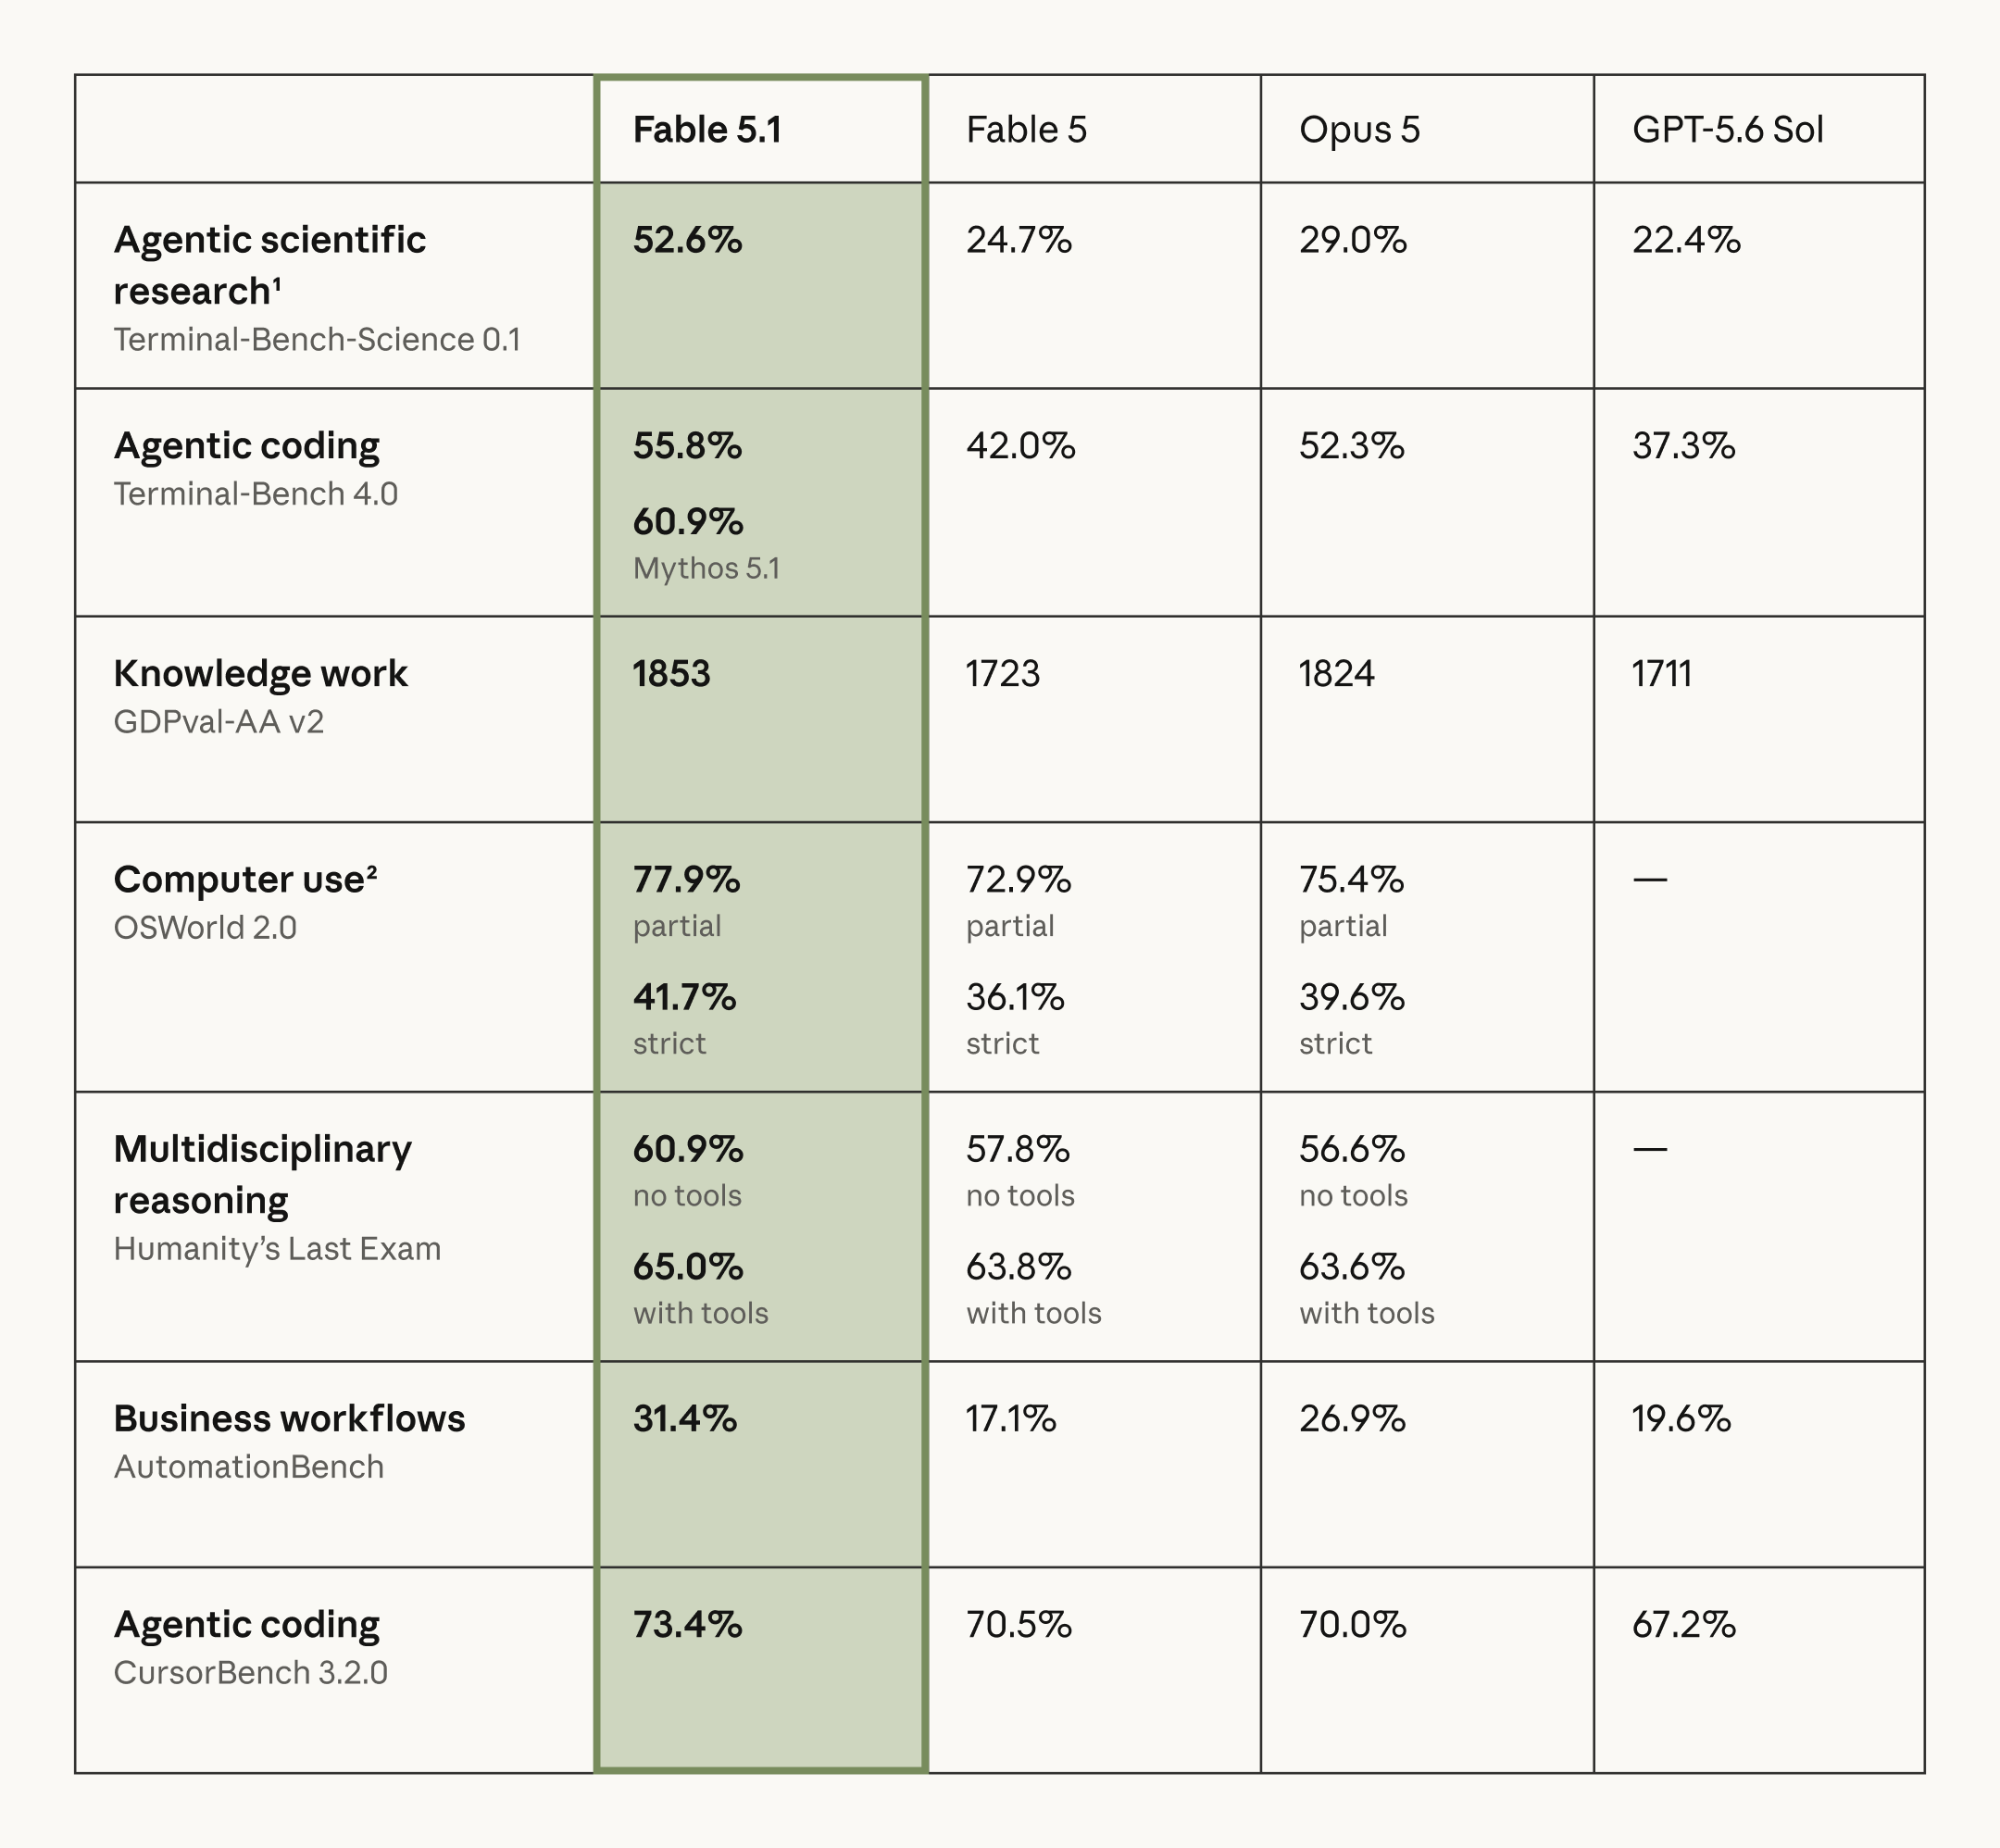
تتضمن النتائج المعيارية الرسمية خمسة مهام مع نتائج لكل نموذج. تم احتساب فروقات النقاط المئوية وفروقات Elo أدناه من تلك القيم المنشورة.
| المعيار | GPT-5.6 Sol | Claude Fable 5.1 | تفوق Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
النتيجة متسقة بشكل غير معتاد: يتقدم Fable 5.1 على GPT-5.6 Sol في كل صف مباشر نشرته Anthropic. أكبر الفروقات تظهر في البحث العلمي الوكيلي والبرمجة المعتمدة على الطرفية بدلًا من الاستدلال القصير المعتاد.
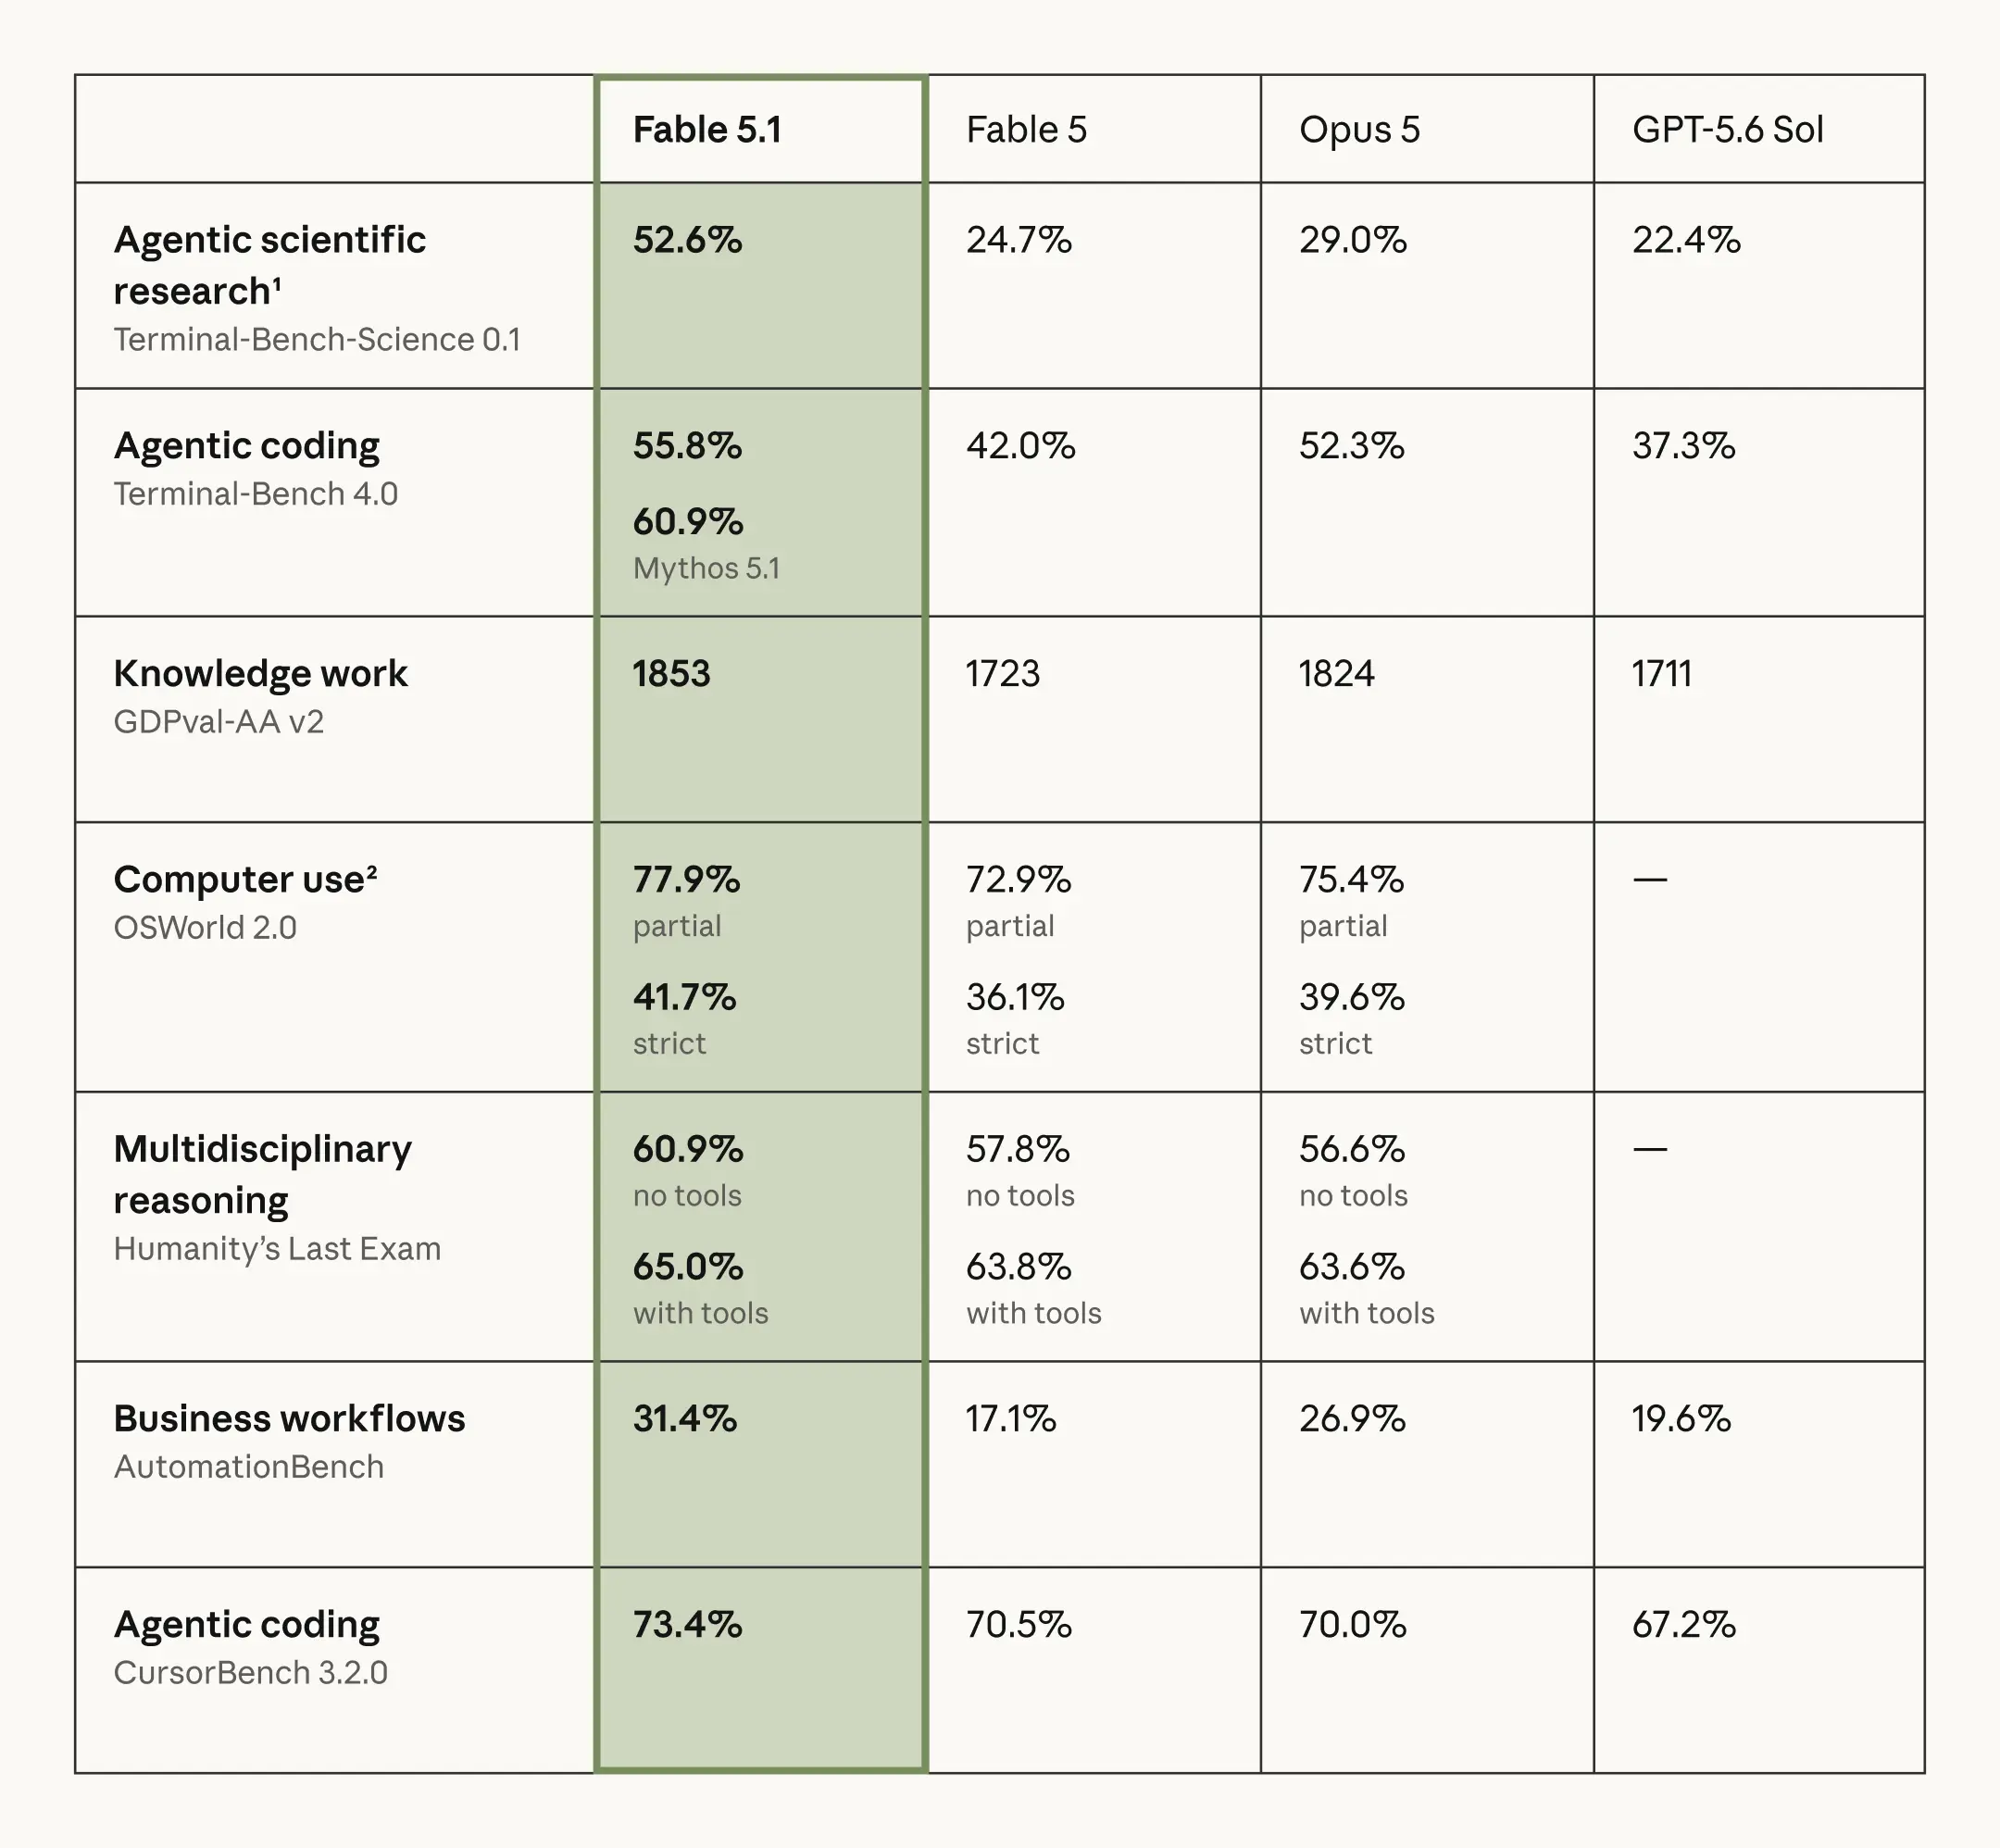
المصدر: Anthropic — الرسم البياني المعياري الأصلي.
هذه تقييمات يُجريها البائع: اختبرت Anthropic نموذجها والنموذج المنافس. توفر أدلة مقارنة مباشرة، لكنها ليست اختبارات مستقلة. تبلغ Anthropic عن خطأ معياري ±3.5–4.5 نقطة مئوية لكل نموذج على Terminal-Bench-Science؛ الجدول أعلاه يعرض تقديرات نقطية، لا فترات ثقة.
تُفضّل نتائج البائع Fable 5.1، لكن الأدلة المستقلة تحتاج تواريخها وتكويناتها الخاصة.
معايير مستقلة: افصل النتائج المؤرخة عن القياسات الحية
قدّمت Artificial Analysis Intelligence Index v4.3 في 7 سبتمبر، مستبدلة Terminal-Bench 2.1 بـ Terminal-Bench 4.0 وأضافت AutomationBench-AA. أبلغ الإصدار عن 53 لـ Fable 5.1 و47 لـ GPT-5.6 Sol، بما يطابق الأرقام المُقربة في مقارنة 8 سبتمبر. يميّز الجدول نتائج الطرفية في الإصدار عن لقطة الأداء اللاحقة.
| مقارنة مؤشر مستقل — AA / إصدار v4.3 | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | النتيجة |
|---|---|---|---|
| Intelligence Index v4.3 (8 سبتمبر) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (إصدار 7 سبتمبر) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| سرعة الإخراج (8 سبتمبر) | 69.8 tok/s | 69.9 tok/s | تعادل فعليًا |
| وقت الوصول إلى أول رمز (8 سبتمبر) | 132.10 s | 277.47 s | Sol |
| سعر AA المعياري لمزيج الرموز / MTok | $3.08 | $7.175 | Sol |
لقطة: 8 سبتمبر 2026، باستثناء صف Terminal-Bench المؤرخ في 7 سبتمبر صراحة. يستخدم Fable 5.1 إعدادات Adaptive Reasoning وMax Effort وDefault Fallback؛ يستخدم Sol أقصى جهد. القياسات الحية قابلة للتغير. يستخدم سعر مزيج الرموز المعياري من AA نسبة 7:2:1 للقراءة من التخزين المؤقت/الإدخال/الإخراج؛ ليس تكلفة كل طلب API.
OSWorld 2.0 هو أكبر تفوق مُبلّغ لـ Sol هنا: 62.6% مقابل 41.7% لـ Fable 5.1، بفارق 20.9 نقطة. هذا يوازن تفوق Fable الأقوى في Intelligence Index وTerminal-Bench.
تدعم الأدلة مقايضة محددة: لدى Fable 5.1 مؤشر ذكاء أعلى، بينما لدى Sol وقت وصول أقل إلى أول رمز وسعر معياري أقل. إنتاجية الإخراج متعادلة فعليًا. هذه القياسات تدعم اختيارات مختلفة لأعمال الدُفعات الحساسة للجودة والتطبيقات التفاعلية.
يشير مقارنة Terminal-Bench المستقلة المؤرخة إلى الاتجاه نفسه الذي أظهره اختبار Anthropic: 52.0% مقابل 39.9%، مقابل 55.8% مقابل 37.3% لدى البائع. الفجوتان غير قابلتين للاستبدال لأن إعدادات التقييم تختلف.
ما الذي تخبرنا به معايير OpenAI عن GPT-5.6 Sol حتى الآن
توفر تقييمات إطلاق OpenAI سياقًا إضافيًا لقدرات GPT-5.6 Sol. تسبق النتائج المباشرة الأحدث المذكورة أعلاه، لذا لا ينبغي استخدامها كمقارنة مباشرة مع Fable 5.1.
تُبلغ OpenAI عن 88.8% على Terminal-Bench 2.1 لـ GPT-5.6 Sol. هذا دليل على قدرة قوية للبرمجة الوكيلية ضمن إعداد الإطلاق؛ لا ينبغي مقارنة نسخة المعيار الأقدم رقميًا بنتائج Terminal-Bench 4.0.
GPT-5.6 Sol مقابل Fable 5.1 في البرمجة
بالنسبة لتوليد الشيفرة المباشر، كلا النموذجين يتجاوز احتياجات العديد من أعباء الإنتاج. يتضح الفصل أكثر عندما تتحول البرمجة إلى هندسة برمجيات وكيلية: تفحّص مستودع كبير، تعديل عدة ملفات، تشغيل أوامر، تشخيص الإخفاقات، كتابة اختبارات، والتكرار حتى تنجح المهمة.
هنا، لدى Claude Fable 5.1 حالة معيارية أقوى حاليًا. يتصدر كلًا من مقارنة Terminal-Bench 4.0 بإدارة البائع والمقارنة المستقلة، كما أن نتيجة Anthropic على CursorBench تفضّله أيضًا 73.4% مقابل 67.2%.
لتقييم عملي للبرمجة، ضُمّن تغييرات على مستوى المستودع، واختبارات، ومراجعة، وعمل الأداء. مقطع شيفرة قصير ناجح هو وكيل ضعيف لإتمام مهمة تمتد عبر عدة ملفات ومحاولات فاشلة.
يبقى GPT-5.6 Sol جذابًا عندما تهم بيئة التنفيذ المحيطة بقدر جودة النموذج الخام. الدعم الأصلي لتنفيذ shell وapply-patch وcode interpreter وبحث الملفات واستخدام الحاسوب وMCP وskills وtool search يمكن أن يقلل من بنية التنسيق التي تحتاج إلى بنائها.
حكم البرمجة: اختر Fable 5.1 عندما تؤكد تقييماتك أصعب الأعمال المستقلة على مستوى المستودع. اختر GPT-5.6 Sol عندما تكون قدرة معيارية أقل قليلًا مقبولة مقابل تكلفة أقل وحزمة تنفيذ مدمجة واسعة.
ضوابط الاستدلال وتجربة المطور
تعرض واجهتا البرمجة الذكاء بطرق مختلفة.
نطاق الجهد من none إلى max في Sol يسمح للفريق باختبار الجودة والتأخير عند عدة إعدادات. يمكن أن يقلل الجهد الأقل من عمل الاستدلال، لكن الإعداد المناسب يعتمد على تكلفة فشل المهمة.
يجعل التفكير التكيفي دائم التشغيل في Fable ضبط الجهد تمرينًا مختلفًا. قارن الإعدادات التي سينشرها تطبيقك بدلًا من اعتبار تسميات الجهد المتطابقة ميزانيات حساب متطابقة.
لا توجد بالتالي مقارنة عادلة عالمية بين "Sol الافتراضي" و"Fable الافتراضي". تختلف إعدادات الاستدلال الافتراضية لديهما. ينبغي أن تقارن التقييمات الإنتاجية إما ميزانيات جهد مكافئة أو الإعدادات الدقيقة التي سيعتمدها تطبيقك بالفعل.
GPT-5.6 Sol مقابل Fable 5.1:أيّهما أفضل لوكلاء الذكاء الاصطناعي؟
يعتمد الاختيار على ما إذا كان عنق الزجاجة هو الاستدلال الصعب أم بيئة التشغيل المحيطة به.
تفوق Fable في اختبارات الطرفية والأتمتة والعمل المهني المذكورة يجعله مرشحًا منطقيًا لأصعب المهام. قِس نسبة الإكمال والقدرة على التعافي من الخطوات الفاشلة قبل تعميم ذلك التفوق على وكيلك.
تجعل حافظة أدوات Responses الموثّقة من GPT-5.6 Sol جذّابة للتطبيقات المبنية حول البحث والملفات وتنفيذ shell والرقع. هذا ميزة تكامل ينبغي تقييمها جنبًا إلى جنب مع دقة المهمة، لا كبديل عنها.
| متطلبات الوكيل | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| استدلال صعب بعيد المدى | Excellent | Best fit |
| استقلالية طرفية/مستودع | Excellent | Stronger evidence |
| حافظة أدوات مدمجة أصلية | Stronger | Strong |
| اختيار أداة قسري | Supported; check chosen API | Restricted; check tool_choice modes |
| تكامل منصة متعددة الوكلاء | Strong advantage | Available through agent architecture |
| تواصل التقدم خلال مهام طويلة | Good | Core behavior |
| وكلاء عالية الحجم حساسة للتكلفة | Better | Premium |
| سياق ضخم متكرر من التخزين المؤقت | Good | Potentially very attractive |
قد يكون استخدام كليهما اقتصاديًا عندما يحتاج جزء صغير فقط من المهام للتصعيد. قِس ما إذا كانت الإكمالات الإضافية تعوّض السعر الأعلى وتأخر البدء للنموذج الثاني.
السياق الطويل: 1.05M مقابل 1M ليس الفرق المهم
الأرقام العنوانية تبدو متطابقة تقريبًا: يقدم GPT-5.6 Sol عدد 1.05M رمزًا وFable يقدم 1M. فرق سعة 5% غير مرجّح لأن يحدد ما إذا كان بإمكانك تحليل مستودع كبير أو متن قانوني أو أرشيف بحثي أو سجل وكيل لعدة ساعات. كلاهما بالفعل ضمن فئة المليون رمز.
بالنسبة لـ GPT-5.6 Sol، يؤدي إدخال يتجاوز 272K إلى أسعار سياق طويل أعلى للطلب: $8/MTok للإدخال، $0.80/MTok لقراءة التخزين المؤقت، و$30/MTok للإخراج. ترتفع كتابات التخزين المؤقت أيضًا من $5 إلى $10/MTok.
يحافظ Fable 5.1 على أسعاره القياسية لسياق 1M: $10/MTok للإدخال، $50/MTok للإخراج، و$0.25/MTok لقراءات التخزين المؤقت. لا توجد تسعيرة مميزة منفصلة فوق 272K في هذا الإعداد الموثّق.
اعتبر دورة تحتوي على 100K رمز إدخال غير مخزّن مؤقتًا، و900K رمز قراءة من التخزين المؤقت، و20K رمز إخراج مُفوتر. تكلفة GPT-5.6 Sol هي 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. تكلفة Fable 5.1 هي 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
هذه الدورة الثقيلة على التخزين المؤقت تكاد تُغلق فجوة السعر لأن لدى Fable قراءات تخزين مؤقت أرخص. النتيجة تعتمد على مزيج الرموز لأعباء العمل؛ لا يعني ذلك أن النموذجين يكلفان الشيء نفسه لجلسة وكيل كاملة.
افتراضات التكلفة: بادئة 900K رمز مخزّنة مؤقتًا بالفعل، و100K إدخال جديد غير مُفوترة ككتابة تخزين مؤقت جديدة. التقدير يستثني الكتابة الأولية للتخزين المؤقت ورسوم الأدوات. بدل 20K للإخراج يشمل كل الإخراج المُفوتر، بما في ذلك رموز الاستدلال المُفوترة إن وُجدت.
التسعير: Sol يفوز في الأحمال العادية، وFable يفوز في مقياس مهم للتخزين المؤقت
بالأسعار المُتحقَّق منها، يكلف Sol $4 إدخال / $20 إخراج لكل MTok، مع $0.40 لقراءة التخزين المؤقت. يكلف Fable 5.1 $10 للإدخال، و$50 للإخراج، و$0.25 لقراءة التخزين المؤقت. يفصل الجدول بين أسعار المزود والـ GPT-5.6 Sol API في CometAPI وأسعار Claude Fable 5.1 API في CometAPI.
| مكوّن السعر | أسعار GPT-5.6 Sol الرسمية | أسعار Claude Fable 5.1 الرسمية |
|---|---|---|
| الإدخال الرسمي / MTok | $4.00 | $10.00 |
| الإخراج الرسمي / MTok | $20.00 | $50.00 |
| قراءة التخزين المؤقت الرسمية / MTok | $0.40 | $0.25 |
| كتابة التخزين المؤقت الرسمية / MTok | $5.00 (30 minutes) | $12.50 (5 minutes) |
| فوق 272K إدخال: إدخال / قراءة مخزّن / كتابة مخزّن / إخراج | $8 / $0.80 / $10 / $30 | نفس الأسعار الأساسية الموثّقة |
| CometAPI الإدخال / MTok | $3.20 | $8.00 |
| CometAPI الإخراج / MTok | $16.00 | $40.00 |
تختلف مدد كتابة التخزين المؤقت: يستخدم Sol فترة احتفاظ افتراضية 30 دقيقة، بينما السعر المعروض لـ Fable 5.1 هو لكتابة 5 دقائق. تحقق من إنشاء التخزين المؤقت وتجديده وانقضائه للمزود والمسار اللذين تستخدمهما فعليًا.
بالأسعار المباشرة المُتحقَّق منها، يكلف Fable 5.1 ما يعادل 2.5× تكلفة Sol لكل من الإدخال غير المخزّن مؤقتًا ($10 مقابل $4/MTok) والإخراج ($50 مقابل $20/MTok). تعامل مع هذه الأسعار ك مقارنة مؤرخة، إذ يمكن أن تتغير عروض المزودين وأسعار البوابات.
طلب سياق قصير مع 100K إدخال و10K إخراج مُفوتر إجمالًا يكلف حوالي $0.60 مع Sol أو $1.50 مع Fable بحسب أسعار المزود المباشر. بالأسعار المعروضة في CometAPI أعلاه، يكلف المزيج نفسه $0.48 أو $1.20. هذه الأمثلة تستثني كتابات التخزين المؤقت ورسوم الأدوات.
سعر قراءة التخزين المؤقت لسياق قصير لدى Fable أقل بنسبة 37.5%: ($0.40 − $0.25) ÷ $0.40. قد يهم ذلك للوكلاء الذين يعيدون استخدام بادئة كبيرة ثابتة، لكن التوفير الإجمالي لا يزال يعتمد على الإدخال الجديد وتواتر الكتابة وحجم الإخراج.
حكم التسعير: Sol هو نقطة الانطلاق الأرخص لحركة السياق الجديد. يصبح Fable أكثر تنافسية مع ازدياد حصة قراءات التخزين المؤقت؛ قارن تكلفة الجلسة الكاملة، بما في ذلك إنشاء وتجديد التخزين المؤقت.
السرعة والزمن
اختبارات أقصى جهد قد تقضي وقتًا كبيرًا في الاستدلال قبل أول رمز مرئي.
تُظهر قياسات الإنتاجية والزمن في 8 سبتمبر 69.9 رمز/ث للإخراج لدى Fable و69.8 لدى Sol. وقت الوصول إلى أول رمز هو 277.47 ثانية مقابل 132.10 ثانية. إنتاجية الإخراج متساوية عمليًا؛ يبدأ Sol بإخراج مرئي أسرع في هذا الإعداد.
هذه قياسات معيارية عند أقصى جهد، وليست زمنًا موعودًا لكل استدعاء API. يمكن لطول الموجه، وإعدادات الاستدلال، وحمل المزود، والأدوات، وحالة التخزين المؤقت أن تغيّر النتيجة. وقت الوصول إلى أول رمز وزمن الاستجابة الكامل مقياسان مختلفان.
للعمل التفاعلي، قد يُفضَّل Sol بسبب تأخر البدء الأقل الملحوظ. لأعمال البحث غير التزامنية أو العمل الليلي على المستودعات، قد يهم الإكمال الناجح أكثر من انتظار أول رمز. قارن النموذجين على الإعدادات والتزامن اللذين تنوي نشرهما.
الضوابط والحماية اختلاف إنتاجي
تطبق كلا النماذجين ضوابط حماية أقوى لأن قدراتهما تمتد إلى مجالات الأمن السيبراني والعلوم الحساسة، لكنهما يطبقانها بطرق مختلفة.
تصف OpenAI حمايات متعددة الطبقات ورصدًا لعائلة GPT-5.6. ينبغي للتطبيقات في المجالات الحساسة تقييم الضوابط ذات الصلة كجزء من سلوك النشر.
تصف شروط Anthropic حول إعادة التوجيه والاحتفاظ إعادة توجيه بعض طلبات الأمن السيبراني أو الأحياء الحساسة إلى نماذج أقل قدرة، دون احتساب سعر Fable لتلك الطلبات المعاد توجيهها. فترة الاحتفاظ الافتراضية للبيانات هي 30 يومًا، مع استثناءات لترتيبات المؤسسات المؤهلة.
بالنسبة للبرمجة العادية والعمل المعرفي، قد لا تظهر هذه الاختلافات إطلاقًا. بالنسبة لمنتجات الأمن، والأحمال الخاضعة للتنظيم، أو النشرات الحساسة للخصوصية، تنتمي إلى قائمة التقييم جنبًا إلى جنب مع جودة المعيار والسعر.
أي نموذج يجب أن تختار؟
يمكن اختزال المقارنة العامة إلى شكل عبء العمل.
| عبء العمل | GPT-5.6 Sol | Claude Fable 5.1 | التوصية |
|---|---|---|---|
| برمجة ذاتية صعبة | Excellent | Stronger current benchmarks | Fable 5.1 |
| بحث بعيد المدى | Excellent | Core strength | Fable 5.1 |
| واجهة API عالية الحجم | Much cheaper | Expensive | Sol |
| مساعد برمجة تفاعلي | Lower measured max-effort TTFT | Higher measured max-effort TTFT | اختبر الإعدادات المنشورة |
| وكيل API كثيف الأدوات | Broader native tool stack | Strong | Sol |
| وكيل بسياق مليون رمز مخزَّن | Competitive | Very low cache-read price | اختبر كليهما |
| أقصى جودة استدلال | Excellent | Independent lead | Fable 5.1 |
| تكلفة الطلبات الاعتيادية | Clear advantage | Premium | Sol |
| استدلال الصور/المستندات | Strong | Strong | اختبر على عبء العمل |
| حزمة موحّدة لمزوّد OpenAI | Natural fit | Requires migration/gateway | Sol |
| توجيه مستقل عن النموذج | Strong | Strong | استخدم كليهما عبر CometAPI |
يجب أن تستحق سياسة التوجيه تعقيدها. قارن خط أساس من نموذج واحد مع سياسة تبدأ بـ Sol وتُصعّد المهام الصعبة إلى Fable 5.1، واحتفظ بالموجّه فقط إذا حسّنت الجودة أو التكلفة لكل مهمة ناجحة.
كيف تقارن GPT-5.6 Sol وFable 5.1 عبر CometAPI
يدمج CometAPI بالفعل GPT-5.6 Sol وClaude Fable 5.1. وصّل كلا النموذجين بتنسيق الطلب الأصلي الخاص بهما، وأرسل مجموعة التقييم نفسها، وقارن النتائج المُعادة تحت إعدادات متطابقة.
استخدم طلبات بالتنسيق الأصلي لكل نموذج واثبت الموجّهات، ومجموعات البيانات، وإعدادات الجهد، والتزامن، وقواعد التقييم. كرر التشغيل؛ طلب واحد متسلسل لكل نموذج لا يكفي لتقدير زمني أو جودة موثوقين.
لتقييم إنتاجي، استخدم مجموعة موجهات ثابتة، وكرر التشغيل بالتناوب، وسجّل إعداد الجهد، وقيّم الصحة، ونسبة اجتياز الاختبارات، ونجاح الأدوات، والمحاولات، واستخدام الرموز، والوقت المنقضي، والتكلفة الإجمالية لكل مهمة ناجحة. قم بضبط كل نموذج على حدة بعد خط الأساس المشترك.
الحكم النهائي: GPT-5.6 Sol أم Claude Fable 5.1؟
لدى Fable 5.1 دليل مباشر أقوى لأصعب البرمجة الذاتية والعمل بعيد المدى. يتصدر الصفوف الخمسة المشتركة في معيار البائع والمقارنة الطرفية المستقلة المؤرخة. هذا يجعله مسار تصعيد قويًا، رهنًا بالتحقق على مهامك الخاصة.
يمتلك Sol أسعار رموز عادية أقل، وضوابط جهد أدق، وحزمة أدوات أصلية واسعة. في الإعداد المستقل المُتحقق منه عند أقصى جهد، لديه أيضًا وقت وصول أقل إلى أول رمز؛ إنتاجية الإخراج متعادلة فعليًا.
قدّم أولوية لـ Fable 5.1 عندما تحدد أصعب المهام الذاتية معدل نجاحك. ابدأ بـ Sol للاستدلال الحدّي الحساس للتكلفة أو التطبيقات كثيفة الأدوات. لأعباء العمل التفاعلية، اختبر إعدادات الجهد المنشورة لتأكيد ما إذا كانت ميزة تأخر البدء الملحوظة مستمرة.
اختر نموذجًا واحدًا عندما يلبّي متطلباتك ببساطة. أضف التوجيه عندما تُظهر نتائج التقييم أن التبديل بين الاثنين يحسّن الجودة أو التكلفة لكل مهمة ناجحة.
الأسئلة الشائعة
هل Claude Fable 5.1 أفضل من GPT-5.6 Sol؟
لديه Intelligence Index مستقل أعلى في لقطة 8 سبتمبر: 53 مقابل 47 لـ Sol. كما يتصدر الاختبار الطرفي المستقل المؤرخ. هذا يدعم أفضلية جودة على هذه التقييمات، لا ادعاء بأنه أفضل لكل عبء عمل.
هل GPT-5.6 Sol أرخص من Claude Fable 5.1؟
للحركة الاعتيادية غير المخزّنة مؤقتًا عبر API، نعم: أسعار المزود المباشر المتحقَّق منها هي $4/$20 لكل MTok لـ Sol و$10/$50 لـ Fable 5.1. يمكن أن تضيق الفجوة في الأحمال الثقيلة على التخزين المؤقت لأن سعر قراءة التخزين المؤقت لدى Fable أقل. ضمّن سلوك الكتابة والانقضاء في التقدير.
أي نموذج أفضل للبرمجة؟
لدى Fable 5.1 دليل معياري أقوى للبرمجة الذاتية في هذه المقارنة. يبقى Sol جذابًا لتدفقات العمل الأقل تكلفة ولأدوات التنفيذ المدمجة. استخدم مهام مستودع مع اختبارات قابلة للتشغيل لتقرر ما إذا كانت فجوة القدرة المقاسة تهم تطبيقك.
أي نموذج لديه نافذة سياق أكبر؟
Sol يتقدم تقنيًا عند 1.05M مقابل 1M رمز لـ Fable 5.1، بينما يسمح كلاهما حتى 128K إخراج. عمليًا، عتبة تسعير >272K لدى Sol وسعر قراءات التخزين المؤقت المنخفض لدى Fable عادة أكثر أهمية من فارق 50K سعة.
هل يمكنني الوصول إلى كلا النموذجين عبر CometAPI؟
نعم. يدعم GPT-5.6 Sol API في CometAPI وClaude Fable 5.1 API في CometAPI نقطة انطلاق مشتركة لتقييمات النص. تحقق من إعدادات الاستدلال والتخزين المؤقت والدعم الأداتي الخاصة بالمسار قبل توسيع خط الأساس إلى وكيل إنتاجي.