كيفية نشر Kimi K3.1 Pro محليًا: متطلبات الأجهزة، إعداد vLLM
تعلّم كيفية الاستضافة الذاتية لـ Kimi K3.1 Pro باستخدام vLLM، والتحقق من متطلبات GPU، وتنزيل الأوزان، واختبار الاستدلال، ومقارنة النشر المحلي بالوصول عبر واجهة برمجة التطبيقات.
انشر Kimi K3.1 Pro على خادم Linux مزود بوحدات GPU، ثم وصّل تطبيقاً محلياً بنقطة الاستدلال الخاصة به. يوضح هذا الدليل استخدام عقدة واحدة تحتوي على ثماني وحدات GPU من NVIDIA B300 مع vLLM. ستحتاج إلى وصول عبر shell إلى الخادم، وتعريفات متوافقة، ومساحة تخزين لكامل نقطة التحقق. ابدأ بإتمام طلب نصي قصير واحد قبل اختبار المدخلات الأطول أو تدفقات وكيل الأدوات.
في حال عدم توفر وحدات GPU مناسبة، يمكنك تشغيل تطبيقك محلياً وربطه بـ API الرسمي لـ Kimi أو مزود طرف ثالث مثل CometAPI.
أهم النقاط
المعاملات النشطة البالغة 104B لا تعكس متطلبات التخزين الكاملة للنموذج.
تمت المراجعة للوضوح ودقة المصدر ومصطلحات API الحالية.
نقطة استدلال عاملة لا تتضمن تلقائياً متصفحاً أو صندوق كود أو بيئة وكيل مكتملة.
قارن الاستضافة الذاتية والوصول عبر API وفق تكلفة كل مهمة ناجحة، شاملاً إعادة المحاولات والصيانة.
ما هو Kimi K3.1 Pro؟
Kimi K3.1 Pro هو نموذج متعدد الوسائط مفتوح الأوزان من Moonshot AI لأغراض البرمجة وتحليل الوثائق واستخدام الأدوات. المواصفات الرئيسية أدناه مستندة إلى بطاقة النموذج الرسمية .
المواصفة
الإعداد المنشور
المعمارية
MoE؛ 2.8T معامل إجمالي، 104B نشطة
الانتباه
93 طبقة: 69 KDA + 24 Gated DSA
الخبراء
896 موجّه؛ 16 يتم اختيارها لكل رمز؛ 2 مشتركة
السياق
1,048,576 رمز
المدخلات
نصوص وصور؛ محول MoonViT-V2 للرؤية
التكميم
MXFP4 للأوزان / MXFP8 للتنشيطات؛ نقطة تحقق مختلطة الدقة
المحركات الموصى بها
vLLM، SGLang، TokenSpeed
يفعّل النموذج 104B معاملات لكل رمز، لكن النشر لا يزال يتطلب نقطة التحقق الكاملة ذات 2.8T من المعاملات. يجب أن يدعم محرك الاستدلال طبقات KDA وGated DSA وتكميم MXFP4.
ما العتاد المطلوب لتشغيل Kimi K3.1 Pro محلياً؟
يلخص الجدول أدناه تكوينات vLLM ذات الصلة بهذا الدليل. يستخدم هذا الشرح عقدة B300 واحدة بثماني وحدات GPU؛ عمليات النشر على GB300 وAMD تتطلب تكويناتها المقابلة.
العتاد
المسار الموثق
ملاحظات التخطيط
NVIDIA B300
عقدة واحدة بثماني وحدات GPU، TP8
خط الأساس للشرح أدناه
NVIDIA GB300
ثماني وحدات GPU عبر صينيتين، TP8
يتطلب تهيئة متعددة العقد وإعداد الروابط البينية
AMD MI355X
عقدة بثماني وحدات GPU مع إعداد خاص بـ AMD
استخدم مسار ROCm/AITER؛ لا تعِد استخدام بيئة NVIDIA
وحدة GPU استهلاكية 24–32 GB
غير كافية لتحميل نقطة التحقق الكاملة مباشرة
ليست هدفاً عملياً لهذا الدليل
لأغراض القياس فقط، ستشغل معاملات 2.8T تقريباً 5.6 تيرابايت عند BF16، أو 2.8 تيرابايت عند ثمانية بتات، أو 1.4 تيرابايت عند أربعة بتات مثالية. هذه حسابات تخزين معاملات خام، وليست أحجام نقاط تحقق فعلية أو حد أدنى لذاكرة VRAM أثناء التشغيل. تؤثر الدقة المختلطة والبيانات الوصفية على حجم الملف؛ كما تزيد ذاكرة التخزين المؤقت وتخصيصات وقت التشغيل من متطلبات الخدمة.
احجز سعة NVMe للتحميل الكامل، والملفات المؤقتة، ونسخة للعودة للخلف. في الأنظمة متعددة العقد، تحقق من الاتصال قبل تحميل النموذج.
كيفية نشر Kimi K3.1 Pro
استخدم الاستضافة الذاتية إذا كان لديك عتاد مناسب؛ وإلا فابدأ بـ API مستضاف. تتبع الخطوات أدناه استخدام vLLM، مع SGLang كبديل في نهاية هذا القسم. قارن تكاليف الاستضافة بعد حصولك على طلب عامل.
شغّل أوامر الإعداد والتحميل والتشغيل والتحقق الأولي في shell Bash على خادم GPU. إذا كنت تعمل من حاسوب محمول، اتصل بذلك الخادم عبر SSH أولاً. يمكن للعميل Python أن يعمل لاحقاً على أي من الجهازين باستخدام تعليمات الاتصال أدناه.
يتبع هذا الشرح وصفة النشر الرسمية؛ لم يتم اختباره بشكل مستقل لهذا المقال.
1. تحقق من رؤية وحدات GPU والتخزين والاتصال
ابدأ بفحوصات البنية التحتية الأساسية:
nvidia-smi
nvidia-smi topo -m
df -h
تأكد من أن جميع وحدات GPU المستهدفة مرئية وأن دليل النموذج يمتلك مساحة كافية. احجز مساحة إضافية لذاكرات التحميل المؤقتة والسجلات وإصدارات نقاط التحقق المستقبلية.
لعمليات النشر متعددة العقد، تحقق من الاتصال بين العقد قبل محاولة تشغيل النموذج.
اجعل الإنجاز الأول محدوداً: حمّل نقطة التحقق وأتمّ طلب نصي قصير واحد. هذا يجعل إخفاقات التشغيل أسهل تشخيصاً.
2. جهّز بيئة الخدمة
استخدم مضيف Linux مع ثماني وحدات GPU من B300 لهذا المثال أحادي العقدة. في بيئة CUDA المتوافقة مع الوصفة المنشورة، أنشئ بيئة معزولة وثبّت أدوات الخدمة:
الحد الأدنى للإصدار لا يضمن التوافق مع كل تعريف أو حزمة. إذا تطلبت وصفة العتاد حاوية أو بناءً مخصصاً، فاستخدم تلك البيئة بدلاً من ذلك. ثبّت الإصدار الذي نجح في اختباراتك قبل الإنتاج.
احتفظ بملفات الإعداد والمحلل اللغوي ومعالج الرؤية وفهارس الأوزان جنباً إلى جنب مع شرائح الأوزان. نسخ ملفات موتر محددة فقط قد يترك عملية النشر غير مكتملة.
لعمليات نشر إنتاجية قابلة لإعادة الاستنساخ، سجّل وثبّت إصدار المستودع الذي تحققت منه. راجع رخصة المستودع المخصصة قبل الاستخدام التجاري.
4. شغّل خادم vLLM
تحدد الوصفة الرسمية أن الإصدار 0.34.0 من vLLM أو أحدث مطلوب. ابدأ بـ إعداد البيئة الخاص بالعتاد، ثم ثبّت الإصدار والاعتمادات التي اجتازت اختباراتك.
بعد إعداد البيئة، استخدم الأمر الأساسي التالي. يبدأ هذا الأمر توازياً موتركياً بثمانية أجزاء ويحدد نافذة السياق الأولية إلى 32,768 رمزاً:
اسم kimi-local هو اسم مستعار موجه للتطبيق. استخدم الاسم نفسه في الطلبات اللاحقة.
إعداد 32,768 رمزاً هو نقطة بداية متحفظة لهذا الشرح، وليس أقصى سياق مدعوم للنموذج.
الخيار --trust-remote-code يسمح بتحميل كود مخصص من المستودع. اقترنه بمراجعة وإصدار مثبت لنقطة التحقق.
تشير 127.0.0.1 هنا إلى الجهاز الذي يشغّل العميل. تعمل اختبارات curl أدناه على خادم GPU، حيث تصل إلى عملية الاستدلال. لاستخدام عميل Python من حاسوبك المحمول، افتح نفق SSH في نافذة طرفية منفصلة على الحاسوب المحمول وأبقِه قيد التشغيل:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
استبدل user@gpu-server بمعلومات تسجيل الدخول لخادمك وعنوانه. مع هذا النفق، يمكن لعميل الحاسوب المحمول استخدام http://127.0.0.1:8000/v1. إذا كان المنفذ 8000 مشغولاً على الحاسوب المحمول، اختر منفذاً محلياً مختلفاً وحدّث عنوان العميل.
قيمة finish_reason التي تشير إلى ما إذا كان التوليد قد اكتمل أو وصل إلى حدّه.
أخطاء ذاكرة GPU أو عمليات غير مدعومة.
قد يستهلك الاستدلال جزءاً من ميزانية التوليد. إذا وصل الطلب إلى حدّه قبل إنتاج إجابة نهائية، زد الميزانية وأعد المحاولة قبل الاستنتاج بأن الخادم غير عامل.
6. وصّل تطبيق Python محلي
python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Write a Python function that removes duplicate filenames while preserving order."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
القيمة EMPTY هي عنصر نائب لهذا الخادم المحلي بدون مصادقة بمفتاح API. استخدم بيانات اعتمادك المضبوطة لنقطة نهاية موثقة. تحقق من إدخال الصور وتنفيذ الأدوات بشكل منفصل قبل ربط وكيل.
بديل SGLang
بالنسبة إلى SGLang، استخدم الوصفة الرسمية الخاصة بالعتاد. اختر B300 وUnified وLow-Latency (TP8) لأقرب تطابق مع هذا الشرح أحادي العقدة. تحقق من حالة التحقق المعروضة؛ فالتكوين المُولّد ليس بالضرورة تكويناً مجرباً.
على خادم GPU، ثبّت Docker واضبط NVIDIA Container Toolkit، ثم أنشئ حاوية مع تركيب نقطة التحقق المحمّلة على /models/Kimi-K3.1-Pro. أوقف vLLM أولاً حتى لا يتنافس المحركان على وحدات GPU ذاتها.
داخل الحاوية، الصق أمر التشغيل الكامل الذي ينتجه كتاب الوصفات لتكوينك المختار. استبدل مسار النموذج بـ /models/Kimi-K3.1-Pro، واضبط المضيف إلى 0.0.0.0 والمنفذ إلى 30000، واحتفظ بالأعلام الخاصة بالعتاد. يجب أن تستمع الحاوية على واجهتها الشبكية كي يعمل تحويل المنافذ في Docker؛ يبقى المنفذ على جانب المضيف مقيداً بالحلقة المحلية. انتظر رسالة جهوزية الخدمة قبل الاختبار.
في shell ثانية على خادم GPU، اعرض النموذج المُقدَّم، ثم أرسل طلباً باستخدام معرف النموذج الدقيق المُعاد:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Explain database indexes in three sentences.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
ينبغي أن تحتوي الاستجابة الناجحة على إجابة نهائية. إذا فشل البدء، افحص سجلات الحاوية وتأكد من أن وصفة العتاد والصورة المحددتين متطابقتان. للوصول من الحاسوب المحمول، استخدم نمط نفق SSH نفسه مع المنفذ 30000. راجع دليل تثبيت Docker لـ SGLang لمتطلبات الحاوية.
كيف يؤدي Kimi K3.1 Pro عبر المقاييس؟
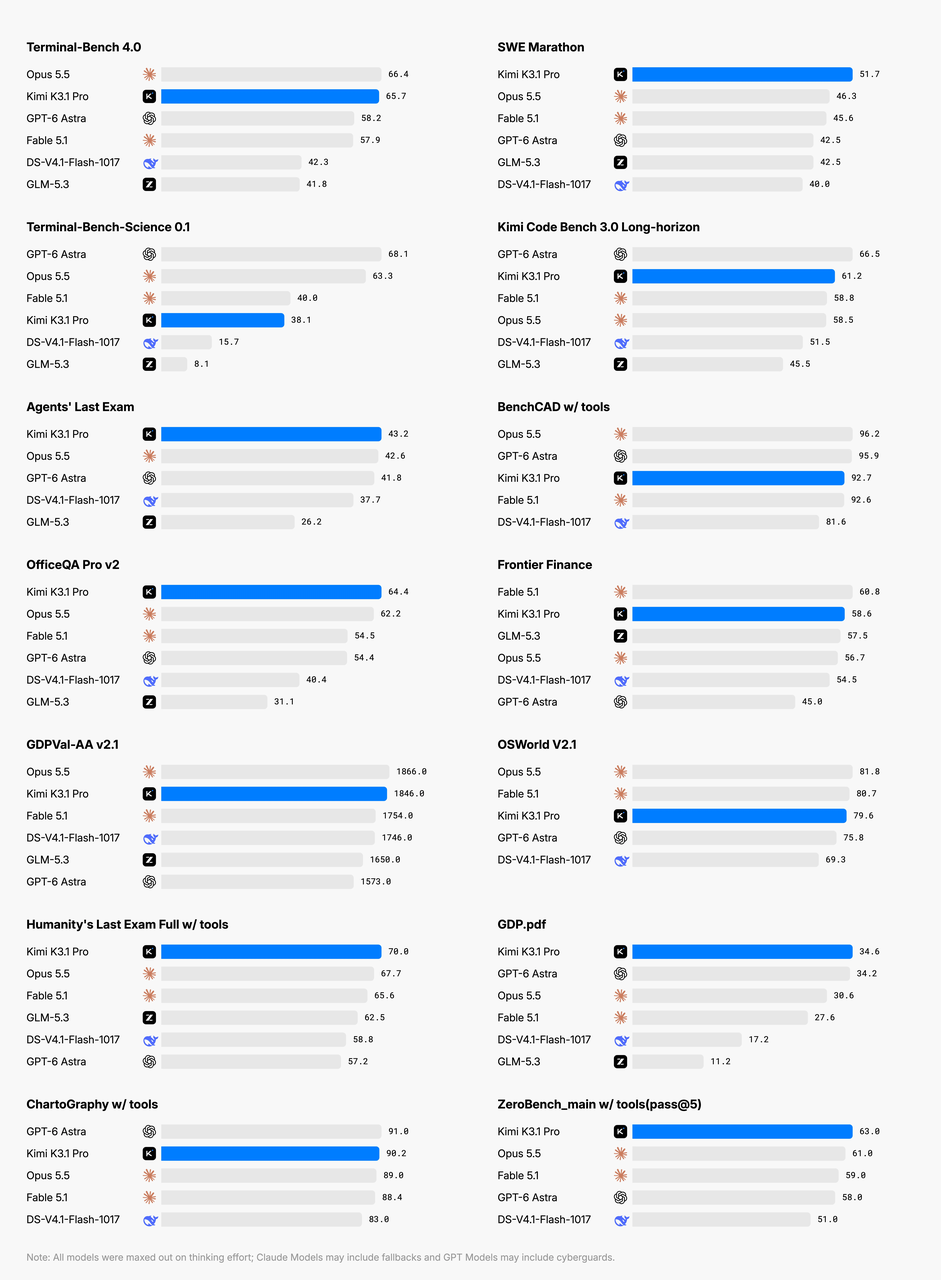
استخدم نتائج التقييم الرسمية أدناه لاختيار المهام لاختبار نشرِك. تصف هذه الدرجات إعداد التقييم المنشور؛ وهي لا تقيس الخادم المحلي المكوَّن في هذا الدليل.
يعرض الجدول التالي نتائج مختارة ومواقعها ضمن مجموعة المقارنة المنشورة في بطاقة النموذج.
المعيار والنتائج الرسمية
درجة النموذج
الترتيب ضمن تلك المقارنة
Terminal-Bench 4.0
65.7
الثاني
SWE Marathon v1.1
51.7
الأول
Program Bench
31.5
الرابع
OfficeQA Pro v2
64.4
الأول بين النتائج المبلغ عنها
Frontier Finance
58.6
الثاني
تدعم النتائج اختبار النموذج للمهام الهندسية الممتدة وتدفقات الوثائق. يتصدر Kimi K3.1 Pro هذه المقارنة على SWE Marathon لكنه يحتل المرتبة الرابعة على ProgramBench، ما يجعل كليهما مرشحين مفيدين للاختبارات الخاصة بالتطبيق.
هذه المواقع محسوبة ضمن جدول المقارنة الرسمي، وليست لوحة صدارة عالمية حية. تختلف أطر التقييم والأدوات وميزانيات الاستدلال واختيار العينات بين المقاييس.
للقرار المتعلق بالنشر، ابن مجموعة تقييم صغيرة من أعمال فعلية: إصلاحات مستودعات، أسئلة عبر وثائق متعددة، ومهام أدوات متعددة الخطوات. قم بقياس جودة الإتمام، وتصحيحات البشر، والوقت المنقضي. الدرجات المنشورة مفيدة للاختصار؛ أما اختبارات التطبيق فتحدد ما إذا كان النشر مجدياً.
كيف يمكنك تحسين استدلال Kimi K3.1 Pro المحلي؟
ضبط السياق والتواقت
بعد نجاح الطلبات القصيرة، اختبر مستندات أطول، صوراً، محادثات متعددة الأدوار، واستدعاءات أدوات بشكل منفصل.
تابع زمن أول رمز، وعدد الرموز في الثانية، وذروة ذاكرة GPU عند طول السياق والتواقت المقصودين. سجّل أيضاً نجاح المهام وتكلفة كل مهمة ناجحة، حتى لا تخفي المخرجات الأسرع المزيد من إعادة المحاولات أو التصحيحات البشرية.
غيّر متغيراً رئيسياً واحداً في كل مرة. إن زيادة طول السياق والتواقت وإعدادات التحسين معاً تجعل التراجعات في الأداء صعبة التفسير.
اختر جهد الاستدلال وإعدادات الذاكرة المؤقتة بعناية
استخدم جهد استدلال منخفضاً أو مرتفعاً أو أقصى حسب المهمة. ابدأ بالمنخفض لفحوصات الواجهة، ثم قارن المرتفع والأقصى في المهام الصعبة باستخدام جودة الإكمال والوقت المنقضي. طول أثر الاستدلال ليس بحد ذاته دليلاً على نتيجة أفضل.
للجلسات الطويلة، قيّم سعة الذاكرة المؤقتة وإعادة استخدام المقدّمات قبل إضافة فك تخمين أو تواقت أعلى. احتفظ بخط أساس معروف جيداً وغيّر إعداداً واحداً في كل مرة.
لماذا قد تفشل استدعاءات الأدوات بعد النشر؟
تطبيقك ينفّذ استدعاءات الأدوات، يعيد نتائجها، ويواصل المحادثة. حافظ على رسالة المساعد كاملة—including reasoning_content وtool_calls—وأعد كل نتيجة أداة مع tool_call_id المطابق.
المعالجة متعددة الأدوار مهمة أيضاً. يتطلب دليل استخدام النموذج الحفاظ على رسالة المساعد كاملة، بما في ذلك حقول الاستدلال واستدعاء الأدوات، بدلاً من الاحتفاظ بالنص النهائي فقط.
العرض
أولى الفحوصات
بنية نموذج غير معترف بها
نسخة وقت التشغيل والكود المخصص والإعداد
نفاد الذاكرة أثناء التحميل
سعة GPU والتوازي والعمليات المتنافسة
الطلبات القصيرة تعمل والطويلة تفشل
حد السياق وسعة الذاكرة المؤقتة والتواقت
تعذّر تحليل استدعاءات الأدوات
إعدادات المحلل ومخطط الأداة
توقف الوكيل بعد طلب أداة
تنفيذ التطبيق ومعالجة نتائج الأدوات
تصبح الإجابات متعددة الأدوار غير متسقة
فقدان حقول رسالة المساعد
استخدم طلباً قابلاً لإعادة الإنتاج وبسيطاً لعزل كل فشل. بمجرد نجاحه، أعد إدخال إعدادات التطبيق الإضافية واحداً تلو الآخر.
هل ينبغي أن تستضيف ذاتياً أم تستخدم API مستضافاً؟
اختر الاستضافة الذاتية عندما تحتاج إلى التحكم في الأوزان والبنية التحتية أو موقع البيانات وتستطيع إبقاء وحدات GPU مشغولة على نحو مفيد. للتقييم الأولي أو الطلب المتغير، قارن API الرسمي لـ Kimi وCometAPI باستخدام المطالبات ومعايير القبول نفسها. أكد الوصول إلى النموذج، والمعاملات المدعومة، والحصص، وشروط التعامل مع البيانات لكل خدمة.
عامل التكلفة أو التشغيل
الاستضافة الذاتية
Kimi API الرسمي / CometAPI
تكلفة السعة
شراء أو استئجار GPU، بما في ذلك وقت الخمول
فواتير استخدام API؛ تحقق من الأسعار الحالية لكل مزود
التخزين والشبكات
تخزين نقطة التحقق، والذاكرة المؤقتة، ورسوم الشبكة
أي تخزين أو رسوم شبكة على جانب التطبيق
العمليات
النشر والمراقبة والترقيات والتعافي
التكامل وإدارة الحصص ومراقبة الطلبات
إعادة المحاولات
احسب زمن GPU ضمن تكاليف الحوسبة
احسب الرموز أو المكالمات ضمن رسوم API
المراجعة البشرية
احسب زمن التصحيح بالمعدل نفسه
احسب زمن التصحيح بالمعدل نفسه
أفضل ملاءمة
طلب مستقر وتحكم في البنية التحتية
التقييم والطلب المتغير
مقارنة مفيدة هي:
تكلفة كل مهمة ناجحة = (حوسبة GPU أو رسوم API + التخزين والشبكات + العمليات + التصحيح البشري) / المهام المكتملة بنجاح.
استخدم تكاليف وعدد المهام الناجحة من الفترة الزمنية نفسها. اشمل المحاولات الفاشلة وإعادة المحاولات مرة واحدة ضمن إجمالي الحوسبة أو API؛ لا تضف تكلفة إعادة المحاولة مرتين. في سير عمل هجين، اشمل كلاً من حوسبة الخادم ورسوم API. عدّ المهام المكتملة الفريدة، لا محاولات الطلب.
قد يبقى الخادم غير المستغل مكلفاً حتى لو كان معدل الإنتاجية النظري ممتازاً. بالمقابل، قد تستفيد الفرق التي لديها بنية تحتية قائمة وطلب مستقر ومتطلبات صارمة لمكان البيانات بشكل كبير من الاستضافة الذاتية.
استخدم المطالبات ومعايير القبول نفسها عند مقارنة طرق النشر. اشمل زمن الاستجابة من الطرف إلى الطرف وجودة المخرجات في القرار.
جرّب نقطة النهاية المستضافة بدون تحميل الأوزان
يستخدم البدء السريع لـ Kimi API الرسمي نقطة النهاية أدناه. اضبط MOONSHOT_API_KEY في بيئتك وتحقق من الوصول إلى النموذج في حسابك. يعمل هذا الطلب على بنية المزود.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
بالنسبة إلى Kimi K3.1 Pro API في CometAPI، اضبط COMETAPI_API_KEY في بيئتك وتأكد من أن حسابك يمتلك الوصول إلى النموذج المطلوب. يعمل الطلب عن بُعد:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
قارن النتيجة مع نقطة نهايتك المحلية باستخدام معايير القبول نفسها. تحقق من سعر المسار الحالي والمعاملات المدعومة قبل تقدير تكاليف الإنتاج.
الخاتمة
الاستضافة الذاتية لـ Kimi K3.1 Pro عملية مع تكوين GPU مدعوم وبيئة استدلال مطابقة. استخدم خطوات النشر أعلاه لإعداد نقطة نهاية عاملة، ثم قِس جودة المهام والكمون والتكلفة على عبء عملك. اختر API مستضافاً إذا كنت لا تزال تتحقق من التطبيق أو لا تملك عتاداً مناسباً.
الأسئلة الشائعة
هل يمكن لحاسوب محمول عادي تشغيل النموذج كاملاً؟
الحاسوب المحمول العادي ليس هدفاً عملياً لمتطلبات سعة نقطة التحقق الأصلية. يمكنه العمل كعميل مرتبط بخادم الاستدلال الخاص بك أو بـ API مستضاف.
هل تثبيت التطبيق المكتبي يُعد نشراً محلياً؟
موقع تثبيت التطبيق لا يحدد مكان حدوث الاستدلال. تتطلب الاستضافة الذاتية تشغيل أوزان النموذج وعملية الاستدلال في بنية تحتية تتحكم بها.
لماذا يحتاج النموذج إلى كل هذه الذاكرة إذا كان 104B فقط من المعاملات نشطاً؟
يمكن لرموز مختلفة اختيار خبراء مختلفين. تصف المعاملات النشطة المشاركة في الحساب؛ أما النشر فلا يزال بحاجة إلى تخزين المجموعة الكاملة من الأوزان والوصول إليها.
هل يمكنني تمكين سياق المليون رمز على الفور؟
زد طول السياق تدريجياً وقِس استخدام ذاكرة GPU عند التواقت المستهدف. يدعم النموذج 1,048,576 رمزاً، لكن سعة الخدمة القابلة للاستخدام تعتمد على الذاكرة المؤقتة وإعدادات التوازي.
هل سيكرر النشر المحلي درجات المقاييس المنشورة؟
ليس تلقائياً. يمكن أن يؤثر التكميم وميزانيات الاستدلال والأدوات والمطالبات وأطر التقييم جميعها على النتائج. تحقق من التكوين على مهامك الخاصة.
هل ينبغي أن أختبر عبر API قبل شراء عتاد؟
إذا لم تثبت أن النموذج يلبي متطلبات الجودة لديك، يوفر الاختبار عبر API خط أساس أوليّاً مع عمل بنية تحتية أقل. يمكن للفرق ذات العتاد المناسب ومتطلبات واضحة لمكان البيانات أن تنتقل مباشرة إلى تقييم استضافة ذاتية محكوم.