Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
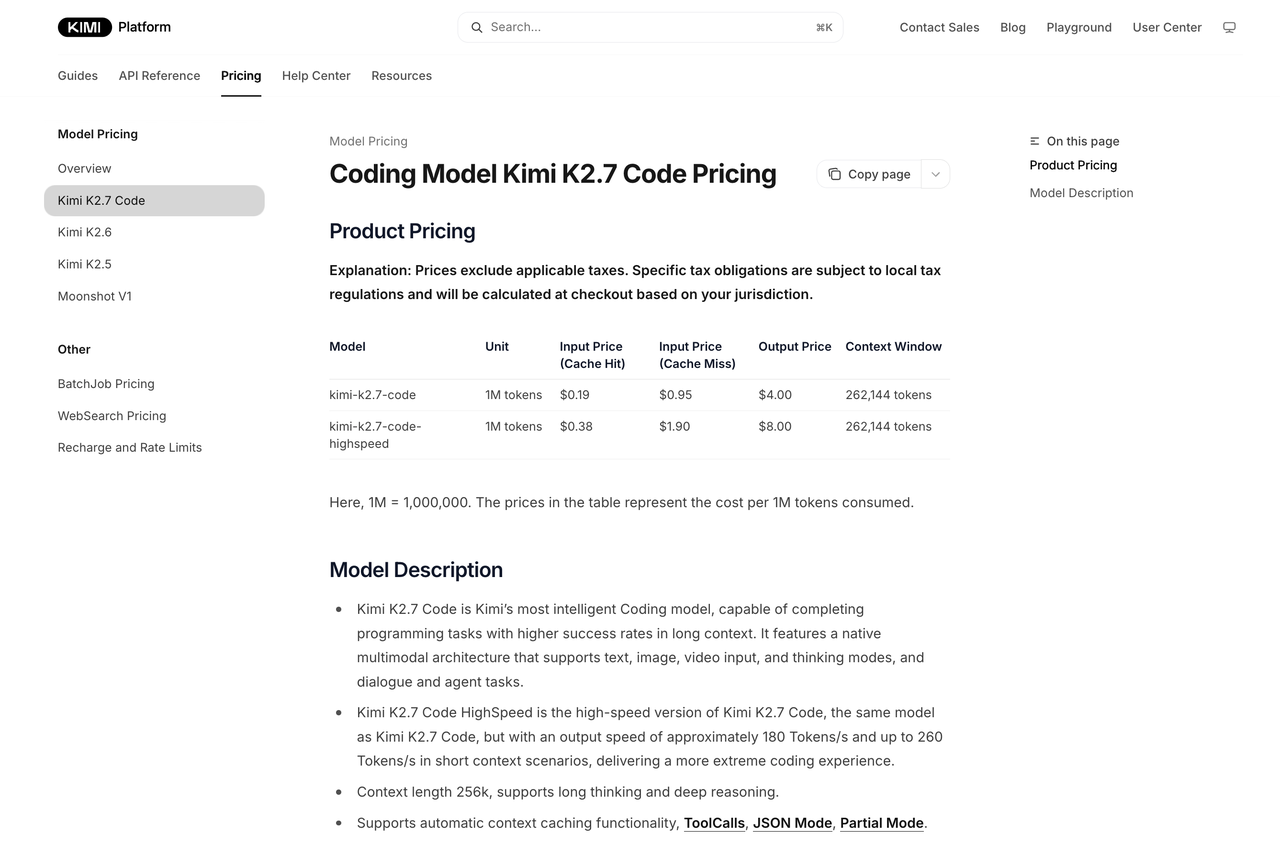
TLDR Moonshot AI berechnet für Kimi K2.7 Code derzeit $0.19 pro 1M Cache‑Hit‑Eingabetoken, $0.95 pro 1M Cache‑Miss‑Eingabetoken und $4.00 pro 1M Ausgabetoken. Kimi K2.7 Code HighSpeed verdoppelt diese Sätze auf $0.38 / $1.90 / $8.00.
Die wichtigsten Kostenfaktoren sind:
Caching: Bei K2.7 sind Cache‑Hit‑Eingabetoken 80% günstiger als Cache‑Miss‑Eingabetoken.
HighSpeed: Die schnellere Route kostet auf Token‑Ebene das Doppelte.
Unterstützte Modelle kosten 60% der Echtzeitpreise, was 40% Ersparnis entspricht.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Batch API:
WebSearch: Moonshot berechnet $0.005 pro erfolgreichem eingebauten Suchaufruf, zuzüglich der Token für die Verarbeitung der Suchergebnisse.
Compatibility: K2.7 Code erfordert Thinking, während die eingebaute WebSearch von Moonshot Thinking deaktiviert verlangt.
Für Coding‑Agenten ist die nützlichste Kennzahl nicht der Preis pro Million Token, sondern die Kosten pro abgeschlossener Aufgabe, inklusive Reasoning, Caching, Retries, Tool‑Aufrufen, Latenz und menschlichen Korrekturen.
Die K2.7‑Preise von Moonshot sind derzeit Aktionspreise. Moonshot und CometAPI nutzen außerdem unterschiedliche Abrechnungsmodelle für Eingaben, daher sind die ausgewiesenen Sätze nicht direkt miteinander vergleichbar.
Moonshot Kimi K2 Preisgestaltung erklärt
K2.7 Code und K2.6 haben die gleichen Preise für Cache‑Miss‑Eingabe und Ausgabe. Die wichtigsten Unterschiede auf Token‑Ebene: K2.7 Code verlangt etwas mehr für gecachte Eingaben, während HighSpeed alle K2.7‑Sätze verdoppelt.
Model
Best suited to
kimi-k2.7-code
Coding‑Agenten, Repository‑Änderungen und langfristige Engineering‑Aufgaben
kimi-k2.7-code-highspeed
Interaktives Coden, bei dem geringere Latenz messbaren Wert hat
kimi-k2.6
Allgemeines multimodales Reasoning, Agenten und eingebaute WebSearch
kimi-k2.5
Günstigere allgemeine und multimodale Workloads
Moonshot beschreibt HighSpeed als dasselbe zugrundeliegende K2.7 Code‑Modell, das über eine schnellere Route bereitgestellt wird. Die dokumentierte Ausgabegeschwindigkeit liegt bei etwa 180 Token pro Sekunde, mit bis zu 260 Token pro Sekunde bei kürzeren Kontexten. Die Kapazität kann schwanken, während Moonshot die Ressourcen ausbaut.
HighSpeed ist daher in erster Linie eine Latenz‑Entscheidung und keine separate Qualitätsstufe des Modells.
Eine direkte Moonshot‑API‑Alternative: CometAPI
Entwickler können auf Kimi K2.7 Code direkt über Moonshot AI oder über die OpenAI‑kompatible API von CometAPI zugreifen.
Access route
Standard input
Cached input
Output
Moonshot direct API
$0.95 / 1M cache miss
$0.19 / 1M
$4.00 / 1M
CometAPI
$0.76 / 1M
Not separately listed
Approx. $3.20 / 1M
Die ausgewiesenen Standardpreise von CometAPI für Eingabe und Ausgabe sind etwa 20% niedriger, während Moonshot bei Workloads mit hohem Cache‑Hit‑Anteil kostengünstiger sein kann.
Wählen Sie CometAPI, wenn Sie eine API für Kimi und andere Modellanbieter möchten. Wählen Sie den direkten Zugang zu Moonshot, wenn Ihre Workflows häufig dieselben Prompts oder Repository‑Kontexte wiederverwenden.
Zu den aktuell ausgewiesenen Sätzen ist CometAPI in etwa 20% günstiger als die Cache‑Miss‑Eingabe‑ und Ausgabe‑Preise von Moonshot.
Allerdings weist CometAPI auf der K2.7‑Modellseite keinen separaten Cache‑Hit‑Preis aus. Der Standard‑Eingabepreis von $0.76 sollte nicht direkt mit dem gecachten Eingabepreis von $0.19 bei Moonshot verglichen werden.
Teams, die lange Systemprompts, Tool‑Definitionen oder Repository‑Kontexte wiederholt nutzen, sollten beide Zugänge mit ihrem tatsächlichen Traffic testen. Ein Workload mit sehr hoher Cache‑Hit‑Quote kann zu anderen Ergebnissen führen als einer, der überwiegend neuen Kontext sendet.
Die Berechnung derselben 1M Token vollständig zum Cache‑Miss‑Satz würde $0.95 kosten. In diesem Beispiel reduziert das gemischte Cache‑Profil die Eingabekosten um $0.608.
Deshalb sollten Produktions‑Dashboards Cache‑Hit‑ und Cache‑Miss‑Token separat erfassen, anstatt nur die gesamten Eingaben zu berichten.
Kimi Batch‑API‑Preise
Die Batch‑API von Moonshot kostet 60% des entsprechenden Echtzeit‑Modellpreises, was Teams bei unterstützten asynchronen Workloads 40% Ersparnis bringt. Die aktuelle Dokumentation listet K2.7 Code, K2.6 und K2.5 als unterstützte Batch‑Modelle.
Batch model
Cache-hit input
Cache-miss input
Output
kimi-k2.7-code
$0.114 / 1M
$0.57 / 1M
$2.40 / 1M
kimi-k2.6
$0.096 / 1M
$0.57 / 1M
$2.40 / 1M
kimi-k2.5
$0.06 / 1M
$0.36 / 1M
$1.80 / 1M
Batch‑API eignet sich gut für:
Repository‑weite Codeanalyse
große Evaluationsläufe
Offline‑Klassifikation
nächtliche Anreicherung
synthetische Testgenerierung
Migrationsanalyse
Security‑Review‑Backlogs
Weniger geeignet ist sie für IDE‑Assistenten, Live‑Chats und andere Workflows, in denen ein Nutzer auf eine sofortige Antwort wartet.
Für Hintergrundverarbeitung kann die 40%‑Ersparnis wertvoller sein, als auf ein günstigeres Modell mit niedrigerer Aufgabenabschlussrate zu wechseln.
Kimi WebSearch: Preise und Kompatibilität
Moonshot berechnet $0.005 für jeden erfolgreichen eingebauten$web_search‑Aufruf. Wenn das Modell ohne Auslösen des Suchtools fertig wird, fällt keine separate Tool‑Gebühr an.
Inhalte aus Suchergebnissen können zudem in die nächste Modellanfrage aufgenommen und als Eingabetoken abgerechnet werden. Moonshot definiert die sich ergebende Token‑Berechnung wie folgt:
Ein vollständiger Such‑Workflow kann daher enthalten:
Initial model request
+ WebSearch tool fee
+ search-result input tokens
+ follow-up model request
+ retries
Es gibt außerdem eine wichtige Modellbeschränkung: Die eingebaute WebSearch von Moonshot erfordert deaktiviertes Thinking, während K2.7 Code keinen nicht‑Thinking‑Modus unterstützt. Das offizielle WebSearch‑Beispiel nutzt daher K2.6 mit deaktiviertem Thinking.
Für die eingebaute Suche von Moonshot verwenden Sie K2.6 oder K2.5 mit deaktiviertem Thinking.
Ein K2.7‑Coding‑Agent kann dennoch über normales Function Calling einen unabhängig implementierten Suchdienst aufrufen. In diesem Fall richtet sich die Suche‑Preisgestaltung nach dem externen Anbieter und nicht nach der eingebauten Gebühr von $0.005 bei Moonshot.
Beispiel 1: K2.7 Code‑Kosten für eine Coding‑Aufgabe
Angenommen, ein Coding‑Agent‑Workflow nutzt:
30,000 Cache‑Miss‑Eingabetoken
8,000 Ausgabetoken, inklusive Reasoning
keinen eingebauten WebSearch‑Aufruf
Standard K2.7 Code
Component
Calculation
Cost
Input
30,000 ÷ 1M × $0.95
$0.03
Output
8,000 ÷ 1M × $4.00
$0.03
Total
$0.06
K2.7 Code HighSpeed
Component
Calculation
Cost
Input
30,000 ÷ 1M × $1.90
$0.06
Output
8,000 ÷ 1M × $8.00
$0.06
Total
$0.12
Bei gleichem Tokenverbrauch kostet HighSpeed genau doppelt so viel.
CometAPI K2.7 Code
Mit den aktuellen CometAPI‑Sätzen:
Component
Calculation
Cost
Input
30,000 ÷ 1M × $0.76
$0.02
Output
8,000 ÷ 1M × $3.19998
Approx. $0.0256
Total
Approx. $0.0484
Das liegt in etwa 20% unter den $0.0605 Moonshot‑Kosten für Cache‑Miss‑Token in diesem Beispiel. Die Berechnung schließt Steuern, externe Tools und andere Plattform‑Services aus.
Beispiel 2: K2.6 mit eingebauter WebSearch
Angenommen, ein K2.6‑Workflow mit deaktiviertem Thinking nutzt:
30,000 Cache‑Miss‑Eingabetoken über den gesamten Workflow
8,000 Ausgabetoken
einen erfolgreichen eingebauten WebSearch‑Aufruf
Die 30,000 Eingabetoken beinhalten Suchergebnis‑Inhalte, die in die Folgeanfrage übernommen wurden.
Component
Calculation
Cost
Input
30,000 ÷ 1M × $0.95
0.0285
Output
8,000 ÷ 1M × $4.00
0.0320
WebSearch
1 × $0.005
0.0050
Total
0.0655
In diesem Beispiel macht die direkte WebSearch‑Gebühr rund 7.6% der Gesamtkosten aus. In längeren Research‑Workflows können die durch die Suchergebnisse hinzugefügten Token mehr kosten als der Tool‑Aufruf selbst.
Engineering‑Details, die die Endabrechnung verändern können
K2.7 Code gibt einen Fehler zurück, wenn Thinking deaktiviert ist. Das Reasoning wird über reasoning_content zurückgegeben, und sowohl das Reasoning als auch die sichtbare Antwort tragen zum Tokenverbrauch bei.
Bei mehrstufigen Tool‑Aufrufen müssen Anwendungen das reasoning_content des Assistenten im Gesprächskontext beibehalten. Längere Agent‑Schleifen können daher sowohl die aktuellen Ausgabekosten als auch die späteren Eingabekosten erhöhen.
max_tokens ist ein Limit, keine fixe Gebühr
Der Parameter max_tokens definiert die maximale Menge, die das Modell generieren darf. Ein höherer Wert gibt dem Modell genug Spielraum, sein Reasoning und die Antwort zu vervollständigen, aber das volle Kontingent wird nicht automatisch abgerechnet.
Die Kosten basieren auf den tatsächlich verarbeiteten und erzeugten Token.
Einige Request‑Parameter sind fix
K2.7 Code erfordert feste Werte für mehrere Parameter:
Parameter
Required value
temperature
1
top_p
0.95
n
1
presence_penalty
0
frequency_penalty
0
Das Übergeben anderer Werte kann einen Fehler verursachen. Anwendungen, die denselben OpenAI‑kompatiblen Wrapper bei mehreren Anbietern verwenden, sollten fest kodierte Defaults prüfen, bevor sie das Modell wechseln.
Offizielle Preisdokumentation erklärt die Abrechnung. Externe Adoption bietet zusätzlichen Kontext dazu, wo das Modell eingesetzt wird und wie Entwickler es bewerten.
GitHub Copilot
GitHub hat Kimi K2.7 Code am 1. Juli 2026 in Copilot allgemein verfügbar gemacht und es als das erste Open‑Weight‑Modell im Copilot‑Modellpicker beschrieben. Die Verfügbarkeit galt zunächst für Individual‑Pläne und wurde am 7. Juli auf Business‑ und Enterprise‑Pläne ausgeweitet.
Die Adoption durch GitHub ist ein nützliches Distributionssignal, beweist aber nicht, dass K2.7 bei jeder Coding‑Aufgabe andere Modelle übertrifft.
Moonshot veröffentlicht Kimi K2.7 Code auf Hugging Face unter einer modifizierten MIT‑Lizenz. Die Modellkarte beschreibt eine Mixture‑of‑Experts‑Architektur mit 1 Billion Parametern, 32 Milliarden aktivierten Parametern und einem 256K‑Kontextfenster. Sie enthält außerdem Bereitstellungsanleitungen für Frameworks wie Transformers, vLLM und SGLang.
Moonshot berichtet von etwa 30% weniger Thinking‑Tokenverbrauch gegenüber K2.6 und einer 10%igen Verbesserung der Agenten‑Fähigkeit. Dies sind Anbieterangaben und sollten mit unabhängigen Workloads validiert werden.
Die Diskussion auf Hacker News ist gemischter als die Launch‑Materialien. Einige Entwickler konzentrieren sich auf die Open‑Weight‑Verfügbarkeit von Kimi, die Tokeneffizienz und die Integration mit Coding‑Agent‑Tools. Andere argumentieren, dass ein niedrigerer Tokenpreis keine niedrigeren Projektkosten garantiert, wenn das Modell mehr Retries, Supervision oder Kontext benötigt.
Diese Debatte unterstützt die zentrale Empfehlung dieses Guides: Modelle anhand realer Repositories vergleichen und Aufgabenabschluss, Retries und menschliche Bearbeitung messen – nicht nur beworbene Tokenraten.
Die folgende Tabelle vergleicht die aktuellen Standard‑API‑Sätze für Kimi K2.7 Code, DeepSeek V4 Pro, Claude Sonnet 5 und GPT‑5.6 Sol mit Stand 13. Juli 2026.
DeepSeek V4 Pro listet derzeit ein 1M‑Kontextfenster mit Cache‑Hit‑Eingabe zu $0.003625, Cache‑Miss‑Eingabe zu $0.435 und Ausgabe zu $0.87 pro Million Token.
Der Einführungspreis von Claude Sonnet 5 beträgt $2 pro Million Eingabetoken, $0.20 pro Million Cache‑Read‑Token und $10 pro Million Ausgabetoken bis zum 31. August 2026. Cache‑Writes sind separat bepreist, und Anthropic weist darauf hin, dass der neuere Tokenizer des Modells für denselben Text mehr Token erzeugen kann als frühere Claude‑Modelle.
Der Standard‑Kurzkontext‑Satz von GPT‑5.6 Sol beträgt $5 pro Million Eingabetoken, $0.50 pro Million gecachter Eingabetoken und $30 pro Million Ausgabetoken. OpenAI listet außerdem separate Sätze für Cache‑Writes, Long‑Context, Batch, Flex und Priority.
Zu den ausgewiesenen Token‑Sätzen ist Kimi K2.7 Code günstiger als Claude Sonnet 5 und GPT‑5.6 Sol, während DeepSeek V4 Pro billiger ist. Daraus ergibt sich nicht, welches Modell für einen bestimmten Coding‑Workflow die niedrigsten Kosten bietet.
Welches Kimi‑Modell sollten Sie verwenden?
Workload
Recommended starting point
Repository‑Änderungen und lange Coding‑Tasks
kimi-k2.7-code
Interaktives Coden mit Relevanz für Latenz
kimi-k2.7-code-highspeed
Allgemeines multimodales Reasoning und Agenten
kimi-k2.6
Eingebaute Moonshot‑WebSearch
kimi-k2.6 oder kimi-k2.5 mit deaktiviertem Thinking
Günstige allgemeine Workloads
kimi-k2.5
Offline‑Evaluationen und Bulk‑Processing
Batch API
K2.7 Code ist der natürliche Ausgangspunkt für qualitätssensitive Coding‑Arbeiten. HighSpeed lohnt sich, wenn schnellere Antworten Developer Experience, Konversion oder Durchsatz verbessern.
K2.6 ist flexibler für allgemeine multimodale und suchgestützte Workflows, während K2.5 die niedrigsten Standard‑Kimi‑Tokenraten hat.
Wie man die tatsächlichen Kosten bewertet
Erstellen Sie ein Evaluationsset aus Produktionstasks, anstatt sich nur auf öffentliche Benchmarks zu verlassen.
Nützliche Testfälle sind:
Repository‑Level‑Feature‑Implementierung
Pull‑Request‑Review
Debugging und Testgenerierung
Long‑Context‑Codeanalyse
mehrstufige Tool‑Aufrufe
entwicklerunterstützte Suche
Verfolgen Sie:
erfolgreiche Aufgabenabschlüsse
Cache‑Hit‑Quote
Eingabe‑ und Ausgabetoken
Reasoning‑Token‑Volumen
Erfolgsquote von Tool‑Aufrufen
Anzahl der Retries
p50‑ und p95‑Latenz
menschliche Korrekturen
Gesamtkosten des Workflows
Berechnen Sie:
Cost per completed task =
total workflow cost ÷ successfully completed tasks
Beispielsweise, wenn ein Team $10 ausgibt und 80 Aufgaben erfolgreich abschließt:
Cost per completed task = $10 ÷ 80 = $0.125
Ein Modell mit günstigeren Token kann dennoch teurer sein, wenn es mehrere Versuche, längeres Reasoning oder umfangreiche manuelle Korrekturen erfordert.
Für Routing‑, Fallback‑ und Evaluationsbeispiele siehe das CometAPI Cookbook.
Häufig gestellte Fragen
Wie viel kostet Kimi K2.7 Code?
Moonshot listet K2.7 Code derzeit mit:
$0.19 pro 1M Cache‑Hit‑Eingabetoken
$0.95 pro 1M Cache‑Miss‑Eingabetoken
$4.00 pro 1M Ausgabetoken
Die Sätze sind als zeitlich begrenzte Aktionspreise markiert.
Wie viel kostet K2.7 Code über CometAPI?
CometAPI listet K2.7 Code derzeit mit $0.76 pro 1M Eingabetoken und $3.19998 pro 1M Ausgabetoken.
Ein separater Cache‑Hit‑Satz wird auf der Modellseite nicht angezeigt.
Senkt die Kimi Batch‑API die Kosten und unterstützt sie K2.7 Code?
Ja. Batch‑Inference kostet 60% des Echtzeitpreises, was 40% Ersparnis entspricht.
Die aktuelle Batch‑Dokumentation von Moonshot listet K2.7 Code, K2.6 und K2.5 als unterstützte Modelle.
Was kostet Kimi WebSearch?
Die eingebaute $web_search kostet $0.005 pro erfolgreichem Aufruf.
Suchergebnis‑Inhalte können beim nächsten Modellrequest als Eingabetoken abgerechnet werden.
Kann Thinking bei K2.7 Code deaktiviert werden?
Nein. Requests mit deaktiviertem Thinking führen zu einem Fehler.
Ist Kimi OpenAI‑kompatibel?
Ja. Moonshot dokumentiert die Kompatibilität zum OpenAI‑API‑Format, obwohl modellspezifische Einschränkungen weiterhin für Thinking, Parameter und mehrstufige Tool‑Aufrufe gelten.
Testen Sie Kimi K2.7 Code mit CometAPI
Kimi K2.7 Code bietet wettbewerbsfähige Preise für Coding‑Agent‑Workloads, aber die beste Wahl hängt von mehr als dem ausgewiesenen Tokenpreis ab.
Vergleichen Sie vor der Auswahl eines Anbieters:
Total workflow cost =
tokens + retries + tools + latency + human correction
CometAPI ermöglicht es Entwicklern, Kimi neben GPT, Claude, Gemini, DeepSeek, Grok und anderen Modellfamilien über einen einheitlichen API‑Workflow zu testen.
Prüfen Sie die aktuellen CometAPI pricing, öffnen Sie die Kimi K2.7 Code model page, und benchmarken Sie das Modell mit realen Aufgaben aus Ihren eigenen Repositories.
Ziel ist nicht einfach, den günstigsten Token zu finden, sondern die niedrigsten Kosten pro abgeschlossener Aufgabe.
Kimi K2 API-Preise 2026: K2.7-, Batch- und WebSearch-Kosten - CometAPI