
TL;DR
Claude Fable 5.1 presenta una base de referencia más sólida para codificación autónoma difícil y trabajo de largo horizonte. GPT-5.6 Sol ofrece menores costos de tokens ordinarios, un amplio stack nativo de herramientas y menor tiempo hasta el primer token en la comparación independiente a máximo esfuerzo. La elección predeterminada correcta depende del costo de una tarea fallida, no solo de la puntuación de referencia más alta.
En la instantánea del 8 de septiembre de 2026 del Intelligence Index, Fable 5.1 obtiene 53, frente a 47 de GPT-5.6 Sol. El rendimiento de salida está prácticamente empatado en 69.9 frente a 69.8 tokens/s. Estos resultados respaldan una decisión calidad vs. costo; no establecen un ganador universal en velocidad.
Conclusiones clave
- Elige Fable 5.1 para las tareas autónomas más difíciles cuando tus propias evaluaciones justifiquen el mayor precio.
- Comienza con GPT-5.6 Sol para inferencia de frontera sensible al costo y aplicaciones que se benefician de sus herramientas integradas.
- Compara la demora de inicio por separado de la velocidad de salida: GPT-5.6 Sol tiene menor tiempo medido hasta el primer token, mientras que el rendimiento está casi igual.
- Modela por separado escrituras, lecturas, retención de caché y tasas de contexto largo. Los precios de entrada/salida principales no describen todas las cargas de los agentes.
Datos verificados el 8 de septiembre de 2026. Los resultados independientes usan GPT-5.6 Sol con esfuerzo máximo y Fable 5.1 con Adaptive Reasoning, Max Effort, Default Fallback. Los benchmarks del proveedor y los independientes usan configuraciones de evaluación diferentes. Los precios están en USD por millón de tokens (MTok), salvo que se indique lo contrario.
GPT-5.6 Sol vs Fable 5.1: veredicto rápido
| Dimensión | GPT-5.6 Sol | Claude Fable 5.1 | Mejor opción |
|---|---|---|---|
| Independent Intelligence Index v4.3 (8 sep) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (7 sep) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Context window | 1.05M | 1M | Prácticamente empatado |
| Maximum output | 128K | 128K | Empate |
| Text/image input | Sí | Sí | Empate |
| Official input price / MTok | $4 | $10 | Sol |
| Official output price / MTok | $20 | $50 | Sol |
| Official cache read / MTok | $0.40 | $0.25 | Fable 5.1 |
| Independent output speed (8 sep) | 69.8 tok/s | 69.9 tok/s | Prácticamente empatado |
| API tool breadth | Muy amplio | Sólido | Sol |
| Long-running autonomous work | Excelente | Fortaleza central | Fable 5.1 |
| Cost-sensitive production | Mejor predeterminado | Escalación premium | Sol |
Una política inicial útil es Sol para trabajo de frontera rutinario, con Fable 5.1 como ruta de escalación cuando una tarea no supera tu umbral de calidad o autonomía. Valida esa política frente al costo por tarea exitosa.
GPT-5.6 Sol expone seis niveles de esfuerzo de razonamiento, desde ninguno hasta máximo, con medio como valor predeterminado. Fable 5.1 usa adaptive thinking siempre activo; el esfuerzo controla la profundidad del razonamiento y el predeterminado es alto.
Los 50,000 tokens adicionales en el contexto de GPT-5.6 Sol probablemente no decidirán la mayoría de las arquitecturas. La facturación y la reutilización de caché se vuelven más importantes a medida que una solicitud se acerca al millón de tokens; la sección de contexto largo a continuación muestra por qué.
¿Qué es GPT-5.6 Sol?
GPT-5.6 Sol es una categoría de alta capacidad en la familia GPT-5.6 de OpenAI para flujos de trabajo exigentes de código, investigación, planificación y agentes. Su principal atractivo en esta comparación es la combinación de controles de razonamiento y el entorno de ejecución circundante.
A través de la Responses API, GPT-5.6 Sol soporta un amplio portafolio nativo de herramientas: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills y tool search. Esto puede reducir la cantidad de componentes de runtime separados que una aplicación necesita integrar.
OpenAI también describe programmatic tool calling y ejecución multiagente para la familia. Estas funciones de plataforma importan cuando un modelo debe coordinar trabajo entre herramientas en lugar de devolver una única respuesta.
¿Qué es Claude Fable 5.1?
Claude Fable 5.1 está orientado a codificación exigente, trabajo profesional de conocimiento, investigación y agentes de larga duración. Sus resultados de referencia directos lo convierten en un candidato sólido para tareas en las que recuperación, persistencia y finalización exitosa importan más que una respuesta corta.
Anthropic enfatiza la sustained autonomous execution en aplicaciones, incluyendo planificación, recuperación de pasos fallidos y comunicación de progreso. Trata ese posicionamiento como un motivo para probar tareas más largas, no como una garantía de que todo flujo de trabajo finalizará correctamente.
Fable 5.1 también difiere de GPT-5.6 Sol en comportamiento de API: sus restricciones de forced tool-choice importan para flujos que requieren que el modelo llame a una herramienta específica. Revisa los modos soportados de tool_choice al migrar un bucle de agente determinista.
La cuestión de la integración es, por tanto, práctica: ¿tu aplicación puede tolerar un bucle de razonamiento más autónomo, o requiere un control más fino de cada paso? Prueba el comportamiento exacto de herramientas antes de elegir una ruta.
Comparación de benchmarks: Fable 5.1 tiene la evidencia directa más sólida
Las comparaciones de benchmarks entre proveedores competidores son fáciles de malinterpretar. Las evaluaciones del lanzamiento original de GPT-5.6 de OpenAI son anteriores a Fable 5.1, mientras que la publicación de Fable 5.1 de Anthropic contiene comparaciones directas más recientes con GPT-5.6 Sol.
La forma más limpia de leer la evidencia es en tres capas: la comparación directa de Anthropic, pruebas independientes actuales y el propio perfil de capacidad de GPT-5.6 Sol de OpenAI.
Resultados directos de Anthropic: Fable 5.1 vs GPT-5.6 Sol
Los resultados oficiales de benchmark incluyen cinco tareas con valores informados para ambos modelos. Las diferencias en puntos porcentuales y Elo a continuación se calculan a partir de esos valores publicados.
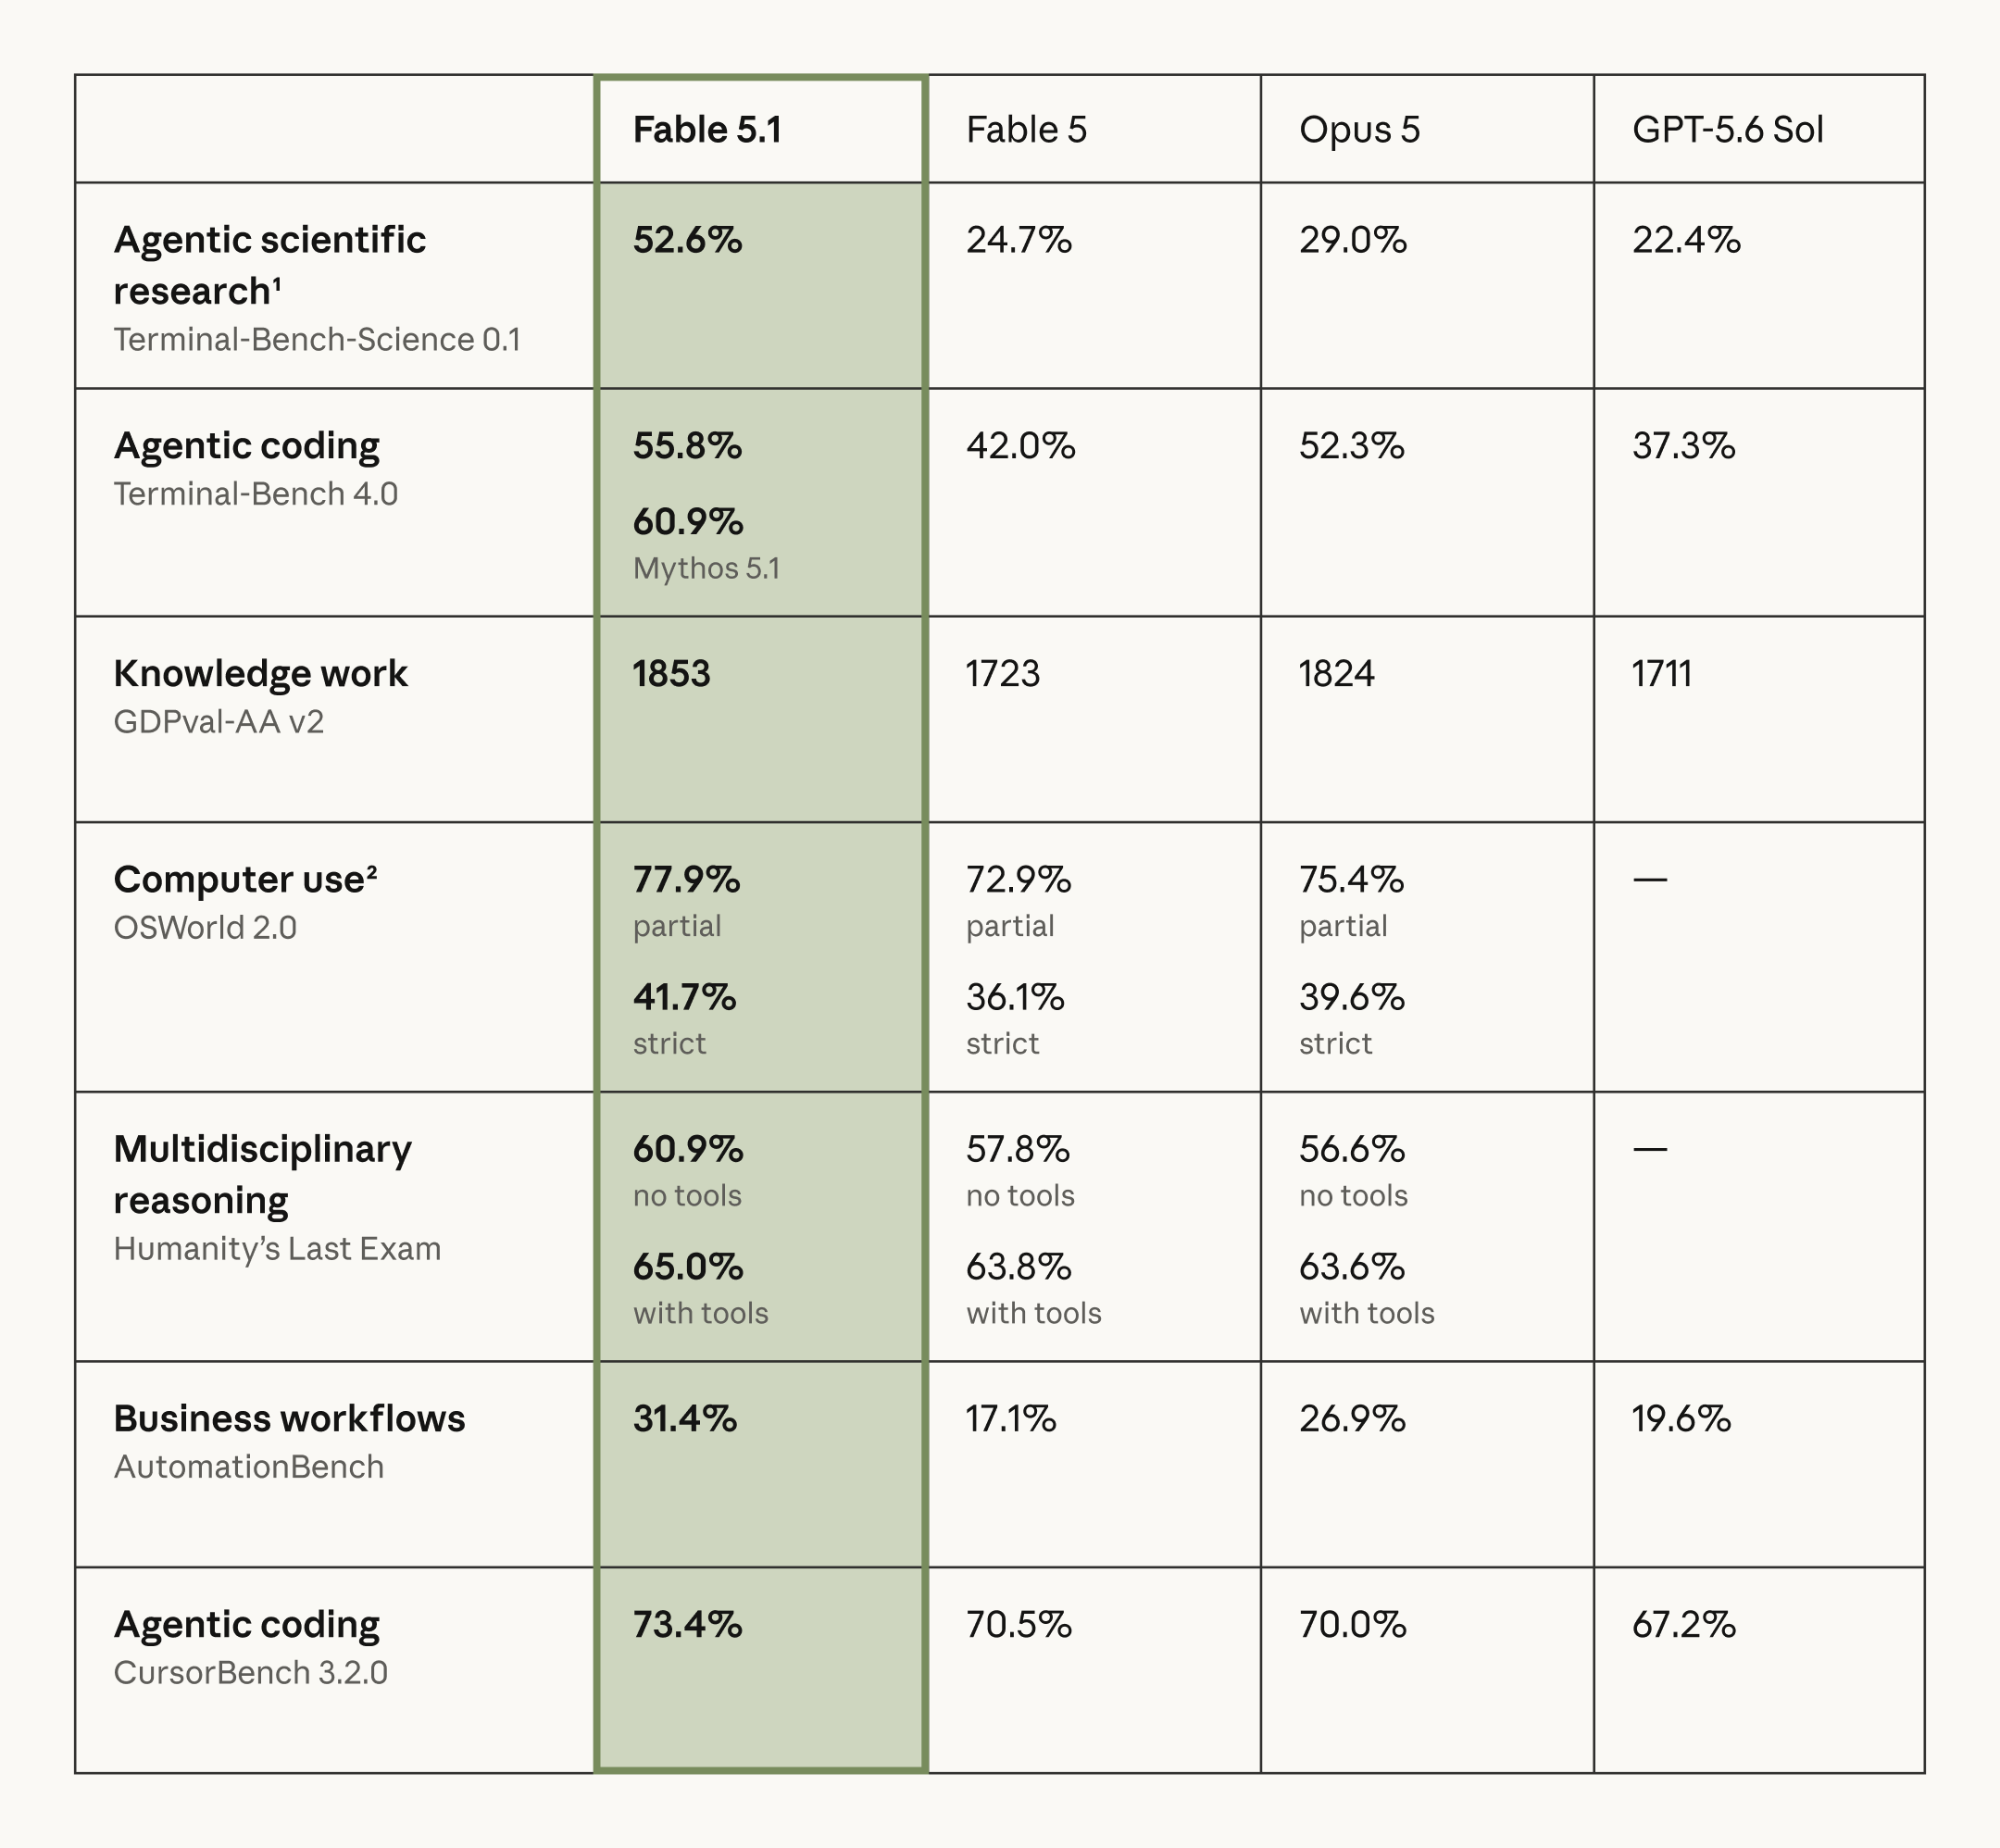
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Ventaja de Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
El resultado es inusualmente consistente: Fable 5.1 supera a GPT-5.6 Sol en todas las filas directas que publicó Anthropic. Las mayores diferencias aparecen en investigación científica agente y codificación basada en terminal, más que en razonamiento corto ordinario.
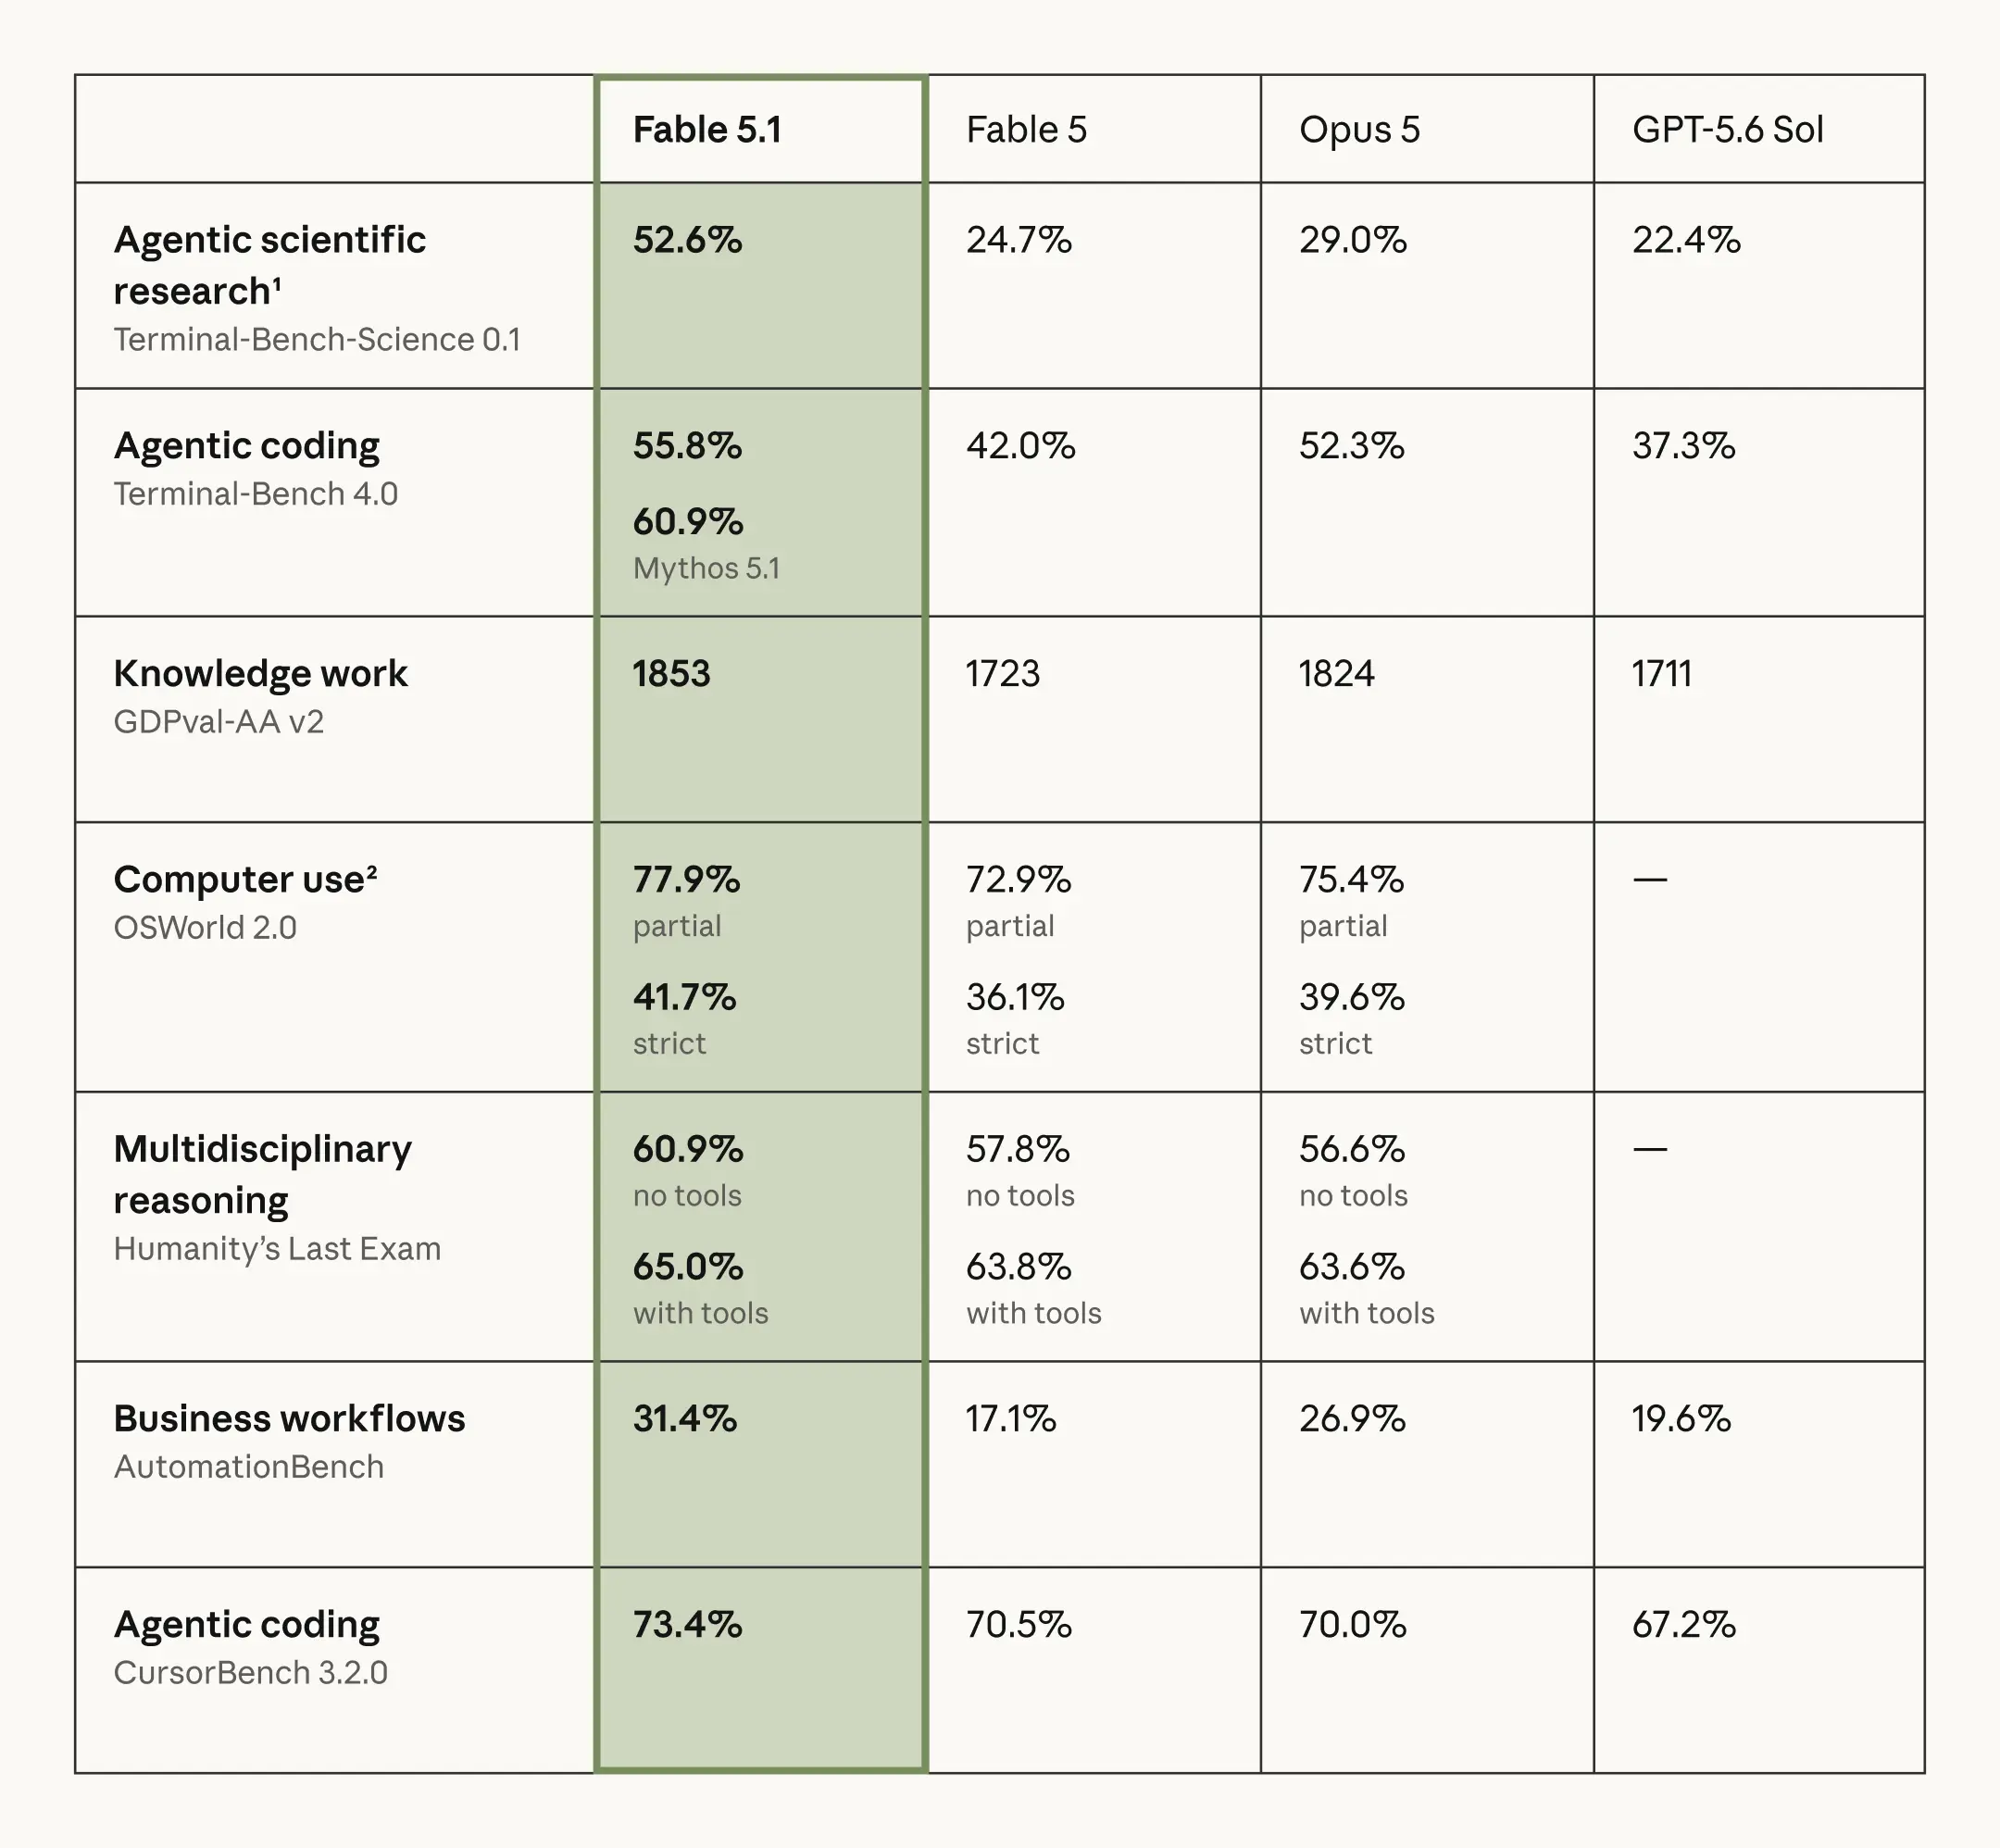
Fuente: Anthropic — gráfico de referencia original.
Son evaluaciones realizadas por el proveedor: Anthropic probó tanto su modelo como el competidor. Proporcionan evidencia comparativa directa, pero no son pruebas independientes. Anthropic informa un error estándar de ±3.5–4.5 puntos porcentuales por modelo en Terminal-Bench-Science; la tabla anterior muestra estimaciones puntuales, no intervalos de confianza.
Los resultados del proveedor favorecen a Fable 5.1, pero la evidencia independiente necesita sus propias fechas y configuraciones.
Benchmarks independientes: separa resultados fechados de mediciones en vivo
Artificial Analysis introdujo el Intelligence Index v4.3 el 7 de septiembre, reemplazando Terminal-Bench 2.1 por Terminal-Bench 4.0 y añadiendo AutomationBench-AA. El lanzamiento informó 53 para Fable 5.1 y 47 para GPT-5.6 Sol, coincidiendo con las puntuaciones redondeadas mostradas en la comparación del 8 de septiembre. La tabla distingue los resultados de terminal del lanzamiento de la instantánea de rendimiento posterior.
| Comparación AA de métrica independiente / lanzamiento v4.3 | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Resultado |
|---|---|---|---|
| Intelligence Index v4.3 (8 sep) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (lanzamiento 7 sep) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Output speed (8 sep) | 69.8 tok/s | 69.9 tok/s | Prácticamente empatado |
| Time to first token (8 sep) | 132.10 s | 277.47 s | Sol |
| AA normalized token-mix price / MTok | $3.08 | $7.175 | Sol |
Instantánea: 8 de septiembre de 2026, salvo la fila de Terminal-Bench del 7 de septiembre. Fable 5.1 usa Adaptive Reasoning, Max Effort, Default Fallback; Sol usa max. Las mediciones en vivo pueden cambiar. El precio normalizado de mezcla de tokens de AA usa una proporción 7:2:1 de cache-hit/entrada/salida; no es el costo de cada solicitud de API.
OSWorld 2.0 es la mayor ventaja reportada para Sol en esta comparación: 62.6% frente a 41.7% para Fable 5.1, una diferencia de 20.9 puntos. Esto contrapesa los resultados más fuertes de Fable en el Intelligence Index y Terminal-Bench.
La evidencia respalda un intercambio específico: Fable 5.1 tiene un Intelligence Index más alto, mientras que Sol tiene menor tiempo hasta el primer token y un precio normalizado inferior. El rendimiento de salida está prácticamente empatado. Estas mediciones respaldan elecciones distintas para trabajo por lotes sensible a la calidad y aplicaciones interactivas.
La comparación independiente fechada de Terminal-Bench apunta en la misma dirección que la prueba de Anthropic: 52.0% frente a 39.9%, comparado con el 55.8% frente a 37.3% del proveedor. Las dos brechas no son intercambiables porque las configuraciones de evaluación difieren.
Qué aún nos dicen los benchmarks de OpenAI sobre GPT-5.6 Sol
Las evaluaciones de lanzamiento de OpenAI aportan contexto adicional sobre las capacidades de GPT-5.6 Sol. Son anteriores a los resultados cara a cara más nuevos discutidos arriba, por lo que no deben usarse como comparación directa con Fable 5.1.
OpenAI informa 88.8% en Terminal-Bench 2.1 para GPT-5.6 Sol. Eso es evidencia de una fuerte capacidad de codificación agente bajo la configuración de lanzamiento; la versión de benchmark más antigua no debe compararse numéricamente con las puntuaciones de Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 para programación
Para generación de código directa, cualquiera de los modelos está sobrado para muchas cargas de producción. La separación se hace más clara cuando la programación se convierte en ingeniería de software agente: inspeccionar un repositorio grande, editar múltiples archivos, ejecutar comandos, diagnosticar fallos, escribir pruebas e iterar hasta que la tarea pase.
Aquí, Claude Fable 5.1 tiene el caso de benchmark actual más sólido. Lidera tanto la comparación de Terminal-Bench 4.0 del proveedor como la independiente, y el resultado de CursorBench de Anthropic también lo favorece 73.4% vs 67.2%.
Para una evaluación práctica de programación, incluye cambios en todo el repositorio, pruebas, revisión y rendimiento. Un snippet corto de código exitoso es un indicador débil de completar una tarea que abarca varios archivos e intentos fallidos.
GPT-5.6 Sol sigue siendo convincente cuando el entorno de ejecución circundante importa tanto como la calidad del modelo. El soporte nativo para shell execution, apply-patch, code interpreter, file search, computer use y MCP puede reducir la cantidad de infraestructura de orquestación que tienes que construir tú mismo.
Veredicto de programación: elige Fable 5.1 cuando tus evaluaciones enfatizan el trabajo autónomo más difícil a nivel de repositorio. Elige GPT-5.6 Sol cuando una capacidad de benchmark ligeramente menor sea aceptable a cambio de menor costo y un amplio stack de ejecución integrado.
Controles de razonamiento y experiencia del desarrollador
Las dos APIs exponen la inteligencia de manera diferente.
El rango de razonamiento de Sol, de ninguno a máximo, permite a un equipo probar calidad y demora en varios ajustes. Un esfuerzo menor puede reducir trabajo de razonamiento, pero el ajuste correcto depende del costo del fallo de la tarea.
El pensamiento adaptativo siempre activo de Fable hace que la afinación del esfuerzo sea un ejercicio diferente. Compara configuraciones que tu aplicación desplegará en lugar de tratar etiquetas de esfuerzo idénticas como presupuestos de cómputo idénticos.
Por consiguiente, no hay comparación universalmente justa entre “Sol por defecto” y “Fable por defecto”. Sus configuraciones de razonamiento predeterminadas difieren. Las evaluaciones de producción deberían comparar presupuestos de esfuerzo equivalentes o los ajustes exactos que tu aplicación desplegará realmente.
GPT-5.6 Sol vs Fable 5.1: ¿Cuál es mejor para agentes de IA?
La elección depende de si el cuello de botella es el razonamiento difícil o el runtime que lo rodea.
La ventaja de Fable en los benchmarks citados de terminal, automatización y trabajo profesional lo convierte en candidato sensato para las tareas más difíciles. Mide la tasa de finalización y la recuperación de pasos fallidos antes de generalizar esa ventaja a tu agente.
El portafolio de herramientas documentado de Responses de GPT-5.6 Sol lo hace atractivo para aplicaciones construidas alrededor de búsqueda, archivos, ejecución de shell y parches. Esa es una ventaja de integración a evaluar junto con la precisión de la tarea, no un sustituto.
| Requisito del agente | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Razonamiento difícil de largo horizonte | Excelente | Mejor ajuste |
| Autonomía en terminal/repositorio | Excelente | Evidencia más fuerte |
| Portafolio nativo de herramientas | Más fuerte | Fuerte |
| Selección forzada de herramienta | Soportada; revisa la API elegida | Restringida; revisa modos de tool_choice |
| Integración de plataforma multiagente | Ventaja sólida | Disponible vía arquitectura de agentes |
| Comunicación de progreso en trabajos largos | Buena | Comportamiento central |
| Agentes de alto volumen sensibles al costo | Mejor | Premium |
| Contexto masivo en caché repetido | Bueno | Potencialmente muy atractivo |
Usar ambos puede ser económico cuando solo una pequeña parte de las tareas necesita escalación. Mide si las finalizaciones adicionales exitosas compensan el mayor precio y la demora de inicio del segundo modelo.
Contexto largo: 1.05M vs 1M no es la diferencia importante
Los números principales lucen casi idénticos: GPT-5.6 Sol ofrece 1.05M tokens y Fable ofrece 1M. Una diferencia de capacidad del 5% probablemente no determine si puedes analizar un repositorio grande, un corpus legal, un archivo de investigación o un historial de agente de varias horas. Ambos ya están en la clase de millón de tokens.
Para GPT-5.6 Sol, la entrada por encima de 272K activa tasas más altas de contexto largo para la solicitud: $8/MTok entrada, $0.80/MTok entrada en caché y $30/MTok salida. Las escrituras de caché también suben de $5 a $10/MTok.
Fable 5.1 mantiene sus tasas estándar de contexto 1M: $10/MTok entrada, $50/MTok salida y $0.25/MTok lecturas de caché. No hay una prima separada por encima de 272K en esta configuración documentada.
Considera un turno con 100K tokens de entrada no en caché, 900K tokens de lectura de caché y 20K tokens de salida totales facturados. GPT-5.6 Sol cuesta 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 cuesta 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Este turno intensivo en caché casi cierra la brecha de precio porque Fable tiene lecturas de caché más baratas. El resultado depende de la mezcla de tokens de la carga; no significa que los dos modelos cuesten lo mismo para una sesión completa de agente.
Supuestos de costo: el prefijo de 900K tokens ya está en caché, y los 100K de entrada nueva no se facturan como una nueva escritura de caché. La estimación excluye la escritura inicial de caché y tarifas de herramientas. La previsión de 20K de salida incluye toda salida facturada, incluidas las tokens de razonamiento facturadas.
Precios: Sol gana cargas ordinarias, Fable gana una métrica importante de caché
Con las tasas verificadas, Sol cuesta $4 entrada / $20 salida por MTok, con $0.40 lecturas de caché. Fable 5.1 cuesta $10 entrada, $50 salida y $0.25 lecturas de caché. La tabla separa precios del proveedor de las tasas de GPT-5.6 Sol API en CometAPI y Claude Fable 5.1 API en CometAPI.
| Componente de precio | Precios oficiales GPT-5.6 Sol | Precios oficiales Claude Fable 5.1 |
|---|---|---|
| Entrada oficial / MTok | $4.00 | $10.00 |
| Salida oficial / MTok | $20.00 | $50.00 |
| Lectura de caché oficial / MTok | $0.40 | $0.25 |
| Escritura de caché oficial / MTok | $5.00 (30 minutos) | $12.50 (5 minutos) |
| Por encima de 272K entrada: entrada / lectura caché / escritura caché / salida | $8 / $0.80 / $10 / $30 | Mismas tasas base documentadas |
| CometAPI entrada / MTok | $3.20 | $8.00 |
| CometAPI salida / MTok | $16.00 | $40.00 |
Las duraciones de escritura de caché difieren: Sol usa un periodo de retención predeterminado de 30 minutos, mientras que la tasa mostrada de Fable 5.1 es para una escritura de 5 minutos. Revisa la creación, actualización y expiración de caché para el proveedor y la ruta que uses realmente.
Con las tasas del proveedor directo verificadas, Fable 5.1 cuesta 2.5× más que Sol tanto para entrada no en caché ($10 vs $4/MTok) como para salida ($50 vs $20/MTok). Trata estas tasas verificadas como una comparación fechada, ya que las promociones de los proveedores y los precios de gateway pueden cambiar.
Una solicitud de contexto corto con 100K de entrada y 10K de salida total facturada cuesta alrededor de $0.60 con Sol o $1.50 con Fable a tasas del proveedor directo. Con las tasas de CometAPI mostradas arriba, la misma mezcla cuesta $0.48 o $1.20. Estos ejemplos excluyen escrituras de caché y tarifas de herramientas.
La tasa de lectura de caché de contexto corto de Fable es 37.5% más baja: ($0.40 − $0.25) ÷ $0.40. Eso puede importar para agentes que reutilizan un prefijo grande y estable, pero el ahorro total aún depende de la entrada fresca, frecuencia de escritura y volumen de salida.
Veredicto de precios: Sol es el punto de partida más barato para tráfico de contexto fresco. Fable se vuelve más competitivo a medida que crece la proporción de lecturas de caché; compara el costo de la sesión completa, incluyendo la creación y actualización de la caché.
Velocidad y latencia
Las pruebas a esfuerzo máximo pueden dedicar tiempo sustancial a razonar antes del primer token visible.
Las mediciones de rendimiento y latencia del 8 de septiembre muestran 69.9 tokens/s de salida para Fable y 69.8 para Sol. El tiempo hasta el primer token es 277.47 segundos frente a 132.10 segundos. El rendimiento de salida es prácticamente igual; Sol empieza a producir salida visible antes en esta configuración.
Son mediciones de benchmark a esfuerzo máximo, no latencia prometida para cada llamada de API. La longitud del prompt, configuración de razonamiento, carga del proveedor, herramientas y estado de la caché pueden cambiar el resultado. El tiempo hasta el primer token y el tiempo total de respuesta son métricas diferentes.
Para trabajo interactivo, la menor demora de inicio observada puede favorecer a Sol. Para investigación asincrónica o trabajo sobre repositorios nocturno, la finalización exitosa puede importar más que esperar el primer token. Haz benchmark de ambos modelos con los ajustes y la concurrencia que planeas usar.
Las salvaguardas son una diferencia de producción
Ambos modelos aplican salvaguardas más fuertes porque sus capacidades se extienden a dominios sensibles de ciberseguridad y ciencia, pero las implementan de manera diferente.
OpenAI describe protecciones y monitoreo en capas para la familia GPT-5.6. Las aplicaciones en dominios sensibles deberían evaluar las salvaguardas relevantes como parte de su comportamiento de despliegue.
Los términos de redireccionamiento y retención de Anthropic describen el enrutamiento de algunas solicitudes sensibles de ciberseguridad o biología a modelos menos capaces, sin cobrar la tarifa de Fable para esas solicitudes redirigidas. El periodo de retención de datos predeterminado es de 30 días, con excepciones para acuerdos empresariales elegibles.
Para programación y trabajo de conocimiento ordinarios, estas diferencias pueden no aparecer nunca. Para productos de seguridad, cargas reguladas o despliegues sensibles a la privacidad, pertenecen a la lista de verificación de evaluación junto con calidad de benchmark y precio.
¿Qué modelo deberías elegir?
La comparación general puede reducirse a la forma de la carga.
| Carga | GPT-5.6 Sol | Claude Fable 5.1 | Recomendación |
|---|---|---|---|
| Codificación autónoma difícil | Excelente | Benchmarks actuales más fuertes | Fable 5.1 |
| Investigación de largo horizonte | Excelente | Fortaleza central | Fable 5.1 |
| API de frontera de alto volumen | Mucho más barato | Costoso | Sol |
| Asistente de código interactivo | TTFT medido menor a máximo esfuerzo | TTFT medido mayor a máximo esfuerzo | Prueba ajustes desplegados |
| Agente de API intensivo en herramientas | Stack nativo más amplio | Fuerte | Sol |
| Agente con contexto en caché de millón de tokens | Competitivo | Precio de lectura de caché muy bajo | Prueba ambos |
| Máxima calidad de razonamiento | Excelente | Ventaja independiente | Fable 5.1 |
| Costo por solicitud ordinaria | Ventaja clara | Premium | Sol |
| Razonamiento de imagen/documento | Fuerte | Fuerte | Prueba en tu carga |
| Stack de un solo proveedor OpenAI | Ajuste natural | Requiere migración/gateway | Sol |
| Enrutamiento independiente del modelo | Fuerte | Fuerte | Usa ambos vía CometAPI |
Una política de enrutamiento debería justificar su complejidad. Compara una base de un solo modelo con una política Sol-primero que escale tareas difíciles a Fable 5.1, y mantén el router solo si mejora el costo por tarea exitosa a la calidad requerida.
Cómo comparar GPT-5.6 Sol y Fable 5.1 mediante CometAPI
CometAPI ya integra GPT-5.6 Sol y Claude Fable 5.1. Accede a ambos modelos con sus formatos de solicitud nativos, envía el mismo conjunto de evaluación y compara los resultados devueltos bajo ajustes igualados.
Usa solicitudes en formato nativo para cada modelo y mantén constantes prompts, datasets, ajustes de esfuerzo, concurrencia y reglas de puntuación. Repite las ejecuciones; una única solicitud secuencial por modelo no basta para estimar latencia o calidad fiables.
Para una evaluación de producción, usa un conjunto de prompts fijo, repite ejecuciones en orden alternado, registra el ajuste de esfuerzo y puntúa corrección, tasa de pruebas superadas, éxito de herramientas, reintentos, uso de tokens, tiempo transcurrido y costo total por tarea exitosa. Ajusta cada modelo por separado después de la base común.
Veredicto final: ¿GPT-5.6 Sol o Claude Fable 5.1?
Fable 5.1 tiene evidencia directa más sólida para la codificación autónoma más difícil y trabajo de largo horizonte. Lidera las cinco filas compartidas de benchmarks del proveedor y la comparación independiente fechada de terminal. Eso lo convierte en un candidato de escalación fuerte, sujeto a validación en tus propias tareas.
Sol tiene precios de tokens ordinarios más bajos, controles de razonamiento más finos y un amplio stack nativo de herramientas. En la configuración independiente verificada a máximo esfuerzo, también tiene menor tiempo hasta el primer token; el rendimiento de salida está prácticamente empatado.
Prioriza Fable 5.1 cuando las tareas autónomas más difíciles determinen tu tasa de éxito. Comienza con Sol para inferencia de frontera consciente del costo o aplicaciones intensivas en herramientas. Para cargas interactivas, prueba los ajustes de esfuerzo desplegados para confirmar si persiste su ventaja observada de demora de inicio.
Elige un solo modelo cuando cumpla tus requisitos de forma simple. Añade enrutamiento cuando los resultados de evaluación muestren que alternar entre ambos mejora la calidad o el costo por tarea exitosa.
FAQ
¿Claude Fable 5.1 es mejor que GPT-5.6 Sol?
Tiene un Intelligence Index independiente más alto en la instantánea del 8 de septiembre: 53, frente a 47 de Sol. También lidera la prueba independiente fechada de terminal. Eso respalda una ventaja de calidad en estas evaluaciones, no una afirmación de que sea mejor para todas las cargas.
¿GPT-5.6 Sol es más barato que Claude Fable 5.1?
Para tráfico ordinario de API sin caché, sí: las tasas verificadas del proveedor directo son $4/$20 por MTok para Sol y $10/$50 para Fable 5.1. Las cargas intensivas en caché pueden reducir esa brecha porque la tasa de lectura de caché de Fable es menor. Incluye el comportamiento de escritura y expiración en la estimación.
¿Qué modelo es mejor para programación?
Fable 5.1 tiene evidencia de benchmark más fuerte en programación autónoma en esta comparación. Sol sigue siendo atractivo para flujos de menor costo y sus herramientas de ejecución integradas. Usa tareas de repositorio con pruebas ejecutables para decidir si la brecha de capacidad medida importa para tu aplicación.
¿Qué modelo tiene una ventana de contexto mayor?
Sol lidera técnicamente con 1.05M frente a los 1M tokens de Fable 5.1, mientras que ambos permiten hasta 128K de salida. En la práctica, el umbral de precios de Sol >272K y las lecturas de caché económicas de Fable suelen ser más importantes que la diferencia de capacidad de 50K tokens.
¿Puedo acceder a ambos modelos mediante CometAPI?
Sí. La GPT-5.6 Sol API en CometAPI y la Claude Fable 5.1 API en CometAPI ofrecen un punto de partida común para evaluaciones de texto. Revisa el soporte de razonamiento, caché y herramientas específicos de la ruta antes de extender la base a un agente de producción.