
TLDR Los benchmarks filtrados y las pruebas encubiertas en Arena.ai a mediados de septiembre de 2026 sitúan al aún inédito Gemini 4 Pro de Google como el nuevo líder en la frontera, superando a GPT-6 Astra y Claude Fable 5.1 en ingeniería de software, tareas agénticas, trabajo de conocimiento, razonamiento y benchmarks multimodales.
Puntos clave
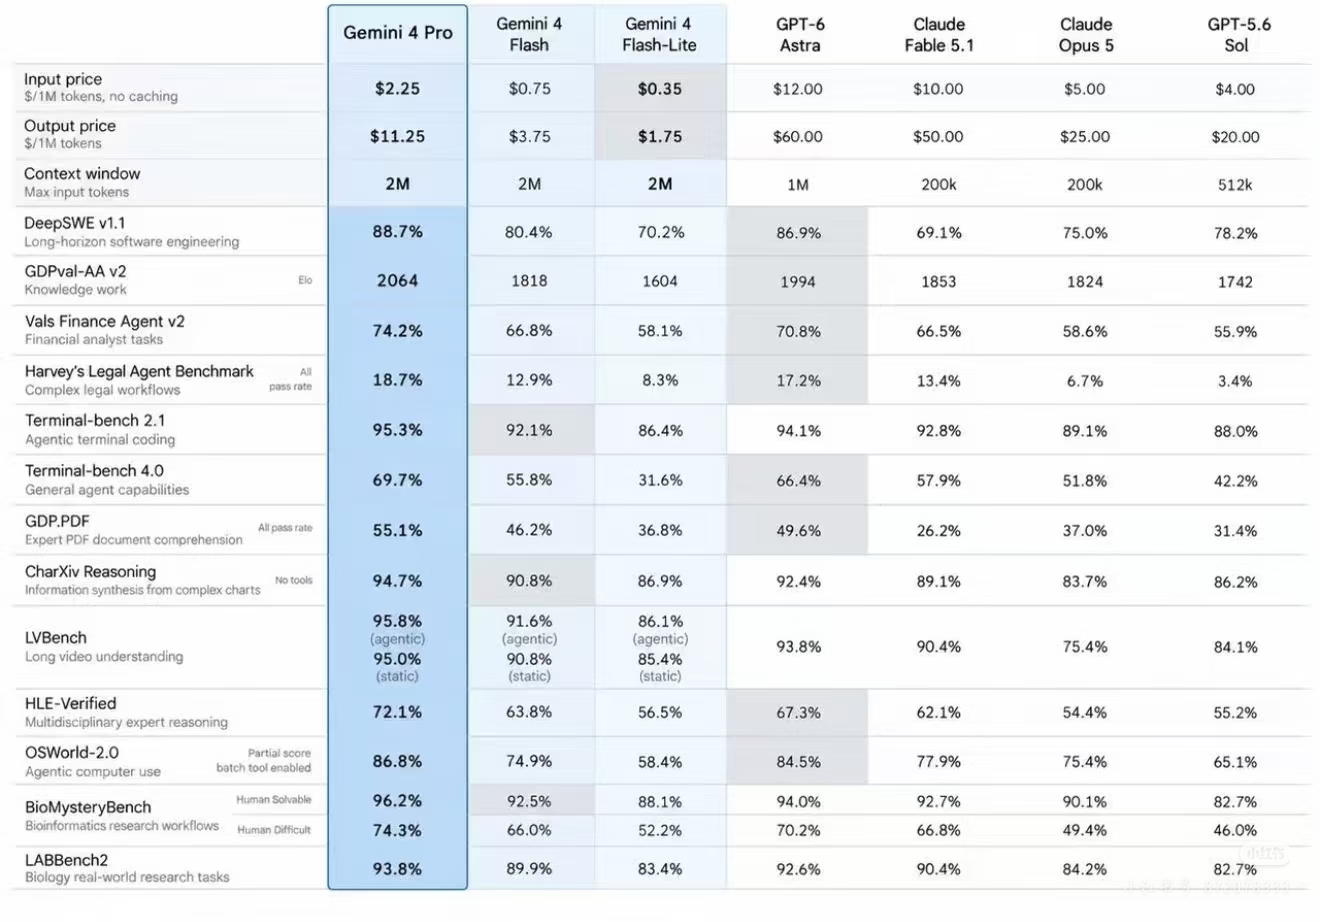
- Gemini 4 Pro encabeza las evaluaciones filtradas en DeepSWE v1.1 (88.7%), GDPval-AA v2 (2064 Elo), Terminal-bench 2.1 (95.3%), OSWorld-2.0 (86.8%) y múltiples otras suites agénticas/de razonamiento.
- Se sitúa por debajo de GPT-6 Astra ($12/$60) y Claude Fable 5.1 ($10/$50) en precio de lista, al tiempo que iguala o supera sus ventanas de contexto de clase 1M.
- Las pruebas encubiertas en Arena.ai bajo nombres de marcador de posición (p. ej., gemini-3.8-flash) han producido demostraciones destacadas de SVG, Three.js y codificación agéntica.
- Circulan rumores sobre RSI (auto-mejora recursiva), pero carecen de evidencia pública de una mejora autónoma en bucle cerrado del propio Gemini 4.
- Google ha confirmado una fuerte inversión en un modelo base Gemini 4 más grande; el calendario de lanzamiento público sigue sin ser oficial.
- Plataformas como CometAPI ya agregan Gemini, GPT-6 Astra, Claude Fable/Opus y cientos de otros modelos detrás de un único endpoint compatible con OpenAI a tarifas competitivas, ideal para evaluar la nueva frontera en cuanto se lance.
¿Qué sabemos sobre Gemini 4? (filtraciones, fuentes y contexto verificado)
A fecha del 20 de septiembre de 2026, Google no ha hecho un anuncio oficial de Gemini 4 Pro, ni ha publicado una ficha del modelo ni un endpoint público de API. Todo lo que va más allá de las declaraciones previas de Google sobre la inversión en un “modelo base Gemini 4 más grande” (resultados de julio de 2026) proviene de filtraciones de la comunidad, pruebas a ciegas en Arena.ai y tablas de benchmarks que circulan.
Entre las fuentes y afirmaciones clave se incluyen:
- El filtrador Pankaj Kumar y publicaciones posteriores (a principios y mediados de septiembre) mencionan un checkpoint interno Pro con lanzamiento público previsto para octubre y una posible variante Flash-Lite antes.
- Varios desarrolladores informaron haber utilizado un modelo de alta capacidad etiquetado como “gemini-3.8-flash” (u otros marcadores similares) en Arena.ai. Las salidas incluían generación compleja de SVG (p. ej., un pelícano en bicicleta, mariposas mecánicas en Three.js), generación de JSON largo no repetitivo y un fuerte comportamiento agéntico. Algunos usuarios mencionaron detalles del backend como contexto de varios millones de tokens, límites de salida de 256k, memoria entre sesiones y capacidades nativas de herramientas/internet.
- Una tabla comparativa ampliamente difundida lista a Gemini 4 Pro frente a Gemini 4 Flash, Gemini 4 Flash-Lite, GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 y GPT-5.6 Sol.
- Google no ha confirmado las pruebas en Arena ni la tabla. El patrón histórico muestra que la compañía suele realizar evaluaciones encubiertas en plataformas públicas semanas antes de los lanzamientos formales.
Ventana de contexto
La tabla filtrada muestra 2M de tokens máximos de entrada para la familia Gemini 4, el doble del 1M de GPT-6 Astra y muy por encima de los 200k de la línea Claude Fable/Opus 5 (algunas variantes de Claude han ofrecido ventanas efectivas mayores mediante otros mecanismos). Reclamaciones separadas de “enrutamiento fantasma” mencionaron techos de 10M; esto sigue sin verificarse.
Precio de Gemini 4 (cifras filtradas)
La tabla en circulación muestra:
- Gemini 4 Pro: $2.25 entrada / $11.25 salida por 1M de tokens (sin caché).
- Gemini 4 Flash: $0.75 / $3.75.
- Gemini 4 Flash-Lite: $0.35 / $1.75.
Estas cifras son sustancialmente inferiores a los $12/$60 reportados de GPT-6 Astra y los $10/$50 de Claude Fable 5.1 (Fable 5.1 ofrece agresivos descuentos en lecturas desde caché que pueden reducir el coste efectivo para cargas agénticas). El precio oficial actual de Gemini 3.x Pro se sitúa en el rango de $2–$4 de entrada / $12–$18 de salida según la longitud de contexto, por lo que los números filtrados del Pro son plausibles como ajuste de próxima generación.
El precio público real solo se conocerá en el lanzamiento. Históricamente, Google ha utilizado tarifas de tokens competitivas y niveles gratuitos para impulsar la adopción.
Rendimiento de Gemini 4 Pro: análisis en profundidad de benchmarks filtrados
La tabla en circulación sitúa a Gemini 4 Pro en la cima de casi todas las categorías. Estos números son no oficiales y no han sido verificados por Google ni por laboratorios independientes en el momento de escribir esto. Deben tratarse como señales direccionales más que clasificaciones definitivas.
Ingeniería de software y codificación agéntica
- DeepSWE v1.1 (ingeniería de software de largo horizonte): 88.7% (frente a GPT-6 Astra 86.9%, Claude Fable 5.1 69.1%, Claude Opus 5 75.0%).
- Terminal-bench 2.1 (codificación agéntica en terminal): 95.3% (frente a Astra 94.1%, Fable 92.8%).
- Terminal-bench 4.0 (capacidades generales de agentes): 69.7% (la mayor brecha relativa frente a Flash y competidores).
Trabajo de conocimiento y tareas profesionales
- GDPval-AA v2 (Elo, trabajo de conocimiento): 2064 (único modelo por encima de 2000; Astra 1994, Fable 1853).
- Vals Finance Agent v2: 74.2%.
- Benchmark legal de Harvey (flujos jurídicos complejos, tasa de aprobado total): 18.7%.
Razonamiento, multimodal y especializado
- CharXiv Reasoning (síntesis de información a partir de gráficos complejos, sin herramientas): 94.7%.
- LVBench (comprensión de video largo): 95.8% agéntico / 95.0% estático.
- HLE-Verified (razonamiento experto multidisciplinar): 72.1%.
- OSWorld-2.0 (uso agéntico de computadora, puntuación parcial, herramienta por lotes habilitada): 86.8%.
- BioMysteryBench y LABBench2 (bioinformática y flujos de investigación en biología): puntuaciones líderes tanto en subconjuntos resolubles por humanos como en los difíciles.
Estos resultados, si son direccionalmente precisos, muestran una fortaleza particular en cargas agénticas de largo horizonte, de múltiples pasos y con uso de herramientas, el área exacta donde GPT-6 Astra y Claude Fable 5.1 se posicionaron como líderes tras sus lanzamientos de principios de septiembre.
Las pruebas cualitativas en Arena refuerzan este panorama: las generaciones complejas de SVG y Three.js del modelo encubierto han sido juzgadas como superiores o muy competitivas frente a Astra en comparativas lado a lado de la comunidad.
¿Cómo funcionará Gemini 4?
Gemini 4 (Pro) aún no está lanzado, por lo que cualquier descripción de “cómo funcionará” se basa necesariamente en las declaraciones oficiales de Google, los limitados detalles filtrados sobre un checkpoint interno temprano, la trayectoria de la serie Gemini 3.x y deducciones de ingeniería razonables. Nada de lo siguiente debe tratarse como especificaciones confirmadas.
Enfoque de entrenamiento básico y escala
Google ha descrito Gemini 4 como su “ejecución de preentrenamiento más ambiciosa hasta la fecha”, construida sobre un modelo base significativamente más grande que generaciones anteriores. El objetivo explícito es mantenerse competitivo en la frontera, especialmente en codificación y agentes autónomos.
Esto implica:
- Un mayor número de parámetros o una capacidad más efectiva (mediante mezcla de expertos [MoE], mejor esparsidad o escalado más denso).
- Mayor inversión de cómputo durante el preentrenamiento.
- Énfasis continuo en datos de entrenamiento multimodales (texto, imagen, video, audio, código, trayectorias de uso de herramientas).
Se espera que el modelo sirva como una nueva base de alta capacidad a partir de la cual puedan derivarse posteriormente variantes tipo Flash más rápidas.
Estilo de inferencia y razonamiento
Las descripciones filtradas de un checkpoint temprano “argon” mencionan un modo de alto esfuerzo de pensamiento que tardaba aproximadamente 2.4 minutos para una sola generación y admitía un límite de salida dramáticamente más alto (reportado en 256k tokens frente a los ~64k previos).
Esto apunta a:
- Rutas de razonamiento opcionales intensivas en cómputo (similares en espíritu a modos de pensamiento extendido o “esfuerzo máximo” en modelos competidores).
- Capacidad de dedicar más cómputo interno a problemas difíciles antes de producir una respuesta.
- Mejor soporte para salidas largas y coherentes como bases de código completas, planes de múltiples pasos o informes extensos.
Es probable que los usuarios puedan controlar la compensación entre velocidad/coste y profundidad de razonamiento, como ya pueden hacerlo con los modelos actuales Gemini Flash que ofrecen niveles de pensamiento bajo/medio/alto.
Áreas clave de enfoque de capacidades
Basado en las declaraciones públicas de Sundar Pichai y la trayectoria de desarrollo:
- Codificación e ingeniería de software Rendimiento de largo horizonte más sólido: refactors multiarchivo, depuración en repositorios, bucles de autocorrección y mayores tasas de finalización en tareas de software realistas.
- Comportamiento autónomo/agéntico Mejor capacidad para planificar, usar herramientas, observar resultados intermedios, recuperarse de errores y continuar hacia un objetivo durante muchos pasos. Esto se construye directamente sobre las funciones de uso de computadora y agénticas presentes en Gemini 3.5/3.8 Flash.
- Fiabilidad en contextos largos Informes de la comunidad mencionan objetivos en el rango de 1.5 millones de tokens (o más). La meta práctica no es solo ventanas más grandes sino mejor fidelidad de recuperación y menos degradación al trabajar con documentos muy largos, bases de código o trazas de agentes de varias horas.
- Comprensión y generación multimodal Manejo nativo de texto + imagen + video + audio, con previsibles avances en razonamiento espacial, comprensión de video e interacciones en tiempo real de voz/agente (sobre la base de los modelos Gemini 3.8 Live de septiembre de 2026).
- Uso de herramientas y salidas estructuradas Invocación de funciones más robusta, ejecución de código, fundamentación en búsquedas y salidas estructuradas tipo JSON/XML para una integración fiable en aplicaciones y agentes.
En qué difiere de Gemini 3.x
- Escala: Modelo base explícitamente más grande en lugar de un refinamiento incremental.
- Capacidad de salida: Límites de tokens más altos filtrados que permiten generaciones más largas en una sola pasada.
- Profundidad de razonamiento: Modos de alto esfuerzo más pronunciados para problemas difíciles.
- Enfoque agéntico: Mayor énfasis en trabajo autónomo sostenido y de múltiples pasos en lugar de tareas de un solo turno o de corto horizonte.
- Posicionamiento: Concebido como el nuevo modelo Pro en la frontera, mientras la línea Flash continúa con iteraciones rápidas para velocidad y eficiencia de costes.
Relación con la auto-mejora recursiva (RSI)
Los ejecutivos de Google han vinculado públicamente el gran gasto de capital en IA de la compañía con el objetivo a largo plazo de la auto-mejora recursiva: sistemas que pueden mejorarse de forma significativa a sí mismos o los procesos que producen la siguiente generación. Investigaciones relacionadas (como el trabajo Dream-RSI) muestran agentes que mejoran sus propias estrategias de exploración sin cambiar los pesos del modelo.
¿Superará Gemini 4 Pro a GPT-6 y Claude Fable 5.1?
| Categoría | Gemini 4 Pro | GPT-6 Astra | Claude Fable 5.1 | Notas |
|---|---|---|---|---|
| Precio entrada/salida | $2.25 / $11.25 | $12.00 / $60.00 | $10.00 / $50.00 | Gemini 4 Pro ~5× más barato que Astra |
| Ventana de contexto | 2M | 1M | 200k | Ventaja significativa para Gemini |
| DeepSWE v1.1 | 88.7% | 86.9% | 69.1% | Fuerte liderazgo en código |
| GDPval-AA v2 (Elo) | 2064 | 1994 | 1853 | Líder en trabajo de conocimiento |
| Terminal-bench 4.0 | 69.7% | 66.4% | 57.9% | Capacidades generales de agentes |
| OSWorld-2.0 | 86.8% | 84.5% | 77.9% | Uso de computadora |
| HLE-Verified | 72.1% | 67.3% | 62.1% | Razonamiento experto |
| LVBench (video) | 95.8% / 95.0% | 93.8% | 90.4% | Fortaleza multimodal |
| Investigación Bio/LAB | Puntuaciones más altas | Sólido | Competitivo | Flujos de trabajo científicos |
Gemini 4 Pro encabeza cada fila importante de la tabla, a menudo por un margen significativo, mientras que su precio declarado es mucho más agresivo que el de GPT-6 Astra o Claude Fable 5.1.
Advertencias importantes
- Esta tabla no es un lanzamiento oficial de Google. A fecha del 20 de septiembre de 2026, Google aún no ha publicado una ficha del modelo, un endpoint de API, precios ni benchmarks confirmados para Gemini 4 Pro. Los números provienen de fuentes comunitarias / avistamientos en Arena / filtraciones de checkpoints internos (relacionados con el nombre en clave “argon”).
- Algunas hojas que circularon anteriormente fueron posteriormente señaladas como predicciones o parcialmente copiadas. Trate cada porcentaje específico y los precios como no verificados hasta que Google los confirme.
- La ventana de contexto de Claude Fable 5.1 se lista aquí como 200k, inferior a la cifra de 1M reportada comúnmente en la documentación oficial de Anthropic. Esto puede reflejar una configuración de evaluación específica o un error en la hoja filtrada.
- GPT-6 Astra y Claude Fable 5.1 siguen siendo, por ahora, los únicos modelos de frontera totalmente públicos y evaluados de forma independiente. Artificial Analysis y otros rastreadores de terceros aún los muestran como muy parecidos en términos generales (con fortalezas diferentes).
Realidad práctica actual (20 de septiembre de 2026)
| Modelo | Estado | Mejor para | Nivel de precio |
|---|---|---|---|
| Gemini 4 Pro | Sin lanzar (se afirma que es fuerte) | Contexto largo, código, agentes, multimodalidad, coste | Muy agresivo (afirmado) |
| GPT-6 Astra | Lanzado | Matemáticas, uso de computadora, terminal, automatización, ciber | Premium |
| Claude Fable 5.1 | Lanzado | Agentes de largo recorrido, razonamiento, calidad de código, eficiencia de caché | Premium |
| Gemini 4 Flash / Flash-Lite | Supuestos hermanos | Velocidad + cargas sensibles al coste | Extremadamente bajo |
Conclusiones rápidas
- Dominante en todos los ámbitos: Gemini 4 Pro ocupa el puesto n.º 1 en cada categoría listada, a menudo por un margen claro.
- Fortalezas particulares: codificación/agentes de largo horizonte (DeepSWE, Terminal-bench), trabajo de conocimiento, multimodal (video + gráficos) y dominios especializados (finanzas, legal, biología, uso de computadora).
- Posicionamiento de precio: aproximadamente 1/5 del precio de GPT-6 Astra y Claude Fable 5.1 en entrada y salida, ofreciendo puntuaciones superiores.
Astra enfatiza el uso de computadora, umbrales de ciberseguridad y descubrimiento científico; Fable 5.1 enfatiza trabajo de conocimiento de larga duración y codificación con salvaguardas refinadas y menores costes de lectura de caché. El perfil filtrado de Gemini 4 Pro parece más fuerte en ingeniería de software agéntica de amplio espectro y razonamiento multimodal.
Cómo pueden prepararse los desarrolladores: recomendaciones de CometAPI
Mientras se espera el acceso oficial a Gemini 4 Pro, los equipos se benefician de una pasarela unificada que ya admite la frontera actual (serie Gemini 3.x, GPT-6 Astra, Claude Fable 5.1 / Opus 5 y más de 500 modelos). CometAPI ofrece exactamente eso: un único endpoint compatible con OpenAI, una sola clave de API, facturación de pago por uso normalmente un 20–40% por debajo de las tarifas directas de los proveedores y la posibilidad de cambiar de modelo con un solo parámetro.
Flujo de trabajo práctico:
- Prototipe pipelines agénticos con los actuales Gemini Flash/Pro, GPT-6 Astra y Claude Fable 5.1 vía CometAPI.
- Compare los mismos prompts en distintos modelos para establecer líneas base.
- Cuando Gemini 4 Pro (y sus variantes Flash) aparezcan en el catálogo de CometAPI —históricamente la plataforma añade rápidamente nuevos modelos de Google—, cambie el ID de modelo y vuelva a ejecutar las evaluaciones con cambios mínimos de código.
- Use el panel de costes para seguir el gasto de tokens entre proveedores y enrute el tráfico de alto volumen o sensible a la latencia al modelo más económico y capaz.
Este enfoque elimina la gestión de múltiples claves, reduce el riesgo de bloqueo de proveedor y posiciona a los equipos para adoptar Gemini 4 Pro el primer día de disponibilidad pública.
Gemini 4 Pro, si las filtraciones resultan direccionalmente correctas, representa la apuesta más fuerte de Google hasta la fecha para recuperar la frontera en ingeniería de software agéntica y razonamiento multimodal de contexto largo. La combinación de rendimiento declarado, gran contexto y precios agresivos lo convertiría en una opción por defecto para muchas cargas en producción. Hasta que lleguen el lanzamiento oficial y las evaluaciones independientes, el camino prudente es la evaluación continua entre los modelos de frontera existentes, algo que ya es sencillo a través de plataformas que unifican el acceso. Esté atento al anuncio formal; es probable que las próximas semanas aclaren cuánto del bombo se traduce en realidad de producción.
Preguntas frecuentes
¿Se ha lanzado Gemini 4 Pro?
No. Según el catálogo más reciente y las declaraciones de Google (de mediados a finales de septiembre de 2026), aún no se ha lanzado públicamente ni figura con un ID de modelo oficial.
¿Cuál es la fecha de lanzamiento prevista de Gemini 4 Pro?
Los filtradores apuntan a octubre de 2026 (con algo de especulación para finales de septiembre). Google no ha dado una fecha oficial. Considérelo una ventana pendiente de confirmación vía catálogo de API o entrada de blog.
¿Logró Google RSI con Gemini 4 Pro?
La evidencia pública muestra uso avanzado de bucles agénticos para el refinamiento del modelo e investigación sobre mejora recursiva a nivel de estrategia (p. ej., Dream-RSI). Las afirmaciones de RSI completo que haya producido el modelo no están respaldadas por verificación independiente.
¿Cómo se compara con GPT-6 Astra y Claude Fable 5.1 en benchmarks?
Gráficos de la comunidad filtrados afirman ventajas en varias suites de agentes/código. Aún no existen puntuaciones oficiales independientes para un Gemini 4 Pro lanzado. Los datos públicos actuales favorecen evaluar los modelos en vivo (Astra y Fable 5.1) en sus tareas.
¿Debería esperar a Gemini 4 Pro antes de construir?
No. Lance con los modelos más fuertes disponibles hoy (accesibles vía CometAPI o APIs directas), mantenga listos sus conjuntos de evaluación y adopte el nuevo modelo si y cuando las pruebas independientes e internas justifiquen el cambio.
¿Dónde puedo acceder fácilmente a los modelos de frontera actuales?
Proveedores unificados como CometAPI ofrecen acceso compatible con OpenAI a la clase GPT-6 Astra, Claude Fable 5.1, los modelos actuales de Gemini y otros, con facturación simplificada y cambios sencillos. Consulte la lista de modelos en vivo y la documentación para los últimos IDs y precios.