
TL;DR
MiniMax H3 Max no es un modelo fundacional completamente nuevo que reemplace a MiniMax H3. Es una variante de H3 con posentrenamiento creada por fal Research, usando los pesos abiertos de H3 y posentrenamiento adicional centrado en fidelidad al prompt, estética visual y eficiencia de inferencia.
Esa distinción explica la mayoría de las diferencias entre los dos modelos. MiniMax H3 Max está optimizado para inferencia rápida en producción y mayor fidelidad al prompt, mientras que MiniMax H3 sigue siendo el sistema omni‑modal más amplio, incluyendo un condicionamiento multimodal más rico, flujos de trabajo de edición de video y salida de hasta 2K mediante H3-Regenerate-2K.
A fecha del 18 de septiembre de 2026, datos de preferencia independientes muestran a H3 Max con 1227 Elo en texto a video con audio frente a 1220 de H3, y 1195 Elo en imagen a video con audio frente a 1181 de H3. Las diferencias son lo bastante significativas como para hacerles seguimiento, pero no lo suficiente como para implicar una diferencia de calidad dramática en cada prompt.
Puntos clave
- H3 Max es una variante de H3 con posentrenamiento, no H4 ni una arquitectura H3 mayor. fal partió de los pesos abiertos de MiniMax H3 y optimizó el modelo y el stack de serving en conjunto.
- La velocidad es el diferenciador más claro de H3 Max. fal reporta aproximadamente tres segundos o menos para una generación de cinco segundos a 768p en su infraestructura optimizada.
- H3 Max lidera actualmente a H3 en las dos pruebas de preferencia independientes directamente comparables usadas aquí. La última instantánea muestra +7 Elo en texto a video con audio y +14 Elo en imagen a video con audio.
- MiniMax H3 sigue siendo el flujo de trabajo fundacional más amplio. Admite referencias multimodales más ricas, edición, pesos abiertos H3-Base y regeneración a 2K.
- La resolución es una distinción importante.H3 Max expone generación a 480p/768p más refinamiento latente a 1080p, mientras que H3 puede alcanzar 2K a través de H3-Regenerate-2K.
¿Qué es MiniMax H3 Max?
MiniMax H3 Max es un modelo de generación de video por IA desarrollado por fal Research mediante el posentrenamiento de los pesos abiertos de MiniMax H3. En lugar de reemplazar la arquitectura H3 subyacente con un modelo fundacional completamente nuevo, fal se concentró en fidelidad al prompt, estética y rendimiento de inferencia.
La palabra “Max” puede ser engañosa si se interpreta como un nivel convencional de mayor número de parámetros. Los materiales públicos no establecen un Transformer más grande ni una nueva escala de parámetros para H3 Max. La diferenciación proviene principalmente del posentrenamiento y de un stack de serving diseñado en torno al modelo modificado.
fal también describe nuevos conjuntos de datos de posentrenamiento sustanciales y bucles de evaluación centrados en la calidad visible para el usuario. En la práctica, H3 Max se entiende mejor como una variante de H3 optimizada para producción, en lugar de un sucesor completamente nuevo.
Especificaciones de MiniMax H3 Max de un vistazo
| Especificación | MiniMax H3 Max |
|---|---|
| Modelo base | MiniMax H3 |
| Desarrollador del posentrenamiento | fal Research |
| Categoría de modelo | Generación de audio y video |
| Texto a video | Sí |
| Imagen a video | Sí |
| Control de primer/último fotograma | Sí |
| Referencia a video | Sí |
| Duración de salida | 5-15 segundos |
| Resolución nativa de generación | 480p / 768p |
| Opción 1080p | Refinamiento latente desde 768p nativo |
| Velocidad de fotogramas | 24 FPS |
| Audio | Audio estéreo sincronizado |
| Relaciones de aspecto | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Optimización principal | Fidelidad al prompt, estética, rendimiento |
| ID de modelo en CometAPI | minimax-h3-max |
El esquema actual del API de fal describe la opción 1080p como refinamiento latente desde una fuente nativa a 768p, lo cual importa al comparar H3 Max con sistemas que regeneran a una resolución genuinamente más alta.
¿Cómo funciona MiniMax H3 Max?
Comprender H3 Max empieza con la base H3 sobre la que se asienta. MiniMax describe H3 como un sistema generativo omnimodal en lugar de una colección de modelos aislados de texto a video, imagen a video, audio y edición.
El flujo completo de H3 se organiza alrededor de H3-Context-IR, H3-Base y H3-Regenerate-2K. H3-Context-IR interpreta instrucciones multimodales de forma libre, H3-Base realiza la generación audiovisual central a 768p, y H3-Regenerate-2K reutiliza el contexto original más el resultado de menor resolución para regenerar una salida de mayor resolución.
La base H3 bajo H3 Max
MiniMax documenta H3-Omni-Transformer como un Transformer denso de flujo único con 33 mil millones de parámetros, con aproximadamente 13B parámetros en ramas relacionadas con AdaLN. El H3-Encoder usa pesos preentrenados Qwen3-VL-32B, mientras que VAE visuales y de audio separados codifican sus respectivas modalidades antes de la generación conjunta.
H3-Omni-Transformer predice conjuntamente latentes de video y audio en lugar de tratar el sonido como una etapa de posprocesamiento separada. Esa arquitectura es la razón por la que tanto H3 como H3 Max pueden producir salida audiovisual sincronizada.
Arquitectura oficial del modelo MiniMax H3
Qué cambió fal para H3 Max
fal posentrenó H3 con datos adicionales dirigidos a la fidelidad a las instrucciones y a la calidad visual, y luego desarrolló el sistema de inferencia junto con el modelo en lugar de optimizar el serving solo después de completar el entrenamiento. El artículo de lanzamiento describe este codesarrollo de modelo e inferencia como la razón central por la que H3 Max puede desplazar la curva de compromiso calidad‑velocidad.
Eso es importante porque simplemente reducir pasos de muestreo o la precisión puede bajar la latencia a costa de degradar la calidad de salida. fal afirma que solo se mantuvieron las optimizaciones candidatas cuando los checkpoints resultantes seguían sosteniéndose en sus evaluaciones de preferencia.
MiniMax H3 proporciona la base de generación multimodal; H3 Max cambia el punto de operación de esa base en la curva calidad‑velocidad‑coste.
¿Cuáles son las principales características de MiniMax H3 Max?
Mayor fidelidad al prompt
La fidelidad al prompt fue un objetivo directo del posentrenamiento. Esto importa para prompts estructurados que combinan múltiples acciones, transiciones de escena, direcciones de cámara, restricciones temporales e instrucciones de estilo.
Generación más rápida que la duración del video
H3 Max está diseñado para una latencia de generación inusualmente baja. fal reporta clips de cinco segundos a 768p en aproximadamente tres segundos o menos en su infraestructura optimizada, habilitando ciclos creativos iterativos mucho más ajustados.
Audio sincronizado nativo
H3 Max mantiene el enfoque de generación conjunta de audio y video de H3, por lo que el diálogo, el ambiente, los efectos de sonido y el movimiento pueden producirse en un flujo de trabajo audiovisual coordinado.
Múltiples flujos de generación
La familia H3 Max admite texto a video, imagen a video, generación del primer al último fotograma y flujos de referencia a video.
Expansión de prompt incorporada
El endpoint de texto a video expone modos de expansión de prompt como deshabilitado, equilibrado y calidad, permitiendo que los desarrolladores intercambien tiempo de preprocesamiento por una interpretación del prompt más rica.
¿Cómo rinde MiniMax H3 Max?
Benchmarks de MiniMax H3 Max
Los benchmarks ejecutados por el proveedor son útiles para mostrar hacia qué se dirigió el posentrenamiento, pero las pruebas de preferencia de terceros continuamente actualizadas son más útiles para comparar H3 Max con el H3 original bajo la misma metodología de arena.
| Instantánea de benchmark — 18 de septiembre de 2026 | MiniMax H3 Max | MiniMax H3 | Diferencia |
|---|---|---|---|
| Elo de Texto a video con audio | 1227 ±9 | 1220 ±8 | +7 |
| Muestras de Texto a video | 5,689 | 8,602 | — |
| Elo de Imagen a video con audio | 1195 ±10 | 1181 ±8 | +14 |
| Muestras de Imagen a video | 5,569 | 6,949 | — |
| Elo de Edición de video con audio | No clasificado en esta comparación | 1132 ±6 | — |
Nota sobre la metodología de benchmark. Las cifras de Artificial Analysis son instantáneas con fecha de preferencias humanas a ciegas; este artículo reporta la puntuación, intervalo de confianza del 95%, conteo de muestras, categoría y fecha de la instantánea. Los prompts exactos, configuraciones de generación y procedimientos de evaluación deben verificarse frente a la metodología actual de Artificial Analysis. El resultado #1 de fal es ejecutado por el proveedor en la infraestructura de fal, y su gráfico público de comparación no divulga todos los prompts, hardware o parámetros de serving necesarios para la reproducción independiente.
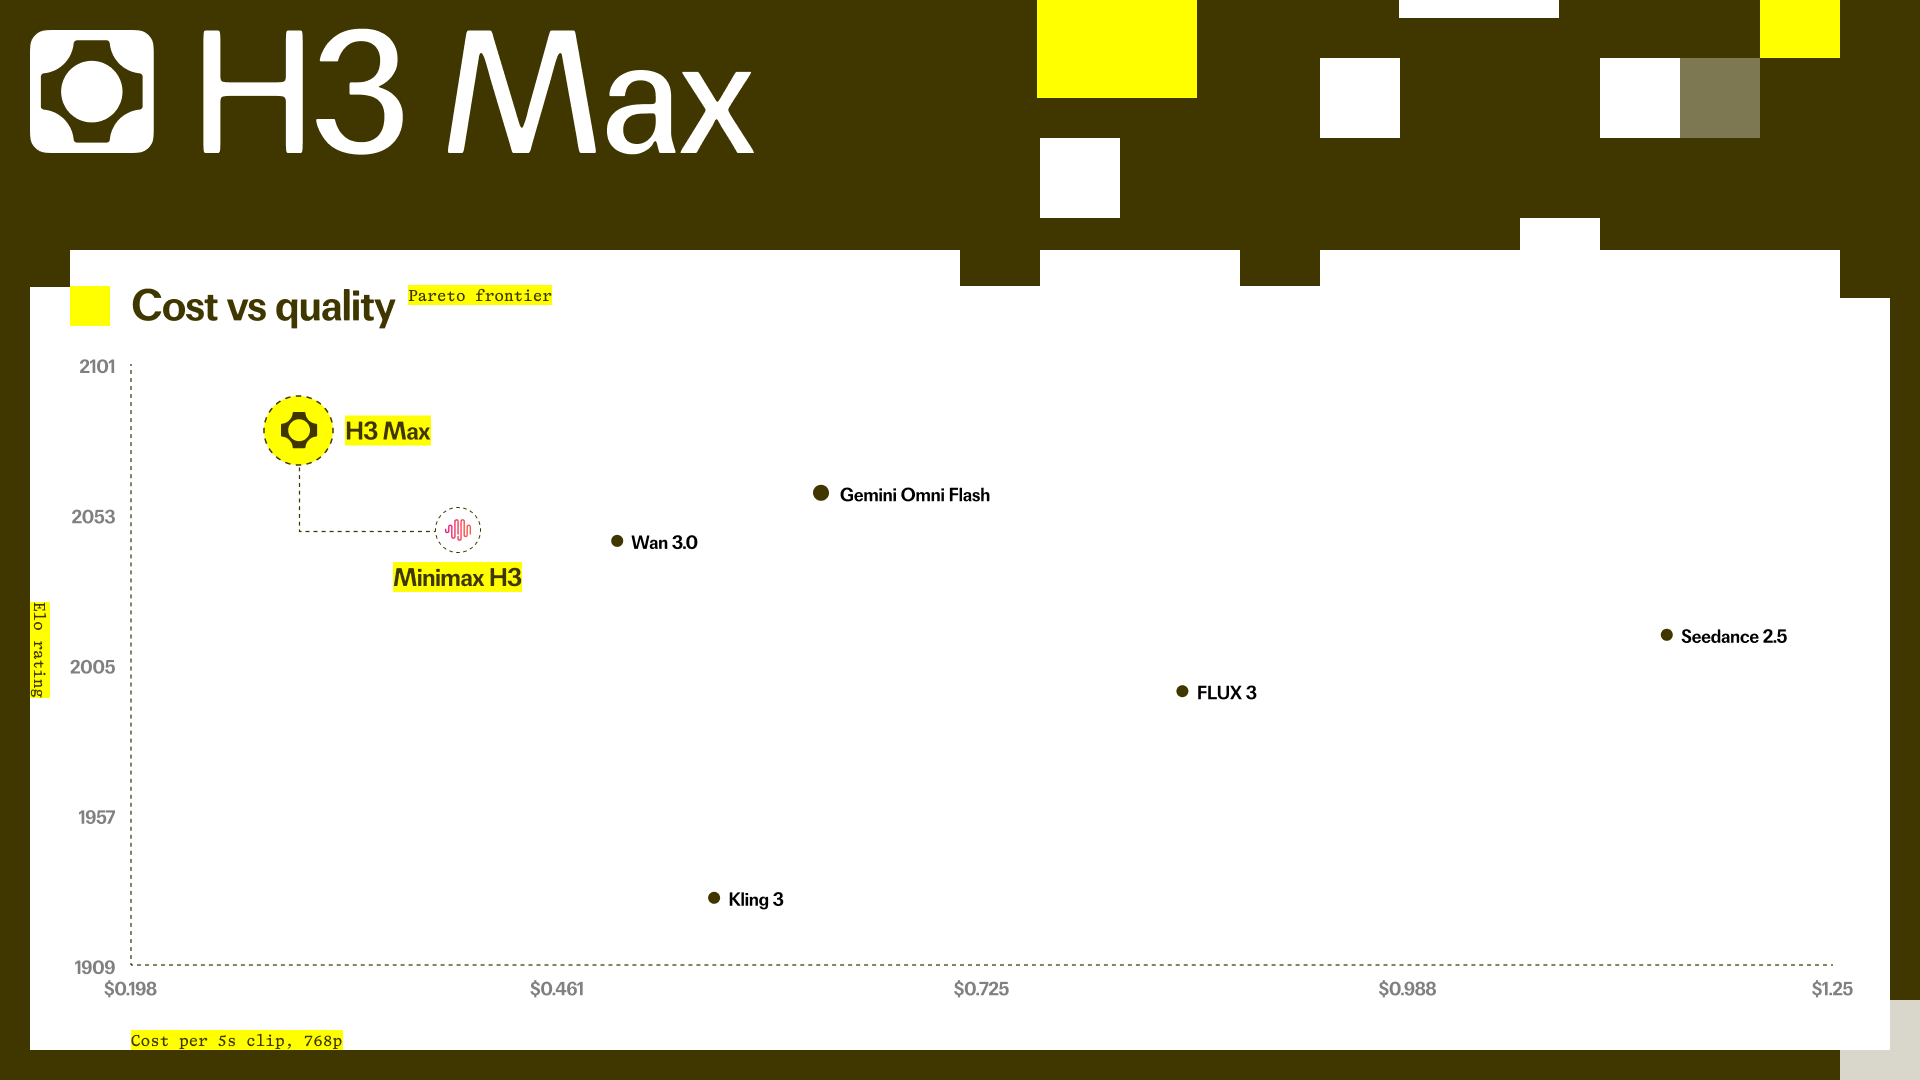
La instantánea actual apoya una conclusión estrecha: H3 Max tiene la puntuación de preferencia medida más alta en ambas categorías directamente comparables de generación audiovisual. Los intervalos de confianza se solapan, por lo que la diferencia no debe presentarse como una ventaja de calidad universal o dramática.
Evaluación propia de fal de H3 Max
fal reporta que H3 Max ocupó el primer lugar en preferencia general, comprensión del prompt y estética en su evaluación cara a cara contra doce modelos de video. Eso es evidencia ejecutada por el proveedor, por lo que es mejor leerla junto con los datos de arena independientes en lugar de como un sustituto.
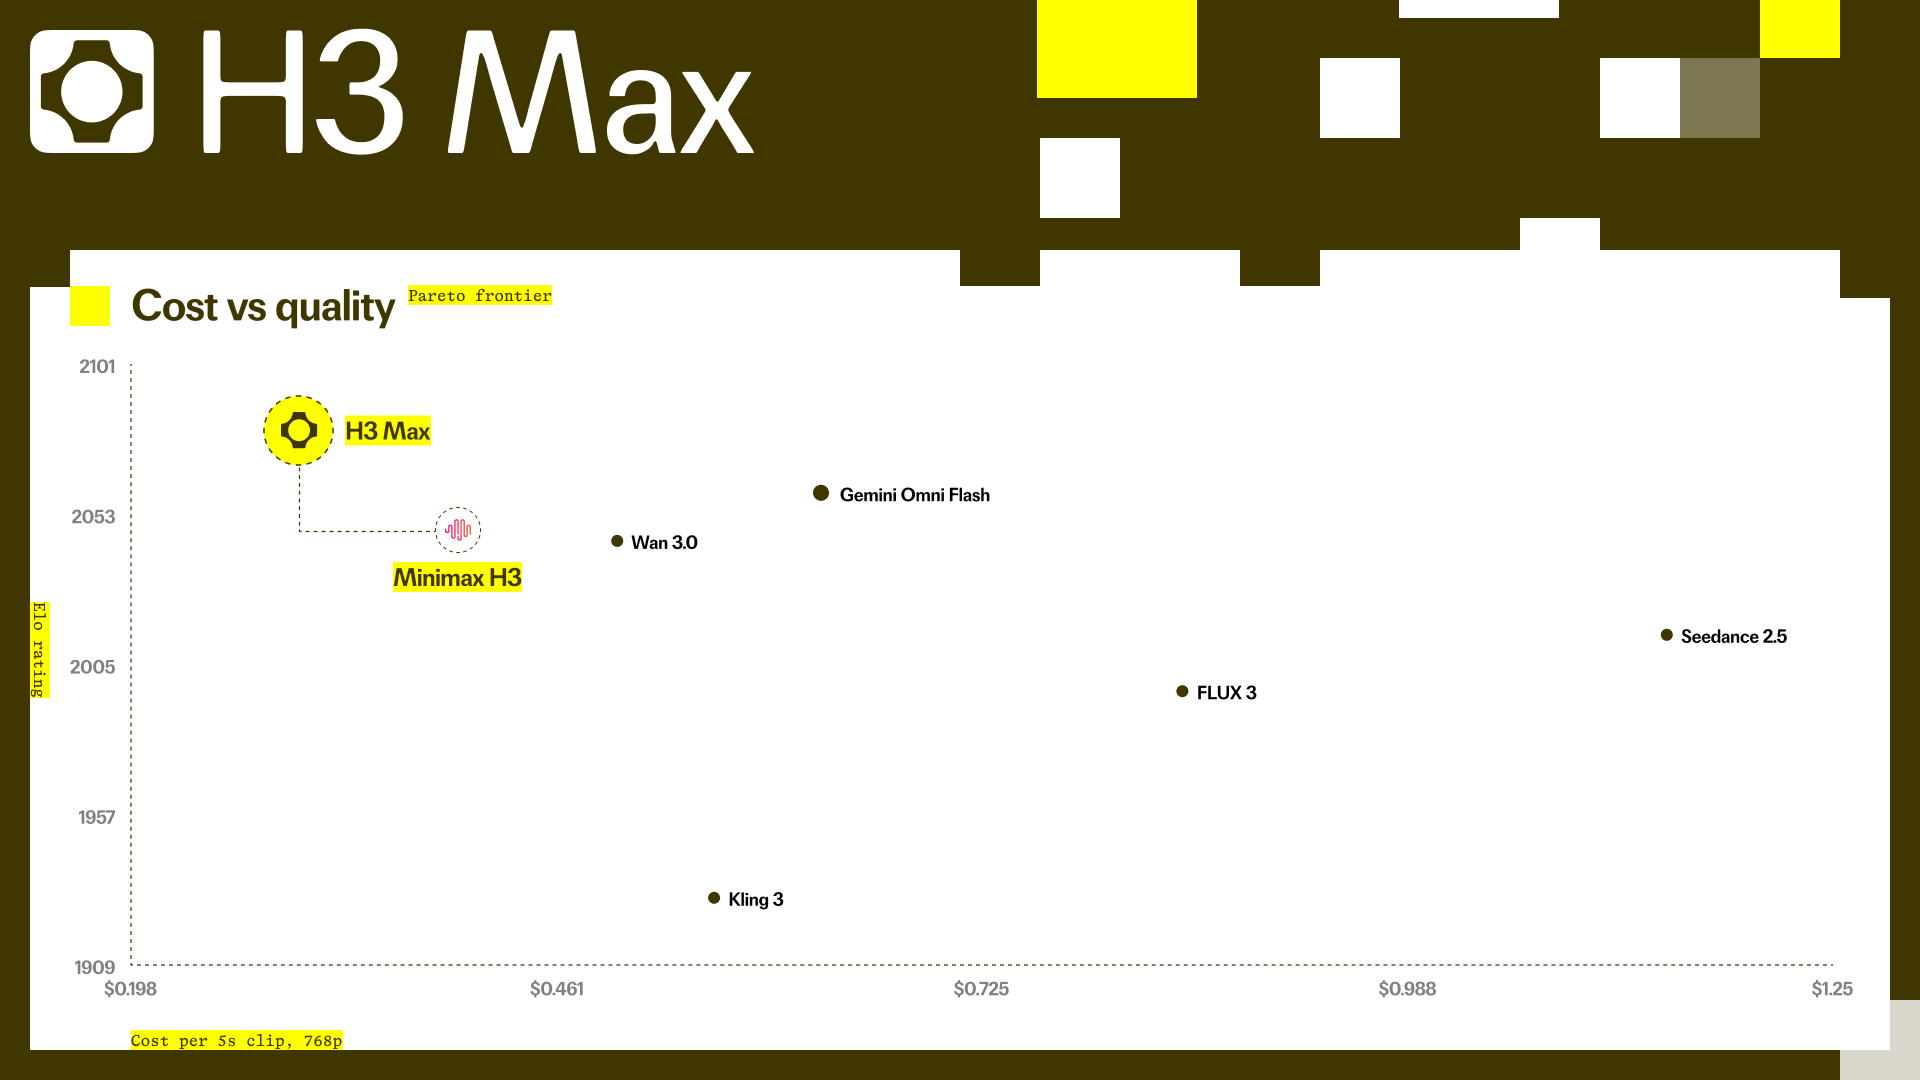
Gráfico oficial de fal costo vs. calidad de H3 Max
La interpretación más útil no es “H3 Max gana universalmente”. Es que H3 Max mejora materialmente el punto de operación de velocidad‑calidad de H3 mientras que la diferencia de preferencia independiente sobre H3 sigue siendo comparativamente modesta.
Velocidad, calidad y el compromiso
fal reporta que H3 Max genera un video de cinco segundos a 768p en menos de tres segundos en su infraestructura optimizada—aproximadamente 35× el rendimiento del endpoint oficial de MiniMax H3 en la comparación de fal. Trátese como evidencia de inferencia específica del proveedor: el tiempo de cola, la transferencia de red, las comprobaciones de seguridad y un backend diferente pueden aumentar la latencia extremo a extremo.
La ventaja de calidad es más modesta que la ventaja de velocidad. En la instantánea independiente del 18 de septiembre usada aquí, H3 Max lideró a H3 por 7 Elo en texto a video con audio y 14 Elo en imagen a video con audio, pero los intervalos de confianza se solapan. La conclusión defendible es que H3 Max desplaza la frontera velocidad‑calidad; no garantiza un resultado visiblemente mejor para cada prompt.
Elección práctica: usa H3 Max para iteración rápida, producción de alto rendimiento en formato corto y prompts donde la fidelidad importa. Prefiere H3 estándar cuando el flujo de trabajo depende del sistema multimodal más amplio, la edición de video, el despliegue con pesos abiertos o la ruta H3-Regenerate-2K.
¿Cuánto cuesta MiniMax H3 Max?
La fijación de precios necesita contexto porque las tarifas y promociones de los proveedores pueden cambiar de forma independiente. La siguiente instantánea refleja tarifas mostradas públicamente verificadas el 18 de septiembre de 2026.
| Fuente de precios | H3 Max | H3 |
|---|---|---|
| fal 480p | $0.025/seg promocional | — |
| fal 768p | $0.04/seg promocional | — |
| fal refinamiento 1080p | $0.08/seg promocional | — |
| MiniMax oficial 768p | — | $0.08/seg |
| MiniMax oficial 2K | — | $0.13/seg |
| MiniMax 768p → regeneración 2K | — | $0.05/seg |
| Precio inicial en CometAPI | $0.064/seg | $0.064/seg |
Actualmente, fal etiqueta sus tarifas de H3 Max como precios promocionales de lanzamiento y afirma que el descuento termina el 30 de septiembre de 2026. El API de MiniMax H3 Max en CometAPI muestra actualmente $0.064 por segundo, mientras que el API de MiniMax H3 en CometAPI también empieza en $0.064 por segundo. Los precios del proveedor deben volverse a comprobar antes de proyectar una carga de producción grande.
Cómo probar MiniMax H3 Max
El API de MiniMax H3 Max en CometAPI está disponible actualmente con ID de modelo minimax-h3-max, un endpoint de producción bajo /v1/videos, manejo asíncrono de tareas y un precio inicial mostrado de $0.064 por segundo.
- Crea una clave de API. Inicia sesión en CometAPI, crea un token y guárdalo de forma segura como
COMETAPI_KEY. - Envía una tarea de generación. Envía una solicitud
POSTahttps://api.cometapi.com/v1/videoscon el modelominimax-h3-max, un prompt, duración y tamaño de salida. Añade una URL de imagen cuando uses imagen a video. - Consulta la tarea asíncrona. Lee el ID de tarea devuelto y solicita
GET /v1/videos/{task_id}hasta que el estado seacompletedofailed. Usa un intervalo de sondeo en lugar de enviar solicitudes continuas. - Descarga y revisa. Recupera
GET /v1/videos/{task_id}/content, guarda el MP4 e inspecciona la fidelidad al prompt, el movimiento, la sincronización de audio y los artefactos visuales antes de escalar la carga de trabajo.
Para una comparación justa entre H3 Max y H3, mantén fijos el prompt, la duración, la relación de aspecto, la resolución, las entradas de referencia, la configuración de audio y la política de reintentos. Confirma el esquema en vivo y el precio en la página del modelo antes de producción porque el enrutamiento y los parámetros expuestos pueden cambiar independientemente del modelo subyacente.
Limitaciones de MiniMax H3 Max
Primero, H3 Max no reemplaza el flujo de trabajo de regeneración a 2K de H3. Su opción 1080p actualmente documentada es un refinamiento de la salida nativa a 768p en lugar de la misma ruta de regeneración a 2K en contexto usada por H3.
Segundo, la latencia destacada de H3 Max está estrechamente ligada al stack de inferencia optimizado de fal, por lo que no debe asumirse la misma velocidad de reloj en otro backend.
Tercero, la ventaja de calidad independiente sobre H3 es actualmente modesta. La instantánea del 18 de septiembre muestra +7 Elo en texto a video con audio y +14 Elo en imagen a video con audio, con intervalos de confianza solapados.
Finalmente, H3 sigue siendo el sistema más amplio si “mejor” significa edición de video, profundidad de referencia multimodal, despliegue con pesos abiertos o resolución máxima de salida en lugar de rendimiento bruto de generación.
Conclusión
MiniMax H3 Max se entiende mejor como una variante de H3 optimizada para producción, no como un sucesor más grande. El posentrenamiento de fal y el codesarrollo de inferencia crean un punto de operación convincente para la generación audiovisual rápida de formato corto, mientras que la ventaja de preferencia independiente sobre H3 estándar sigue siendo modesta más que universal.
Elige H3 Max cuando la velocidad de iteración, el rendimiento y la fidelidad al prompt sean las principales restricciones. Elige H3 estándar cuando necesites el flujo multimodal más amplio, edición de video, pesos abiertos H3-Base o regeneración a 2K. Antes de comprometerte con cualquiera de las dos rutas, ejecuta un benchmark controlado con prompts y configuraciones idénticas y calcula el coste por clip aceptado—no solo el coste por segundo generado.
Preguntas frecuentes
¿Cómo deben interpretar los equipos la ventaja de benchmark de H3 Max cuando los intervalos de confianza se solapan?
Trata la ventaja como evidencia direccional, no como prueba de que H3 Max gana cada prompt. En la instantánea citada, H3 Max lidera a H3 por 7 Elo en texto a video con audio y 14 Elo en imagen a video con audio, pero los intervalos de confianza se solapan. Por lo tanto, los equipos deben probar un conjunto de prompts representativo, reportar la tasa de victorias y los modos de fallo, y evitar convertir una ventaja agregada modesta en una afirmación de calidad universal.
¿Cómo deben comparar los equipos el coste real de producción de H3 Max y H3 más allá del precio por segundo listado?
Calcula el coste por clip aceptado en lugar del coste por segundo generado. Incluye reintentos, salidas rechazadas, refinamiento a 1080p o regeneración a 2K, almacenamiento y transferencia, tiempo de revisión y cualquier edición posterior. H3 Max puede reducir el coste de iteración mediante generación más rápida y mayor fidelidad al prompt, mientras que H3 puede ser más económico cuando su edición, controles multimodales o flujo a 2K evitan herramientas adicionales y reprocesos.
¿Qué velocidad de generación pueden esperar realísticamente los equipos y qué factores afectan la latencia extremo a extremo?
fal reporta menos de tres segundos de inferencia para un clip de cinco segundos a 768p en su infraestructura optimizada. Eso no es una garantía extremo a extremo universal: el tiempo de cola, las cargas de entrada, la expansión del prompt, el procesamiento de seguridad, la resolución, la duración y el enrutamiento del proveedor afectan la latencia observada. Haz un benchmark del endpoint y la configuración exactos que planeas desplegar.
¿Qué flujo de H3 Max debe usarse para trabajos solo con texto, condicionados por imagen, controlados por fotogramas clave o impulsados por referencias?
Usa texto a video cuando la escena pueda definirse completamente en lenguaje; usa imagen a video cuando la identidad, la composición o el estilo visual deban partir de un fotograma suministrado. Elige control de primer a último fotograma cuando los estados inicial y final sean ambos importantes, y referencia a video cuando la consistencia con múltiples referencias visuales sea importante. El flujo correcto reduce la ambigüedad del prompt y debe fijarse antes de comparar H3 Max con H3.
¿Cómo deben los equipos elegir entre 480p, 768p, el refinamiento a 1080p de H3 Max y la regeneración a 2K de H3?
Usa 480p para borradores económicos y cribado de conceptos de alto volumen, luego pasa a 768p para evaluación normal y muchas entregas web. Elige el refinamiento a 1080p de H3 Max cuando la producción rápida siga siendo la prioridad pero el formato de entrega necesite más píxeles. Elige la regeneración a 2K de H3 cuando el máximo detalle y el flujo de trabajo más amplio de H3 justifiquen mayor latencia y coste; compara los artefactos finales al tamaño de visualización real en lugar de seleccionar solo por la etiqueta de resolución.
¿En qué se diferencia la regeneración a 2K de MiniMax H3 del refinamiento a 1080p de H3 Max?
Sí. MiniMax H3 estándar puede alcanzar 2K a través de H3-Regenerate-2K. Se trata de una etapa de regeneración en contexto que reutiliza tanto las instrucciones multimodales originales como el resultado a 768p, permitiéndole reconstruir detalles en lugar de aplicar un paso de super‑resolución convencional. Ese flujo de trabajo más amplio es una razón para preferir H3 sobre H3 Max para la resolución máxima.
¿Qué partes de MiniMax H3 son de pesos abiertos y cuáles siguen requiriendo APIs alojadas?
Parcialmente. MiniMax lanzó los checkpoints H3-Base FL2VA y Ref2VA bajo la H3 Community License, habilitando la validación local de la generación central a 768p. El sistema de producción completo no está totalmente abierto: H3-Context-IR y H3-Regenerate-2K siguen siendo componentes alojados, por lo que reproducir todo el flujo oficial a 2K requiere APIs de MiniMax.
¿Cuándo debería un producto de API elegir H3 Max en lugar de H3 estándar?
A menudo, cuando la aplicación valora la baja latencia, la iteración creativa rápida y el rendimiento de producción. No es automáticamente la mejor elección de API: H3 estándar es preferible para regeneración a 2K, condicionamiento multimodal más amplio, edición de video o despliegue con pesos abiertos. Ejecuta una prueba de aceptación y compara el coste por salida utilizable antes de elegir.
¿Qué debe medir una suite de evaluación de producción antes de cambiar de H3 a H3 Max?
Mide fidelidad al prompt, coherencia del movimiento, artefactos visuales, calidad y sincronización del audio, consistencia de identidad y tasa de aceptación por parte de los revisores. Añade métricas operativas como tasa de fallos de tareas, tasa de reintentos, latencia p50 y p95 de extremo a extremo y coste por clip aceptado. Segmenta los resultados por texto a video, imagen a video, duración, resolución, relación de aspecto y complejidad del prompt para que un promedio fuerte no oculte un escenario crítico para la producción.