
Résumé rapide : Pour utiliser la Claude Fable 5.1 API dans CometAPI, préparez une clé API, définissez l’ID du modèle sur claude-fable-5-1, et validez une petite requête avant de construire un workflow plus long. Ce guide couvre l’accès, l’effort, le streaming, les outils, le cache, la migration et les contrôles de production. Traitez le déploiement comme bien plus qu’un simple changement de chaîne de modèle : confirmez la compatibilité de la route, validez les sorties et mesurez la qualité des tâches acceptées, la latence et le coût avant d’élargir l’usage.
Points clés
- Faites fonctionner une première requête : confirmez les identifiants, l’accès au modèle, l’endpoint choisi et une réponse exploitable avec des données de test non sensibles.
- Choisissez l’effort délibérément : démarrez en High, puis comparez d’autres réglages sur des tâches représentatives plutôt que d’utiliser l’effort maximum pour chaque requête. Claude Code est par défaut en High. Claude Cowork / Claude.ai est par défaut en Medium
- Passez en revue le comportement de migration : la sélection forcée d’outils est refusée ; maintenez les étapes de workflow obligatoires et la validation des arguments d’outils dans le code applicatif.
- Mesurez le workflow complet : suivez l’usage du cache, le coût en tokens, la latence, les refus, le comportement de repli et si le résultat final passe vos contrôles d’acceptation.
Pour le contexte, voir le suivi Fable 5.1 précédent de CometAPI et le tutoriel Fable 5 API. Cet article se concentre sur le workflow d’intégration actuel.
Qu’est-ce que Claude Fable 5.1 ?
Claude Fable 5.1 est le modèle généralement disponible le plus puissant d’Anthropic pour le code ambitieux, la recherche multi-étapes, l’utilisation de l’ordinateur et les workflows professionnels riches en documents. Anthropic recommande de démarrer la plupart des charges avec Claude Opus 5 et de monter à Fable 5.1 lorsque les évaluations en effort élevé d’Opus restent insuffisantes.
La distinction est opérationnelle : Fable 5.1 est conçu pour continuer à travailler à travers des étapes dépendantes, se rétablir après un appel d’outil échoué, vérifier les résultats et signaler la progression lors d’exécutions longues. Cela peut améliorer les taux de complétion, mais rend aussi le coût, la latence et l’observabilité centraux au déploiement.
Spécifications de l’API Claude Fable 5.1
| Spécification officielle | Claude Fable 5.1 |
|---|---|
| Fournisseur | Anthropic |
| ID du modèle | claude-fable-5-1 |
| Date de sortie | 1er septembre 2026 |
| Fenêtre de contexte | 1 000 000 tokens |
| Sortie maximale | 128 000 tokens |
| Entrée et sortie | Texte et images vers texte |
| Raisonnement | Adaptatif, toujours actif |
| Effort par défaut | API en High, Claude Code par défaut en High, Claude Cowork / Claude.ai par défaut en Medium |
| Niveaux d’effort | low, medium, high, xhigh, max |
| Coupe de connaissances | juin 2026 |
| Prix officiel | 10 $ entrée / 50 $ sortie par million de tokens |
| Lecture du cache | 0,25 $ par million de tokens |
L’aperçu officiel confirme une fenêtre de contexte de 1M et une sortie maximale de 128K. Le raisonnement adaptatif est toujours actif ; la profondeur de raisonnement est contrôlée via l’effort plutôt qu’un budget traditionnel de thinking-tokens.
Claude Fable 5.1 API : performances officielles aux benchmarks
Le résumé des benchmarks est intentionnellement compact car l’objectif principal de l’article est l’implémentation. Les résultats ci-dessous identifient où la prime API a le plus de chances de compter.
| Benchmark Anthropic | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6 % | 24,7 % | 29,0 % | 22,4 % |
| Terminal-Bench 4.0 | 55,8 % | 42,0 % | 52,3 % | 37,3 % |
| GDPval-AA v2 | 1 853 Elo | 1 723 | 1 824 | 1 711 |
| OSWorld 2.0, partiel | 77,9 % | 72,9 % | 75,4 % | — |
| Humanity's Last Exam, sans outils | 60,9 % | 57,8 % | 56,6 % | — |
| AutomationBench | 31,4 % | 17,1 % | 26,9 % | 19,6 % |
| CursorBench 3.2.0 | 73,4 % | 70,5 % | 70,0 % | 67,2 % |
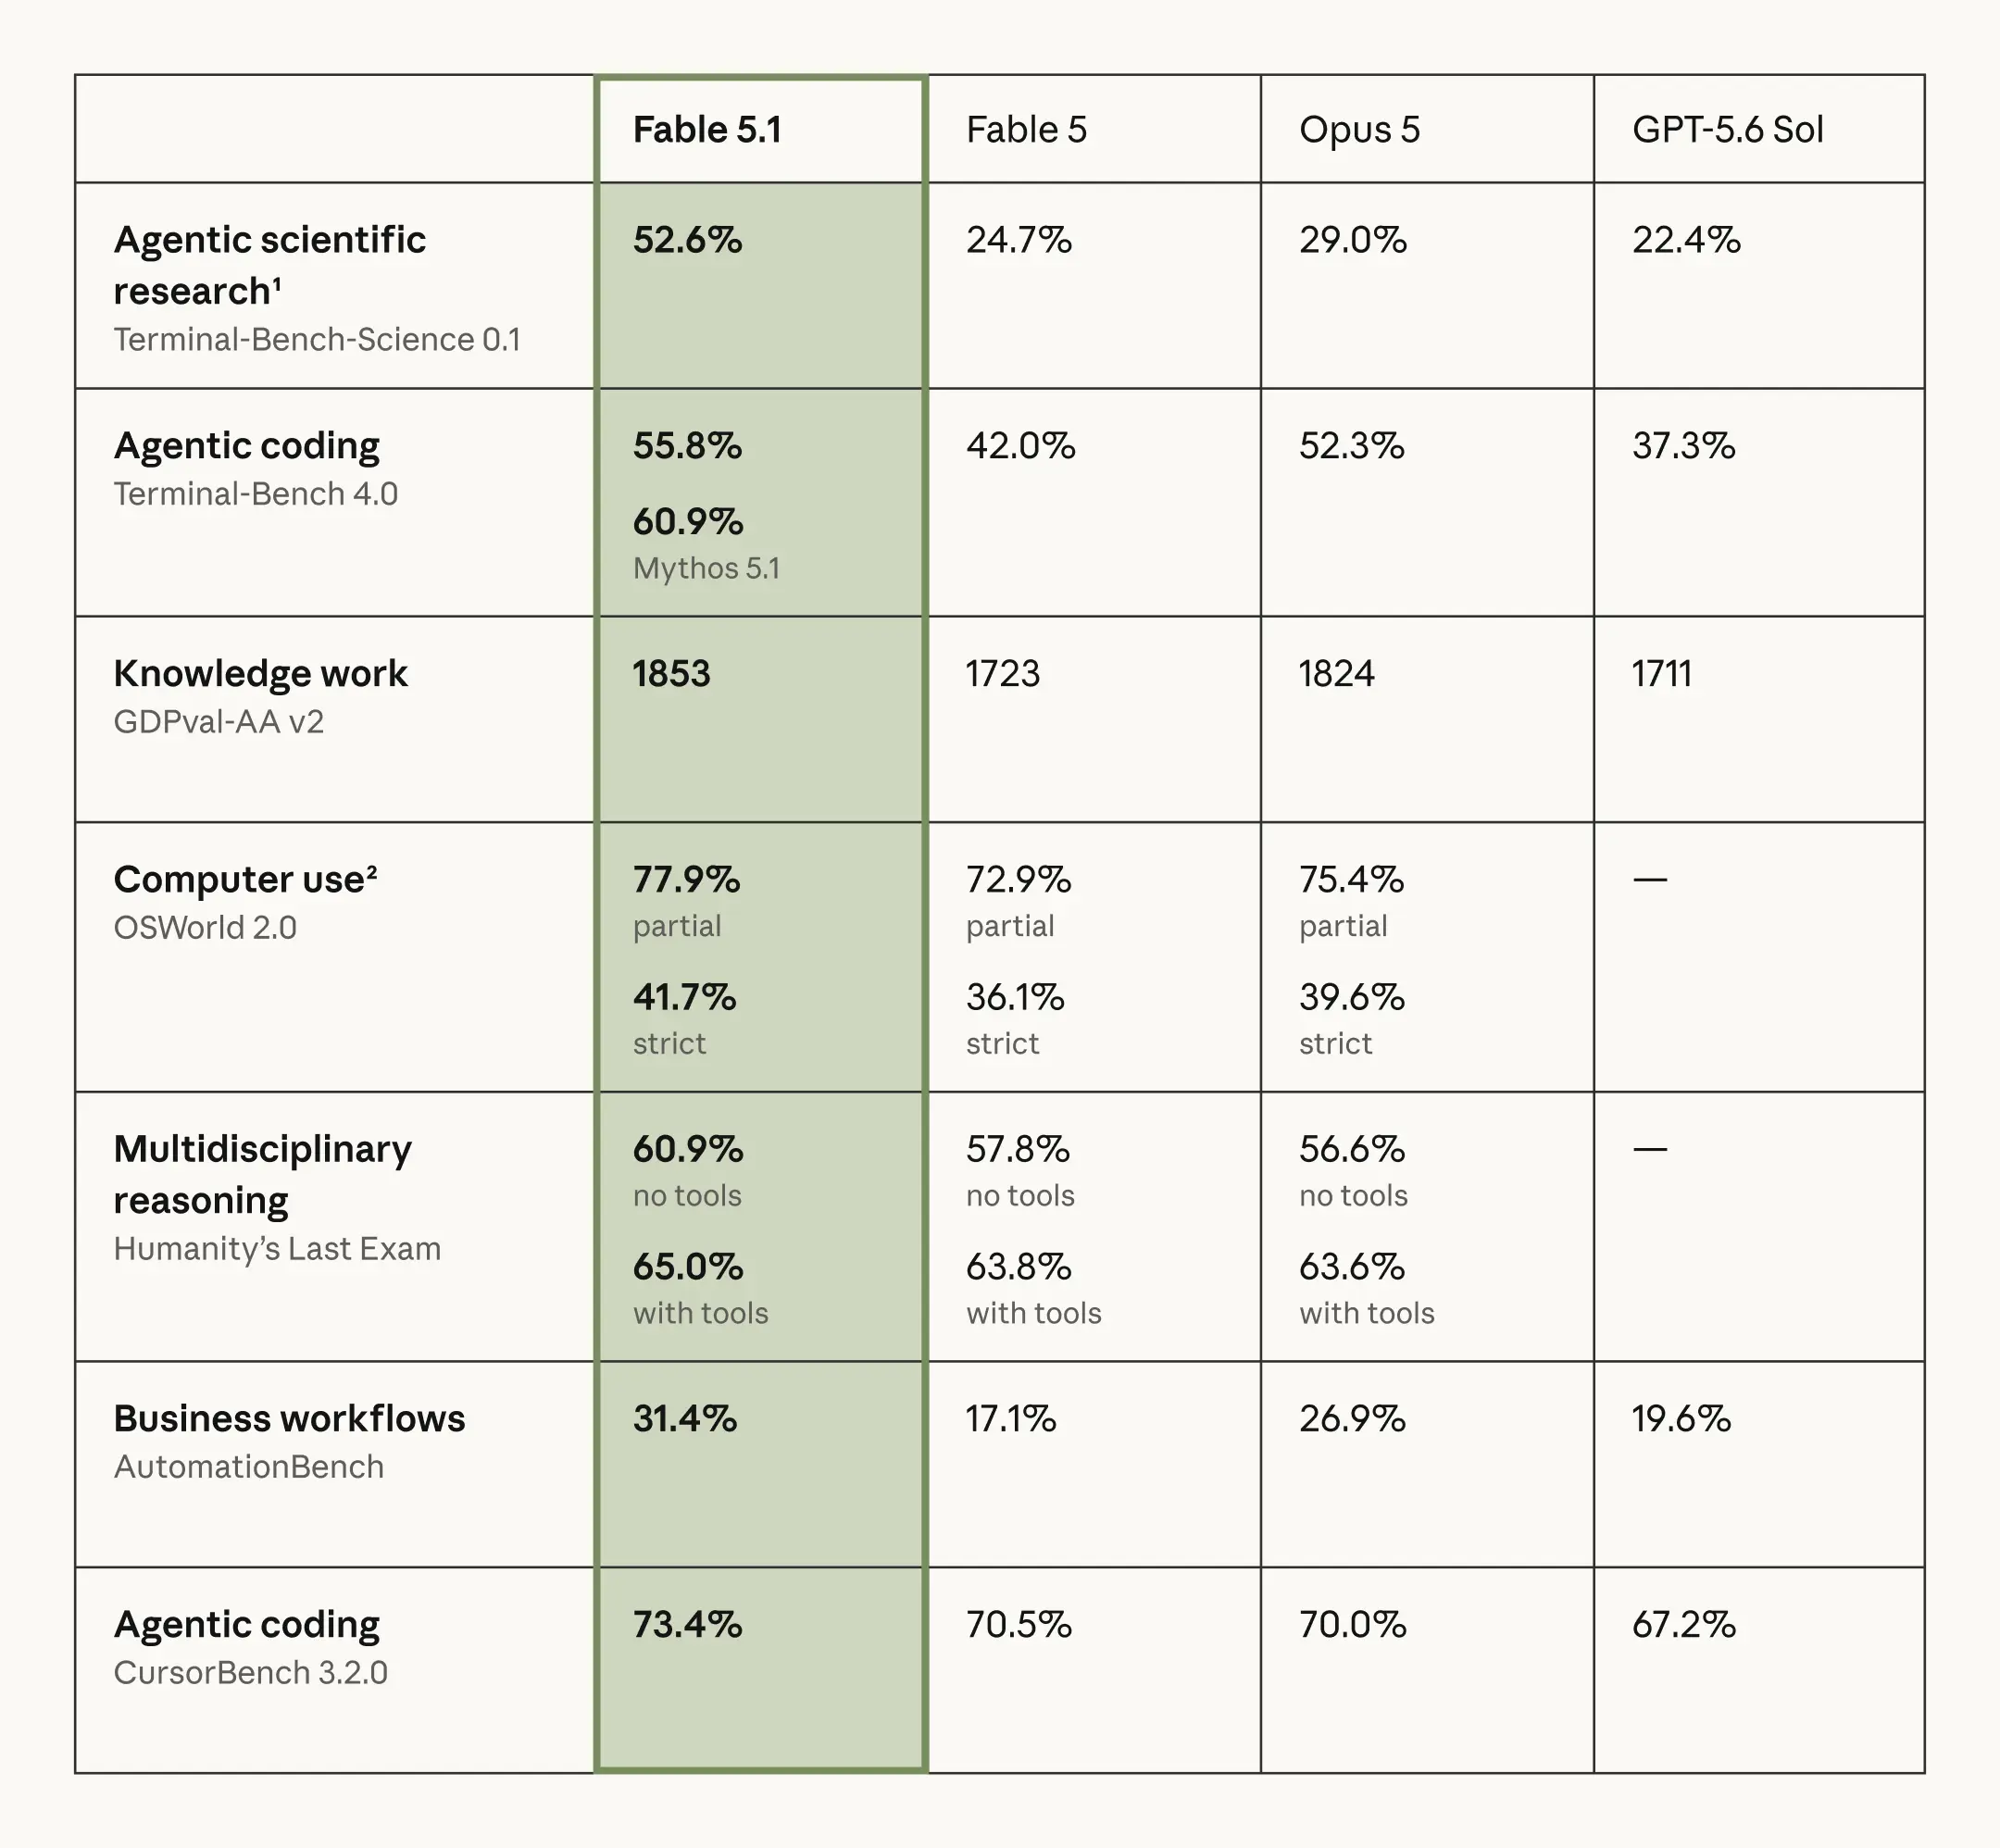
Comparaison officielle des benchmarks Claude Fable 5.1 par Anthropic
Le plus grand gain générationnel de cet ensemble est Terminal-Bench-Science : 52,6 % contre 24,7 %. AutomationBench passe de 17,1 % à 31,4 %, tandis que Terminal-Bench 4.0 progresse à 55,8 %. Il en résulte un argument solide pour tester Fable 5.1 sur des agents de recherche, du codage longue durée et l’automatisation métier — pas pour router chaque requête courte vers le modèle le plus coûteux.
Qu’est-ce qui a changé par rapport à l’API Claude Fable 5 ?
| Dimension | Claude Fable 5.1 | Claude Fable 5 | Impact de migration |
|---|---|---|---|
| Rôle principal | Agents longue durée et recherche renforcés | Modèle public original classe Mythos | Réévaluer les workflows les plus durs |
| Choix d’outil forcé | Renvoie une erreur | Précédemment pris en charge | Supprimer tout forçage, y compris nommé |
| Historique de réflexion | Règles de compatibilité plus strictes | Comportement antérieur | Garder les historiques append-only |
| Mises à jour de progression | Mises à jour lisibles entre appels d’outil | Non disponible sous cette forme | Exposer l’état des longues exécutions |
| Effort par message | Disponible en bêta | Non disponible sous cette forme | Ajuster la profondeur au sein d’une conversation |
| Prix lecture cache | 0,25 $ / MTok | 1,00 $ / MTok | Recalculer l’économie des longs contextes |
| Prix entrée/sortie | 10 $ / 50 $ par MTok | 10 $ / 50 $ par MTok | Pas de changement de liste |
Trois changements incompatibles
L’utilisation forcée d’outils n’est plus prise en charge
Claude Fable 5.1 rejette les valeurs tool_choice qui forcent n’importe quel outil ou un outil nommé, renvoyant une erreur 400 invalid-request. Gardez la sélection automatique, utilisez des schémas stricts ou des sorties structurées pour la validation, et faites respecter les étapes de workflow obligatoires dans l’orchestration applicative plutôt qu’en forçant un appel d’outil du modèle.
Les modèles antérieurs ne peuvent pas lire les blocs de réflexion de Fable 5.1
La compatibilité de réflexion est unidirectionnelle : Fable 5.1 peut consommer des blocs de réflexion créés par des modèles Claude antérieurs compatibles, mais les modèles plus anciens ne peuvent pas lire les blocs créés par Fable 5.1. Un routeur ou un repli vers un modèle antérieur peut supprimer ces blocs avant l’inférence ; les intégrations doivent journaliser les changements de modèle et tester explicitement le comportement de repli.
Modifier des tours antérieurs invalide la réflexion préservée
Modifier un prompt système, une définition d’outil, un message ou des octets de fichier référencés antérieurs peut invalider des blocs de réflexion ultérieurs. Traitez le préfixe de conversation comme append-only, utilisez des instructions en cours de conversation plutôt que de réécrire l’historique et surveillez les transformations de décalage de préfixe lors de la migration.
Cinq capacités API additionnelles
Effort par message
Les applications peuvent changer l’effort au cours d’une conversation sans invalider le cache de prompt. Cette capacité bêta permet à un workflow d’abaisser l’effort pour les suivis routiniers et de l’augmenter pour des tours de planification, de débogage ou de vérification difficiles.
Messages système à portée de tour
Un message système bêta peut s’appliquer à un tour puis cesser d’apparaître après le prochain message utilisateur tout en restant inchangé dans l’historique. Utile pour des instructions temporaires dans des boucles d’outils, car cela préserve à la fois l’adéquation au cache de prompt et la validité des blocs de réflexion ultérieurs.
Mises à jour de progression lisibles entre appels d’outil
Avec l’option bêta d’affichage de progression, certains blocs de réflexion peuvent porter de courts statuts que l’application peut montrer aux utilisateurs tandis que le raisonnement privé reste caché. Les agents longue durée doivent traiter ces mises à jour comme un statut opérationnel, pas comme des réponses finales.
Baisse du prix de lecture du cache
Les lectures de cache coûtent 0,25 $ par million de tokens, soit un quart du tarif Fable 5, tandis que les prix d’entrée et de sortie de base restent inchangés. Cela peut réduire sensiblement le coût des longues sessions qui réutilisent à plusieurs reprises un préfixe mis en cache stable.
Provenance de contenu
Le texte généré porte le filigrane statistique d’Anthropic, tandis que les médias pris en charge via l’API Files peuvent inclure des Content Credentials C2PA signés. Ces mécanismes de provenance n’ajoutent pas de tokens de prompt et ne nécessitent pas de changements de format de requête.
De quoi avez-vous besoin avant d’utiliser l’API Claude Fable 5.1 ?
- Un compte et une clé API : connectez-vous à CometAPI et générez une clé dans la console des clés API. Vérifiez l’accès au modèle et que votre compte est prêt pour la facturation à l’usage avant d’envoyer des appels de test.
- Un environnement local : utilisez un terminal avec curl pour le premier exemple HTTP. Pour les exemples Python, préparez Python et pip dans un environnement isolé, puis installez le SDK choisi par votre exemple.
- Une route sélectionnée : la Claude Fable 5.1 API dans CometAPI propose des formats Messages et Chat Completions. Utilisez l’URL de base et le format de requête correspondants ; ne mélangez pas leurs payloads.
- Configuration sécurisée : définissez
COMETAPI_KEYen dehors des fichiers source versionnés, utilisezclaude-fable-5-1comme ID de modèle et assurez-vous que votre réseau peut atteindrehttps://api.cometapi.com. - Un test sûr et un contrôle d’acceptation : commencez avec un prompt court et non sensible. Confirmez que la réponse contient un contenu exploitable, inspectez l’usage et l’état de complétion, et vérifiez les exigences de gestion des données de votre organisation avant d’envoyer de vrais documents ou journaux.
Comment accéder à Claude Fable 5.1 via CometAPI
CometAPI expose Claude Fable 5.1 via une route Messages compatible Anthropic et une route Chat Completions compatible OpenAI. Utilisez Messages lorsque vous avez besoin de l’effort natif, du raisonnement, du cache et des sémantiques d’outils de Claude ; utilisez Chat Completions si votre application standardise déjà sur le SDK OpenAI.
Étape 1 : Stocker la clé API
export COMETAPI_KEY="your-cometapi-key"
$env:COMETAPI_KEY="your-cometapi-key"
Étape 2 : Faire la première requête Messages
curl https://api.cometapi.com/v1/messages \
  --header "Authorization: Bearer $COMETAPI_KEY" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-fable-5-1",
    "max_tokens": 2048,
    "messages": [{
      "role": "user",
      "content": "Review this deployment architecture and list the three highest-risk failure modes."
    }]
  }'
Étape 3 : Utiliser le SDK Python d’Anthropic
pip install anthropic
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
)

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    messages=[{
        "role": "user",
        "content": "Find the root cause of this test failure and propose a verified patch.",
    }],
)

print(response.content[0].text)
Étape 4 : Utiliser le SDK Python d’OpenAI
pip install openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="claude-fable-5-1",
    messages=[{
        "role": "user",
        "content": "Design a migration plan for this service.",
    }],
)

print(response.choices[0].message.content)
Comment fonctionne le raisonnement de l’API Claude Fable 5.1 ?
Les modèles antérieurs ne peuvent pas lire les blocs de réflexion de Claude Fable 5.1
Les blocs de réflexion produits par Fable 5.1 ne sont pas rétrocompatibles avec les modèles Claude antérieurs. Si un workflow change de modèle en cours de conversation, supprimez les blocs de réflexion incompatibles ou démarrez une nouvelle branche en ne conservant que les messages visibles et les résultats d’outils requis pour la prochaine requête.
Modifier des tours antérieurs invalide la réflexion préservée
Un bloc de réflexion préservé est lié cryptographiquement à l’état de conversation précédent. Modifier un prompt système, une définition d’outil, un message utilisateur, une réponse d’assistant ou un résultat d’outil antérieur peut rompre ce lien et déclencher une erreur d’historique de réflexion. Gardez le préfixe rejoué strictement identique octet par octet et ajoutez de nouveaux tours plutôt que de réécrire les anciens.
Réflexion préservée à travers les tours
Lorsque le préfixe de conversation reste inchangé, la réflexion préservée peut porter un état de raisonnement utile vers des tours ultérieurs. Stockez les blocs de réflexion avec leur ordre de message d’origine, ne les rejouez que vers un modèle compatible et considérez une modification de l’historique comme une nouvelle branche de conversation plutôt que de muter la transcription existante.
Contrôler le raisonnement avec l’effort
Démarrez les travaux de production difficiles en High, puis testez des réglages plus bas pour les tours routiniers et plus élevés uniquement là où la qualité des tâches acceptées s’améliore suffisamment pour justifier la latence et les tokens supplémentaires. Comme l’effort peut changer entre les tours, une conversation n’a plus besoin d’un seul niveau de raisonnement tout du long.
Fable 5.1 utilise le raisonnement adaptatif comme unique mode de réflexion. Commencez en High, puis mesurez des réglages plus bas pour le travail routinier et xhigh ou max uniquement lorsque la capacité supplémentaire justifie le coût et la latence.
| Effort | Rôle recommandé | Compromis |
|---|---|---|
| low | Travail routinier bien spécifié | Le plus rapide et économique |
| medium | Trafic de production équilibré | Profondeur modérée |
| high | Travail difficile par défaut | Meilleur point de départ |
| xhigh | Codage longue durée et agents | Plus de latence et de tokens |
| max | Tâches les plus dures à forte valeur | Coût et latence secondaires |
response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Audit this repository migration plan.",
    }],
)
Claude Fable 5.1 API : diffuser de longues réponses, utiliser des outils et le cache de prompt
Configurez ensemble les contrôles suivants : effort de raisonnement, streaming, exécution d’outils, mise en cache de prompt, et gestion des garde-fous et des données conservées. Chacun influe sur la manière dont une requête longue est observée, validée et opérée.
Diffuser de longues réponses
Le streaming est le choix par défaut le plus sûr pour les tâches longues et à effort élevé, car il évite d’attendre la complétion d’une grande réponse avant que l’application ne reçoive une sortie.
with client.messages.stream(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Analyze these logs and produce a remediation plan.",
    }],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
Utiliser des outils sans choix d’outil forcé
Fable 5.1 rejette la sélection forcée d’outils via un tool_choice de type any ou un outil nommé. Utilisez la sélection automatique, des schémas stricts, validez les arguments d’outil dans le code applicatif et contrôlez le séquencement obligatoire du workflow en dehors du modèle. Si un workflow exige l’exécution d’un outil spécifique, ne comptez pas sur tool_choice pour imposer la séquence. Faites que l’application invoque cet outil ou implémentez l’étape requise dans le code d’orchestration.
tools = [{
    "name": "search_incidents",
    "description": "Search recent production incidents",
    "input_schema": {
        "type": "object",
        "properties": {
            "service": {"type": "string"},
            "days": {"type": "integer"},
        },
        "required": ["service", "days"],
    },
}]

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    tools=tools,
    tool_choice={"type": "auto"},
    messages=[{
        "role": "user",
        "content": "Review checkout incidents from the last 30 days.",
    }],
)
Utiliser le cache de prompt pour de longs contextes
Anthropic liste les lectures de cache à 0,25 $ par million de tokens, soit un quart du tarif Fable 5. Placez des instructions système stables, des schémas d’outils et de grandes références avant le contenu utilisateur dynamique, puis vérifiez les hits du cache dans les métadonnées d’usage.
messages = [{
    "role": "user",
    "content": [
        {
            "type": "text",
            "text": large_reference_document,
            "cache_control": {"type": "ephemeral"},
        },
        {
            "type": "text",
            "text": "Identify obligations that changed in this revision.",
        },
    ],
}]
Gérer les garde-fous et la conservation des données
Anthropic indique que de nombreuses requêtes en cybersécurité et biologie signalées sont routées vers des modèles moins capables. Traitez un refus ou un repli comme un état applicatif : enregistrez la raison d’arrêt, affichez un message utilisateur approprié et routez vers une alternative approuvée lorsque la politique le permet.
Fable exige également une rétention des données de 30 jours par défaut pour la sécurité. Confirmez l’éligibilité de l’organisation et les paramètres de rétention avant de déboguer une requête syntaxiquement valide comme si ce n’était qu’un problème de format d’API.
Fable 5.1 vs Opus 5 vs Sonnet 5
| Dimension de décision | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Contexte / sortie max | 1M / 128K | 1M / 128K | 1M / 128K |
| Tarif officiel entr./sort. | 10 $ / 50 $ | 5 $ / 25 $ | 2 $ / 10 $ |
| Latence relative | Plus lente | Modérée | Rapide |
| Effort par défaut | high | high | high |
| Force principale | Capacité maximale long-horizon | Raisonnement général premium | Équilibre vitesse/coût |
| Rôle en production | Escalade de capacité | Travail complexe par défaut | Baseline à fort volume |
Résultat de la sélection : démarrez le trafic routinier sur Sonnet 5, utilisez Opus 5 pour le travail général complexe, et n’escaladez vers Fable 5.1 que pour les tâches les plus difficiles ou échouant de manière répétée. Cela suit les recommandations d’Anthropic et évite que le raisonnement premium devienne le coût par défaut de chaque requête.
Tarification via CometAPI
| Route | Entrée / MTok | Sortie / MTok | Lecture cache / MTok |
|---|---|---|---|
| Prix liste Anthropic | 10 $ | 50 $ | 0,25 $ |
| Prix listé CometAPI | 8 $ | 40 $ | Voir route en direct |
| Différence nominale entr./sort. | 20 % de moins | 20 % de moins | Varie selon la route |
La page modèle en direct CometAPI est la source de vérité pour la disponibilité et la tarification actuelles par route. Pour une requête avec 100 000 tokens d’entrée non mis en cache et 10 000 tokens de sortie, l’estimation simple CometAPI est de 1,20 $ ; le coût réel peut changer avec le cache, le raisonnement, le comportement par lot et le routage. Les prix peuvent changer ; consultez la page modèle en direct avant de budgéter en production.
Liste de contrôle de migration depuis Fable 5
- Remplacez l’ID du modèle de claude-fable-5 par claude-fable-5-1.
- Supprimez le forçage tool_choice any et celui d’outils nommés ; utilisez auto.
- Remplacez les hypothèses d’ancien budget de réflexion par output_config.effort.
- Commencez l’évaluation en High, puis ajustez sur des tâches réelles.
- Gardez les historiques append-only lorsqu’ils contiennent des blocs de réflexion préservés.
- Augmentez max_tokens pour les exécutions longues à effort élevé.
- Vérifiez les hits de cache via les métadonnées d’usage.
- Traitez les refus et replis comme des états explicites.
- Rejouez des traces de production et comparez taux de tâches acceptées, latence et coût.
Stratégie de migration la plus sûre : gardez les historiques append-only. Fable 5.1 peut préserver des blocs de réflexion à travers les tours, mais les blocs rejoués sont liés à l’état de conversation précédent ; modifier des prompts système, des outils ou des messages antérieurs peut invalider ce lien.
Erreurs API courantes
Erreur 400 après modification des appels d’outils
Cause probable : tool_choice forcé utilisant any ou un outil nommé. Utilisez auto et imposez la séquence requise dans la logique applicative.
claude-fable-5.1 ne fonctionne pas
L’ID canonique utilise des tirets : claude-fable-5-1.
La sortie se termine plus tôt que prévu
effort contrôle la quantité de raisonnement effectuée par le modèle, tandis que max_tokens limite le budget de tokens de la réponse. Un effort plus élevé peut nécessiter plus de budget de sortie ; les applications de production doivent ajuster les deux indépendamment. Augmentez max_tokens si justifié et diffusez les longues réponses.
Le cache de prompt n’est jamais utilisé
Gardez le préfixe mis en cache identique au byte près ; des timestamps, des outils réordonnés et des messages système changeants empêchent la réutilisation.
Une réponse HTTP réussie ne contient aucune réponse normale
Inspectez stop_reason et les métadonnées de fallback au lieu de traiter chaque refus comme une erreur de transport.
Rejouer l’historique produit une erreur de réflexion
N’éditez pas des tours antérieurs avant des blocs de réflexion Fable 5.1 préservés. Utilisez un historique append-only ou les contrôles de migration actuels.
Comment utiliser l’API Claude Fable 5.1 en production ?
Séparez le routage des requêtes, l’exécution du modèle, l’exécution d’outils, la validation et l’évaluation. Journalisez l’ID de modèle, l’effort, la latence, l’usage de tokens, l’usage du cache, la raison d’arrêt, le comportement de repli et le succès final de la tâche.
Utilisez Fable 5.1 pour des migrations à l’échelle du dépôt, du débogage difficile, des agents longue durée, de la recherche approfondie, la synthèse de documents volumineux et des tâches à forte valeur où des modèles moins coûteux échouent de façon répétée. Évitez d’en faire le défaut pour les résumés, la classification, l’extraction et les réponses courtes de service client.
Exemple : enquêter sur un incident de checkout
Une équipe pourrait fournir des erreurs de checkout anonymisées, des diffs de déploiement récents et des runbooks pertinents. L’application récupère les incidents correspondants, puis demande au modèle de classer les causes possibles et de relier chaque hypothèse à des preuves. Un ingénieur examine les étapes de diagnostic proposées et approuve un test dans un bac à sable avec des transactions synthétiques. La porte d’acceptation est un comportement reproductible, des preuves traçables et des vérifications de régression réussies ; toute remédiation en production nécessite une approbation humaine distincte.
Exemple : analyser des changements aux exigences d’exploitation
Une équipe pourrait fournir un manuel d’exploitation approuvé, des politiques de support et un projet révisé. Conservez le matériel de référence inchangé comme contexte stable, puis demandez au modèle de comparer les obligations modifiées, les équipes responsables, les délais et les exceptions. Chaque constat proposé devrait référencer les passages pertinents dans les deux versions et distinguer les changements explicites des interprétations incertaines. La porte d’acceptation est un réviseur confirmant chaque changement rapporté contre sa preuve citée avant de mettre à jour les procédures ou de notifier les équipes concernées.
Conclusion
Claude Fable 5.1 n’est pas une simple mise à jour de chaîne de modèle. Son comportement sur les outils forcés, les règles d’historique de réflexion, les contrôles d’effort, l’économie du cache et les fonctionnalités de progression longue exigent une migration délibérée.
Le déploiement le plus efficace utilise Claude Sonnet 5 pour le volume routinier, Claude Opus 5 pour le trafic complexe par défaut, et Claude Fable 5.1 comme escalade de capacité mesurée. Ne le promouvez que lorsque la complétion des tâches acceptées s’améliore suffisamment pour justifier le coût et la latence totaux.