Spécifications techniques de GLM-5.2
| Item | GLM-5.2 |
|---|---|
| Provider | Zhipu AI |
| Release Date | June 13, 2026 |
| Model Type | LLM Mixture-of-Experts (MoE) à poids ouverts |
| Total Parameters | ~744B |
| Active Parameters | ~40B per token |
| Context Window | 1,000,000 tokens |
| Maximum Output | 131,072 tokens |
| Reasoning Modes | High, Max |
| License | MIT |
| Primary Focus | Codage agentique, ingénierie logicielle, raisonnement à long terme |
| API Availability | Plateforme Z.ai et fournisseurs compatibles |
| Open Weights | Yes |
GLM-5.2 est le dernier modèle phare de la famille GLM de Zhipu AI. Contrairement aux modèles généralistes de pointe, GLM-5.2 est principalement positionné comme un modèle axé d’abord sur le code et orienté agent, conçu pour l’ingénierie logicielle à l’échelle des dépôts, les workflows autonomes et le raisonnement sur des contextes extrêmement longs. Sa fonctionnalité phare est une fenêtre de contexte native d’1 million de jetons, ce qui en fait l’une des plus grandes fenêtres de contexte publiquement disponibles parmi les modèles à poids ouverts.
Principales fonctionnalités de GLM-5.2
- Fenêtre de contexte de 1M de jetons pour des dépôts entiers, des ensembles de documentation volumineux et des workflows d’agents multi-session.
- Optimisation prioritairement axée sur le code, centrée sur la refactorisation, le débogage, la génération de code et les tâches d’ingénierie logicielle.
- Prise en charge de workflows orientés agents pour des outils tels que Claude Code, Cline, Roo Code, OpenCode et des agents de codage similaires.
- Publication à poids ouverts sous licence MIT, permettant l’auto-hébergement et l’ajustement fin.
- Deux modes de raisonnement (High et Max) permettant des compromis entre latence et profondeur de raisonnement.
- Grande architecture MoE avec environ 744B de paramètres totaux tout en n’en activant que ~40B par jeton pour l’efficacité.
Performances de référence de GLM-5.2
Zhipu n’a pas publié de résultats de référence officiels complets au lancement, ce qui rend les comparaisons directes plus incertaines que pour des modèles tels que GPT-5 ou Claude. Plusieurs rapports du secteur signalent l’absence de publications d’évaluations validées de manière indépendante.
| Benchmark | Reported Score |
|---|---|
| Terminal-Bench 2.1 | 81.0 |
| SWE-Bench Pro | 62.1 |
| NL2Repo | 48.9 |
| AIME 2026 | 99.2 |
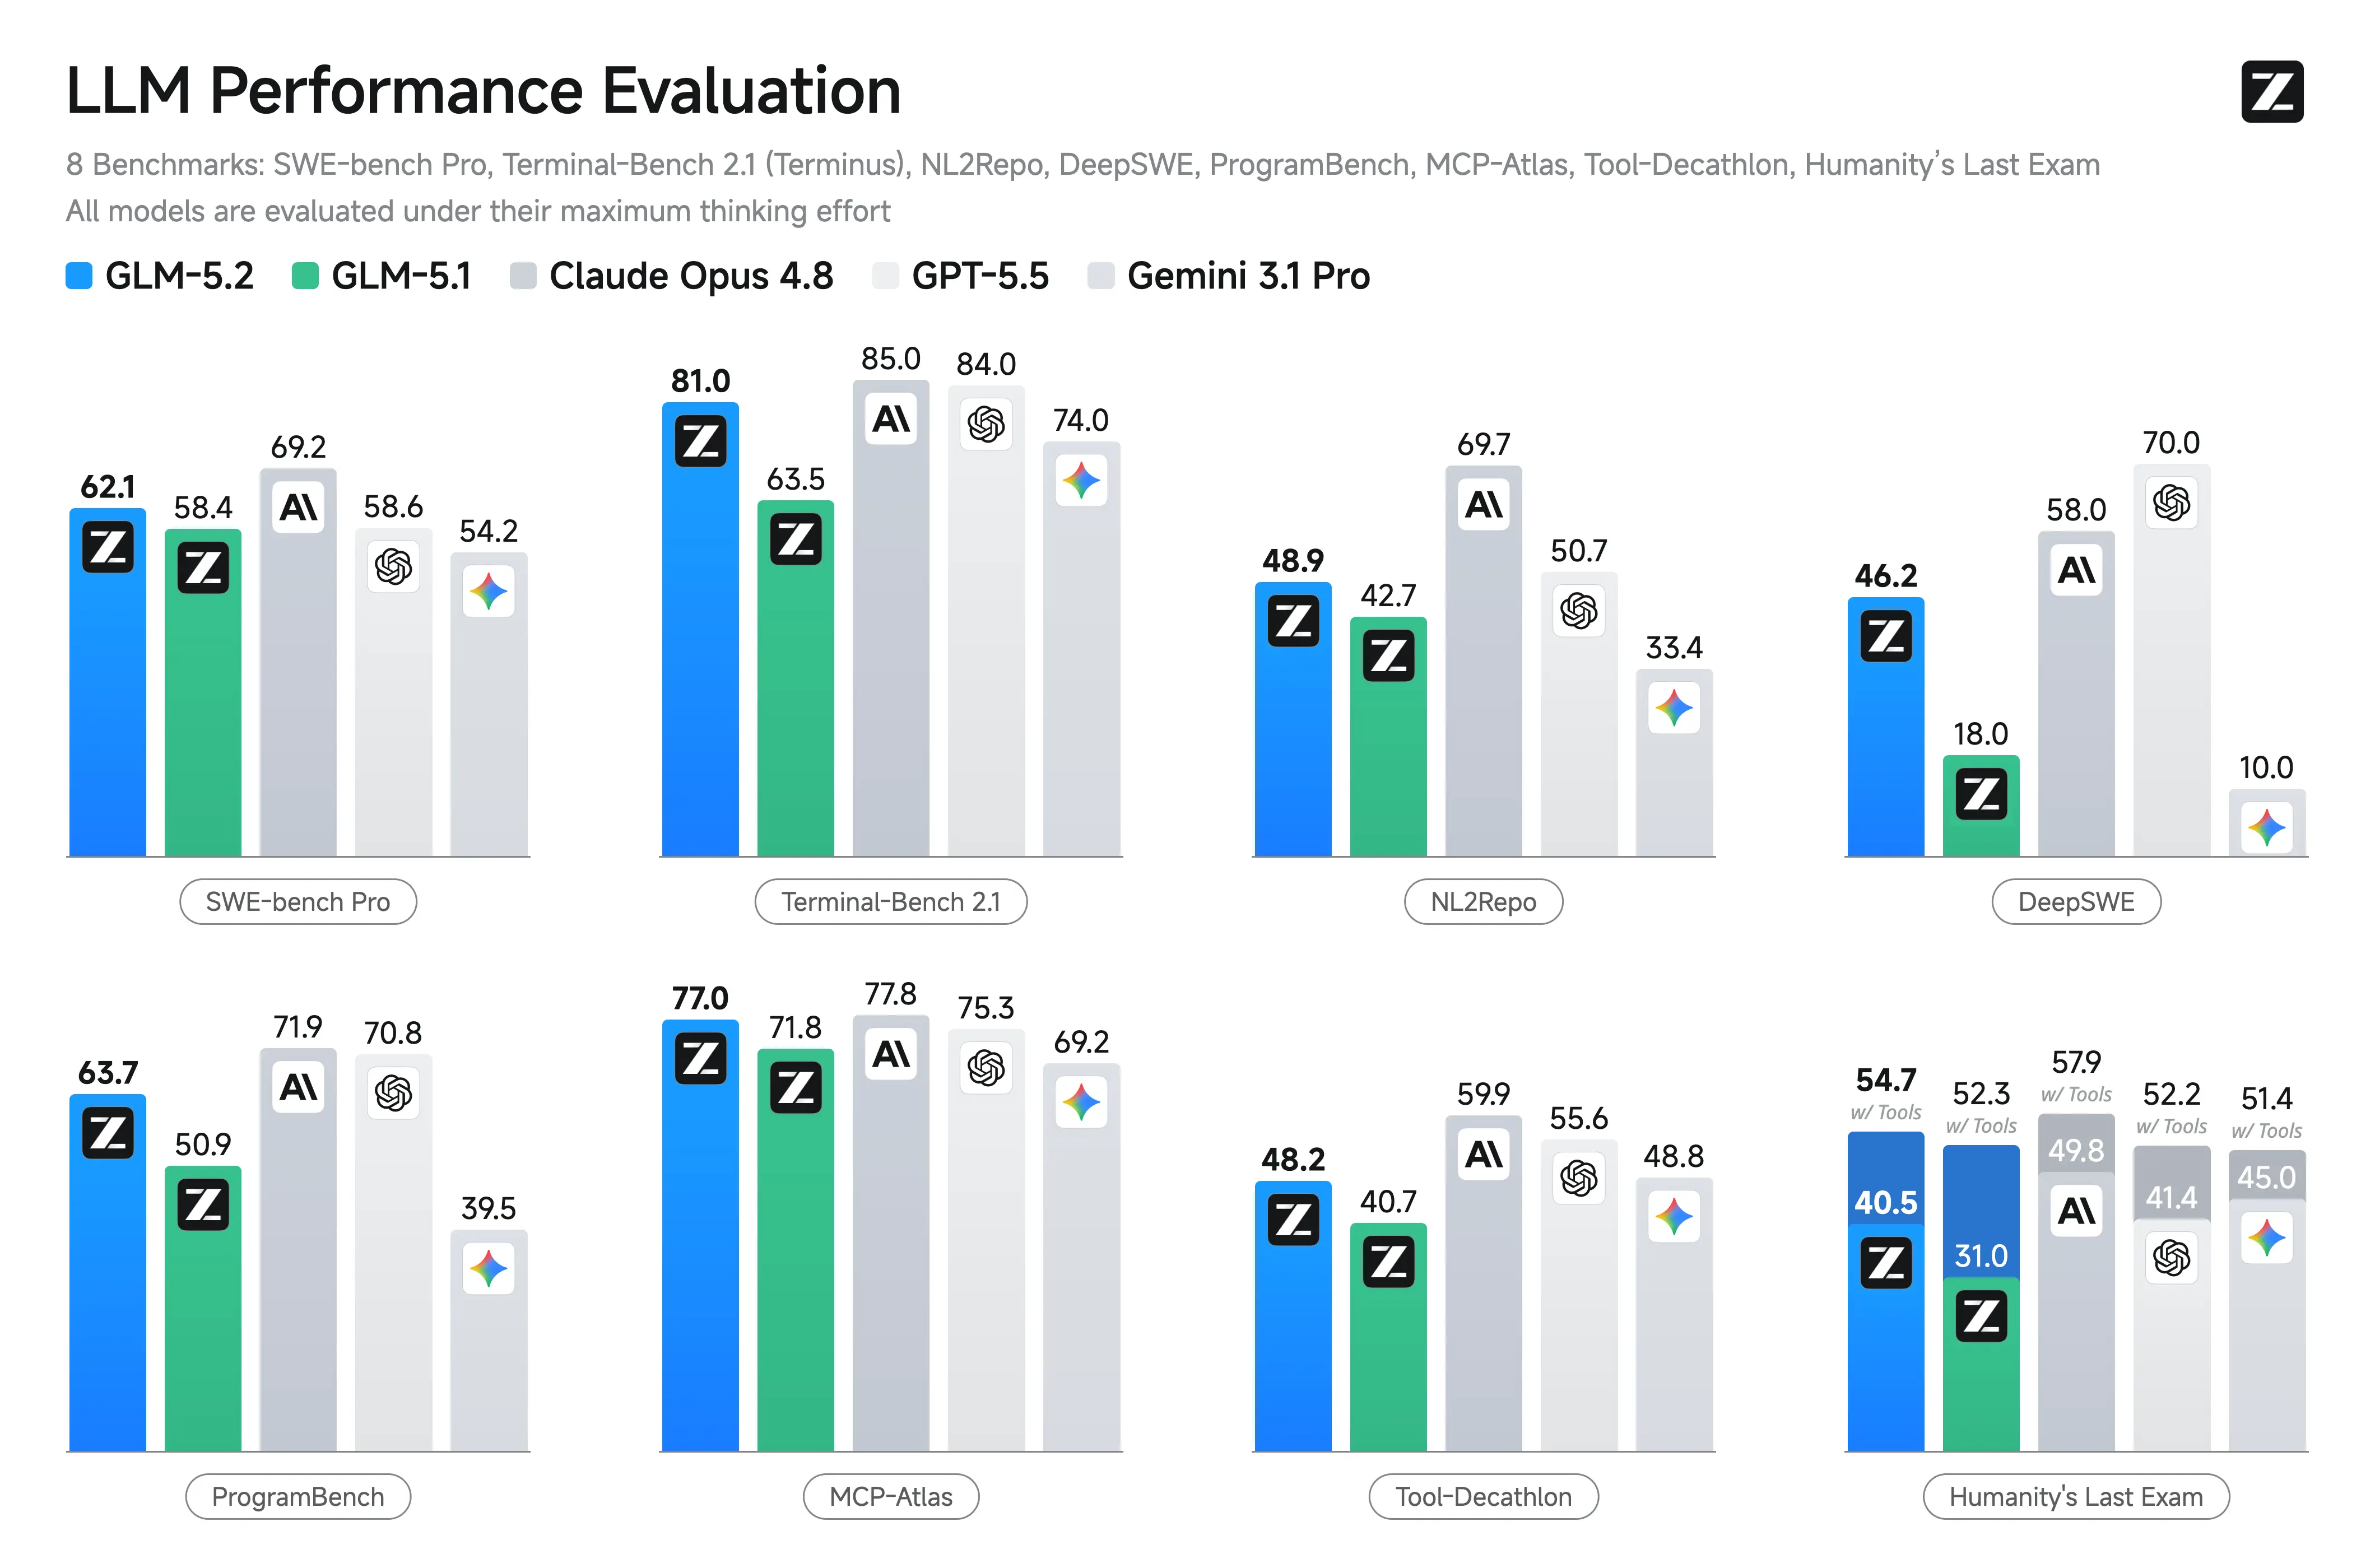
GLM-5.2 vs GLM-5.1 vs Claude Opus 4.8
| Specification | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 |
|---|---|---|---|
| Release Date | 2026-06-13 | 2026 | 2026 |
| Context Window | 1,000,000 | ~200,000 | 1,000,000 |
| Open Weights | Yes (MIT) | Yes | No |
| Reasoning Modes | High, Max | Standard | Extended Thinking |
| Total Parameters | 744B | 744B | Not disclosed |
| Active Parameters | 40B | 40B | Not disclosed |
| Official Benchmark Data | Not published | Published at launch | Published |
L’amélioration principale documentée de GLM-5.2 par rapport à GLM-5.1 est l’extension à une fenêtre de contexte de 1M de jetons et l’introduction de modes de raisonnement sélectionnables High et Max. Au lancement, Z.ai n’a pas publié de résultats officiels pour SWE-Bench, LiveCodeBench, HumanEval ou des évaluations similaires, de sorte que les comparaisons de performances avec Claude Opus 4.8, GPT-5, DeepSeek ou les modèles Qwen restent non vérifiées.
Comparé à d’autres modèles ouverts, le principal différenciateur de GLM-5.2 est sa combinaison d’une très grande fenêtre de contexte, d’une spécialisation en codage et d’une licence MIT. Son atout majeur est l’ingénierie logicielle à l’échelle des dépôts plutôt que les applications de chat généralistes.
Pourquoi utiliser GLM-5.2 via CometAPI ?
CometAPI permet aux développeurs d’intégrer GLM-5.2 en utilisant la même interface que pour des dizaines de modèles d’IA de premier plan.
Avantages :
- Authentification unifiée auprès de plusieurs fournisseurs
- Intégration d’API compatible avec OpenAI
- Facturation et gestion de l’usage simplifiées
- Expérimentation rapide avec des modèles alternatifs
- Changement facile entre modèles de codage, de raisonnement, image, audio et vidéo
- Réduction du verrouillage fournisseur pour les systèmes en production
Que vous construisiez un IDE d’IA, un assistant d’ingénierie interne ou une plateforme d’automatisation d’entreprise, CometAPI minimise l’effort d’intégration tout en préservant la flexibilité.
Comment accéder à l’API GLM-5.2 sur CometAPI
Commencez avec notre produit en quelques étapes simples...
Step 1: Sign Up for Your GLM-5.2 API Key
Créez un compte sur CometAPI et accédez au tableau de bord de l’API pour générer votre clé d’API GLM-5.2. Cette clé authentifie toutes vos requêtes et vous donne un accès immédiat à l’ensemble des capacités de l’API GLM-5.2, y compris la fenêtre de contexte de 1M de jetons et 128k jetons de sortie.
Step 2: Send Requests to GLM-5.2 API
Utilisez votre clé d’API GLM-5.2 pour envoyer des requêtes POST vers l’endpoint CometAPI. Transmettez votre prompt, définissez des paramètres du modèle tels que le niveau d’effort et le nombre maximal de jetons, et l’API GLM-5.2 traite votre requête — gérant tout, de la génération de code à l’analyse de documents en passant par l’utilisation d’outils orientés agents.
Step 3: Retrieve Results and Integrate GLM-5.2 API
L’API GLM-5.2 renvoie des réponses structurées, incluant le texte de complétion, des instructions d’appel d’outils et des métadonnées d’utilisation des jetons. Elle prend en charge les réponses synchrones standard et le streaming en temps réel via Server-Sent Events (SSE) lorsque stream: true est configuré. L’endpoint peut être intégré facilement à vos workflows existants à l’aide de clients HTTP standard ou de SDK compatibles OpenAI en routant les requêtes via url(//api.cometapi.com/v1) avec votre Bearer Token.