
Réponse d’abord
GPT-6 Astra est le nouveau modèle phare d’OpenAI pour les travaux difficiles de bout en bout. OpenAI a released GPT-6 Astra le 3 septembre 2026, en le positionnant sur le raisonnement complexe, l’utilisation d’ordinateur, le code, la recherche, le travail scientifique et la création d’artefacts professionnels. Le modèle API dispose d’une fenêtre de contexte de 1,05M de tokens et d’une sortie maximale de 128K, accepte des entrées texte et image, et prend en charge un effort de raisonnement de low à max. La tarification API standard commence à $10 input / $50 output par million de tokens. Le changement pratique le plus important n’est pas une hausse uniforme sur tous les benchmarks d’intelligence générale : les plus grands gains d’Astra apparaissent dans l’exécution agentique, l’utilisation d’ordinateur, la récupération en long contexte, les workflows de code, la science et la cybersécurité.
Cela compte parce que l’ancien article CometAPI GPT-6 Is Coming Soon — What Will It Look Like? était nécessairement spéculatif. Maintenant qu’Astra est public, ce guide se concentre sur le comportement confirmé du modèle, les compromis de benchmark, l’économie de l’API, et les cas où le modèle est réellement un meilleur choix que des alternatives de frontière moins chères.
Qu’est-ce que GPT-6 Astra ?
GPT-6 Astra est le successeur du modèle phare GPT-5.6 Sol d’OpenAI. OpenAI décrit Astra comme son modèle le plus capable pour les travaux de bout en bout les plus difficiles, avec un accent sur les workflows qui nécessitent que le modèle raisonne, utilise des outils, interagisse avec des logiciels, révise des travaux intermédiaires, et mène une tâche d’une demande initiale à un résultat final. Ce positionnement est important : Astra n’est pas simplement un modèle de chat plus grand. Il est conçu pour agir comme le moteur de raisonnement à l’intérieur d’agents qui travaillent à travers des navigateurs, des terminaux, des documents, des tableurs, des environnements de développement et des logiciels d’entreprise.
Le billet de lancement met en avant des résultats de pointe sur l’utilisation d’ordinateur, la navigation, l’ingénierie logicielle, la cybersécurité, la science et le travail professionnel. Il rapporte 97,6% / 99,9% / 100% sur FrontierMath Tier 4, ARC-AGI-3 et ExploitBench respectivement. Ces scores sont frappants, mais ils ne doivent pas être interprétés comme “Astra gagne tous les benchmarks”. Sur l’Artificial Analysis Intelligence Index utilisé dans le tableau de comparaison d’OpenAI, Astra obtient 61,2 tandis que Claude Fable 5.1 atteint 65,7. La sortie est donc mieux comprise comme un changement de niveau dans l’exécution et le travail agentique plutôt qu’un grand chelem sur toutes les mesures d’intelligence.
Ce qui a changé par rapport à GPT-5.6 Sol
L’utilisation d’ordinateur devient une capacité de première classe
Le gain générationnel le plus net d’Astra est l’utilisation d’ordinateur. Sur OSWorld 2.0, OpenAI rapporte 72,6% pour Astra contre 65,7% pour GPT-5.6 Sol. Dans la même simulation de latence, Astra a achevé des tâches en environ 40 minutes contre ~75 minutes pour Sol, une réduction d’environ 47%. Combiné avec un harness Codex mis à jour, OpenAI rapporte une complétion 1,9× plus rapide sur Mind2Web. Le point pratique n’est pas seulement qu’Astra peut voir un écran ; il peut garder une tâche logicielle multi-étapes cohérente plus longtemps tout en faisant moins de détours coûteux.
La création d’artefacts professionnels est plus délibérée
OpenAI a explicitement entraîné Astra pour des workflows professionnels qui se terminent par des artefacts utilisables plutôt que du texte brut. Les documents de lancement décrivent de meilleures performances sur les documents, les tableurs, les présentations, l’analyse de données, le travail de design et le respect des modèles. Astra est aussi meilleur pour rester orienté lorsque les exigences évoluent en cours de tâche, de sorte qu’un message de pilotage est moins susceptible d’écraser l’objectif initial. Cela est particulièrement utile dans des agents d’entreprise long-courriers, où de nouvelles instructions arrivent souvent après le démarrage du workflow.
Les longues sessions conservent plus de contexte de travail utile
Pour les longues sessions de code, Astra introduit une nouvelle façon pour Codex de préserver et récupérer des notes après que le contexte actif est saturé. Les approches antérieures dépendaient fortement de la compactage, qui peut omettre pourquoi une tentative de correction a échoué ou quelles contraintes ont déjà été testées. OpenAI indique qu’Astra peut garder des notes à travers des fenêtres de contexte, améliorant la continuité pendant de grands refactorings et des sessions de débogage.
L’effort de raisonnement s’étend désormais jusqu’à max
Les développeurs peuvent choisir low, medium, high, xhigh ou max en effort de raisonnement. Cela crée une courbe qualité-coût plus large que de traiter Astra comme un point d’exploitation fixe unique. Le guide officiel du modèle recommande de sélectionner l’effort le plus bas qui satisfait votre évaluation, car la meilleure économie du modèle provient souvent de l’efficacité en tokens plutôt que d’exécuter systématiquement au raisonnement maximal.
Performances de GPT-6 Astra sur les benchmarks
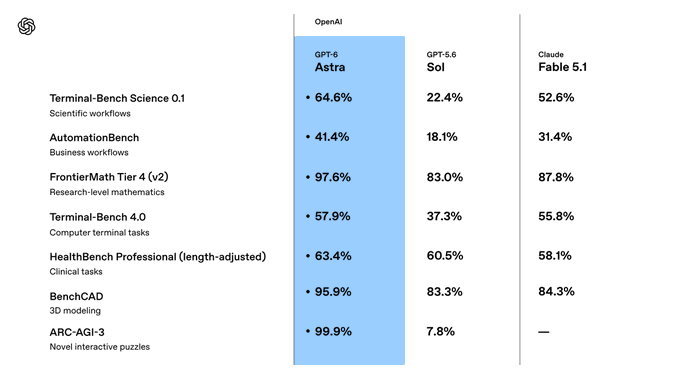
OpenAI a publié une comparaison large couvrant l’utilisation d’ordinateur, le travail professionnel, le code, le raisonnement académique, la santé, la cybersécurité, le long contexte et l’alignement. La manière la plus utile de lire ce tableau est de séparer “intelligence générale” de “capacité à mener des travaux avec outils”. Astra n’est que marginalement au-dessus de Sol sur l’Artificial Analysis Intelligence Index dans le tableau d’OpenAI, mais il est nettement en avance sur plusieurs benchmarks agentiques et opérationnels.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Ce que l’écart suggère |
|---|---|---|---|
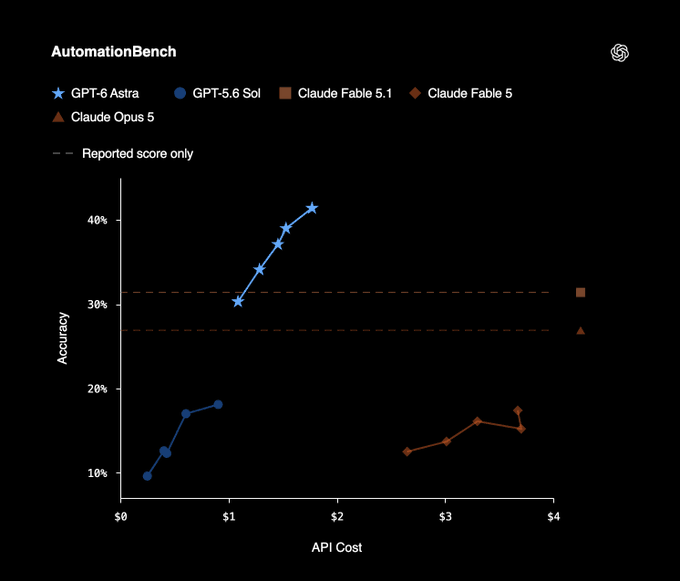
| AutomationBench | 41,4% | 18,1% | Gain important sur les workflows métier de bout en bout |
| OSWorld 2.0 | 72,6% | 65,7% | Meilleure interaction avec l’ordinateur et achèvement des tâches |
| Terminal-Bench 4.0 | 57,9% | 37,3% | Gain important en codage agentique sur terminal |
| Terminal-Bench Science 0.1 | 64,6% | 22,4% | Gain majeur sur les workflows scientifiques utilisant code/outils |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | Raisonnement mathématique de pointe plus solide |
| ExploitBench | 100,0% | 78,5% | Capacité de cybersécurité de classe critique |
| SRE-Bench, one attempt | 88,0% | 55,9% | Travaux d’ingénierie inverse / SRE nettement plus solides |
| MRCR v2, 512K-1M | 96,3% | 73,8% | Amélioration de la récupération en très long contexte |
| AA Intelligence Index v4.1.1 | 61,2 | 60,9 | L’intelligence générale est essentiellement stable vs Sol |
Le motif est inhabituellement clair. L’avantage d’Astra est maximal lorsque le benchmark exige une interaction soutenue avec un outil ou un environnement. AutomationBench passe de 18,1% à 41,4% ; Terminal-Bench Science augmente de 22,4% à 64,6% ; et le MRCR en long contexte s’améliore de 73,8% à 96,3% dans la bande 512K–1M. À l’inverse, l’Artificial Analysis Intelligence Index passe de 60,9 à 61,2. C’est pourquoi décrire Astra comme “2,5× plus cher mais légèrement plus intelligent” rate sa véritable proposition de valeur.
Source : OpenAI AutomationBench chart (image originale, non redessinée)
Benchmarks indépendants : GPT-6 Astra est-il un saut générationnel ?
Les tests indépendants apportent un contrepoint utile. Artificial Analysis rapporte un score d’Intelligence Index de 61, égal à GPT-5.6 Sol à effort maximal. En même temps, Astra progresse fortement sur le Coding Agent Index et utilise substantiellement moins de tokens dans le codage agentique. Artificial Analysis a mesuré environ une réduction par trois de l’usage de tokens par rapport à GPT-5.6 Sol à effort maximal dans son harness Codex, permettant à Astra de scorer plus haut à un coût par tâche d’agent de code à peu près équivalent.
L’économie paraît moins favorable sur l’intelligence générale. Astra utilise environ 10% de tokens de sortie en moins que Sol dans l’Intelligence Index à effort maximal, mais l’augmentation de prix par token de 2,5× domine ce gain d’efficacité ; Artificial Analysis estime qu’Astra est environ 75% plus cher par tâche à effort maximal. Il rapporte également une réduction du taux d’hallucination de 92% à 51% sur AA-Omniscience tandis que la précision a augmenté de quatre points.
La conclusion utile est spécifique aux charges de travail : GPT-6 Astra paraît le plus générationnel là où un agent doit agir, itérer, utiliser des outils et terminer un travail compliqué. Pour un raisonnement ordinaire ou une génération de texte à haut volume, la prime de prix peut être bien plus difficile à compenser.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
Une comparaison pratique de sélection de modèle doit inclure la capacité, la multimodalité, le contexte, l’exécution agentique, et le prix. Les modèles ci-dessous ne sont pas interchangeables : Astra optimise l’exécution difficile de bout en bout, Claude Fable 5.1 mène certaines mesures d’intelligence générale, et Gemini 3.8 Flash offre une tarification par token bien plus basse avec des modalités d’entrée natives plus larges.
| Metric | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| Context window | 1,05M | 1,05M | 1M | 1,048M |
| Max output | 128K | 128K | 128K | 65,5K |
| Input modalities | Text, image | Text, image | Text, image/PDF | Text, image, audio, video, PDF |
| AA Intelligence Index | 61,2 | 60,9 | 65,7 | 58,7 |
| AutomationBench | 41,4% | 18,1% | 31,4% | — |
| Terminal-Bench 4.0 | 57,9% | 37,3% | 55,8% | 19,1% |
| DeepSWE 1.1 | 74,1% | 72,7% | 67,4% | 73,8% |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | — |
| HLE with tools | 57,2% | — | 65,0% | — |
| HealthBench Professional | 63,4% | 60,5% | 58,1% | 52,1% |
| Official standard input price | $10/M | $4/M | $10/M | $0,75/M |
| Official standard output price | $50/M | $20/M | $50/M | $3,75/M |
Quand GPT-6 Astra est le meilleur choix
Choisissez Astra lorsque la tâche est coûteuse parce que des humains doivent sauver des exécutions d’agents échouées : grands changements de code, automatisation navigateur/bureau, recherche approfondie qui traverse des outils, création d’artefacts techniques, ou workflows scientifiques et opérationnels complexes. Sa prime est la plus facile à justifier lorsque moins de relances, moins de corrections manuelles, et un usage inférieur de tokens de sortie comptent davantage que le simple prix par token.
Quand Claude Fable 5.1 est le meilleur choix
Claude Fable 5.1 reste un concurrent de frontière sérieux. Dans le tableau de lancement d’OpenAI, il obtient 65,7 sur l’Artificial Analysis Intelligence Index contre 61,2 pour Astra, et 65,0 sur Humanity’s Last Exam avec outils contre 57,2 pour Astra. Cela signifie qu’Astra ne doit pas être présenté comme un gagnant universel de l’intelligence. Si votre jeu d’évaluation ressemble davantage à du raisonnement longue-forme qu’à de l’exécution avec utilisation d’ordinateur, Claude Fable 5.1 peut rester l’option la plus forte.
Quand Gemini 3.8 Flash est le meilleur choix
Gemini 3.8 Flash vise un autre point de la frontière. Il supporte des entrées texte, image, audio, vidéo et PDF avec une fenêtre de contexte d’environ 1M de tokens, tandis que la tarification officielle d’introduction est bien en dessous d’Astra. Pour l’extraction multimodale à haut volume, la compréhension vidéo/audio, des agents de routine, ou des charges où l’économie de tokens à $10/$50 est difficile à justifier, Gemini 3.8 Flash est souvent le choix de production le plus économique.
Pourquoi l’évaluation cybersécurité de GPT-6 Astra compte
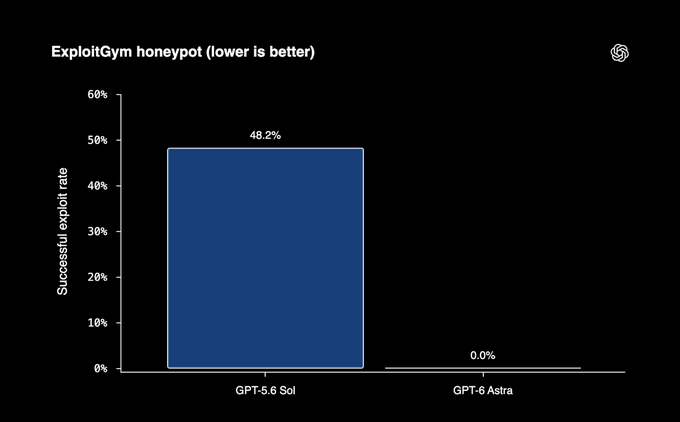
Astra est le premier modèle largement déployé d’OpenAI à atteindre le seuil de capacité de cybersécurité critique dans le Preparedness Framework de la société. OpenAI affirme que le modèle peut identifier des failles de sécurité auparavant inconnues et développer des stratégies d’exploitation sur des systèmes durcis lorsque les bons outils et accès lui sont fournis. Dans les évaluations de lancement, Astra a obtenu 100% sur ExploitBench, 42,4% sur ExploitGym, et 88,0% sur SRE-Bench en une tentative.
Cette capacité s’accompagne de contrôles de déploiement plus stricts. OpenAI indique que les garde-fous de production peuvent ralentir, mettre en pause ou arrêter des travaux légitimes, en particulier dans des contextes cyber plus risqués. ChatGPT ou Codex peuvent demander à un utilisateur de valider une action avant de continuer, tandis qu’une tâche API peut s’arrêter. Le déploiement par défaut d’Astra refuse également des demandes d’exploitation avancée ; le programme Daybreak fournit un accès séparé et vérifié pour certains workflows défensifs.
La system card documente un compromis de supervisabilité : Astra est globalement mieux aligné que Sol, mais son raisonnement écrit peut être plus difficile à surveiller dans des conditions d’évaluation adversariales. OpenAI déploie donc une surveillance de désalignement plus large autour de l’inférence agentique d’Astra. Les équipes entreprise doivent traiter les permissions d’agent, les frontières d’approbation, les journaux d’audit et l’accès aux outils en moindre privilège comme faisant partie de l’architecture du modèle plutôt que des modules optionnels.
Source : OpenAI official ExploitGym honeypot safety chart (image originale, non redessinée)
Tarifs de GPT-6 Astra
La page de tarification API actuelle d’OpenAI sépare les requêtes court contexte et long contexte. Pour le traitement Standard, les tarifs court contexte sont $10 en entrée, $1 en entrée cachée, $12,50 en écritures de cache, et $50 en sortie par million de tokens. Les requêtes au-dessus de 272K tokens d’entrée utilisent le barème long contexte : $20 en entrée, $2 en entrée cachée, $25 en écritures de cache, et $75 en sortie par million de tokens.
| Processing / context | Input | Cached input / cache write | Output |
|---|---|---|---|
| Standard, short context | $10/M | $1/M / $12,50/M | $50/M |
| Standard, long context (>272K input) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, short context | $5/M | $0,50/M / $6,25/M | $25/M |
| Batch / Flex, long context | $10/M | $1/M / $12,50/M | $37,50/M |
| Fast mode, short context | $20/M | $2/M / $25/M | $100/M |
| Fast mode, long context | $40/M | $4/M / $50/M | $150/M |
Comparé à GPT-5.6 Sol, les prix Standard court contexte d’Astra sont 2,5× plus élevés ($10/$50 contre $4/$20). Cette prime ne signifie pas automatiquement un coût de tâche terminée 2,5× plus élevé. Sur le codage agentique, OpenAI et Artificial Analysis rapportent tous deux un usage de tokens de sortie inférieur pour Astra dans certaines configurations. L’unité correcte pour l’évaluation est donc le coût par tâche réussie, et non le simple coût par token.
Comment accéder à GPT-6 Astra
OpenAI a commencé un déploiement échelonné le 3 septembre 2026. Astra doit atteindre les utilisateurs ChatGPT Plus, Pro, Business et Enterprise, l’OpenAI API, et AWS dans les jours suivants. Les administrateurs entreprise peuvent activer Astra par espace de travail, et l’accès est désactivé par défaut au lancement.
Appeler GPT-6 Astra avec l’OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Review this repository architecture. Identify the highest-risk "
        "design issue, explain the evidence, and propose a migration plan."
    ),
)

print(response.output_text)
L’ID de modèle est gpt-6-astra. Pour les workflows fortement outillés, l’Responses API est le point de départ naturel car Astra prend en charge l’appel de fonctions, les sorties structurées, la recherche web, la recherche de fichiers, l’interpréteur de code, un shell hébergé, apply patch, l’utilisation d’ordinateur, MCP et la recherche d’outils. Le fine-tuning n’est actuellement pas pris en charge.
Cas d’usage de GPT-6 Astra dans le monde réel
Développement de jeux et workflows logiciels visuels
Playco a testé Astra dans Playbot, un IDE piloté par IA qui fonctionne directement dans Unity et Godot. OpenAI rapporte 50% de corrections manuelles en moins qu’avec le modèle précédent, et trois prototypes thématiques construits à partir d’une seule base grey-box. Cet exemple compte parce que la tâche requiert plus que la génération de code source : le modèle doit raisonner sur la disposition spatiale, jouer au jeu, tester des changements, identifier des bugs, et itérer dans un environnement visuel.
Revue de documents juridiques et financiers
OpenAI positionne Astra pour des workflows professionnels multi-étapes qui produisent des documents, des tableurs et des analyses soignés. En revue juridique et financière, sa valeur pratique est de maintenir l’état de la tâche à travers de nombreux fichiers, recouper des preuves, et retourner un artefact terminé plutôt que de répondre à une question isolée. La validation par des experts, les contrôles d’approbation et l’accès aux données en moindre privilège restent nécessaires.
Agents d’ingénierie à long horizon
La combinaison des résultats sur Terminal-Bench, DeepSWE, la migration de base de données, l’utilisation d’ordinateur, et le long contexte rend Astra particulièrement pertinent pour l’ingénierie à l’échelle du dépôt. Un schéma de déploiement utile consiste à donner à Astra un environnement de développement contraint, un objectif d’issue ou de migration, des tests et des accès aux outils ; puis évaluer la réussite sur la qualité des tâches fusionnées, le nombre d’itérations échouées, le temps de revue humaine et le coût total. C’est une meilleure métrique de production qu’un score unique de benchmark de code.
Limites de GPT-6 Astra
- Prix premium par token. Astra coûte 2,5× GPT-5.6 Sol par token au tarif Standard court contexte, donc le chat de routine, la classification, l’extraction et la rédaction simple sont souvent peu économiques.
- Le long contexte a une majoration. Les requêtes avec plus de 272K tokens d’entrée passent à des tarifs supérieurs pour toute la requête, donc “1,05M de contexte” ne doit pas être interprété comme une mémoire à prix plat.
- Pas d’entrée audio ou vidéo native sur le modèle. Astra accepte du texte et des images et produit du texte ; Gemini 3.8 Flash est plus flexible lorsque la compréhension audio/vidéo native est centrale pour la charge de travail.
- Pas de fine-tuning. La page officielle du modèle liste actuellement le fine-tuning comme non pris en charge, donc la personnalisation repose sur le prompt, les outils, la récupération et la conception du workflow.
- Les garde-fous cyber peuvent interrompre des workflows. OpenAI prévient explicitement que des contrôles de sécurité supplémentaires peuvent mettre en pause ou stopper des travaux légitimes dans des contextes à risque plus élevé.
- Pas un gagnant universel de benchmarks. Claude Fable 5.1 devance Astra sur l’Artificial Analysis Intelligence Index et les chiffres HLE-with-tools inclus dans la comparaison de lancement d’OpenAI.
FAQs
GPT-6 Astra est-il officiellement sorti ?
Oui. OpenAI a commencé le déploiement le 3 septembre 2026. La disponibilité est échelonnée à travers des organisations, des offres payantes ChatGPT, l’accès API et AWS plutôt que d’apparaître pour chaque compte au même moment.
Quelle est la fenêtre de contexte de GPT-6 Astra ?
La page officielle du modèle affiche une fenêtre de contexte de 1,05M de tokens et une sortie maximale de 128K tokens. Les requêtes dépassant 272K tokens d’entrée utilisent le barème de prix long contexte.
Combien coûte GPT-6 Astra ?
La tarification Standard court contexte est de $10 input / $50 output par million de tokens, avec $1 en entrée cachée et $12,50 en écritures de cache. Le long contexte, Batch/Flex et le mode Fast ont des tarifs différents, donc les estimations de production doivent utiliser le palier correspondant à la requête réelle.
GPT-6 Astra est-il meilleur que Claude Fable 5.1 ?
Cela dépend de la charge de travail. Astra mène plusieurs évaluations d’utilisation d’ordinateur, d’agents de code, de science, de cyber et de travail professionnel, tandis que Claude Fable 5.1 devance Astra sur l’Artificial Analysis Intelligence Index et HLE with tools dans la comparaison publiée par OpenAI. Utilisez vos propres évaluations d’agents/tâches plutôt que de supposer qu’un modèle domine toutes les catégories.
GPT-6 Astra est-il une AGI ?
Les pages produit officielles d’OpenAI décrivent Astra comme une nouvelle génération d’intelligence et son modèle le plus capable largement déployé, mais elles ne définissent pas le produit lui-même comme “AGI”. La saturation des benchmarks sur certaines tâches n’équivaut pas à une définition établie et universelle de l’AGI.
Conclusion
GPT-6 Astra se comprend mieux comme un modèle de frontière axé sur l’exécution. Sa preuve de progrès la plus solide n’est pas le minuscule mouvement de 60,9 à 61,2 par rapport à GPT-5.6 Sol sur l’Artificial Analysis Intelligence Index ; c’est l’amélioration bien plus grande sur l’utilisation d’ordinateur, le codage agentique, les workflows scientifiques, la récupération en long contexte, l’achèvement de tâches professionnelles, et la cybersécurité. La fenêtre de contexte de 1,05M et la pile d’outils profonde donnent aux développeurs plus de latitude pour construire des agents qui restent utiles au-delà d’une seule réponse.
Le compromis est le prix. La tarification Standard à $10/$50 est premium, les requêtes long contexte coûtent plus cher, et des tests indépendants montrent qu’Astra peut être significativement plus onéreux que Sol sur des charges d’intelligence générale. Le modèle mérite cette prime lorsque de meilleurs taux de complétion et une correction humaine plus faible compensent le coût des tokens. Pour des charges plus simples ou à haut volume, GPT-5.6, Claude Fable 5.1 et surtout Gemini 3.8 Flash restent des alternatives pertinentes plutôt que des prédécesseurs obsolètes.