
TLDR: DeepSeek-V4.1-Flash-1017 adalah pembaruan minor namun sangat berdampak pada model V4.1-Flash milik DeepSeek yang dirilis 17 Oktober 2026. Ia menghadirkan hasil yang lebih kuat pada tolok ukur penalaran, pengodean, agenik, dan visual, sekaligus menghasilkan output yang lebih pendek dan menyelesaikan tugas lebih cepat—mendorong frontier Pareto kinerja-biaya.
Poin Penting
- DeepSeek-V4.1-Flash-1017 Dirilis 17 Oktober 2026 sebagai upgrade gratis untuk endpoint API
deepseek-flashyang ada—pengguna lama tidak perlu mengubah kode. - Kenaikan yang dilaporkan vendor pada semua 11 benchmark yang tercantum vs. V4.1-Flash bulan September, dengan lonjakan terbesar pada tugas agenik dan pengodean.
- Arsitektur: Mixture-of-Experts 552B parameter dengan desain Causal Encoder-Decoder (≈8B parameter aktif pada input/prefill, 16B pada decode/output); jendela konteks 1M token; hingga 384K token output; dukungan visi native.
- Harga tidak berubah: Off-peak $0.15 / $0.60 per 1M token input (cache miss) / output (peak menggandakan tarif ini); cache hit serendah $0.003. CometAPI dihargai 20% di bawah tarif resmi.
- API Search & Fetch baru dibuka untuk semua developer ($0.75 per 1.000 panggilan; gratis melalui beberapa alat server-side hingga 31 Okt 2026).
- Kapabilitas “pemrograman berbasis keinginan” yang kuat untuk generasi proyek end-to-end (gim, adegan 3D, repo lengkap). Kompetitif melawan model tertutup yang lebih besar pada benchmark agen/pengodean sambil tetap jauh lebih murah dan cepat untuk banyak beban kerja produksi.
- Bobot open-source MIT di Hugging Face dan ModelScope memungkinkan self-hosting dan fine-tuning.
- Untuk produksi, platform seperti CometAPI menyediakan akses kompatibel OpenAI yang praktis ke model DeepSeek bersama 500+ lainnya, sering kali dengan harga kompetitif dan kemudahan switching.
DeepSeek terus mendorong batas model AI terbuka yang efisien dan berkinerja tinggi. Pada 17 Oktober 2026, perusahaan merilis DeepSeek-V4.1-Flash-1017, sebuah pembaruan terarah untuk model V4.1-Flash (awalnya diluncurkan 10 September 2026). Dipasarkan dengan peningkatan substansial dalam penalaran, pengodean, kapabilitas agenik, dan pemahaman visual—seraya mengurangi waktu eksekusi tugas dan panjang output—checkpoint ini diposisikan sebagai model efisien paling kuat DeepSeek hingga saat ini untuk beban kerja agen dan pengodean dunia nyata.
Model ini sudah aktif di situs web, aplikasi seluler, dan API DeepSeek (tetap disebut deepseek-flash). Bobot dirilis secara terbuka di bawah lisensi MIT, menjadikannya salah satu opsi open-weight terkuat bagi developer yang menginginkan performa agen level frontier tanpa biaya level frontier.
Apa Sebenarnya DeepSeek V4.1-Flash-1017?
DeepSeek-V4.1-Flash-1017 adalah checkpoint bertanggal (“1017” mengacu pada rilis 17 Oktober) dari keluarga V4.1-Flash. DeepSeek menggambarkannya sebagai “pembaruan minor,” namun peningkatannya luas dan bermakna: skor lebih tinggi di setiap kategori benchmark yang dilaporkan, penyelesaian tugas lebih cepat, dan output lebih pendek. Perusahaan membingkainya sebagai peningkatan Pareto sejati—kinerja lebih baik dan efisiensi biaya lebih baik secara simultan.
Model ini mewarisi arsitektur inovatif yang diperkenalkan dengan V4.1-Flash:
- Desain Mixture-of-Experts (MoE) dengan sekitar 552B total parameter backbone (ditambah parameter Engram dalam beberapa laporan). Arsitektur Causal Encoder-Decoder baru yang hanya mengaktifkan ~8B parameter per token selama pemrosesan input/prefill dan ~16B selama generasi decode/output.
- KV cache yang sangat terkompresi (diklaim pengurangan kebutuhan HBM 1/4 dan SSD 1/8 dibanding generasi sebelumnya), yang secara dramatis menurunkan biaya konteks panjang dan interaksi agen multi-giliran.
- Dukungan multimodal native (input teks + gambar → output teks). Jendela konteks 1 juta token dan panjang output maksimum 384K token (pengambilan sampel yang direkomendasikan sering menggunakan ≥256K token maks).
- Dukungan mode berpikir dan non-berpikir, pemanggilan alat (tool calling), output JSON, dan upaya penalaran yang dapat disesuaikan.
Model ini dilatih dengan teknik reinforcement learning yang ditingkatkan, termasuk loop umpan-balik mandiri yang secara khusus ditujukan untuk meningkatkan pengembangan proyek end-to-end. Ini memungkinkan “pemrograman berbasis keinginan” yang lebih andal—mengubah tujuan bahasa alami tingkat tinggi menjadi proyek yang lengkap dan fungsional seperti gim web, adegan 3D, atau repositori kode penuh.
Bagi pengembang aplikasi, ini menggeser pertanyaan evaluasi. Alih-alih memeriksa apakah model dapat menghasilkan fungsi yang masuk akal, uji apakah model dapat memahami codebase yang ada, melakukan edit terkoordinasi, menjalankan pemeriksaan, dan memperbaiki kesalahan. Demonstrasi yang meyakinkan menetapkan sebuah kapabilitas yang layak diuji; itu tidak menetapkan keandalan di seluruh repositori arbitrer.
Pembaruan juga membuat efisiensi output layak diukur secara terpisah dari kualitas jawaban. Respons yang lebih pendek dapat mengurangi biaya generasi, tetapi hanya jika tetap mempertahankan implementasi, penjelasan, atau bukti yang dibutuhkan tugas. Menghapus validasi yang berguna akan menjadi kemunduran bahkan jika tagihan token turun.
Spesifikasi API DeepSeek V4.1-Flash-1017
| Specification | DeepSeek V4.1-Flash-1017 |
|---|---|
| Native API identifier | deepseek-flash |
| Context window | 1M tokens |
| Maximum output | 384K tokens |
| Input support | Text and images |
| Reasoning modes | Thinking and non-thinking |
| Developer features | Tool calls, JSON output, Responses API |
| Architecture | Causal Encoder–Decoder MoE |
| Announced family parameter count | 552B |
| Active parameters | 8B for input; 16B for output |
Bagaimana Performa DeepSeek V4.1-Flash-1017 pada Benchmark?
Uji awal independen (mis., berdampingan dengan DeepSeek V4 Pro) menunjukkan 1017 menyamai kualitas pada tugas praktis sambil signifikan lebih cepat dan lebih murah, plus menambahkan dukungan visi yang kurang dimiliki Pro dalam beberapa konfigurasi.
Hasil pilihan yang dilaporkan vendor membandingkan rilis September dengan pembaruan 17 Oktober.
| Official benchmark results | September release | October 17 update | Absolute score change (points) |
|---|---|---|---|
| HLE without tools | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography with tools | 78.9 | 83.0 | +4.1 |
Ini adalah hasil yang dilaporkan vendor, bukan replikasi independen. DeepSeek menggunakan Claude Code untuk Terminal-Bench 4.0 dan Mini-SWE-V2 untuk DeepSWE v1.1. HLE dilaporkan tanpa alat dan menggunakan skor utama alih-alih subset khusus teks yang ditandai secara terpisah; Chartography menggunakan alat. Tabel rilis yang dikutip tidak menyediakan konfigurasi per baris lengkap untuk setiap benchmark lainnya, sehingga anggaran penalaran setara, perangkat keras, dan kondisi penghentian tidak dapat diasumsikan. Perubahan di atas adalah selisih skor sederhana, bukan peningkatan persentase relatif.
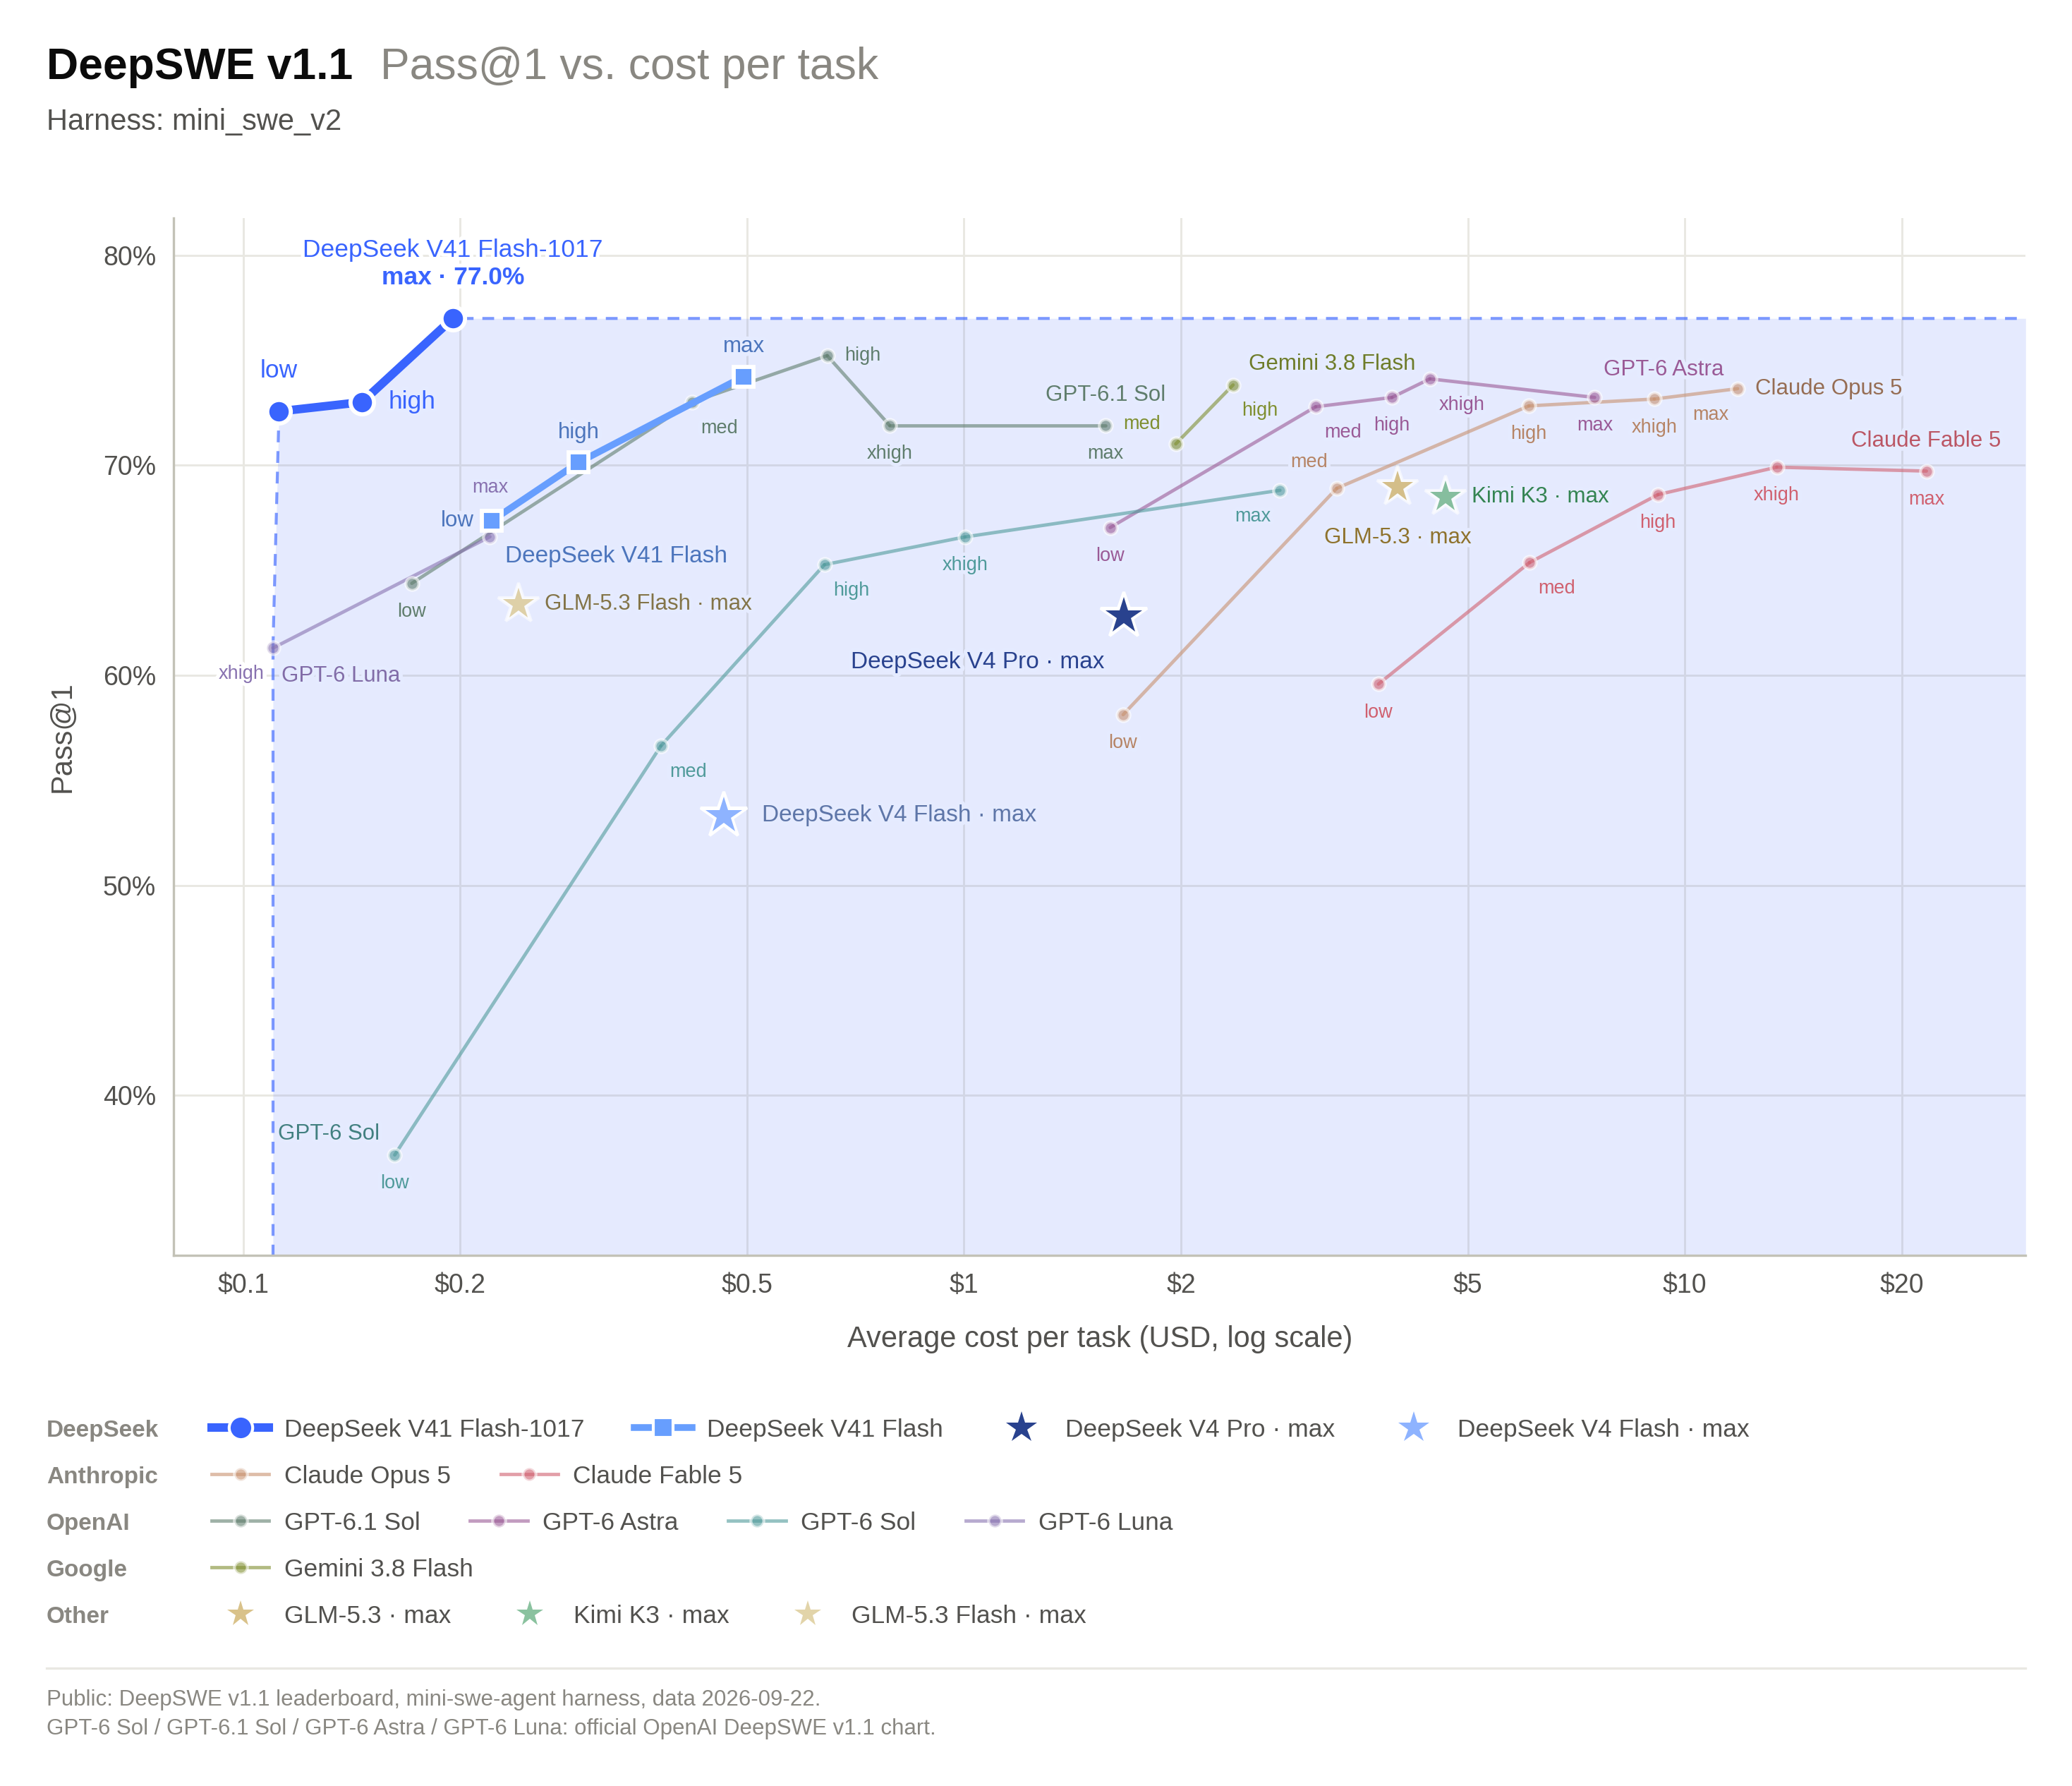
Bagan kinerja-versus-biaya DeepSWE v1.1 milik DeepSeek memplot Pass@1 terhadap biaya tugas rata-rata dalam USD pada sumbu logaritmik, menggunakan harness Mini-SWE-V2. Pengaturan penalaran yang berbeda muncul sebagai titik terpisah; bandingkan tingkat keberhasilan dan konfigurasi yang sesuai sebelum menarik kesimpulan biaya.
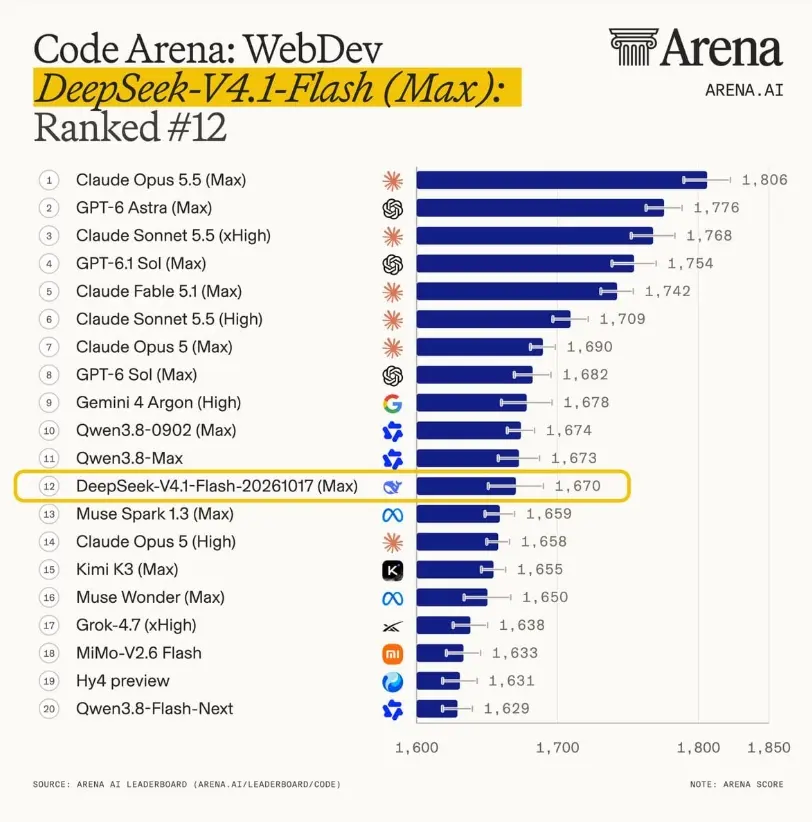
Code Arena: WebDev Leaderboard – Model Sumber Terbuka Teratas
Dalam evaluasi benchmark frontier coding dan pengembangan web WebDev terbaru, DeepSeek-V4.1-Flash-1017 tidak hanya melampaui Kimi K3 (Max) yang sangat dihormati tetapi juga mencapai peningkatan efisiensi biaya inferensi satu orde besaran—dengan biaya operasional kira-kira sepersepuluh dari padanannya. DeepSeek-V4.1-Flash-20261017 (Max) secara resmi meraih posisi puncak pada Code Arena: WebDev leaderboard, memperoleh gelar "model sumber terbuka nomor satu."
Pada papan peringkat keseluruhan, model ini menempati peringkat ke-12 dengan skor 1670. Pada tingkat peringkat tinggi ini, ia mengungguli model tertutup terdepan, Claude Opus5 (High), dan telah memperkecil jarak dengan model kelas atas, GPT-6Sol (Max), hingga dalam 10 poin.
Bagaimana Pembaruan Oktober Dibandingkan dengan Rilis September?
Dibanding dengan rilis September, pembaruan 17 Oktober menunjukkan kenaikan paling jelas pada benchmark pengodean terpilih: Terminal-Bench 4.0 naik dari 31.2 ke 42.3 (+11.1 poin), sementara ProgramBench naik dari 20.3 ke 29.1 (+8.8 poin). DeepSWE v1.1 meningkat dari 74.2 ke 77.0 (+2.8 poin). Hasil yang dilaporkan vendor ini mendukung evaluasi pembaruan untuk alur kerja terminal dan tugas pemrograman yang lebih luas; ini tidak menyiratkan kenaikan produktivitas setara di setiap codebase.
Rilis juga menempatkan penekanan lebih besar pada pengembangan proyek lengkap melalui reinforcement learning dengan umpan balik mandiri. Kecepatan dan penghematan token tetap bergantung pada tugas, seperti yang ditunjukkan oleh dua contoh pada bagian berikutnya. Untuk integrasi API native yang ada, pengenal model tetap deepseek-flash. Keputusan upgrade praktis karenanya harus bertumpu pada penyelesaian tugas yang diterima, total biaya, dan waktu end-to-end yang diukur pada pekerjaan representatif.
Berapa Biaya DeepSeek V4.1-Flash-1017?
Keunggulan biayanya sangat besar: Flash biasanya 10–40× lebih murah per token daripada model tertutup teratas, dan output yang lebih pendek semakin memperkuat penghematan pada agen multi-langkah. Dibanding pendahulunya, 1017 secara ketat lebih baik pada metrik yang dilaporkan sambil mempertahankan harga yang sama—menjadikannya upgrade murni.
USD per satu juta token, sebagaimana dicatat dalam artikel sumber pada 19 Oktober 2026. Tarif puncak CometAPI menerapkan pengali 2× yang dipublikasikan.
| Token category | DeepSeek native: off-peak | DeepSeek native: peak | DeepSeek V4.1 Flash API in CometAPI: base | CometAPI: 2× window |
|---|---|---|---|---|
| Input, cache hit | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Input, cache miss | $0.15 | $0.30 | $0.12 | $0.24 |
| Output | $0.60 | $1.20 | $0.48 | $0.96 |
Kedua penyedia mencantumkan jendela puncak hari kerja pukul 01:00–04:00 dan 06:00–10:00 UTC. DeepSeek mengecualikan hari libur umum Tiongkok; ketentuan yang ditampilkan CometAPI tidak menentukan pengecualian tersebut. Jam lainnya menggunakan tarif off-peak/base. Kolom 2× CometAPI dihitung dari harga dasar yang dipublikasikan.
Untuk API native DeepSeek, 10 juta token input yang tidak di-cache plus 2 juta token output berbiaya:
- Off-peak: (10 × $0.15) + (2 × $0.60) = $2.70.
- Peak: (10 × $0.30) + (2 × $1.20) = $5.40.
Untuk anggaran pilot, bagi seluruh token dan biaya alat di semua percobaan berdasarkan tugas yang diterima. Sertakan reuse cache dan jendela puncak; laporkan biaya infrastruktur dan tinjauan manusia secara terpisah. Contoh di atas hanya mencakup token model.
Biaya Search dan Fetch
Search dan Fetch API milik DeepSeek masing-masing berbiaya $0.75 per 1.000 permintaan yang berhasil. Penagihannya terpisah dari penggunaan token model; permintaan gagal, hasil pencarian kosong, dan timeout tidak dikenai biaya berdasarkan aturan yang didokumentasikan.
Bagi pengguna API DeepSeek, panggilan Search dan Fetch sisi server melalui DeepSeek Harness, Claude Code, dan Codex sementara gratis sesuai kebijakan penagihan resmi. Penagihan untuk panggilan tersebut dimulai 31 Oktober 2026, pukul 16:00 UTC, setara dengan 1 November tengah malam di Beijing. Pembebasan terbatas ini tidak membuat semua permintaan API Search dan Fetch mandiri menjadi gratis.
Apakah DeepSeek V4.1-Flash-1017 Selalu Lebih Cepat dan Lebih Murah?
Tidak. Uji dua tugas milik EmpirioLabs menemukan waktu dan penggunaan token output yang lebih rendah untuk animasi akuarium, tetapi nilai yang lebih tinggi untuk animasi cakrawala:
| EmpirioLabs’ first-hand coding tests | September release | October 17 update | Observed result |
|---|---|---|---|
| Aquarium completion time | 162 seconds | 124 seconds | October update faster |
| Aquarium output tokens | 41,833 | 33,149 | October update used fewer |
| Skyline completion time | 163 seconds | 177 seconds | October update slower |
| Skyline output tokens | 37,928 | 42,907 | October update used more |
Kedua versi menghasilkan animasi yang berfungsi dalam uji ini di platform API EmpirioLabs pada 18 Oktober 2026. Setiap tugas menggunakan prompt yang sama dan meminta satu file HTML mandiri dengan CSS dan JavaScript inline, tanpa pustaka atau aset eksternal. Kedua model berjalan dengan pengaturan default, berpikir diaktifkan pada anggaran default, dan batas output 65.536 token. Model dijalankan bersamaan untuk setiap tugas, dengan satu percobaan per model. Waktu mencakup seluruh permintaan; jumlah token output, termasuk token penalaran, berasal dari laporan penggunaan API. Tangkapan layar dirender dalam peramban headless setelah enam detik. Dua contoh ini menggambarkan variasi beban kerja alih-alih menetapkan peringkat umum.
Bagaimana Cara Mengakses DeepSeek V4.1-Flash-1017?
- Official DeepSeek API — Gunakan nama model
deepseek-flashdi https://api.deepseek.com. - Open weights — Unduh dari Hugging Face atau ModelScope untuk self-hosting.
- CometAPI — CometAPI Adds DeepSeek-V4.1-Flash-1017 Lihat detail model Model ID: deepseek-v4.1-flash-1017
Gunakan API Native DeepSeek
API quick start milik DeepSeek dan CometAPI mengonfirmasi bahwa deepseek-flash kini menyajikan versi 17 Oktober, dengan metode pemanggilan yang tidak berubah.
Kirim permintaan perencanaan proyek melalui API dengan Python. Instal paket OpenAI Python dan set API_KEY di environment Anda sebelum menjalankan contoh.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Design a small issue-tracking application. "
                "Give the data model, implementation plan, "
                "and acceptance tests."
            ),
        }
    ],
)
print(response.choices[0].message.content)
Ini menghasilkan respons model. Untuk membangun dan memvalidasi proyek secara otomatis, lingkungan agen harus tambahan menyediakan akses file, eksekusi perintah, umpan balik uji, dan izin yang sesuai.
CometAPI Rekomendasi: CometAPI sudah mencantumkan berbagai model DeepSeek dan merupakan cara yang sangat baik untuk mencoba V4.1-Flash-1017 bersama Claude, GPT, Gemini, Grok, serta model khusus pengodean/visi tanpa keterikatan vendor. Daftar dan dapatkan kunci API, lalu arahkan SDK OpenAI Anda yang ada ke base URL CometAPI. Pendekatan ini sangat kuat untuk kerangka kerja agen yang diuntungkan oleh perutean sub-tugas yang berbeda ke model yang paling hemat biaya atau berkinerja tertinggi yang tersedia.
Kesimpulan
DeepSeek-V4.1-Flash-1017 mewakili lompatan cerdas dan efisien ke depan dalam kapabilitas AI terbuka. Dengan meningkatkan performa di berbagai benchmark agenik dan pengodean yang kritis sambil sekaligus mengurangi panjang output dan waktu tugas—semuanya dengan harga rendah yang tidak berubah—model ini memperkuat posisi DeepSeek sebagai pemimpin dalam perlombaan kinerja-per-dolar. Baik Anda membangun agen perangkat lunak otonom, aplikasi multimodal, atau sistem produksi yang dioptimalkan biaya, model ini layak dievaluasi secara serius.
Dipadukan dengan lapisan akses yang nyaman seperti CometAPI, pengembang dapat mengintegrasikan model mutakhir seperti V4.1-Flash-1017 ke dalam alur kerja multi-penyedia yang tangguh dengan gesekan minimal. Seiring evaluasi independen terus bermunculan dan ekosistem alat (Harness, CodeBuddy, dll.) semakin matang, harapkan checkpoint ini menjadi pilihan default untuk banyak beban kerja volume tinggi dan berinteligensi tinggi pada akhir 2026 dan seterusnya.