
TL;DR
Gemini 4 Argon tidak termasuk dalam Gemini API Free tier, dan langganan Google AI Pro saja tidak menyediakan akses Argon API. Google AI Ultra mungkin menyediakan akses melalui produk Gemini tertentu, sementara penggunaan API berbayar tetap ditagih secara terpisah. CometAPI menawarkan jalur API independen tanpa mengharuskan setiap pengguna akhir memiliki langganan Google AI Pro atau Ultra. Tarif input dan output tanpa cache yang dipublikasikan adalah $1,60 dan $8 per satu juta token, dibandingkan tarif Standard perkenalan Google sebesar $2 dan $10.
Akses dan tarif utama penyedia diperiksa pada 16 Oktober 2026.
Key Takeaways
- Harga perkenalan: $2 / 1M token input dan $10 / 1M token output; mulai 1 Desember, tarif menjadi dua kali lipat.
- Input dalam cache: diskon cache implisit 95% untuk hit yang memenuhi syarat; minimum cache adalah 4,096 token prompt.
- Penagihan output mencakup token pemikiran; input, pemikiran, dan output yang terlihat berbagi anggaran 1,048,576 token.
- Bedakan langganan aplikasi Gemini dari hak Antigravity dan akses API berbayar. Ketiadaan model di satu produk tidak berarti semua jalur akses tidak tersedia.
- CometAPI menyediakan jalur API independen dengan tarif input dan output tanpa cache yang lebih rendah. Aplikasi dapat melayani banyak pengguna akhir melalui satu akun CometAPI tanpa mengharuskan setiap pengguna mempertahankan langganan Google AI Pro atau Ultra; batas kuota, saldo, tarif, dan konkurensi tingkat akun tetap berlaku.
What Are Google’s Current Gemini 4 Argon Access Limits?
Keputusan pertama adalah di mana Anda memerlukan Argon: aplikasi interaktif, lingkungan coding lokal, atau integrasi API. Pengumuman akses pengembang Google membedakan akses Gemini API berbayar dari akses pelanggan Ultra di AI Studio dan Antigravity. Jangan menafsirkan pembatasan langganan Antigravity sebagai persyaratan untuk membeli Ultra untuk setiap alur kerja API berbayar.
Untuk aplikasi API, CometAPI menyediakan jalur akun dan penagihan alternatif. Ini berguna saat Anda ingin mengevaluasi Argon bersama model lain tanpa membeli langganan konsumen Google untuk tujuan tersebut. Ini tidak mengubah hak akses di dalam aplikasi Google sendiri, dan tidak boleh digambarkan sebagai penggunaan tak terbatas.
How Much Does Gemini 4 Argon API Cost?
Tarif Standard Gemini 4 Argon Google berlaku hingga 30 November 2026, dengan tarif lebih tinggi mulai 1 Desember. Semua jumlah di bawah ini adalah USD per satu juta token kecuali dinyatakan lain. Batch, Flex, dan Priority memiliki tarif terpisah.
| Kategori penagihan (USD / 1M token) | Google Standard: hingga 30 Nov 2026 | Google Standard: mulai 1 Des 2026 | Gemini 4 Argon API di CometAPI |
|---|---|---|---|
| Input | $2.00 | $4.00 | $1.60 |
| Input dalam cache | $0.10 | $0.20 | $0.16 |
| Output, termasuk pemikiran | $10.00 | $20.00 | $8.00 |
Tarif CometAPI diperiksa pada 14 Oktober 2026. Harga input dan output yang dipublikasikan 20% di bawah tarif Standard perkenalan Google. Angka input-dalam-cache berasal dari kalkulator biaya CometAPI; konfirmasikan tarif akun aktif dan kelayakan cache sebelum mengandalkannya. Perubahan harga Google pada bulan Desember tidak menentukan tarif CometAPI di masa depan; periksa tarif yang ditampilkan di akun CometAPI Anda saat menyusun anggaran.
Dengan tarif ini, 200,000 token input tanpa cache plus 60,000 token output yang ditagihkan berbiaya $0.80 melalui CometAPI, dibandingkan $1.00 melalui Google selama periode perkenalan. Contoh perhitungan ini tidak termasuk alat dan percobaan ulang.
What Does Gemini 4 Argon Cost Across Realistic Workloads?
Skenario berikut adalah contoh perhitungan, bukan penggunaan model terukur. Input tidak di-cache; output mencakup pemikiran dan teks yang terlihat. Permintaan agen pengodean dengan 200,000 token input dan 60,000 token output yang ditagihkan berbiaya $1.00 selama periode perkenalan dan $2.00 setelahnya. Beban kerja yang sama diulang 1,000 kali berbiaya $1,000 atau $2,000 sebelum percobaan ulang, alat, dan pajak.
| Contoh permintaan | Token input tanpa cache | Token output yang ditagihkan | Harga intro | Harga standard |
|---|---|---|---|---|
| Jawaban asisten singkat | 5K | 1K | $0.02 | $0.04 |
| Analisis dokumen | 100K | 10K | $0.30 | $0.60 |
| Agen coding kompleks | 200K | 60K | $1.00 | $2.00 |
| Alur kerja riset | 500K | 100K | $2.00 | $4.00 |
| Permintaan decode panjang | 100K | 500K | $5.20 | $10.40 |
Formula: Cost = (uncached input tokens × input rate + cached input tokens × cached rate + billable output tokens × output rate) / 1,000,000. Contoh di atas bersifat ilustratif dan mengasumsikan tanpa cache.
How Can You Reduce Gemini 4 Argon API Costs?
Implicit Caching and Reused Prompt Prefixes
Caching menurunkan pengeluaran untuk input yang digunakan ulang, bukan harga seluruh permintaan. Untuk contoh 200K input / 60K output, hit cache input yang memenuhi syarat sepenuhnya menurunkan biaya input perkenalan dari $0.40 menjadi $0.02. Total biaya token menjadi $0.62 alih-alih $1.00: pengurangan 38%, meskipun diskon input adalah 95%. Jika 50% token input dilayani dari cache, permintaan yang sama berbiaya $0.81: 100,000 token input dalam cache × $0.10 / 1M + 100,000 token input tanpa cache × $2 / 1M + 60,000 token output yang ditagihkan × $10 / 1M = $0.01 + $0.20 + $0.60. Di sini, 50% merujuk secara spesifik pada volume token input. Perlakukan ini sebagai skenario dan gunakan penggunaan token dalam cache yang diamati untuk peramalan.
Google mengaktifkan caching implisit untuk prompt minimal 4,096 token dan tidak mendukung pembuatan cache eksplisit untuk Argon. Pertahankan prefiks prompt yang dapat digunakan kembali, tetapi susun anggaran untuk input tanpa cache hingga hit cache yang diamati membenarkan estimasi yang lebih rendah.
Thinking Levels and Output Spending
Jawaban terlihat yang pendek tetap dapat membawa biaya output yang besar karena pemikiran ditagihkan. Mulailah dengan pemikiran tingkat sedang, kemudian uji tingkat yang lebih rendah dan lebih tinggi pada tugas representatif. Lacak kualitas dan total penggunaan output; pilih tingkat penalaran terendah yang memenuhi kriteria penerimaan Anda.
Karena pemikiran dan output yang terlihat berbagi batas respons, nilai max_output_tokens yang rendah dapat menyisakan ruang yang tidak memadai untuk jawaban akhir. Bandingkan keberhasilan penyelesaian tugas pada setiap tingkat pemikiran sebelum menurunkan batas output.
Operational Controls for Gemini 4 Argon Costs
- Gunakan batas output yang realistis dan hindari generasi yang panjang tanpa perlu.
- Gunakan ulang prefiks prompt bersama saat memenuhi syarat untuk caching implisit.
- Rute tugas sederhana ke model yang lebih murah, sisakan Argon untuk kasus sulit.
- Catat total token yang ditagihkan, kegagalan, percobaan ulang, dan biaya per tugas berhasil.
- Evaluasi ekonomi pada tarif pascapromosi sebelum berkomitmen pada penerapan besar.
How Can You Access Gemini 4 Argon?
Pilih akses aplikasi Gemini untuk pekerjaan interaktif pribadi dan jalur API berbayar untuk aplikasi serta agen otomatis. Argon dikecualikan dari Gemini API Free tier; langganan Google AI Pro saja tidak memberikan akses Argon API. Hak aplikasi Pro dan Ultra terpisah dari penagihan token API, dan Ultra tidak diperlukan untuk Gemini API berbayar.
| Jalur akses | Akses Argon | Penagihan / hak |
|---|---|---|
| Aplikasi Gemini | Pelanggan Pro dan Ultra yang memenuhi syarat | Langganan dan batas aplikasi |
| Google AI Studio | Pelanggan Ultra yang memenuhi syarat atau pengguna API berbayar | Bergantung pada jalur akses |
| Gemini API | Proyek berbayar yang memenuhi syarat | Penagihan API berbasis penggunaan |
| Google Antigravity | Pelanggan Ultra yang memenuhi syarat | Hak spesifik produk |
| CometAPI | Akun CometAPI yang didukung | Tarif dan ketentuan CometAPI |
Direct Gemini 4 Argon API Integration
Pengembang dapat mengintegrasikan Gemini 4 Argon secara langsung melalui proyek Gemini API berbayar yang memenuhi syarat. ID model adalah gemini-4-argon. Jalur ini ditujukan untuk aplikasi, agen otomatis, dan alur kerja produksi yang memerlukan akses langsung ke API Google, penagihan berbasis penggunaan, dan fitur API resmi.
Gemini API Free tier tidak termasuk Argon. Akses aplikasi Google AI Pro juga tidak otomatis menyediakan akses API atau kredit API. Pengembang harus mengonfigurasi penagihan dan kelayakan untuk proyek yang terkait dengan kredensial API mereka.
Kesalahan autentikasi, penagihan, atau kelayakan harus diselesaikan untuk proyek pemilik kunci sebelum mencoba lagi; mengubah langganan konsumen saja tidak mengonfigurasi penagihan API.
CometAPI Access for Gemini 4 Argon
Pengembang dapat mengakses Gemini 4 Argon API di CometAPI melalui akun dan kunci API terpisah. Keuntungan praktisnya adalah penagihan API independen, akses ke banyak model melalui satu penyedia, dan tarif input/output yang dipublikasikan seperti di atas. Jalur ini tidak mengharuskan pembelian Google AI Pro atau Ultra sebagai langganan konsumen.
Akses berbasis akun bukan janji kapasitas tanpa batas. Konfirmasikan ketersediaan model, saldo, batas tarif dan konkurensi, wilayah yang didukung, caching, kontrol pemikiran, dan pelaporan penggunaan untuk akun CometAPI Anda. Akses API juga tidak membuka Argon di dalam aplikasi Gemini atau Antigravity.
Mulailah dengan permintaan kecil melalui penyedia yang dipilih, verifikasi bidang model dan penggunaan yang dikembalikan, lalu tetapkan batas pengeluaran sebelum meningkatkan trafik.
Is Gemini 4 Argon Worth the Cost?
Gemini 4 Argon adalah kandidat untuk penalaran menuntut, pengodean, riset, dan pekerjaan konteks panjang. Nilainya bergantung pada apakah model ini meningkatkan keberhasilan penyelesaian tugas atau mengurangi percobaan ulang cukup banyak untuk membenarkan pengeluaran token. Gunakan spesifikasi dan tolok ukur yang dipublikasikan di bawah untuk mengidentifikasi beban kerja yang akan diuji, lalu evaluasi kualitas dan biaya dengan prompt, alat, dan jalur akses Anda sendiri.
Gemini 4 Argon Specifications
| Spesifikasi | Gemini 4 Argon |
|---|---|
| ID model | gemini-4-argon |
| Pengembang | Google DeepMind |
| Jenis model | Model multimodal berorientasi penalaran |
| Jendela gabungan input + pemikiran + output | Hingga 1,048,576 token gabungan |
| Tingkat pemikiran | Rendah / sedang / tinggi |
| Tingkat pemikiran default | Sedang |
| Dukungan output panjang | Eksekusi latar belakang; maksimum tunduk pada anggaran bersama |
| Cache konteks | Implisit; prompt yang memenuhi syarat ≥ 4,096 token |
| Cache eksplisit | Tidak didukung |
Batas satu juta token dibagi antara input, pemikiran, dan output yang dihasilkan. Pada Interactions API, menghasilkan lebih dari 65,536 token memerlukan background=True dan generation_config.max_output_tokens di atas 65,536. Mengatur background=True saja tidak menaikkan batas output default. GenerateContent API juga mendukung kelanjutan di sisi klien untuk decoding panjang
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: Published Benchmarks
Nilai berikut cocok dengan hasil evaluasi yang dipublikasikan Google. Ini adalah hasil yang dipublikasikan vendor yang dikompilasi dari berbagai sumber evaluasi, bukan perbandingan terkontrol baru untuk artikel ini.
| Tolok ukur yang dipublikasikan | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% |
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% |
| GraphWalks 256K–1M, BFS F1 | 84.2% | 71.8% | 66.8% |
| LVBench | 91.7% | 87.5% | 83.7% |
Evaluation Conditions and Comparability
Metodologi evaluasi Google menggunakan Gemini API pada pengaturan pemikiran tertinggi kecuali disebutkan lain, umumnya dengan pass@1. DeepSWE menggunakan mini-swe untuk Argon; angka pesaing berasal dari leaderboard atau kartu sistem. GraphWalks 256K–1M menggunakan 200 masalah. LVBench dijalankan tanpa alat, dengan 1 FPS untuk Gemini, 800 frame untuk GPT-6 Astra, dan 600 untuk Opus 5.5. Hasil Vals berasal dari Vals AI; AutomationBench menggunakan leaderboard set privat Zapier. Perbedaan ini membatasi keterbandingan langsung.
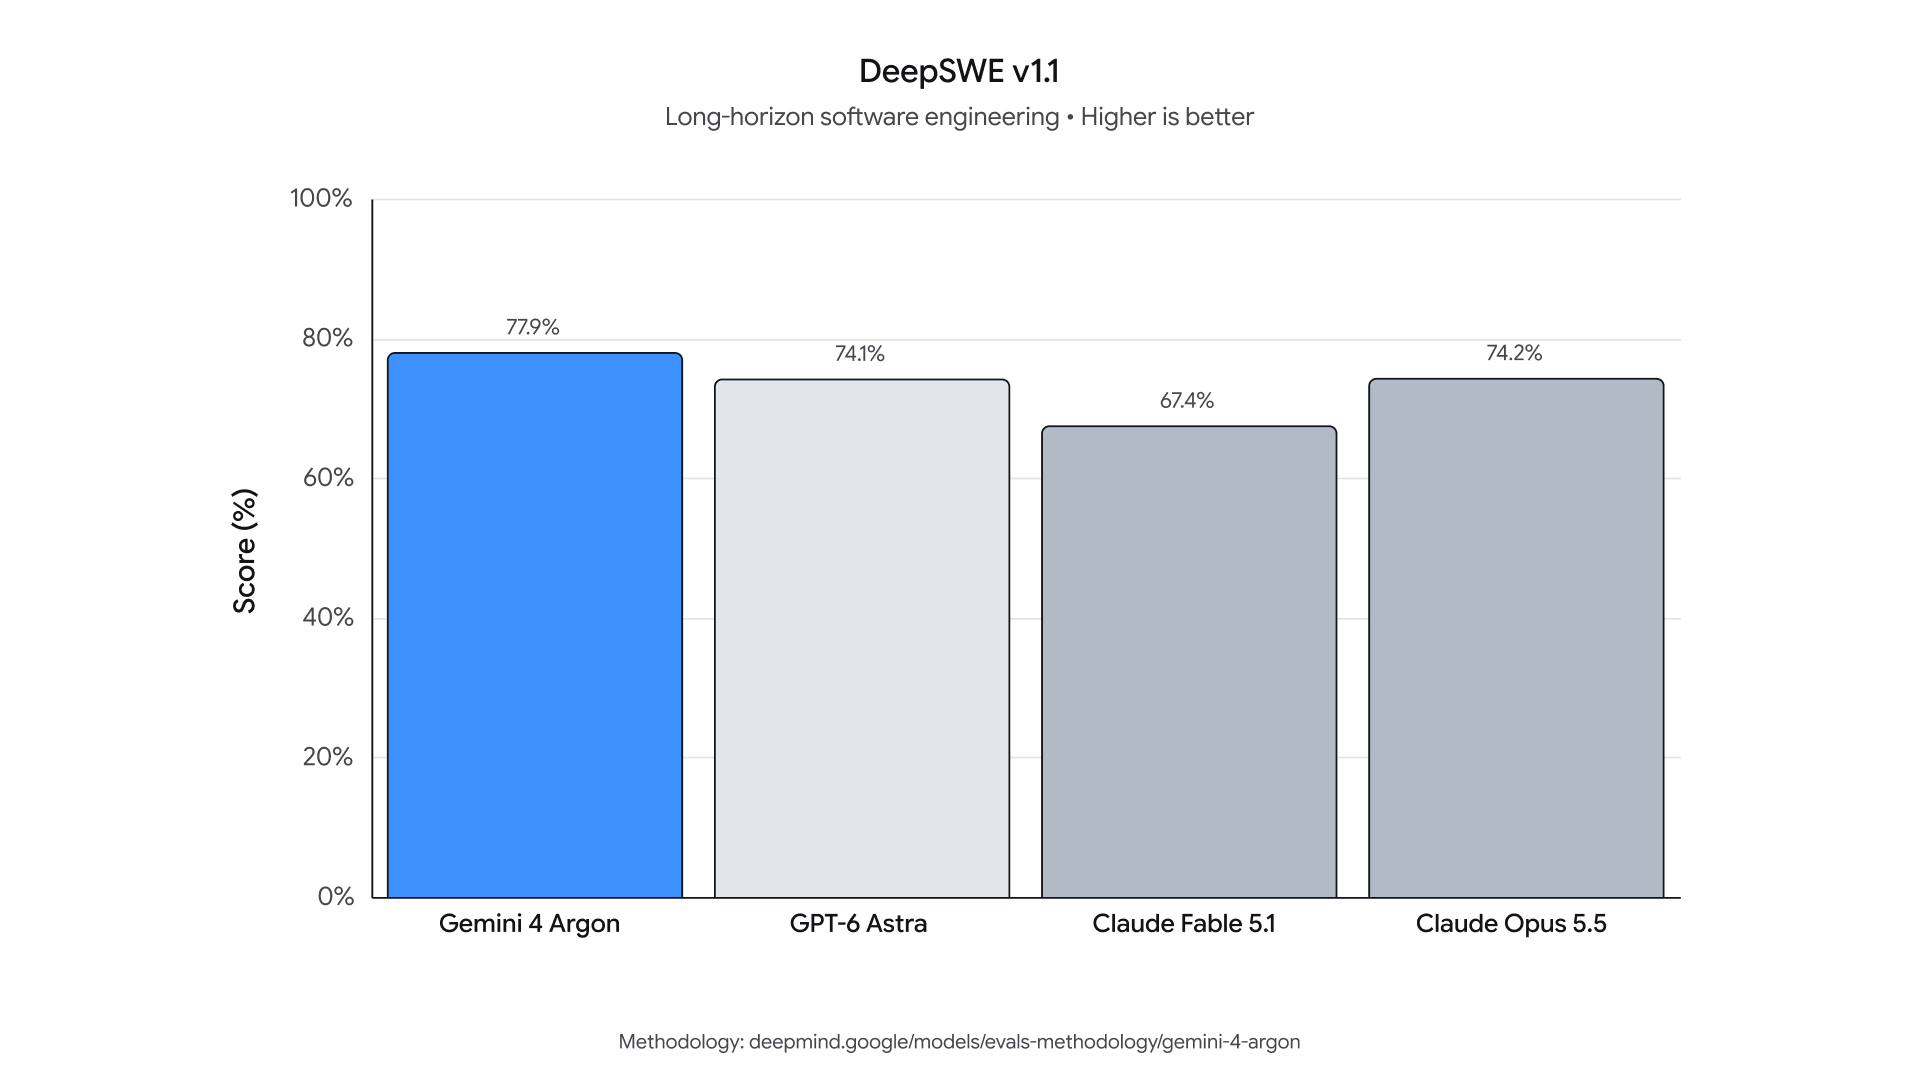
Gambar grafik DeepSWE v1.1 asli Google menampilkan Gemini 4 Argon (77.9%), GPT-6 Astra (74.1%), Claude Fable 5.1 (67.4%), dan Claude Opus 5.5 (74.2%), dari kiri ke kanan. Tabel di atas memilih tiga model ini; gambar resmi mencakup keempatnya.
Performance Implications for Gemini 4 Argon Users
Interpretasi: Argon memimpin pada baris Vals Index, AutomationBench, agen keuangan, dan konteks panjang yang dipilih; tidak memimpin pada FrontierSWE atau Terminal-bench. Karena perangkat evaluasi dan prompt dapat bervariasi, gunakan hasil ini sebagai bukti arah dan jalankan uji beban kerja spesifik.
Untuk pengadaan, ukur biaya tugas yang berhasil bersama akurasi, latensi, percobaan ulang, dan penggunaan token. Skor yang lebih tinggi yang dipublikasikan tidak menetapkan biaya produksi yang lebih rendah di bawah prompt, alat, atau jalur akses Anda.
Choose Gemini 4 Argon or Cheaper Model
Uji Argon pada tugas penalaran, pengodean, dan konteks panjang yang sulit di mana lebih sedikit percobaan ulang atau tingkat penyelesaian lebih tinggi dapat membenarkan pengeluaran token yang lebih besar. Untuk klasifikasi rutin, ekstraksi, dan ringkasan volume tinggi, uji model berbiaya lebih rendah terlebih dahulu.
Bandingkan total biaya per tugas berhasil, termasuk token pemikiran, penggunaan cache, pemanggilan alat, dan percobaan ulang. Pilih model dan jalur akses yang memenuhi persyaratan kualitas Anda dengan biaya yang dapat diterima.
FAQ
Are Gemini 4 Argon Batch and Flex cheaper than Standard?
Tarif token Argon Batch dan Flex Google adalah $1 input dan $5 output per satu juta token hingga 30 November 2026, naik menjadi $2 dan $10 setelahnya. Input dalam cache adalah $0.05, naik menjadi $0.10. Ini adalah opsi pemrosesan terpisah, jadi validasikan kendala operasionalnya terhadap beban kerja Anda sebelum mengganti integrasi Standard.
Perkirakan penggunaan Standard, Batch, dan Flex secara terpisah menggunakan tarif masing-masing, lalu tambahkan subtotal untuk anggaran beban kerja campuran.
Do Gemini 4 Argon token estimates include search charges?
Tidak. Aritmetika token saja mengecualikan layanan yang ditagih terpisah. Biaya Search grounding Google adalah $14 per 1,000 kueri setelah jatah bulanan bersama 5,000 permintaan untuk model Gemini 3 dan yang lebih baru. Satu permintaan yang dikirim dapat mengeluarkan lebih dari satu kueri pencarian, jadi lacak penggunaan grounding aktual secara terpisah alih-alih mengasumsikan satu prompt pengguna sama dengan satu kueri yang ditagihkan.
How should I budget Gemini 4 Argon across the price change?
Pisahkan perkiraan penggunaan token ke dalam periode perkenalan dan standard, lalu terapkan tarif masing-masing periode. Misalnya, 10 juta token input tanpa cache plus 1 juta token output berbiaya $30 pada tarif Standard perkenalan atau $60 setelahnya. Jika setengah dari volume tersebut jatuh pada masing-masing periode, estimasi token adalah $45. Tambahkan biaya alat dan percobaan ulang secara terpisah, dan gunakan tarif pascapromosi untuk anggaran keadaan stabil.
Why can a Gemini 4 Argon answer stop before it is complete?
Batas output mencakup pemikiran serta teks yang terlihat. Prompt yang menuntut dapat menghabiskan alokasi tersebut sebelum jawaban akhir selesai. Untuk respons panjang, eksekusi latar belakang melanjutkan generasi secara bertahap hingga selesai atau mencapai batas yang dikonfigurasi; tetap membutuhkan nilai max_output_tokens yang memadai. Periksa status penyelesaian dan penggunaan, kemudian sesuaikan kedalaman penalaran atau batasnya alih-alih berulang kali mengirim permintaan yang kekurangan anggaran yang sama.
Conclusion
Pilih akses Gemini 4 Argon berdasarkan alur kerja, lalu bandingkan biaya penyelesaian tugas yang berguna. Hak aplikasi Google dan Antigravity berbeda dari akses API berbayar. CometAPI menawarkan jalur API terpisah dengan harga input/output yang dipublikasikan 20% di bawah tarif Standard perkenalan Google, menjadikannya opsi praktis untuk evaluasi kecil dengan anggaran. Validasi batas akun dan fitur yang diperlukan, lacak token pemikiran dan percobaan ulang, dan skala hanya ketika kualitas dan total biaya memenuhi kebutuhan Anda.