
TL;DR
GLM 5.4 adalah nama komunitas untuk kandidat penerus dalam keluarga GLM milik Z.ai. Per 14 Oktober 2026, dokumentasi model resmi dan catatan rilis yang ditinjau untuk artikel ini tidak menetapkan peluncuran, lembar spesifikasi, atau pengenal API GLM-5.4. Union Alpha adalah petunjuk rumor, sementara peluncuran Oktober hanya kemungkinan berbasis ritme rilis. Pertanyaan yang berguna adalah apakah rilis mendatang meningkatkan reliabilitas pengodean dan biaya per tugas yang selesai; model GLM yang ada menyediakan baseline untuk evaluasi tersebut.
Key Takeaways
- Status rilis: Sumber resmi yang ditinjau pada 14 Oktober 2026 tidak mengonfirmasi GLM-5.4; tidak ada tanggal peluncuran pasti yang ditetapkan.
- Bukti rumor: Kaitan Union Alpha dengan GLM-5.4 belum terverifikasi, dan ringkasan yang dikutip tidak mengidentifikasi pos atribusi asli.
- Baseline performa: Hasil GLM-5.3 yang ada berguna sebagai konteks, tetapi itu bukan pengukuran GLM-5.4.
- Arsitektur: GLM-5.3-Flash menunjukkan arah efisiensi dan multimodal yang berbeda; apakah GLM-5.4 akan mewarisinya masih menjadi pertanyaan terbuka.
- Tindakan pengembang: Evaluasi model yang tersedia sekarang dan minta ID model terverifikasi, kompatibilitas, serta pengukuran tingkat tugas sebelum melakukan upgrade.
Apakah GLM 5.4 Sudah Dirilis?
GLM 5.4 adalah nama tidak resmi untuk kandidat penerus GLM. Indeks dokumentasi resmi dan catatan rilis yang ditinjau pada 14 Oktober 2026 mengidentifikasi model GLM yang ada tetapi tidak menetapkan rilis produk GLM-5.4. Ini adalah pemeriksaan sumber bertanggal, bukan bukti bahwa tidak ada pengembangan privat.
Dua jalur pengembangan terdokumentasi menjelaskan mengapa kandidat penerus menarik perhatian.
Z.ai mengonfirmasi bahwa GLM-5.3 menggunakan kembali model dasar GLM-5.2 dan memperoleh peningkatan melalui pascapelatihan. GLM-5.3-Flash justru menggunakan basis multimodal baru dan arsitektur atensi hibrida sparse-linear. Fakta ini menggambarkan model yang ada, bukan desain GLM-5.4 yang telah diungkap.
Secara praktis, satu jalur meningkatkan model yang ada melalui pelatihan tambahan, sementara jalur lain mendesain ulang arsitektur untuk menurunkan biaya komputasi dan mendukung kapabilitas baru.
GLM-5.4 di masa depan bisa dibangun di atas salah satu arah tersebut, tetapi belum ada bukti yang cukup untuk menentukan pendekatan mana yang akan dipilih Z.ai.
Seberapa Andal Rumor dan Bocoran GLM-5.4?
Informasi yang Dikonfirmasi
Baseline teknis yang dikonfirmasi berasal dari GLM-5.3 dan GLM-5.3-Flash, bukan dari GLM-5.4. Nama GLM-5.4, spesifikasi final, tanggal rilis, dan hasil benchmark tetap tidak terkonfirmasi dalam sumber resmi yang ditinjau untuk artikel ini.
Laporan Komunitas / Bocoran
Sebuah posting X pada 8 Oktober 2026 oleh @NFT_Chen mengatribusikan kemungkinan arah pengembangan GLM-5.4/5.5 pada komentar Tang Jie. Pos tersebut menggambarkan tiga prioritas penskalakan: memperluas pra-pelatihan, memperkuat pascapelatihan melalui SFT, RLHF, dan RLVR, serta memperluas penalaran dan eksekusi agen untuk tugas yang lebih sulit dan lebih panjang.
Penulis menafsirkan arah berikutnya sebagai agen otonom yang lebih panjang dan recursive self-improvement (RSI). Ini adalah catatan komunitas atas sebuah talk, bukan pengumuman rilis Z.ai. Nama versi dan klaim pengembangan tetap diatribusikan pada pos tersebut; itu tidak menetapkan tanggal peluncuran, arsitektur final, jumlah parameter, atau kemampuan perbaikan diri yang terdemonstrasi untuk GLM-5.4.
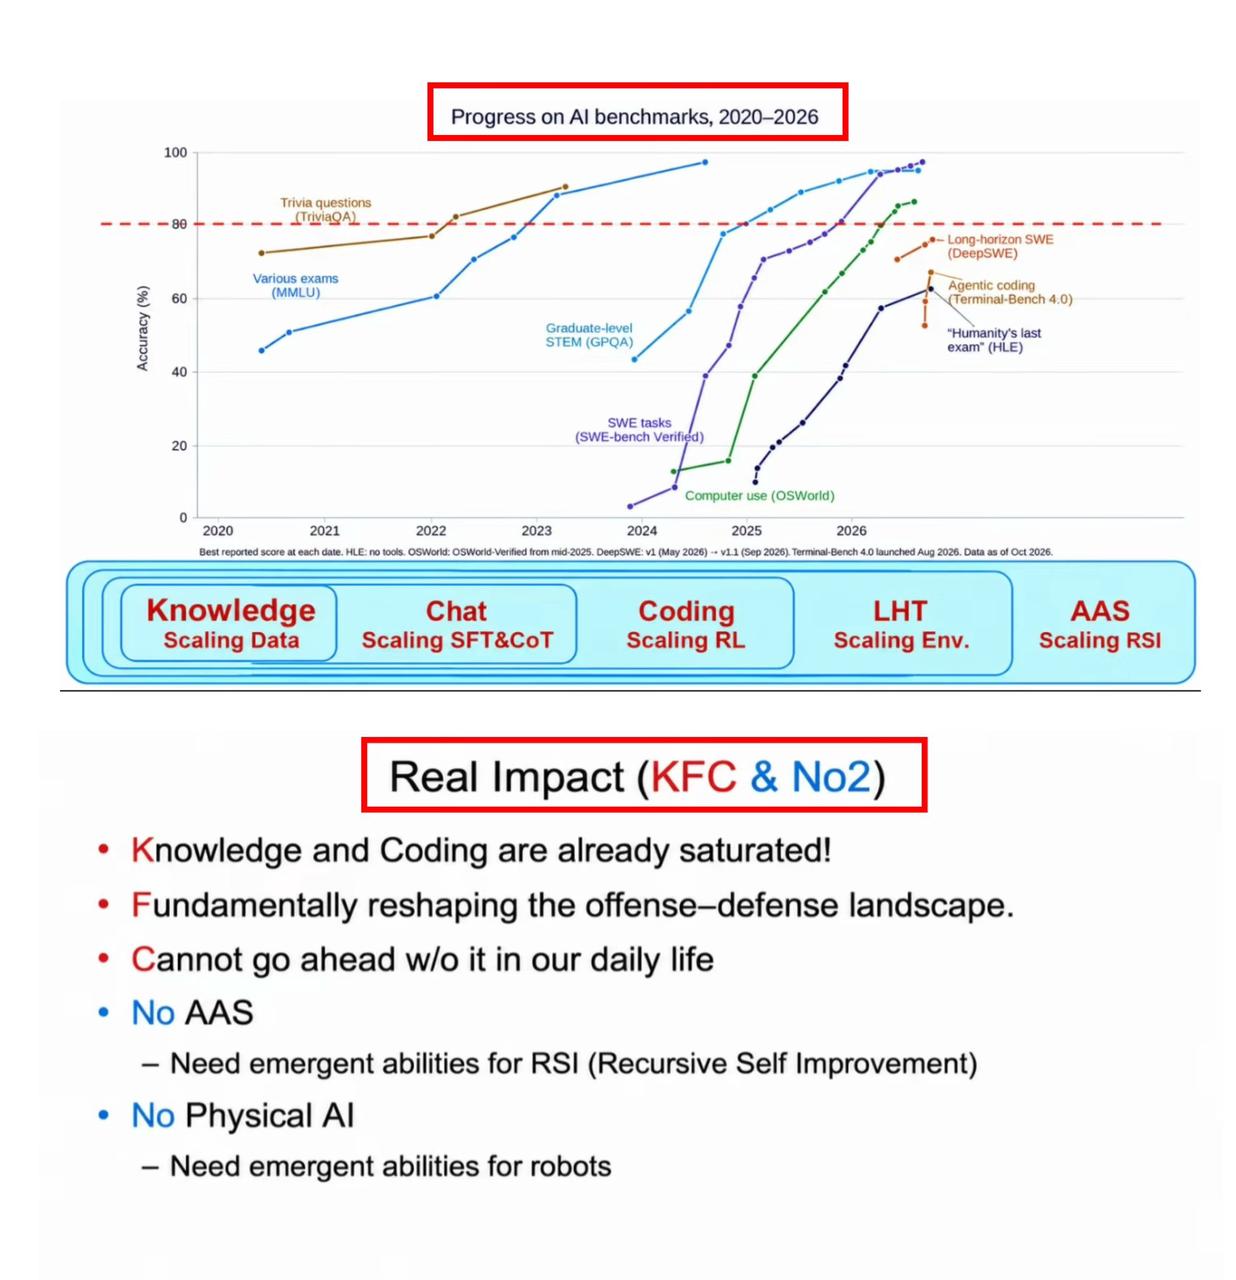
Gambar slide presentasi yang dilampirkan pada pos X asli @NFT_Chen, 8 Oktober 2026. Gambar membahas kemajuan benchmark dan RSI sebagai arah masa depan; ini bukan laporan benchmark GLM-5.4.
Foto talk yang dilampirkan pada pos X asli @NFT_Chen, 8 Oktober 2026.
Analisis
Analisis rumor yang berguna menanyakan pengamatan apa yang akan mengubah kesimpulan. Pengenal model resmi, pengumuman rilis, atau pemetaan terungkap dari alias anonim akan secara material memperkuat kasus. Pola penamaan serupa atau interval rilis saja tidak dapat melakukannya. Spekulasi lama tentang nomor versi GLM lain tidak menetapkan spesifikasi untuk GLM-5.4.
Kapan GLM 5.4 Bisa Dirilis?
Linimasa catatan rilis Z.ai mencatat GLM-5 pada 12 Februari, GLM-5.1 pada 7 April, GLM-5.2 pada 16 Juni, GLM-5.3 pada 18 Agustus, dan GLM-5.3-Flash pada 26 Agustus 2026. Ini adalah tanggal yang dicatat dalam catatan rilis; jangan disamakan dengan setiap pengumuman riset atau tanggal ketersediaan penyedia.
Perkembangan sekitar dua bulan untuk versi titik utama membuat Oktober menjadi jendela analitis yang masuk akal untuk diperhatikan. Ini tidak menetapkan peluncuran Oktober, hari spesifik, atau bahkan nama versi berikutnya. Tanpa sumber prakiraan yang dapat ditelusuri beserta metodologinya, prediksi tepat 20 Oktober atau 23 Oktober akan menyiratkan presisi lebih dari yang didukung bukti.
Peluncuran yang lebih lambat, nama yang berbeda, atau varian produk terpisah tetap memungkinkan. Pengembang sebaiknya merencanakan berdasarkan API yang saat ini tersedia daripada perkiraan kalender.
Apa Spesifikasi yang Diharapkan untuk GLM 5.4?
Tidak ada lembar spesifikasi GLM-5.4 yang andal. Alih-alih menetapkan perangkat keras dan parameter model yang dirumorkan ke produk yang belum dirilis, lebih informatif membandingkan model GLM terdokumentasi terbaru dan mengidentifikasi apa yang masih tidak diketahui.
| Spesifikasi | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Rilis | 18 Agustus 2026 | 26 Agustus 2026 | Belum diumumkan |
| Fondasi model | Basis GLM-5.2; pascapelatihan lanjutan | Basis multimodal baru | Tidak diketahui |
| Arsitektur | Fondasi MoE | MoE; atensi hibrida sparse-linear | Tidak diketahui |
| Dukungan konteks | 1M konteks API terdokumentasi | 1M | Tidak diketahui |
| Multimodal native | Masukan teks saja | Masukan teks, gambar, video, dan file | Tidak diketahui |
| Fokus utama | Pengodean, agen, keamanan siber | Efisiensi, pengodean, multimodal | Tidak diketahui |
| Benchmark dipublikasikan | Tersedia | Tersedia | Tidak tersedia |
| Bobot model | Dirilis | Dirilis | Tidak tersedia |
Tabel melaporkan kapabilitas model yang ada. Entri GLM-5.4 tetap tidak diketahui alih-alih mewarisi nilai dari pendahulunya. Konteks evaluasi model, jendela konteks API, dan panjang keluaran maksimum adalah batasan yang berbeda.
Ikhtisar arsitektur GLM-5.3-Flash melaporkan 320B total parameter, 18B parameter aktif, dan atensi hibrida sparse-linear. Ini adalah spesifikasi Flash yang diungkap dan tidak boleh ditetapkan untuk GLM-5.4.
Pengodean Berbasis Agen sebagai Arah Peningkatan Potensial
Pengodean berbasis agen adalah salah satu area paling kredibel untuk diperhatikan. GLM-5.3 telah menunjukkan bahwa penskalakan pascapelatihan dapat secara signifikan meningkatkan performa pada tugas rekayasa multi-langkah. Pengembangnya menekankan pekerjaan repositori kompleks, horizon eksekusi yang lebih panjang, dan pemecahan masalah berbasis alat yang lebih baik.
Model di masa depan bisa memperluas kapabilitas ini melalui interaksi lingkungan yang lebih baik, perencanaan yang lebih andal, dan lebih sedikit kegagalan pemanggilan alat.
Evaluasi yang paling berguna bukan hanya mengukur persentase pertanyaan pengodean yang dijawab dengan benar. Evaluasi harus mengukur apakah sebuah agen dapat menyelesaikan tugas rumit secara end-to-end, termasuk debugging, pengujian, revisi, dan pemulihan setelah kegagalan.
Arsitektur Multimodal Efisien sebagai Arah yang Mungkin
GLM-5.3-Flash menyediakan titik acuan arsitektural untuk pengembangan masa depan, sementara tidak ada sumber resmi yang ditinjau yang menetapkan penggunaannya dalam GLM-5.4.
Z.ai menggambarkan korpus pra-pelatihan multimodal 30T token sebagai bagian dari desain GLM-5.3-Flash yang berorientasi efisiensi. Ini menggambarkan skala data pelatihan model yang ada dan bukan komitmen peta jalan untuk GLM-5.4.
Ikhtisar resmi Flash melaporkan 3,01× perhitungan atensi lebih rendah dan 4,44× kebutuhan KV-cache lebih rendah dibanding GLM-5.3 di bawah perbandingan yang dinyatakan. Ini adalah hasil efisiensi tingkat komponen, bukan jaminan percepatan aplikasi atau diskon API.
Ini adalah peningkatan rekayasa yang berarti, tetapi tidak ada konfirmasi bahwa GLM-5.4 akan mewarisi arsitektur yang sama. Model generasi berikutnya yang lebih besar bisa memprioritaskan performa penalaran maksimum, sementara varian Flash terpisah mungkin terus mengoptimalkan latensi dan biaya.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
Baseline Benchmark GLM-5.3
Data benchmark yang tersedia mendukung analisis trajektori performa GLM-5.3, bukan pengukuran langsung GLM-5.4. Nilai di bawah adalah evaluasi yang dilaporkan Z.ai untuk model yang ada. Nilai tersebut belum direproduksi secara independen untuk artikel ini dan tidak mengukur GLM-5.4. Setiap benchmark menggunakan set tugas dan metode skornya masing-masing; perbedaan skor tidak boleh ditafsirkan sebagai kenaikan setara lintas tugas.
| Benchmark dan metodologi | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | Perbedaan GLM-5.3 vs GLM-5.2 |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4,6 | 28,3 | Tidak dilaporkan dalam perbandingan Flash yang dikutip | +23,7 poin |
| DeepSWE v1.1 | 46,2 | 66,9 | 63,4 | +20,7 poin |
| AutomationBench v1.0.6 | 26,2 | 48,2 | 48,8 | +22,0 poin |
| CyberGym | 77,2 | 84,5 | Tidak dilaporkan dalam perbandingan Flash yang dikutip | +7,3 poin |
| ExploitBench | 24,4 | 54,4 | Tidak dilaporkan dalam perbandingan Flash yang dikutip | +30,0 poin |
| HLE with Tools | 54,7 | 62,5 | 55,3 | +7,8 poin |
| GDPval-AA v2 | 1508 | 1769 | Tidak dilaporkan dalam perbandingan Flash yang dikutip | +261 Elo |
| Toolathlon Verified | 59,9 | Tidak dilaporkan dalam perbandingan GLM-5.3 yang dikutip | 78,4 | Tidak tersedia |
Tabel gabungan menempatkan hasil model yang ada berdampingan; tabel ini tidak berisi pengukuran GLM-5.4. Nilai yang tidak dilaporkan bukan berarti nol. Jaga kondisi evaluasi masing-masing benchmark tetap dalam pandangan, dan perlakukan perbedaan GDPval-AA sebagai Elo, bukan poin persentase.
Metodologi: DeepSWE v1.1 menggunakan mini-swe-agent, temperatur 0,95, top_p 1,0, batas waktu enam jam, dan konteks 400K. AutomationBench menggunakan v1.0.6. HLE with Tools menggunakan temperatur 1,0, top_p 0,95, batas generasi 163.840 token, dan batas konteks 300K dengan manajemen konteks. GDPval-AA v2 menggunakan skala Elo, jadi perbedaannya bukan kenaikan poin persentase.
Untuk CyberGym dan ExploitBench, Z.ai melaporkan Claude Code 2.1.207 dengan upaya penalaran maksimum, tanpa web tools, temperatur 1,0, top_p 1,0, dan batas keluaran 128.000 token. CyberGym melaporkan pass@1 satu kali jalan di 1.507 tugas dengan batas waktu per tugas tak terbatas. ExploitBench menggunakan hingga 300 ronde interaksi dan merata-ratakan cakupan atas 41 tugas di tiga revisi. Catatan kaki model card menyediakan detail lingkungan spesifik benchmark.
Metodologi Flash: DeepSWE menggunakan mini-swe-agent, konteks 400K, dan batas waktu enam jam; AutomationBench menggunakan v1.0.6. Toolathlon Verified melaporkan pass@1 yang dirata-ratakan dari tiga jalan independen melalui layanan evaluasi resmi. HLE menggunakan pengaturan sampling dan manajemen konteks seperti di atas. Lihat metodologi model card Flash. Hasil benchmark ini tidak menetapkan latensi produksi atau biaya.
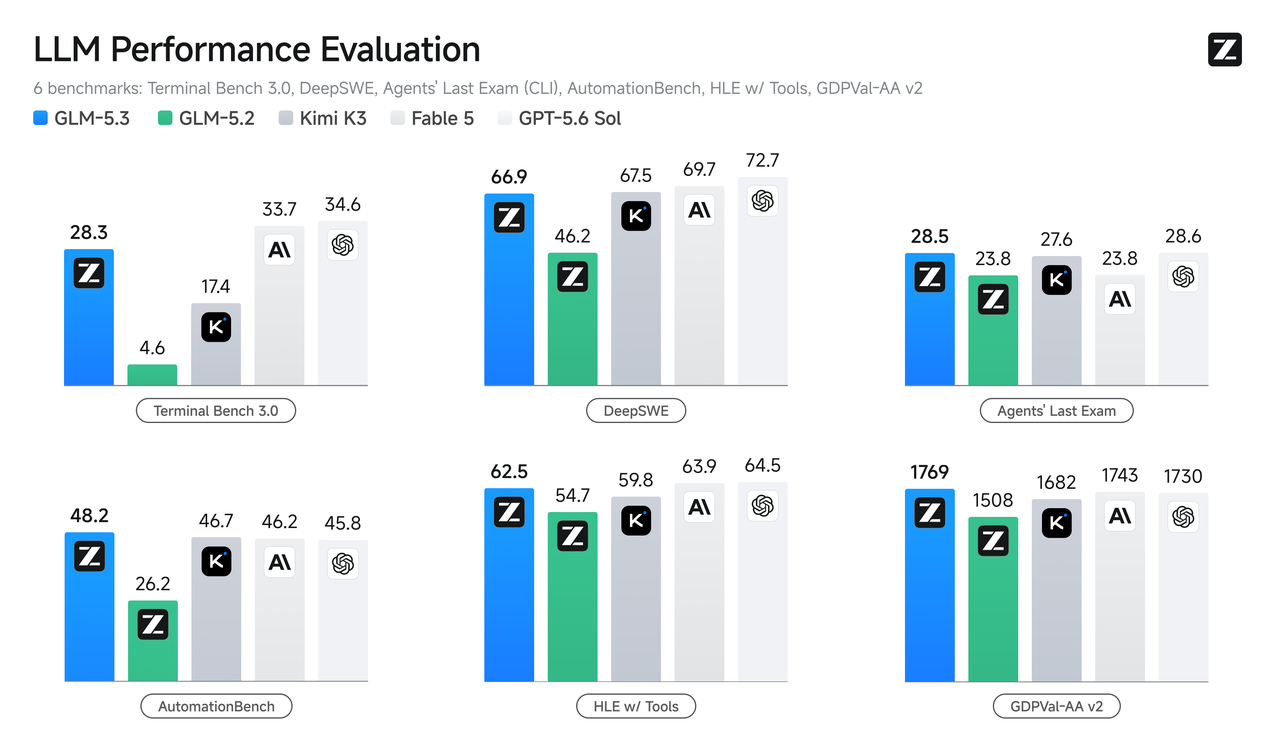
Grafik performa resmi GLM-5.3, direproduksi dari pengumuman benchmark Z.ai. Gambar menunjukkan evaluasi model pendahulu; tidak berisi hasil GLM-5.4.
Peningkatan terbesar tampak pada tugas yang memerlukan interaksi berkelanjutan dengan lingkungan. Terminal Bench 3.0 naik dari 4,6 ke 28,3, sementara ExploitBench meningkat dari 24,4 ke 54,4.
Peningkatan ini menunjukkan bahwa pascapelatihan dan lingkungan berorientasi agen dapat secara dramatis mengubah performa model tanpa mengubah arsitektur dasar. Namun, temuan ini tidak boleh diekstrapolasi menjadi prediksi numerik untuk GLM-5.4.
Kapabilitas dan Kecocokan Produksi
Untuk produksi, GLM-5.3 adalah referensi yang lebih kuat untuk pengodean kompleks, rekayasa horizon panjang, dan evaluasi keamanan siber. GLM-5.3-Flash menambahkan masukan visual native dan menekankan penggunaan alat yang efisien. Penawaran GLM-5.2, GLM-5.3, dan Flash yang ada menyediakan baseline; tidak ada kapabilitas atau ketersediaan GLM-5.4 yang ekuivalen yang ditetapkan dalam sumber yang ditinjau untuk artikel ini.
Model terdokumentasi mendukung hingga 1M konteks, tetapi batas tersebut tidak menjamin konteks yang dapat digunakan atau performa tugas yang identik pada setiap endpoint. Pilih di antara mereka menggunakan beban kerja representatif dan biaya per tugas yang berhasil diselesaikan.
Model GLM-5.4 di masa depan perlu menawarkan peningkatan terukur untuk membenarkan migrasi. Meningkatkan akurasi benchmark sambil melipatgandakan biaya penyelesaian tugas mungkin tidak menarik untuk penerapan produksi. Sebaliknya, kenaikan akurasi yang moderat dan lebih sedikit pemanggilan alat bisa sangat berharga pada skala besar.
Bandingkan keberhasilan tugas, token masukan dan keluaran, latensi, kegagalan pemanggilan alat, dan biaya per tugas yang berhasil di bawah harness evaluasi yang sama. Deskripsi kualitatif model bukanlah uji head-to-head terkontrol.
Status API GLM-5.4 Saat Ini di CometAPI?
CometAPI telah membuat halaman model GLM 5.4 khusus dengan entri pengenal model yang stabil. Namun, halaman tersebut masih melabeli model sebagai “Coming soon” dan menggambarkannya sebagai model pra-peluncuran. Pengembang harus memverifikasi ID model aktual, akses akun, ketersediaan endpoint, parameter yang didukung, batas konteks, dan harga sebelum mencoba penggunaan produksi.
Untuk integrasi yang saat ini terdokumentasi, gunakan model GLM yang tersedia seperti GLM-5.2 atau GLM-5.3. Halaman GLM-5.4 milik CometAPI saat ini harus diperlakukan sebagai entri katalog pra-peluncuran hingga ID model dan endpoint dikonfirmasi dapat dipanggil.
Persiapan Integrasi API GLM 5.4
Persiapan paling praktis adalah menghindari pengaitan logika aplikasi ke satu versi model. Pengenal model yang dapat dikonfigurasi memudahkan evaluasi upgrade tanpa menulis ulang pipeline permintaan.
Pertahankan pengenal model dapat dikonfigurasi dan gunakan model GLM yang tersedia untuk menetapkan baseline kerja. Sebelum beralih ke GLM-5.4, konfirmasikan ID model yang dapat dipanggil, akses akun, parameter permintaan yang didukung, batas konteks dan keluaran, perilaku streaming, dan kompatibilitas pemanggilan alat. Siapkan opsi rollback.
Saat GLM-5.4 resmi tersedia, verifikasi ID model, parameter yang didukung, batas konteks, dan kompatibilitas endpoint. Jalankan model lama dan baru terhadap dataset evaluasi yang sama, melacak tingkat keberhasilan, latensi, token keluaran, kegagalan pemanggilan alat, dan biaya per eksekusi yang berhasil.
Seperti Apa Harga API GLM 5.4?
Belum ada harga API GLM-5.4 yang diumumkan secara resmi. Karena itu, menampilkan tarif token masukan atau keluaran spesifik seolah-olah bocoran nyata akan menyesatkan.
Keluarga GLM saat ini mengilustrasikan mengapa ukuran model saja tidak cukup untuk memprediksi harga. GLM-5.3-Flash memperkenalkan optimasi arsitektural yang dirancang untuk memberikan kecerdasan kompetitif pada biaya inferensi yang jauh lebih rendah.
Perbandingan Artificial Analysis Intelligence Index v4.1.1 dari Z.ai melaporkan skor 57 pada perkiraan biaya diskon $0,045 per tugas untuk GLM-5.3-Flash. Biaya evaluasi ini bukan tarif token masukan/keluaran dan tidak memprediksi harga GLM-5.4.
Harga GLM-5.4 di masa depan bisa bergantung pada arsitektur, upaya penalaran, diskon token cache, infrastruktur hosting, dan varian. Untuk perencanaan produksi, biaya per tugas yang berhasil diselesaikan sering kali lebih berharga daripada tarif token masukan terendah.
Haruskah Pengembang Menunggu GLM 5.4?
Bagi sebagian besar pengembang, menunggu model yang tidak diumumkan tidak perlu. Model GLM yang ada menyediakan kapabilitas pengodean dan agen yang terdokumentasi yang dapat diuji dalam aplikasi nyata.
Tim yang membangun asisten pengodean atau agen rekayasa multi-langkah dapat menetapkan baseline dengan GLM-5.3. Aplikasi yang menekankan pemahaman visual, konteks panjang, dan panggilan berulang yang efisien dapat mengevaluasi GLM-5.3-Flash.
Bangun harness evaluasi sekarang dan sisihkan slot perbandingan di masa depan untuk GLM-5.4. Saat tersedia, rilisnya akan penting jika meningkatkan hasil yang berarti bagi aplikasi tertentu.
Peneliti sebaiknya memantau arsitektur fondasi baru, perubahan pada benchmark horizon panjang, dan reliabilitas end-to-end. Bisnis harus memprioritaskan ketersediaan, biaya, latensi, kompatibilitas, dan kualitas pada data produksi yang representatif.
Kesimpulan
GLM 5.4 adalah langkah berikutnya yang masuk akal dalam keluarga model Z.ai yang berkembang pesat, tetapi narasi saat ini tetap lebih spekulatif daripada terkonfirmasi.
Union Alpha adalah petunjuk identitas yang belum diverifikasi, dan ritme rilis hanya mendukung hipotesis waktu yang luas. Keduanya tidak menetapkan tanggal peluncuran. Sumber resmi yang ditinjau pada 14 Oktober 2026 menyediakan baseline untuk model yang ada alih-alih rilis GLM-5.4 yang terkonfirmasi.
Yang dapat diverifikasi adalah kemajuan yang telah dicapai GLM-5.3 dan GLM-5.3-Flash. Peningkatan signifikan dalam pengodean berbasis agen, evaluasi keamanan siber, dan efisiensi inferensi menetapkan baseline yang menuntut bagi penerus mana pun.
Pertanyaan kunci adalah apakah Z.ai dapat menghadirkan eksekusi otonom yang andal, penalaran yang lebih kuat, dan biaya kompetitif per tugas yang diselesaikan. Hingga spesifikasi dan benchmark resmi muncul, GLM-5.4 harus diperlakukan sebagai rilis potensial, bukan produk yang tersedia.
FAQ
Bagaimana saya dapat memverifikasi listing API GLM 5.4?
Periksa bahwa penyedia menyediakan pengenal model yang dapat dipanggil, endpoint yang didukung, ketentuan akses, dan harga saat ini. Lalu bandingkan identitas tersebut dengan pengumuman atau dokumentasi resmi Z.ai. Listing penyedia dapat menetapkan penawaran penyedia tersebut, tetapi tidak dengan sendirinya mengautentikasi pengembang model yang anonim.
Pemeriksaan kompatibilitas apa yang penting sebelum migrasi GLM 5.4?
Validasi parameter permintaan, pengaturan penalaran, skema pemanggilan alat, keluaran terstruktur, perilaku streaming, batas konteks, dan keluaran maksimum pada endpoint Anda yang sebenarnya. Sertakan uji negatif untuk parameter yang tidak didukung dan pertahankan model yang ada untuk rollback. Kompatibilitas OpenAI menggambarkan sebuah antarmuka; itu tidak menjamin perilaku model yang identik.
Bagaimana saya harus mengevaluasi GLM 5.4 untuk agen pengodean?
Gunakan set tetap tugas repositori representatif dengan alat, perizinan, batas waktu, dan harness yang sama untuk kedua model. Hitung perubahan teruji yang berhasil, pemulihan dari kegagalan alat, penggunaan token, latensi, dan total biaya. Rekam setiap jalan dan ulangi tugas cukup banyak untuk mengekspos variabilitas alih-alih mempromosikan satu contoh yang menguntungkan.
Apa yang membenarkan menunggu GLM 5.4?
Menunggu masuk akal hanya ketika kapabilitas mendatang yang terdokumentasi memenuhi kebutuhan yang tidak dapat dipenuhi model yang tersedia, dan penundaan tersebut sesuai dengan jadwal pengiriman Anda. Dengan hanya rumor, bangun di atas model yang tersedia dan pertahankan pemilihan model yang dapat dikonfigurasi. Definisikan ambang kapabilitas dan biaya yang harus dipenuhi rilis berikutnya sebelum menggantikan baseline Anda.