Bangun dengan CometAPIButuh satu API untuk banyak model?Uji alur kerja di Playground, lalu buat API key saat model dan biayanya sesuai dengan use case Anda.
Mulailah dengan GPT-6.1 Terra untuk tugas ber-volume tinggi yang dapat diverifikasi dan sensitif biaya. Evaluasi GPT-6.1 Sol untuk pengodean kompleks, penggunaan alat multi-langkah, dan alur kerja di mana kegagalan berdampak mahal. Praktiknya, gunakan Terra terlebih dahulu dan eskalasi ke Sol saat pengujian atau pemeriksaan validasi yang telah ditentukan gagal.
Poin Utama
Harga token standar: Pada OpenAI Standard, Terra berharga $1 per juta token input dan $5 per juta token output; Sol masing-masing $2 dan $10.
Kinerja spesifik tugas: Pada upaya penalaran maksimum, Terra unggul tipis pada Agents’ Last Exam v1 dan Terminal-Bench-Science 0.1, sementara Sol unggul pada Terminal-Bench 4.0 dan OSWorld 2.1.
Keduanya menawarkan jendela konteks 1,05 juta token dan menerima input teks serta gambar.
Ditinjau untuk kejelasan, atribusi sumber, dan terminologi API terkini.
Kapasitas konteks bersama:
Kontrol penalaran berbeda: Terra mendukung menonaktifkan penalaran dengan none; Sol memerlukan setidaknya upaya penalaran low.
Biaya operasional penting: Bandingkan pengeluaran per tugas yang berhasil diselesaikan, termasuk percobaan ulang dan pemanggilan alat, serta catat biaya tinjauan manusia secara terpisah.
GPT-6.1 Terra vs GPT-6.1 Sol: Gambaran dan Spesifikasi
Gambaran di bawah ini merangkum kompromi yang ada. Bagian terperinci menjelaskan bukti, asumsi penagihan, dan batasan di balik setiap pilihan.
GPT-6.1 Terra: Alur Kerja Visual dan Agen yang Efisien
OpenAI memperkenalkan GPT-6.1 Terra pada 26 Oktober 2026. Model ini menggabungkan penalaran visual, penggunaan komputer, dan pembuatan teks serbaguna untuk alur kerja profesional rutin. Tarif token yang lebih rendah menjadikannya titik awal yang berguna saat tugas sering dan hasilnya dapat diperiksa.
GPT-6.1 Sol: Pengodean Kompleks dan Penalaran Profesional
GPT-6.1 Sol diluncurkan pada 29 September 2026. Model ini menargetkan pengodean dan pekerjaan profesional yang menuntut. Evaluasi saat repositori tidak familiar, rantai tindakan saling bergantung panjang, atau koreksi yang mahal membuat kemampuan penalaran tambahan bernilai.
Konteks, Penalaran, dan Spesifikasi API
Fitur API: Kedua model mendukung Structured Outputs, streaming, dan Batch API. Pemanggilan alat menggunakan Responses API, dan fine-tuning tidak didukung. Periksa bahwa penyedia dan endpoint pilihan Anda menawarkan fitur yang dibutuhkan aplikasi Anda.
Kedua model memungkinkan hingga 128.000 token output dalam jendela konteks 1.050.000 token. Menyisihkan alokasi output penuh menyisakan 922.000 token untuk sisa pertukaran, termasuk input Anda, instruksi sistem, dan riwayat alat. Ini adalah perhitungan perencanaan, bukan batas input tetap terpisah.
Pengungkapan arsitektur: Spesifikasi model publik yang ditautkan tidak memberikan detail arsitektur internal yang cukup untuk perbandingan yang andal. Kapasitas konteks dan pengaturan penalaran tidak boleh diperlakukan sebagai bukti jumlah parameter atau arsitektur.
Kontrol penalaran: Pengaturan none milik Terra berguna untuk transformasi dan ekstraksi yang lugas. Untuk perbandingan pertama, gunakan pengaturan penalaran yang didukung sama pada kedua model, lalu setel masing-masing model terhadap kualitas dan latensi yang dibutuhkan alur kerja Anda.
Kedua model memiliki kapasitas konteks yang sama menurut publikasi, tetapi itu tidak menyiratkan akurasi pengambilan yang identik atau kualitas penalaran konteks panjang. Oleh karena itu, pemilihan model harus mempertimbangkan kualitas penalaran, efisiensi alur kerja, biaya, dan kinerja pengambilan spesifik tugas.
GPT-6.1 Terra vs GPT-6.1 Sol: Kinerja
Hasil yang dilaporkan menunjukkan gambaran campuran: Terra unggul tipis pada beberapa evaluasi agen dan pengodean ilmiah, sementara Sol mencetak lebih tinggi pada pengodean terminal umum, otomasi desktop, dan visi. Perbandingan di bawah ini memisahkan hasil peluncuran OpenAI dari evaluasi independen dan menjelaskan apa yang dapat—dan tidak dapat—memberi tahu Anda tentang kinerja produksi.
Hasil Benchmark Resmi dan Kondisi Uji
Hasil berikut berasal dari evaluasi peluncuran Terra oleh OpenAI. Terra ditampilkan pada upaya penalaran medium dan maksimum; Sol ditampilkan pada upaya maksimum. Kolom terakhir hanya membandingkan konfigurasi upaya maksimum.
OSWorld menggunakan evaluasi offline 2.1. Uji faktualitas menggunakan prompt internal OpenAI yang dirancang untuk memicu kesalahan. Ini adalah hasil yang dilaporkan vendor dari pengaturan evaluasi tertentu, bukan pengukuran alur kerja produksi Anda.
Semua skor dalam persen; selisih dinyatakan dalam percentage points (pp). Lebih rendah lebih baik hanya untuk tingkat kesalahan faktual. Perbedaan tingkat kesalahan 0,1 poin saja tidak menetapkan keunggulan keandalan yang bermakna.
Untuk rekayasa perangkat lunak, keunggulan Terminal-Bench milik Sol dan keunggulan tipis Terminal-Bench-Science milik Terra menyiratkan bahwa hasil bergantung pada jenis tugas pengodean. Untuk alur kerja aplikasi, skor OSWorld yang lebih tinggi milik Sol mendukung evaluasinya untuk otomasi desktop, sementara hasil Agents’ Last Exam milik Terra menjadikannya kandidat untuk tugas agen profesional. Tidak ada pola yang menetapkan pemenang universal.
Rangka agen, akses alat, dan konfigurasi lingkungan dapat memengaruhi hasil ini. Gunakan angka-angka tersebut untuk mengidentifikasi kandidat pengujian, lalu validasi terhadap perubahan repositori dan alur kerja aplikasi yang benar-benar perlu Anda selesaikan.
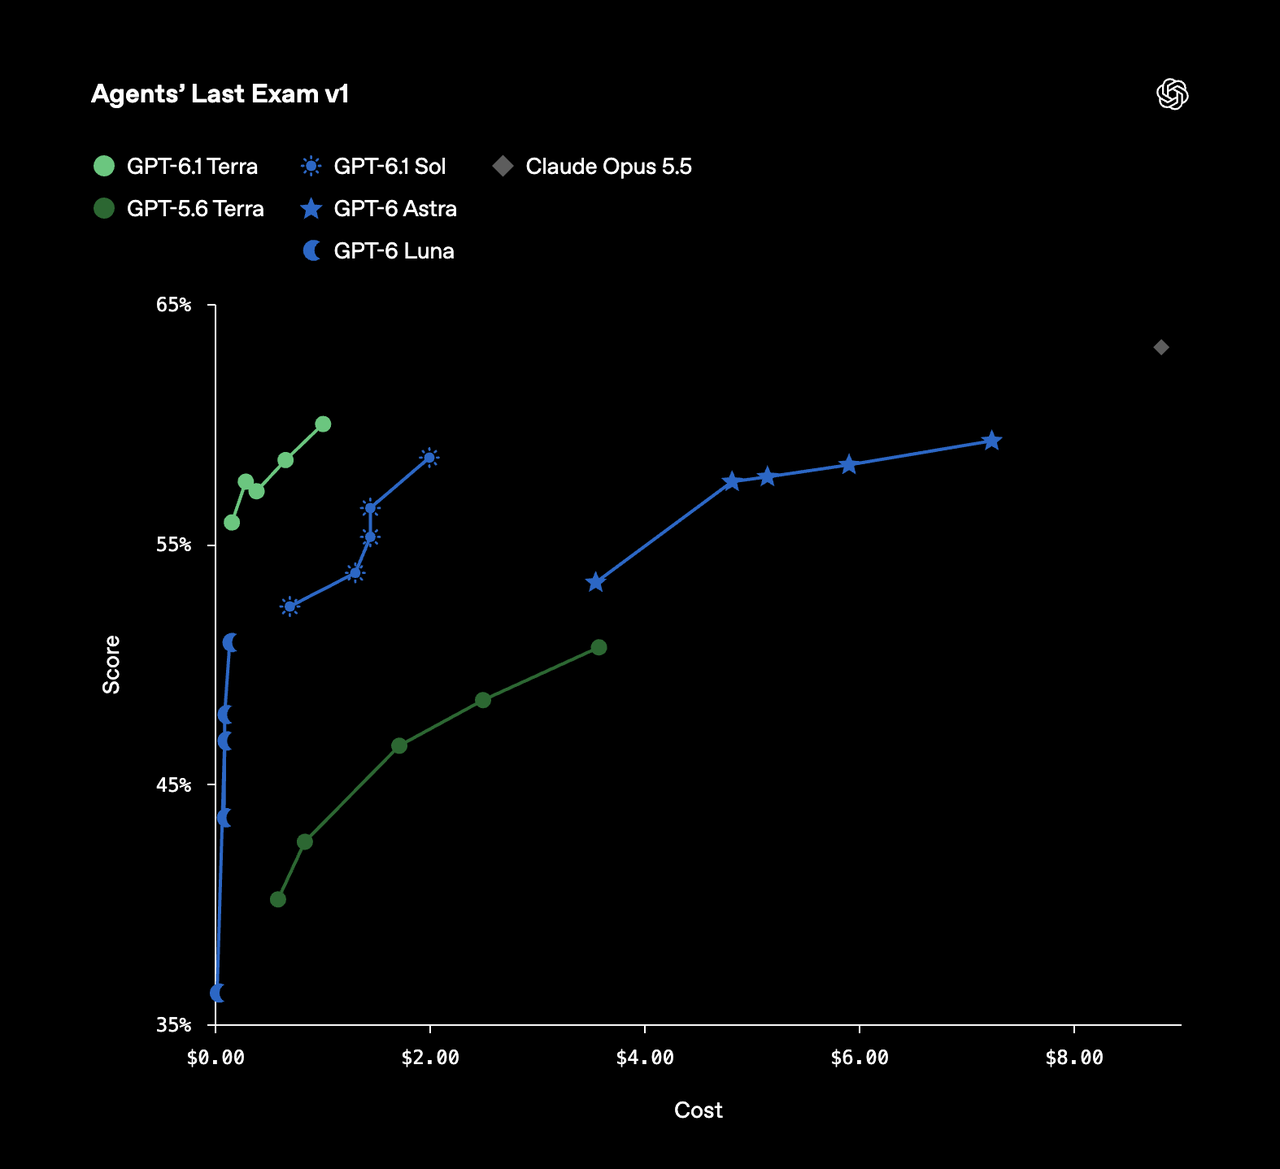
Grafik Agents’ Last Exam v1 milik OpenAI memplot skor terhadap perkiraan biaya tugas di berbagai konfigurasi model. Ini menambahkan perspektif efisiensi biaya ke tabel skor di atas; biaya yang diplot spesifik untuk pengaturan evaluasi.
Evaluasi Intelijensi dan Pengodean Independen
Evaluasi 26 Oktober oleh Artificial Analysis menempatkan Terra empat poin di bawah Sol pada Intelligence Index pada upaya penalaran maksimum. Coding Agent Index v2.0 memberikan Terra 48 dan Sol 54. Ini adalah evaluasi terpisah dengan metode dan skala penilaiannya sendiri; jangan digabungkan secara numerik dengan hasil benchmark OpenAI.
Analisis yang sama mengidentifikasi pengaturan penalaran low dan medium milik Terra sebagai khususnya efisien biaya pada evaluasi intelijensi. Ini mendukung pengujian konfigurasi praktis berdampingan dengan pengaturan upaya maksimum. Biaya evaluasi tetap spesifik untuk pengaturan pengujian dan tidak boleh diperlakukan sebagai estimasi pengeluaran aplikasi Anda.
Kecepatan dan Latensi: Penyelesaian Tugas vs. Generasi Token
OpenAI melaporkan bahwa Terra menyelesaikan tugas Agents’ Last Exam yang dievaluasi lebih dari tiga kali lebih cepat daripada Sol. Ini adalah pengukuran tugas end-to-end yang mencakup penalaran dan interaksi perangkat lunak. Ini tidak menyiratkan throughput token output tiga kali lipat atau percepatan yang sama untuk setiap permintaan API.
Untuk aplikasi interaktif, bedakan antara waktu ke token pertama, yang mengukur waktu tunggu sebelum output dimulai, dan token output per detik, yang mengukur seberapa cepat jawaban berlanjut. Untuk agen, prioritaskan waktu penyelesaian end-to-end, termasuk panggilan alat, percobaan ulang, dan pemulihan.
Bandingkan kedua model menggunakan prompt, alat, pengaturan penalaran yang didukung, dan kriteria penerimaan yang sama. Catat latensi bersamaan dengan keberhasilan tugas: respons yang lebih cepat bernilai terbatas jika memerlukan lebih banyak koreksi atau gagal menyelesaikan alur kerja.
Kinerja Visi dan Konteks Panjang: Apa yang Ditetapkan Hasil
Keunggulan 0,8 poin persentase Sol pada MMMU-Pro pada upaya maksimum adalah satu hasil visi yang dilaporkan, bukan jaminan kinerja lebih baik pada setiap alur kerja visual. Uji label kecil, pemindaian buruk, diagram padat, dan tata letak yang tidak familiar menggunakan input yang representatif.
Evaluasi di atas tidak menetapkan model mana yang lebih baik dalam pengambilan konteks panjang atau penalaran. Meskipun keduanya memiliki kapasitas konteks yang sama menurut publikasi, kapasitas saja tidak menunjukkan akurasi pengambilan atau memori lintas sesi. Uji apakah masing-masing model dapat menemukan dan menggunakan bukti yang relevan dalam dokumen Anda, dan kelola state aplikasi secara eksplisit di seluruh permintaan.
GPT-6.1 Terra vs GPT-6.1 Sol: Biaya
Harga token adalah titik awal untuk membandingkan biaya. Percobaan ulang, token penalaran, pemanggilan alat, dan tinjauan manusia juga memengaruhi berapa banyak yang Anda belanjakan untuk menyelesaikan tugas dengan sukses.
Tarif berikut dalam USD per juta token dan harga.
Harga API OpenAI
Tarif Standard Terra yang tercantum adalah setengah dari Sol di seluruh kategori ini. Biaya aktual bergantung pada konfigurasi permintaan: permintaan konteks panjang, tingkatan pemrosesan, pemrosesan regional, dan penggunaan alat mungkin memiliki ketentuan berbeda. Periksa dokumentasi harga OpenAI yang berlaku sebelum memperkirakan biaya produksi.
Harga CometAPI
CometAPI adalah jalur akses pihak ketiga dengan harga dan ketersediaan fitur sendiri. Tarif ordinary input dan output yang tercantum ditampilkan terpisah di bawah.
Dengan tarif ini, harga ordinary input dan output CometAPI 20% di bawah tarif OpenAI Standard di atas. Konfirmasikan harga saat ini, biaya konteks panjang, dukungan caching, dan ketersediaan alat untuk akun Anda sebelum penerapan.
Contoh Biaya untuk 1.000 Permintaan
Misalkan sebuah aplikasi membuat 1.000 permintaan, masing-masing menggunakan 2.000 token input tidak di-cache dan 500 token output yang ditagih. Ini menghasilkan total 2 juta token input dan 500.000 token output.
Untuk 1.000 permintaan, masing-masing menggunakan 2.000 token input tidak di-cache dan 500 token output yang ditagih, perkiraan biayanya adalah:
Terra melalui OpenAI: $2.00 untuk input dan $2.50 untuk output, total $4.50.
Sol melalui OpenAI: $4.00 untuk input dan $5.00 untuk output, total $9.00.
Terra melalui CometAPI: $1.60 untuk input dan $2.00 untuk output, total $3.60.
Sol melalui CometAPI: $3.20 untuk input dan $4.00 untuk output, total $7.20.
Perhitungan ini menggunakan tarif ordinary yang tercantum di atas, tanpa diskon Batch API. Mereka tidak termasuk penulisan cache, biaya alat terpisah, dan percobaan ulang. Token penalaran apa pun yang ditagih sebagai output harus dimasukkan dalam total output.
Biaya Efektif per Tugas yang Berhasil
Dalam artikel ini, tugas yang berhasil adalah yang lulus pemeriksaan kualitas, skema jika berlaku, dan penyelesaian yang telah ditentukan tanpa koreksi manusia tambahan.
Harga token yang lebih rendah tidak selalu menghasilkan biaya operasional yang lebih rendah. Penghematan Terra dapat menyusut jika memerlukan lebih banyak percobaan, token penalaran, atau intervensi manusia. Tarif lebih tinggi Sol dapat sepadan jika ia menyelesaikan lebih banyak tugas dengan sukses pada percobaan pertama.
Biaya model-dan-alat efektif per tugas yang berhasil = total pengeluaran model dan alat di semua percobaan ÷ jumlah tugas yang berhasil.
Lacak biaya tinjauan dan koreksi manusia secara terpisah. Pilih model yang memenuhi target kualitas Anda dengan biaya gabungan terendah, alih-alih hanya membandingkan harga token.
Model Mana yang Harus Anda Pilih: GPT-6.1 Terra atau GPT-6.1 Sol?
Pilih berdasarkan kompleksitas tugas, kualitas output yang dapat diverifikasi, dan total biaya penyelesaian. Terra berguna sebagai titik awal untuk alur kerja rutin; Sol layak dievaluasi ketika penalaran sulit atau kegagalan yang mahal membenarkan pengeluaran tambahan.
Kapan Memilih GPT-6.1 Terra
Mulailah dengan Terra untuk ekstraksi ber-volume tinggi, penyusunan dokumen, pencocokan katalog, dan alur kerja aplikasi yang dapat diprediksi. Tugas-tugas ini adalah kandidat yang baik ketika hasilnya dapat diperiksa terhadap dokumen sumber, bidang yang diwajibkan, atau aturan validasi otomatis.
Pilih Terra ketika ia memenuhi target akurasi dan penyelesaian dalam batas percobaan ulang dan anggaran tinjauan manusia. Tarif token yang lebih rendah menawarkan sedikit manfaat jika kegagalan berulang menghapus penghematan.
Kapan Memilih GPT-6.1 Sol
Evaluasi Sol untuk debugging sulit, perubahan repositori yang melibatkan banyak dependensi, dan alur kerja desktop dengan rantai tindakan saling bergantung yang panjang.
Pilih Sol ketika pengujian menunjukkan bahwa ia menghasilkan lebih banyak patch yang diterima, melewati lebih banyak pengujian, atau memerlukan lebih sedikit koreksi manual. Biaya token yang lebih tinggi dibenarkan ketika peningkatan tersebut mengurangi total biaya menyelesaikan pekerjaan.
Kapan Menggunakan Terra Terlebih Dahulu dan Menaikkan ke Sol
Alur kerja hibrida dapat menggunakan Terra untuk upaya awal dan menaikkan ke Sol ketika pemeriksaan yang telah ditentukan gagal. Dasarkan eskalasi pada hasil yang dapat diamati, bukan hanya kepercayaan diri model.
Sebagai contoh, alur kerja pembuatan kode dapat:
Meminta Terra menghasilkan perubahan yang diminta.
Menjalankan pengujian dan pemeriksaan validasi yang relevan.
Menaikkan ke Sol jika perubahan gagal dalam pemeriksaan tersebut atau berada di luar kemampuan Terra yang telah diverifikasi.
Mengirim kasus yang belum terselesaikan untuk tinjauan manusia setelah anggaran percobaan ulang habis.
Saat menaikkan, pertahankan permintaan asli, konteks yang relevan, output yang gagal, dan hasil validasi. Catat penggunaan kedua model sehingga perbandingan biaya mencakup seluruh alur kerja.
Daftar Periksa Evaluasi Produksi
Sebelum memilih model default atau menerapkan alur kerja eskalasi:
Gunakan tugas yang representatif: Sertakan permintaan rutin dan kasus di mana kegagalan berdampak mahal.
Jaga perbandingan tetap terkontrol: Gunakan instruksi, bukti, alat, dan kriteria penerimaan yang sebanding. Catat ID model, endpoint, pengaturan penalaran, dan tanggal pengujian.
Ukur hasil yang diterima: Periksa akurasi, validitas skema jika berlaku, hasil pengujian, dan penyelesaian tanpa koreksi manual.
Ukur waktu dan pengeluaran: Lacak latensi median dan ekor, token yang ditagih, panggilan alat, percobaan ulang, dan upaya tinjauan manusia.
Ulangi perbandingan: Jalankan tugas beberapa kali dan selang-seling urutan model untuk mengurangi pengaruh hasil satu kali.
Di Mana Anda Dapat Mengakses GPT-6.1 Terra dan GPT-6.1 Sol?
Akses Penyedia Resmi
Kedua model tersedia melalui OpenAI API. Untuk permintaan teks, Chat Completions didukung; pemanggilan alat memerlukan Responses API. Konfirmasikan parameter yang didukung model, batas akun Anda, dan alat yang tersedia pada rute yang ingin Anda gunakan.
Akses CometAPI
Untuk menggunakan salah satu model melalui CometAPI, ikuti panduan cepatnya untuk menyiapkan SDK yang kompatibel dengan OpenAI. Pasok kunci CometAPI Anda secara aman melalui variabel lingkungan COMETAPI_KEY dan setel base URL ke https://api.cometapi.com/v1. Pilih gpt-6.1-terra atau gpt-6.1-sol sebagai pengenal model, dan konfirmasikan bahwa rute tersebut diaktifkan untuk akun Anda.
Untuk perbandingan pertama, berikan kedua model tugas representatif yang sama dan gunakan reasoning effort medium. Jaga instruksi dan kriteria penerimaan konsisten, ulangi setiap tugas, dan selang-seling urutan model. Bandingkan hasil yang berhasil, waktu berlalu, token yang ditagih, dan percobaan ulang alih-alih menilai salah satu model dari satu respons saja.
Kesimpulan
Mulailah dengan GPT-6.1 Terra untuk alur kerja yang sering dan dapat diverifikasi, di mana harga token lebih rendah dan penyelesaian tugas lebih cepat penting. Evaluasi GPT-6.1 Sol ketika pengodean sulit, penggunaan alat multi-langkah, atau kegagalan yang mahal membuat kemampuan penalaran yang lebih tinggi bernilai. Pilihan akhir harus didasarkan pada biaya tugas yang diterima di bawah set evaluasi yang representatif, bukan pada harga atau satu benchmark saja.
Untuk banyak aplikasi, langkah berikut yang bermanfaat adalah uji coba kecil yang representatif dengan kondisi lulus yang jelas dan rute eskalasi terbatas. Biarkan hasil terukur menentukan model, alih-alih mengandalkan harga atau satu benchmark saja.
Faktor keputusan
GPT-6.1 Terra
GPT-6.1 Sol
Beban kerja awal
Pekerjaan visual rutin dan agen yang dapat diulang
Pengodean kompleks dan penalaran profesional berkelanjutan
Konteks dan modalitas
Kapasitas konteks total sama; input teks dan gambar
Kapasitas konteks total sama; input teks dan gambar
Kontrol penalaran
Menyertakan opsi mematikan penalaran
Memerlukan upaya penalaran minimal low
Pola kinerja yang dipublikasikan
Kinerja berbiaya lebih rendah pada tugas agen yang dapat diulang
Lebih kuat pada beberapa pengujian pengodean dan desktop yang sulit
Akses API
OpenAI dan CometAPI
OpenAI dan CometAPI
Spesifikasi
GPT-6.1 Terra
GPT-6.1 Sol
Tanggal rilis resmi
26 Oktober 2026
29 September 2026
ID model API
gpt-6.1-terra
gpt-6.1-sol
Jendela konteks
1,050,000 tokens
1,050,000 tokens
Knowledge cutoff
1 Juni 2026
30 April 2026
Input / output
Teks dan gambar / teks
Teks dan gambar / teks
Reasoning effort
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Reasoning effort bawaan
medium
medium
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Perbandingan pada upaya maksimum
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Tingkat kesalahan faktual pada prompt sulit
10.10%
4.30%
4.40%
Terra 0.1 pp lebih rendah
Penyedia dan kategori token
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — input
$1.00
$2.00
OpenAI Standard — cached input
$0.05
$0.10
OpenAI Standard — output
$5.00
$10.00
OpenAI Standard — 30-minute cache write
$1.25
$2.50
OpenAI Standard — 12-hour cache write
$2.50
$5.00
CometAPI ordinary input
$0.80
$1.60
CometAPI ordinary output
$4.00
$8.00
Tentukan batas operasional: Tetapkan anggaran percobaan ulang, pemicu eskalasi, dan persyaratan persetujuan manusia sebelum penerapan.
Bandingkan alur kerja lengkap: Sertakan percobaan yang tidak berhasil dan biaya eskalasi saat menghitung pengeluaran per tugas yang berhasil.
GPT-6.1 Terra vs GPT-6.1 Sol: Benchmark, Harga, dan Mana yang Harus Dipilih - CometAPI