
Ringkas
MiniMax M3.1 Flash menghadirkan AI open-weight untuk workflow coding dan agen yang menuntut, namun menjalankannya secara lokal memerlukan perangkat keras yang serius. Arsitektur MoE 428B parameternya hanya mengaktifkan 23B parameter per token, sehingga menurunkan komputasi tanpa menghilangkan kebutuhan menyimpan keseluruhan model. Developer dengan sistem multi-GPU yang didukung dapat menerapkannya menggunakan vLLM atau SGLang. Bagi yang ingin melewati manajemen infrastruktur, MiniMax M3.1 Flash API di CometAPI menawarkan cara lebih sederhana untuk memulai.
Pokok-Pokok Penting
- Hardware adalah hambatan terbesar. Konfigurasi vLLM yang dipublikasikan menggunakan empat GPU Blackwell atau AMD MI355X yang didukung, atau delapan GPU H100/H200.
- Konteks panjang membawa biaya memori. Model mendukung hingga satu juta token, namun batas serving praktis bergantung pada memori GPU yang tersedia dan konkurensi.
- Deployment bersifat spesifik hardware. Gunakan engine inferensi, format kuantisasi, dan konfigurasi akselerator yang kompatibel, bukan perintah instalasi generik.
- Benchmark hanyalah titik awal. Evaluasi akurasi coding, penyelesaian tugas agen, latensi, dan throughput di workload Anda sendiri.
- Inferensi lokal dan hosted melayani kebutuhan berbeda. Self-hosting menawarkan kontrol infrastruktur yang lebih besar, sementara akses API mengurangi kompleksitas setup dan overhead pemeliharaan.
Apa Itu MiniMax M3.1 Flash?
MiniMax M3.1 Flash menerima teks, gambar, dan video, serta menghasilkan teks. Model ini dirancang untuk workflow coding, otomasi, interaksi komputer, dan keamanan. Bobotnya didistribusikan di bawah MiniMax Community License. Sebelum menawarkan layanan komersial, baca lisensi yang disertakan dengan checkpoint dan periksa ketentuan yang berlaku untuk penggunaan Anda.
Spesifikasi MiniMax M3.1 Flash
Bagaimana MiniMax M3.1 Flash menggunakan arsitektur 428B/23B-nya?
Model Mixture-of-Experts (MoE) merutekan setiap token melalui expert yang dipilih. Pada MiniMax M3.1 Flash, sekitar 23B parameter aktif untuk sebuah token, sementara total pool parameter sekitar 428B. Aktivasi sparse mengurangi komputasi; ini tidak mengubah checkpoint menjadi model dense 23B.
Apa yang Berubah di MiniMax M3.1 Flash?
- Sparse attention: Diterapkan di seluruh model untuk mengurangi pekerjaan attention pada input panjang; manfaat bergantung pada kernel serving dan prompt.
- Bobot mixed-precision: Komponen dense MXFP8 dan expert NVFP4 mengurangi kebutuhan penyimpanan dan komputasi, namun tetap memerlukan hardware dan kernel yang kompatibel.
- DSpark decoding: Head draft terintegrasi dapat mempercepat generasi pada resep yang didukung; hasil tergantung pada penerimaan token dan workload.
- Serving sadar daya: Penjadwalan pada level infrastruktur dapat meningkatkan utilisasi, namun ini bukan fitur yang otomatis didapat hanya dengan mengunduh bobot.
Perangkat Keras Apa yang Diperlukan untuk MiniMax M3.1 Flash?
Anggarkan memori GPU dalam empat bagian: bobot checkpoint, cache kunci-nilai (KV) untuk token sebelumnya, buffer runtime, dan headroom beban kerja. Perkiraan di bawah hanya mencakup penyimpanan parameter mentah. Precision campuran, skala kuantisasi, komponen multimodal, dan overhead serving akan mengubah kebutuhan sebenarnya.
Topologi GPU yang divalidasi
Perkiraan memori: Penyimpanan mentah untuk 428B parameter kira-kira 856 GB pada BF16, 428 GB pada 8-bit, atau 214 GB pada 4-bit yang diidealkan. Checkpoint resmi mencampur format, jadi angka ini bukan kebutuhan VRAM runtime. Sisihkan untuk skala kuantisasi, cache KV, buffer runtime, dan konkurensi; gunakan file checkpoint aktual dan resep untuk GPU Anda guna memperkirakan ukuran sistem.
Cadangkan ruang NVMe untuk checkpoint, unduhan sementara, dan salinan rollback.
Metode Deployment Mana yang Harus Anda Pilih?
Untuk cluster lokal yang didukung, vLLM adalah titik awal praktis dengan konfigurasi referensi dan integrasi API yang familier; SGLang cocok untuk tim yang mengeksplorasi kustomisasi serving setelah memeriksa kompatibilitas, sementara CometAPI menawarkan jalur hosted untuk prototyping dan switching model.
Pilih framework dengan resep tervalidasi untuk hardware Anda, lalu bandingkan latensi dan throughput menggunakan prompt, precision, dan konkurensi yang sama.
Cara Menjalankan MiniMax M3.1 Flash Secara Lokal dengan vLLM?
Langkah berikut mengasumsikan host Linux yang dilengkapi empat GPU NVIDIA Blackwell yang kompatibel, lingkungan driver/CUDA yang didukung, serta akses ke checkpoint resmi. Gunakan build vLLM yang tervalidasi; instalasi biasa pada hardware GPU yang tidak didukung dapat gagal meski instalasi paket berhasil.
Langkah 1: Instal alat serving
python3 -m venv minimax-env
source minimax-env/bin/activate
python -m pip install --upgrade pip
python -m pip install -U huggingface_hub
python -m pip install "vllm>=0.33.0"
python -c "import vllm; print(vllm.__version__)"
Pastikan wheel yang terpasang dan runtime CUDA cocok dengan keluarga GPU Anda. Jika diperlukan build pengembangan spesifik proyek, ikuti catatan instalasi referensi sebelum menggunakan argumen peluncuran.
Langkah 2: Unduh checkpoint resmi
hf download MiniMaxAI/MiniMax-M3.1-Flash \
  --local-dir ./MiniMax-M3.1-Flash
Gunakan token akses Hugging Face yang sesuai jika diperlukan, pertahankan struktur direktori, dan verifikasi unduhan shard lengkap sebelum meluncurkan server.
Langkah 3: Jalankan pada empat GPU NVIDIA GB200
export CUDA_VISIBLE_DEVICES=0,1,2,3
export VLLM_FLOAT32_MATMUL_PRECISION=high

vllm serve ./MiniMax-M3.1-Flash \
  --tensor-parallel-size 4 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype nvfp4 \
  --attention-config '{"indexer_kv_dtype":"nvfp4","use_prefill_query_quantization":true}' \
  --compilation-config '{"cudagraph_mode":"FULL_AND_PIECEWISE"}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"attention_backend":"FLASHINFER_TS","kv_cache_dtype":"fp8","draft_sample_method":"probabilistic","rejection_sample_method":"block"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --disable-hybrid-kv-cache-manager \
  --host 127.0.0.1 \
  --port 8000
Tunggu hingga server selesai memuat dan melaporkan bahwa ia siap sebelum mengirim permintaan. Perintah di atas membatasi konteks ke 32.768 token dan urutan bersamaan ke empat untuk uji awal. Batas yang diperkecil ini bukan pengaturan yang telah dibenchmark; sesuaikan setelah mengukur penggunaan memori dan perilaku permintaan pada hardware Anda.
Langkah 4: Kirim permintaan lokal
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "./MiniMax-M3.1-Flash",
    "messages": [{"role":"user","content":"Explain sparse attention in three bullets."}],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 1024
  }'
Jika identifier yang disajikan berbeda dari nama direktori, panggil /v1/models dan gunakan ID yang dikembalikan persis. Respons teks yang berhasil hanya memvalidasi inferensi dasar; uji visi, pemanggilan alat, konkurensi, dan konteks panjang secara terpisah.
Langkah 5: Integrasi dengan klien Python kompatibel OpenAI
python -m pip install openai
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
model_id = client.models.list().data[0].id

response = client.chat.completions.create(
    model=model_id,
    messages=[{"role": "user", "content": "Write a Python duplicate filename detector."}],
    temperature=1.0,
    top_p=0.95,
    max_tokens=2048,
)
print(response.choices[0].message.content)
Contoh ini mendengarkan pada 127.0.0.1 untuk pengujian lokal. Sebelum menghubungkan klien jarak jauh, pasang kontrol akses di depan endpoint dan konfigurasikan timeout klien, retry terbatas, serta monitoring.
Varian H100/H200: gunakan resep Hopper delapan GPU
Pada delapan GPU H100/H200, gunakan cache FP8 spesifik Hopper dan jalur Marlin MoE alih-alih konfigurasi Blackwell NVFP4. Perintah di bawah mengikuti resep vLLM Hopper resmi dengan konteks dan konkurensi dikurangi ke 32K dan empat urutan untuk uji awal. Ini menonaktifkan input video sesuai resep tersebut. Jaga endpoint ini di belakang kontrol akses Anda yang ada.
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
Cara Menjalankan MiniMax M3.1 Flash dengan SGLang?
SGLang menawarkan resep deployment M3.1 spesifik hardware dan serving yang kompatibel OpenAI. Pada snapshot 23 Oktober, dokumentasi mencakup image container pengembangan khusus, jadi instalasi SGLang generic tidak boleh diasumsikan sudah berisi semua dukungan spesifik model.
Tarik image container khusus
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Selanjutnya, ikuti cookbook SGLang MiniMax M3.1 untuk akselerator Anda. Menarik image hanya mengunduh runtime; Anda tetap perlu memulai container dengan akses GPU dan meluncurkan konfigurasi serving yang cocok di dalamnya. Gunakan perintah lengkap spesifik hardware dari cookbook, tunggu hingga siap, lalu query daftar model endpoint sebelum mengirim permintaan uji. Jalur NVIDIA dan AMD yang didokumentasikan menggunakan dependensi berbeda dan harus dikonfigurasi secara terpisah.
Bagaimana MiniMax M3.1 Flash Dibandingkan pada Benchmark?
Setelah endpoint Anda lulus pemeriksaan dasar, gunakan benchmark yang dipublikasikan untuk memutuskan workload mana yang diuji selanjutnya. Angka di bawah adalah evaluasi yang dipublikasikan vendor, bukan pengukuran dari deployment lokal Anda.
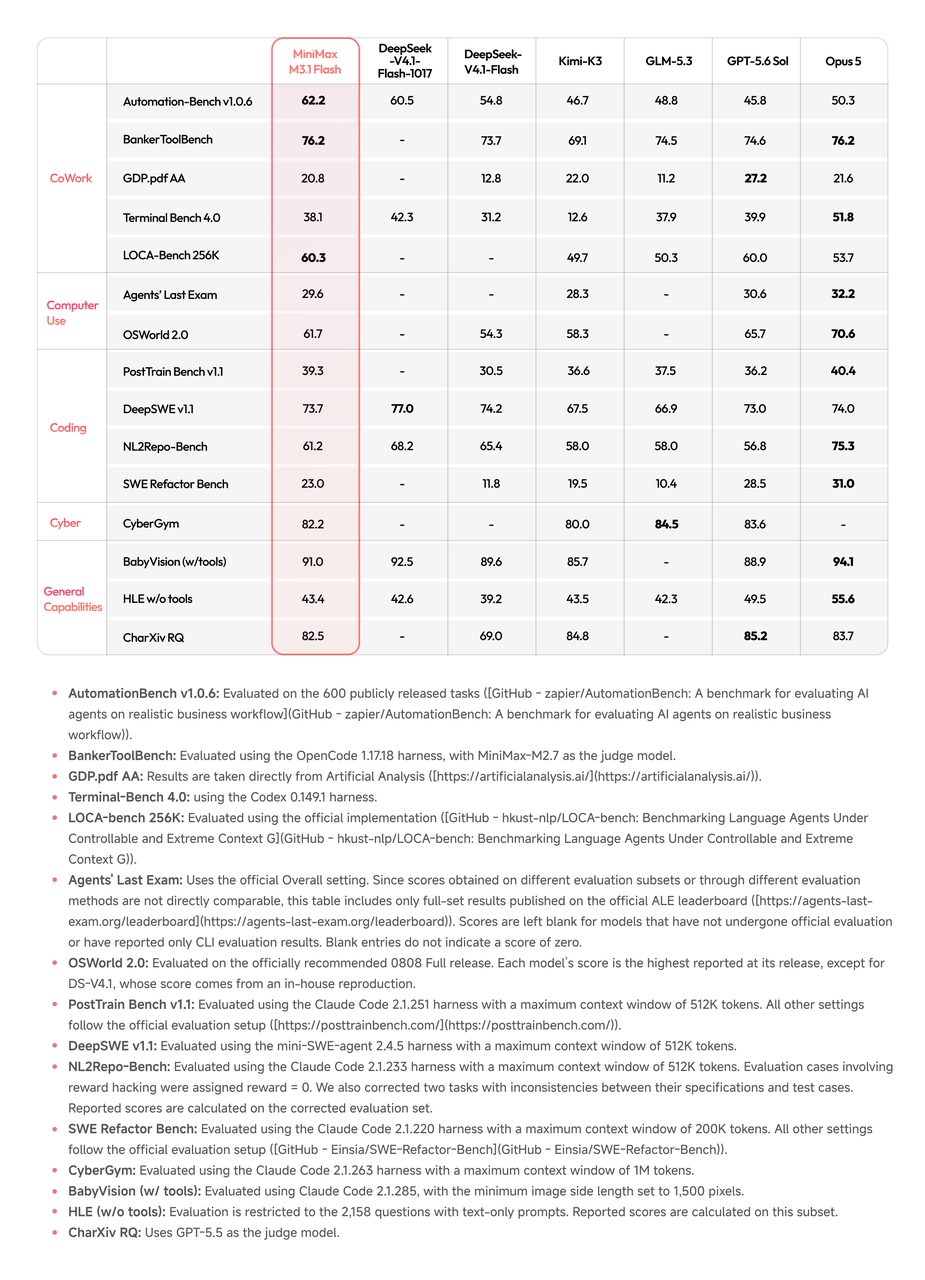
Dalam perbandingan ini, MiniMax memimpin model yang terdaftar pada Automation-Bench, sementara DeepSeek memimpin beberapa benchmark coding. Baca model card dan pengaturan evaluasi sebelum menarik kesimpulan, dan uji prompt serta alat yang benar-benar digunakan aplikasi Anda. Skor dari versi atau setup benchmark berbeda tidak langsung sebanding.
Bagaimana Anda Dapat Mengoptimalkan Performa MiniMax M3.1 Flash?
Kendalikan konteks dan konkurensi
Setelah permintaan pertama berhasil, tingkatkan satu variabel beban pada satu waktu: panjang input, panjang output, atau permintaan bersamaan. Catat puncak memori dan latensi respons untuk setiap run. Simpan pengaturan stabil terakhir sebagai titik rollback, agar eksperimen gagal tidak menjadi baseline baru.
Pilih tingkat upaya penalaran secara sengaja
M3.1 Flash mendukung low, medium, high, xhigh, dan max. Pengaturan lebih tinggi dapat meningkatkan skor tugas yang menuntut tetapi sering memerlukan lebih banyak token penalaran dan latensi lebih panjang. Gunakan kualitas penyelesaian tugas dan biaya komputasi yang berlalu bersama-sama.
Untuk hubungan yang dipublikasikan antara tingkat upaya penalaran dan biaya tugas, lihat grafik skor–biaya Automation-Bench resmi.
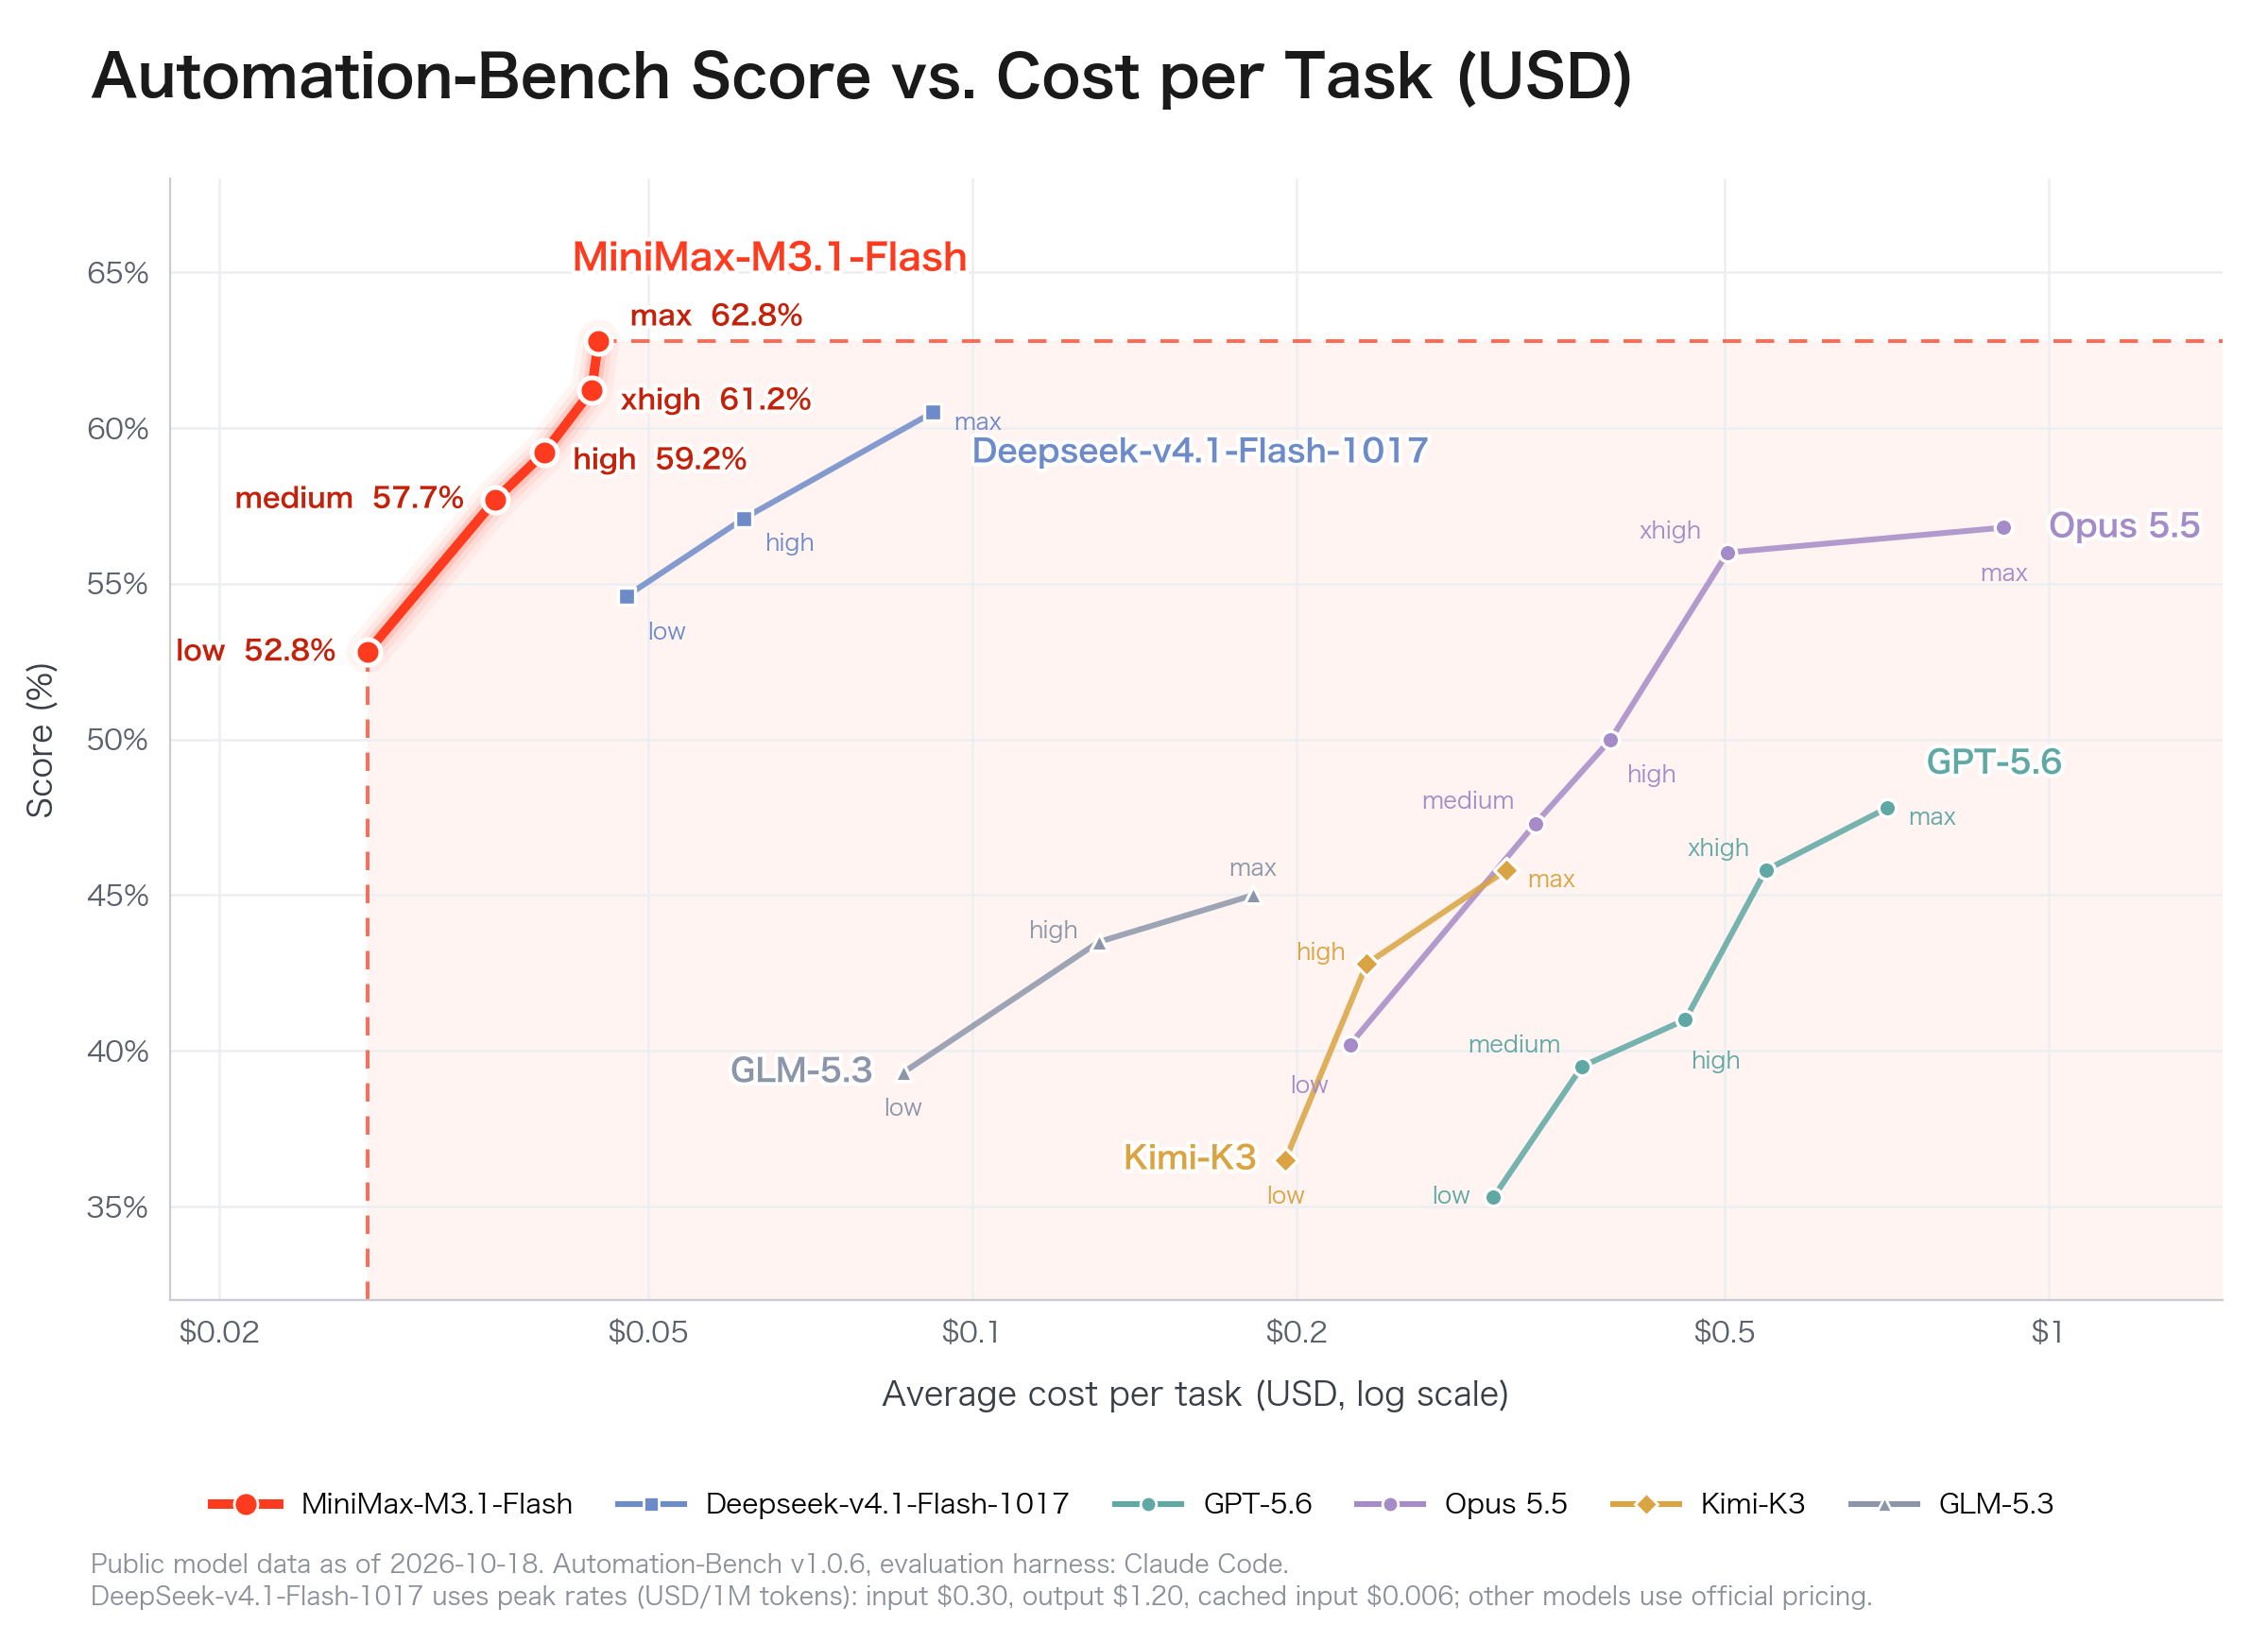
| Tingkat penalaran | Skor Automation-Bench yang dilaporkan |
|---|---|
| Low |
Untuk permintaan vLLM lokal, resep menunjukkan pengaturan reasoning-effort di bawah chat_template_kwargs. Periksa baik jawaban akhir maupun field penalaran yang dikembalikan terpisah saat memvalidasi klien Anda, karena endpoint hosted dan lokal dapat mengekspos field ini secara berbeda.
Lacak biaya per tugas yang selesai
Untuk agen, token per detik saja tidak cukup. Catat waktu ke token pertama, laju output, tingkat penerimaan untuk speculative decoding, throughput bersamaan, kegagalan pemanggilan alat, pemanfaatan memori, dan biaya tugas yang selesai. Respons yang lebih lambat dengan lebih sedikit alat yang gagal dapat menghasilkan ekonomi keseluruhan yang lebih baik.
Bagaimana Anda Dapat Menggunakan MiniMax M3.1 Flash API di CometAPI?
Tim yang tidak memerlukan infrastruktur akselerator khusus dapat menggunakan endpoint hosted yang kompatibel OpenAI. Ini menghilangkan unduhan checkpoint dan operasi GPU, tetapi memindahkan pemrosesan permintaan ke luar lingkungan self-hosted.
Gunakan MiniMax M3.1 Flash API untuk akses hosted. Untuk membandingkan model melalui gateway yang sama, coba DeepSeek V4.1 Flash API atau Kimi K3 API dengan pengujian aplikasi yang sama.
Contoh permintaan CometAPI
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Konfirmasikan identifier model di konsol CometAPI Anda sebelum menjalankan contoh ini. Gunakan gateway ketika API umum di berbagai penyedia membantu aplikasi Anda; bandingkan kuota saat ini dengan akses langsung untuk penggunaan yang diharapkan.
Harga MiniMax M3.1 Flash API
| Harga per sejuta token | MiniMax official API | CometAPI |
|---|---|---|
| Input | $0,15 | $0,80 |
Tarif API langsung MiniMax dalam pengumuman peluncuran 19 Oktober 2026 adalah $0,15 untuk input, $0,60 untuk output, dan $0,015 untuk input cache per sejuta token. Untuk CometAPI, periksa rute model aktif, tarif input/output, aturan caching, dan diskon akun apa pun sebelum memperkirakan pengeluaran. Bandingkan biaya total untuk campuran token dan retry yang Anda harapkan.
Masalah Apa yang Mungkin Muncul Saat Menjalankan MiniMax M3.1 Flash?
Kehabisan memori saat loading atau permintaan
- Jika bobot gagal dimuat: Periksa tahap yang gagal di log startup, konfirmasi checkpoint lengkap, dan verifikasi bahwa topologi GPU serta backend kuantisasi cocok dengan resep. Jika bobot melebihi memori yang tersedia, gunakan konfigurasi dengan kapasitas yang cukup; memendekkan permintaan tidak dapat memperbaiki kegagalan loading bobot.
- Jika bobot dimuat tetapi alokasi cache gagal saat startup: Periksa pengaturan cache dan memori yang tersedia, lalu kurangi konteks atau konkurensi yang dikonfigurasikan sesuai resep.
- Jika server mulai tetapi sebuah permintaan kehabisan memori: Ulangi prompt pendek dengan satu permintaan pada satu waktu, lalu tingkatkan panjang input, panjang output, dan konkurensi secara terpisah sambil memantau memori.
Kernel kuantisasi atau attention yang tidak kompatibel
Eksekusi NVFP4 berbeda antara hardware Blackwell, Hopper, dan AMD. Cocokkan versi engine inferensi, backend kuantisasi, versi CUDA/ROCm, dan keluarga akselerator alih-alih memakai flag secara serampangan.
Konfigurasi cache sparse-attention
Jika startup melaporkan layout cache yang tidak didukung, bandingkan konfigurasi cache lengkap dengan resep spesifik hardware. Resep vLLM saat ini memerlukan --block-size 128 untuk cache sparse/index MSA. Jika startup melaporkan error layout cache atau ukuran blok, bandingkan konfigurasi lengkap dengan resep untuk hardware Anda.
Identifier model yang tidak terduga
Path lokal dan nama model gateway jarak jauh tidak selalu identik. Query respons /v1/models lokal dan hindari menghardcode asumsi dari endpoint lain.
Throughput yang teramati buruk
Pisahkan pemrosesan prompt yang lambat dari generasi token yang lambat. Bandingkan run dengan panjang input dan batas output yang sama, lalu periksa utilisasi GPU dan perilaku interkoneksi sebelum meningkatkan batch size. Angka kecepatan yang di-host penyedia bukan baseline untuk cluster lokal Anda.
Kesimpulan
Pilih jalur deployment pertama dari hardware yang dapat Anda operasikan hari ini. Gunakan walkthrough vLLM untuk cluster lokal yang didukung, cookbook SGLang spesifik hardware untuk stack serving alternatif, atau API hosted ketika Anda ingin fokus pada integrasi aplikasi. Pertahankan konfigurasi yang memenuhi target kualitas tugas dan latensi pada biaya operasional yang berkelanjutan.
Cara paling andal untuk memilih metode serving adalah mengoptimalkan untuk pekerjaan selesai yang benar per dolar dan menit, bukan hanya puncak token per detik.
FAQ
Bagaimana membuat deployment dapat direproduksi setelah upgrade runtime?
Pin revisi checkpoint, image runtime atau versi paket, stack driver, dan pengaturan peluncuran. Jalankan set penerimaan kecil yang sama sebelum setiap upgrade, dan simpan konfigurasi kerja sebelumnya untuk rollback.
Bagaimana menangani retry ketika agen memanggil alat?
Pisahkan retry model dari pengulangan aksi alat. Gunakan idempotency key untuk aksi yang mengubah data, periksa apakah percobaan pertama berhasil, dan validasi argumen alat lengkap sebelum eksekusi.
Bisakah saya beralih antara endpoint lokal dan CometAPI tanpa mengubah perilaku aplikasi?
Jaga endpoint, kredensial, dan ID model dapat dikonfigurasi. Uji streaming, pemanggilan alat, field penalaran, dan input multimodal pada kedua rute, serta konfirmasikan persyaratan perutean data Anda sebelum mengaktifkan fallback.
Apa yang harus diuji sebelum menerima input multimodal?
Uji gambar dan video yang representatif, termasuk file berkualitas rendah dan tidak didukung. Periksa prapemrosesan, batas ukuran, kualitas jawaban, dan timeout secara terpisah; permintaan teks yang berhasil tidak memvalidasi jalur multimodal.
Bagaimana saya tahu apakah deployment siap untuk pengguna nyata?
Tetapkan target untuk keberhasilan tugas, pemanggilan alat yang valid, latensi, error, dan biaya. Uji trafik realistis, verifikasi monitoring dan perilaku fallback, lalu perluas dari rollout kecil hanya selama target tersebut terpenuhi.