
Cara tercepat untuk menggunakan GLM-5.3 Flash API adalah memanggil model melalui endpoint chat-completions yang kompatibel dengan OpenAI milik CometAPI. Detail koneksi dirangkum dalam tabel spesifikasi API di bawah; simpan kunci API di server.
Jawab dulu: buat kunci CometAPI, pasang SDK yang kompatibel dengan OpenAI, kirim permintaan POST ke /v1/chat/completions, lalu tambahkan streaming, visi, output JSON, atau tools hanya setelah permintaan dasar berhasil.
Apa itu GLM-5.3 Flash API?
GLM-5.3 Flash adalah model multimodal native berorientasi efisiensi dari Z.ai dalam keluarga GLM-5. Model ini menghadirkan kemampuan penalaran, konteks panjang, pemahaman visual, dan agen melalui chat API. Model ini memiliki 320B total parameter namun mengaktifkan 18B per token; arsitektur tersebut penting untuk biaya, tetapi yang dirasakan pengembang terutama adalah model yang tetap “terjaga” untuk prompt panjang dan panggilan tool berulang.
Panduan ini sengaja menyingkat bagian arsitektur dan tolok ukur. Artikel gambaran model pendamping sudah menjelaskan desain atensi hibrida, bobot terbuka, matriks tolok ukur peluncuran lengkap, latar belakang harga, dan perbandingan keluarga model. Di sini, fokusnya adalah perilaku integrasi dan keputusan produksi.
Spesifikasi API yang Mempengaruhi Integrasi
| Spesifikasi API | Nilai | Makna praktis |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Konfigurasikan sekali di klien sisi server. |
| Endpoint | POST /v1/chat/completions | Gunakan rute chat-completions yang kompatibel dengan OpenAI. |
| SDK kompatibel | Klien Python dan JavaScript yang kompatibel dengan OpenAI | Gunakan pola klien yang familier dengan CometAPI base URL. |
| Autentikasi | Bearer API key | Simpan kunci di variabel lingkungan sisi server atau pengelola rahasia. |
| Kode model | glm-5.3-flash | Gunakan nilai ini persis di body permintaan. |
| Jendela konteks | 1,048,576 token | Cocok untuk repositori besar, paket dokumen, dan riwayat agen panjang. |
| Output maksimum | Hingga 131,072 token | Tetapkan batas khusus aplikasi untuk mengendalikan biaya dan latensi. |
| Input native | Teks, gambar, video, file | Dukungan rute hosted bisa berbeda; validasi rute CometAPI yang tepat sebelum mengandalkan setiap modalitas. |
| Output | Teks | Model menafsirkan media tetapi tidak langsung menghasilkan gambar atau video. |
| Reasoning | low, high, max | Gunakan tingkat effort untuk menukar latensi dan konsumsi token dengan kedalaman. |
| Thinking | Selalu aktif | Jangan kirim parameter yang mencoba menonaktifkan thinking. |
| Fitur pengembang | Streaming, function calling, caching, structured output | Berguna untuk aplikasi interaktif, agen, dan pipeline yang dapat dibaca mesin. |
Kemampuan model dan kemampuan gateway tidak identik. Perlakukan halaman model CometAPI live dan skema API sebagai kontrak untuk rute yang Anda panggil, terutama untuk video, file, JSON Schema ketat, dan field thinking spesifik penyedia.
Konteks Kinerja Singkat
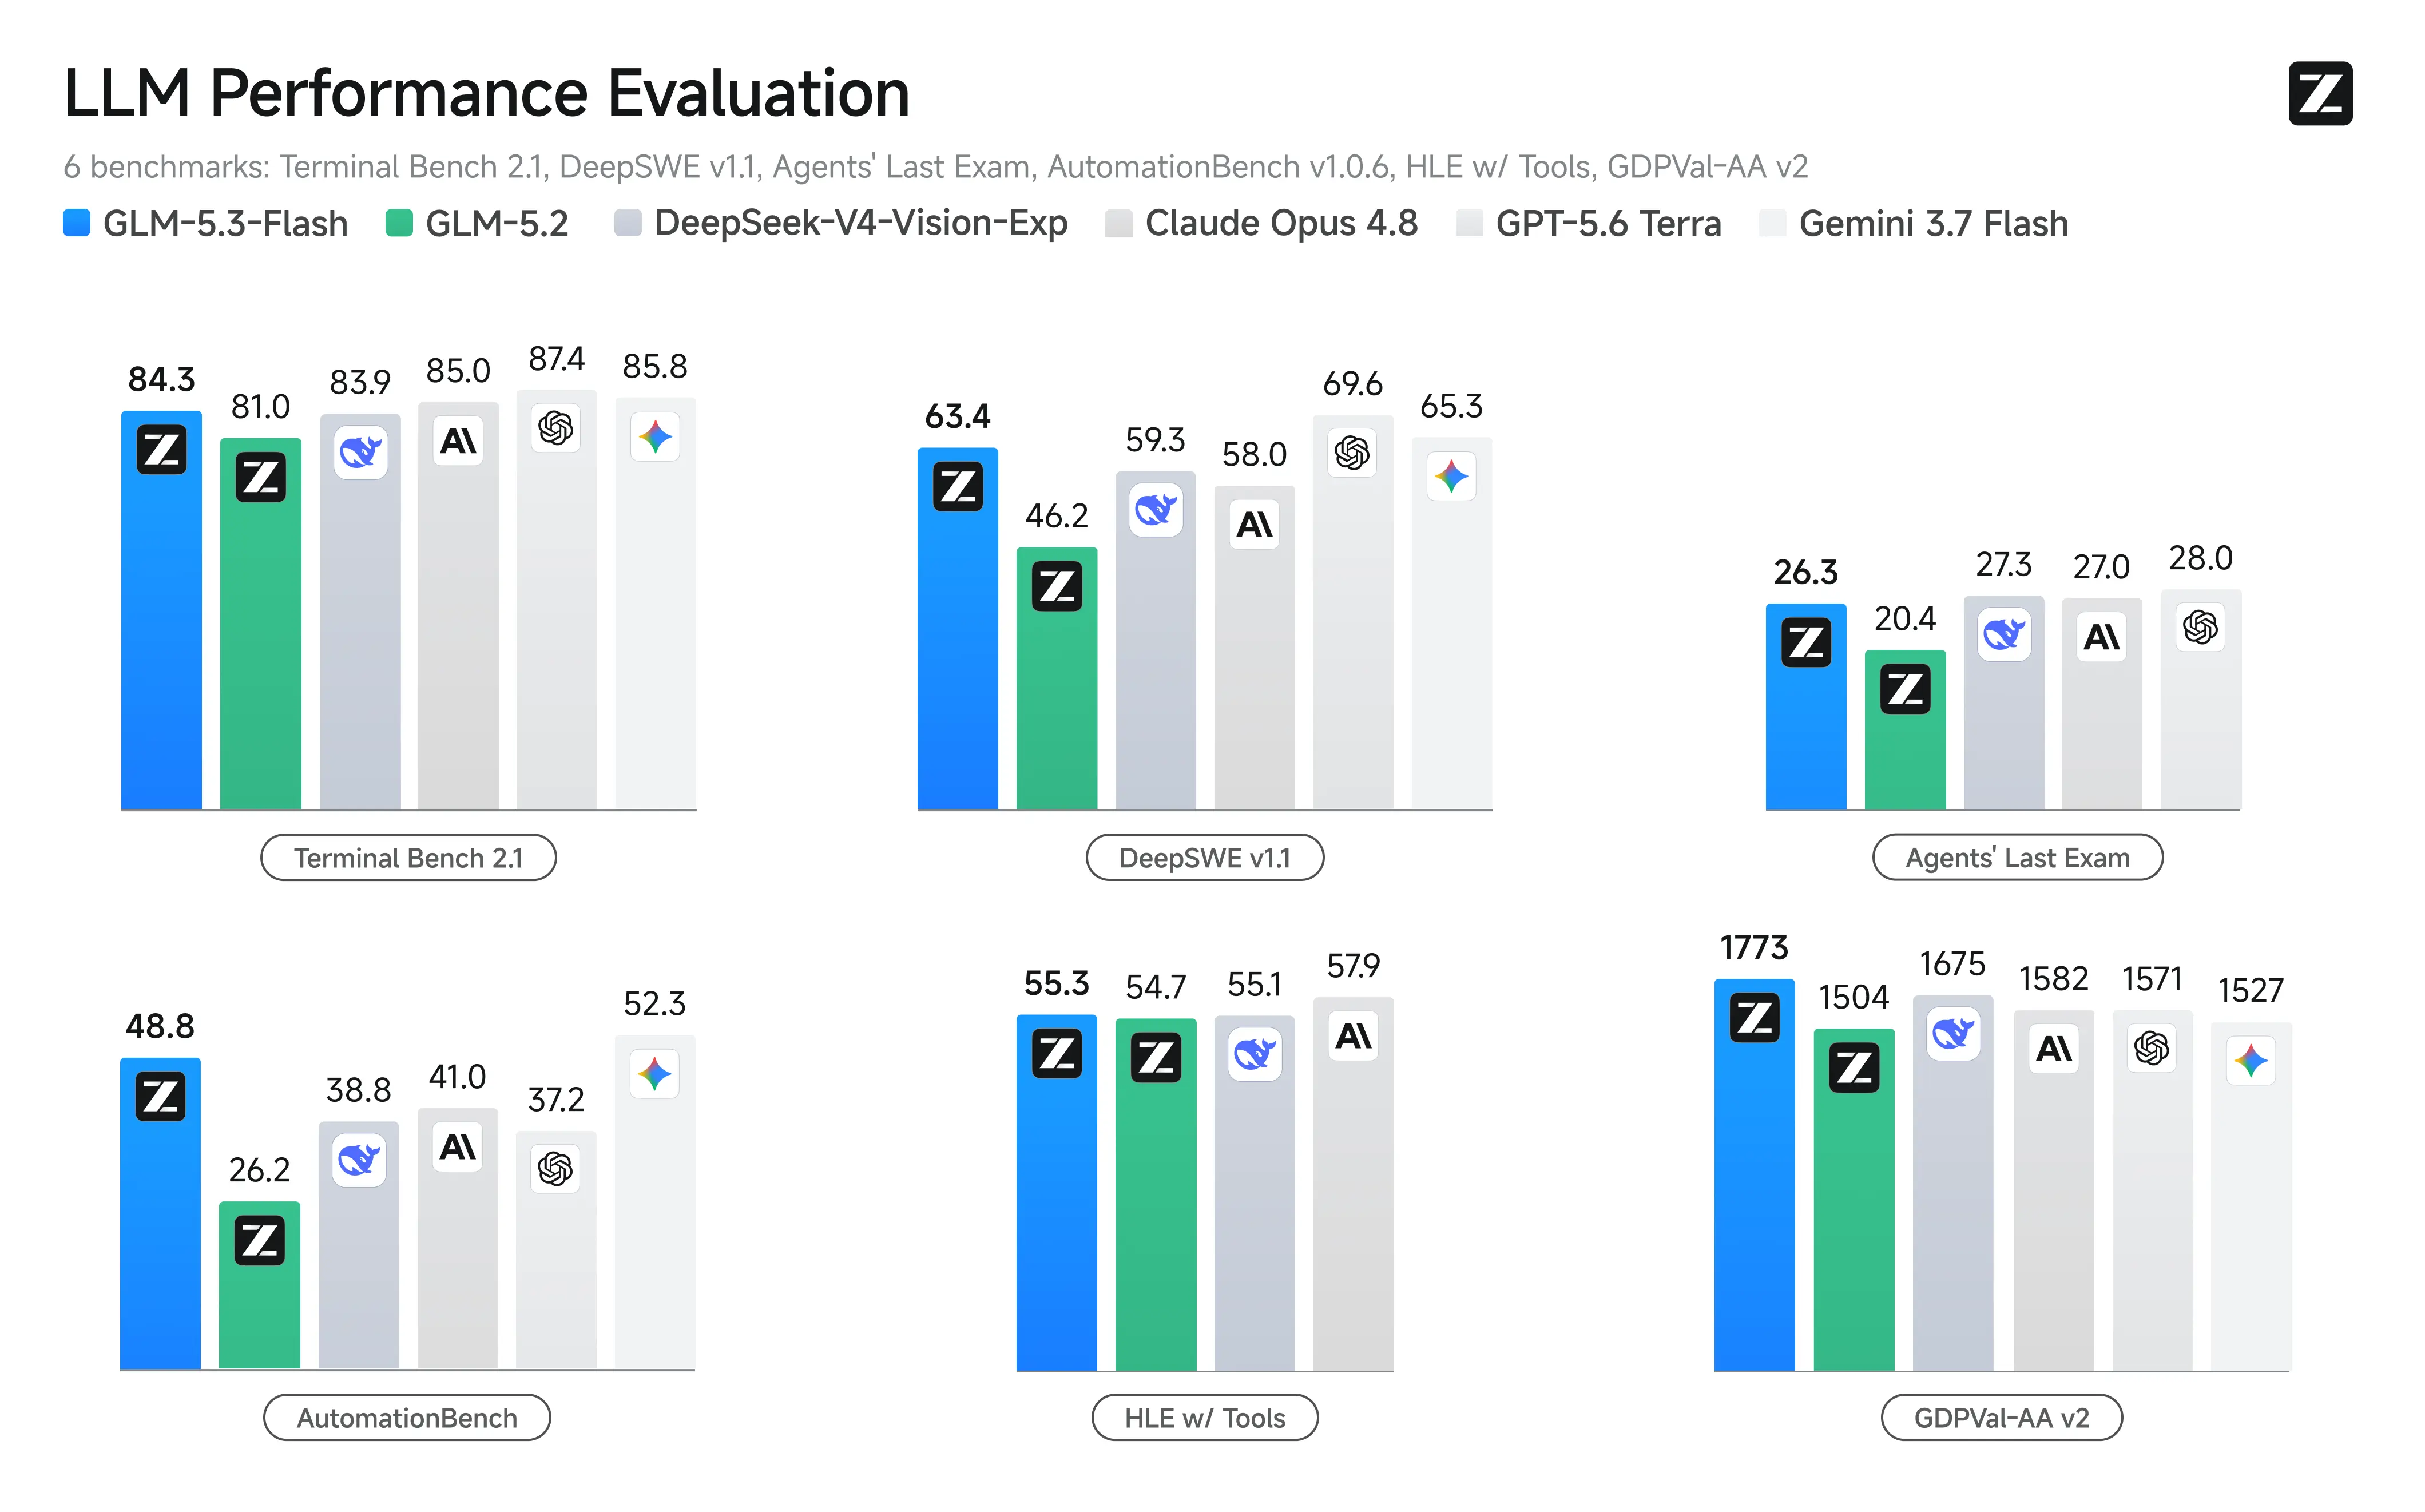
Z.ai melaporkan hasil peluncuran yang kuat pada tugas yang penting bagi pembuat API: kerja terminal, rekayasa perangkat lunak, penggunaan tool, dan otomasi. Ini adalah skor dari vendor yang diperoleh dengan harness dan kebijakan tool tertentu, sehingga membantu mengidentifikasi kekuatan yang mungkin alih-alih menetapkan peringkat universal.
| Benchmark | GLM-5.3 Flash | Implikasi untuk beban kerja API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Sangat cocok untuk agen coding yang digerakkan terminal. |
| DeepSWE v1.1 | 63.4 | Menjanjikan untuk rekayasa perangkat lunak skala repositori. |
| Toolathlon Verified | 78.4 | Sinyal kuat pemilihan dan penggunaan tool. |
| AutomationBench | 48.8 | Otomasi multi-langkah yang lebih baik dibanding pendahulunya. |
Implikasi praktisnya lebih sempit daripada tabel tolok ukur: GLM-5.3 Flash adalah kandidat kuat ketika alur kerja menggabungkan konteks panjang dengan tool atau umpan balik visual. Untuk perbandingan model lengkap, gunakan gambaran model yang ada alih-alih menduplikasinya di sini.
Sumber: grafik tolok ukur resmi Z.ai
Grafik tolok ukur resmi membandingkan kinerja GLM-5.3 Flash di berbagai model dan pengaturan effort. Untuk panduan API ini, grafik tersebut memberikan konteks kinerja yang ringkas daripada mengulangi matriks peluncuran lengkap. Aplikasi tetap harus mengukur keberhasilan tugas, latensi end-to-end, dan total penggunaan token pada prompt mereka sendiri.
Mengapa Menggunakan GLM-5.3 Flash melalui CometAPI?
CometAPI mengekspos GLM-5.3 Flash melalui antarmuka yang kompatibel dengan OpenAI. Ini memungkinkan tim menggunakan kembali pola SDK yang familier, memusatkan kredensial dan penagihan, serta mengganti model tanpa membangun ulang seluruh lapisan permintaan.
• Satu pola integrasi. Klien dasar yang sama dapat memanggil model berbeda yang didukung dengan mengubah ID model.
• Visibilitas penggunaan terpusat. Tim dapat meninjau penggunaan dan biaya tanpa memelihara dasbor terpisah untuk setiap penyedia.
• Evaluasi lebih cepat. Satu harness permintaan dapat membandingkan kualitas respons, latensi, dan error di berbagai model kandidat.
• Desain fallback lebih sederhana. Aplikasi dapat mempertahankan logika retry dan routing di satu lapisan gateway.
• Harga rute terdaftar lebih rendah. Halaman model saat ini mencantumkan $/0.06 per satu juta token input dan $/0.20 per satu juta token output; verifikasi halaman live sebelum membuat anggaran.
Sebelum Memulai
Anda memerlukan akun CometAPI, kunci API, dan salah satu lingkungan lokal berikut:
• Python 3.9 atau lebih baru dengan pip
• Node.js 18 atau lebih baru dengan npm
• cURL untuk uji minimal di command line
Jangan pernah menempatkan kunci CometAPI produksi di JavaScript browser, aplikasi seluler, repositori publik, tangkapan layar, atau log sisi klien. Panggil CometAPI dari server tepercaya dan simpan kunci di variabel lingkungan atau pengelola rahasia.
Cara Menggunakan GLM-5.3 Flash API dengan CometAPI
Langkah 1: Buat Kunci API CometAPI
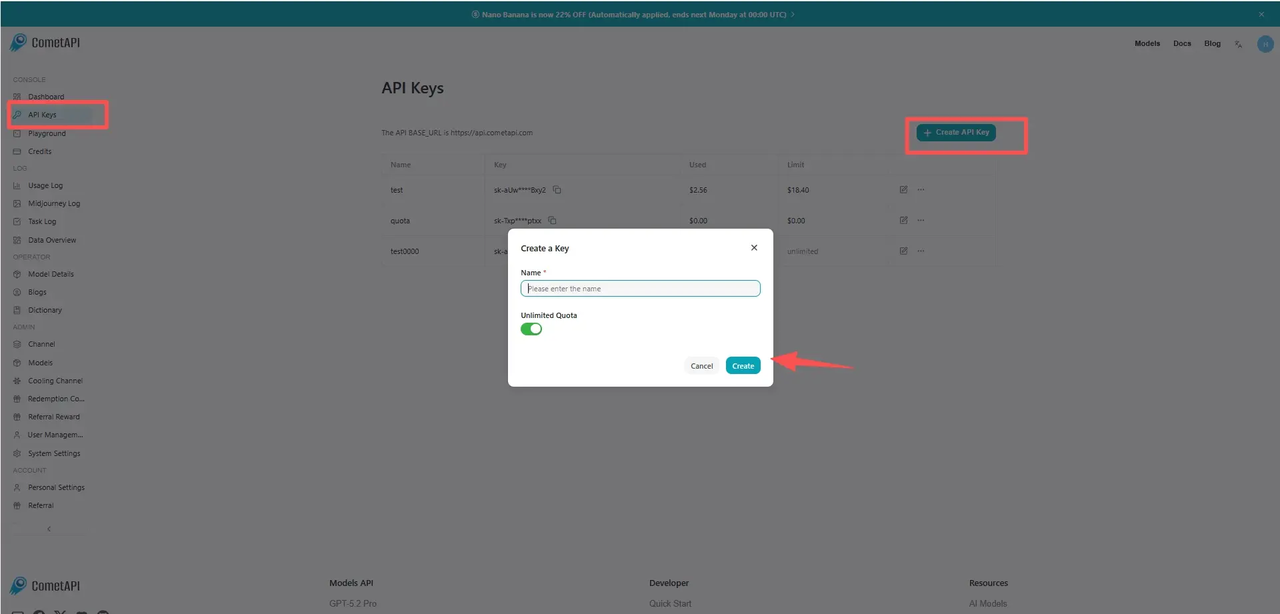
Masuk ke CometAPI, buka konsol kunci API, buat kunci, dan salin sekali ke alur kerja manajemen rahasia Anda. Gunakan kunci terpisah untuk pengembangan dan produksi agar dapat memutar atau mencabut salah satunya tanpa mengganggu yang lain.
Sumber: gambar panduan kunci API resmi CometAPI
Langkah 2: Simpan Kunci sebagai Variabel Lingkungan
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
Untuk produksi, ganti riwayat shell dengan rahasia deployment, rahasia container, atau vault terkelola.

### Langkah 3: Pasang SDK yang Kompatibel dengan OpenAI
python -m pip install --upgrade openai
npm install openai
```

### Langkah 4: Buat Permintaan Pertama dengan cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Respons yang berhasil berisi pesan asisten di bawah choices\[0].message.content plus metadata usage ketika rute mengembalikannya. Mulailah dengan permintaan kecil ini sebelum menambahkan parameter opsional.

### Langkah 5: Panggil API dari Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Langkah 6: Panggil API dari JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Cara Mengendalikan Reasoning Effort

Dokumentasi model resmi mendukung [effort low, high, dan max](https://docs.z.ai/guides/vlm/glm-5.3-flash). [Thinking tetap aktif](https://docs.z.ai/guides/vlm/glm-5.3-flash); pengaturan effort mengubah seberapa banyak anggaran penalaran yang bisa digunakan model.

| Effort | Beban kerja awal yang baik                        | Trade-off                                             |
| ------ | -------------------------------------------------- | ----------------------------------------------------- |
| low    | Klasifikasi, penulisan ulang, ekstraksi singkat   | Latensi lebih rendah dan token output lebih sedikit; kedalaman berkurang. |
| high   | Code review, perencanaan, analisis dokumen        | Default seimbang untuk banyak tugas produksi.         |
| max    | Debugging kompleks, agen tool, penalaran sulit    | Kedalaman tertinggi; potensi latensi dan biaya lebih besar. |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

*Jika SDK yang terpasang mengekspos reasoning_effort sebagai argumen kelas satu, Anda dapat menggunakannya langsung. Jika rute CometAPI menolak field spesifik penyedia, hapus dan gunakan default rute. Jangan mencoba menonaktifkan thinking.*

## Cara Melakukan Streaming Respons

Streaming berguna untuk chat, asisten coding, dan analisis panjang karena memungkinkan antarmuka menampilkan output saat tiba. Streaming tidak mengurangi jumlah total token yang dihasilkan, jadi pertahankan batas output dan kontrol biaya yang sama.

### Streaming di Python

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### Streaming di JavaScript

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Tangani pembatalan. Hentikan pembacaan stream saat klien terputus dan batalkan pekerjaan upstream jika didukung.

• Buffer dengan aman. Jangan berasumsi setiap chunk berisi satu kata lengkap, token JSON, atau objek tool-call.

• Catat usage final. Usage mungkin hanya muncul di event terakhir atau metadata khusus rute.

## Cara Mengirim Gambar

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) menerima konten visual melalui blok image_url di messages\[].content\[]. Dokumentasi resmi merekomendasikan URL gambar yang dapat dijangkau atau Data URL Base64. Halaman model CometAPI mengidentifikasi kemampuan image-to-text, namun aplikasi tetap harus menguji format, ukuran file, dan perilaku rute sebelum produksi.

### Menganalisis URL Gambar

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Mengirim Gambar Lokal sebagai Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Pangkas whitespace yang tidak relevan sebelum melakukan encoding gambar.

• Perkecil gambar yang jauh lebih besar daripada informasi yang diperiksa.

• Ajukan pertanyaan visual yang spesifik alih-alih meminta deskripsi umum.

• Jangan mengasumsikan URL halaman web publik adalah URL gambar langsung.

• Uji pengurutan multi-gambar karena setiap gambar harus dirujuk dengan jelas dalam prompt.

## Cara Meminta JSON Terstruktur

Output terstruktur bernilai ketika komponen berikutnya adalah kode, bukan pembaca manusia. Gunakan skema yang sempit, validasi hasilnya, dan pertahankan fallback untuk rute yang tidak mengekspos JSON Schema ketat dalam bentuk yang persis sama.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

*Mode JSON tidak menghilangkan kebutuhan validasi. Periksa field wajib, tipe, nilai yang diizinkan, dan panjang maksimum sebelum menyimpan hasil atau memicu sistem lain.*

## Cara Menggunakan Function Calling

Function calling memungkinkan model memutuskan kapan memerlukan data eksternal, sementara kode aplikasi tetap bertanggung jawab atas otorisasi dan eksekusi. Pola aman: model mengusulkan pemanggilan tool, server memvalidasi, server mengeksekusi tool, dan model menerima hasilnya.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Validasi argumen. Perlakukan JSON tool-call sebagai input yang tidak tepercaya.

• Tegakkan otorisasi. Model tidak memutuskan apa yang boleh dilakukan pengguna saat ini.

• Pisahkan tool baca dan tulis. Minta konfirmasi untuk tindakan destruktif atau yang terlihat ke luar.

• Batasi inventaris tool. Ekspos hanya tool yang relevan dengan alur kerja saat ini.

• Batasi loop. Tetapkan maksimum putaran tool, total token, waktu berlalu, dan biaya.

## Parameter API [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)

| Parameter               | Tujuan                            | Panduan praktis                                        |
| ----------------------- | --------------------------------- | ------------------------------------------------------ |
| model                   | Memilih rute model                | Gunakan glm-5.3-flash.                                 |
| messages                | Percakapan dan input multimodal   | Jaga urutan role tetap valid; pertahankan pesan tool yang diperlukan. |
| max\_completion\_tokens | Membatasi output yang dihasilkan  | Tetapkan per alur kerja alih-alih mengandalkan maksimum model. |
| temperature             | Perilaku sampling                 | Rekomendasi resmi adalah 1.                            |
| top\_p                  | Nucleus sampling                  | Rekomendasi resmi adalah 0.95.                         |
| reasoning\_effort       | Anggaran penalaran                | Gunakan low, high, atau max; dukungan rute perlu diuji. |
| stream                  | Output inkremental                | Gunakan true untuk respons interaktif.                 |
| tools                   | Definisi fungsi                   | Pertahankan skema sempit dan validasi setiap panggilan. |
| tool\_choice            | Mengontrol pemilihan tool         | Mulai dengan auto kecuali alur kerja mewajibkan tool.  |
| response\_format        | Meminta output yang terbaca mesin | Validasi dukungan dan JSON yang dikembalikan.          |

## Z.ai Direct API vs CometAPI

Keduanya bisa sesuai. Keputusan terutama tentang kepemilikan integrasi, keluasan model, penagihan, dan seberapa cepat aplikasi membutuhkan fitur native penyedia.

| Dimensi        | Z.ai Direct API                               | CometAPI                                           | Hasil praktis                                                   |
| -------------- | --------------------------------------------- | -------------------------------------------------- | --------------------------------------------------------------- |
| Akun dan kunci | Akun dan kunci Z.ai                           | Akun dan kunci CometAPI                            | Kunci tidak dapat dipertukarkan.                                |
| Pola SDK       | Kompatibel dengan OpenAI                      | Kompatibel dengan OpenAI                           | Banyak kode klien dapat digunakan kembali.                      |
| Cakupan model  | Keluarga model Z.ai                           | Banyak penyedia dan keluarga model                 | CometAPI berguna untuk routing dan perbandingan.                |
| Fitur native   | Akses paling awal ke perilaku spesifik penyedia | Bergantung pada eksposur gateway dan pass-through  | Uji field lanjutan di rute yang dipilih.                        |
| Penagihan      | Spesifik penyedia                             | Terpusat di berbagai model yang didukung           | Penagihan terpusat menyederhanakan operasi multi-model.         |
| Desain fallback| Membutuhkan integrasi penyedia lain           | Dapat tetap di satu lapisan gateway                | CometAPI dapat mengurangi friksi saat beralih.                  |
| Kecocokan terbaik | Komitmen mendalam pada kapabilitas native Z.ai | Akses terpadu, evaluasi, dan routing produksi      | Pilih berdasarkan arsitektur sistem, bukan pemenang generik.    |

Gunakan API langsung ketika parameter native penyedia atau fitur produk terbaru sangat penting. Gunakan CometAPI saat satu klien, penagihan terpadu, dan kemampuan membandingkan atau mengganti model lebih penting. Untuk produksi, jalankan suite uji perwakilan yang sama terhadap rute yang persis akan Anda deploy.

## Estimasi Biaya dan Penganggaran Token

Halaman model CometAPI saat ini mencantumkan [$/0.06 per satu juta token input](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) dan [$/0.20 per satu juta token output](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/). Dengan tarif tersebut, estimasi biaya permintaan adalah:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Beban kerja             | Token input | Token output | Perkiraan biaya |
| ----------------------- | ----------- | ------------ | --------------- |
| Pertanyaan singkat      | 2,000       | 400          | $0.00020        |
| Code review             | 50,000      | 4,000        | $0.00380        |
| Analisis dokumen besar  | 250,000     | 10,000       | $0.01700        |
| Putaran agen panjang    | 800,000     | 30,000       | $0.05400        |

*Harga sensitif waktu. Konfirmasikan tarif input, cached-input, dan output yang live sebelum publikasi atau penganggaran produksi. Reasoning dan loop tool dapat meningkatkan output yang ditagih dan input berulang, jadi estimasikan alur kerja lengkap alih-alih satu jawaban yang terlihat.*

## Praktik Terbaik Produksi GLM-5.3 Flash API

### Kontrol Biaya dan Latensi

#### Output caps

Pengaturan generasi untuk tolok ukur dan batas API produksi berbeda. Evaluasi HLE yang dikutip menggunakan maksimum panjang generasi 163,840 token, sementara beberapa evaluasi menggunakan output 64K; tidak ada yang membuktikan setiap rute API hosted dapat mengembalikan lebih dari 100,000 token. Tetapkan batas dari skema rute live dan anggaran alur kerja. Gunakan batas kecil untuk klasifikasi dan ekstraksi, batas sedang untuk analisis, dan batas lebih besar hanya untuk tugas panjang atau agen secara eksplisit.

**Context control**

Jendela satu juta token adalah kapasitas, bukan target. Ambil file yang relevan, hapus log duplikat, letakkan instruksi stabil di dekat awal, dan ukur apakah konteks tambahan meningkatkan keberhasilan tugas.

### State dan Reliabilitas

#### Preserve state

Simpan pesan asisten lengkap yang diperlukan untuk giliran berikutnya, termasuk tool call dan field khusus rute yang telah diverifikasi aplikasi Anda. Menghapus riwayat terstruktur dapat merusak loop tool multi-langkah meskipun teks yang terlihat tampak lengkap.

#### Retry secara selektif

• Retry kegagalan sementara 429, 500, 502, 503, dan timeout jaringan dengan exponential backoff dan jitter.

• Jangan melakukan retry secara membabi buta untuk error autentikasi, parameter tidak valid, atau permintaan berukuran terlalu besar.

• Lampirkan ID permintaan aplikasi agar pekerjaan duplikat dapat dikenali.

• Gunakan kontrol idempoten di sekitar operasi tulis eksternal, bahkan jika permintaan model itu sendiri di-retry.

### Keamanan dan Validasi

#### Validasi output yang dapat dibaca mesin

Validasi skema, pemeriksaan nilai yang diizinkan, batas panjang, dan aturan domain harus berada di antara model dan setiap database, antrean, atau API eksternal. Objek JSON yang valid secara sintaksis masih dapat tidak lengkap atau tidak aman.

#### Otorisasi tool call

Perlakukan tool call yang diusulkan model sebagai permintaan yang tidak tepercaya: validasi argumen, tegakkan otorisasi pengguna, pisahkan operasi baca dan tulis, dan minta konfirmasi untuk tindakan destruktif.

### Observabilitas dan Fallback

#### Ukur alur kerja

• Keberhasilan tugas atau tingkat penerimaan manusia

• Waktu ke token pertama dan total latensi

• Token input, cached input, reasoning, dan output

• Jumlah tool call dan tingkat kegagalan tool

• Retry, pembatasan laju, dan error penyedia

• Biaya per tugas yang diselesaikan, bukan biaya per panggilan terisolasi

#### Rancang fallback

Pilih fallback berdasarkan beban kerja, bukan reputasi. Fallback hanya-teks mungkin memadai untuk ekstraksi dokumen tetapi gagal untuk tugas berbasis tangkapan layar. Definisikan input dan skema tool mana yang portabel, parameter mana yang harus dihapus, dan kapan pengguna harus melihat error yang dapat dipulihkan alih-alih penggantian model otomatis.

## Error Umum dan Pemecahan Masalah

| Gejala                 | Penyebab kemungkinan                                            | Yang perlu diperiksa                                                                 |
| --------------------- | --------------------------------------------------------------- | ------------------------------------------------------------------------------------ |
| 401 Unauthorized      | Kunci hilang, salah format, atau dicabut                        | Konfirmasikan header Authorization dan variabel lingkungan sisi server.             |
| 404 atau model tidak ditemukan | ID model salah atau rute tidak tersedia                    | Gunakan glm-5.3-flash dan konfirmasi ketersediaan di halaman model live.            |
| 429 Rate Limit        | Kuota permintaan atau token terlampaui                          | Backoff, kurangi konkurensi, periksa batas akun, dan retry dengan jitter.           |
| Parameter tidak didukung | Field native penyedia tidak diekspos oleh gateway             | Hapus field opsional, lalu tambahkan kembali satu per satu.                         |
| Context length exceeded | Prompt plus output yang diminta melebihi batas rute            | Pangkas, ambil kembali, rangkum, atau turunkan max\_completion\_tokens.             |
| Gambar tidak valid    | URL tidak dapat diakses, format tidak didukung, atau Base64 rusak | Uji URL gambar HTTPS langsung dan perbaiki prefiks MIME.                            |
| JSON streaming rusak  | Chunk diparsing sebagai objek lengkap                           | Buffer stream dan parse hanya setelah payload JSON lengkap tiba.                    |
| Loop tool tidak berakhir | Tidak ada batas langkah atau hasil tool ambigu                  | Batasi putaran, perbaiki deskripsi tool, dan kembalikan error tool yang eksplisit.  |

## Kapan Anda Harus Menggunakan GLM-5.3 Flash API?

### Kecocokan yang Baik

• Pemahaman kode skala repositori dan review multi-file

• Coding visual, analisis tangkapan layar, dan QA antarmuka

• Paket dokumen panjang dan sintesis berbasis bukti

• Agen yang menggunakan tool dengan perencanaan dan verifikasi berulang

• Alur kerja volume tinggi di mana biaya token memengaruhi unit economics

• Aplikasi yang diuntungkan dari penggantian atau perbandingan model melalui satu gateway

### Gunakan Rute atau Model Lain Ketika

• Produk memerlukan output gambar atau video, bukan output teks.

• Tugas adalah klasifikasi kecil berisiko rendah yang dapat ditangani model lebih kecil secara andal.

• Fitur native penyedia wajib tetapi tidak diekspos di rute gateway.

• Alur kerja tidak dapat mentoleransi thinking yang selalu aktif atau profil latensi terkait.

• Aplikasi belum menguji model pada tool, data, dan kasus kegagalannya sendiri.

## FAQ

###

### Apa yang harus Anda verifikasi pada rute CometAPI yang tepat sebelum peluncuran?

Verifikasi ketersediaan model, format multimodal yang diterima, output maksimum, field reasoning, perilaku output terstruktur, batas laju, dan harga saat ini dengan permintaan yang representatif.

### Metrik apa yang harus dilacak evaluasi produksi?

Lacak keberhasilan tugas, waktu ke token pertama, total latensi, token input dan output, kegagalan tool-call, tingkat retry, dan biaya per alur kerja yang diselesaikan, bukan hanya biaya per panggilan API.

### Bagaimana cara memilih antara Z.ai direct dan CometAPI?

Gunakan Z.ai direct saat akses segera ke perilaku native penyedia itu penting. Gunakan CometAPI saat autentikasi terpadu, penagihan, perbandingan model, dan fallback di level gateway lebih penting.

### Apa yang membuat fallback aman?

Fallback yang aman menerima modalitas input yang sama, mempertahankan skema tool yang diperlukan, menghapus parameter yang tidak didukung, tetap dalam batas otorisasi tugas, dan gagal secara terlihat ketika perilaku tidak dapat dipertahankan.

## Kesimpulan

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) paling berguna melalui API ketika konteks panjang, input visual, penalaran, dan penggunaan tool menjadi bagian dari satu alur kerja. Integrasi CometAPI dasar itu kecil: satu kunci sisi server, satu klien yang kompatibel dengan OpenAI, ID model [glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/), dan endpoint chat-completions. Kualitas produksi berasal dari segala sesuatu di sekitar permintaan itu: prompt yang terukur, batas output, validasi skema, otorisasi tool, retry, observabilitas, dan evaluasi spesifik beban kerja.

Mulailah dengan panggilan teks pendek, tambahkan satu kemampuan lanjutan pada satu waktu, dan uji perjalanan pengguna lengkap sebelum skala. Konfirmasikan halaman model [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) live untuk ketersediaan saat ini, perilaku rute yang didukung, dan harga.

## Metadata SEO

**Meta title:** Cara Menggunakan GLM-5.3 Flash API: Panduan Pengembang

**Meta description:** Pelajari cara menggunakan GLM-5.3 Flash API dengan CometAPI, termasuk contoh Python dan JavaScript, visi, streaming, tools, output JSON, dan praktik terbaik.

**Keywords:** GLM-5.3 Flash API, cara menggunakan GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, tutorial API GLM, API multimodal, reasoning API, function calling

**URL slug:** how-to-use-glm-5-3-flash-api