
TL;DR
Kimi K3.1 Pro adalah peningkatan Kimi K3 oleh Moonshot AI pada 24 Oktober 2026. Pascapelatihan tambahan meningkatkan pengodean otonom, riset keuangan, dan alur kerja penggunaan alat yang diperluas sambil mempertahankan kapasitas konteks sekitar satu juta token yang sama.
Evaluasi independen menunjukkan kinerja keseluruhan yang lebih kuat, dan tarif token input/output resmi standar turun sepertiga. Peningkatan ini tetap memerlukan pengujian beban kerja: penalaran yang lebih dalam dapat meningkatkan latensi tugas dan total pengeluaran, sementara K3 mempertahankan sedikit keunggulan pada AA-LCR dan bobot yang tersedia saat ini untuk self-hosting.
Poin Utama
- Peningkatan paling jelas ada pada eksekusi agentik. Artificial Analysis melaporkan skor Terminal-Bench 4.0 sekitar 67% untuk K3.1 Pro versus 13% untuk K3; skor Riset Keuangan internal Moonshot naik dari 58.8 menjadi 70.4.
- Harga token yang lebih rendah tidak menjamin biaya tugas yang lebih rendah. Tarif input/output resmi standar turun dari $3/$15 menjadi $2/$10 per juta token, tetapi penalaran tambahan, pemanggilan alat, dan percobaan ulang dapat meniadakan penghematan tersebut.
- Jendela konteks tetap sama. Kedua model mendukung hingga 1,048,576 token. K3 tetap sedikit unggul dalam evaluasi AA-LCR v1.1 yang dikutip, jadi uji akurasi konteks panjang pada dokumen Anda sendiri.
- Ketersediaan bobot dapat menentukan pilihan. Per 24 Oktober 2026, bobot K3 tersedia; bobot K3.1 Pro dijadwalkan rilis sebelum 4 November. Tim yang membutuhkan self-hosting segera harus memperhitungkan perbedaan ini.
Kimi K3.1 Pro vs Kimi K3: Gambaran Umum dan Spesifikasi
Kimi K3.1 Pro dibangun di atas K3 melalui pascapelatihan tambahan, dengan peningkatan difokuskan pada pengodean, riset keuangan, dan alur kerja agen yang diperluas. Keduanya mempertahankan sekitar satu juta token konteks. Perbedaan utama adalah kinerja tugas, harga token, opsi penyajian, dan ketersediaan bobot.
| Spesifikasi | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Pengembang | Moonshot AI | Moonshot AI |
| Tanggal rilis | 24 Oktober 2026 | 16 Juli 2026 |
| Arsitektur | MoE turunan K3, pascapelatihan lanjut | MoE dengan KDA, AttnRes |
| Ukuran model | Kelas 3T dan 104B parameter aktif | Total 2.8T dan 104B parameter aktif |
| Jendela konteks | Hingga 1,048,576 token | Hingga 1,048,576 token |
| Harga input / output API standar | $2 / $10 per juta token | $3 / $15 per juta token |
| Versi Highspeed | Tersedia | Tidak ada varian K3 Highspeed terpisah yang tercantum |
| Ketersediaan bobot | Rilis direncanakan pada 4 November 2026 | Tersedia di bawah Lisensi Kimi K3 |
Ketersediaan bobot mencerminkan informasi per 24 Oktober 2026. Harga API dalam USD untuk input dan output reguler, tidak termasuk biaya penulisan cache, pajak, dan biaya lain yang berlaku.
Arsitektur dan Pascapelatihan
K3 memperkenalkan arsitektur 2.8 triliun parameter yang menggabungkan Kimi Delta Attention, Attention Residuals, dan Stable LatentMoE. Model ini mengaktifkan sekitar 104 miliar parameter per token.
Moonshot menggambarkan K3.1 Pro sebagai versi K3 yang dipascapelatihan dengan komputasi pascapelatihan yang jauh lebih besar. Peningkatan berfokus pada penerapan kapabilitas model di tugas multi-langkah, termasuk penggunaan alat, debugging, dan verifikasi hasil. Pengumuman ini tidak memperkenalkan arsitektur dasar terpisah yang diberi nama tersendiri.
Kemampuan Bersama dan Persyaratan API
Kedua model mendukung input multimodal, pemanggilan alat, output terstruktur, dan cache konteks. Format input gambar dan video bergantung pada rute API yang dipilih. Keduanya selalu melakukan penalaran dan mendukung tingkat upaya penalaran low, high, dan max, dengan max sebagai default.
Untuk percakapan multi-giliran dan pemanggilan alat, integrasi harus mempertahankan pesan asisten secara lengkap, termasuk konten penalaran dan pemanggilan alat, sebagaimana disyaratkan oleh API. Batas konteks aktual dan ketersediaan fitur juga harus diperiksa untuk penyedia, produk, dan tingkat langganan yang dipilih.
Kimi K3.1 Pro vs Kimi K3: Kinerja
Bukti berasal dari pengujian internal Moonshot dan perbandingan yang dilaporkan, bersama evaluasi independen pihak ketiga.
Ini harus ditafsirkan secara terpisah karena kerangka benchmark, set uji, pengaturan penalaran, dan kriteria penilaian dapat berbeda.
Evaluasi peluncuran Artificial Analysis melaporkan peningkatan 11 poin pada Indeks Kecerdasan kompositnya, dengan peningkatan besar pada pengodean berbasis terminal dan alur kerja agentik.
| Benchmark Independen (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Perbedaan |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 poin persentase |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| Tingkat halusinasi AA-Omniscience | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 pp |
Ini adalah hasil evaluasi independen. Nilai dibulatkan digunakan ketika evaluator melaporkan skor yang dibulatkan. Tingkat halusinasi yang lebih rendah lebih baik.
Peningkatan terbesar terjadi pada pengodean berbasis terminal. K3.1 Pro berkinerja jauh lebih baik pada tugas yang memerlukan eksekusi perintah, interaksi lingkungan, debugging, dan validasi berulang.
AutomationBench-AA juga menunjukkan kenaikan signifikan, yang menyiratkan eksekusi yang lebih kuat dalam alur kerja software-as-a-service.
Benchmark rilis Moonshot berfokus pada pengodean, sains, rekonstruksi 3D, keuangan, pekerjaan berbasis pengetahuan, dan agen otonom.
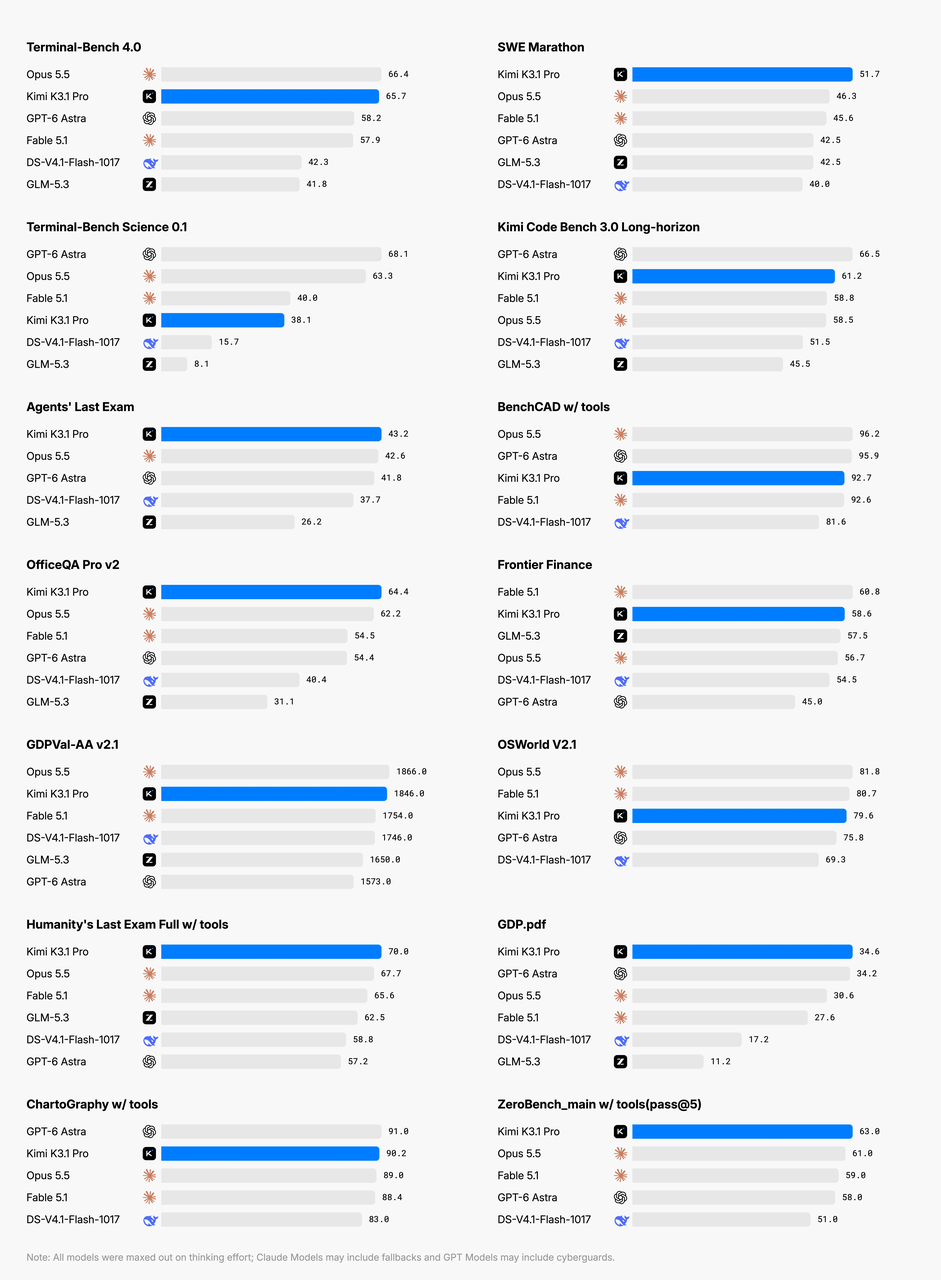
Perbandingan yang dipilih mencakup Claude Opus 5.5 dan GPT-6 Astra. Bandingkan setiap hasil dalam benchmark bernama dan konfigurasi yang dinyatakan.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Model Lain | Skor Model Pembanding |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD dengan alat | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro mendekati atau melampaui beberapa model proprietari terkemuka dalam tugas-tugas terpilih. Namun ia tidak mendominasi setiap kategori.
Misalnya, model ini masih tertinggal dari Claude Opus 5.5 dalam perbandingan BenchCAD dan OSWorld yang dilaporkan vendor, dan grafik resmi menunjukkan kelemahan yang lebih besar di Terminal-Bench Science.
Pengaturan evaluasi berbeda: Artificial Analysis menggunakan kerangka mini-swe-agent untuk Terminal-Bench 4.0, sementara Moonshot menggunakan Claude Code. Bandingkan skor dalam set pengujian yang sama; kerangka, upaya penalaran, dan batas waktu eksekusi dapat memengaruhi hasil.
Pemrograman dan Rekayasa Perangkat Lunak
Untuk pengodean otonom yang kompleks, K3.1 Pro umumnya pilihan yang lebih kuat.
Hasil Long-horizon Kimi Code Bench 3.0 internal Moonshot meningkat dari 55.95% untuk K3 menjadi 61.2% untuk K3.1 Pro, kenaikan sekitar 5.25 poin persentase.
Hasil Terminal-Bench independen juga menunjukkan kenaikan substansial. Pengujian ini menilai eksekusi multi-langkah: memahami repositori, mengubah file, menjalankan perintah, mendiagnosis kesalahan, dan memverifikasi hasil.
K3.1 Pro adalah kandidat yang lebih kuat untuk pengembangan multi-file, pekerjaan terminal otonom, dan debugging yang diperpanjang. Untuk generasi kode sederhana, bandingkan kedua model pada tugas Anda sendiri; K3 tetap menjadi opsi langsung ketika self-hosting diperlukan.
Satu perbedaan penting adalah skor benchmark pengodean sangat bergantung pada kerangka kerja agen. Alat, prompt, batas runtime, dan lingkungan pengujian memengaruhi hasil.
Untuk pengembangan perangkat lunak produksi, evaluasi terbaik tetap perbandingan yang cocok pada repositori Anda sendiri.
Riset Keuangan dan Operasi Bisnis
Pemodelan keuangan memberikan beberapa perbandingan langsung paling jelas antara kedua model.
Moonshot menguji K3 dan K3.1 Pro pada evaluasi internal yang mencakup pembuatan spreadsheet, kualitas riset, dan operasi bisnis yang disimulasikan.
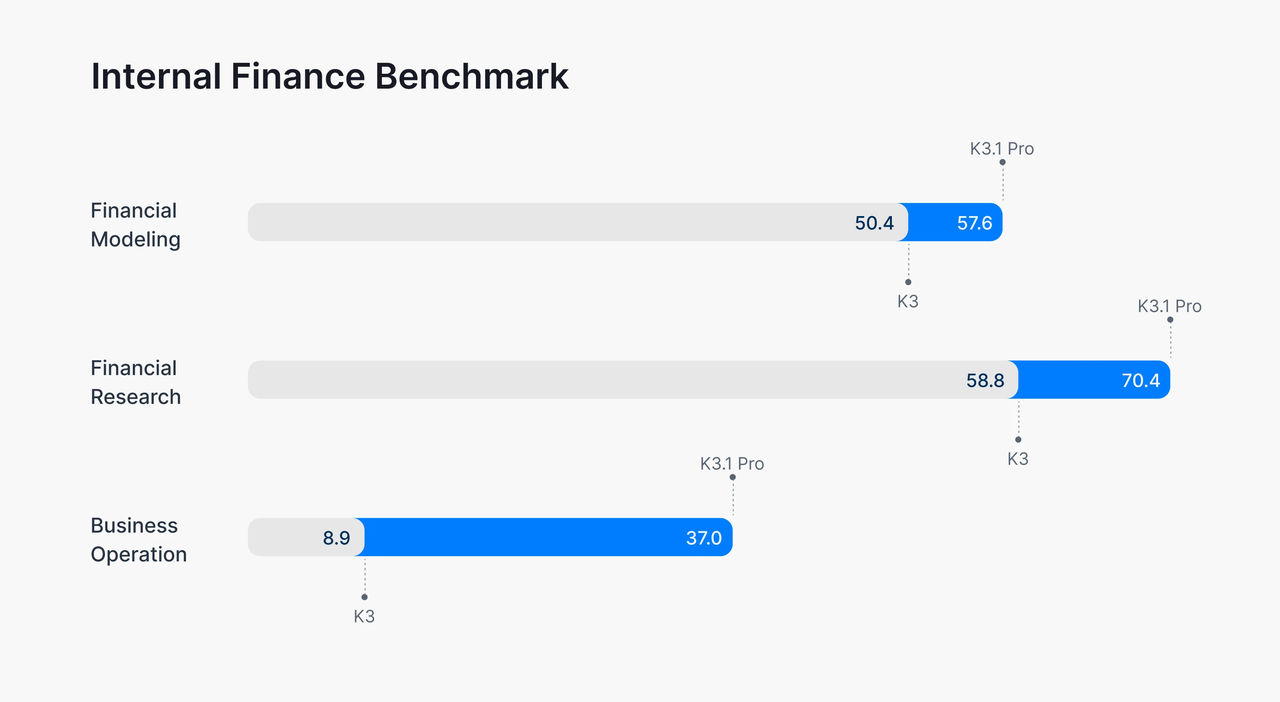
Hasil keuangan internal Moonshot mencakup pemodelan keuangan, riset, dan operasi bisnis yang disimulasikan. Skor tugas yang dilaporkan vendor ini bukan ukuran pengembalian investasi. Pengaturan per tugas tidak boleh diasumsikan identik dengan benchmark lain yang tidak terkait.
Dalam pengujian internal Moonshot, Financial Modeling naik dari 50.4 menjadi 57.6, kenaikan 7.2 poin, dan Financial Research naik dari 58.8 menjadi 70.4, kenaikan 11.6 poin. Business Operation meningkat dari 8.9 menjadi 37.0, sekitar 4.2 kali skor K3.
Benchmark ini mengevaluasi manajemen dan pengambilan keputusan horizon panjang dalam lingkungan bisnis yang disimulasikan. Oleh karena itu, benchmark ini lebih terkait dengan perencanaan agentik dibandingkan dengan tanya jawab keuangan sederhana.
Financial Research mengukur kemampuan menghasilkan riset berbasis bukti sambil menghormati persyaratan sumber dan cutoff informasi. Financial Modeling berfokus pada hubungan matematis, logika spreadsheet, dan kualitas workbook.
Pola tersebut menunjukkan bahwa K3.1 Pro sangat berharga ketika tugas keuangan memerlukan penalaran berkelanjutan, verifikasi, dan deliverable terstruktur.
Bagi investor, analis, dan pengguna bisnis, manfaat praktisnya berpotensi penanganan yang lebih baik atas alur kerja multi-dokumen. Tidak ada model yang boleh digunakan sebagai otoritas yang tidak perlu dipertanyakan untuk keputusan keuangan.
Penalaran Konteks Panjang dan Keandalan Faktual
Namun, hasil konteks panjang AA-LCR menunjukkan K3 sedikit unggul. Ini merupakan pengingat berguna bahwa model yang lebih baru dapat meningkat secara substansial secara keseluruhan tanpa memenangkan setiap tugas khusus.
Evaluasi yang dilaporkan menunjukkan lebih sedikit kesalahan faktual pada set uji masing-masing.
Pada Kimi Hallu Bench Hard dengan alat, Moonshot melaporkan tingkat kesalahan setingkat klaim turun dari 23.4% untuk K3 menjadi 8.3% untuk K3.1 Pro.
Itu sekitar penurunan relatif 65% pada uji stres sengaja sulit milik Moonshot, bukan perkiraan tingkat kesalahan sehari-hari. Secara terpisah, Artificial Analysis melaporkan penurunan tingkat halusinasi AA-Omniscience dari 53% menjadi 44%. Kedua evaluasi menggunakan metode berbeda, sehingga persentasenya tidak dapat dibandingkan secara langsung.
Pelajaran praktisnya adalah K3.1 Pro tampak lebih andal pada tugas yang dievaluasi, tetapi perbaikan faktual tidak menghilangkan kebutuhan akan retrieval, sitasi, pemeriksaan perhitungan, dan review manusia dalam alur kerja yang konsekuensial.
Analisis Data: Bukti dari Evaluasi Plotly
Plotly mengevaluasi K3.1 Pro standar melalui OpenRouter menggunakan uji privat 43 pertanyaan atas gudang data energi angin sintetis. Highspeed tidak diuji. Hasilnya menggambarkan trade-off antara kualitas jawaban, waktu penyelesaian, dan biaya dalam alur kerja analitik berbasis SQL spesifik tersebut.
| Ukuran Analitik Data Plotly | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Jawaban benar | 35/43 | 42/43 |
| Akurasi | 81.4% | 97.7% |
| Pola tersembunyi ditemukan | 0/5 | 5/5 |
| Isu kualitas data teridentifikasi | 1/3 | 3/3 |
| Biaya evaluasi penuh | $5.01 | $13.47 |
| Waktu median per pertanyaan | 43 detik | 2.5 menit |
Dalam evaluasi ini, K3.1 Pro menjawab lebih banyak pertanyaan dengan benar dan mengidentifikasi lebih banyak pola tersembunyi serta isu kualitas data, tetapi menimbulkan biaya lebih tinggi dan waktu penyelesaian median lebih lama.
Biaya yang dilaporkan adalah biaya evaluasi yang diamati, bukan estimasi yang dihitung dari harga API standar Moonshot. Pengaturan yang dipublikasikan tidak menetapkan bahwa semua pengaturan penyedia identik antara dua jalur model, sehingga perbedaan tidak dapat diatribusikan hanya pada model.
Hasil ini mendukung evaluasi K3.1 Pro untuk tugas analitis di mana temuan tambahan dapat membenarkan lebih banyak waktu dan pengeluaran. Mereka tidak menetapkan akurasi atau keunggulan biaya yang sama.
Apakah Kimi K3.1 Pro Lebih Cepat daripada Kimi K3?
Bedakan throughput token output dari latensi tugas ujung-ke-ujung.
Artificial Analysis melaporkan 73.5 token output per detik untuk K3.1 Pro, dibandingkan 38.5 untuk K3 pada upaya penalaran maksimum, menggunakan API Kimi. Ini adalah pengukuran generasi token, diperiksa pada 24 Oktober 2026; latensi tugas total juga bergantung pada panjang penalaran dan eksekusi alat.
Namun, generasi token yang lebih cepat tidak menjamin penyelesaian tugas yang lebih cepat.
Moonshot juga menawarkan K3.1 Pro Highspeed, yang diiklankan memberikan output sekitar dua hingga tiga kali lebih cepat daripada varian standar. Ini adalah peningkatan kecepatan penyajian, bukan peningkatan kecerdasan terverifikasi terpisah.
K3.1 Pro memiliki throughput token output yang lebih tinggi, tetapi tidak selalu menyelesaikan tugas lebih cepat. Bedakan antara kecepatan menghasilkan token dan waktu yang diperlukan untuk bernalar, memanggil alat, dan menyelesaikan pekerjaan.
Kecepatan Output vs. Waktu Penyelesaian Tugas
Artificial Analysis melaporkan kecepatan output 73.5 token per detik untuk K3.1 Pro dan 38.5 untuk K3 pada upaya penalaran maksimum, menggunakan API Kimi. Pengukuran ini diperiksa pada 24 Oktober 2026 dan menggambarkan throughput generasi token, bukan latensi tugas ujung-ke-ujung.
Sebuah model dapat menghasilkan token lebih cepat sambil memakan waktu lebih lama secara keseluruhan jika ia menghasilkan lebih banyak token penalaran atau melakukan pemanggilan alat tambahan. Dalam evaluasi Plotly yang dibahas di atas, waktu penyelesaian median K3.1 Pro adalah 2.5 menit per pertanyaan, dibandingkan 43 detik untuk K3, bersamaan dengan akurasi yang lebih tinggi.
Untuk aplikasi interaktif, ukur waktu hingga token pertama dan total waktu penyelesaian tugas pada rute penyedia yang sebenarnya. Throughput output saja tidak cukup untuk memprediksi responsivitas.
Pertimbangkan K3.1 Pro Highspeed
Moonshot mengiklankan K3.1 Pro Highspeed sebagai memberikan kecepatan output sekitar dua hingga tiga kali varian K3.1 Pro standar. Klaim itu terkait kecepatan penyajian; ini tidak boleh ditafsirkan sebagai pengurangan waktu penyelesaian tugas total dua hingga tiga kali lipat.
Pertimbangkan Highspeed untuk pengodean interaktif atau asisten yang menunggu respons. Bandingkan latensi ujung-ke-ujung, keberhasilan tugas, dan total biaya yang ditagihkan terhadap endpoint standar sebelum memilihnya. Highspeed memiliki harga token input reguler dan output yang lebih tinggi, sementara tarif input cache-nya sama.
Kimi K3.1 Pro vs Kimi K3: Biaya
Tarif API Resmi dan CometAPI
Tarif input, output, dan hit cache K3.1 Pro standar resmi sepertiga lebih rendah daripada K3. Tarif input dan output CometAPI yang tercantum 20% lebih rendah lagi dari tarif resmi yang bersesuaian.
| Model | Input Resmi / 1M | Output Resmi / 1M | Input Cache Resmi / 1M | Input CometAPI / 1M | Output CometAPI / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Cek kuotasi saat ini | Cek kuotasi saat ini |
USD per juta token; tarif diperiksa 24 Oktober 2026. Kolom input menunjukkan tarif input tak bercache reguler. Pajak dan biaya penggunaan yang ditagihkan terpisah tidak termasuk.
Harga resmi Kimi juga mencantumkan biaya penulisan cache: $2/$4 per juta token untuk Pro standar dengan retensi 5 menit/1 jam, dan $4/$8 untuk Highspeed. Hit cache, penulisan cache, dan input reguler adalah kategori penagihan terpisah yang saling eksklusif.
Kimi resmi dan CometAPI adalah rute penyedia terpisah. Konfirmasikan harga saat ini dan dukungan cache untuk rute yang Anda pilih, termasuk ketersediaan Highspeed. Bandingkan biaya tugas yang ditagihkan total serta tarif token.
Contoh Biaya Token Tetap
Pertimbangkan beban kerja yang mengonsumsi 100,000 token input tak bercache dan 20,000 token output.
Untuk beban kerja tetap ini, biaya API resmi adalah $0.60 dengan K3 dan $0.40 dengan K3.1 Pro. Pada tarif CometAPI yang tercantum, jumlah token yang sama berbiaya $0.48 dan $0.32, masing-masing. Total ini hanya mencakup token input dan output yang dinyatakan.
Namun ini adalah perbandingan token tetap. Alur kerja agen yang kompleks dapat mengonsumsi jumlah token penalaran dan panggilan alat yang berbeda bergantung pada modelnya.
Penghematan Token Menghilang
Misalkan I adalah jumlah token input tak bercache yang identik, O adalah jumlah token output yang ditagihkan Kimi K3, dan P adalah jumlah token output yang ditagihkan Kimi K3.1 Pro, semuanya diukur dalam jutaan. Pada tarif resmi standar dalam tabel harga, biayanya adalah 3I + 15O dan 2I + 10P dolar. Mereka sama ketika P = 1.5O + 0.1I.
Untuk permintaan yang berat pada output, K3.1 Pro karena itu dapat menggunakan sekitar 50% lebih banyak token output yang ditagihkan sebelum kehilangan keunggulan harganya. Perhitungan ini mengasumsikan tarif yang tidak berubah dan mengecualikan caching, biaya alat, dan penggunaan yang ditagihkan terpisah lainnya. Gunakan kategori token yang ditagihkan sebenarnya alih-alih panjang jawaban yang terlihat.
Biaya per Tugas yang Berhasil Diselesaikan
Hitung biaya per tugas yang berhasil sebagai total biaya yang ditagihkan dari semua percobaan evaluasi dibagi jumlah tugas unik yang memenuhi kriteria penerimaan yang telah ditentukan. Sertakan biaya dari percobaan yang gagal, percobaan ulang, dan timeout ketika penyedia menagihnya; membagi hanya biaya dari run yang berhasil dengan jumlahnya dapat meremehkan biaya per keberhasilan.
Pertahankan set tugas, kriteria penerimaan, batas percobaan ulang, dan kebijakan timeout tetap antara Kimi K3 dan K3.1 Pro. Laporkan tingkat keberhasilan bersamaan dengan biaya per keberhasilan sehingga menjatuhkan tugas sulit tidak dapat membuat model tampak ekonomis secara artifisial. Jika tidak ada tugas yang berhasil, biaya per keberhasilan tidak terdefinisi, bukan nol.
Kimi K3.1 Pro vs Kimi K3: Perbandingan dan Pemilihan
Untuk sebagian besar beban kerja agentik yang di-host, K3.1 Pro adalah titik awal yang lebih kuat. Namun demikian, keputusan harus mencerminkan kompleksitas tugas dan persyaratan penerapan.
| Kasus Penggunaan | Model yang Direkomendasikan | Alasan |
|---|---|---|
| Pemrograman otonom | Kimi K3.1 Pro | Evaluasi perubahan multi-file, pekerjaan terminal, debugging, dan hasil uji akhir. |
| Riset keuangan multi-dokumen | Kimi K3.1 Pro | Benchmark riset dan operasi bisnis yang ditingkatkan |
| Analisis data kompleks | Kimi K3.1 Pro | Penemuan masalah yang lebih baik dan pengujian kualitas data |
| Pembuatan 3D dan alur kerja CAD | Kimi K3.1 Pro | Kapabilitas khusus berbantuan alat yang kuat |
| Tugas teks sederhana | Benchmark keduanya | Bandingkan tugas rutinitas teks dan pengodean sederhana pada keduanya; penalaran ekstra dapat menambah latensi tanpa memperbaiki hasil yang sudah memadai. |
| Akurasi pengambilan konteks panjang | Benchmark keduanya | K3 sedikit unggul pada AA-LCR |
| Self-hosting segera | Kimi K3 | Bobot yang dapat diunduh sudah tersedia |
| Agen interaktif berkemampuan tinggi | K3.1 Pro Highspeed | Penyajian lebih cepat, tunduk pada validasi biaya |
| Alur kerja produksi peka biaya | Benchmark keduanya | Harga token yang lebih rendah mungkin tidak berarti biaya tugas lebih rendah |
Otomasi Hosted dan Alur Kerja Profesional
Untuk agen pengodean yang di-host dan alur kerja analitik, evaluasi K3.1 Pro pada bagian tersulit dari pekerjaan sebenarnya: perubahan multi-file, pengumpulan bukti, pemeriksaan perhitungan, dan pemulihan setelah pemanggilan alat yang gagal. Utamakan pengurangan terukur pada tugas gagal atau pekerjaan korektif dibandingkan skor utama yang lebih tinggi semata.
Untuk aplikasi K3 yang sudah mapan, pertahankan rute yang ada sebagai baseline perbandingan. Tugas rutin mungkin sudah memenuhi ambang penerimaan, sementara tugas konteks panjang khusus dapat berperilaku berbeda dari benchmark agregat. Prioritaskan segmen beban kerja di mana peningkatan memiliki manfaat terukur.
Self-Hosting dan Kendala Penerapan
Per 24 Oktober 2026, bobot penuh K3 tersedia untuk penerapan sesuai lisensi model dan persyaratan perangkat keras. Bobot penuh K3.1 Pro belum dipublikasikan.
Moonshot berencana merilis bobot K3.1 Pro sebelum 4 November 2026. Ini adalah rencana rilis yang diumumkan, bukan checkpoint yang tersedia; konfirmasikan bobot yang dipublikasikan dan ketentuan yang berlaku sebelum menjadwalkan self-hosting.
Kriteria Evaluasi Produksi
Bandingkan K3 dan K3.1 Pro pada tugas representatif menggunakan prompt, alat, kriteria penerimaan, batas percobaan ulang, dan timeout yang sama. Catat pengaturan penyedia dan penalaran, dan pertahankan pesan asisten lengkap sebagaimana disyaratkan oleh API.
Ukur keberhasilan tugas, latensi, penggunaan token, dan biaya per tugas yang berhasil, termasuk kegagalan dan percobaan ulang yang ditagihkan. Tinjau kasus di mana K3 berhasil tetapi K3.1 Pro gagal. Untuk evaluasi manusia, sembunyikan label model dan acak urutan output.
Jika K3.1 Pro memenuhi ambang kualitas, latensi, dan biaya Anda, rilis bertahap dengan fallback K3 yang telah diuji.
Migrasi Terkendali dan Fallback
Pendekatan praktis adalah memulai dengan persentase kecil lalu lintas produksi pada K3.1 Pro.
Pertahankan K3 sebagai fallback selama validasi. Bandingkan kualitas tugas, latensi, tingkat kegagalan, dan pengeluaran sebelum meningkatkan penggunaan K3.1 Pro.
Perhatikan khusus skema pemanggilan alat, field pesan terkait penalaran, input multimodal, dan parsing output. Kompatibilitas API tidak otomatis menjamin perilaku aplikasi yang identik.
Kenaikan dan Regresi Benchmark
Jika kedua model menjawab 43 pertanyaan yang sama dan mencetak 35 dan 42, K3.1 Pro mungkin telah mengoreksi tujuh kegagalan K3 tanpa regresi, atau delapan kegagalan sambil kehilangan satu jawaban yang sebelumnya benar. Skor total saja tidak dapat membedakan hasil ini.
Inspeksi jawaban berpasangan dan klasifikasikan sebagai keduanya benar, hanya K3 yang benar, hanya K3.1 Pro yang benar, atau keduanya salah. Tinjau keberhasilan khusus K3 terhadap tugas dampak tertinggi Anda sebelum bermigrasi. Hasil 42/43 menggambarkan set uji tersebut; itu tidak menjamin tingkat keberhasilan 97.7% pada beban kerja lain.
Evaluasi Buta atas Output Model
Sembunyikan label model dan acak urutan di mana peninjau melihat output. Definisikan rubrik penerimaan sebelum meninjaunya: untuk kode, gunakan uji yang dapat dieksekusi dan pemeriksaan regresi; untuk riset, periksa dukungan sumber, perhitungan, dan apakah deliverable yang diminta lengkap. Skorkan kebenaran sebelum mempertimbangkan presentasi atau gaya penulisan.
Ungkap identitas model, latensi, dan biaya yang ditagihkan hanya setelah penilaian kualitas dicatat. Ini memisahkan kualitas output dari ekspektasi tentang model yang lebih baru. Selesaikan perbedaan peninjau terhadap uji atau sumber yang sama, dan pertahankan keputusan agar model atau perubahan prompt berikutnya dapat dievaluasi secara konsisten.
Di Mana Anda Bisa Mengakses Kimi K3.1 Pro dan Kimi K3?
Akses Penyedia Resmi
Gunakan API Kimi K3 atau API Kimi K3.1 Pro yang didokumentasikan Moonshot untuk integrasi langsung dengan penyedia. Periksa pengenal model endpoint yang dipilih, field permintaan yang didukung, dan batas akun. Akses API publik dan bobot model yang dapat diunduh adalah opsi penerapan yang terpisah.
Akses melalui CometAPI
Pengembang dapat mengakses API Kimi K3.1 Pro dan API Kimi K3 melalui antarmuka terpadu CometAPI dan membandingkan kedua rute dengan beban kerja aplikasi yang sama.
Ini membuat migrasi K3 ke K3.1 Pro relatif mudah, terutama untuk aplikasi yang sudah menggunakan antarmuka chat yang kompatibel dengan OpenAI.
Untuk menggunakan CometAPI, buat akun dan kunci API, lalu konfigurasikan aplikasi Anda dengan endpoint dan pengenal model dalam dokumentasi integrasi. Pilih kimi-k3 untuk K3, kimi-k3.1-pro untuk K3.1 Pro standar, atau kimi-k3.1-pro-highspeed untuk rute Highspeed jika didukung. Mulailah dengan permintaan kecil, kemudian bandingkan beban kerja yang sama di seluruh model sambil memeriksa hasil yang dikembalikan, latensi, dan penggunaan yang ditagihkan.
Kesimpulan
Kimi K3.1 Pro adalah kandidat yang lebih kuat untuk pengodean otonom yang menuntut, riset keuangan, dan alur kerja agen yang diperluas dalam evaluasi yang ditinjau di sini. Kimi K3 tetap relevan untuk self-hosting segera dan beban kerja di mana profil akurasi atau latensi yang ada sudah memenuhi kebutuhan.
Pilih menggunakan tugas representatif dan rute penyedia yang sebenarnya. Bandingkan hasil yang berhasil, latensi, dan total pengeluaran, lalu migrasikan secara bertahap. Harga token yang lebih rendah dan skor benchmark agregat yang lebih tinggi adalah titik awal yang berguna, tetapi tidak menetapkan konfigurasi terbaik untuk setiap aplikasi.