
TL;DR
MiniMax M3.1 Flash adalah model AI berkecepatan tinggi yang dirancang untuk agen otonom, rekayasa perangkat lunak, penggunaan komputer, dan otomasi alur kerja yang kompleks. Resmi dirilis pada 19 Oktober 2026, model ini menggabungkan jendela konteks 1 juta token dengan kedalaman penalaran yang dapat dikonfigurasi dan biaya inferensi yang lebih rendah.
MiniMax melaporkan hingga 200+ token keluaran per detik, pengurangan biaya beban kerja agen sebesar 70% dibanding pendahulunya, dan kinerja kompetitif di Automation-Bench, DeepSWE, dan OSWorld. Dengan $0,15 per juta token input dan $0,60 per juta token output, model ini membuat alur kerja agen AI multi-langkah lebih ekonomis.
Key Takeaways
- Kinerja MiniMax M3.1 Flash: Benchmark yang dilaporkan vendor mencakup Automation-Bench 62,8, DeepSWE v1.1 73,7, dan OSWorld 2,0 61,7, menyoroti kapabilitasnya dalam otomasi agen, coding, dan penggunaan komputer.
- Harga API MiniMax M3.1 Flash: Tarif resmi adalah $0,15/M input, $0,60/M output, dan $0,015/M input cache. Tarif CometAPI adalah $0,80/M input dan $3,20/M output per 21 Oktober 2026, tanpa tarif cache yang dipublikasikan di halaman modelnya.
- Kecepatan inferensi MiniMax M3.1 Flash: MiniMax melaporkan 200+ token/dtk dalam kondisi menguntungkan dan throughput P50 di atas 170 token/dtk, mendukung alur kerja agen yang responsif.
- Efisiensi agen MiniMax M3.1 Flash: Lima tingkat upaya penalaran memungkinkan pengembang menyeimbangkan penyelesaian tugas, latensi, dan biaya agen AI keseluruhan.
- Akses API MiniMax M3.1 Flash: Pengembang dapat mengakses model yang dirilis melalui MiniMax atau mengeksplorasi integrasi CometAPI menggunakan pengenal model dan harga spesifik penyedia.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash adalah model bahasa generasi berikutnya yang dioptimalkan untuk penalaran agen, coding, penggunaan alat (tool), dan eksekusi alur kerja otonom. MiniMax secara resmi memperkenalkan M3.1 Flash pada 19 Oktober 2026.
Alih-alih berfokus secara eksklusif pada kecerdasan percakapan atau skor terisolasi, model ini menargetkan total biaya penyelesaian tugas melalui penalaran berulang, pemanggilan alat, dan eksekusi multi-langkah. MiniMax juga mengaitkan pengembangan awalnya dengan Space Bunny, model yang dideploy secara anonim yang disebut memproses lebih dari 200 triliun token sebelum pengumuman; ini adalah angka penggunaan yang dilaporkan, bukan jumlah token pelatihan yang dipublikasikan.
Bagi pengembang yang membangun asisten coding otonom, rekan kerja AI enterprise, dan agen berbasis peramban, M3.1 Flash menawarkan tiga keunggulan relevan: kapasitas konteks yang luas, generasi cepat, dan penggunaan token yang murah.
What Are MiniMax M3.1 Flash’s Specifications?
| API specifications | MiniMax M3.1 Flash |
|---|---|
| Developer | MiniMax |
| Official release | October 19, 2026 |
| Model family | MiniMax M3 |
| Context window | 1,000,000 tokens |
| Primary capabilities | Otomasi agen, coding, penalaran, penggunaan komputer |
| Input modalities | Teks, gambar, dan video melalui API kompatibel OpenAI milik MiniMax; konfirmasi dukungan di penyedia lain |
| Output modality | Teks |
| Reasoning controls | Low, medium, high, xhigh, max |
| Reported output speed | Hingga 200+ tokens/s |
| Reported P50 speed | 170+ tokens/s |
| Access channels | MiniMax API, M Plan, MiniMax Code |
| Open weights | Diumumkan untuk rilis di masa mendatang |
| M3.1-specific parameter count | Tidak ditetapkan dalam pengumuman |
Jendela konteks besar bermanfaat untuk coding skala repositori dan alur kerja dengan banyak dokumen, namun tidak menjamin kemampuan recall yang sempurna. Agen produksi tetap harus menggunakan pengambilan selektif, respons alat terstruktur, dan kompresi konteks.
Lima pengaturan upaya penalaran memungkinkan pengembang mengalokasikan komputasi intensif untuk perencanaan dan debugging yang kompleks alih-alih menghabiskan upaya maksimum pada setiap langkah klasifikasi, ekstraksi, atau pemilihan alat sederhana. Karena satu permintaan agen dapat memicu puluhan pemanggilan model, penghematan kecil pada langkah rutin dapat secara material menurunkan total biaya.
How Does MiniMax M3.1 Flash Perform on Benchmarks?
MiniMax melaporkan hasil benchmark yang mencakup otomasi bisnis, rekayasa perangkat lunak, penggunaan komputer, keamanan siber, dan penalaran multimodal. Ini adalah evaluasi yang dilaporkan vendor, bukan pengganti pengujian independen pada penerapan nyata.
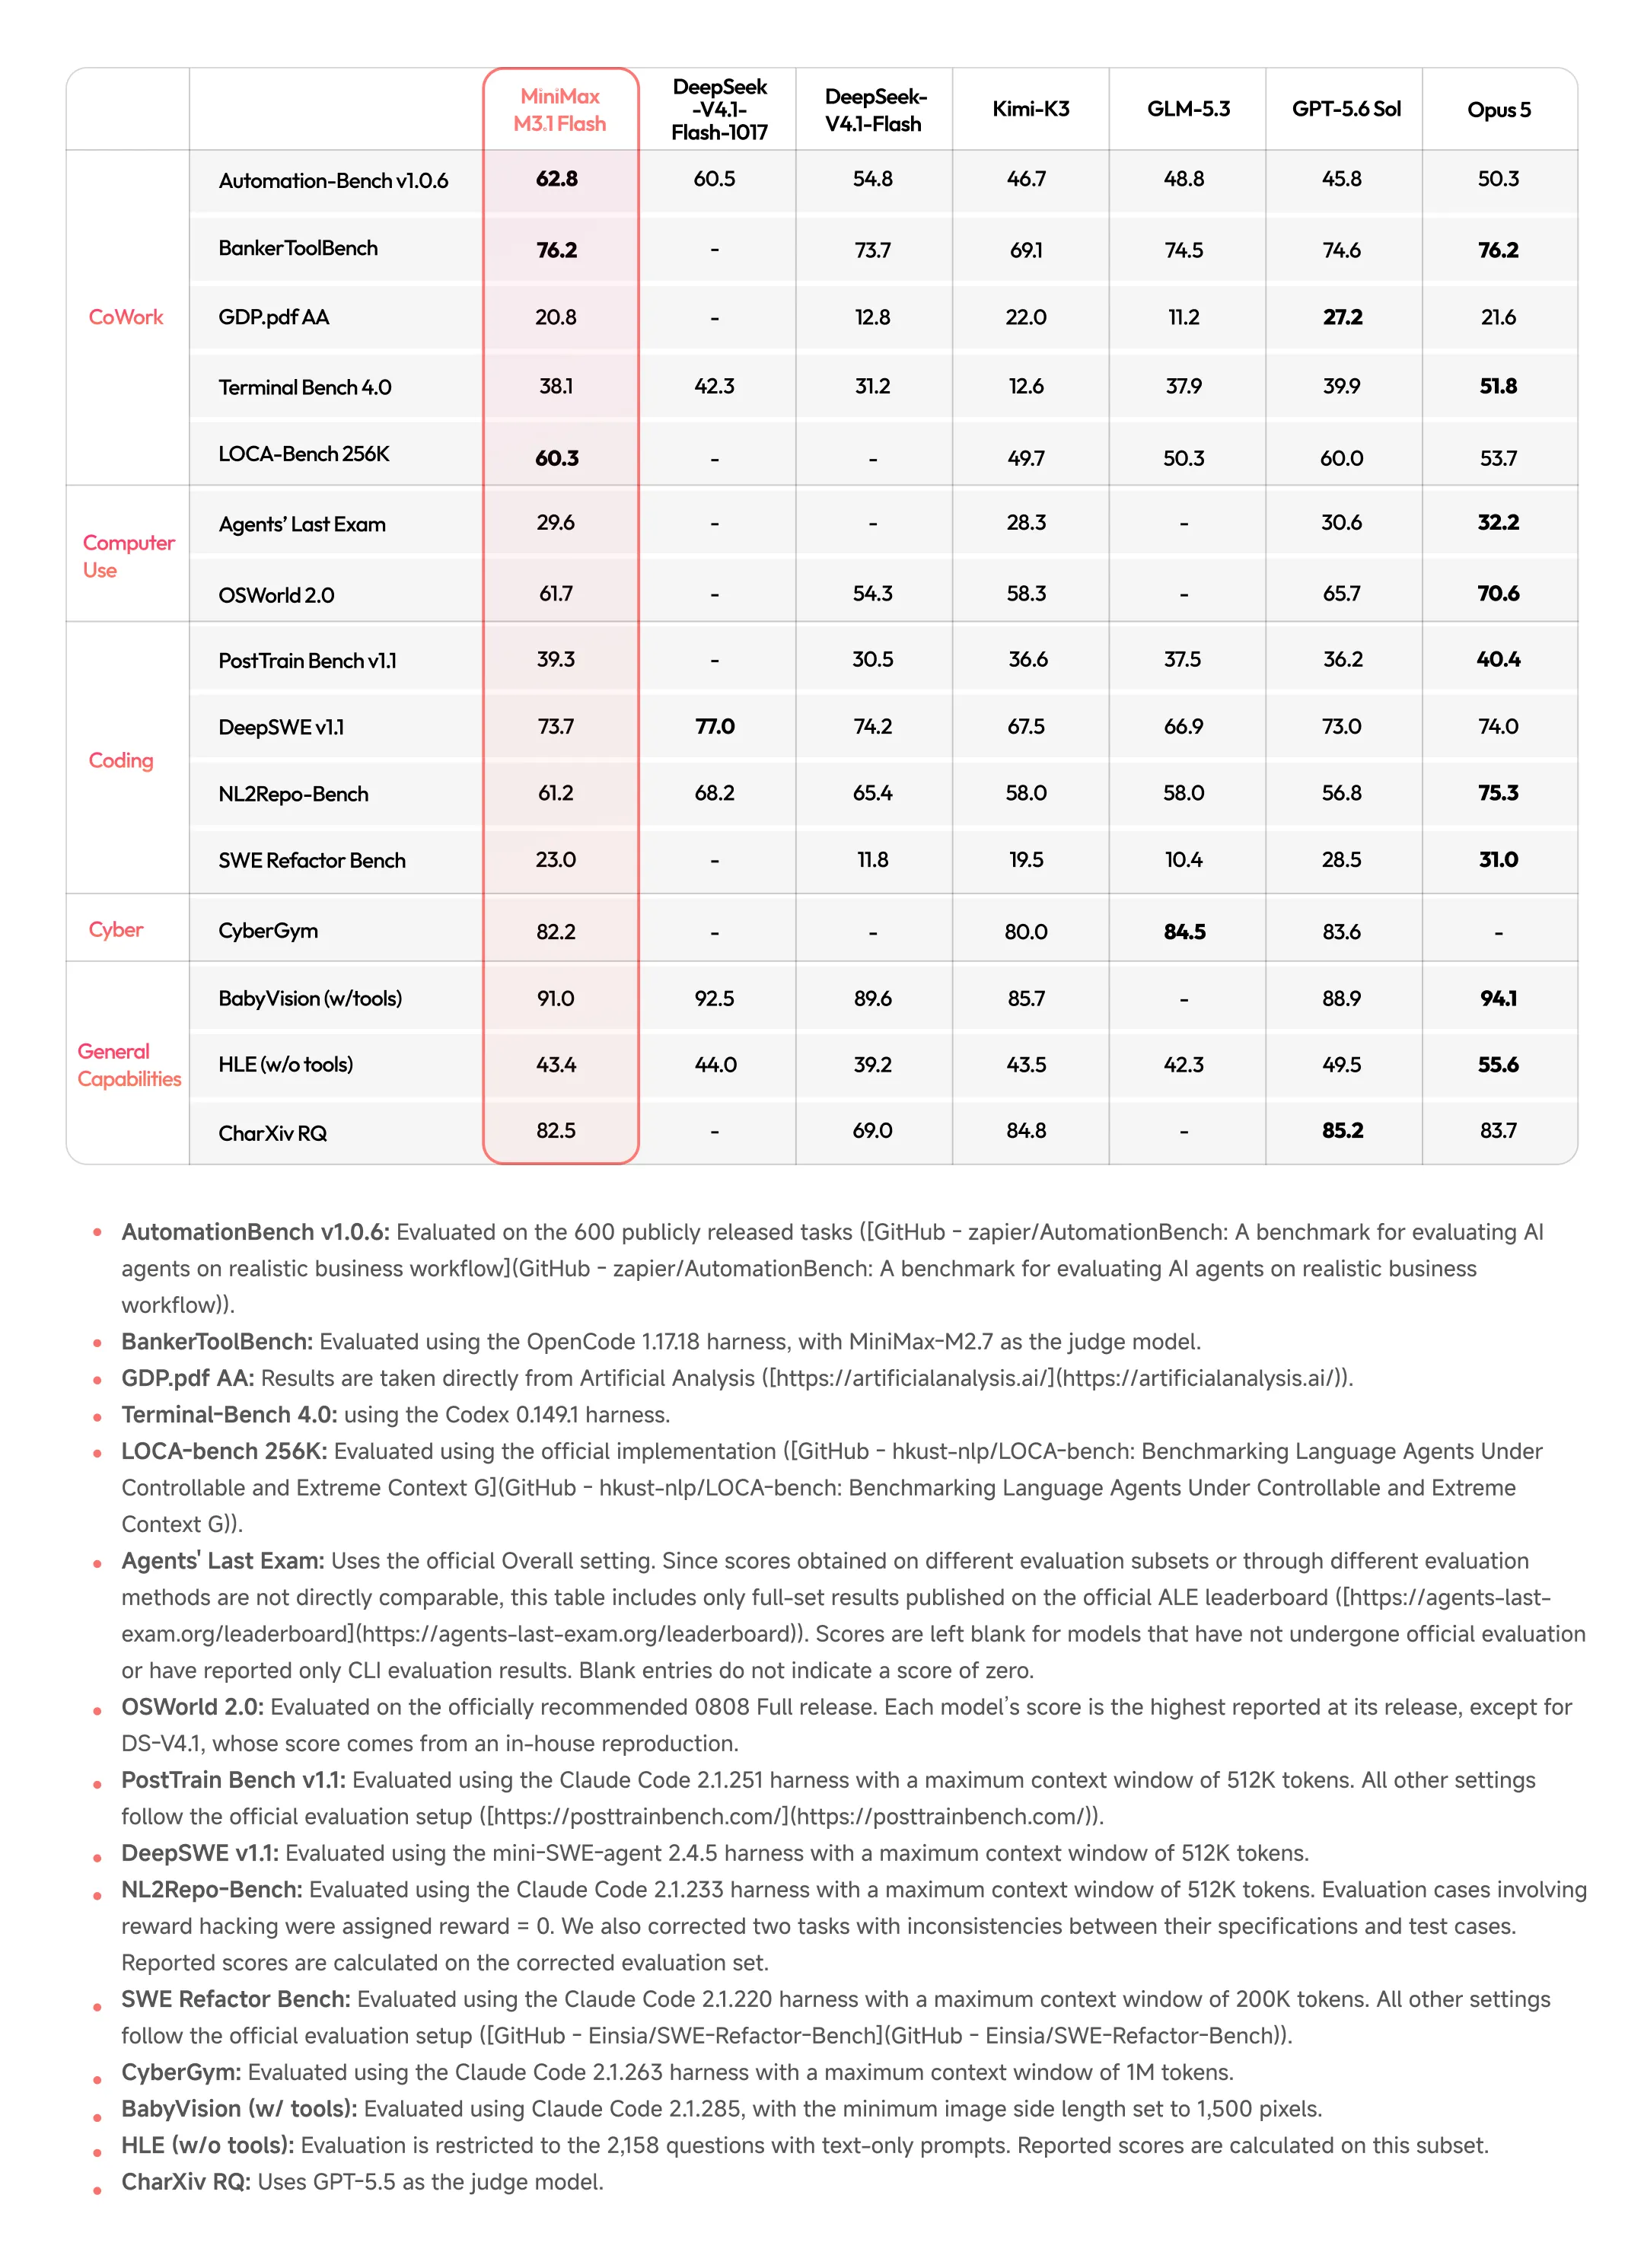
Perbandingan benchmark resmi MiniMax, termasuk catatan evaluasi. Skor dilaporkan vendor dan tidak merepresentasikan uji independen yang seragam.
| Official benchmark results | M3.1 Flash | What it measures |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | Otomasi bisnis multi-langkah |
| BankerToolBench | 76.2 | Penalaran finansial dan alat |
| LOCA-Bench 256K | 60.3 | Eksekusi agen konteks panjang |
| DeepSWE v1.1 | 73.7 | Rekayasa perangkat lunak otonom |
| Terminal Bench 4.0 | 38.1 | Pemecahan masalah berbasis terminal |
| OSWorld 2.0 | 61.7 | Interaksi desktop/komputer |
| Agents’ Last Exam | 29.6 | Tugas ekonomi kompleks |
| CyberGym | 82.2 | Pemecahan masalah keamanan siber |
| BabyVision with tools | 91.0 | Penalaran visual dengan alat |
| HLE without tools | 43.4 | Pengetahuan dan penalaran menantang |
Automation-Bench v1.0.6 menggunakan 600 tugas publik. BankerToolBench menggunakan OpenCode 1.17.18 dengan MiniMax-M2.7 sebagai juri; Terminal Bench 4.0 menggunakan Codex 0.149.1. DeepSWE v1.1 menggunakan mini-SWE-agent 2.4.5 dengan batas konteks 512K. OSWorld menggunakan rilis 0808 Full: tabel menggabungkan skor rilis tertinggi setiap model, kecuali DeepSeek V4.1, yang direproduksi secara internal oleh MiniMax. Perbedaan setup ini membatasi kesimpulan lintas model secara langsung.
Untuk otomasi bisnis, prioritaskan Automation-Bench dan BankerToolBench; untuk agen coding, periksa DeepSWE dan hasil berbasis terminal. OSWorld mengevaluasi interaksi dengan lingkungan komputer, bukan sekadar menghasilkan instruksi. Satu skor agregat tidak dapat menggantikan analisis spesifik tugas.
How Fast Is MiniMax M3.1 Flash?
Sistem agen sering melakukan banyak panggilan model berurutan, sehingga throughput saja tidak dapat menggambarkan responsivitas.
| Speed metric | Reported performance |
|---|---|
| Everyday peak output throughput | 200+ tokens/s |
| Median output throughput (P50) | 170+ tokens/s |
| Online inference improvement | Hampir 3× vs generasi sebelumnya |
| Agent workload cost reduction | 70% vs pendahulunya |
Angka kecepatan dan biaya beban kerja yang dilaporkan vendor ini menggambarkan evaluasi peluncuran MiniMax, bukan throughput atau penghematan yang dijamin untuk setiap aplikasi. Perangkat keras penyajian, konkurensi, panjang prompt, dan variabilitas pengulangan tidak sepenuhnya ditentukan dalam pengumuman.
Latensi end-to-end juga mencakup keterlambatan token pertama, overhead penalaran, waktu alat, percobaan ulang, dan dependensi antar langkah. Generator yang lebih cepat bisa kehilangan keunggulannya jika agen membutuhkan lebih banyak panggilan untuk menyelesaikan tugas yang sama.
How Much Does MiniMax M3.1 Flash API Cost?
MiniMax mengumumkan tarif standar flat untuk M3.1 Flash tanpa tier konteks panjang terpisah dalam deskripsi harga awalnya. Sementara itu, MiniMax M3.1 Flash Preview API di CometAPI menawarkan struktur harga terpisah dengan diskon 20% terhadap tarif referensi yang ditampilkan.
| Pricing category | Official M3.1 Flash | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Input tokens / 1M | $0.15 | $0.24 | $0.48 |
| Output tokens / 1M | $0.60 | $0.96 | $1.92 |
| Cached input / 1M | $0.02 | $0.05 | $0.10 |
| Pricing structure | Flat rate | Short-context tier | Long-context tier |
Harga resmi API MiniMax membuat M3.1 Flash sangat menarik untuk beban kerja agen. Token output berharga empat kali tarif input standar, sementara input cache berharga sepersepuluhnya. Instruksi berulang dan riwayat tool karenanya dapat menjadi target optimasi utama.
Harga Preview CometAPI dimulai dari $0,24 per juta token input dan $0,96 per juta token output, merepresentasikan diskon 20% dibanding harga referensi Preview yang ditampilkan. Namun, tarif ini tetap lebih tinggi daripada harga resmi M3.1 Flash yang baru diumumkan karena kedua penawaran menggunakan baseline harga yang berbeda.
Bagi pengembang, perbedaan kunci adalah CometAPI menyediakan pengalaman integrasi terpadu, sementara rilis resmi saat ini menawarkan tarif token terpublikasi yang lebih rendah. Sebelum penerapan, verifikasi versi model aktif, tier panjang konteks, dan aturan penagihan untuk memperkirakan biaya alur kerja agen otonom secara akurat.
MiniMax M3.1 Flash Cost per Agent Task
Perkiraan biaya inferensi = (uncached input tokens × input rate + cached input tokens × cache rate + output tokens × output rate) / 1,000,000.
| Illustrative workload | Uncached input | Cached input | Output | Est. cost |
|---|---|---|---|---|
| Simple tool assistant | 10K | 0 | 2K | $0.0027 |
| Pull request review | 40K | 20K | 8K | $0.0111 |
| Multi-step coding agent | 100K | 200K | 30K | $0.0360 |
| Enterprise research | 300K | 700K | 80K | $0.1035 |
| Large autonomous workflow | 1M | 3M | 200K | $0.3150 |
Perhitungan ilustratif, bukan penagihan yang diamati. Mengasumsikan pembacaan cache memenuhi syarat untuk tarif cache yang diumumkan; tidak termasuk biaya alat, pencarian, peramban, infrastruktur, dan tinjauan manusia.
Reasoning Effort and Task Cost
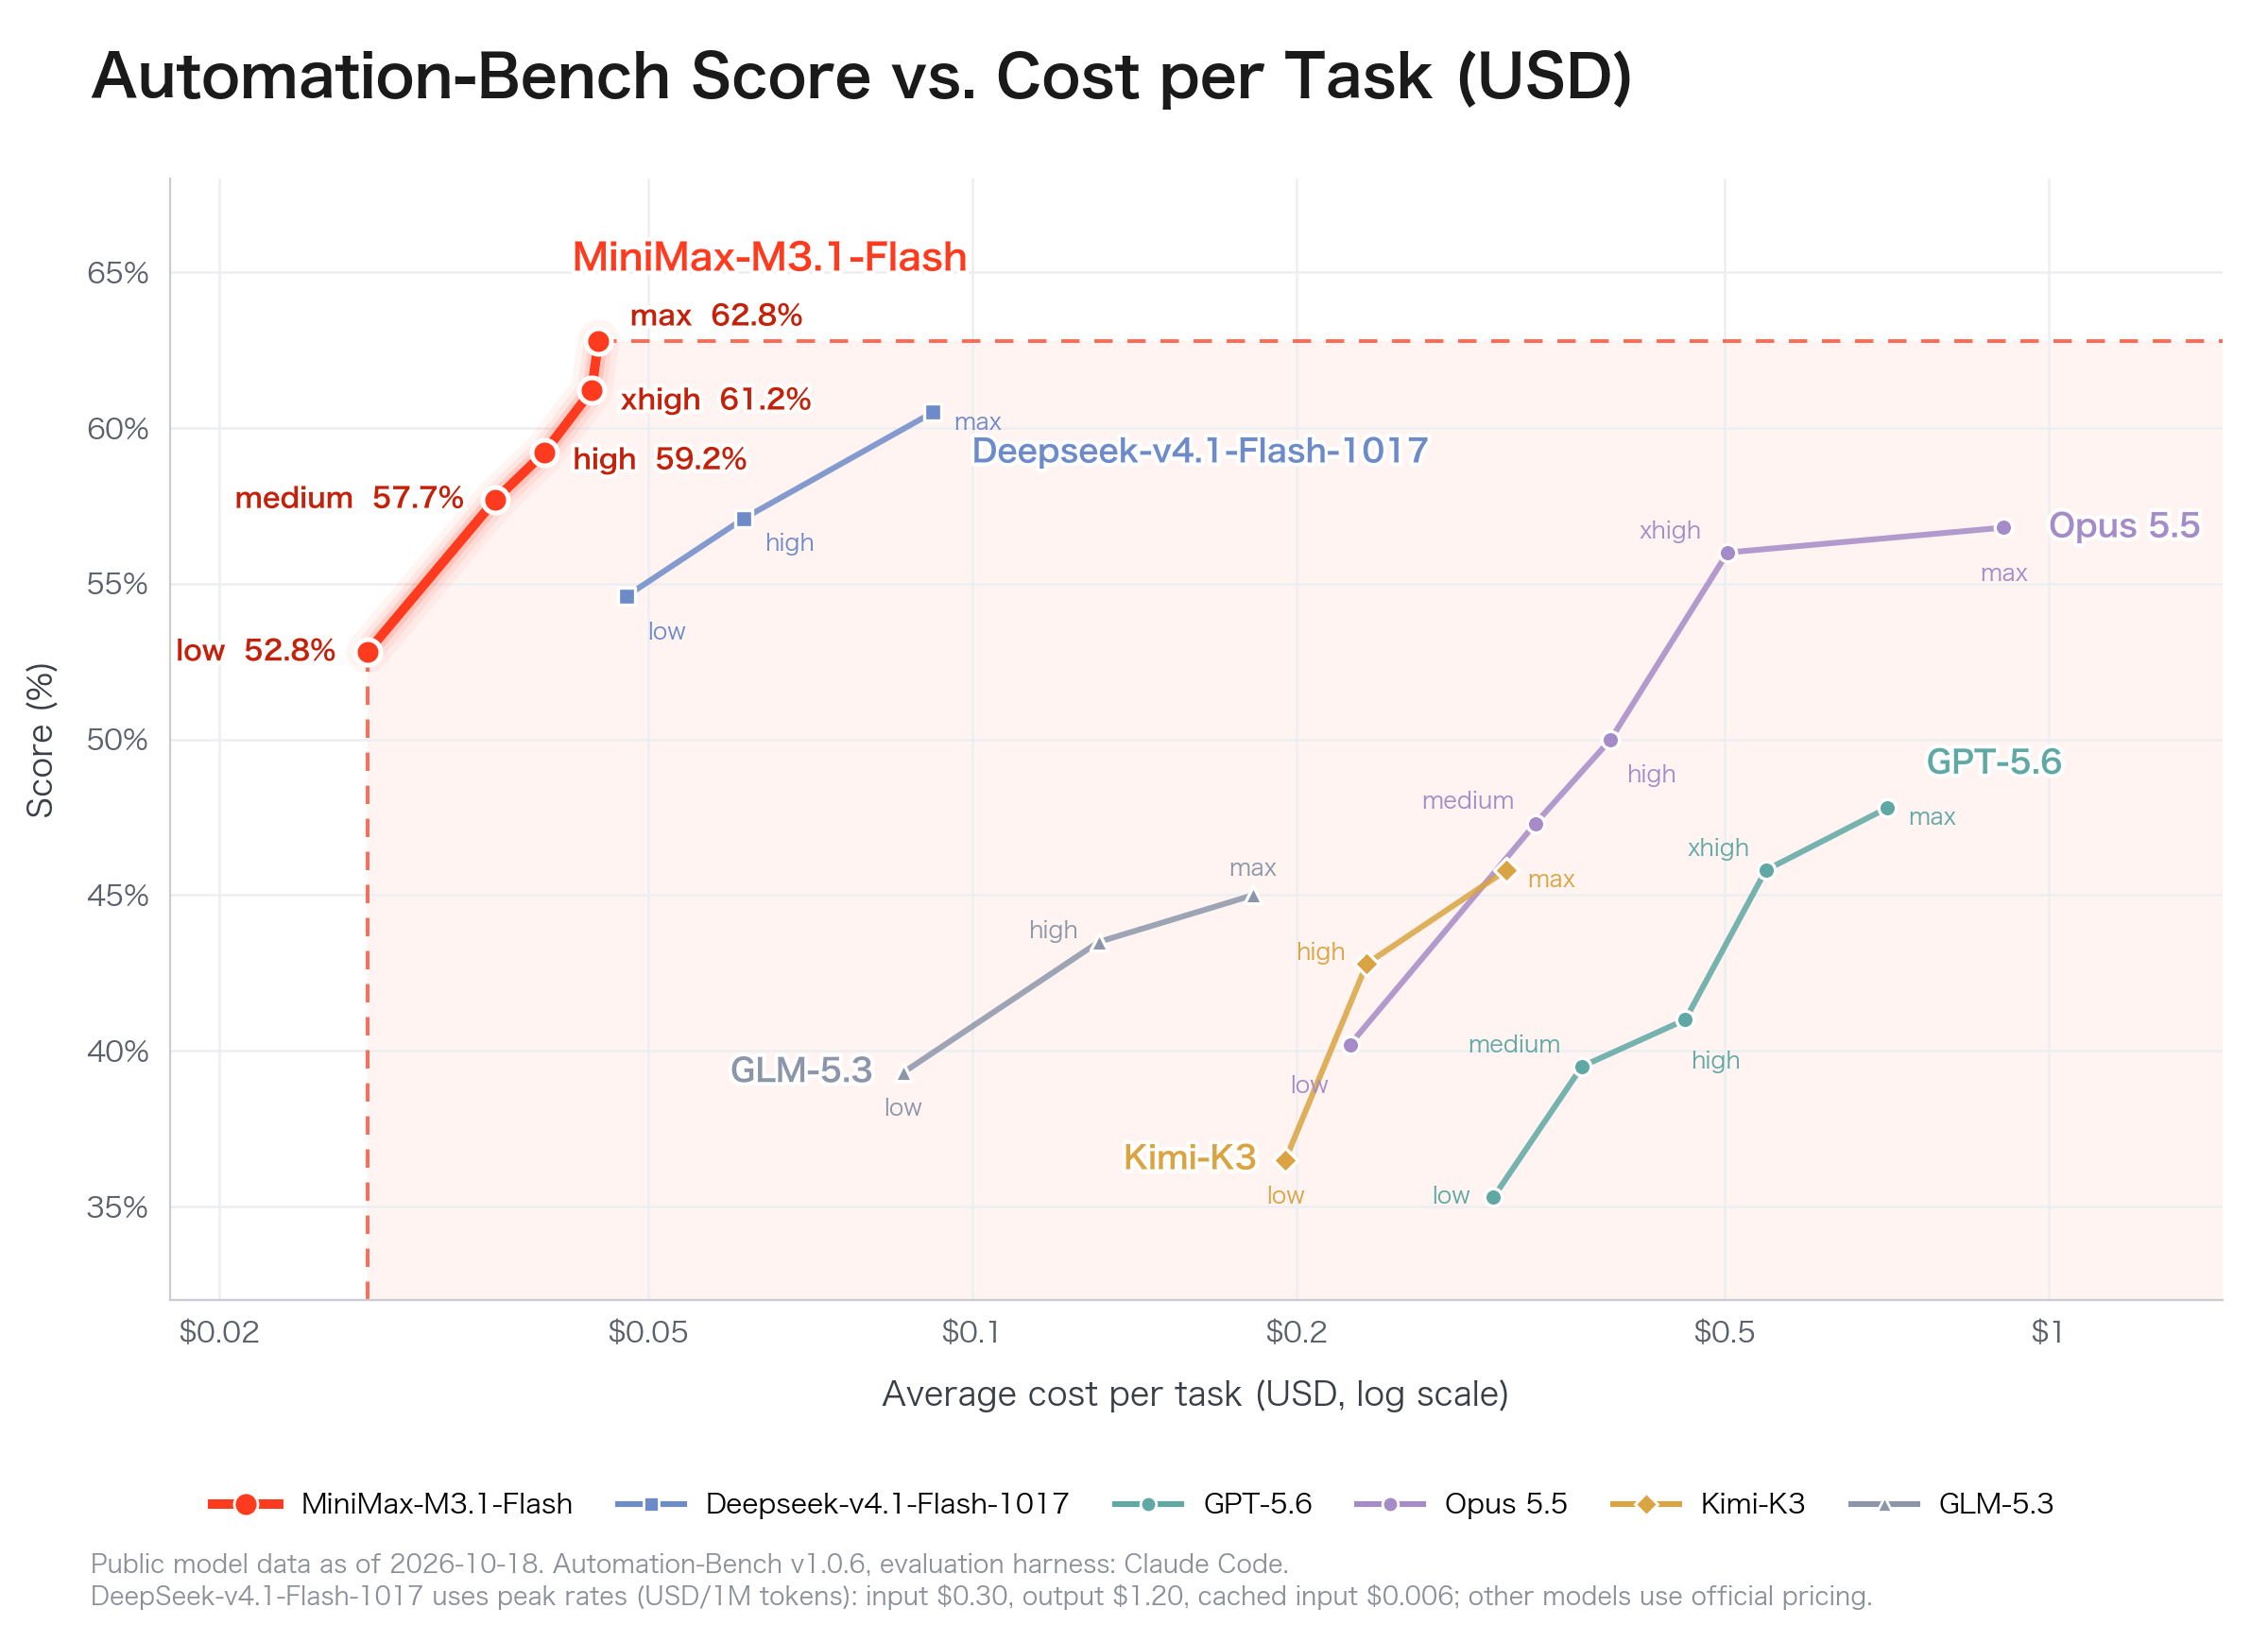
Analisis biaya Automation-Bench MiniMax menghubungkan upaya penalaran dengan keberhasilan benchmark dan pengeluaran inferensi per tugas.
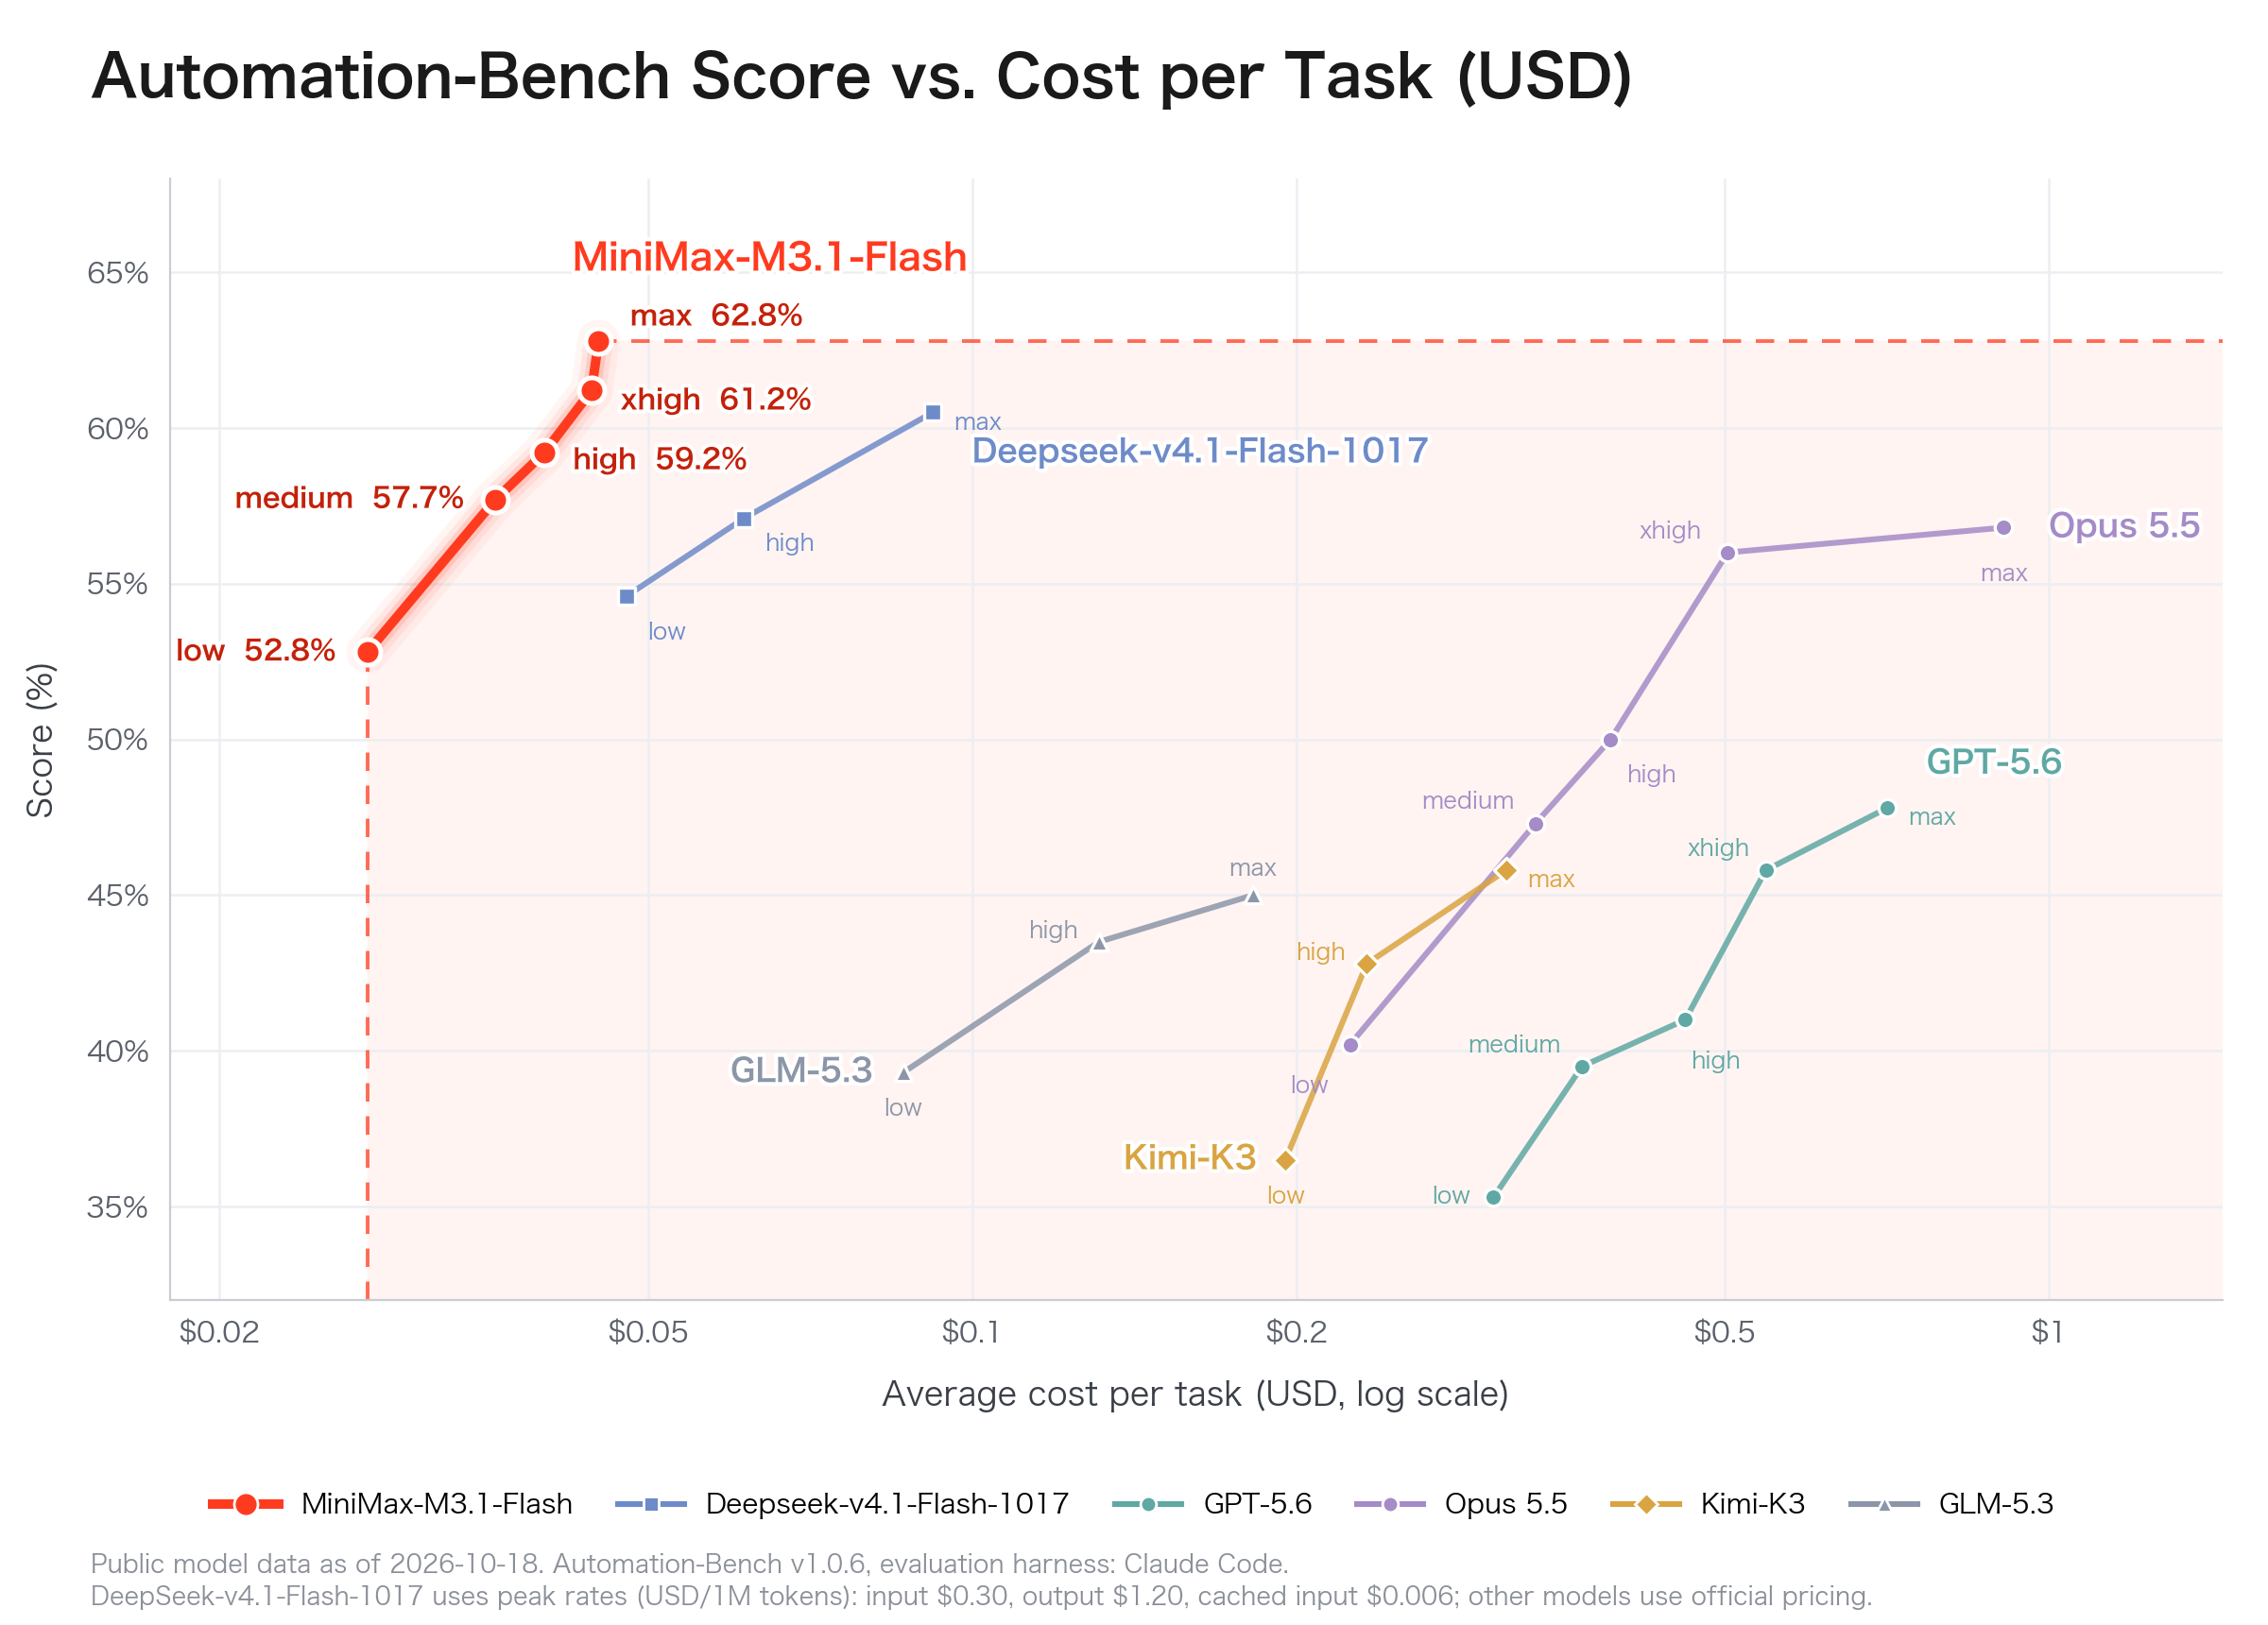
Bagan resmi skor vs biaya Automation-Bench MiniMax. Sumbu horizontal berskala logaritmik; biaya dolar tepat tidak dicetak untuk titik MiniMax individual.
Catatan evaluasi bagan resmi menetapkan Automation-Bench v1.0.6 dengan harness Claude Code dan data model publik per 18 Oktober 2026. DeepSeek menggunakan tarif token puncak; model lain menggunakan harga resmi. Detail perangkat keras dan interval kepercayaan pengulangan tidak ditentukan.
| Reasoning effort | Labeled Automation-Bench score |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
Tabel perbandingan resmi saat ini dan titik upaya maksimum keduanya menunjukkan 62,8. Kurva biaya membandingkan pengaturan upaya dalam setup vendor; ini tidak menetapkan biaya dolar tetap untuk agen produksi.
Skor berlabel naik 10 poin persentase dari upaya rendah ke maksimum. Untuk penerapan, bandingkan upaya medium dan lebih tinggi pada himpunan tugas tetap, hitung upaya gagal dan percobaan ulang dalam total pengeluaran. Pilih pengaturan yang memenuhi target kualitas dengan biaya terendah per tugas yang diterima.
How Can Developers Access MiniMax M3.1 Flash Through CometAPI?
Pengembang dapat mengakses MiniMax M3.1 Flash API di CometAPI. Katalog publik yang diperiksa pada 20 Oktober 2026 menampilkan model ID minimax-m3.1-flash meskipun URL-nya mempertahankan sufiks preview. Gunakan model ID yang tersedia untuk akun Anda, alih-alih menurunkan pengenal API dari URL halaman.
Kirim permintaan POST ke https://api.cometapi.com/v1/chat/completions dengan Authorization: Bearer YOUR_COMETAPI_KEY dan Content-Type: application/json. Dalam body JSON, set model ke minimax-m3.1-flash (jika diaktifkan untuk akun Anda) dan sediakan array messages. Lihat dokumentasi CometAPI untuk detail permintaan.
Mengapa menggunakan CometAPI? Kunci API terpadu, format permintaan kompatibel, dan dasbor penggunaan dapat menyederhanakan kerja lintas penyedia model. Untuk MiniMax M3.1 Flash, pertimbangkan kemudahan integrasi tersebut terhadap harga spesifik penyedia di atas dan verifikasi fitur yang tersedia untuk akun Anda.
Which AI Agents Benefit Most From MiniMax M3.1 Flash?
| Use case | Why it may fit | Deployment consideration |
|---|---|---|
| Enterprise automation | Hasil Automation-Bench kuat | Validasi tool dan percobaan ulang |
| Coding assistants | Performa DeepSWE kompetitif | Jalankan tes dan tinjau patch |
| Customer support | Harga input dan cache rendah | Pantau akurasi |
| Research agents | Jendela konteks 1M | Periksa bukti dan sumber |
| Computer-use agents | Kapabilitas OSWorld | Tangani perubahan UI dan pemulihan |
| Security code review | Hasil CyberGym | Verifikasi independen |
Manfaat paling kuat ketika agen menyelesaikan cukup banyak tugas dengan benar untuk mengimbangi biaya percobaan ulang, orkestrasi, dan tinjauan. Penggunaan produksi harus mengukur kinerja di tingkat model dan alur kerja.
Is MiniMax M3.1 Flash the Best Value for AI Agents?
MiniMax M3.1 Flash adalah opsi kuat untuk agen sensitif biaya yang melibatkan konteks berulang dan alat terstruktur, tetapi harga token terendah tidak selalu menghasilkan biaya terendah per tugas yang berhasil. Panggilan yang gagal, percobaan ulang tambahan, dan intervensi manusia dapat menghapus penghematan. Evaluasi tingkat penyelesaian yang diterima, waktu end-to-end, total biaya per tugas yang berhasil, dan tingkat intervensi manusia.
FAQ
Why can MiniMax M3.1 Flash return an empty answer?
Pada API kompatibel OpenAI native MiniMax, thinking tokens mengonsumsi anggaran generasi. Batas yang terlalu kecil dapat mengakhiri permintaan dengan finish_reason disetel ke length sebelum teks jawaban terlihat diproduksi. Periksa alasan penyelesaian dan penggunaan token, tingkatkan anggaran completion bila sesuai, dan tangani reasoning_content secara terpisah dari jawaban akhir. Konfirmasikan semantik respons yang sama pada rute pihak ketiga.
How should MiniMax M3.1 Flash tool-call history be stored?
Simpan pesan asisten lengkap, termasuk pemanggilan alat dan reasoning content, sebelum menambahkan hasil alat yang cocok. Menyimpan hanya jawaban yang terlihat dapat menghapus informasi yang diperlukan untuk langkah berikutnya. Pertahankan ID pemanggilan alat dan urutan pesan, serta validasi perilaku replay menggunakan endpoint penyedia aktual. Panduan riwayat percakapan MiniMax menggambarkan persyaratan API native.
How can teams detect MiniMax M3.1 Flash routing changes?
Simpan suite regresi kecil dengan input tetap, struktur output yang diharapkan, dan asersi pemanggilan alat. Catat model ID yang diminta, pengenal model yang dikembalikan bila ada, penyedia, timestamp, dan penggunaan yang ditagihkan. Jalankan ulang setelah pembaruan penyedia; alias yang stabil saja tidak menunjukkan bahwa checkpoint atau perilaku yang mendasarinya tidak berubah.
How should a MiniMax M3.1 Flash migration be staged?
Mulailah dengan tugas baca-saja atau replay, lalu rute sebagian kecil lalu lintas live sambil mempertahankan fallback yang telah diuji. Tetapkan ambang rollback untuk pemanggilan alat tidak valid, timeout, dan tugas yang tidak berhasil sebelum meningkatkan lalu lintas. Tinjau contoh regresi alih-alih hanya mengandalkan skor rata-rata, karena sejumlah kecil kegagalan mahal dapat mengimbangi harga token yang lebih rendah.
Conclusion
MiniMax M3.1 Flash meningkatkan ekonomi agen AI otonom melalui token murah, penalaran yang dapat dikonfigurasi, jendela konteks besar, dan hasil otomasi serta coding yang kuat (dilaporkan). Keunggulan utamanya adalah keseimbangan antara kinerja, latensi, dan biaya tugas—bukan superioritas absolut di setiap benchmark.
Pengembang harus memvalidasi tingkat penyelesaian alur kerja nyata dan total biaya agen, lalu memilih rute MiniMax M3.1 Flash yang konfigurasi aktif, fitur yang didukung, dan penagihannya sesuai dengan kebutuhan mereka.