Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
GLM-6.0: Cosa ci dice davvero la roadmap dell'auto-addestramento completo di Z.AI
Quanto Z.AI ha reso noto su GLM 6.0, Full Self-Training, i loop di addestramento ricorsivi, gli attuali benchmark di GLM e le informazioni ancora mancanti prima del rilascio.
Z.AI ha pubblicamente nominato GLM-6.0 e ha posto il Full Self-Training al centro della roadmap di nuova generazione. La direzione divulgata collega l’esperienza auto-generata tra pre-addestramento, addestramento intermedio e post-addestramento con autovalutazione e correzione, trasformando l’addestramento in un ciclo di feedback controllato invece che in un singolo passaggio di generazione dati.
La parte difficile è il controllo: GLM-6.0 dovrebbe ripulire i dati sintetici, rilevare e riparare gli errori, interrompere iterazioni improduttive e impedire al proprio valutatore di premiare scorciatoie. Questi meccanismi sollevano questioni pratiche su verifica indipendente, sicurezza, costi e governance. Poiché non sono pubbliche una model card completa, una suite di benchmark, specifiche API, prezzo o data di rilascio, l’articolo valuta l’architettura di addestramento e le sue evidenze — non specifiche speculative.
Key Takeaways per GLM 6.0?
Le evidenze pubbliche più forti riguardano il sistema di Full Self-Training, non un conteggio di parametri trapelato o un risultato di benchmark.
La direzione divulgata copre dati auto-prodotti, ambienti di addestramento auto-costruiti e ottimizzazione dell’infrastruttura assistita dal modello.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Il ciclo di feedback previsto si estende da pre-addestramento, addestramento intermedio, fino al post-addestramento, invece di trattare l’autoformazione come una tecnica solo di post-addestramento.
Modellazione multimodale nativa, apprendimento per rinforzo su orizzonti più lunghi, pianificazione, uso di strumenti, recupero e verifica sono direzioni di ricerca rilevanti, ma non sono ancora specifiche pubblicate di GLM 6.0.
Ox Alpha non è evidenza di prestazioni trapelate di GLM 6.0; Z.AI lo ha identificato come l’identità pre-release di GLM-5.3-Flash.
Cosa ha effettivamente confermato Z.AI su GLM 6.0?
I materiali pubblici di Z.AI stabiliscono quattro segnali concreti: il nome GLM-6.0, il Full Self-Training come direzione centrale di addestramento, un ciclo previsto tra pre-addestramento, addestramento intermedio e post-addestramento, e un meccanismo di autovalutazione e correzione. L’azienda afferma inoltre che circa il 60% dei proventi netti è destinato a supportare modelli di prossima generazione, Full Self-Training, addestramento su larga scala, inferenza, calcolo e infrastrutture correlate.
Il framework di Full Self-Training di Z.AI
Il Full Self-Training è presentato come l’idea organizzativa per GLM-6.0, non come una piccola funzione di post-addestramento. Il sistema previsto genererebbe esperienza di addestramento, apprendendo dagli esiti, filtrando i campioni deboli e ripetendo il ciclo sotto controlli di qualità espliciti.
Autoformazione GLM-6.0 attraverso pre-, medio- e post-addestramento
La sequenza divulgata — pre-addestramento, addestramento intermedio e post-addestramento — implica che l’esperienza auto-generata possa influenzare la conoscenza di base, il plasmare delle capacità e l’allineamento ai compiti, invece di comparire solo durante la fase finale di tuning. Z.AI non ha divulgato dataset, confini tra fasi o rapporti di miscelazione, quindi ciò va trattato come una direzione confermata, non come una ricetta completa.
Meccanismo di autovalutazione e correzione di GLM-6.0
La roadmap collega il Full Self-Training con autovalutazione, rilevamento degli errori, correzione e auto-purificazione dei dati. In termini pratici, il modello dovrebbe giudicare traiettorie, rivedere i passaggi falliti, scartare dati inaffidabili e decidere quando ulteriori iterazioni non migliorano più le prestazioni misurate indipendentemente. Il design del valutatore e le regole di arresto rimangono non divulgate.
Il record pubblico supporta una roadmap, ma non una specifica finita. La tabella separa la direzione confermata dalle questioni aperte, così che l’articolo non trasformi l’intento divulgato in un’affermazione di prodotto non supportata.
Affermazione
Stato delle evidenze
Cosa è supportato
Cosa resta sconosciuto
Nome GLM-6.0
Identificato pubblicamente
Z.AI ha nominato il modello di nuova generazione GLM-6.0.
Data di rilascio e posizionamento finale.
Full Self-Training
Roadmap confermata
È una priorità strategica dichiarata.
Dettagli di implementazione e comportamento di scalabilità.
L’autoformazione è destinata a coprire l’intero ciclo di addestramento.
Dataset, validatori, confini tra fasi e rapporti dei dati.
Autovalutazione e correzione
Obiettivo confermato
La roadmap include auto-purificazione, rilevamento errori e correzione.
Affidabilità, verifica indipendente e criteri di arresto.
Specifiche
Non divulgate
Nessuna specifica pubblica completa.
Parametri, finestra di contesto, modalità, prezzo e identificatore API.
Benchmark
Non divulgati
Nessun set di risultati ufficiale di GLM-6.0.
Punteggi, metodologia e risultati riproducibili indipendentemente.
Che cos’è il Full Self-Training e come funziona
Il Full Self-Training è un ciclo di apprendimento chiuso nel quale un modello aiuta a creare compiti o ambienti, li tenta, valuta le traiettorie risultanti, corregge i passaggi deboli e reinserisce l’esperienza accettata nell’addestramento. Il cambiamento importante è il passaggio da una pipeline una tantum di dati sintetici a un processo continuamente controllato.
Generate: costruire problemi, ambienti di strumenti e percorsi soluzione candidati.
Act: completare i compiti e preservare azioni, osservazioni e ragionamenti intermedi come traiettorie.
Evaluate and correct: valutare gli esiti con verificatori, rilevare errori, rivedere i passaggi falliti e respingere i campioni a bassa fiducia.
Train and stop: apprendere dall’esperienza accettata, quindi proseguire solo finché valutazioni indipendenti mostrano miglioramenti utili.
Estendere questo ciclo attraverso pre-addestramento, addestramento intermedio e post-addestramento consentirebbe a GLM-6.0 di migliorare qualità dei dati, plasmare delle capacità e allineamento ai compiti in fasi diverse. L’architettura dipende comunque da valutatori affidabili: senza controlli indipendenti, l’autoformazione può premiare i propri punti ciechi.
In che modo il Full Self-Training potrebbe cambiare GLM 6.0?
Il design divulgato è meglio inteso come un’architettura di sistema che come un singolo nuovo blocco Transformer. Tenta di chiudere il ciclo attorno al modello, così che il modello contribuisca sempre più a generare le risorse necessarie per il ciclo di addestramento successivo.
Come potrebbe GLM 6.0 produrre dati di addestramento?
Il primo ciclo è l’auto-produzione di dati. Invece di dipendere solo da dataset scritti da umani o raccolti esternamente, i modelli possono usare self-play, controlli basati su regole, risultati di esecuzione, giudizio del modello e verifiche a campione umane per generare e filtrare nuovi esempi. Gli esempi accettati confluiscono poi in pre-addestramento, addestramento intermedio e post-addestramento.
Il vincolo importante è la verifica: la generazione sintetica a basso costo è utile solo quando il sistema sa identificare esempi corretti, diversi e non degenerati. Un ciclo pratico è generazione del modello → esecuzione del compito → verifica tramite regole o strumenti → filtraggio → riaddestramento.
Come potrebbe GLM 6.0 costruire ambienti di addestramento?
Il secondo ciclo è l’auto-costruzione di ambienti. Gli agenti possono raccogliere o trasformare compiti reali, tentare tali compiti, creare validatori e verificare se il compito è effettivamente risolvibile prima che diventi materiale di addestramento. Ciò è particolarmente importante per coding e lavoro degli agenti, dove stato del terminale, output degli strumenti, stato del browser, risultati dei test e recupero dai fallimenti forniscono una supervisione più forte rispetto a sole risposte testuali.
L’obiettivo di valutazione si sposta da se una risposta suona plausibile a se un’azione ha successo, il risultato è verificabile indipendentemente e l’agente sa recuperare dopo un fallimento.
Come potrebbe GLM 6.0 ottimizzare la propria infrastruttura di addestramento?
Il terzo ciclo è l’auto-ottimizzazione dell’infrastruttura. In pratica, va interpretato come ingegneria dei sistemi assistita dall’IA: un solido modello di coding propone modifiche a operatori, kernel, scheduling, caching o codice di serving, mentre benchmark automatizzati e validazione sotto controllo umano determinano quali modifiche vengono accettate.
Il ciclo risultante è modello migliore → proposte di sistema migliori → guadagni di efficienza validati → più esperimenti di addestramento → modello migliore. La revisione umana e benchmark riproducibili restano punti di controllo, non optional.
Cosa ci dice l’attuale baseline GLM 5.3 Flash su GLM 6.0?
In sviluppo; nome di prodotto finale non stabilito indipendentemente dal documento citato
Parametri
320B totali / 18B attivi
Non divulgati
Architettura core
MoE; attenzione ibrida sparsa + lineare; mHC
Non divulgata a livello di blocco
Dati di addestramento
Corpus multimodale da 30T token
Dati auto-prodotti destinati a entrare in un loop ricorsivo
Multimodalità
Input multimodale nativo
Modellazione multimodale unificata è una direzione di ricerca, non una specifica pubblicata
Fasi di addestramento
Ricetta di addestramento a fasi pubblicata
Autoformazione su pre-, medio- e post-addestramento
Ambienti di addestramento
Ambienti disegnati e benchmarkati dai ricercatori
Gli agenti aiutano a costruire e validare gli ambienti
Verifica
Pipeline di valutazione e addestramento esistenti
Autogiudizio più forte, feedback di esecuzione e auto-verifica
Infrastruttura
Stack di inferenza ottimizzato
I modelli assistono nell’ottimizzazione dell’infrastruttura
Dettagli API
ID modello pubblicato e API attiva
Non divulgati
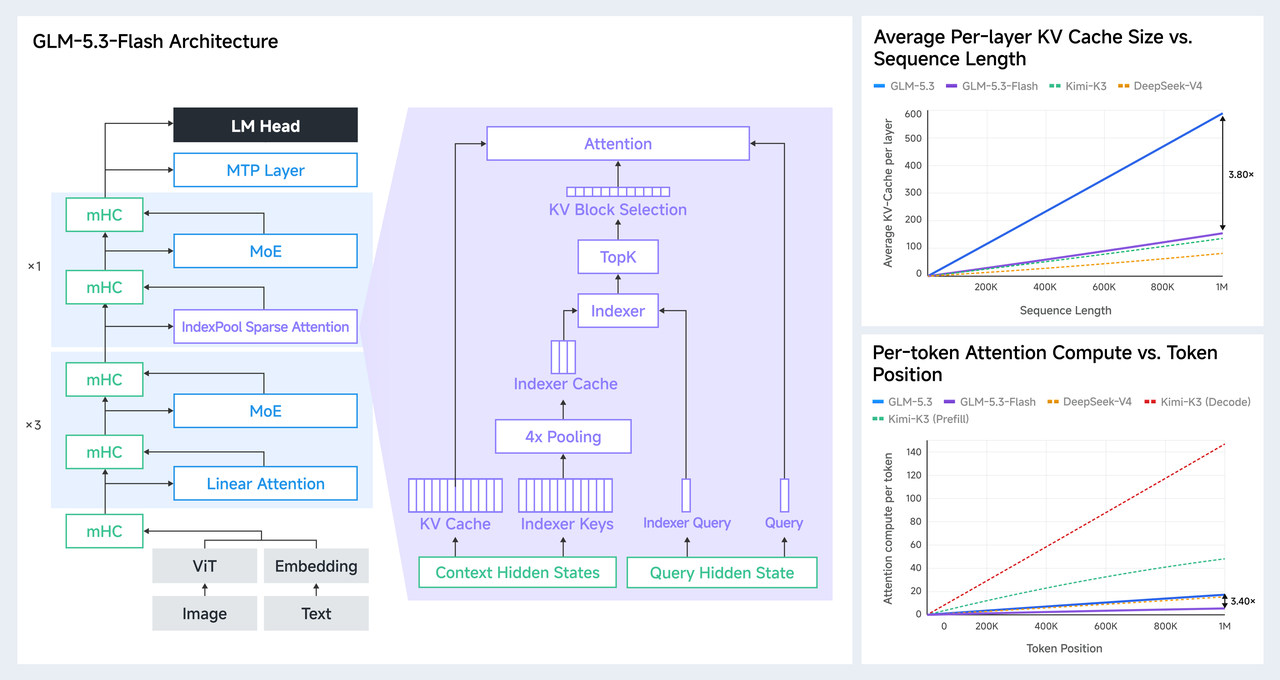
Il testo di rilascio di Z.AI riporta circa 3,0× di riduzione del compute di attenzione e una KV-cache per livello 4,4× più piccola per GLM-5.3-Flash rispetto a GLM-5.3 API. Il grafico ufficiale di accompagnamento etichetta il confronto a un milione di token come 3,40× per il compute di attenzione e 3,80× per la KV-cache per livello. Poiché le due risorse ufficiali usano cifre diverse, andrebbero riportate con i rispettivi contesti invece di essere fuse in un’unica misura.
Confronto ufficiale dell’architettura e dell’efficienza di GLM-5.3-Flash pubblicato da Z.AI
Quali risultati di benchmark costituiscono la baseline di GLM 6.0?
Non esiste una tabella di benchmark verificata per GLM 6.0. L’attuale generazione GLM è utile solo come baseline perché le valutazioni sottostanti misurano pianificazione, coding, uso di strumenti, automazione ed esecuzione a lungo orizzonte — le capacità più rilevanti per la direzione di Full Self-Training divulgata.
Valutazione ufficiale Z.AI
GLM-5.3-Flash
GLM-5.2
Differenza riportata
Terminal Bench 2.1
84.3
81.0
+3.3
DeepSWE v1.1
63.4
46.2
+17.2
NL2Repo
56.3
48.9
+7.4
Toolathlon Verified
78.4
59.9
+18.5
AutomationBench v1.0.6
48.8
26.2
+22.6
Agents’ Last Exam
26.3
20.4
+5.9
HLE with Tools
55.3
54.7
+0.6
GDPval-AA v2
1773 Elo
1504 Elo
+269 Elo
Il confronto è multidimensionale, non una classifica a punteggio unico. GLM-5.3-Flash mostra i guadagni riportati più grandi su AutomationBench (+22.6), Toolathlon Verified (+18.5) e DeepSWE (+17.2), mentre la differenza su HLE-with-Tools è solo +0.6. Questo schema suggerisce guadagni più forti nei compiti agent-centrici pesanti in esecuzione che non in ogni forma di ragionamento assistito da strumenti. Non predice i punteggi di GLM 6.0.
Perché questi benchmark contano
I benchmark contano qui solo se rivelano le capacità che il Full Self-Training intende migliorare. Le sei categorie nella tabella incorporata formano una progressione dal produrre lavoro corretto al sostenere un comportamento efficace in ambienti reali. La programmazione (coding) verifica se il modello sa eseguire un compito complesso; l’uso degli strumenti verifica se sa trasformare un’azione in feedback e scegliere il passo successivo; e l’automazione verifica se sa mantenere quel loop lungo un workflow esteso.
Categoria di benchmark
Perché conta per GLM-6.0
Programmazione
Verifica l’esecuzione di compiti complessi
Uso degli strumenti
Verifica il loop azione→feedback
Automazione
Verifica l’esecuzione di workflow a lungo orizzonte
HLE
Verifica la risoluzione di problemi complessi a livello esperto
GDPval
Verifica la qualità del lavoro professionale
Multimodale
Verifica l’uso del feedback visivo
HLE aumenta poi la difficoltà dei problemi da risolvere, GDPval chiede se l’output è utile nel lavoro professionale, e la valutazione multimodale verifica se osservazioni visive possono guidare le azioni successive. Letti insieme, i sei ambiti passano dalla competenza isolata al completamento end-to-end dei compiti: generare un piano, agire, osservare feedback, correggere gli errori e continuare finché l’obiettivo non è raggiunto.
Un futuro risultato di GLM-6.0 sarebbe quindi significativo non perché produce un punteggio aggregato più alto, ma perché guadagni lungo queste dimensioni mostrerebbero che l’esperienza di addestramento auto-generata si trasferisce in un’esecuzione reale affidabile. L’obiettivo finale del Full Self-Training non è migliorare i punteggi di test, ma migliorare la capacità del modello di completare compiti nel mondo reale.
Perché il Full Self-Training potrebbe essere importante per GLM 6.0?
La vera promessa non è che GLM 6.0 “si addestrerà da solo”. Il cambiamento più significativo è che parti maggiori della pipeline di sviluppo potrebbero diventare generate e verificate dalla macchina. Oggi i ricercatori svolgono ancora molta parte del lavoro attorno al modello: raccolta dati, progettazione di compiti, costruzione di valutatori, costruzione di ambienti, diagnosi dei fallimenti e tuning del software di sistema. Il Full Self-Training spinge il modello dentro più di queste fasi.
Se l’approccio funziona, la variabile di scaling importante diventa meno quanti parametri si possano aggiungere e più quante ciclicità di apprendimento utili e verificate si possano eseguire per unità di calcolo. Questa è un’interpretazione pratica del miglioramento ricorsivo di sé, non la versione fantascientifica di auto-modifica autonoma illimitata.
La strategia divulgata va valutata come un sistema di feedback ingegnerizzato con validatori, ambienti riproducibili, benchmark dell’infrastruttura e controlli umani — non come evidenza di miglioramento autonomo illimitato.
Cosa potrebbe andare storto con il Full Self-Training?
Un ciclo di autoformazione può amplificare gli errori con la stessa efficienza con cui amplifica l’esperienza utile. Quattro modalità di fallimento meritano particolare attenzione:
Amplificazione degli errori: traiettorie sintetiche deboli possono diventare dati di addestramento futuri, permettendo a pattern plausibili ma errati di auto-rafforzarsi.
Ricompensa e gaming del valutatore: se lo stesso sistema genera e giudica il lavoro, potrebbe ottimizzare per le lacune del verificatore invece che per il successo reale del compito.
Restringimento della distribuzione: apprendere ripetutamente da dati generati dal modello può ridurre la diversità e rendere più difficili i casi reali non comuni.
Pressioni di costo, sicurezza e governance: costruzione di ambienti, accesso agli strumenti e iterazione persistente aumentano il consumo di calcolo e ampliano la superficie d’attacco.
Una implementazione credibile di GLM-6.0 richiede quindi validatori indipendenti, provenienza dei dati, soglie di accettazione, test di red team, audit umani e regole di arresto esplicite. L’autocorrezione è utile solo quando il segnale di correzione è più affidabile del comportamento che si sta correggendo.
Quando potrebbe essere disponibile l’API di GLM 6.0?
Z.AI non ha pubblicato una data di rilascio dell’API di GLM 6.0, ID del modello, finestra di contesto, output massimo, prezzo per token, impegno di open-weight o requisiti di deployment. Qualsiasi valore specifico sarebbe attualmente speculazione.
Gli sviluppatori possono valutare la direzione attuale tramite l’API GLM-5.3-Flash in CometAPI per carichi di lavoro multimodali nativi e orientati all’efficienza, l’API GLM-5.3 in CometAPI per il ramo di punta attuale, o l’API GLM-5.2 in CometAPI come baseline di confronto della generazione precedente.
Conclusione
GLM-6.0 conta meno come prodotto promesso e più come test per verificare se Z.AI può trasformare il Full Self-Training in un sistema di ingegneria ripetibile. La roadmap collega esperienza auto-generata, addestramento a fasi, autovalutazione, correzione e iterazione controllata; l’evidenza decisiva sarà se questi meccanismi migliorano l’affidabilità su workflow reali, lunghi e con uso di strumenti.
Quell’evidenza è ancora incompleta. Z.AI non ha pubblicato una model card di GLM-6.0, una data di rilascio, un identificatore API, prezzi o una suite di benchmark. Finché tali artefatti non esistono, la conclusione difendibile è ristretta: l’azienda ha divulgato una direzione di addestramento, non un profilo di capacità finito.
L’obiettivo finale del Full Self-Training non è migliorare i punteggi di test, ma migliorare la capacità del modello di completare compiti nel mondo reale.