
Sintesi
GPT-6 Astra mostra punteggi titolati eccezionali. I maggiori miglioramenti compaiono quando il ragionamento deve essere convertito in azione: operazioni da terminale, uso di software, automazione, recupero su contesti lunghi, workflow scientifici e cybersecurity. Su test accademici già saturi, il progresso rispetto alla precedente generazione OpenAI è spesso molto più contenuto.
Il modello combina una finestra di contesto da 1.050.000 token con un’ampia gamma di strumenti. I benchmark di esecuzione pubblicati da OpenAI suggeriscono che l’upgrade pratico è più forte nel lavoro di lungo orizzonte, ma il design dell’harness, lo sforzo di ragionamento, la latenza e l’accesso agli strumenti influenzano materialmente il risultato.
Punti chiave
- I guadagni più chiari di Astra riguardano l’esecuzione agentica, non ogni forma di question answering.
- Terminal-Bench, AutomationBench, computer-use e database-migration mostrano movimenti sostanzialmente maggiori rispetto a GPQA o DeepSWE.
- Il risultato di ARC-AGI-3 dimostra che stato del modello, gestione del contesto e harness di valutazione possono dominare il punteggio finale.
- Una grande finestra di contesto conta solo quando l’informazione resta recuperabile vicino al limite; MRCR è più informativo della capacità pubblicizzata da sola.
- Prezzi token più alti non significano automaticamente costo di task più alto se il modello richiede meno token, turni, retry o correzioni umane.
- Le decisioni di produzione dovrebbero comparare insieme tasso di successo, tempo trascorso, costo totale, affidabilità degli strumenti e onere di correzione.
GPT-6 Astra in breve
OpenAI specifica fino a 128.000 token di output, input di testo e immagini, output di testo e sforzo di ragionamento da low a max. Queste specifiche rendono possibili workflow ampi e multistep, ma non provano che un modello recupererà le prove giuste o completerà un task in modo affidabile.
| Specifiche ufficiali | GPT-6 Astra in CometAPI | Significato pratico |
|---|---|---|
| Model ID | gpt-6-astra | Identificatore stabile per il routing API |
| Context window | 1.050.000 token | Supporta grandi repository, archivi e storici di agent |
| Maximum output | 128.000 token | Consente report, patch e artefatti strutturati di grandi dimensioni |
| Knowledge cutoff | 30 aprile 2026 | Fatti successivi richiedono strumenti o fonti fornite |
| Input | Testo e immagini | Supporta documenti, screenshot, diagrammi ed evidenza mista |
| Output | Testo | Produce prosa, codice e testo strutturato |
| Reasoning effort | low, medium, high, xhigh, max | Scambia latenza e costo per una ricerca più profonda |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | Abilita workflow end-to-end invece di risposte isolate |
| OpenAI Standard input | $10 per milione di token | La dimensione dell’input e il riuso della cache influenzano il costo totale |
| OpenAI cached input | $1 per milione di token | Si applica quando il prefisso del prompt viene riutilizzato dalla cache |
| OpenAI cache writes | $12.50 per milione di token | Fatturato a 1.25× della tariffa di input non in cache |
| OpenAI Standard output | $50 per milione di token | Output verbosi possono dominare il costo del task |
| Requests above 272K input tokens | Tariffe di input e cache ×2; tariffa di output ×1.5 | Le tariffe più alte si applicano all’intera richiesta |
Un limite di contesto misura la capacità, non il richiamo utilizzabile. Un elenco di strumenti misura la disponibilità, non l’esecuzione riuscita. Servono benchmark per testare se tali specifiche si traducono in lavoro completato.
Cosa mostrano i risultati di benchmark di GPT-6 Astra?
Il portafoglio mostra un andamento irregolare. Astra oltrepassa di poco Sol su alcuni test accademici e di ragionamento software, ma produce guadagni a doppia cifra su lavoro da terminale, automazione, migrazione di database, interazione visiva, recupero su contesti lunghi e matematica avanzata.
| Benchmark pubblicato | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Emergono tre cluster. Primo, i gap di 1.4 punti su DeepSWE e GPQA indicano un movimento incrementale limitato su task in cui modelli forti già performano bene. Secondo, guadagni oltre 20 punti su Terminal-Bench, AutomationBench, migrazione database e recupero su milioni di token mostrano un cambiamento molto più ampio nell’esecuzione. Terzo, ARC-AGI-3 è un outlier la cui interpretazione dipende dall’harness.
Risultato di test indipendenti
Artificial Analysis riporta Astra e Sol intorno a 61 sul suo Intelligence Index, mostrando però un guadagno molto più chiaro sul suo Coding Agent Index. Questo rinforza indipendentemente il pattern nei dati di OpenAI: il miglioramento maggiore è concentrato nell’esecuzione agentica.
Al massimo sforzo nell’harness Codex, Astra userebbe circa un terzo dei token rispetto a Sol sul Coding Agent Index. L’uso di token sul suo Intelligence Index cala solo di circa il 10%. Poiché il rate per token di Astra è più alto, questi due profili di efficienza creano economie diverse.
| Valutazione indipendente | Risultato osservato | Interpretazione per la produzione |
|---|---|---|
| Intelligence Index | Separazione ridotta da Sol | Il ragionamento ampio può non giustificare un forte premium |
| Coding Agent Index | Chiaro miglioramento agentico | Meno token possono compensare un rate per token più alto |
| AA-Omniscience | Il tasso di allucinazioni scende dal 92% al 51% al max effort | Un’astensione migliore può contare per sistemi di ricerca e retrieval |
| Lavoro conoscitivo a lungo orizzonte | Progressi misti tra i task | È necessaria una valutazione locale |
Nessun benchmark indipendente certifica la factualità o la sicurezza in produzione. I team dovrebbero separatamente misurare risposte corrette, incertezze giustificate, affermazioni non supportate e fallimenti nel seguire i vincoli della fonte.
Perché Astra è più adatta al lavoro agentico di lungo orizzonte?
GPT-6 Astra aggiunge tre controlli pensati per lavori che cambiano mentre sono in esecuzione. L’affidabilità a lungo termine dipende anche dall’intero sistema di contesto: la finestra di contesto stabilisce la capacità; la compattazione controlla come il materiale più vecchio viene condensato; il ragionamento persistente porta avanti lo stato del modello rilevante; il retrieval mantiene ricercabili le evidenze precedenti; e l’applicazione deve preservare output importanti degli strumenti, risultati di test, approcci falliti e requisiti dell’utente. Questi meccanismi dovrebbero essere testati insieme all’harness dell’agente.
- Chiamata asincrona degli strumenti: Astra può continuare a ragionare in modo indipendente o chiamare altri strumenti mentre un’applicazione esegue uno strumento a lunga durata.
- Steering a metà turno: un’applicazione può inviare una correzione o un nuovo requisito via WebSocket senza scartare il lavoro completato.
- Regolazione del ragionamento a conversazione in corso: un aggiornamento di configurazione può alzare o abbassare lo sforzo di ragionamento preservando il prefisso del prompt in cache.
Dove GPT-6 Astra migliora realmente
Coding agentico: il lavoro da terminale è l’upgrade più grande
Terminal-Bench 4.0 valuta se un agente può portare a termine difficili task da terminale, invece di generare solo una risposta di codice isolata. Astra arriva al 57.9%, 20.6 punti percentuali sopra Sol e 2.1 punti sopra Fable. È un miglioramento sostanziale generazione-su-generazione per OpenAI, ma un vantaggio molto più stretto rispetto a un altro sistema agentico di frontiera.
DeepSWE racconta una storia diversa: 74.1% per Astra e 72.7% per Sol. Il gap di 1.4 punti invita alla cautela nel generalizzare da un singolo benchmark di coding. Astra sembra guadagnare di più quando il coding richiede interazione con l’ambiente, iterazione, preservazione dello stato e verifica.
Database Migration Tasks rafforza questa interpretazione. Il risultato di 63.9% è 21.2 punti sopra Sol e 6.1 punti sopra Fable. Il lavoro di migrazione combina comprensione del codice, uso degli strumenti, sequenziamento e giudizio operativo — il tipo di workflow composto in cui piccoli miglioramenti di ragionamento possono accumularsi in guadagni di completamento molto più grandi.
Per gli agenti di coding, valutare insieme il modello e l’harness. Istruzioni del repository, strumenti da terminale, comportamento di retry, preservazione del contesto ed esecuzione dei test contribuiscono tutti all’esito misurato.
Uso del computer: contano sia il tasso di successo sia il runtime
Su Agents’ Last Exam, GPT-6 Astra ottiene 59.3%, rispetto al 53.6% di GPT-5.6 Sol: un guadagno di 5.7 punti percentuali. Questo aggiunge un risultato più ampio su task agentici al punteggio di OSWorld 2.0 e ScreenSpot-Pro nella panoramica dei benchmark sopra.
Oltre all’accuratezza, il confronto di runtime OSWorld aggiunge un’altra dimensione pratica: OpenAI riporta circa 40 minuti per task per Astra contro circa 75 minuti per Sol, ovvero circa il 47% di tempo trascorso in meno aumentando anche il successo del task.
Un agente che ha successo un po’ più spesso e finisce molto più velocemente può offrire un grande miglioramento di throughput. I test di procurement dovrebbero quindi riportare tasso di successo, tempo trascorso, chiamate agli strumenti, retry e interventi umani — non la sola accuratezza.
Automazione e lavoro professionale
AutomationBench sale da 18.1% a 41.4%, un guadagno di 23.3 punti. Il punteggio assoluto è ancora lontano dalla perfezione, ma il cambiamento nel profilo di fallimento è più significativo di un movimento di un punto vicino alla saturazione. Su BenchCAD, Astra arriva a 95.9%, superando Sol di 12.6 punti e Fable di 11.6 punti.
Questi risultati supportano un’affermazione specifica: Astra è migliore nel convertire istruzioni in sequenze di azioni validate. Non provano guadagni uguali per ogni workflow di business. Un processo di produzione può introdurre passaggi di autenticazione, interfacce proprietarie, policy ambigue o formati di dati assenti dal benchmark.
Scienza
La scienza è uno dei guadagni di capacità più chiari di Astra. Su FrontierMath Tier 4 v2, Astra raggiunge 97.6%, rispetto a 83.0% per Sol e 87.8% per Fable. Il vantaggio di 14.6 punti su Sol è sostanziale, sebbene il benchmark copra una distribuzione di task selezionata piuttosto che l’intero workflow scientifico.
Cybersecurity
La cybersecurity è un secondo grande guadagno, con posta in gioco più alta di un semplice movimento in classifica. Su ExploitBench che copre giugno–agosto 2026, Astra ottiene 39.0% contro il 5.5% di Sol. OpenAI riporta che questo set più recente mira a vulnerabilità dei tre mesi precedenti per ridurre l’esposizione storica. Nella valutazione di cybersecurity di OpenAI, Astra ha dimostrato la capacità di scoprire ed exploitare due vulnerabilità zero-day precedentemente sconosciute durante test controllati. Questo risultato è importante perché la valutazione è stata progettata attorno a vulnerabilità recentemente divulgate, riducendo la possibilità che la performance fosse semplicemente causata da esempi memorizzati. Il risultato ha contribuito a far raggiungere ad Astra la soglia di capacità di cybersecurity Critical di OpenAI e quindi cambia le salvaguardie richieste per la distribuzione. Il significato non è che Astra possa condurre autonomamente operazioni cyber senza restrizioni, ma che il suo livello di capacità cambia i requisiti per le misure di salvaguardia nella distribuzione. I sistemi con maggiore capacità di discovery ed exploit di vulnerabilità richiedono controlli di accesso più rigorosi, monitoraggio, sandboxing e meccanismi di revisione umana.
Attività di lunga durata: la finestra di contesto non è tutta la storia
La finestra di contesto da 1.050.000 token di Astra descrive la capacità, non la continuità. La performance a lungo termine dipende anche da compattazione, stato persistente, contesto precedente ricercabile, stato di ragionamento mantenuto e preservazione degli output degli strumenti. In MRCR v2, Astra ottiene 100.0% a 256K–512K e 96.3% a 512K–1M, mentre Sol registra 91.5% e 73.8%. Il gap di 22.5 punti nella fascia più lunga mostra che la capacità di recupero utilizzabile vicino al limite conta più della sola capacità pubblicizzata.
MRCR resta un test di retrieval sintetico, quindi la valutazione in produzione dovrebbe preservare l’evidenza che i riassunti spesso perdono: perché una correzione precedente è fallita, il comportamento di un componente specifico, risultati di test, requisiti storici e dettagli sepolti nell’output degli strumenti. Repository e archivi di ricerca dovrebbero anche essere testati con nomi duplicati, riferimenti incrociati, policy obsolete, fonti contraddittorie e lunghi intervalli di distrazione. Questo separa la capacità grezza del contesto dalla preservazione e dal comportamento di retrieval che un agente di lungo orizzonte realmente necessita.
Conservazione del contesto: perché Astra è diversa dai sistemi tradizionali a contesto lungo
I workflow tradizionali a contesto lungo solitamente seguono uno schema:
context → compaction → summary → continue
Questo approccio riduce l’uso di token, ma introduce un rischio critico: durante la sintesi potrebbe scomparire informazione intermedia importante.
L’informazione persa spesso non è la risposta finale, ma i dettagli operativi necessari per decisioni future:
- perché un fix precedente è fallito;
- quale componente ha mostrato comportamenti anomali;
- quale risultato di test ha cambiato la direzione dell’implementazione;
- quale requisito utente è stato aggiunto in seguito;
- quale output di uno strumento conteneva evidenza importante.
GPT-6 Astra affronta questo limite combinando meccanismi di conservazione del contesto e retrieval all’interno dei workflow agentici a lunga durata.
Invece di affidarsi solo a riepiloghi compressi, il sistema può preservare note importanti, recuperare informazioni precedenti quando necessario e mantenere la continuità tra molteplici interazioni con strumenti.
Per gli agenti di coding come Codex, questo significa che un lungo task di debugging può mantenere:
- precedenti esperimenti falliti;
- modifiche al repository;
- output dei test;
- decisioni architetturali;
- problemi irrisolti.
Pertanto, il valore della finestra di contesto da 1M token di Astra non è solo la quantità di informazione che può ricevere, ma se il sistema può preservare e recuperare l’informazione giusta dopo ore di interazione.
Ragionamento e interpretazione
ARC-AGI-3: l’harness fa parte del risultato
ARC-AGI-3 fornisce la dimostrazione più chiara che un benchmark di frontiera può misurare un sistema piuttosto che un modello isolato. ARC Prize riporta 62.7% con lo Standard harness al max effort e 99.9% con il Provider Adapter al high effort.
| Valutazione ARC Prize | Standard Harness | Provider Adapter | Adapter Gain |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
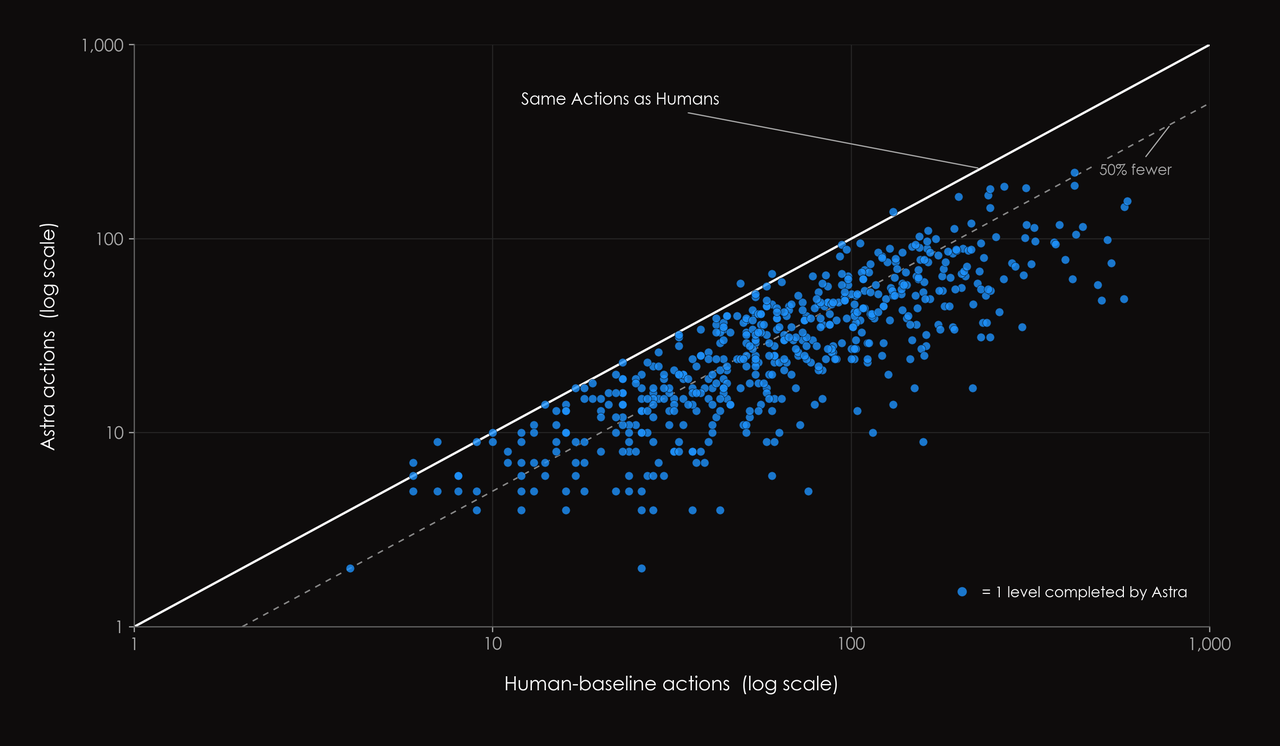
Confronto ARC Prize dell’efficienza d’azione di Astra tra harness di valutazione
La policy del harness provider-neutral richiede al modello di preservare informazioni importanti in uno stato visibile. Il Provider Adapter conserva ulteriore stato di ragionamento e utilizza gestione del contesto specifica del provider. Su coppie condivise di game-reasoning risolte, ARC Prize riporta esecuzione 3.66× più veloce e 49% di token totali in meno con l’adapter.
Il risultato del 99.9% misura uno specifico sistema modello–provider–adapter e non dovrebbe essere trattato come una misura indipendente dal harness dell’intelligenza grezza del modello. L’architettura del contesto è parte del sistema valutato dal benchmark.
Lo sforzo di ragionamento non scala linearmente
La tabella ARC mostra anche che lo sforzo massimo non produce sempre il punteggio più alto. High effort arriva al 99.9% con il Provider Adapter, mentre max raggiunge 98.6%. Nello Standard harness, max performa meglio.
OpenAI osserva che le cifre della tabella di lancio generalmente utilizzano la migliore impostazione di ragionamento osservata. Questo approccio stima un tetto prestazionale, ma non identifica la miglior configurazione di produzione. I team dovrebbero testare diversi livelli di sforzo e calcolare la qualità marginale guadagnata per ogni secondo e dollaro aggiuntivi.
Matematica e ragionamento accademico
FrontierMath Tier 4 v2 sale da 83.0% a 97.6%, un guadagno di 14.6 punti. È un importante miglioramento di benchmark, ma non è evidenza che la matematica di frontiera sia stata risolta. La valutazione copre una distribuzione di task selezionata e non misura ogni fase della ricerca matematica, inclusi selezione dei problemi, verifica formale delle dimostrazioni, sviluppo di programmi di lungo termine o peer review avversaria.
GPQA Diamond mostra il pattern opposto: 96.0% per Astra, 94.6% per Sol, 93.7% per Fable e 95.3% per Gemini 3.8 Flash. I modelli si raggruppano strettamente vicino al tetto. Riportare il differenziale di 1.4 punti Astra–Sol è accurato, ma chiamarlo una rivoluzione ampia dell’intelligenza esagererebbe l’evidenza.
Capacità critiche + salvaguardie
| Valutazione di cybersecurity | Astra | Sol | Guadagno assoluto |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, giugno–agosto 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI ha creato ExploitBench (giugno–agosto 2026) da vulnerabilità divulgate nei tre mesi precedenti, riducendo la possibilità che l’esposizione storica alle vulnerabilità abbia gonfiato il risultato. Astra ottiene 39.0% su questo set rispetto al 5.5% di Sol, e OpenAI riporta che Astra ha trovato ed exploitato due vulnerabilità zero-day precedentemente sconosciute. Questi risultati hanno contribuito a far diventare Astra il primo modello ampiamente distribuito di OpenAI a raggiungere la soglia di capacità di cybersecurity Critical, che ha influito direttamente sulle salvaguardie e sulla policy di accesso.
Come leggere i punteggi vicino alla saturazione
Punteggi oltre il 90% richiedono un linguaggio più attento rispetto ai risultati di fascia media. Passare da 50% a 60% risolve dieci task aggiuntivi per cento. Passare da 95% a 96% risolve solo un task aggiuntivo per cento, anche se riduce il numero di errori rimanenti da cinque a quattro — una riduzione del 20% degli errori. Entrambe le descrizioni sono matematicamente corrette, ma supportano titoli molto diversi.
La cautela opposta si applica ai benchmark a punteggio basso. Un aumento da 18.1% a 41.4% resta ben lontano da un’operazione autonoma affidabile, ma più che raddoppia il numero di casi di successo e può trasformare un workflow supervisionato. Il punteggio assoluto determina se il sistema è pronto; la dimensione del miglioramento indica quanto velocemente la capacità sta cambiando. Le decisioni di produzione hanno bisogno di entrambi.
Un confronto multidimensionale
| Dimensione | Astra | Sol | Fable | Segnale decisionale |
|---|---|---|---|---|
| Ragionamento accademico generale | Eccellente; spesso vicino alla saturazione | Subito dietro | Competitivo | Piccoli gap raramente decidono la distribuzione |
| Esecuzione da terminale | Top-tier | Ampio gap generazionale | Competitore vicino | Testare l’intero harness di coding |
| Uso del computer | Maggior successo e runtime più basso | Più lento e meno accurato | Dati comparabili insufficienti nella tabella di lancio | Misurare il successo per ora |
| Recupero su contesti lunghi | Forte vicino a 1M token | Degradazione materiale vicino al limite | Dati direttamente comparabili insufficienti | Usare test di retrieval modellati sulla produzione |
| Controllo del ragionamento | low fino a max | Envelope di sforzo differente | Approccio adaptive-thinking | Ottimizzare la configurazione, non solo il nome del modello |
| Capacità cyber | Tier di rischio qualitativamente più alto | Risultati pubblicati inferiori | Non comparato qui | Salvaguardie e policy di accesso contano |
| Economia dei token | Rate più alto; talvolta meno token | Rate più basso | Dipende dal carico | Comparare il costo per task riuscito |
Il risultato dipende dal carico di lavoro. Astra è più convincente quando il task richiede interazione sostenuta con strumenti e ambienti, recupero dopo fallimenti o retrieval affidabile su contesti molto grandi. Sol può rimanere più economico per lavori delimitati con contesto modesto e iterazione limitata. Fable è un concorrente vicino sul lavoro da terminale e guida alcune valutazioni accademiche esterne, quindi un benchmark a livello di applicazione è più utile di una conclusione a livello di provider.
Chi dovrebbe usare GPT-6 Astra?
| Caso d’uso | Raccomandazione |
|---|---|
| Classificazione semplice | Non necessariamente vale la pena usare Astra |
| Sintesi semplice | Non necessariamente vale la pena usare Astra |
| RAG standard | Prima confrontare costo vs. performance |
| Sintesi e analisi di documenti lunghi | Vale la pena testare Astra |
| Coding agentico | Fortemente consigliato testare |
| Uso del computer | Fortemente consigliato testare |
| Automazione multi-step | Fortemente consigliato testare |
| Ricerca complessa | Vale la pena testare |
| Calcolo scientifico / software specializzato | Vale la pena testare |
| Cybersecurity | Capacità forti, ma richiede controlli di sicurezza appropriati |
| Task semplici ad alto throughput | Modelli a costo inferiore possono essere più convenienti |
I miglioramenti delle prestazioni di GPT-6 Astra giustificano il prezzo più alto?
GPT-6 Astra è significativamente più costoso di GPT-5.6 Sol, ma i miglioramenti di benchmark non sono distribuiti in modo uniforme tra i carichi di lavoro. La domanda sul prezzo non può quindi essere risolta comparando solo i rate per token.
| Scenario | Guadagno di performance | Giustificazione del costo |
|---|---|---|
| Q&A semplice | Piccolo miglioramento | Di solito non vale il premium |
| Agente di coding | Grande miglioramento | Il premium può essere giustificato |
| Analisi a lungo contesto | Miglioramento significativo | Dipende dalle esigenze di retrieval |
| Automazione computer | Forte miglioramento | Spesso vale la pena testare |
| Ragionamento generale | Miglioramento limitato | Confrontare attentamente i costi |
Alle tariffe OpenAI Standard, GPT-6 Astra costa $10 per milione di token di input, $1 per milione di token di input in cache, $12.50 per milione di token di scrittura cache e $50 per milione di token di output. Input e output Standard sono 2.5× rispetto alle tariffe $4 e $20 di GPT-5.6 Sol. Quando una richiesta supera i 272K token di input, le tariffe di input e cache di Astra raddoppiano e la tariffa di output aumenta di 1.5× per l’intera richiesta.
Il premium di prezzo si allinea più chiaramente con il lavoro agentico. Astra guadagna oltre 20 punti percentuali su Terminal-Bench, AutomationBench, migrazione di database e MRCR nella fascia più lunga; i test indipendenti riportano anche circa un terzo dell’uso di token di Sol sul Coding Agent Index. L’allineamento è più debole sul ragionamento ampio, dove l’Intelligence Index è quasi in parità e l’uso di token cala solo di circa il 10%. La decisione di acquisto dovrebbe quindi comparare il costo per task riuscito, includendo output, attività di cache, uso degli strumenti, tempo trascorso, retry, fallimenti e correzioni umane.
Costo per task riuscito
Costo per task riuscito = (Costo di input + Costo di output + Costo degli strumenti + Costo dei retry + Costo della revisione umana) / Task riusciti
Costo aziendale previsto
Costo aziendale previsto = Costo API + Costo degli strumenti + Costo dei retry + Costo della revisione umana + Costo dei fallimenti
La metrica decisionale dovrebbe essere il costo totale diviso per i task riusciti, valutato a una soglia di qualità accettabile — non il prezzo per milione di token.
Come gli sviluppatori dovrebbero eseguire benchmark su Astra
Le classifiche pubbliche dovrebbero determinare cosa merita di essere testato, non decidere la distribuzione finale. Costruire un set di task rappresentativo con casi di routine, casi difficili, casi con contesto mancante, failure degli strumenti e istruzioni avversarie. Usare lo stesso prompt di produzione, permessi, file sorgente, budget di tempo e criteri di completamento per ogni modello.
| Dimensione di valutazione | Misura | Perché conta |
|---|---|---|
| Successo del task | Criteri di accettazione soddisfatti | Previene che risposte persuasive ma incomplete vengano conteggiate come successo |
| Affidabilità | Distribuzione del successo su run ripetute | Espone vittorie isolate instabili |
| Esecuzione degli strumenti | Azioni riuscite verificate | Separa le chiamate agli strumenti dagli esiti corretti |
| Factualità | Affermazioni fattuali supportate | Misura la qualità dell’evidenza e l’astensione |
| Latenza | Tempo di completamento mediano e in coda | Cattura il throughput operativo |
| Costo | Costo totale per task riuscito | Include retry e tentativi falliti |
| Sforzo umano | Minuti di correzioni e revisione | Spesso domina il costo reale di distribuzione |
| Steerability | Recupero dopo requisiti cambiati | Testa il comportamento dell’agente a lunga durata |
L’API di Astra in CometAPI usa il model ID gpt-6-astra. Un’API multi-modello rende pratico eseguire la stessa valutazione su Astra, Sol, Fable e Gemini senza ridisegnare il benchmark attorno alla tabella dei titoli di un singolo provider. Instradare i task agentici impegnativi verso il modello che si guadagna il suo premium, e usare modelli a costo inferiore dove il vantaggio misurato scompare.
Conclusione
Il foglio dei benchmark di Astra è impressionante, ma i punteggi più spettacolari non sono automaticamente i più utili. ARC-AGI-3 dimostra il potenziale di un harness di agente specifico del provider; il punteggio con lo Standard harness mostra quanto fortemente l’infrastruttura contribuisca. GPQA e l’Intelligence Index indipendente mostrano che i guadagni nel ragionamento ordinario possono essere modesti. Lavoro da terminale, automazione, uso del computer, recupero su contesti lunghi, workflow scientifici e cybersecurity raccontano la storia più importante.
Il rilascio riguarda meno un chatbot che diventa proporzionalmente più intelligente su ogni domanda e più l’intelligenza di frontiera che diventa migliore nel completare il lavoro. Se vale la pena pagare per questo upgrade dipende dall’intera configurazione del sistema-modello e dall’economia dei task di produzione riusciti.