
TL;DR
DeepSeek V4.1 Flash è il modello multimodale di DeepSeek orientato all’efficienza per coding, reasoning, agenti e carichi con contesto lungo. La documentazione tecnica ufficiale specifica un design Mixture-of-Experts da 552B con 8B di parametri attivi in input e 16B in output, oltre a comprensione visiva nativa e un’impronta della cache KV molto più piccola.
Per gli sviluppatori che utilizzano la DeepSeek V4.1 Flash API in CometAPI, l’integrazione pratica è compatibile con OpenAI: usa https://api.cometapi.com/v1 come base URL, imposta il modello su deepseek-v4.1-flash e chiama l’interfaccia standard Chat Completions.
Una differenza di naming è importante: l’API first-party di DeepSeek usa deepseek-flash, mentre CometAPI usa deepseek-v4.1-flash. Considera gli identificatori di modello come configurazione specifica del provider.
Punti chiave
- DeepSeek V4.1 Flash combina un backbone MoE da 552B, comprensione di immagini nativa e un profilo di calcolo asimmetrico tra input e output.
- In CometAPI, usa deepseek-v4.1-flash; sull’API first-party di DeepSeek, usa deepseek-flash.
- CometAPI pubblica prezzi base da $0.12/M token di input, mentre l’input cache-miss off-peak di DeepSeek è $0.15/M.
- Le differenze più marcate si concentrano su coding, terminale, repository, automazione e benchmark per agenti assistiti da strumenti.
- Prima del rollout in produzione, valida campi avanzati come controlli del “thinking”, payload visivi, streaming, chiamate a strumenti e output strutturato sulla rotta del provider esatta che utilizzerai.
Che cos’è la DeepSeek V4.1 Flash API?
DeepSeek V4.1 Flash è l’ultimo modello Flash costruito su un’architettura Mixture-of-Experts da 552B parametri. Il design Encoder-Decoder causale attiva 8B parametri per l’elaborazione in input e 16B per la generazione in output.
Per la pianificazione dell’integrazione, l’API ufficiale di DeepSeek espone una finestra di contesto da 1M token e un output massimo di 384K token. Il servizio upstream supporta Chat Completions e Responses API compatibili con OpenAI, un’API compatibile Anthropic, streaming, output JSON, chiamate a strumenti e input immagine nativo. Questa guida usa la rotta Chat Completions di CometAPI, quindi verifica il passthrough delle funzionalità su quella rotta prima della messa in produzione.
| Specifica | Dettagli API ufficiale DeepSeek V4.1 Flash |
|---|---|
| Architettura | 552B MoE, Encoder-Decoder causale |
| Parametri attivi | 8B per input; 16B per output |
| Lunghezza contesto | 1M token |
| Output massimo | 384K token |
| Interfacce | Chat Completions, Responses API, API compatibile Anthropic |
| Streaming | Supportato |
| Output strutturato | Output JSON e JSON Schema tramite endpoint supportati |
| Chiamate a strumenti | Supportate, incluso l’uso in modalità “thinking” |
| Input visivo | JPEG, PNG, GIF e WebP |
| Limiti immagine | 32 MiB inline; 64 MiB per file; fino a 600 immagini per richiesta |
| Model ID first-party | deepseek-flash |
| Model ID CometAPI | deepseek-v4.1-flash |
Nota del provider: gli ID modello e i campi di richiesta avanzati sono specifici per rotta. Usa deepseek-v4.1-flash per gli esempi CometAPI in questa guida e testa visione, chiamate a strumenti, output strutturato e controlli del thinking sull’endpoint distribuito.
DeepSeek riporta anche che la cache KV globale è di circa 890 byte per token, contro 3,514 byte per token della precedente generazione V4 Flash. Questa riduzione conta soprattutto per agenti di lunga durata che riutilizzano ripetutamente prompt grandi, schemi di strumenti e cronologia conversazionale.
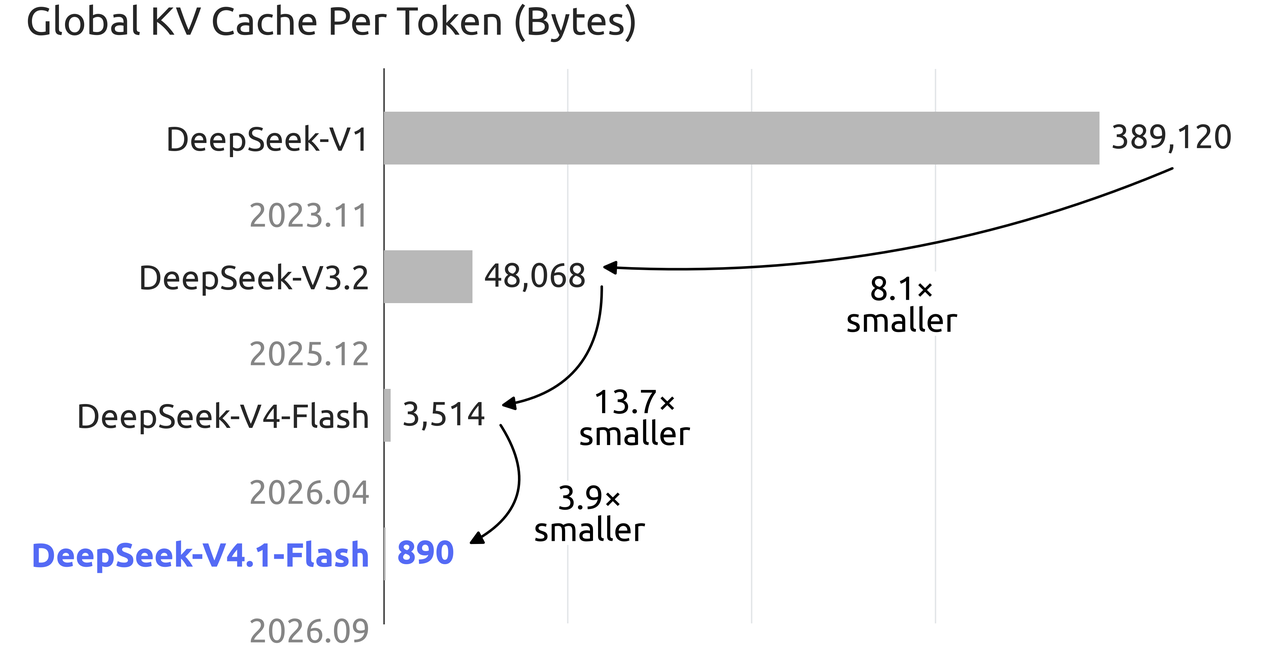
Confronto ufficiale della cache KV di DeepSeek ? fonte immagine ufficiale
Quanto è forte DeepSeek V4.1 Flash per coding e agenti AI?
Questa guida si concentra su evidenze di benchmark che informano direttamente la selezione dell’API. DeepSeek caratterizza V4.1 Flash come superiore ai modelli di punta, incluso V4 Pro, nel suo pacchetto di valutazione pubblicato. I guadagni più utili emergono nel lavoro da terminale, nell’ingegneria del software, nei task su repository, nell’automazione e negli agenti assistiti da strumenti; i team di produzione dovrebbero comunque validare il modello sui propri prompt e criteri di completamento.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| HLE with tools | 63.9 | 60.0 | 51.5 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
La conclusione pratica è più ristretta di “V4.1 è più intelligente”. DeepSeek V4.1 Flash è particolarmente interessante per uso ripetuto di strumenti, azioni da terminale, coding su scala repository, automazione e traiettorie di agenti lunghe. Carichi puramente di conoscenza o ragionamento possono produrre un ranking diverso.
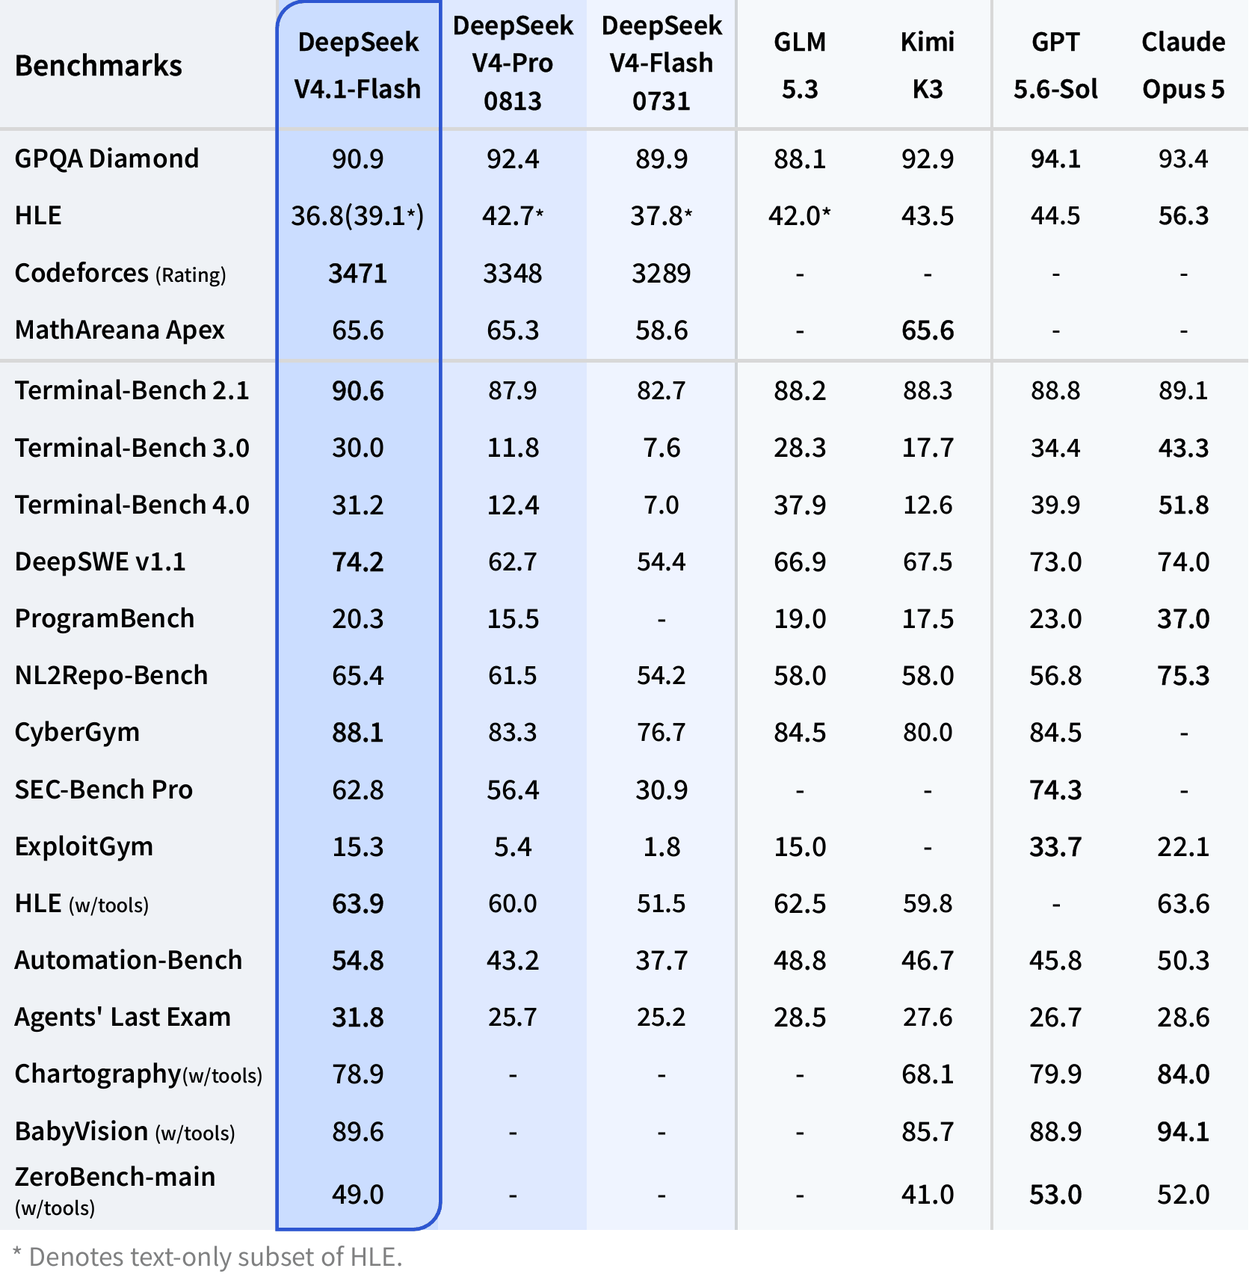
Risultati ufficiali dei benchmark DeepSeek ? fonte immagine ufficiale
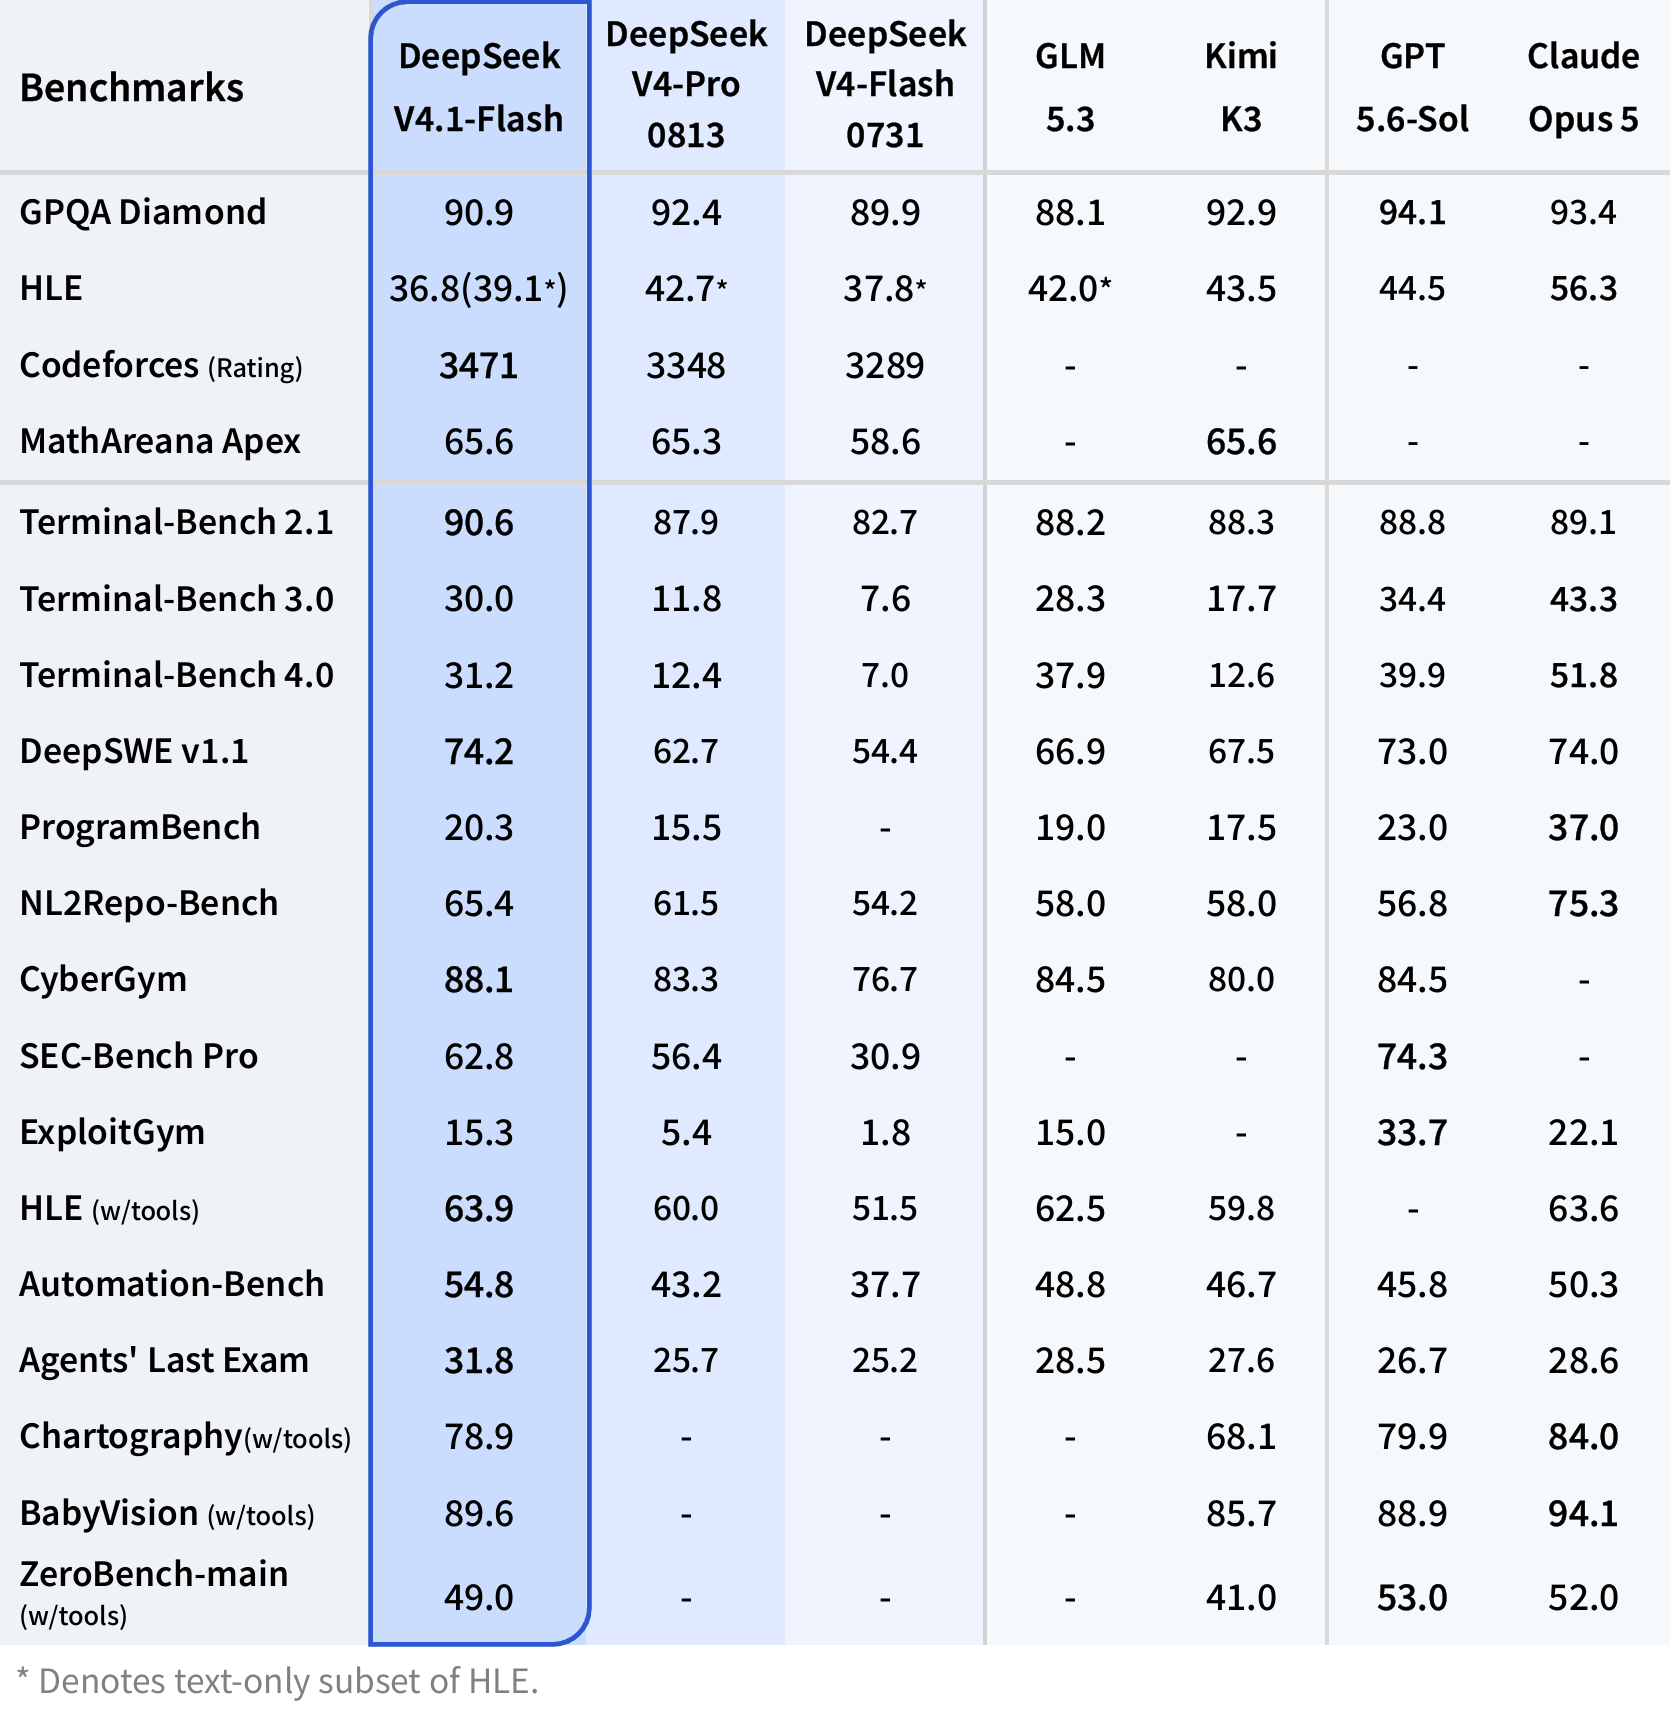
Perché usare la DeepSeek V4.1 Flash API tramite CometAPI?
Il principale vantaggio d’integrazione è che la DeepSeek V4.1 Flash API in CometAPI può essere invocata con lo stesso pattern client compatibile con OpenAI usato per altri modelli, riducendo i cambi di SDK nelle applicazioni multi-modello.
| Impostazione | Valore |
|---|---|
| Base URL | https://api.cometapi.com/v1 |
| Endpoint chat | /chat/completions |
| Model ID | deepseek-v4.1-flash |
| Autenticazione | API key Bearer |
| SDK Python | Compatibile con OpenAI SDK |
| SDK JavaScript | Compatibile con OpenAI SDK |
Questo evita anche un errore d’integrazione comune: copiare l’identificatore first-party di DeepSeek in una richiesta CometAPI. Le route dei provider si riferiscono alla stessa famiglia di modelli, ma gli ID modello documentati sono diversi.
| Dimensione | CometAPI DeepSeek V4.1 Flash | API ufficiale DeepSeek |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | https://api.deepseek.com |
| Modello | deepseek-v4.1-flash | deepseek-flash |
| Interfaccia | Compatibile OpenAI | Compatibile OpenAI |
| Input base/off-peak | $0.12/M base | $0.15/M off-peak cache miss |
| Output base/off-peak | $0.48/M base | $0.60/M off-peak |
| Lettura cache/hit | $0.0024/M base | $0.003/M off-peak |
Connettersi a DeepSeek V4.1 Flash con CometAPI
Configura la tua API key e il Base URL
Crea una API key CometAPI, salvala in una variabile d’ambiente e configura il base URL compatibile con OpenAI come https://api.cometapi.com/v1. Non incorporare credenziali di produzione nel codice sorgente.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"
``````sh
$env:COMETAPI_KEY="YOUR_COMETAPI_KEY"
Effettua la tua prima richiesta API
Usa l’identificatore di modello deepseek-v4.1-flash con l’endpoint standard Chat Completions.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Una risposta corretta usa la familiare struttura di completamento in stile OpenAI, quindi le applicazioni che già leggono choices[0].message.content richiedono un lavoro di migrazione minimo.
Esempio SDK Python
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
Per la produzione, aggiungi timeout espliciti, retry limitati, logging delle richieste e monitoraggio dell’utilizzo.
Esempio SDK JavaScript
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
L’astrazione del client resta invariata mentre base URL e ID modello diventano configurazione del provider.
Funzionalità della DeepSeek V4.1 Flash API
Configurare il ragionamento e la modalità thinking
DeepSeek documenta sia il funzionamento con thinking sia senza. Quando instradi tramite CometAPI, verifica che i campi specifici del vendor vengano passati esattamente come previsto prima di farne un contratto di produzione.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant distributed job scheduler."
        }
    ],
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"}
    },
)
Prova ogni livello di effort supportato rispetto ai tuoi obiettivi di latenza, uso di token e completamento del task, poiché le mappature dei provider possono differire.
Analizzare immagini con input visivo
DeepSeek V4.1 Flash accetta immagini JPEG, PNG, GIF e WebP. I limiti ufficiali includono 32 MiB per immagine inline, 64 MiB per immagine basata su file, fino a 600 immagini per richiesta e un limite di 8.192 caratteri per URL di immagini esterne. Le immagini appartengono a messaggi user o developer, non a system o assistant.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Valida dimensione immagine, accessibilità dell’URL, pre-processing, uso di token e latenza sulla rotta CometAPI esatta usata in produzione.
Trasmettere risposte con SSE
Lo streaming riduce la latenza percepita consegnando output incrementale a interfacce interattive di coding, chat e agenti.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
I client di produzione dovrebbero gestire stream interrotti, delta vuoti, recupero da timeout, limiti di retry e contabilizzazione finale dell’utilizzo.
Quanto costa la DeepSeek V4.1 Flash API?
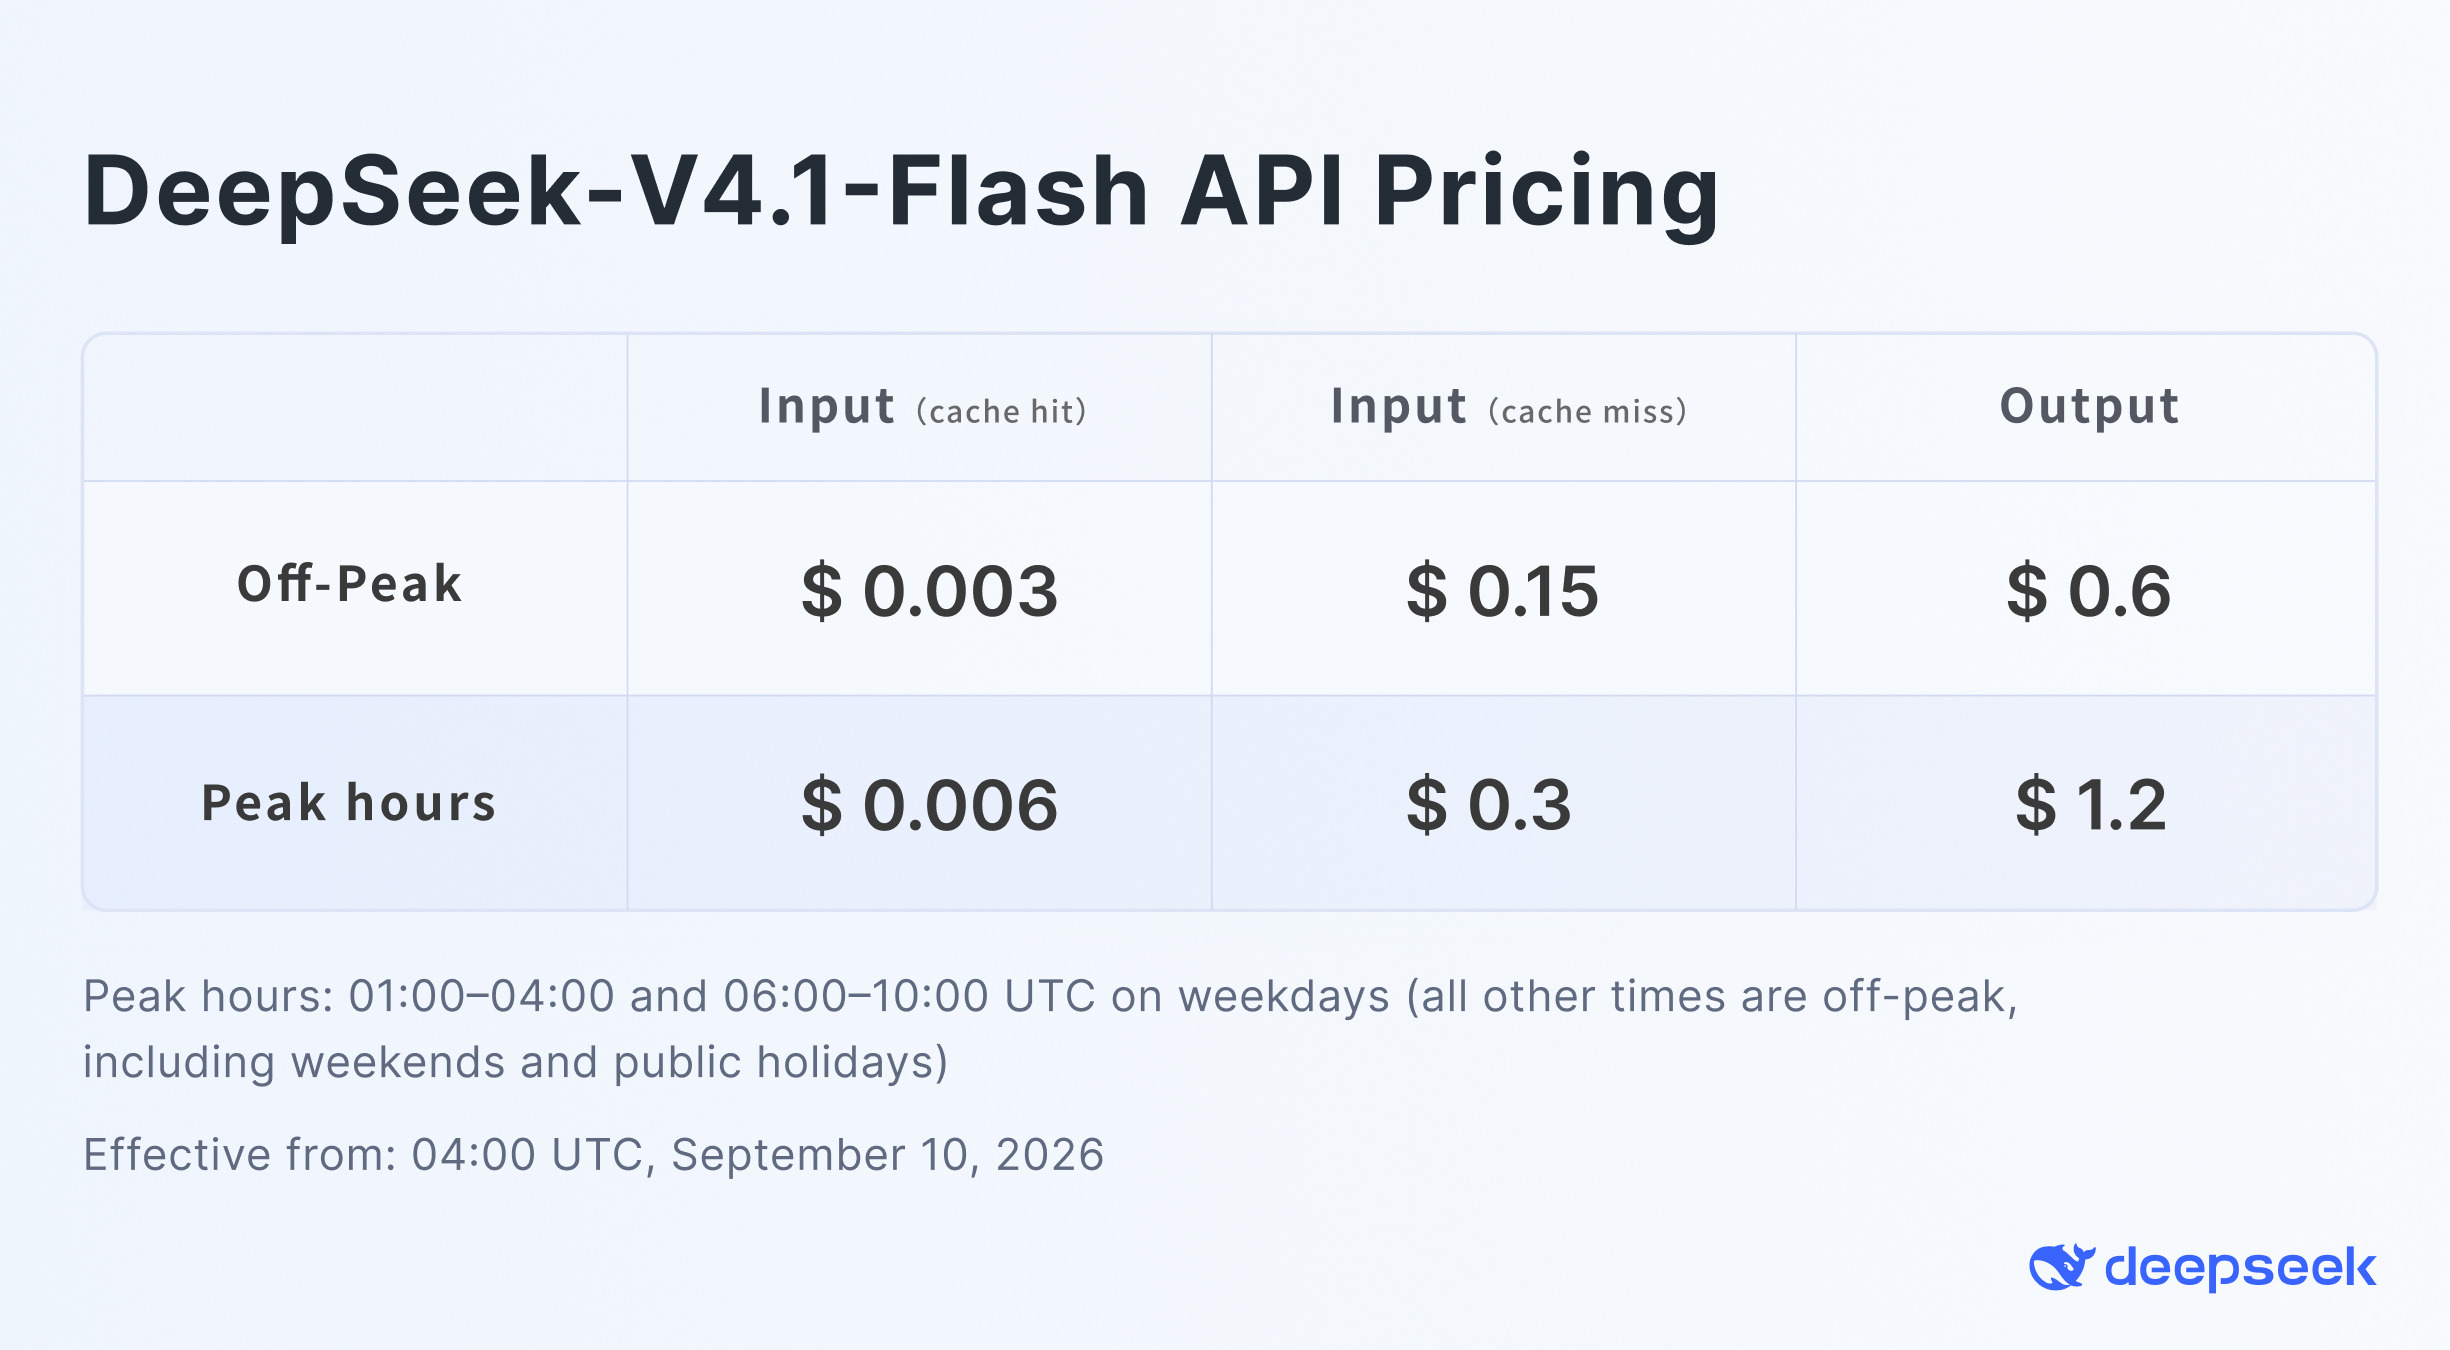
La tariffazione API documentata da DeepSeek usa finestre di picco e fuori picco (peak/off-peak). L’immagine ufficiale dei prezzi mostra tariffe off-peak di $0.003/M per cache-hit in input, $0.15/M per cache-miss in input e $0.60/M per output; le tariffe di picco sono il doppio.
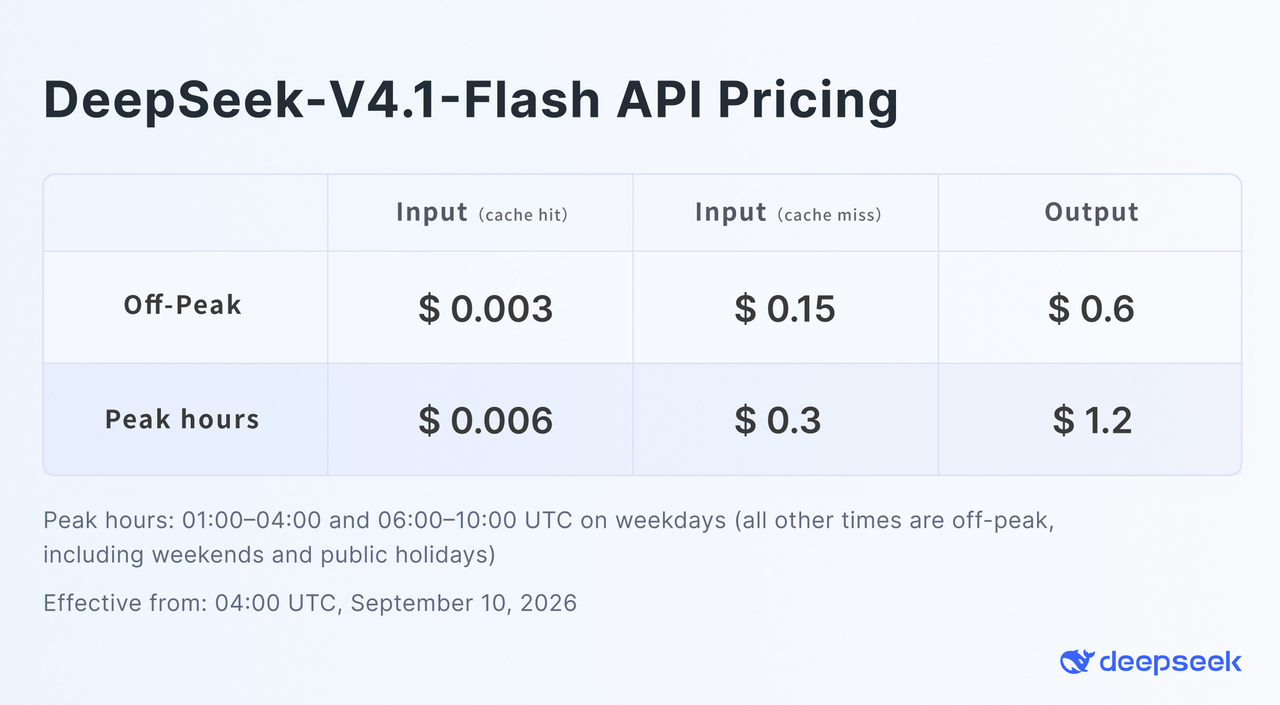
Prezzi ufficiali della DeepSeek V4.1 Flash API ? fonte immagine ufficiale
| Categoria di token | CometAPI DeepSeek V4.1 Flash | Prezzi ufficiali DeepSeek |
|---|---|---|
| Input / cache miss | $0.1200/M base | $0.15/M off-peak |
| Output | $0.4800/M base | $0.60/M off-peak |
| Lettura cache / cache hit | $0.0024/M base | $0.003/M off-peak |
| Moltiplicatore di picco | 2x durante le finestre corrispondenti | 2x durante le finestre corrispondenti |
| Finestra di picco feriale 1 | 01:00-04:00 UTC | 01:00-04:00 UTC |
| Finestra di picco feriale 2 | 06:00-10:00 UTC | 06:00-10:00 UTC |
Un semplice esempio a tariffa base per 100M token di input cache-miss e 20M token di output è:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
Il costo reale in produzione dipende dal mix di token in cache, dai moltiplicatori di picco, dalle condizioni della richiesta e dalla tariffa corrente del provider. La grande differenza tra prezzi di cache-hit e cache-miss rende i prefissi riutilizzabili stabili – istruzioni di sistema, schemi degli strumenti e contesto comune – una leva di costo importante.
DeepSeek V4.1 Flash API vs V4 Pro vs V4 Flash
| Dimensione | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| Posizionamento principale | Ragionamento efficiente, agenti, visione | Ragionamento V4 di fascia alta | Precedente tier V4 veloce |
| Visione nativa | Sì | Dipende dal modello/rotta | Rotta visione separata nella generazione precedente |
| Thinking | Sì | Sì | Sì |
| Prestazioni degli agenti | La più forte delle tre in molti test pubblicati | Forte | Inferiore a V4.1 nei test pubblicati |
| ID canonico first-party | deepseek-flash | deepseek-v4-pro | Alias legacy/compatibilità |
| ID CometAPI | deepseek-v4.1-flash | deepseek-v4-pro | deepseek-v4-flash |
| Miglior adattamento | Nuovi carichi agent/coding ad alto volume | Carichi validati specificamente su Pro | Compatibilità legacy e confronti |
Stato attuale: la documentazione live di DeepSeek
indica che DeepSeek V4 Pro resta disponibile dopo il 14 settembre 2026, con fatturazione invariata. Verifica la documentazione live prima di fare affidamento su routing o comportamenti di migrazione.
Cosa testare prima di mettere in produzione la DeepSeek V4.1 Flash API?
- Instradamento dei modelli: conferma deepseek-v4.1-flash in CometAPI e mantieni gli ID specifici del provider nella configurazione anziché nella logica applicativa.
- Regressione dei prompt: esegui prompt rappresentativi di produzione e confronta il completamento dei task, non solo i punteggi di benchmark.
- Output strutturato: valida ogni risposta JSON contro lo schema applicativo e definisci un percorso di riparazione o retry.
- Chiamate a strumenti: testa tipi di argomento, chiamate malformate, chiamate parallele e condizioni di terminazione dei loop.
- Controlli del thinking: verifica quali campi CometAPI inoltra e misura l’impatto su latenza e token di ciascuna impostazione.
- Visione: testa screenshot e documenti reali, inclusi limiti di dimensione, URL inaccessibili e ruoli di messaggio non supportati.
- Streaming: gestisci delta vuoti, connessioni interrotte, limiti di retry e contabilizzazione finale dell’utilizzo.
- Contesto lungo e caching: misura qualità della risposta, ratio di cache-hit e costo all’aumentare della lunghezza del prompt.
- Affidabilità: registra latenza p50, p95 e p99; esercita percorsi 429, 5xx, timeout e fallback.
- Controllo dei costi: traccia token di input, input in cache, reasoning e output per task completato.
Per carichi agentici, confronta il costo per task completato – non solo dollari per milione di token. Un modello può essere più costoso per token di output e risultare comunque più economico end-to-end se riduce retry e chiamate a strumenti; vale anche il contrario quando un maggiore effort di reasoning aggiunge token senza migliorare il completamento del task.
Vale la pena usare la DeepSeek V4.1 Flash API?
Per nuove integrazioni DeepSeek, DeepSeek V4.1 Flash è un forte candidato predefinito per la famiglia Flash perché combina migliori prestazioni agentiche pubblicate con visione nativa e prezzi aggressivi.
I suoi casi d’uso più forti non sono la semplice chat generica. L’adattamento migliore è per agenti di coding, software engineering automatizzato, analisi con contesto lungo, assistenti multimodali, automazione di flussi ad alto volume e agenti che usano strumenti in cui il contesto riutilizzato può dominare il costo totale.
Per gli sviluppatori che vogliono mantenere un’architettura di SDK in stile OpenAI, la DeepSeek V4.1 Flash API in CometAPI offre il pattern d’integrazione usato in tutta questa guida: mantenere l’interfaccia client standard, puntarla a https://api.cometapi.com/v1 e usare deepseek-v4.1-flash.
FAQ sulla DeepSeek V4.1 Flash API
Come dovrei organizzare gli ID modello specifici del provider?
Memorizza provider, base URL e ID modello insieme nella configurazione specifica dell’ambiente. Questo evita che un ID first-party come deepseek-flash venga inviato per errore a una rotta CometAPI che si aspetta deepseek-v4.1-flash.
Come posso migliorare il riuso della cache in agenti di lunga durata?
Mantieni istruzioni di sistema stabili, schemi degli strumenti e contesto di riferimento condiviso all’inizio del prompt. Aggiungi più avanti l’input utente volatile e i risultati degli strumenti, così il prefisso riutilizzabile cambia meno spesso.
Qual è il modo più sicuro per confrontare V4.1 Flash con V4 Pro?
Riesegui lo stesso set di task di produzione, limita i budget di retry e confronta tasso di completamento, latenza, numero di chiamate a strumenti e token totali. Un prezzo per token più basso non garantisce un costo inferiore per task completato.
Quale politica di fallback dovrebbe usare un agente?
Definisci quali errori sono ripetibili, imposta un tetto rigoroso ai retry e seleziona un modello di fallback solo dopo aver preservato lo stato degli strumenti necessario a riprendere in sicurezza. Registra ogni fallback così che derivazioni di qualità silenziose siano visibili.
Come dovrebbero essere validati gli input immagine prima dell’invio?
Verifica firma reale del file, formato supportato, dimensione in byte, accessibilità dell’URL e ruolo del messaggio. Rimuovi metadati non necessari ed evita di inviare immagini sensibili a meno che le tue politiche di retention e accesso lo consentano esplicitamente.
Quando considerare la Responses API invece di Chat Completions?
Usa Chat Completions quando mantieni un workflow di messaggi compatibile con OpenAI esistente. Considera la Responses API quando l’applicazione beneficia di elementi di input tipizzati, immagini di output degli strumenti o output JSON Schema; poi conferma che la rotta del provider selezionata supporti i campi richiesti.
Come gestire i fallimenti di validazione dello schema?
Rifiuta l’output non valido prima che raggiunga i sistemi a valle, registra l’errore di validazione e riprova con un prompt di riparazione limitato. Se ripetute riparazioni falliscono, instrada il task a un fallback sicuro invece di accettare JSON plausibile ma non valido.