Specifiche tecniche di GLM-5.2
| Voce | GLM-5.2 |
|---|---|
| Fornitore | Zhipu AI |
| Data di rilascio | 13 giugno 2026 |
| Tipo di modello | LLM Mixture-of-Experts (MoE) a pesi aperti |
| Parametri totali | ~744B |
| Parametri attivi | ~40B per token |
| Finestra di contesto | 1,000,000 token |
| Output massimo | 131,072 token |
| Modalità di ragionamento | High, Max |
| Licenza | MIT |
| Focus principale | Programmazione orientata ad agenti, ingegneria del software, ragionamento a lungo orizzonte |
| Disponibilità API | Piattaforma Z.ai e fornitori compatibili |
| Pesi aperti | Sì |
GLM-5.2 è l’ultimo modello di punta della famiglia GLM di Zhipu AI. Diversamente dai modelli generalisti all’avanguardia, GLM-5.2 è posizionato principalmente come modello incentrato sulla programmazione e orientato ad agenti, progettato per l’ingegneria del software a livello di repository, workflow autonomi e ragionamento con contesti estremamente lunghi. La sua capacità di punta è una finestra di contesto nativa da 1 milione di token, rendendola una delle più grandi finestre di contesto pubblicamente disponibili tra i modelli a pesi aperti.
Caratteristiche principali di GLM-5.2
- Finestra di contesto da 1M token per interi repository, set documentali estesi e workflow multi-sessione per agenti.
- Ottimizzazione incentrata sulla programmazione focalizzata su refactoring, debugging, generazione di codice e attività di ingegneria del software.
- Supporto ai workflow basati su agenti per strumenti quali Claude Code, Cline, Roo Code, OpenCode e agenti di codifica analoghi.
- Rilascio a pesi aperti sotto licenza MIT, che abilita self-hosting e fine-tuning.
- Due modalità di ragionamento (High e Max) che consentono compromessi tra latenza e profondità del ragionamento.
- Ampia architettura MoE con circa 744B parametri totali, attivandone solo ~40B per token per efficienza.
Prestazioni nei benchmark di GLM-5.2
Zhipu non ha pubblicato risultati ufficiali completi al lancio, rendendo il confronto diretto più incerto rispetto a modelli come GPT-5 o Claude. Vari report di settore segnalano l’assenza di benchmark convalidati in modo indipendente.
| Benchmark | Punteggio riportato |
|---|---|
| Terminal-Bench 2.1 | 81.0 |
| SWE-Bench Pro | 62.1 |
| NL2Repo | 48.9 |
| AIME 2026 | 99.2 |
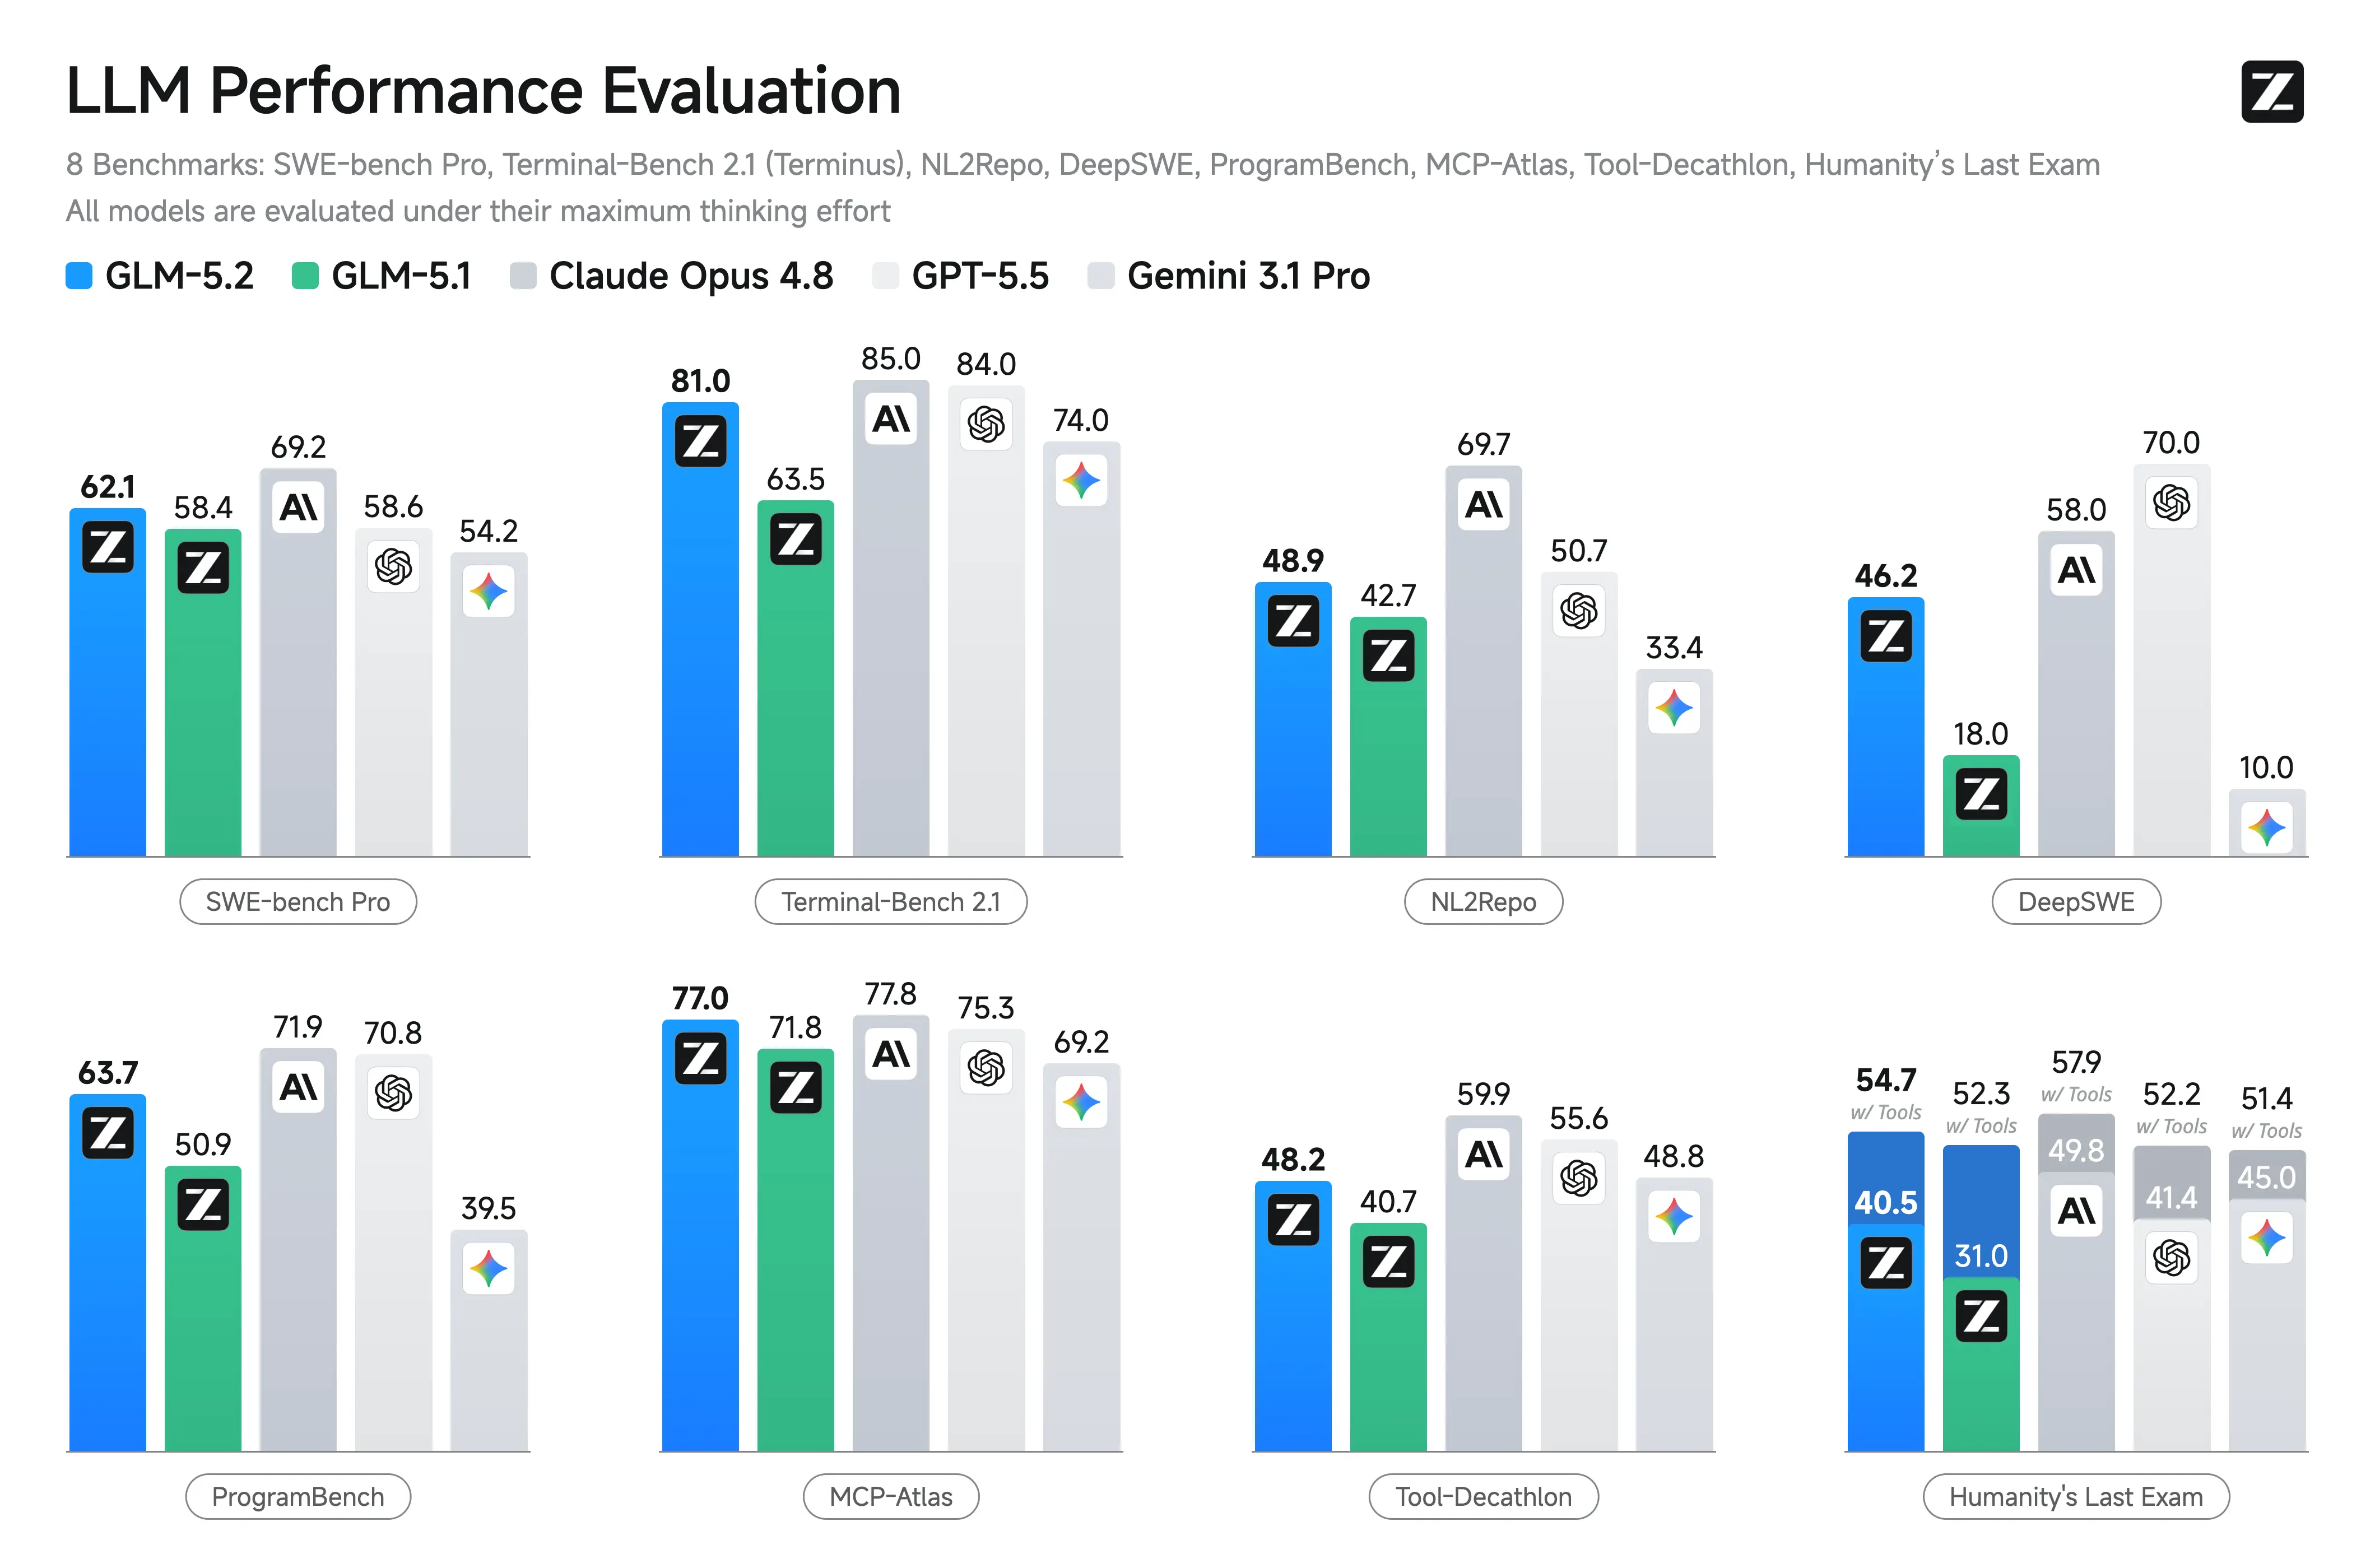
GLM-5.2 vs GLM-5.1 vs Claude Opus 4.8
| Specifiche | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 |
|---|---|---|---|
| Data di rilascio | 2026-06-13 | 2026 | 2026 |
| Finestra di contesto | 1,000,000 | ~200,000 | 1,000,000 |
| Pesi aperti | Sì (MIT) | Sì | No |
| Modalità di ragionamento | High, Max | Standard | Extended Thinking |
| Parametri totali | 744B | 744B | Non divulgati |
| Parametri attivi | 40B | 40B | Non divulgati |
| Dati di benchmark ufficiali | Non pubblicati | Pubblicati al lancio | Pubblicati |
L’aggiornamento principale documentato di GLM-5.2 rispetto a GLM-5.1 è l’espansione a una finestra di contesto da 1M token e l’introduzione delle modalità di ragionamento selezionabili High e Max. Al lancio, Z.ai non ha pubblicato risultati ufficiali per SWE-Bench, LiveCodeBench, HumanEval o benchmark simili, quindi i confronti prestazionali con Claude Opus 4.8, GPT-5, DeepSeek o i modelli Qwen restano non verificati.
Rispetto ad altri modelli open, il principale elemento differenziante di GLM-5.2 è la combinazione di una finestra di contesto molto ampia, specializzazione nella programmazione e licenza MIT. Il suo punto di forza è l’ingegneria del software a livello di repository più che le applicazioni di chat generiche.
Perché usare GLM-5.2 tramite CometAPI?
CometAPI consente agli sviluppatori di integrare GLM-5.2 usando la stessa interfaccia impiegata per decine di modelli AI leader.
I vantaggi includono:
- Autenticazione unificata tra più provider
- Integrazione API compatibile con OpenAI
- Gestione semplificata di fatturazione e utilizzo
- Sperimentazione rapida con modelli alternativi
- Passaggio semplice tra modelli di codifica, ragionamento, immagine, audio e video
- Riduzione del lock-in del fornitore per i sistemi di produzione
Che tu stia costruendo un IDE AI, un assistente di ingegneria interno o una piattaforma di automazione aziendale, CometAPI riduce al minimo lo sforzo di integrazione preservando la flessibilità.
Come accedere all’API GLM-5.2 su CometAPI
Inizia con il nostro prodotto in pochi semplici passaggi...
Passaggio 1: Registrati per ottenere la tua chiave API GLM-5.2
Crea un account su CometAPI e vai alla dashboard delle API per generare la tua chiave API GLM-5.2. Questa chiave autentica tutte le tue richieste e ti dà accesso immediato a tutte le funzionalità dell’API GLM-5.2, inclusa la finestra di contesto da 1M token e 128k token di output.
Passaggio 2: Invia richieste all’API GLM-5.2
Usa la tua chiave API GLM-5.2 per inviare richieste POST all’endpoint CometAPI. Passa il tuo prompt, imposta i parametri del modello come livello di effort e max tokens, e l’API GLM-5.2 elabora la tua richiesta — gestendo tutto, dalla generazione di codice all’analisi di documenti fino all’uso di strumenti agentici.
Passaggio 3: Recupera i risultati e integra l’API GLM-5.2
L’API GLM-5.2 fornisce risposte strutturate, tra cui testo di completamento, istruzioni per la chiamata degli strumenti e metadati sull’utilizzo dei token. Supporta sia risposte sincrone standard sia lo streaming in tempo reale tramite Server-Sent Events (SSE) quando stream: true è configurato. L’endpoint può essere facilmente integrato nei tuoi workflow esistenti usando client HTTP standard o SDK compatibili con OpenAI instradando le richieste tramite url(//api.cometapi.com/v1) con il tuo Bearer Token.